
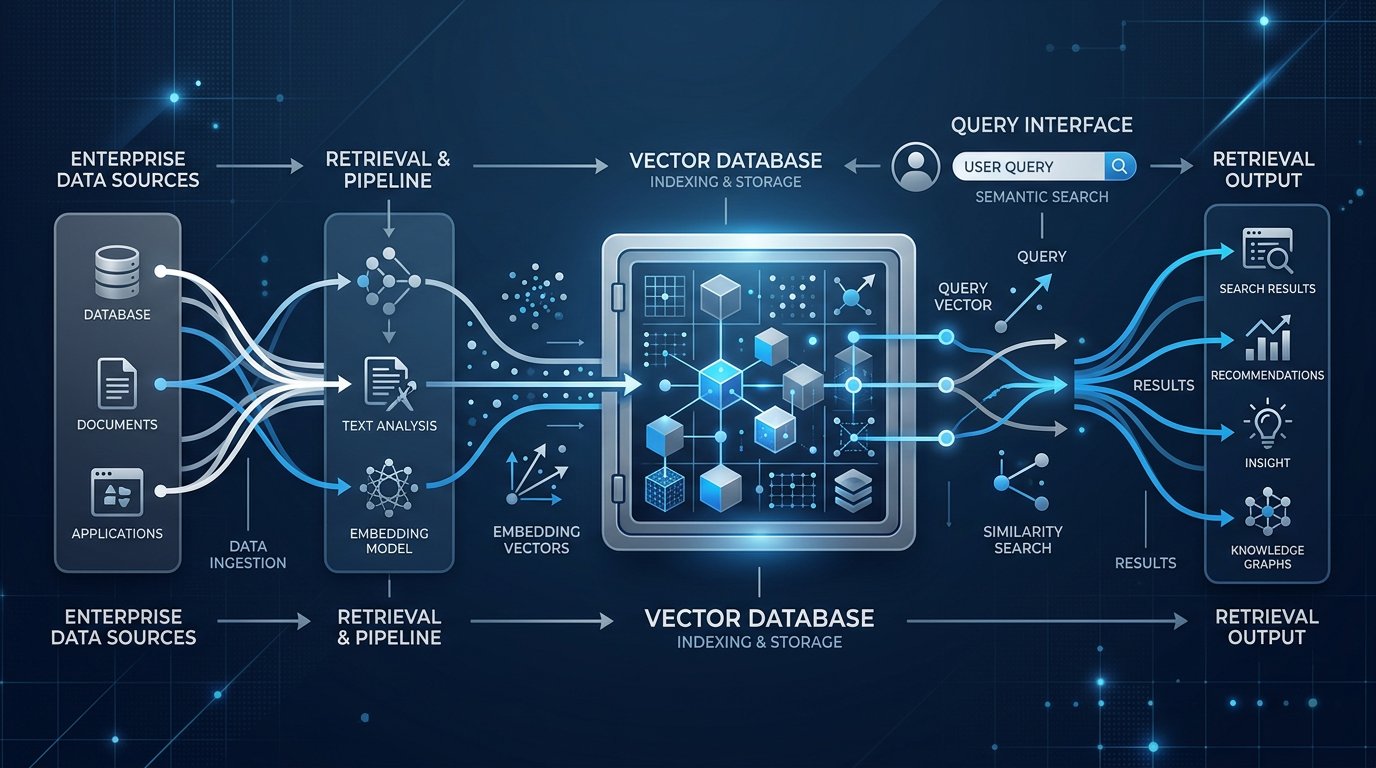
📌 本文重點
- 企業級 RAG 關鍵在檢索架構與權限設計
- 混合檢索 + 重排序是實務標配
- metadata/ACL 必須在檢索前就生效
- 評估指標需同時涵蓋正確性與延遲
在企業環境裡,RAG 的真正價值是:讓 LLM 能安全地用內部最新知識、可控地減少幻覺、並可以用工程方法迭代優化。本文從工程視角拆解:向量資料庫選型、檢索策略、chunking 與 metadata 設計、多租戶與權限控制、線上/離線評估指標,以及常見坑與解法。
重點說明
1. 檢索策略:不只向量,BM25 + 重排序才是實務標配
企業知識庫多來源、多格式,單純向量檢索很容易 miss 關鍵字或出現語義偏移。建議:
- 混合檢索(Hybrid Search):
- 先用 BM25 或全文搜尋(Postgres
tsvector、Elasticsearch、OpenSearch)做初篩 -
再用向量相似度做語義排序,避免只靠 embedding 導致關鍵領域術語被忽略
-
重排序(Rerank):
- 對 top-50 結果使用 cross-encoder / reranker 模型重新排序(如
bge-reranker-large) - 好處:在不放大向量庫負載的情況下,顯著提升 answer correctness
💡 關鍵: 透過「先 BM25 初篩、再向量排序、最後 rerank」三段式檢索,可以在不犧牲效能的前提下,大幅提升答案正確率與穩定性。
實務上你可以:
- 用 pgvector 存 embedding + Postgres 原生全文檢索
- 或用 Milvus 做向量檢索,搭配獨立搜尋服務(Elastic / OpenSearch)做 BM25
2. Chunking 與 Metadata:為檢索設計,而不是為分段而分段
錯誤的 chunking 會直接降低 context recall,企業常見問題是「段太小、沒有結構」。建議:
- 混合策略 chunking:
- 先以語義斷點(標題、小節)切大塊,再用字數/token 限制微調
-
典型配置:512–1024 tokens + 128–256 tokens overlap
-
metadata schema 是檢索與權限的核心:至少包含:
tenant_id: 多租戶隔離doc_id,section_id: 追蹤來源與回溯source_system: Slack / GDrive / Confluence / Jira…visibility_tags/acl: 權限控制(角色、群組、文件 owner)
好處:
- chunk 不只是「段落」,而是帶有權限、業務上下文的最小檢索單位
- 評估失敗案例時可以精準定位是哪個 chunk / doc 出問題
3. 多租戶與權限:在「檢索前」把不該看的東西砍掉
語義向量檢索會天然繞過傳統 RBAC 的關鍵字邊界,必須在檢索前加上身分綁定的 filter:
- Identity-bound pre-retrieval filters:查詢向量庫前,先用
tenant_id+ ACL 建立 filter - 所有檢索 API 都要支援條件:
WHERE tenant_id = $tenant AND acl @> $user_roles
關鍵結論:
- 權限控制不能只做在「生成後」,因為一旦檢索到不該看的 context,就算你遮罩輸出,也已經有資料洩漏風險
- 向量庫層一定要有 硬隔離策略(租戶切庫 / 切 collection / 至少切 partition)
💡 關鍵: 權限過濾一定要在向量檢索「之前」就生效,否則只在輸出層遮罩,其實已經完成資料洩漏。
4. 評估與監控:不只看 BLEU,更要看「能不能在生產上 debug」
建議至少三類指標:
- Answer Correctness(生成品質)
-
LLM 自評(使用 judge model)、人工標註小樣本、或用 rule-based 準確率
-
Context Recall(檢索品質)
-
離線 benchmark:準備一組「問題 + 標準文件」pair,測量 top-k 是否包含正確文件
-
Latency(服務體驗)
- 分段量測:檢索延遲、重排序延遲、LLM 生成延遲
好處:
- 可以清楚區分是檢索出錯、權限漏控,還是 LLM 幻覺
- 為迭代(換 embedding 模型、調 chunking、調 rerank)提供可量化目標
實作範例:Node + pgvector + 開源 embedding 的簡單企業知識庫
下面用一個簡化的架構示範:
- 向量庫:Postgres + pgvector
- Embedding 模型:
BAAI/bge-base-en(你可以換成中文模型) - 後端:Node.js (TypeScript)
1. 資料庫 schema 設計
-- pgvector 安裝後,建立知識庫表
CREATE TABLE kb_chunks (
  id             BIGSERIAL PRIMARY KEY,
  tenant_id      TEXT NOT NULL,
  doc_id         TEXT NOT NULL,
  section_id     TEXT,
  source_system  TEXT NOT NULL,
  content        TEXT NOT NULL,
  embedding      VECTOR(768) NOT NULL,
  visibility_tags TEXT[], -- e.g. ['legal', 'finance']
  acl_roles      TEXT[],  -- e.g. ['legal_team', 'admin']
  created_at     TIMESTAMP DEFAULT NOW()
);

CREATE INDEX idx_kb_chunks_tenant ON kb_chunks (tenant_id);
CREATE INDEX idx_kb_chunks_acl_roles ON kb_chunks USING GIN (acl_roles);
CREATE INDEX idx_kb_chunks_visibility_tags ON kb_chunks USING GIN (visibility_tags);
CREATE INDEX idx_kb_chunks_embedding ON kb_chunks USING ivfflat (embedding vector_l2_ops) WITH (lists = 100);
重點:
- 用 ivfflat +
lists調優檢索速度 - 用
acl_roles/visibility_tags作為 pre-retrieval filter 的基礎
2. Chunking 與寫入管線(Python 伺服端工具)
from transformers import AutoTokenizer, AutoModel
import psycopg2

MODEL_NAME = "BAAI/bge-base-en"
MAX_TOKENS = 800
OVERLAP = 200

# 省略連線與模型初始化

def chunk_document(text: str, tenant_id: str, doc_id: str, source_system: str, acl_roles: list[str]):
    tokens = tokenizer.encode(text)
    chunks = []
    start = 0
    while start < len(tokens):
        end = min(start + MAX_TOKENS, len(tokens))
        chunk_tokens = tokens[start:end]
        chunk_text = tokenizer.decode(chunk_tokens)
        chunks.append(chunk_text)
        start += MAX_TOKENS - OVERLAP
    return chunks

def embed(texts: list[str]):
    # 簡化:batch embedding
    inputs = tokenizer(texts, padding=True, truncation=True, return_tensors="pt")
    with torch.no_grad():
        outputs = model(**inputs)
    embeddings = outputs.last_hidden_state[:, 0, :].cpu().numpy()  # CLS pooling 或改用 mean pooling
    return embeddings

# 寫入 pgvector 的 SQL 略
好處:
- chunking 有明確 token 參數,可調試
- metadata 與 ACL 一起寫入,避免「後面再補權限」的錯誤做法
3. Node RAG Pipeline:帶權限的混合檢索 + 重排序
import { Pool } from 'pg';
import { getEmbedding } from './embeddingClient'; // 呼叫 Python 或直接用 Node 模型

const pool = new Pool({ /* db config */ });

interface UserContext {
  tenantId: string;
  roles: string[];
}

export async function ragAnswer(query: string, user: UserContext) {
  const embedding = await getEmbedding(query); // 返回 Float32Array 長度 768

  // 1. 帶 ACL 的向量檢索
  const vectorSql = `
    SELECT id, content, doc_id, section_id, source_system,
           1 - (embedding <=> $1::vector) AS score
    FROM kb_chunks
    WHERE tenant_id = $2
      AND acl_roles && $3::text[]
    ORDER BY embedding <-> $1::vector
    LIMIT 50;
  `;

  const vectorRes = await pool.query(vectorSql, [embedding, user.tenantId, user.roles]);

  // 2. 這裡可以加 BM25 / tsquery 做 keyword 初篩(略)

  // 3. 用 reranker 模型重排序(虛擬碼)
  const reranked = await rerank(query, vectorRes.rows.map(r => r.content));
  const topContexts = reranked.slice(0, 5).map(r => r.content);

  // 4. 組 prompt 給 LLM
  const prompt = `你是公司內部助理,回答必須只根據提供的內容。

[檢索到的內容]
${topContexts.join('\n---\n')}

[問題]
${query}

請根據上面內容回答,若資料不足請明確說「目前知識庫沒有相關資訊」。`;

  const answer = await callLLM(prompt); // 例如 OpenAI / 本地 LLM

  return {
    answer,
    contexts: topContexts,
    debug: {
      retrievedCount: vectorRes.rowCount,
      tenantId: user.tenantId,
    },
  };
}
關鍵 API / 參數:
embedding <-> $1::vector:pgvector 距離運算,建議用L2或cosineacl_roles && $3::text[]:在檢索階段就做 ACL filter(pre-retrieval)- LLM prompt 強制「無資料要明說」,降低幻覺
4. 簡單線上評估與監控
可以加一個中介層紀錄:
await logMetrics({
  tenantId: user.tenantId,
  query,
  latencyMs,
  retrievedCount: vectorRes.rowCount,
  model: 'bge-base-en',
  llmModel: 'gpt-4o',
});
後續離線跑:
- 對一批標註問題跑 RAG,請 judge LLM 給出 correctness score(1–5)
- 比較不同 embedding / chunking / rerank 策略的分數與延遲,做 A/B 測試
建議與注意事項
1. 幻覺依然存在:RAG 不是「關幻覺開關」
- 即使檢索正確,LLM 仍可能「補細節」或「推理過頭」
- 解法:
- 明確在 prompt 中說:「不在 context 裡的資訊一律不要編造」
- 在輸出層加 rule-based 檢查(如法律/財務答案一定要附來源文件 ID)
2. 檢索結果不穩定:embedding / chunking / rerank 三者缺一不可
- 換 embedding 模型時,一定要重新做離線 benchmark,不要只看 demo 感覺
- chunking 調整需同時看:
- context recall(有沒有檢索到正確文件)
- latency(chunk 變多會拖慢向量檢索)
💡 關鍵: 每次調整 embedding 或 chunking,都要用標註資料評估「召回率 + 延遲」,而不是只憑主觀 demo 感受做決策。
3. 權限洩漏:不要相信「應用層自己會控」
- RBAC 必須深入到向量庫 query 層
- 尤其是把 Slack / GDrive / Jira 接在一起作企業 search 時:
- 預設策略是「拒絕」,只對明確授權內容建索引
- 建議對敏感資料(legal / M&A 文件)做 單獨 collection / database 隔離
4. 迭代路線:從 PoC 到生產級
- PoC 階段:單租戶、簡單 chunking、只向量檢索
- Beta 階段:加 metadata schema、權限 filter、簡單監控
- 生產階段:
- Hybrid search(BM25 + 向量)
- reranker 模型
- 線上指標 + 離線 benchmark(answer correctness / context recall / latency)
- 權限審計與合規(log 每次檢索的 doc_id 與 user_id)
核心結論:企業級 RAG 的關鍵不在「模型選哪個」,而在於:檢索架構、權限設計與可評估性是否工程化落地。只要這三件事做穩,模型與向量庫都可以迭代替換,而整個系統仍保持穩定、可回溯、可持續優化。
🚀 你現在可以做的事
- 在現有 Postgres 專案中安裝
pgvector,建立含tenant_id與acl_roles的kb_chunks表- 準備一批「問題 + 標準答案文件」pair,離線跑一次 context recall/latency benchmark
- 將現有 RAG 應用的權限邏輯下沉到向量庫查詢層,加入
tenant_id+ ACL 的 pre-retrieval filter
發佈留言