標籤: 企業知識庫

  • 生產級 RAG 架構實戰與踩坑指南

    生產級 RAG 架構實戰與踩坑指南

    📌 本文重點

    • 生產級 RAG 核心在「檢索精準度」
    • 先設計穩定索引管線,再優化查詢路徑
    • 權限與多租戶必須在索引層處理
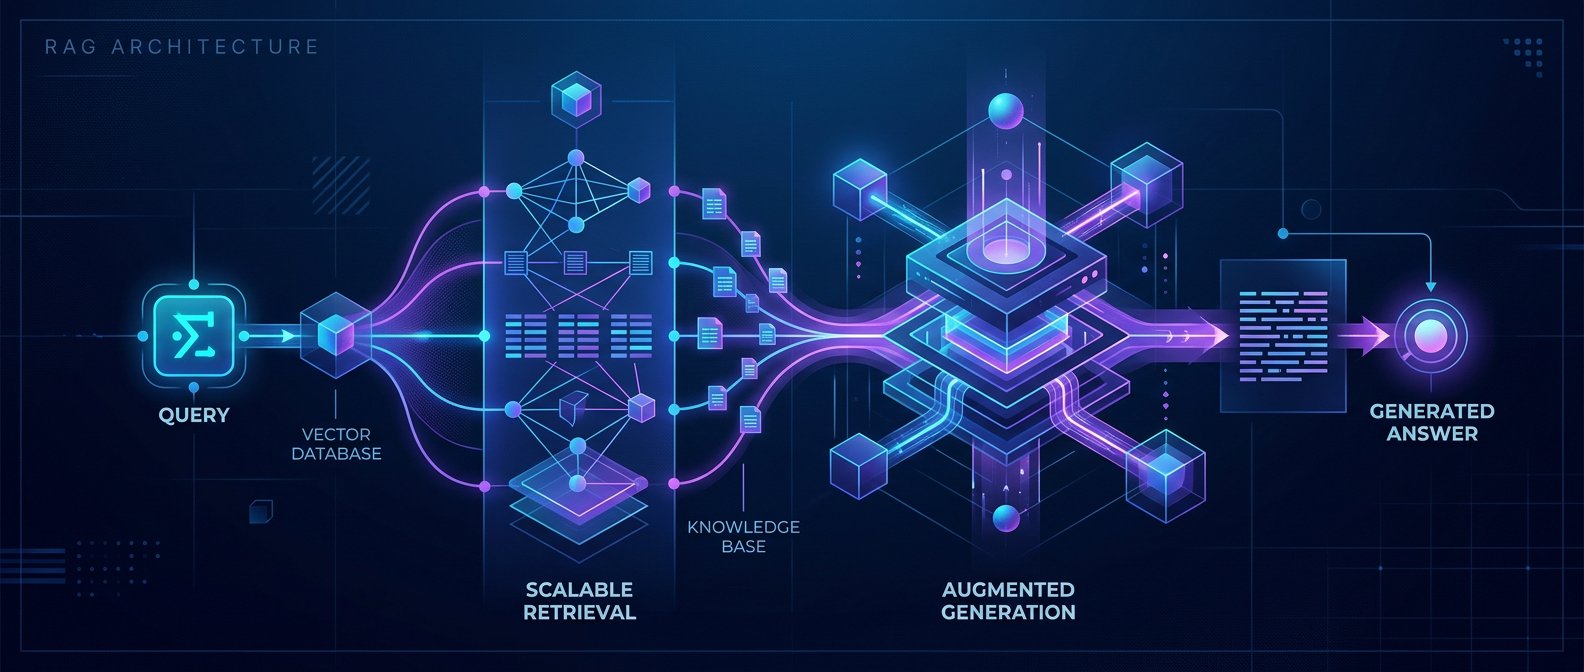
    • 把 RAG 當「檢索系統 + LLM」來設計

    在 demo 環境跑得很順的 RAG,一接上真實企業文件就開始答非所問、亂編內容、延遲爆炸。這篇文章要解決的痛點很直接:如何把「玩具級 RAG」變成「可以被客服、業務、內部搜尋真正依賴」的生產系統,而不是靠換更大的 LLM 硬撐。


    重點說明:兩個關鍵心智模型

    1. 檢索精準度 > 模型能力

    多數生產事故不是 LLM 太笨,而是檢索到的內容就錯了:

    • chunk 切太碎:一句關鍵話被切開,LLM 根本看不到完整前後文
    • embedding 品質差:相似度搜尋抓不到真正相關的段落
    • 檢索策略太單純:只用 top-k dense vector,忽略 metadata / keyword / rerank

    💡 關鍵: 先把檢索品質拉高,通常比直接換更大的模型帶來更高的整體效益。

    結論:先優化檢索,再考慮換更大的模型。實務上,花在檢索調整的時間,ROI 通常比換模型高很多。

    2. 系統品質由最弱環節決定

    一個典型 RAG 流水線:

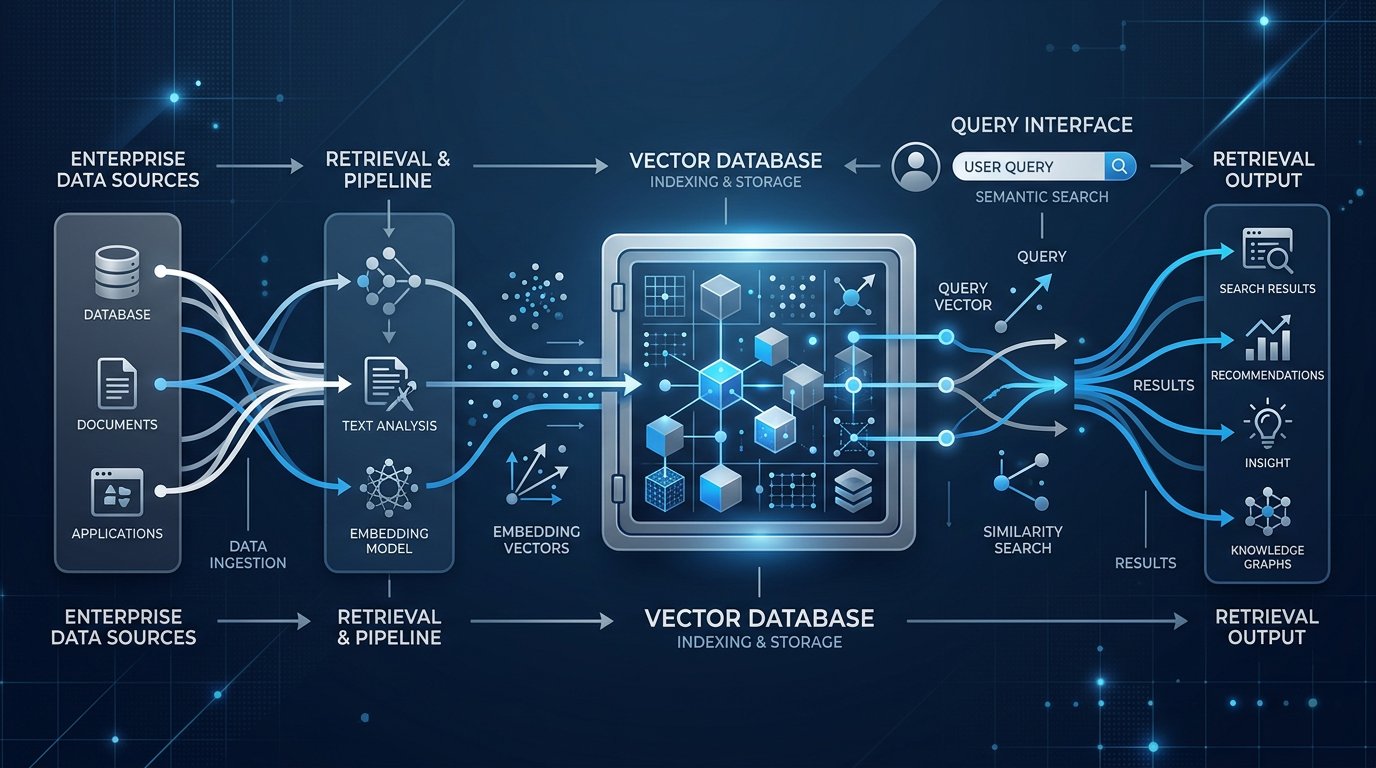
    資料 → chunking → embedding → 向量庫/索引 → 查詢策略 → rerank → LLM 回答

    任何一段出問題,整條鏈就報廢:

    • Chunking 不考慮結構:FAQ 題目和答案被拆開
    • 向量庫設計混亂:不同語言、不同資料源混在同一 index
    • 檢索策略只有單一路徑:某個類型問題天生查不到答案,直接導致幻覺

    把它當成一條 ML data pipeline 來設計:

    先穩定離線索引,再設計可觀測的線上查詢路徑。


    離線索引管線:從混亂文件到可用索引

    1. 資料清洗與格式統一

    企業常見情境:Confluence、PDF 掃描檔、工單、Excel 報表全混在一起。

    目標:轉成「統一的文件 schema」,例如:

    {
      "doc_id": "policy-2024-hr-001",
      "source": "confluence",
      "title": "2024 HR 政策總則",
      "lang": "zh-TW",
      "section_path": ["人資", "請假制度"],
      "content": "純文字內容...",
      "permissions": ["dept-hr", "role-admin"],
      "updated_at": "2024-05-01T10:00:00Z"
    }
    

    重點:

    • 提前把 權限、多租戶標籤、語言 等 metadata 帶上,後面檢索才能 filter
    • 盡量在這一步做結構抽取(標題、段落、表格轉文字)

    2. Chunk 策略:不是「固定 500 tokens 就好」

    實務上可以用「結構優先 + 長度限制」策略:

    MAX_TOKENS = 350
    OVERLAP_TOKENS = 50
    
    # 1. 先依標題 / 小節切
    sections = split_by_headings(doc.content)
    
    # 2. 每個 section 再依 token 長度切成多個 chunk
    chunks = []
    for sec in sections:
        for c in sliding_window_tokenize(
            sec,
            max_tokens=MAX_TOKENS,
            overlap_tokens=OVERLAP_TOKENS,
        ):
            chunks.append({
                "doc_id": doc.doc_id,
                "section_title": sec.title,
                "content": c.text,
                "start_offset": c.start,
                "end_offset": c.end,
            })
    

    好處:

    • 儘量保持語意完整的段落,減少「半句話」的 chunk
    • 使用 overlap 避免重要句子剛好被切斷

    3. Embedding 批次處理與向量庫設計

    建議:

    • 儘量統一使用 同一個 embedding 模型 處理相同語料
    • 做 batch embedding,避免每個 chunk 單獨呼叫 API 導致吞吐量慘烈

    示意程式碼:

    from openai import OpenAI
    from tqdm import batched
    
    client = OpenAI()
    
    EMBED_MODEL = "text-embedding-3-large"
    BATCH_SIZE = 256
    
    vectors = []
    for batch in batched(chunks, BATCH_SIZE):
        texts = [c["content"] for c in batch]
        resp = client.embeddings.create(
            model=EMBED_MODEL,
            input=texts,
        )
        for c, emb in zip(batch, resp.data):
            vectors.append({
                "id": f"{c['doc_id']}::{c['start_offset']}",
                "embedding": emb.embedding,
                "metadata": {
                    "doc_id": c["doc_id"],
                    "section_title": c["section_title"],
                    "permissions": doc.permissions,
                    "lang": doc.lang,
                    "source": doc.source,
                },
            })
    

    向量庫設計要點(不管你用 Pinecone、Weaviate、Qdrant、pgvector):

    • 每個 index 維持單一主要語言或資料型態,避免 embedding 空間太混
    • 必須支援 metadata filter(之後做權限、多租戶隔離)

    線上查詢路徑:多路檢索 + Rerank + Fallback

    1. 多路檢索與 metadata filter

    典型路徑不是一發向量搜尋就結束,而是:

    1. 根據使用者身份加上 權限 filter
    2. 同時走 向量檢索(semantic) 與 關鍵字 / BM25(lexical)
    3. 合併結果後用 reranker 排序

    假設你用的是一個支援 hybrid search 的向量庫:

    query_vector = embed_query(user_query)
    
    filters = {
      "must": [
        {"key": "tenant_id", "match": user.tenant_id},
        {"key": "permissions", "in": user.roles},
      ]
    }
    
    # dense + keyword 路徑
    vec_results = vector_index.search(
        vector=query_vector,
        top_k=30,
        filter=filters,
    )
    
    keyword_results = keyword_index.search(
        text=user_query,
        top_k=30,
        filter=filters,
    )
    
    candidates = dedup(vec_results + keyword_results)
    

    2. 使用 rerank 提升最終精準度

    在 top-30 或 top-50 候選上,用一個更強的 cross-encoder / LLM reranker 排序:

    from my_reranker import cross_encoder_rerank
    
    reranked = cross_encoder_rerank(user_query, candidates)  # 回傳已排序列表
    top_contexts = reranked[:5]
    

    好處:

    • dense 向量比較好抓「同一概念不同字眼」
    • keyword 比較好抓「精準術語」與數字、代碼
    • rerank 用較貴的模型,但只跑在小量候選上,CP 值高

    3. LLM 回答與 Fallback 策略

    最後呼叫 LLM 時,不要直接餵所有 chunk,而是:

    • 限制 context 數量(例如最多 4–8 個 chunk)
    • 明確告訴模型:只能根據提供的資料回答
    SYSTEM_PROMPT = """你是公司內部知識庫助理,只能根據提供的 context 回答。
    如果找不到答案,請明確回答「依目前資料無法確認」。
    """
    
    context_str = "\n\n".join(
        [f"[{i}] {c['content']}" for i, c in enumerate(top_contexts)]
    )
    
    completion = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"問題:{user_query}\n\n參考資料:\n{context_str}"},
        ],
    )
    

    Fallback 設計建議:

    • 若檢索結果的 相似度分數都低於某門檻,直接回答「查無對應資料」而非亂編
    • 若向量檢索失敗,可 fallback 成只用 keyword search

    常見坑與實戰建議

    1. 混亂企業文件與長上下文幻覺

    • 問題:把整份 PDF 直接丟進 LLM 的 long context,看起來很酷,但成本與幻覺都超高
    • 建議:
    • 把 long context 當成 最後手段,先用精準檢索把範圍縮小
    • 針對常見錯誤問句,建立 失敗樣本集,離線迭代 chunking / 檢索策略

    2. 權限與多租戶

    • 絕對不要在 LLM prompt 內才控制權限
    • 權限應該在 向量庫的 metadata filter 層 完成
    • 多租戶建議:
    • 小規模:同一 index,用 tenant_id 做 filter
    • 大客戶:獨立 index,避免資料量與權限邏輯互相影響

    3. 成本與延遲控制

    可以從幾個槓桿調整:

    • top-k:從 20 慢慢調到 50 看效果,不要一開始就丟 100
    • 使用 gpt-4.1-mini / Llama 小模型當回答模型,搭配精準檢索,通常已足夠
    • 批次 embedding、批次向量查詢,減少 API round-trip

    💡 關鍵: 先優化 top-k、模型選型與批次策略,往往就能在不換主模型的情況下顯著降低成本與延遲。

    4. 離線評估與線上監控

    離線評估:

    • 建立一小包「問題–標準答案–應該被檢索到的 chunk」
    • 指標:Hit@k、MRR、生成答案與標準答案的相似度

    線上監控:

    • 記錄每次 query 的:
    • 檢索到的 doc_id / 相似度分數
    • LLM 回答 + 使用者後續行為(是否重新提問、是否人工改寫)
    • 針對「多次重試」或「被人工標記錯誤」的 query,自動加入離線失敗樣本集

    不同規模專案的 RAG 架構選型建議

    1. 小型專案(單一產品 FAQ / 文件 < 1k 篇)

    • 架構:Single-vector RAG 即可
    • 單一向量庫 index
    • 單一路徑的向量檢索(top-k=10)+ 簡單 rerank 或甚至不 rerank
    • 什麼時候足夠:
    • 問題類型集中、文件格式相對乾淨
    • 沒有複雜權限、多租戶

    2. 中型專案(多產品、多來源文檔,含內部知識庫)

    • 架構:Hybrid Search RAG
    • 向量檢索 + keyword/BM25 檢索
    • Metadata filter 處理基本權限、多語言
    • reranker 排序 top-30
    • 適用情境:
    • 文件來源與格式混雜
    • 問題類型多樣(政策、程式碼、FAQ 混在一起)

    3. 大型企業級專案(多租戶 SaaS、嚴格權限控制)

    • 架構:分層 RAG pipeline
    • 第一層:根據 query 先判斷「要去哪個 domain / product / tenant」
    • 第二層:在該 domain 內做 hybrid search + rerank
    • 針對高價值流程(法務、財務)再加一層 LLM verification / rule-based check
    • 必備:
    • 完整 observability(檢索 log、失敗樣本管理)
    • 嚴格權限控制嵌在 index filter,不依賴 prompt

    小結:先把檢索做好,再談「更聰明的模型」

    如果要一句話總結生產級 RAG:

    把它當檢索系統 + LLM,而不是 LLM + 一點點檢索。

    從離線索引管線、chunk 策略、向量庫設計到線上多路檢索與 rerank,只要能有系統地優化這些「最弱環節」,你的 RAG 往往在不升級模型的情況下,就能從 demo 品質變成可以上線承壓的生產系統。

    🚀 你現在可以做的事

    • 把現有企業文件先整理成統一 document schema,並補上權限與語言等 metadata
    • 實作一條離線 chunking + batch embedding 管線,搭配支援 metadata filter 的向量庫
    • 為常見查詢建立「失敗樣本集」,定期用 Hit@k / MRR 檢驗並調整檢索與 chunk 策略
  • 企業級 RAG 實戰架構與評估全攻略

    企業級 RAG 實戰架構與評估全攻略

    📌 本文重點

    • 企業級 RAG 關鍵在檢索架構與權限設計
    • 混合檢索 + 重排序是實務標配
    • metadata/ACL 必須在檢索前就生效
    • 評估指標需同時涵蓋正確性與延遲

    在企業環境裡,RAG 的真正價值是:讓 LLM 能安全地用內部最新知識、可控地減少幻覺、並可以用工程方法迭代優化。本文從工程視角拆解:向量資料庫選型、檢索策略、chunking 與 metadata 設計、多租戶與權限控制、線上/離線評估指標,以及常見坑與解法。


    重點說明

    1. 檢索策略:不只向量,BM25 + 重排序才是實務標配

    企業知識庫多來源、多格式,單純向量檢索很容易 miss 關鍵字或出現語義偏移。建議:

    1. 混合檢索(Hybrid Search):
    2. 先用 BM25 或全文搜尋(Postgres tsvector、Elasticsearch、OpenSearch)做初篩
    3. 再用向量相似度做語義排序,避免只靠 embedding 導致關鍵領域術語被忽略

    4. 重排序(Rerank):

    5. 對 top-50 結果使用 cross-encoder / reranker 模型重新排序(如 bge-reranker-large)
    6. 好處:在不放大向量庫負載的情況下,顯著提升 answer correctness

    💡 關鍵: 透過「先 BM25 初篩、再向量排序、最後 rerank」三段式檢索,可以在不犧牲效能的前提下,大幅提升答案正確率與穩定性。

    實務上你可以:

    • 用 pgvector 存 embedding + Postgres 原生全文檢索
    • 或用 Milvus 做向量檢索,搭配獨立搜尋服務(Elastic / OpenSearch)做 BM25

    2. Chunking 與 Metadata:為檢索設計,而不是為分段而分段

    錯誤的 chunking 會直接降低 context recall,企業常見問題是「段太小、沒有結構」。建議:

    1. 混合策略 chunking:
    2. 先以語義斷點(標題、小節)切大塊,再用字數/token 限制微調
    3. 典型配置:512–1024 tokens + 128–256 tokens overlap

    4. metadata schema 是檢索與權限的核心:至少包含:

    5. tenant_id: 多租戶隔離
    6. doc_id, section_id: 追蹤來源與回溯
    7. source_system: Slack / GDrive / Confluence / Jira…
    8. visibility_tags / acl: 權限控制(角色、群組、文件 owner)

    好處:

    • chunk 不只是「段落」,而是帶有權限、業務上下文的最小檢索單位
    • 評估失敗案例時可以精準定位是哪個 chunk / doc 出問題

    3. 多租戶與權限:在「檢索前」把不該看的東西砍掉

    語義向量檢索會天然繞過傳統 RBAC 的關鍵字邊界,必須在檢索前加上身分綁定的 filter:

    • Identity-bound pre-retrieval filters:查詢向量庫前,先用 tenant_id + ACL 建立 filter
    • 所有檢索 API 都要支援條件:WHERE tenant_id = $tenant AND acl @> $user_roles

    關鍵結論:

    • 權限控制不能只做在「生成後」,因為一旦檢索到不該看的 context,就算你遮罩輸出,也已經有資料洩漏風險
    • 向量庫層一定要有 硬隔離策略(租戶切庫 / 切 collection / 至少切 partition)

    💡 關鍵: 權限過濾一定要在向量檢索「之前」就生效,否則只在輸出層遮罩,其實已經完成資料洩漏。


    4. 評估與監控:不只看 BLEU,更要看「能不能在生產上 debug」

    建議至少三類指標:

    1. Answer Correctness(生成品質)
    2. LLM 自評(使用 judge model)、人工標註小樣本、或用 rule-based 準確率

    3. Context Recall(檢索品質)

    4. 離線 benchmark:準備一組「問題 + 標準文件」pair,測量 top-k 是否包含正確文件

    5. Latency(服務體驗)

    6. 分段量測:檢索延遲、重排序延遲、LLM 生成延遲

    好處:

    • 可以清楚區分是檢索出錯、權限漏控,還是 LLM 幻覺
    • 為迭代(換 embedding 模型、調 chunking、調 rerank)提供可量化目標

    實作範例:Node + pgvector + 開源 embedding 的簡單企業知識庫

    下面用一個簡化的架構示範:

    • 向量庫:Postgres + pgvector
    • Embedding 模型:BAAI/bge-base-en(你可以換成中文模型)
    • 後端:Node.js (TypeScript)

    1. 資料庫 schema 設計

    -- pgvector 安裝後,建立知識庫表
    CREATE TABLE kb_chunks (
      id             BIGSERIAL PRIMARY KEY,
      tenant_id      TEXT NOT NULL,
      doc_id         TEXT NOT NULL,
      section_id     TEXT,
      source_system  TEXT NOT NULL,
      content        TEXT NOT NULL,
      embedding      VECTOR(768) NOT NULL,
      visibility_tags TEXT[], -- e.g. ['legal', 'finance']
      acl_roles      TEXT[],  -- e.g. ['legal_team', 'admin']
      created_at     TIMESTAMP DEFAULT NOW()
    );
    
    CREATE INDEX idx_kb_chunks_tenant ON kb_chunks (tenant_id);
    CREATE INDEX idx_kb_chunks_acl_roles ON kb_chunks USING GIN (acl_roles);
    CREATE INDEX idx_kb_chunks_visibility_tags ON kb_chunks USING GIN (visibility_tags);
    CREATE INDEX idx_kb_chunks_embedding ON kb_chunks USING ivfflat (embedding vector_l2_ops) WITH (lists = 100);
    

    重點:

    • 用 ivfflat + lists 調優檢索速度
    • 用 acl_roles / visibility_tags 作為 pre-retrieval filter 的基礎

    2. Chunking 與寫入管線(Python 伺服端工具)

    from transformers import AutoTokenizer, AutoModel
    import psycopg2
    
    MODEL_NAME = "BAAI/bge-base-en"
    MAX_TOKENS = 800
    OVERLAP = 200
    
    # 省略連線與模型初始化
    
    def chunk_document(text: str, tenant_id: str, doc_id: str, source_system: str, acl_roles: list[str]):
        tokens = tokenizer.encode(text)
        chunks = []
        start = 0
        while start < len(tokens):
            end = min(start + MAX_TOKENS, len(tokens))
            chunk_tokens = tokens[start:end]
            chunk_text = tokenizer.decode(chunk_tokens)
            chunks.append(chunk_text)
            start += MAX_TOKENS - OVERLAP
        return chunks
    
    def embed(texts: list[str]):
        # 簡化:batch embedding
        inputs = tokenizer(texts, padding=True, truncation=True, return_tensors="pt")
        with torch.no_grad():
            outputs = model(**inputs)
        embeddings = outputs.last_hidden_state[:, 0, :].cpu().numpy()  # CLS pooling 或改用 mean pooling
        return embeddings
    
    # 寫入 pgvector 的 SQL 略
    

    好處:

    • chunking 有明確 token 參數,可調試
    • metadata 與 ACL 一起寫入,避免「後面再補權限」的錯誤做法

    3. Node RAG Pipeline:帶權限的混合檢索 + 重排序

    import { Pool } from 'pg';
    import { getEmbedding } from './embeddingClient'; // 呼叫 Python 或直接用 Node 模型
    
    const pool = new Pool({ /* db config */ });
    
    interface UserContext {
      tenantId: string;
      roles: string[];
    }
    
    export async function ragAnswer(query: string, user: UserContext) {
      const embedding = await getEmbedding(query); // 返回 Float32Array 長度 768
    
      // 1. 帶 ACL 的向量檢索
      const vectorSql = `
        SELECT id, content, doc_id, section_id, source_system,
               1 - (embedding <=> $1::vector) AS score
        FROM kb_chunks
        WHERE tenant_id = $2
          AND acl_roles && $3::text[]
        ORDER BY embedding <-> $1::vector
        LIMIT 50;
      `;
    
      const vectorRes = await pool.query(vectorSql, [embedding, user.tenantId, user.roles]);
    
      // 2. 這裡可以加 BM25 / tsquery 做 keyword 初篩(略)
    
      // 3. 用 reranker 模型重排序(虛擬碼)
      const reranked = await rerank(query, vectorRes.rows.map(r => r.content));
      const topContexts = reranked.slice(0, 5).map(r => r.content);
    
      // 4. 組 prompt 給 LLM
      const prompt = `你是公司內部助理,回答必須只根據提供的內容。
    
    [檢索到的內容]
    ${topContexts.join('\n---\n')}
    
    [問題]
    ${query}
    
    請根據上面內容回答,若資料不足請明確說「目前知識庫沒有相關資訊」。`;
    
      const answer = await callLLM(prompt); // 例如 OpenAI / 本地 LLM
    
      return {
        answer,
        contexts: topContexts,
        debug: {
          retrievedCount: vectorRes.rowCount,
          tenantId: user.tenantId,
        },
      };
    }
    

    關鍵 API / 參數:

    • embedding <-> $1::vector:pgvector 距離運算,建議用 L2 或 cosine
    • acl_roles && $3::text[]:在檢索階段就做 ACL filter(pre-retrieval)
    • LLM prompt 強制「無資料要明說」,降低幻覺

    4. 簡單線上評估與監控

    可以加一個中介層紀錄:

    await logMetrics({
      tenantId: user.tenantId,
      query,
      latencyMs,
      retrievedCount: vectorRes.rowCount,
      model: 'bge-base-en',
      llmModel: 'gpt-4o',
    });
    

    後續離線跑:

    • 對一批標註問題跑 RAG,請 judge LLM 給出 correctness score(1–5)
    • 比較不同 embedding / chunking / rerank 策略的分數與延遲,做 A/B 測試

    建議與注意事項

    1. 幻覺依然存在:RAG 不是「關幻覺開關」

    • 即使檢索正確,LLM 仍可能「補細節」或「推理過頭」
    • 解法:
    • 明確在 prompt 中說:「不在 context 裡的資訊一律不要編造」
    • 在輸出層加 rule-based 檢查(如法律/財務答案一定要附來源文件 ID)

    2. 檢索結果不穩定:embedding / chunking / rerank 三者缺一不可

    • 換 embedding 模型時,一定要重新做離線 benchmark,不要只看 demo 感覺
    • chunking 調整需同時看:
    • context recall(有沒有檢索到正確文件)
    • latency(chunk 變多會拖慢向量檢索)

    💡 關鍵: 每次調整 embedding 或 chunking,都要用標註資料評估「召回率 + 延遲」,而不是只憑主觀 demo 感受做決策。


    3. 權限洩漏:不要相信「應用層自己會控」

    • RBAC 必須深入到向量庫 query 層
    • 尤其是把 Slack / GDrive / Jira 接在一起作企業 search 時:
    • 預設策略是「拒絕」,只對明確授權內容建索引
    • 建議對敏感資料(legal / M&A 文件)做 單獨 collection / database 隔離

    4. 迭代路線:從 PoC 到生產級

    1. PoC 階段:單租戶、簡單 chunking、只向量檢索
    2. Beta 階段:加 metadata schema、權限 filter、簡單監控
    3. 生產階段:
    4. Hybrid search(BM25 + 向量)
    5. reranker 模型
    6. 線上指標 + 離線 benchmark(answer correctness / context recall / latency)
    7. 權限審計與合規(log 每次檢索的 doc_id 與 user_id)

    核心結論:企業級 RAG 的關鍵不在「模型選哪個」,而在於:檢索架構、權限設計與可評估性是否工程化落地。只要這三件事做穩,模型與向量庫都可以迭代替換,而整個系統仍保持穩定、可回溯、可持續優化。


    🚀 你現在可以做的事

    • 在現有 Postgres 專案中安裝 pgvector,建立含 tenant_id 與 acl_roles 的 kb_chunks 表
    • 準備一批「問題 + 標準答案文件」pair,離線跑一次 context recall/latency benchmark
    • 將現有 RAG 應用的權限邏輯下沉到向量庫查詢層,加入 tenant_id + ACL 的 pre-retrieval filter
  • 把縮小版網路塞進你筆電:LLMSearchIndex 實戰

    把縮小版網路塞進你筆電:LLMSearchIndex 實戰

    📌 本文重點

    • 2 億頁壓成約 2GB 的「縮小版網際網路」可離線搜尋
    • 純本地檢索搭配任意 LLM,輕鬆組出 RAG 流程
    • 特別適合高隱私、內網環境與成本敏感的 RAG 應用

    用一句話定位:LLMSearchIndex 就是把「壓縮過的縮小版網際網路」塞進你筆電,讓你在本機就能做全網級搜尋,再拿結果丟給任何 LLM 做 RAG,完全不用再付搜尋 API 費。

    原始專案介紹可看 Reddit:https://www.reddit.com/r/LocalLLaMA/comments/1t3hokh/llmsearchindex_an_open_source_local_web_search/


    核心功能:一台筆電裝下一個「可離線的 Google 替身」

    1. 2 億頁壓縮索引,約 2GB 就能跑

    LLMSearchIndex 預先把網頁爬好、清洗、壓縮成自訂索引格式,涵蓋 FineWeb、維基百科等資料,超過 2 億頁內容壓進約 2GB 檔案。

    💡 關鍵: 把原本動輒數 TB 的網頁內容壓成約 2GB,使全網級搜尋第一次可以在一般筆電本機完成。

    你可以做的事:

    • 把它想成「只存文字精華的迷你網際網路」
    • 在任何一台 8GB RAM 以上的筆電或桌機上運行,不用伺服器
    • 直接拿來當你自建 RAG 系統的「泛網背景知識來源」,不用自己寫爬蟲 + 建索引

    2. 純本地檢索,不靠外部搜尋 API

    LLMSearchIndex 是一個 Python 函式庫,檢索完全在本機完成:

    • 不依賴 Google、Brave、Bing API
    • 不需要額外布署 SearXNG 這種 meta search
    • 問題 → 本機索引 → 回傳相關片段(含來源網址)

    實際效果:只要你還在用本地 LLM(如 Ollama、llama.cpp)或雲端 LLM(OpenAI、Claude 等),檢索這一段可完全脫離網路與付費 API,對公司內網環境或隱私要求嚴格的團隊特別實用。

    💡 關鍵: 把「搜尋這一步」完全搬到本地,不只省掉搜尋 API 成本,也避免把查詢內容外送到第三方服務。

    3. Python API + 任意 LLM,快速組出 RAG 流程

    LLMSearchIndex 的設計就是為 RAG 用:

    • 輸入:自然語言 query
    • 輸出:N 個相關片段(帶文字與 URL),可直接拼進 LLM 的系統提示或 context
    • 不綁特定模型,你可以串:
    • 本地模型(Ollama、vLLM、Kobold、LM Studio…)
    • 雲端模型(OpenAI、Anthropic、Gemini、Groq…)

    典型 workflow:

    1. 使用者問問題
    2. 用 LLMSearchIndex 搜索全網索引,取前 5–10 個片段
    3. 把片段整理成「context」
    4. 丟給 LLM 生成回答

    這整套,你可以在一支 Python 檔內完成。


    適合誰用:三種典型場景

    1. 公司內部知識問答:先查內網,再查「縮小版全網」

    情境:你有一個內部知識庫(Notion、Confluence、PDF…),已經做了 RAG,但常遇到:

    • 文件沒寫清楚,需要補充產業背景
    • 客戶問題牽涉到外部規範、標準、技術細節

    做法:

    1. 先用公司內部向量庫檢索(例如 Chroma、Qdrant、Weaviate)
    2. 若分數不夠高或結果太少,再用 LLMSearchIndex 查一次「全網索引」
    3. 把「內網內容 + 全網片段」一起餵給 LLM

    好處:

    • 內網問題走本地知識(更準、更貼合公司語境)
    • 外部背景靠本地全網索引補足,不用再打搜尋 API

    2. 研究人員做主題深度檢索

    情境:你是研究員 / 資深工程師,常需要:

    • 快速掃描一個新主題的相關文章
    • 找技術名詞、標準、實作細節的來源

    做法:

    • 用 LLMSearchIndex 做多輪查詢,像這樣:
    • 「LLM 推理最佳化 quantization 技術」
    • 「vLLM streaming serving 實作」
    • 「RAG selective retrieval cost optimization」
    • 把回來的片段整理成資料集,再讓 LLM 幫你摘要、對比觀點、拉時間線

    你得到的是:一套可重複的「本機文獻預篩管線」,比手動 Google → 開一堆分頁 → Copy/Paste 省力很多,也更隱私。

    3. 離線 / 高隱私環境下的「像 Google 一樣」輔助搜尋

    情境:

    • 政府、醫療、金融等內網環境不允許對外連線
    • 你只被允許「把工具帶進來」,不能讓資料出去

    做法:

    • 先在可上網環境下載索引檔與程式碼
    • 帶進封閉網路內安裝
    • 之後所有搜尋與 RAG 都在本機完成

    搭配 Selective RAG(參考 Silicon Protocol 思路):

    • 只有在「本地內網文件」不足以回答時,才啟動 LLMSearchIndex 檢索
    • 把返回片段壓縮(摘要、抽 key points),控制 context 在 3–4 萬 token,以節省 LLM 成本

    💡 關鍵: 用 Selective RAG 控制 context 在 3–4 萬 token 內,可以在維持回答品質的同時大幅壓低 LLM 推理成本。

    參考文章:


    怎麼開始:從 pip 到最小可用 RAG 範例

    以下程式碼是假想 API 介面,目的是讓你知道「整體長什麼樣」,實作時請以實際專案 README 為主。

    步驟 1:安裝與下載索引

    # 1. 安裝套件
    pip install llmsearchindex
    
    # 2. 下載預先建好的 2GB 索引
    llmsearchindex download --dataset fineweb-wikipedia
    # 或依 README 指示,選擇其他索引來源
    

    行動重點:確保你有至少 5GB 以上的剩餘磁碟空間與穩定網路,這一步可能會跑一陣子,但只需做一次。

    步驟 2:在 Python 裡發一個最簡單的 query

    from llmsearchindex import LLMSearchIndex
    
    # 載入索引(第一次載入會較慢,之後可快取)
    index = LLMSearchIndex("./indexes/fineweb_wiki.idx")
    
    # 發出一個查詢
    results = index.search(
        query="什麼是 Selective RAG,怎麼降低 LLM context 成本?",
        top_k=5
    )
    
    for i, r in enumerate(results, 1):
        print(f"[{i}] score={r.score:.3f}\nURL={r.url}\nSnippet={r.text[:200]}...\n")
    

    行動重點:

    • 改成你的問題跑一次
    • 看回傳的文字和 URL,確認內容大致合理

    步驟 3:把檢索結果接到任意 LLM(本地或雲端)

    以下以 OpenAI API 為例,你可以換成任何 LLM SDK:

    import os
    from openai import OpenAI
    from llmsearchindex import LLMSearchIndex
    
    client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
    index = LLMSearchIndex("./indexes/fineweb_wiki.idx")
    
    question = "請用中文說明 Agentic RAG 與傳統 RAG 的差異,並舉一個應用例子。"
    
    # 1) 先檢索
    hits = index.search(question, top_k=5)
    
    context_blocks = []
    for h in hits:
        context_blocks.append(f"來源:{h.url}\n內容:{h.text}")
    
    context = "\n\n".join(context_blocks)
    
    # 2) 再把 context 丟給 LLM
    prompt = f"""你是一位技術寫作者。
    根據以下資料回答使用者問題,回答要有條列與具體例子。
    
    【檢索到的資料】
    {context}
    
    【使用者問題】
    {question}
    """
    
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[{"role": "user", "content": prompt}]
    )
    
    print(resp.choices[0].message.content)
    

    行動重點:

    • 把 model 改成你實際在用的模型
    • 若是本地模型(例如 Ollama),只需把「呼叫 OpenAI」那段換成對本地 API 的 HTTP POST

    步驟 4:加一點「Selective / Agentic RAG」邏輯

    目標:控制什麼時候查本機內網知識、什麼時候查全網索引,並讓 LLM 自己做選擇。

    下面是一個可直接複製的「最小工作流」範例(假設你已有 search_internal() 可查公司文件):

    def answer_question(question: str):
        """最小 Agentic + Selective RAG 工作流示意"""
        # 1) 先查內部知識庫
        internal_docs = search_internal(question, top_k=5)
    
        # 2) 請 LLM 判斷要不要額外查全網
        judge_prompt = f"""你是一個檢索決策助手。
        使用者問題:{question}
        下面是內部文件的部份內容,如果已足夠回答,就回答 NO;
        如果明顯需要外部背景知識,回答 YES。
    
        內部文件摘要:
        {internal_docs[:4000]}
    
        只回答 YES 或 NO。"""
    
        judge = client.chat.completions.create(
            model="gpt-4.1-mini",
            messages=[{"role": "user", "content": judge_prompt}],
            max_tokens=2
        ).choices[0].message.content.strip()
    
        web_context = ""
        if judge == "YES":
            web_hits = index.search(question, top_k=5)
            web_context = "\n\n".join(h.text for h in web_hits)
    
        # 3) 最終回答,Selective RAG:只注入必要的 context
        final_prompt = f"""根據以下資料,用清楚的條列方式回答問題。
    
        【內部文件】
        {internal_docs}
    
        【外部網路資料】
        {web_context}
    
        問題:{question}
        """
    
        ans = client.chat.completions.create(
            model="gpt-4.1-mini",
            messages=[{"role": "user", "content": final_prompt}]
        )
        return ans.choices[0].message.content
    

    這段做了幾件關鍵事:

    • 先用內部文件回答,避免 context 過大
    • 只在 LLM 判斷「需要外部背景」時才查 LLMSearchIndex → Selective RAG
    • 讓「要不要查外網」變成 LLM 可控制的動作 → Agentic RAG 思路

    你可以把這段包成 API,直接給前端 chat UI 使用,實際上就完成了一個「有公司腦、有縮小版全網腦」的混合助理。


    小結:什麼時候值得把 LLMSearchIndex 裝進你電腦?

    如果你符合以下任一條件,很值得試:

    • 不想再為 Brave / Bing / 其他 Web Search API 付費
    • 公司內網不能直連外網,但又需要一般網路知識
    • 已經有 RAG,但缺一層泛網背景,常被卡在「文件沒寫但網路上早就有答案」

    先從:

    1. pip install + 下載索引
    2. 跑一次簡單 query
    3. 用上面最小工作流範例接到你的 LLM

    開始把「縮小版網際網路」塞進你的 RAG pipeline 裡,用一台筆電就做出接近全網搜尋體驗的助理。

    🚀 你現在可以做的事

    • 打開 README,實際執行 pip install llmsearchindex 並下載一個索引檔
    • 改寫文中的 Python 範例,把 query 換成你真實工作會問的問題跑一次
    • 把「步驟 4」的 answer_question() 包成一個簡單 API,接到現有的內網 chat UI 做小規模試用
  • 實戰 Agentic RAG 與 Hybrid Search

    實戰 Agentic RAG 與 Hybrid Search

    📌 本文重點

    • 單一檢索策略讓 RAG 在真實場景很容易翻車
    • Hybrid Search 能互補向量與關鍵字的盲點
    • 讓 Agent 負責檢索策略與多輪重試能顯著提升穩定度
    • 不換模型也能透過 eval、Hybrid 與權限控管大幅升級 RAG

    在實際專案裡,多數 RAG 翻車不是因為模型不夠聰明,而是檢索策略太單一:只用向量會被專有名詞和代碼玩死,只用關鍵字又抓不到語義相近的長文件內容。Agentic RAG + Hybrid Search 的組合,重點就是讓「檢索」變成可調度、可重試、可觀測的一級公民,而不是一個寫死的 search(query) 函式。


    重點說明

    1. 為什麼單一檢索在真實專案會翻車?

    常見四種翻車場景:

    1. 長文件 / 手冊
    2. 只用向量:整份手冊被切成很多 chunk,語義太接近,top-k 都很像,但真正要的那一段不一定排前面。
    3. 只用 BM25:查詢句子太口語,關鍵字重疊度不高,直接 miss。

    4. 專有名詞 / 法規條文 / 內部代號

    5. 向量模型常常把 DS-104、DS-140 當成類似,專案實際上兩者完全不同。
    6. 法規編號、API 名稱、Ticket ID 等,關鍵字檢索反而更穩。

    7. 程式碼、表格、錯誤訊息

    8. 向量對縮排、符號、stack trace 的敏感度很差。
    9. Log ID 或錯誤碼這類「硬字串」,BM25/關鍵字幾乎是必要條件。

    10. 跨語言 / 口語查詢

    11. 使用者用自然語言描述問題,文件是正式用語或英文,公司內還混雜縮寫。
    12. 需要先用 LLM 做 query 改寫,再讓向量與 BM25 各自發揮。

    Hybrid Search(向量 + BM25) 的實際好處:

    • 可以 補各自的盲點:專有名詞用 BM25 鎖定,模糊描述用向量補齊。
    • 可以針對不同類型文件設定 權重策略(例如法規 > 內部 wiki > Slack 摘要)。
    • 可以後面用 rerank 模型 做第二次排序,穩定提升回答可靠度。

    💡 關鍵: 單一檢索在長文件與專有名詞場景很容易漏抓關鍵內容,Hybrid Search 能同時顧到語義相似與精確字串匹配,明顯降低 RAG 翻車率。


    2. 讓 Agent 負責檢索策略,而不是把檢索寫死

    典型 Agentic RAG 設計:

    • 一個 Orchestrator Agent(對話主控)
    • 多個 retriever 工具:keyword_retriever、vector_retriever、hybrid_retriever、legal_retriever 等

    Agent 的工作不是「自己產生答案」,而是先判斷:

    1. 要用哪種檢索策略?
    2. 查錯誤碼或 ticket:優先 關鍵字 → 再向量精抽
    3. 問概念解釋:優先 向量 → 再用 BM25 找原始定義
    4. 法規/權威階層:改用 分層 retriever(例如每一層級至少取 1–2 筆)

    5. 要不要改寫 Query?

    6. 第一輪命中文件相關度低時,讓 Agent 自動:

      • 摘出關鍵詞
      • 加上同義詞 / 全名(例如:DS → Data Steward)
      • 限縮 domain(例如:限定 product=core-banking)
    7. 多輪重試與合併結果

    8. 第一輪檢索後如果信心不足(例如 top-3 相似度都 < 0.7),
    9. Agent 改寫 query 或更換 retriever,再抓一次,最後合併去重後送入 LLM。

    這樣做的實際好處:

    • 檢索策略可迭代:只要調整工具 / prompt,不必重寫服務架構。
    • 容易在線上 A/B:只換掉 Orchestrator 的 prompt 或 routing 邏輯即可。
    • 可以針對不同客戶 / 部門掛不同的工具組合。

    一個可落地的組合:

    • LLM:OpenAI(gpt-4.1)、Anthropic(claude-3.7)皆可
    • 檢索:
    • Elasticsearch:BM25 + dense vector + hybrid score
    • 或 Weaviate / Qdrant:向量 + keyword filter

    簡化架構:

    User → Orchestrator Agent → (tool calls) →
      - keyword_retriever (Elasticsearch BM25)
      - vector_retriever  (Weaviate / ES dense vector)
      - hybrid_retriever  (ES rank_feature / script_score)
    → merge + dedup + rerank → LLM answer
    

    實作範例

    1. Orchestrator Agent Prompt(決定使用哪個 retriever)

    假設用 OpenAI Assistants API 或自行封裝 tools:

    系統指示(Orchestrator):
    你是一個檢索協調代理,負責從多種檢索器取得最相關的企業知識。
    
    - 若使用者詢問:
      - 錯誤碼、ticket ID、法規條號、API 名稱 → 優先使用 **keyword_retriever**。
      - 抽象概念、最佳實踐、流程說明 → 優先使用 **vector_retriever**。
      - 法律 / 合規問題,且需多層級來源 → 使用 **legal_hybrid_retriever**。
    
    流程:
    1. 先決定要呼叫哪些工具(可以多個)。
    2. 若第一輪檢索結果的「來源數量 < 3」或「相關度評估偏低」,
       - 自行改寫查詢(更精簡、加入關鍵字),再重試一次。
    3. 最終將所有檢索結果去重、排序,回傳給後續回答模型。
    禁止自行編造公司內部資料,所有答案必須可追溯到文件片段。
    

    索引 mapping:

    PUT knowledge_base
    {
      "mappings": {
        "properties": {
          "content": { "type": "text" },
          "content_vec": { "type": "dense_vector", "dims": 1536, "index": true },
          "source_type": { "type": "keyword" },   
          "tenant_id": { "type": "keyword" }
        }
      }
    }
    

    簡化版 hybrid 查詢(BM25 + 向量):

    POST knowledge_base/_search
    {
      "size": 20,
      "query": {
        "script_score": {
          "query": {
            "bool": {
              "must": [
                {"match": {"content": "GDPR data retention"}},
                {"term": {"tenant_id": "acme_corp"}}
              ]
            }
          },
          "script": {
            "source": "0.6 * _score + 0.4 * cosineSimilarity(params.q_vec, 'content_vec')",
            "params": {"q_vec": [/* query embedding */]}
          }
        }
      }
    }
    

    關鍵點:

    • BM25 與向量權重(例子中 0.6 / 0.4)要透過線上 A/B 或離線 eval 調整。
    • tenant_id filter 做多租戶權限隔離,非常重要。

    💡 關鍵: 在同一個查詢裡用 script score 同時結合 BM25 分數與 cosine similarity,能控制兩者權重,調整出最適合自己資料分佈的 Hybrid 策略。


    3. Chunking 與 max context 的工程細節

    基本原則:

    • 以 語義切分(semantic splitting)+ 適度 overlap 為主,而不是死切 512 tokens。
    • 避免 chunk 過長導致:
    • 向量語義太混濁,top-k 噪音變高。
    • LLM context 塞滿 retrieval 噪音,回答變模糊。

    實作骨架(pseudo-code):

    from semantic_splitter import split_semantic
    
    def chunk_doc(text: str):
        sections = split_semantic(text, max_chars=1200)
        chunks = []
        overlap = 150  # 字元級 overlap
        for sec in sections:
            if len(sec) <= 1200:
                chunks.append(sec)
            else:
                # 針對長 section 再做 sliding window
                for i in range(0, len(sec), 1200 - overlap):
                    chunks.append(sec[i:i+1200])
        return chunks
    

    與 max context tokens 的關係:

    • 假設 LLM context 32k,系統 prompt + 對話占 4k,其實留給 RAG 的只有約 28k。
    • 若每個 chunk 約 400 tokens,你實際能塞 約 50–60 個 chunk 就爆,但通常 8–16 個 chunk 就夠,更多只會拉高成本與噪音。

    rerank 與去重:

    • 先取寬一點的 top_k(例如 30–50),再用輕量 rerank(如 bge-reranker)縮到 8–12 個。
    • 去重邏輯可以用:same doc_id + 高度相似 直接只留一個,減少重複內容浪費 context。

    💡 關鍵: 雖然 context 可能有 32k tokens,但實務上只保留約 8–16 個高質量 chunk,通常就能兼顧成本與效果,塞太多反而害答題品質下滑。


    建議與注意事項

    1. 不要只做 embedding,不做 eval

    常見錯誤流程:

    1. 把全部文件 embed → 塞進向量庫 → 上線。
    2. 發現回答怪怪的 → 開始懷疑模型。

    比較健康的流程:

    1. 先準備一組 標記好的 QA/Eval 集(10–50 題也好)。
    2. 對同一組問題,分別跑:
    3. 純 BM25
    4. 純向量
    5. Hybrid + 不同權重
    6. 用簡單指標(hit@k、人工評分)挑一個 baseline,再上線 A/B。

    2. 向量庫維護:重建 / 追加 / 版本化

    • Embedding 模型版本變更 時:
    • 盡量用新 index 重建(kb_v2),舊版保留一段時間做對照。
    • 不要在同一個 index 裡混不同 embedding 模型的向量。
    • 大量文件更新策略:
    • 批次追加新文檔時,要記錄 批次 ID / 資料版本,方便 rollback。
    • 下線文件要標記 is_active=false 或直接 soft delete,避免回答引用過期政策。

    3. 多租戶與權限過濾

    • 在 Elasticsearch / Weaviate 中務必存:tenant_id、visibility、role 等欄位。
    • 檢索 query 層一定要加:
    "filter": [
      {"term": {"tenant_id": "${current_tenant}"}},
      {"terms": {"visibility": ["public", "internal"]}}
    ]
    
    • 不要指望 LLM 自己遵守權限,權限控制一定要在檢索階段完成。

    4. 線上評測與 A/B 驗證

    簡易做法:

    1. 選一組真實高頻 query(客服 ticket、搜尋 log)。
    2. 設計兩條路線:
    3. A:純向量 RAG
    4. B:Agentic RAG + Hybrid Search
    5. 隨機分流流量,收集:
    6. 使用者是否重問 / 追問率
    7. 是否需要人工接手
    8. CSR / domain expert 的 1–5 分主觀評分

    通常在企業知識庫場景,只要加上 Hybrid Search + Agent 重試,就能看到 10–30% 的 query 成功率提升,而且失誤類型會明顯變少(比較少「答錯法規條」、「引用過期政策」)。


    總結:如果你現在的 RAG 還是「單一向量庫 + top-k 塞給 LLM」,要提升穩定性,不一定要換更大的模型,先把 Hybrid Search 與 Agentic 檢索策略補上,通常是成本最低、效果最直接的升級路線。


    🚀 你現在可以做的事

    • 從現有專案中抽出 10–50 則真實 query,分別用純 BM25、純向量與 Hybrid 跑一次,記錄 hit@k 與人工評分
    • 在現有 RAG 服務前面加一個簡單 Orchestrator,把關鍵字與向量檢索拆成兩個 tool,用 prompt 控制選用策略
    • 在搜尋層加入 tenant_id 與 visibility 欄位與 filter,先確保權限過濾正確,再進一步調整 Hybrid 權重與 rerank 策略