標籤: pgvector

  • 從 BM25 到稀疏向量混合檢索打造可靠多語 RAG

    從 BM25 到稀疏向量混合檢索打造可靠多語 RAG

    📌 本文重點

    • 多語場景下單一檢索技術不可靠
    • Sparse + dense 混合檢索能顯著提升召回
    • RRF 等穩健融合策略優於簡單加權
    • 現有「只用 embedding」RAG 可漸進升級

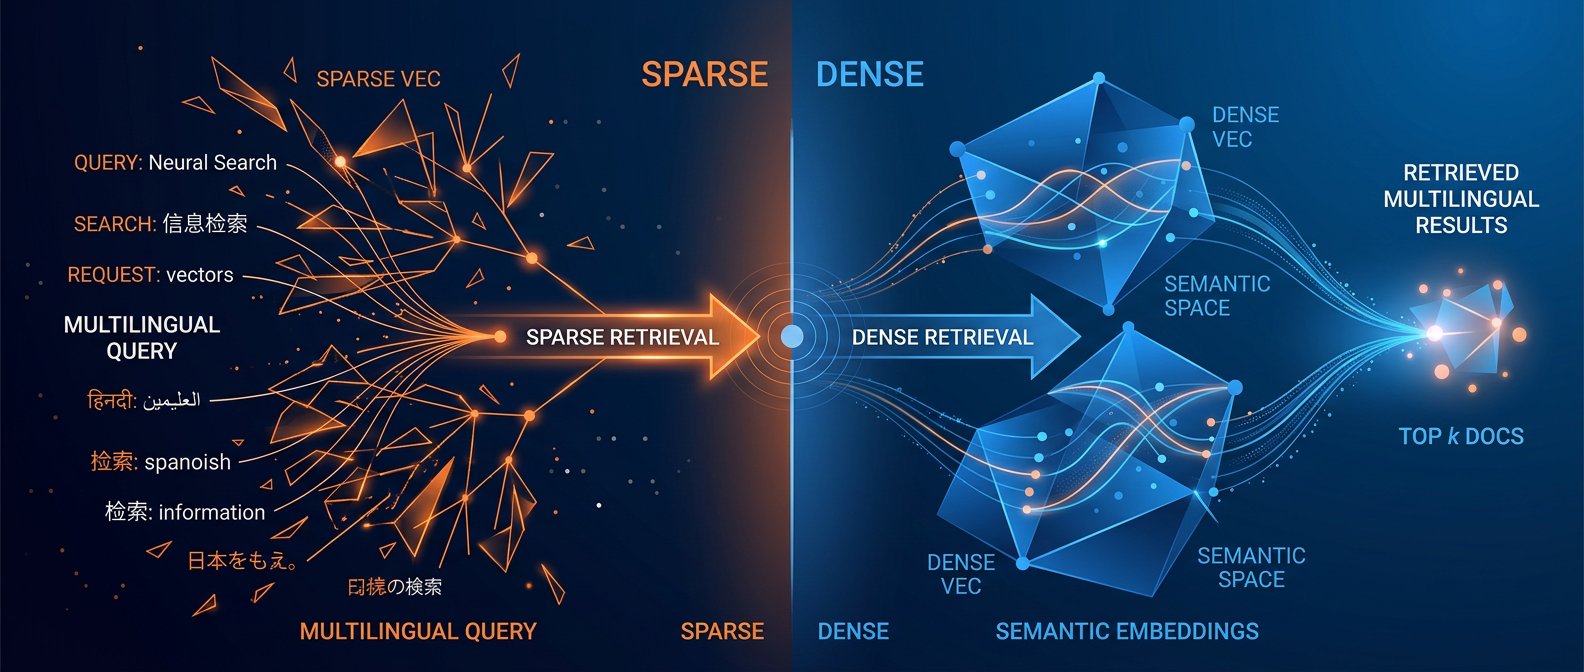
    多語 RAG 最大的痛點,不是模型能力,而是檢索可靠性:民眾怎麼描述需求,和政府怎麼寫方案,永遠長得不一樣。從 MyScheme 這種多語、口語化的政府資料集可以看到,純 BM25 找不到語義相近但字面不同的文件,純 dense embedding 又容易在多語、多拼寫下語義漂移或召回太亂。本文聚焦一件事:如何用 sparse + dense 混合檢索,在現有 RAG 專案裡實際提升 recall,而不是只靠「換一個更大的 embedding 模型」。


    重點說明

    1. 純 BM25 vs 純 dense:多語查詢的失敗模式

    以 MyScheme 的農民補助方案為例,同一個意圖可能長這樣:

    • farmer income support scheme
    • kisan ko har saal paisa milne wali scheme
    • किसानों को हर साल पैसे देने वाली योजना
    • farmer ko 6000 rupees wali yojna

    失敗模式很典型:

    • 純 BM25
    • 英文 query 找到英文文件還行,但遇到混 Hindi/English 的查詢時,停用詞與分詞完全不對齊,得分被噪音稀釋。
    • 政府文件常用「PM-KISAN」「beneficiary」「disbursement」,民眾只說「har saal paisa」「6000 rupees」,詞彙不重疊直接失敗。
    • 純 dense embedding
    • 多語模型雖然能把 Hindi/English 映射到同一語義空間,但口語拼寫、錯字、混寫系統很容易落在 embedding 邊緣,導致相似度偏低。
    • RAG 常見做法是 top-k = 5~10,一旦語義有點偏,整批召回的文件都錯,LLM 再會「瞎補」也救不回來。

    💡 關鍵: 在多語口語查詢下,BM25 容易因詞彙不重疊失效,而 dense 在 top-k = 5~10 時只要稍微語義偏離就會整批召回錯誤文件。

    結論:lexical 是精確但太窄,dense 是寬但容易飄。混合檢索的目標就是用 sparse 捕捉字面線索、用 dense 捕捉語義,再在 ranking 階段做穩健融合。


    2. Sparse + Dense Hybrid 的設計拆解

    混合檢索不是「把兩個分數加起來」這麼簡單,它牽涉到幾個具體設計。

    (1) 索引結構:一個引擎還是兩層系統?

    • 單一引擎模式(適合小團隊):
    • 用 Elasticsearch / OpenSearch 的 BM25 + 稀疏向量(如 SPLADE、ELASTICSPLADE)+ dense 向量三合一索引。
    • 優點:部署簡單、一套 API;缺點:向量能力受限於 ES/OpendSearch 版本,調參空間較小。
    • 兩層模式(適合大型系統):
    • 第一層:search engine 做 sparse(BM25 + sparse vector)coarse recall。
    • 第二層:向量資料庫(PGVector / Qdrant)做 dense rerank / 精細相似度計算。
    • 可在第二層加上 cross-encoder reranker 或 LLM-based re-ranking。

    (2) 查詢改寫與 normalization

    多語、多拼寫下,query preprocessing 本身就是一個模組:

    1. 語言偵測:
    2. 使用 fastText / CLD3 或 LLM 自帶的語言偵測,標記 query 語言。
    3. Normalization:
    4. script normalization:全形/半形、Devanagari vs Latin transliteration。
    5. lowercasing、去除標點與顯而易見的 noise。
    6. 多語 query 擴展(選配):
    7. 將 Hindi query 透過 LLM 翻成英文:किसानों को हर साल पैसे देने वाली योजना -> farmer yearly income support scheme,兩個版本都丟進檢索。

    實務上,一個簡單但有效的策略是:統一把查詢轉成英文+原語言兩個 view,分別檢索,再在 ranking 層融合。

    (3) Score Fusion / RRF:怎麼「穩健」地合併分數

    常見幾種做法:

    • 線性加權(BM25_score * α + dense_score * β + sparse_score * γ):
    • 問題:不同分數尺度差很大、對參數敏感,容易在某些 query 下完全偏向單一來源。
    • Reciprocal Rank Fusion(RRF):
    • 每個檢索器給一個排序,對某文件的融合分數是:

    [
    RRF(d) = \sum_{s \in \text{sources}} \frac{1}{k + rank_s(d)}
    ]

    • k 為平滑常數(常用 k=60),不用調很多權重,對不同 query 分布也比較穩。

    💡 關鍵: 使用 RRF 搭配 k=60 能在多種檢索來源之間提供穩健且低參數敏感度的排序融合。

    對多語 RAG,我會優先選 RRF 作為第一版融合策略,然後再針對特定語言或場景加權調整。


    實作範例

    以下用一個簡化架構示範:

    • OpenSearch:BM25 + sparse vector(透過插件或內建向量)做第一層 hybrid search。
    • Qdrant:dense embedding 的向量查詢與 rerank。

    1. OpenSearch 索引設定:文件 + 稀疏/密集向量

    PUT myscheme-schemes
    {
      "settings": {
        "analysis": {
          "analyzer": {
            "multilingual_analyzer": {
              "type": "custom",
              "tokenizer": "standard",
              "filter": ["lowercase", "stop_multilingual"]
            }
          },
          "filter": {
            "stop_multilingual": {
              "type": "stop",
              "stopwords": ["_english_", "_hindi_"]
            }
          }
        }
      },
      "mappings": {
        "properties": {
          "title": {
            "type": "text",
            "analyzer": "multilingual_analyzer"
          },
          "description": {
            "type": "text",
            "analyzer": "multilingual_analyzer"
          },
          "sparse_vector": {
            "type": "rank_features"
          },
          "dense_vector": {
            "type": "dense_vector",
            "dims": 768,
            "index": true,
            "similarity": "cosine"
          }
        }
      }
    }
    

    說明:

    • multilingual_analyzer 同時掛載英文和印地語 stopwords,但要注意不要過 aggressive(後面會講坑)。
    • sparse_vector 可以存像 SPLADE 這種模型產出的 token->weight,透過 rank_features 來用 BM25-like scoring。
    • dense_vector 用預先算好的多語 embedding,例如 Jina Embeddings / LaBSE / m3e。

    2. 查詢流程:先 ES hybrid,再 Qdrant rerank

    伪程式碼:

    def search_myscheme(query: str):
        lang = detect_language(query)  # fastText / LLM
        norm_query = normalize_query(query, lang)
    
        # 1. 產生 sparse + dense 查詢向量
        sparse_q = splade_encode(norm_query)   # 稀疏向量:token->weight
        dense_q = embed_multilingual(norm_query)  # 768-d 向量
    
        # 2. 在 OpenSearch 做 hybrid search
        es_res = es.search(
            index="myscheme-schemes",
            body={
                "size": 50,
                "query": {
                    "bool": {
                        "should": [
                            {"match": {"description": norm_query}},
                            {"rank_feature": {"field": "sparse_vector", "boost": 2}},
                            {
                              "script_score": {
                                "query": {"match_all": {}},
                                "script": {
                                  "source": "cosineSimilarity(params.query_vector, 'dense_vector') + 1.0",
                                  "params": {"query_vector": dense_q}
                                }
                              }
                            }
                        ]
                    }
                }
            }
        )
    
        # 3. 把 top-50 丟進 Qdrant 用 dense similarity 做 rerank
        points = [
            {"id": doc["_id"], "vector": doc["_source"]["dense_vector"]}
            for doc in es_res["hits"]["hits"]
        ]
    
        qdrant_res = qdrant.search(
            collection_name="myscheme_schemes",
            query_vector=dense_q,
            search_params={"hnsw_ef": 128},
            limit=10,
            # 可以在這邊實作 RRF 或線性融合
        )
    
        return qdrant_res
    

    如果想在單一 OpenSearch 裡就做 RRF,可以改成兩個子查詢各自出 top-k,再用 client 端做 RRF 合併。


    3. 在現有「只用 embedding」的 RAG 上漸進式升級

    典型現有流程:

    # 既有做法
    vec = embed(query)
    results = vector_db.search(vec, top_k=10)
    context = build_context(results)
    answer = llm.generate(prompt_with(context, query))
    

    漸進式升級建議:

    1. 第一步:加入 BM25 coarse recall
    2. 把 query 同時丟到 search engine:
      python
      bm25_results = es_bm25_search(query, top_k=50)
      dense_results = vector_db.search(embed(query), top_k=30)
      fused = rrf_fusion(bm25_results, dense_results, k=60)
    3. 第二步:換 dense 為 multilingual + 加入 sparse
    4. 把原本英語 embedding 換成多語模型,再用 sparse 模型(SPLADE)重建索引。
    5. 第三步:加入語言偵測與 normalization
    6. 先實作簡單版:detect → normalize(lowercase+簡單清洗)→ bilingual query expansion。

    💡 關鍵: 將現有「只用 embedding」流程按步驟加入 BM25、sparse 向量與語言偵測,可以在不重寫架構的情況下逐步提升召回與穩定度。

    每一步都要搭配線上或離線評估,避免「看起來很厲害但實際沒有變好」。


    建議與注意事項

    1. 多語 stopwords 與錯誤分詞

    • 坑 1:停用詞把關鍵字吃掉
    • 多語 stopwords 列表往往過於粗糙,像 Hindi 裡有些詞在政府文本是關鍵字,在口語查詢卻被錯當停用詞。
    • 建議先用 統計 + 標註樣本檢查停用詞對召回的影響,必要時為特定欄位(如 title)使用較少的停用詞。

    • 坑 2:錯誤分詞導致 BM25 完全失效

    • 非空白分隔語言(中文、某些印度語)如果切錯字,BM25 的詞頻意義直接失真。
    • 解法:用 適語言分詞器(jieba、HanLP、Indic NLP),或在部分欄位改用 n-gram 分詞降低風險。

    2. 長文本切片策略:token 限制下如何不破壞語義

    混合檢索遇到長文件(例如政策全文)時,常見坑是:

    • chunk 切太細,BM25 還能找得到,但 dense embedding 像是記憶碎片,語義不完整。
    • chunk 切太粗,dense 相似度還好,但 BM25 命中的字詞被大量無關文本稀釋,排序變差。

    建議策略:

    • 以 語段(paragraph)或條款為單位切片,長度控制在 200–400 tokens。
    • 每個 chunk 保留 標題 / 小節名,讓 lexical 的命中不只在正文。
    • 如果有政策層級結構,建立 hierarchical RAG:先檢索 policy,再在 policy 下檢索條款。

    3. 標註與線上 A/B:怎麼確認 recall 真的變好

    不要只看「LLM 回答看起來比較合理」,要量化:

    1. 離線標註:
    2. 從真實 query(或合成 query)抽樣,為每個 query 標註「有用的文件 ID」。
    3. 比較純 BM25、純 dense、hybrid 在 top-k 的 Recall@k / MRR / nDCG。

    4. 線上 A/B:

    5. 對真實使用者流量,隨機分流到 dense-only vs hybrid pipeline。
    6. 收集:
      • 使用者是否點選推薦方案。
      • 是否更快完成查詢(減少反覆搜尋)。
    7. 避免只用主觀「好像比較好」,用行為指標判斷。

    4. 架構選型:小團隊 vs 大型系統

    • 小團隊 / MVP 階段:
    • 優先選一個支援向量的 search engine(OpenSearch + k-NN plugin / Elasticsearch + vector)。
    • 提示重點:一個 index 同時存 text + sparse + dense,client 端做 RRF fusion 就足夠支撐絕大部分 RAG 應用。

    • 大型系統 / 高流量服務:

    • 分層:
      • Tier 1:search engine 做 BM25 + sparse coarse recall(top-100~200)。
      • Tier 2:向量資料庫(PGVector / Qdrant / Milvus)做 dense rerank + optional cross-encoder。
    • 好處:
      • 可以針對不同語言、資料域調不同策略,如 Hindi 專用索引、英語專用索引再做 union。
      • 資源隔離:檢索與 rerank 分別 scale。

    核心結論:在多語、口語化場景下,單一檢索技術不夠可靠。把 BM25、稀疏向量和密集向量結合,搭配語言偵測與穩健的 score fusion(如 RRF),可以在不大改現有 RAG 架構的前提下,顯著提升查詢召回與答案穩定度。對已經在用「只用 embedding」的專案來說,這是一條可漸進落地的技術升級路線,而不是重寫整套系統。


    🚀 你現在可以做的事

    • 在現有 RAG 專案中加入一個 BM25 搜尋來源,並用 RRF(k=60) 與 dense 結果融合測試效果
    • 選定一個多語 embedding 模型(如 LaBSE 或 m3e),為核心資料集建立 dense_vector 欄位
    • 抽樣實際使用者查詢,標註「關鍵文件 ID」,離線比較 dense-only 與 hybrid pipeline 的 Recall@k
  • 企業級 RAG 實戰架構與評估全攻略

    企業級 RAG 實戰架構與評估全攻略

    📌 本文重點

    • 企業級 RAG 關鍵在檢索架構與權限設計
    • 混合檢索 + 重排序是實務標配
    • metadata/ACL 必須在檢索前就生效
    • 評估指標需同時涵蓋正確性與延遲

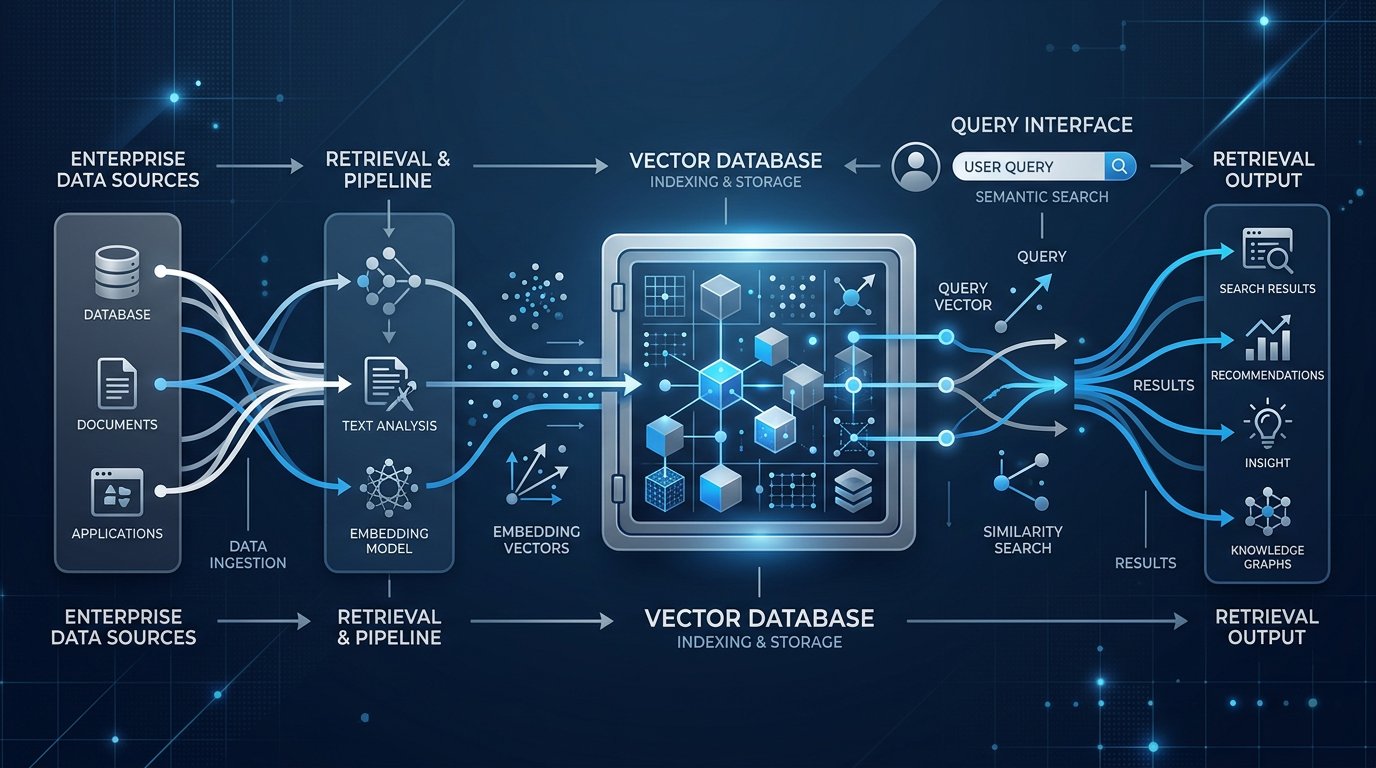
    在企業環境裡,RAG 的真正價值是:讓 LLM 能安全地用內部最新知識、可控地減少幻覺、並可以用工程方法迭代優化。本文從工程視角拆解:向量資料庫選型、檢索策略、chunking 與 metadata 設計、多租戶與權限控制、線上/離線評估指標,以及常見坑與解法。


    重點說明

    1. 檢索策略:不只向量,BM25 + 重排序才是實務標配

    企業知識庫多來源、多格式,單純向量檢索很容易 miss 關鍵字或出現語義偏移。建議:

    1. 混合檢索(Hybrid Search):
    2. 先用 BM25 或全文搜尋(Postgres tsvector、Elasticsearch、OpenSearch)做初篩
    3. 再用向量相似度做語義排序,避免只靠 embedding 導致關鍵領域術語被忽略

    4. 重排序(Rerank):

    5. 對 top-50 結果使用 cross-encoder / reranker 模型重新排序(如 bge-reranker-large)
    6. 好處:在不放大向量庫負載的情況下,顯著提升 answer correctness

    💡 關鍵: 透過「先 BM25 初篩、再向量排序、最後 rerank」三段式檢索,可以在不犧牲效能的前提下,大幅提升答案正確率與穩定性。

    實務上你可以:

    • 用 pgvector 存 embedding + Postgres 原生全文檢索
    • 或用 Milvus 做向量檢索,搭配獨立搜尋服務(Elastic / OpenSearch)做 BM25

    2. Chunking 與 Metadata:為檢索設計,而不是為分段而分段

    錯誤的 chunking 會直接降低 context recall,企業常見問題是「段太小、沒有結構」。建議:

    1. 混合策略 chunking:
    2. 先以語義斷點(標題、小節)切大塊,再用字數/token 限制微調
    3. 典型配置:512–1024 tokens + 128–256 tokens overlap

    4. metadata schema 是檢索與權限的核心:至少包含:

    5. tenant_id: 多租戶隔離
    6. doc_id, section_id: 追蹤來源與回溯
    7. source_system: Slack / GDrive / Confluence / Jira…
    8. visibility_tags / acl: 權限控制(角色、群組、文件 owner)

    好處:

    • chunk 不只是「段落」,而是帶有權限、業務上下文的最小檢索單位
    • 評估失敗案例時可以精準定位是哪個 chunk / doc 出問題

    3. 多租戶與權限:在「檢索前」把不該看的東西砍掉

    語義向量檢索會天然繞過傳統 RBAC 的關鍵字邊界,必須在檢索前加上身分綁定的 filter:

    • Identity-bound pre-retrieval filters:查詢向量庫前,先用 tenant_id + ACL 建立 filter
    • 所有檢索 API 都要支援條件:WHERE tenant_id = $tenant AND acl @> $user_roles

    關鍵結論:

    • 權限控制不能只做在「生成後」,因為一旦檢索到不該看的 context,就算你遮罩輸出,也已經有資料洩漏風險
    • 向量庫層一定要有 硬隔離策略(租戶切庫 / 切 collection / 至少切 partition)

    💡 關鍵: 權限過濾一定要在向量檢索「之前」就生效,否則只在輸出層遮罩,其實已經完成資料洩漏。


    4. 評估與監控:不只看 BLEU,更要看「能不能在生產上 debug」

    建議至少三類指標:

    1. Answer Correctness(生成品質)
    2. LLM 自評(使用 judge model)、人工標註小樣本、或用 rule-based 準確率

    3. Context Recall(檢索品質)

    4. 離線 benchmark:準備一組「問題 + 標準文件」pair,測量 top-k 是否包含正確文件

    5. Latency(服務體驗)

    6. 分段量測:檢索延遲、重排序延遲、LLM 生成延遲

    好處:

    • 可以清楚區分是檢索出錯、權限漏控,還是 LLM 幻覺
    • 為迭代(換 embedding 模型、調 chunking、調 rerank)提供可量化目標

    實作範例:Node + pgvector + 開源 embedding 的簡單企業知識庫

    下面用一個簡化的架構示範:

    • 向量庫:Postgres + pgvector
    • Embedding 模型:BAAI/bge-base-en(你可以換成中文模型)
    • 後端:Node.js (TypeScript)

    1. 資料庫 schema 設計

    -- pgvector 安裝後,建立知識庫表
    CREATE TABLE kb_chunks (
      id             BIGSERIAL PRIMARY KEY,
      tenant_id      TEXT NOT NULL,
      doc_id         TEXT NOT NULL,
      section_id     TEXT,
      source_system  TEXT NOT NULL,
      content        TEXT NOT NULL,
      embedding      VECTOR(768) NOT NULL,
      visibility_tags TEXT[], -- e.g. ['legal', 'finance']
      acl_roles      TEXT[],  -- e.g. ['legal_team', 'admin']
      created_at     TIMESTAMP DEFAULT NOW()
    );
    
    CREATE INDEX idx_kb_chunks_tenant ON kb_chunks (tenant_id);
    CREATE INDEX idx_kb_chunks_acl_roles ON kb_chunks USING GIN (acl_roles);
    CREATE INDEX idx_kb_chunks_visibility_tags ON kb_chunks USING GIN (visibility_tags);
    CREATE INDEX idx_kb_chunks_embedding ON kb_chunks USING ivfflat (embedding vector_l2_ops) WITH (lists = 100);
    

    重點:

    • 用 ivfflat + lists 調優檢索速度
    • 用 acl_roles / visibility_tags 作為 pre-retrieval filter 的基礎

    2. Chunking 與寫入管線(Python 伺服端工具)

    from transformers import AutoTokenizer, AutoModel
    import psycopg2
    
    MODEL_NAME = "BAAI/bge-base-en"
    MAX_TOKENS = 800
    OVERLAP = 200
    
    # 省略連線與模型初始化
    
    def chunk_document(text: str, tenant_id: str, doc_id: str, source_system: str, acl_roles: list[str]):
        tokens = tokenizer.encode(text)
        chunks = []
        start = 0
        while start < len(tokens):
            end = min(start + MAX_TOKENS, len(tokens))
            chunk_tokens = tokens[start:end]
            chunk_text = tokenizer.decode(chunk_tokens)
            chunks.append(chunk_text)
            start += MAX_TOKENS - OVERLAP
        return chunks
    
    def embed(texts: list[str]):
        # 簡化:batch embedding
        inputs = tokenizer(texts, padding=True, truncation=True, return_tensors="pt")
        with torch.no_grad():
            outputs = model(**inputs)
        embeddings = outputs.last_hidden_state[:, 0, :].cpu().numpy()  # CLS pooling 或改用 mean pooling
        return embeddings
    
    # 寫入 pgvector 的 SQL 略
    

    好處:

    • chunking 有明確 token 參數,可調試
    • metadata 與 ACL 一起寫入,避免「後面再補權限」的錯誤做法

    3. Node RAG Pipeline:帶權限的混合檢索 + 重排序

    import { Pool } from 'pg';
    import { getEmbedding } from './embeddingClient'; // 呼叫 Python 或直接用 Node 模型
    
    const pool = new Pool({ /* db config */ });
    
    interface UserContext {
      tenantId: string;
      roles: string[];
    }
    
    export async function ragAnswer(query: string, user: UserContext) {
      const embedding = await getEmbedding(query); // 返回 Float32Array 長度 768
    
      // 1. 帶 ACL 的向量檢索
      const vectorSql = `
        SELECT id, content, doc_id, section_id, source_system,
               1 - (embedding <=> $1::vector) AS score
        FROM kb_chunks
        WHERE tenant_id = $2
          AND acl_roles && $3::text[]
        ORDER BY embedding <-> $1::vector
        LIMIT 50;
      `;
    
      const vectorRes = await pool.query(vectorSql, [embedding, user.tenantId, user.roles]);
    
      // 2. 這裡可以加 BM25 / tsquery 做 keyword 初篩(略)
    
      // 3. 用 reranker 模型重排序(虛擬碼)
      const reranked = await rerank(query, vectorRes.rows.map(r => r.content));
      const topContexts = reranked.slice(0, 5).map(r => r.content);
    
      // 4. 組 prompt 給 LLM
      const prompt = `你是公司內部助理,回答必須只根據提供的內容。
    
    [檢索到的內容]
    ${topContexts.join('\n---\n')}
    
    [問題]
    ${query}
    
    請根據上面內容回答,若資料不足請明確說「目前知識庫沒有相關資訊」。`;
    
      const answer = await callLLM(prompt); // 例如 OpenAI / 本地 LLM
    
      return {
        answer,
        contexts: topContexts,
        debug: {
          retrievedCount: vectorRes.rowCount,
          tenantId: user.tenantId,
        },
      };
    }
    

    關鍵 API / 參數:

    • embedding <-> $1::vector:pgvector 距離運算,建議用 L2 或 cosine
    • acl_roles && $3::text[]:在檢索階段就做 ACL filter(pre-retrieval)
    • LLM prompt 強制「無資料要明說」,降低幻覺

    4. 簡單線上評估與監控

    可以加一個中介層紀錄:

    await logMetrics({
      tenantId: user.tenantId,
      query,
      latencyMs,
      retrievedCount: vectorRes.rowCount,
      model: 'bge-base-en',
      llmModel: 'gpt-4o',
    });
    

    後續離線跑:

    • 對一批標註問題跑 RAG,請 judge LLM 給出 correctness score(1–5)
    • 比較不同 embedding / chunking / rerank 策略的分數與延遲,做 A/B 測試

    建議與注意事項

    1. 幻覺依然存在:RAG 不是「關幻覺開關」

    • 即使檢索正確,LLM 仍可能「補細節」或「推理過頭」
    • 解法:
    • 明確在 prompt 中說:「不在 context 裡的資訊一律不要編造」
    • 在輸出層加 rule-based 檢查(如法律/財務答案一定要附來源文件 ID)

    2. 檢索結果不穩定:embedding / chunking / rerank 三者缺一不可

    • 換 embedding 模型時,一定要重新做離線 benchmark,不要只看 demo 感覺
    • chunking 調整需同時看:
    • context recall(有沒有檢索到正確文件)
    • latency(chunk 變多會拖慢向量檢索)

    💡 關鍵: 每次調整 embedding 或 chunking,都要用標註資料評估「召回率 + 延遲」,而不是只憑主觀 demo 感受做決策。


    3. 權限洩漏:不要相信「應用層自己會控」

    • RBAC 必須深入到向量庫 query 層
    • 尤其是把 Slack / GDrive / Jira 接在一起作企業 search 時:
    • 預設策略是「拒絕」,只對明確授權內容建索引
    • 建議對敏感資料(legal / M&A 文件)做 單獨 collection / database 隔離

    4. 迭代路線:從 PoC 到生產級

    1. PoC 階段:單租戶、簡單 chunking、只向量檢索
    2. Beta 階段:加 metadata schema、權限 filter、簡單監控
    3. 生產階段:
    4. Hybrid search(BM25 + 向量)
    5. reranker 模型
    6. 線上指標 + 離線 benchmark(answer correctness / context recall / latency)
    7. 權限審計與合規(log 每次檢索的 doc_id 與 user_id)

    核心結論:企業級 RAG 的關鍵不在「模型選哪個」,而在於:檢索架構、權限設計與可評估性是否工程化落地。只要這三件事做穩,模型與向量庫都可以迭代替換,而整個系統仍保持穩定、可回溯、可持續優化。


    🚀 你現在可以做的事

    • 在現有 Postgres 專案中安裝 pgvector,建立含 tenant_id 與 acl_roles 的 kb_chunks 表
    • 準備一批「問題 + 標準答案文件」pair,離線跑一次 context recall/latency benchmark
    • 將現有 RAG 應用的權限邏輯下沉到向量庫查詢層,加入 tenant_id + ACL 的 pre-retrieval filter
  • 語義快取實戰:RAG 成本暴降指南

    語義快取實戰:RAG 成本暴降指南

    📌 本文重點

    • 語義快取可降 20–60% API 成本
    • 僅對「穩定且短」內容做 embedding
    • 加多鍵條件與門檻避免誤命中
    • 做成可監控、有版本的基礎設施

    多數 RAG / chat backend 在做完 模型選型、prompt 調參、retriever 調優 之後,推理帳單還是居高不下,關鍵原因往往是:只做 exact-match cache,幾乎等於沒快取。語義快取(semantic cache)能把「同一個問題的不同說法」視為同一查詢,實務上可以做到 20–60% API call 減少,延遲跟成本一起砍。

    💡 關鍵: 用語義快取把不同說法視為同一查詢,實務上可直接減少約 20–60% 的 API 呼叫與成本。

    下面直接從實作觀點拆解:要怎麼在典型 RAG 架構裡,把語義快取變成一個可上線的「基礎設施」,而不只是一個實驗性 side project。


    重點說明

    1. Exact-match cache vs Semantic cache:差在哪裡?

    典型 chat / RAG backend 的 exact-match cache 會用:

    key   = hash(user_id + model_id + prompt_string)
    value = LLM 回應(與中間狀態)
    

    問題:只要 user 換句話說、加入一句客套話、locale 不同,就完全 miss。

    語義快取改成:

    1. 用 embedding 模型 將「實際送進 LLM 的完整 prompt」轉成向量
    2. 在向量空間做 相似度搜尋,找到語義相近的歷史請求
    3. 若相似度高於門檻,就直接重用快取結果

    核心差異:

    • exact-match:字串完全一致才命中 → hit rate 極低
    • semantic cache:語義相似即可命中 → 命中率與長尾查詢成本大幅改善

    2. Embedding 維度、距離度量與門檻設計

    (1) Embedding 選型

    實務建議:

    • 優先用雲端提供的現成模型,例如:
    • OpenAI:text-embedding-3-small(1536 維,CP 值高)
    • Anthropic:搭配外部 embedding 模型(現階段主力還是在 text model)
    • 本地:bge-m3 / bge-large-zh 系列
    • 維度建議:768–1536 維,再低容易語義表達力不足,再高會拖慢向量查詢與存儲

    💡 關鍵: Embedding 維度落在 768–1536 通常能兼顧語義表達力與查詢成本,是實務上常用的安全區間。

    (2) 距離度量

    多數 embedding 預設是單位向量,直接用:

    • Cosine 相似度 或
    • Inner product(dot product) + normalization

    在 pgvector / RediSearch 中對應為:

    • pgvector:cosine_distance, inner_product
    • RediSearch:COSINE, IP

    (3) 相似度門檻

    實務上用相似度 score(越高越相似):

    • 一般 QA / FAQ 類:≥ 0.85 才視為命中
    • 容錯度高(例如推薦、summarize):可以放寬到 0.8
    • 安全關鍵(法務 / 醫療):建議 0.9+ 或只做「候選提示」不直接 auto-hit

    建議做成 可配置:

    semantic_cache:
      min_similarity: 0.87
      max_age_seconds: 86400  # 24h
    

    💡 關鍵: 把相似度門檻做成可配置,可以依場景在 0.8–0.9+ 之間調整,兼顧命中率與錯答風險。

    3. 多鍵策略 & Prompt 模板變動

    (1) 多鍵策略:user_id / locale / model_id

    避免「錯人、錯模、錯語系」的語義誤命中,可以在向量檢索時加上多維限制:

    • user_id:B2B 場景常有客製知識庫,可用 tenant_id / org_id 分區
    • locale:zh-TW vs en-US 的語義可近但答案不同
    • model_id:不同模型輸出風格與能力差異大,cache 混用會有體感落差

    查詢條件大致會長這樣:

    WHERE tenant_id = $1 AND locale = $2 AND model_id = $3
    ORDER BY embedding <-> $query_embedding
    LIMIT 1
    

    (2) Prompt 模板變動導致 cache miss

    大部分團隊會把 系統提示 + tool 描述 + 歷史對話 + user 問句 串成完整 prompt 做快取 key;結果一改模板,整個 cache 幾乎報廢。

    實務作法:

    • 把要做 embedding 的內容拆成比較穩定的部分:
    • 不要含整個系統提示
    • 不要含 tool schema
    • 只對「語義關鍵」部分做 embedding:user 問句 + 精簡後的 RAG context
    • 快取 key 中再另外紀錄 prompt_template_version,查詢時限制:
    WHERE prompt_template_version = $ver
    

    這樣改模板時只需要 bump version,舊資料會自然「冷掉」,又不會影響新版本 cache 收斂。


    實作範例

    1. 架構視角

    以典型 RAG / chat backend 為例,語義快取插在:

    1. 收到 user query
    2. 組裝完整 prompt 前/後,計算 embedding
    3. 先查 semantic cache:
    4. 命中:直接回應
    5. 未命中:
      • 走正常流程:檢索(RAG)、呼叫 OpenAI / Anthropic / Meta 模型
      • 回寫快取

    2. PostgreSQL + pgvector 範例

    建表:

    CREATE EXTENSION IF NOT EXISTS vector;
    
    CREATE TABLE semantic_cache (
      id BIGSERIAL PRIMARY KEY,
      tenant_id TEXT NOT NULL,
      locale TEXT NOT NULL,
      model_id TEXT NOT NULL,
      prompt_template_version INT NOT NULL,
    
      prompt_text TEXT NOT NULL,       -- 關鍵語義部分(例如 user 問句 + RAG context 摘要)
      response_json JSONB NOT NULL,    -- 模型原始回傳(含tool_calls可選)
    
      embedding VECTOR(1536) NOT NULL,
      created_at TIMESTAMPTZ DEFAULT now(),
    
      UNIQUE (tenant_id, locale, model_id, prompt_template_version, id)
    );
    
    CREATE INDEX ON semantic_cache USING ivfflat (embedding vector_cosine_ops)
      WITH (lists = 100);
    

    查詢(Node / TS pseudo-code):

    const { embedding } = await openai.embeddings.create({
      model: "text-embedding-3-small",
      input: cacheKeyText, // user 問句 + RAG 摘要
    });
    
    const { rows } = await pg.query(
      `SELECT id, response_json,
              1 - (embedding <=> $4) AS similarity
       FROM semantic_cache
       WHERE tenant_id = $1
         AND locale = $2
         AND model_id = $3
         AND prompt_template_version = $5
       ORDER BY embedding <-> $4
       LIMIT 1`,
      [tenantId, locale, modelId, embedding, promptTemplateVersion]
    );
    
    if (rows[0] && rows[0].similarity >= MIN_SIMILARITY) {
      return rows[0].response_json; // 命中語義快取
    }
    

    回寫:

    await pg.query(
      `INSERT INTO semantic_cache
       (tenant_id, locale, model_id, prompt_template_version,
        prompt_text, response_json, embedding)
       VALUES ($1, $2, $3, $4, $5, $6, $7)`,
      [tenantId, locale, modelId, promptTemplateVersion,
       cacheKeyText, responseJson, embedding]
    );
    

    3. Redis + RediSearch 範例

    定義向量索引:

    FT.CREATE semantic_cache_idx ON HASH PREFIX 1 sc:
      SCHEMA tenant_id TAG locale TAG model_id TAG prompt_template_version NUMERIC
             embedding VECTOR HNSW 6 TYPE FLOAT32 DIM 1536 DISTANCE_METRIC COSINE
    

    查詢(Python pseudo-code):

    vec = get_embedding(cache_key_text)  # 1536 維 float32
    
    q = (
      f"(@tenant_id:{{{tenant_id}}} "
      f"@locale:{{{locale}}} "
      f"@model_id:{{{model_id}}} "
      f"@prompt_template_version:[{ver} {ver}])=>[KNN 1 @embedding $vec AS sim]"
    )
    
    res = redis.ft("semantic_cache_idx").search(q, query_params={"vec": vec})
    if res.docs:
      sim = 1 - float(res.docs[0].sim)
      if sim >= MIN_SIMILARITY:
        return json.loads(res.docs[0].response_json)
    

    建議與注意事項

    1. 長輸入的 embedding 成本「反向暴增」

    常見錯誤:把 整個 prompt(含長 RAG context) 丟去做 embedding。

    問題:

    • context 動輒上千 tokens,embedding 成本跟 LLM inference 一起爆
    • 一點點 context 差異就讓相似度下降 → 命中率不升反降

    實務建議:

    • 只對「stable 且短」的部分做 embedding:
    • user 問句
    • RAG context 的「摘要」而不是原文(可用小模型先 summarize 成 2–3 句)
    • 大型企業專案:先用 request 日誌做統計,估算 embedding 成本佔比,再決定精度/長度 trade-off

    2. 語義誤命中 → 幻覺與錯答風險

    語義快取本質上是「猜這問題和之前那題是不是本質相同」,猜錯就會回錯答案,而且錯得非常「自信」。

    風險控制手段:

    1. 提高門檻 + 多條件:
    2. similarity 0.9+ + 同 tenant / locale / model / template_version
    3. 加上 lightweight 檢查模型:
    4. 對 candidate 問題 & 當前問題再丟給小模型,問:
    5. 「這兩個問題是否在同一個具體情境下?只回答 yes/no」
    6. 只回部分結果:
    7. 把 cache 命中當作「示範答案」塞進 system prompt,而不是直接當最終輸出

    3. 線上 A/B、hit rate 與 cost saving 監控

    (1) A/B 框架

    • A 組:只用 exact-match cache
    • B 組:開啟 semantic cache
    • 衡量指標:
    • cache_hit_rate:命中次數 / 總請求
    • avg_latency:端到端延遲
    • cost_per_1k_requests:可用 token 使用量 × 單價估算

    (2) 實作例:log 設計

    {
      "request_id": "...",
      "tenant_id": "...",
      "model_id": "gpt-4.1-mini",
      "semantic_cache_hit": true,
      "semantic_similarity": 0.91,
      "exact_cache_hit": false,
      "prompt_tokens": 923,
      "completion_tokens": 134,
      "latency_ms": 480
    }
    

    可以直接在 ClickHouse / BigQuery 做每日 dashboard:

    • 按 tenant 和 model 切分 semantic_cache_hit_rate
    • 比較「命中 vs 未命中」的平均 latency / token usage

    4. 上線前的設計 Checklist

    • Embedding 模型
    • [ ] 維度 768–1536,成本可接受
    • [ ] 支援你主要語言(中/英通常 OK,但特定語種要確認)
    • 距離度量與索引
    • [ ] PostgreSQL 使用 pgvector + ivfflat,設好 lists
    • [ ] Redis 使用 HNSW,確認記憶體預算
    • 快取 key 策略
    • [ ] 僅對 user query + 短 RAG 摘要做 embedding
    • [ ] 有 tenant_id / locale / model_id / prompt_template_version 條件
    • 風險控制
    • [ ] similarity 門檻可配置,預設 ≥ 0.85
    • [ ] 高風險業務要額外加一層 lightweight 檢查
    • 監控與 rollback
    • [ ] 有 semantic_cache_hit_rate / latency / token usage 監控
    • [ ] 開關旗標(feature flag)可在出問題時快速關閉

    只要把語義快取做成這樣一個「有監控、有開關、有版本」的基礎組件,你的 RAG / chat backend 通常能在不改業務邏輯的前提下,拿到一個非常直接的 成本與體感雙重優化。從 infra 角度來說,這個投資的 ROI 幾乎是整條 LLM pipeline 裡最高的一塊。

    🚀 你現在可以做的事

    • 在現有 RAG backend 中,先對 user 問句接入 text-embedding-3-small 或 bge-m3 的語義快取實驗路徑
    • 用 ClickHouse 或 BigQuery 建一個簡單 dashboard,監控 semantic_cache_hit_rate、延遲與 token 成本變化
    • 增加 tenant_id / locale / model_id / prompt_template_version 條件,並設好 min_similarity 旗標,逐步在低風險場景 rollout