標籤: AI 技術

  • Agent Loop RAG:超越傳統 RAG 的下一步

    Agent Loop RAG:超越傳統 RAG 的下一步

    📌 本文重點

    • 多輪 Agent Loop RAG 可讓 QA 準確率大幅提升
    • 關鍵是「決策 +多輪檢索」而非一味加 reranker
    • 實作重點在 decision head、記憶管理與 citation 驗證

    Google FRAMES 的多跳 QA 實驗顯示:最佳傳統 RAG pipeline 78.9%,Agent Loop 式 RAG 92.7%,幾乎等同「直接給模型正確文件」。對工程團隊來說,這代表一件很直接的事:

    你不一定需要更大的模型或更複雜的 reranker,而是需要讓模型有“多輪檢索與決策能力”的 RAG 架構。

    💡 關鍵: 在相同文件與 embedding 條件下,Agent Loop 式 RAG 能比傳統 RAG 多拿約 14 個百分點的準確率,效益遠勝只換大模型或小 reranker。

    下面從工程視角拆解:Agent Loop 式 RAG 到底多了什麼、怎麼實作一個最小可行版本、以及部署時要小心哪些坑。


    重點說明:Agent Loop 式 RAG 的關鍵差異

    1. 一次性 Top‑k vs. 多輪自我檢索

    傳統 RAG:
    1. 使用者 query
    2. 向量庫 top_k 檢索
    3. 把 chunks 拼進 context
    4. 一次性回答

    Agent Loop RAG(FRAMES 的 Agent Loop 類型):
    1. 使用者 query
    2. 模型判斷:需要檢索嗎?→ 呼叫 檢索工具
    3. 讀結果後:
    – 若資訊不足:改寫 / 分解 query 再查一次
    – 若資訊足夠:生成答案
    4. 持續迭代,直到滿足「可以回答」的停止條件

    對多跳問題(典型企業知識庫 QA)來說:
    – 傳統 RAG 常卡在「第一跳檢索就打偏」
    – Agent Loop 允許模型根據前一輪讀到的內容,修正檢索方向

    這也是為什麼同一組 embedding/文件,Agent Loop 在 FRAMES 能拉高約 14 個百分點的原因。


    2. Agent 如何決定「要不要再查」?

    實務上會做成一個小的 decision head,而不是完全靠 prompt。常見做法:

    • 用一個 工具選擇 schema,讓模型每輪輸出:
    • action:"search" | "answer"
    • reason:決策理由(方便 debug)
    • query:若 action 是 search,要查的內容

    範例(以 OpenAI / OpenRouter 類 API 為例):

    // tool schema(簡化版)
    {
      "type": "function",
      "function": {
        "name": "agent_decide",
        "description": "決定下一步是再次檢索還是回答",
        "parameters": {
          "type": "object",
          "properties": {
            "action": {
              "type": "string",
              "enum": ["search", "answer"]
            },
            "reason": {"type": "string"},
            "query": {
              "type": "string",
              "description": "如果需要檢索,這是更新後的查詢語句"
            }
          },
          "required": ["action", "reason"]
        }
      }
    }
    

    在 loop 中實作邏輯:

    • 若 action == "search":
    • 呼叫你的 檢索 API(向量庫、混合搜尋皆可)
    • 把檢索結果 append 到對話狀態
    • 若 action == "answer":
    • 要求模型在嚴格引用現有 context 的前提下生成最終答案

    這種方式比「用 system prompt 告訴模型:資訊不夠就再查」穩定得多,因為 decision 被結構化,容易觀測與評估。


    3. 為何小 reranker 反而拖垮效果?

    FRAMES 實驗的結果很不直覺:
    – 小 reranker:讓最佳 pipeline 準確率 掉了 9 個百分點
    – 大 reranker:只有輕微提升

    💡 關鍵: 弱 reranker 容易錯殺原本已在 top_k 的關鍵 chunk,在多跳 QA 中反而降低整體答對率。

    工程上的原因通常是:
    1. 弱 reranker = 引入噪音排序
    – 原本 top_k 裡其實已有足夠訊息
    – 小模型 rerank 反而把關鍵 chunk 往下排
    2. 多跳場景不適合一次性排序整包文件
    – FRAMES 類題目常需要「先找到中間 entity,再查下個文件」
    – 一次性把所有文件塞進 context,再怎麼 rerank 都很難

    對多跳問題來說,檢索策略(多輪) > 排序策略(rerank)。實務結論:
    – 先把心力放在 Agent Loop + query 改寫/分解
    – reranker 真要上,從 大一點的模型 + 明確場景評估 開始


    實作範例:最小可行 Agent Loop RAG

    以下是一個可以直接改成你專案版本的「最小可行」架構:

    1. 介面與狀態設計

    核心組件:
    – 檢索 API:search_docs(query, top_k) -> [Doc]
    – 對話狀態:messages + memory
    – 工具 schema:agent_decide + search_tool

    # 假設已有向量庫 search_docs
    
    def search_docs(query: str, top_k: int = 5):
        # return list of {"id", "title", "content"}
        ...
    
    # 對話記憶(簡化)
    class AgentMemory:
        def __init__(self):
            self.history = []      # user / assistant turns
            self.retrieved = []    # 已讀過的 docs meta
    
        def add_retrieval(self, query, docs):
            self.retrieved.append({"query": query, "docs": docs})
    

    2. 工具定義(決策 + 檢索)

    TOOLS = [
        {
            "type": "function",
            "function": {
                "name": "search_tool",
                "description": "用關鍵字搜尋文件庫",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "query": {"type": "string"},
                        "top_k": {"type": "integer", "default": 5}
                    },
                    "required": ["query"]
                }
            }
        },
        {
            "type": "function",
            "function": {
                "name": "agent_decide",
                "description": "決定接下來是檢索還是回答",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "action": {"type": "string", "enum": ["search", "answer"]},
                        "reason": {"type": "string"},
                        "query": {"type": "string"}
                    },
                    "required": ["action", "reason"]
                }
            }
        }
    ]
    

    3. Agent Loop Pseudo-code

    MAX_STEPS = 4
    
    def agent_loop(user_query: str, llm_client) -> str:
        memory = AgentMemory()
        messages = [
            {"role": "system", "content": "你是一個嚴格依據檢索文件回答的助理。"},
            {"role": "user", "content": user_query},
        ]
    
        for step in range(MAX_STEPS):
            # 1) 請模型用 agent_decide
            decision = call_llm_decide(messages, llm_client)
    
            if decision["action"] == "search":
                q = decision.get("query") or user_query
                docs = search_docs(q, top_k=5)
    
                # 避免重複查同批文件(一個常見坑)
                if is_duplicate_retrieval(memory, q, docs):
                    # 強制模型換策略:更新 prompt 或降低溫度
                    messages.append({"role": "assistant", "content": "目前檢索結果重複,請改寫查詢或嘗試總結。"})
                    continue
    
                memory.add_retrieval(q, docs)
                # 把摘要版 docs 塞回 messages
                context_txt = summarize_docs_for_context(docs)
                messages.append({
                    "role": "assistant",
                    "content": f"[檢索結果]\n{context_txt}"
                })
    
            elif decision["action"] == "answer":
                # 2) 最終回答:強調不得虛構引用
                messages.append({
                    "role": "system",
                    "content": "只允許引用上述[檢索結果]中出現的資訊,若沒有就回答無法判斷。"
                })
                return call_llm_answer(messages, llm_client)
    
        # 超過 MAX_STEPS 仍未收斂
        return "目前檢索仍不足以可靠回答這個問題。"
    

    這樣的框架可以直接套到既有向量庫專案,只需要:
    – 把原本「一次性檢索 + 回答」拆成 decision → 檢索 → decision → 回答 loop
    – 把 檢索結果縮摘要(避免 context 爆掉)


    建議與注意事項:部署時的實務考量

    1. 延遲與成本:多輪檢索怎麼控

    Agent Loop 必然:
    – 更多 LLM call(decision + answer)
    – 更多檢索 call

    控制策略:
    – 設定 MAX_STEPS(通常 3–5 輪就夠,多了收益遞減)
    – decision 用較小模型、最後回答用大模型(類似 routing)
    – 對「簡單問題」走捷徑:
    – 先讓模型判斷 need_search: bool
    – 為 False 時走 direct answer 或 cached FAQ


    2. 限制 hallucination 與 citation 造假

    FRAMES 實驗也發現,即使明講「只能根據文件」,模型仍會:
    – 憑記憶補完內容,硬塞 citation 看起來很合理

    實務防禦:

    1. 結構化 citation:
    2. 要求回答時返回:{"answer": ..., "citations": [doc_id, ...]}
    3. 像「citation receipt」一樣,保存:哪個句子對應哪個 chunk

    4. 離線自動驗證:

    5. 對高風險場景(法務、醫療),可加一個 verification pass:

      • 把 answer + citations 再丟給 LLM,問:
      • 這些句子是否都能在 citied chunks 中找到明確證據?
      • 若否,標記為需人工審查
    6. 明確拒答路徑:

    7. 在 prompt 中允許、甚至鼓勵模型回答「依據現有檢索結果無法判斷」,比亂猜好

    3. Loop 不收斂、重複查同一批文件、context 爆掉

    這是 Agent Loop RAG 的三大工程坑:

    1. loop 不收斂:
    2. 加 MAX_STEPS 上限
    3. decision prompt 中加入:「若多次檢索仍無新訊息,請選擇 answer 並說明無法回答」

    4. 重複查同一批文件:

    5. 在 AgentMemory 中存檢索 query + top 文檔 id
    6. 若新一輪檢索與前一輪 query 相似度高且 top ids 近似,視為重複,強制換策略

    7. context 爆掉:

    8. 對每次檢索結果先做 chunk‑level 摘要 再拼進 prompt
    9. 對話歷史採 滑動視窗,只保留「最近幾輪檢索摘要 + 關鍵決策理由」

    4. 從既有 RAG 平滑遷移到 Agent Loop

    推薦遷移路徑:

    1. Phase 1:保留現有 RAG,只加一層 decision head
    2. 先讓模型判斷 need_extra_search(布林值)
    3. 若是:再跑一次檢索 + answer

    4. Phase 2:引入多輪 query 改寫

    5. 在 decision 中加入 refined_query 欄位
    6. 觀察實際 query 改寫對召回率的提升

    7. Phase 3:完全 Agent Loop

    8. 將檢索、決策、回答視為三個工具,以 loop 驅動
    9. 為每一輪紀錄 log,方便做 自動打標 / 事後評估

    觀測上,建議:
    – 對一批固定測試集(可自建,也可用 FRAMES 類題目)
    – 比較:
    – 傳統 RAG pipeline vs Agent Loop RAG 的答對率 / citation 正確率
    – 並記錄平均回合數與成本


    總結:
    – 多跳與複雜 QA 場景下,Agent Loop 式 RAG 的收益實際可觀(以 FRAMES 為證)
    – 與其疊更多「hybrid search + 小 reranker」,不如先讓模型具備:
    – 多輪檢索決策能力
    – 對話狀態 / 檢索記憶管理
    – 可觀測、可驗證的 citation 流程

    如果你已有一個傳統 RAG QA 服務,本文的最小 Agent Loop 範例幾乎可以直接改成你自己的 API 呼叫,把 loop 跑起來,會比換更大模型更划算。

    🚀 你現在可以做的事

    • 在現有專案中,先加上一層 agent_decide decision head,觀察多一次檢索帶來的答對率變化
    • 用自家資料集或 FRAMES 類題目,對比「傳統 RAG vs Agent Loop RAG」的準確率與平均步數
    • 為現有回答格式加入結構化 citations 欄位,並設計一個簡單的離線驗證流程
  • 別讓 LLM 幫你丟銅板

    別讓 LLM 幫你丟銅板

    📌 本文重點

    • 用小決策模型取代 LLM 處理「丟銅板」級判斷
    • 建立「雙大腦」架構:小模型決策,大模型推理
    • 以 0.8B/2B 模型降低成本、延遲並集中安全邏輯

    多數現在的 Agent pipeline,都在做一件超浪費的事:用昂貴的 LLM 做「單選題」、「要不要重試」、「走哪條 route」。結果是:

    • 每個小決策都要 多幾百 ms~數秒延遲
    • 成本被這些「丟銅板級」判斷吃掉 30–60%
    • 因為每次都要 prompt LLM,安全策略與控制邏輯難以驗證與重用

    💡 關鍵: 把「銅板級小決策」從 LLM 移到輕量模型,可大幅省下 30–60% 的成本與延遲開銷。

    System One / Decision Models(如 Jev、Jeff 系列)解的,就是這一層「決策邏輯」:不產生長文本,只輸出結構化 label / probabilities,在 20–50 ms 內做完一次判斷,讓 LLM 專心做它擅長的長文本推理與生成。

    下面會講:為什麼要導入這種決策模型、如何在現有 Agent 中插入一顆 0.8B/2B 模型,實作「雙大腦」架構,最後整理導入時的注意事項與常見踩坑。


    重點說明

    1. 先拆開:「決策」≠「生成」

    目前常見 Agent(工具調用、Router、Guardrail)都有這類 pattern:

    • 決定 用哪個 tool:"tool_1" / "tool_2" / "none"
    • 判斷 要不要重試:"retry" / "abort"
    • 風險標註:"low" / "medium" / "high"

    傳統作法是:

    1. 把上下文丟給 LLM
    2. 要求輸出 JSON
    3. 再 parse 成一個 label

    這會導致:

    • 成本:每次小決策都耗一個完整 LLM call
    • 延遲:生成 + parsing 帶來 300ms–數秒
    • 安全性:Prompt 工程非常脆弱,一個格式錯就整個 decision pipeline 崩

    System One 決策模型的設計哲學是:

    給我一個 context + 選項列表,我只回傳 每個選項的機率分佈,不跟你聊天。

    像 Jev 或開源 Jeff:

    • 輸入:{"context": ..., "options": ["use_search", "ask_user", "call_tool"]}
    • 輸出:{"use_search": 0.62, "ask_user": 0.18, "call_tool": 0.20}

    你可以直接在程式碼裡用這個分佈做 argmax、帶溫度抽樣、risk-aware routing,完全不用再 parse 文字。


    2. 「雙大腦」:小模型決策,大模型推理

    實務上最有用的模式是:一個 fast decision brain + 一個 reasoning LLM。

    • Decision Brain(例如 Jeff-0.8B / Jeff-2B):
    • 任務:routing、重試判斷、優先級、風險上報
    • 特性:單次 forward ~30 ms、本地可部署、輸出概率

    • Reasoning LLM(例如 GPT、Claude、Llama):

    • 任務:長文本生成、複雜推理、多步工具調用
    • 特性:成本高、延遲高,但能力強

    常見模式(改編自 Jev/Jeff 的 pattern):

    1. Router:決策模型選「用哪個 LLM / 哪個專家 Agent」
    2. Retry Policy:LLM 出錯,由決策模型判斷「重試/降階模型/人工接管」
    3. Risk Escalation:決策模型只要發現 high-risk,立即上報/阻斷,不讓 LLM 自己「想一想」
    4. Multi-Agent 協調:多個小 Agent 各自提案,由決策模型打分、選擇最適方案

    好處非常直接:

    • 成本降 30–80%:多數小決策不再叫大模型
    • 延遲變穩定:本地 decision 模型可維持 <50 ms
    • 安全邏輯集中:決策 policy 都寫在程式碼 + decision 模型裡,而不是散在 prompt

    💡 關鍵: 「雙大腦」架構把高成本 LLM 使用頻率壓到最低,同時讓安全與路由策略變得可觀測、可測試。


    3. 為什麼選 0.8B / 2B 決策模型?

    Jeff 這類 0.8B/2B 模型,實務上剛好落在:

    • 夠小:
    • 0.8B 量化後可在 CPU 或 M 系列 Mac 上跑
    • ~30ms/decision,TPS 可以拉到數百
    • 夠準:
    • 在 Jev 同類 benchmark 上能到 ~83% 正確率,接近 Jev
    • 對多選概率輸出做過校準(適合做 risk-based policy)

    💡 關鍵: 0.8B/2B 模型在 ~83% 正確率與 ~30ms 延遲之間取得平衡,非常適合作為高頻決策核心。

    對 Agent 來說,這種模型可以:

    • 作為 中央決策器:統一處理 route / retry / escalate
    • 作為 專用分類器:例如 ticket triage、工具選擇、user intent 分類
    • 透過本地 fine-tune/LoRA,快速貼合你的業務決策空間

    實作範例:在現有 Agent 中插入一顆決策模型

    以下以一個典型 LLM-based Agent 為例,有這幾步:

    1. 分類 user intent
    2. 決定是否查詢工具 / RAG
    3. 呼叫 LLM 生成回應

    我們要做的是:把第 1, 2 步改由 System One 決策模型處理。

    架構概觀

    User → (Decision Model) → route: {search, direct_llm, ask_clarify}
          → (Optional) Decision Model: retry / escalate
          → (LLM) 只在必要時被呼叫
    

    範例 1:HTTP API 版本(推論在遠端或內網)

    假設你有一個決策模型 API:POST /decision,輸入 context+options,輸出 probability。

    import requests
    
    DECISION_API = "https://decision.local/api/v1/decision"
    
    OPTIONS_ROUTE = ["direct_llm", "search", "ask_clarify"]
    
    def call_decision_model(context: str, options: list[str]) -> dict:
        payload = {
            "context": context,
            "options": options
        }
        resp = requests.post(DECISION_API, json=payload, timeout=0.2)
        resp.raise_for_status()
        return resp.json()["probs"]  # e.g. {"direct_llm": 0.2, "search": 0.6, ...}
    
    
    def route_request(user_query: str, history: list[str]) -> str:
        context = "\n".join([*history[-5:], f"User: {user_query}"])
        probs = call_decision_model(context, OPTIONS_ROUTE)
    
        # 簡單 argmax,實務上可加溫度或阈值
        choice = max(probs.items(), key=lambda x: x[1])[0]
        return choice
    
    
    def handle_request(user_query: str, history: list[str]):
        route = route_request(user_query, history)
    
        if route == "search":
            docs = search_api(user_query)
            return llm_answer_with_docs(user_query, docs)
        elif route == "ask_clarify":
            return "我需要多一點資訊才能幫你,能描述得再具體一些嗎?"
        else:  # direct_llm
            return llm_direct_answer(user_query)
    

    重點:

    • 決策模型輸出的是 probs,而不是自然語言
    • routing 邏輯安全可控,可以在程式碼中加入 risk threshold:
    if probs["search"] < 0.4 and probs["direct_llm"] < 0.4:
        # 模型不確定,改走安全路線
        route = "ask_clarify"
    

    範例 2:本地部署 Jeff-0.8B(以 Python + ggml 為例)

    以下為 pseudo-code,示意如何用本地 0.8B 決策模型取代雲端判斷:

    from my_decision_runtime import JeffModel
    
    # 載入量化後的 0.8B 模型(例如 Q4_0)
    model = JeffModel(
        model_path="./jeff-0.8b-q4.gguf",
        max_seq_len=2048,
    )
    
    OPTIONS_RETRY = ["retry", "fallback_small_llm", "escalate_human", "abort"]
    
    
    def decide_retry(error_summary: str, last_attempt_prompt: str) -> str:
        context = f"Error: {error_summary}\nLastPrompt: {last_attempt_prompt[:512]}"
        probs = model.predict(context=context, options=OPTIONS_RETRY)
        # probs: dict[str, float]
    
        # 基於風險的 policy
        if probs["escalate_human"] > 0.4:
            return "escalate_human"
        if probs["abort"] > 0.5:
            return "abort"
        # 其餘用 argmax
        return max(probs.items(), key=lambda x: x[1])[0]
    
    
    # 在你的 Agent 裡:
    
    def run_with_retry(prompt: str):
        try:
            return call_main_llm(prompt)
        except Exception as e:
            decision = decide_retry(str(e), prompt)
    
            if decision == "retry":
                return call_main_llm(prompt)
            elif decision == "fallback_small_llm":
                return call_small_llm(prompt)
            elif decision == "escalate_human":
                notify_oncall("LLM failure", prompt, str(e))
                raise
            else:  # abort
                raise
    

    這段展示了 Jeff 作為「錯誤策略決策器」:

    • 不再需要 LLM 生成「請重試」之類字串
    • 所有錯誤策略可以用程式碼寫死,決策模型只給概率與偏好

    建議與注意事項

    1. 資料標註與格式:把決策當「分類任務」設計

    導入決策模型前,要先把業務決策抽象成 明確選項 + context:

    • 標註格式建議:
    • context: 純文字,包含必要上下文(user input、歷史、meta)
    • options: 選項列表,例如 ["route_a", "route_b", "escalate"]
    • label: 真實選擇(其中一個 option)

    範例 JSON:

    {
      "context": "User: 我要查 2023 年度發票\nMetadata: plan=premium, region=tw",
      "options": ["billing", "tech_support", "sales"],
      "label": "billing"
    }
    

    不要 把決策模型當一般文本 LLM 用:

    • 不要要求它寫長回應
    • 不要在 output 裡混入自然語言,只保留 label / prob

    2. 評估指標與 reward 設計:先拆「業務 reward」再看模型 metrics

    常見坑是:

    • 把「業務 KPI」(例如轉換率、工單處理時間)直接當作模型訓練 reward
    • 或只看 accuracy,而忽略 不同錯誤的成本不對稱

    建議:

    • 模型層面:看 top-1 accuracy、calibration(Brier score)
    • 業務層面:再看
    • routing 正確率對 成本、延遲 的影響
    • risk decision 對 事故率、誤報率 的影響

    並且明確定義:

    • 哪些錯誤是 容忍型(例如選錯 LLM 只是有點慢)
    • 哪些錯誤是 致命型(例如錯過 high-risk 交易)

    讓 decision policy 在程式碼裡顯式處理這些差異,不要全丟給模型學。

    3. 延遲、量化、TPS:本地部署要先壓指標

    在本地跑 0.8B/2B 決策模型時,幾個容易忽略的點:

    • 量化策略:
    • Q4_0 / Q5_K 通常是延遲/精度的甜 spot
    • 過度量化(Q2 等)可能讓概率校準崩掉,對 decision 特別危險
    • TPS(吞吐量):
    • 估算公式:TPS ≈ (batch_size / latency_per_batch)
    • 若有大量併發 Agent,建議跑一個 decision service,統一打 batch
    • 延遲測試:
    • 在 staging 模擬實際 traffic,測試 end-to-end:user → decision → LLM
    • 對每種 decision path 分別量測(例如 search route vs direct_llm)

    4. Fallback 策略:永遠保留「不用 decision 模型」的路徑

    導入新 decision layer 很容易把整個系統綁死在它上面。建議:

    • 在 config 中預留 DECISION_MODEL_ENABLED 旗標
    • 實作 fallback policy:
    if not DECISION_MODEL_ENABLED or decision_model_unhealthy():
        # 回到簡單的 rule-based or default LLM
        route = default_route(user_query)
    

    這可以:

    • 快速 A/B test decision 模型的影響
    • 緊急時一鍵關閉 decision 層,避免整個系統因為一顆 0.8B 卡住

    5. 常見踩坑總結

    • 把決策模型當 LLM 文本模型用:要它寫長答案,結果 latency 又上來
    • 沒拆 rewards:直接用業務 reward 當 loss,導致 reward hacking(例如模型只選能快速結束對話的 route)
    • 忽略成本與延遲測試:只看 benchmark accuracy,不做真實流量測試
    • 選項設計過細:options 太多、含義不清,導致 decision noise 大

    導入 System One / Decision Models 的關鍵心態是:

    讓 LLM 做它擅長的推理與生成,把所有「丟銅板」級決策搬給一顆小而快、可控的模型。

    只要你願意把 Agent pipeline 中的各種 routing、重試、risk 判斷抽離出來,用一顆 0.8B/2B 決策模型接手,就能在 成本、延遲、安全性 上一次升級,真正做出「雙大腦」架構的智慧 Agent。

    🚀 你現在可以做的事

    • 清點現有 Agent pipeline 中所有「單選題」與「要不要重試」類決策,列成 options 清單
    • 寫一個簡單的 /decision API(可先 mock),在程式碼中改用「機率分佈 → route」的決策流程
    • 選一個 0.8B/2B 模型(例如 Jeff 類),在 staging 環境測試延遲、TPS 與成本改善幅度
  • 從 BM25 到稀疏向量混合檢索打造可靠多語 RAG

    從 BM25 到稀疏向量混合檢索打造可靠多語 RAG

    📌 本文重點

    • 多語場景下單一檢索技術不可靠
    • Sparse + dense 混合檢索能顯著提升召回
    • RRF 等穩健融合策略優於簡單加權
    • 現有「只用 embedding」RAG 可漸進升級

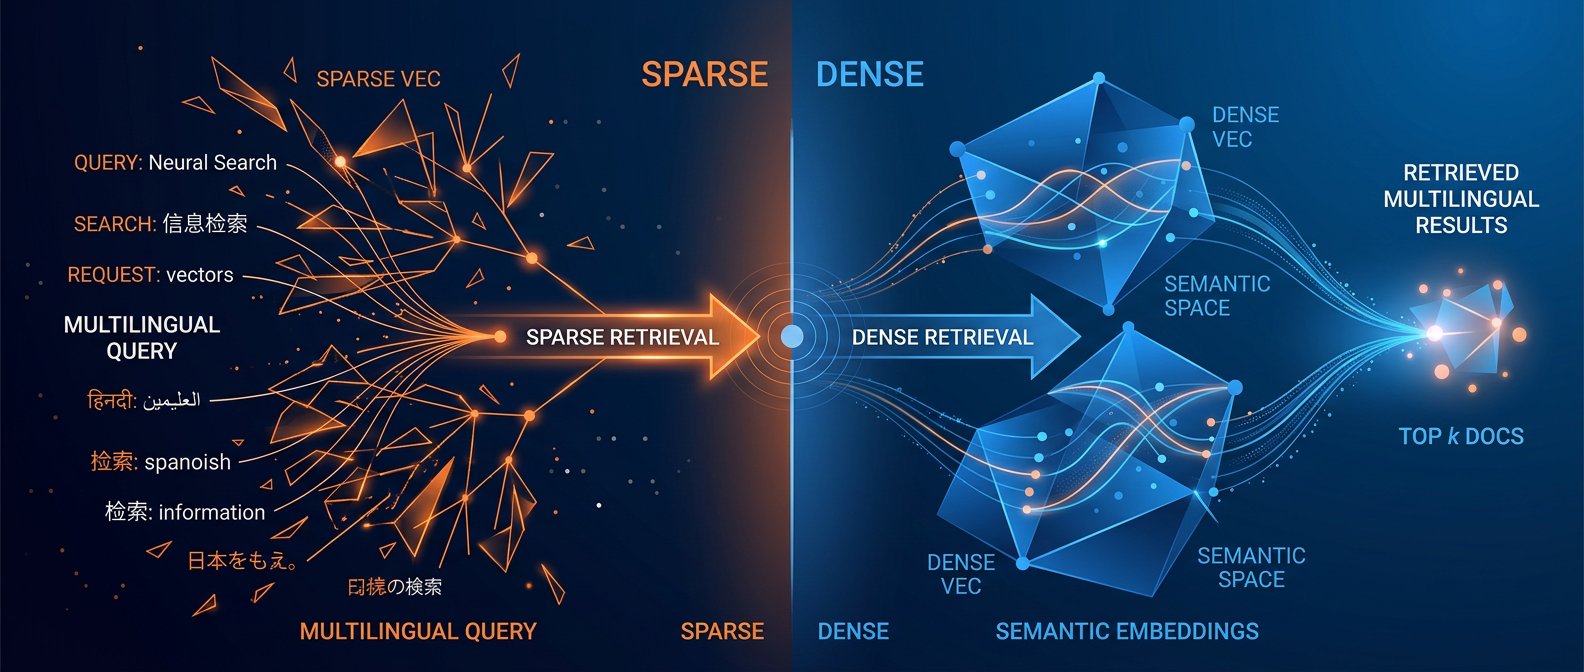
    多語 RAG 最大的痛點,不是模型能力,而是檢索可靠性:民眾怎麼描述需求,和政府怎麼寫方案,永遠長得不一樣。從 MyScheme 這種多語、口語化的政府資料集可以看到,純 BM25 找不到語義相近但字面不同的文件,純 dense embedding 又容易在多語、多拼寫下語義漂移或召回太亂。本文聚焦一件事:如何用 sparse + dense 混合檢索,在現有 RAG 專案裡實際提升 recall,而不是只靠「換一個更大的 embedding 模型」。


    重點說明

    1. 純 BM25 vs 純 dense:多語查詢的失敗模式

    以 MyScheme 的農民補助方案為例,同一個意圖可能長這樣:

    • farmer income support scheme
    • kisan ko har saal paisa milne wali scheme
    • किसानों को हर साल पैसे देने वाली योजना
    • farmer ko 6000 rupees wali yojna

    失敗模式很典型:

    • 純 BM25
    • 英文 query 找到英文文件還行,但遇到混 Hindi/English 的查詢時,停用詞與分詞完全不對齊,得分被噪音稀釋。
    • 政府文件常用「PM-KISAN」「beneficiary」「disbursement」,民眾只說「har saal paisa」「6000 rupees」,詞彙不重疊直接失敗。
    • 純 dense embedding
    • 多語模型雖然能把 Hindi/English 映射到同一語義空間,但口語拼寫、錯字、混寫系統很容易落在 embedding 邊緣,導致相似度偏低。
    • RAG 常見做法是 top-k = 5~10,一旦語義有點偏,整批召回的文件都錯,LLM 再會「瞎補」也救不回來。

    💡 關鍵: 在多語口語查詢下,BM25 容易因詞彙不重疊失效,而 dense 在 top-k = 5~10 時只要稍微語義偏離就會整批召回錯誤文件。

    結論:lexical 是精確但太窄,dense 是寬但容易飄。混合檢索的目標就是用 sparse 捕捉字面線索、用 dense 捕捉語義,再在 ranking 階段做穩健融合。


    2. Sparse + Dense Hybrid 的設計拆解

    混合檢索不是「把兩個分數加起來」這麼簡單,它牽涉到幾個具體設計。

    (1) 索引結構:一個引擎還是兩層系統?

    • 單一引擎模式(適合小團隊):
    • 用 Elasticsearch / OpenSearch 的 BM25 + 稀疏向量(如 SPLADE、ELASTICSPLADE)+ dense 向量三合一索引。
    • 優點:部署簡單、一套 API;缺點:向量能力受限於 ES/OpendSearch 版本,調參空間較小。
    • 兩層模式(適合大型系統):
    • 第一層:search engine 做 sparse(BM25 + sparse vector)coarse recall。
    • 第二層:向量資料庫(PGVector / Qdrant)做 dense rerank / 精細相似度計算。
    • 可在第二層加上 cross-encoder reranker 或 LLM-based re-ranking。

    (2) 查詢改寫與 normalization

    多語、多拼寫下,query preprocessing 本身就是一個模組:

    1. 語言偵測:
    2. 使用 fastText / CLD3 或 LLM 自帶的語言偵測,標記 query 語言。
    3. Normalization:
    4. script normalization:全形/半形、Devanagari vs Latin transliteration。
    5. lowercasing、去除標點與顯而易見的 noise。
    6. 多語 query 擴展(選配):
    7. 將 Hindi query 透過 LLM 翻成英文:किसानों को हर साल पैसे देने वाली योजना -> farmer yearly income support scheme,兩個版本都丟進檢索。

    實務上,一個簡單但有效的策略是:統一把查詢轉成英文+原語言兩個 view,分別檢索,再在 ranking 層融合。

    (3) Score Fusion / RRF:怎麼「穩健」地合併分數

    常見幾種做法:

    • 線性加權(BM25_score * α + dense_score * β + sparse_score * γ):
    • 問題:不同分數尺度差很大、對參數敏感,容易在某些 query 下完全偏向單一來源。
    • Reciprocal Rank Fusion(RRF):
    • 每個檢索器給一個排序,對某文件的融合分數是:

    [
    RRF(d) = \sum_{s \in \text{sources}} \frac{1}{k + rank_s(d)}
    ]

    • k 為平滑常數(常用 k=60),不用調很多權重,對不同 query 分布也比較穩。

    💡 關鍵: 使用 RRF 搭配 k=60 能在多種檢索來源之間提供穩健且低參數敏感度的排序融合。

    對多語 RAG,我會優先選 RRF 作為第一版融合策略,然後再針對特定語言或場景加權調整。


    實作範例

    以下用一個簡化架構示範:

    • OpenSearch:BM25 + sparse vector(透過插件或內建向量)做第一層 hybrid search。
    • Qdrant:dense embedding 的向量查詢與 rerank。

    1. OpenSearch 索引設定:文件 + 稀疏/密集向量

    PUT myscheme-schemes
    {
      "settings": {
        "analysis": {
          "analyzer": {
            "multilingual_analyzer": {
              "type": "custom",
              "tokenizer": "standard",
              "filter": ["lowercase", "stop_multilingual"]
            }
          },
          "filter": {
            "stop_multilingual": {
              "type": "stop",
              "stopwords": ["_english_", "_hindi_"]
            }
          }
        }
      },
      "mappings": {
        "properties": {
          "title": {
            "type": "text",
            "analyzer": "multilingual_analyzer"
          },
          "description": {
            "type": "text",
            "analyzer": "multilingual_analyzer"
          },
          "sparse_vector": {
            "type": "rank_features"
          },
          "dense_vector": {
            "type": "dense_vector",
            "dims": 768,
            "index": true,
            "similarity": "cosine"
          }
        }
      }
    }
    

    說明:

    • multilingual_analyzer 同時掛載英文和印地語 stopwords,但要注意不要過 aggressive(後面會講坑)。
    • sparse_vector 可以存像 SPLADE 這種模型產出的 token->weight,透過 rank_features 來用 BM25-like scoring。
    • dense_vector 用預先算好的多語 embedding,例如 Jina Embeddings / LaBSE / m3e。

    2. 查詢流程:先 ES hybrid,再 Qdrant rerank

    伪程式碼:

    def search_myscheme(query: str):
        lang = detect_language(query)  # fastText / LLM
        norm_query = normalize_query(query, lang)
    
        # 1. 產生 sparse + dense 查詢向量
        sparse_q = splade_encode(norm_query)   # 稀疏向量:token->weight
        dense_q = embed_multilingual(norm_query)  # 768-d 向量
    
        # 2. 在 OpenSearch 做 hybrid search
        es_res = es.search(
            index="myscheme-schemes",
            body={
                "size": 50,
                "query": {
                    "bool": {
                        "should": [
                            {"match": {"description": norm_query}},
                            {"rank_feature": {"field": "sparse_vector", "boost": 2}},
                            {
                              "script_score": {
                                "query": {"match_all": {}},
                                "script": {
                                  "source": "cosineSimilarity(params.query_vector, 'dense_vector') + 1.0",
                                  "params": {"query_vector": dense_q}
                                }
                              }
                            }
                        ]
                    }
                }
            }
        )
    
        # 3. 把 top-50 丟進 Qdrant 用 dense similarity 做 rerank
        points = [
            {"id": doc["_id"], "vector": doc["_source"]["dense_vector"]}
            for doc in es_res["hits"]["hits"]
        ]
    
        qdrant_res = qdrant.search(
            collection_name="myscheme_schemes",
            query_vector=dense_q,
            search_params={"hnsw_ef": 128},
            limit=10,
            # 可以在這邊實作 RRF 或線性融合
        )
    
        return qdrant_res
    

    如果想在單一 OpenSearch 裡就做 RRF,可以改成兩個子查詢各自出 top-k,再用 client 端做 RRF 合併。


    3. 在現有「只用 embedding」的 RAG 上漸進式升級

    典型現有流程:

    # 既有做法
    vec = embed(query)
    results = vector_db.search(vec, top_k=10)
    context = build_context(results)
    answer = llm.generate(prompt_with(context, query))
    

    漸進式升級建議:

    1. 第一步:加入 BM25 coarse recall
    2. 把 query 同時丟到 search engine:
      python
      bm25_results = es_bm25_search(query, top_k=50)
      dense_results = vector_db.search(embed(query), top_k=30)
      fused = rrf_fusion(bm25_results, dense_results, k=60)
    3. 第二步:換 dense 為 multilingual + 加入 sparse
    4. 把原本英語 embedding 換成多語模型,再用 sparse 模型(SPLADE)重建索引。
    5. 第三步:加入語言偵測與 normalization
    6. 先實作簡單版:detect → normalize(lowercase+簡單清洗)→ bilingual query expansion。

    💡 關鍵: 將現有「只用 embedding」流程按步驟加入 BM25、sparse 向量與語言偵測,可以在不重寫架構的情況下逐步提升召回與穩定度。

    每一步都要搭配線上或離線評估,避免「看起來很厲害但實際沒有變好」。


    建議與注意事項

    1. 多語 stopwords 與錯誤分詞

    • 坑 1:停用詞把關鍵字吃掉
    • 多語 stopwords 列表往往過於粗糙,像 Hindi 裡有些詞在政府文本是關鍵字,在口語查詢卻被錯當停用詞。
    • 建議先用 統計 + 標註樣本檢查停用詞對召回的影響,必要時為特定欄位(如 title)使用較少的停用詞。

    • 坑 2:錯誤分詞導致 BM25 完全失效

    • 非空白分隔語言(中文、某些印度語)如果切錯字,BM25 的詞頻意義直接失真。
    • 解法:用 適語言分詞器(jieba、HanLP、Indic NLP),或在部分欄位改用 n-gram 分詞降低風險。

    2. 長文本切片策略:token 限制下如何不破壞語義

    混合檢索遇到長文件(例如政策全文)時,常見坑是:

    • chunk 切太細,BM25 還能找得到,但 dense embedding 像是記憶碎片,語義不完整。
    • chunk 切太粗,dense 相似度還好,但 BM25 命中的字詞被大量無關文本稀釋,排序變差。

    建議策略:

    • 以 語段(paragraph)或條款為單位切片,長度控制在 200–400 tokens。
    • 每個 chunk 保留 標題 / 小節名,讓 lexical 的命中不只在正文。
    • 如果有政策層級結構,建立 hierarchical RAG:先檢索 policy,再在 policy 下檢索條款。

    3. 標註與線上 A/B:怎麼確認 recall 真的變好

    不要只看「LLM 回答看起來比較合理」,要量化:

    1. 離線標註:
    2. 從真實 query(或合成 query)抽樣,為每個 query 標註「有用的文件 ID」。
    3. 比較純 BM25、純 dense、hybrid 在 top-k 的 Recall@k / MRR / nDCG。

    4. 線上 A/B:

    5. 對真實使用者流量,隨機分流到 dense-only vs hybrid pipeline。
    6. 收集:
      • 使用者是否點選推薦方案。
      • 是否更快完成查詢(減少反覆搜尋)。
    7. 避免只用主觀「好像比較好」,用行為指標判斷。

    4. 架構選型:小團隊 vs 大型系統

    • 小團隊 / MVP 階段:
    • 優先選一個支援向量的 search engine(OpenSearch + k-NN plugin / Elasticsearch + vector)。
    • 提示重點:一個 index 同時存 text + sparse + dense,client 端做 RRF fusion 就足夠支撐絕大部分 RAG 應用。

    • 大型系統 / 高流量服務:

    • 分層:
      • Tier 1:search engine 做 BM25 + sparse coarse recall(top-100~200)。
      • Tier 2:向量資料庫(PGVector / Qdrant / Milvus)做 dense rerank + optional cross-encoder。
    • 好處:
      • 可以針對不同語言、資料域調不同策略,如 Hindi 專用索引、英語專用索引再做 union。
      • 資源隔離:檢索與 rerank 分別 scale。

    核心結論:在多語、口語化場景下,單一檢索技術不夠可靠。把 BM25、稀疏向量和密集向量結合,搭配語言偵測與穩健的 score fusion(如 RRF),可以在不大改現有 RAG 架構的前提下,顯著提升查詢召回與答案穩定度。對已經在用「只用 embedding」的專案來說,這是一條可漸進落地的技術升級路線,而不是重寫整套系統。


    🚀 你現在可以做的事

    • 在現有 RAG 專案中加入一個 BM25 搜尋來源,並用 RRF(k=60) 與 dense 結果融合測試效果
    • 選定一個多語 embedding 模型(如 LaBSE 或 m3e),為核心資料集建立 dense_vector 欄位
    • 抽樣實際使用者查詢,標註「關鍵文件 ID」,離線比較 dense-only 與 hybrid pipeline 的 Recall@k
  • 從 RLHF 到 Agentic RL:讓 Agent 真正會做事

    從 RLHF 到 Agentic RL:讓 Agent 真正會做事

    📌 本文重點

    • RLHF 只優化單輪輸出,不管整體任務
    • Agentic RL 把產品流程當決策過程來學
    • 先設環境與 reward,再收集軌跡做離線 ranking
    • 安全疊代要用 shadow run 與 sandbox 控制風險

    現有多數商用 LLM 都經過 RLHF 微調,所以模型看起來「很乖」,會照格式回答、會道歉、會避開風險。但當你要它接 CRM、排行程、幫客服真正自動處理問題時,常見狀況是:

    • 要嘛只完成第一步就說「完成了」
    • 要嘛在工具調用之間 瘋狂 loop,一直改 plan 不收斂

    💡 關鍵: RLHF 主要優化「單輪回答好不好看」,而不是整個多步流程是否真正完成任務。

    痛點就是:RLHF 只優化單輪輸出品質,沒有優化「整個任務流程」的長期回報。Agentic RL 的目的,就是把整個產品流程當成可學習的決策過程,讓 Agent 在真實業務環境裡學會:怎麼分解任務、怎麼多輪調用工具完成目標、怎麼在成本/風險下做權衡。


    重點說明

    1. RLHF 與 Agentic RL:優勢與侷限

    RLHF 做到的事:

    • 把基礎模型變成「有禮貌、守規則、對齊人類偏好」的聊天助手
    • 著重在單輪回合的回覆是否人類覺得好(helpful/harmless)

    但 RLHF 不做這些:

    • 不關心模型在一整個多步任務上的總表現(例如 10 步內完成退貨流程)
    • 不優化工具使用策略:什麼時候查 DB、什麼時候寫 note、什麼時候結束

    Agentic RL 多做的事:

    • 把 Agent 放在明確定義的 環境(API、DB、外部系統)裡學習
    • 用 任務分解 + 規劃 + 行動–觀察–反饋迴圈 來建模整個流程
    • 以「長期回報」作為訓練目標:成功率、成本、風險、用戶滿意度

    💡 關鍵: Agentic RL 的訓練目標是整個 episode 的「長期回報」,而不是單一回答的文句品質。


    2. 把真實產品抽象成可訓練的 MDP

    你要做的,是把現有產品流程抽象成一個 MDP / 決策流程:

    • 狀態(state):Agent 目前看到的上下文 + 工具回傳 + 用戶狀態
    • 例:客服場景 = 聊天紀錄 + 工單狀態 + CRM 查詢結果
    • 行動(action):Agent 可以做什麼工具調用/決策
    • 例:CALL_SEARCH_TICKET, UPDATE_CRM_FIELD, SEND_REPLY, CLOSE_CASE
    • 轉移(transition):環境如何回應(API response / 用戶反應)
    • 回報(reward):最後有沒有解決問題?是否超時?是否誤操作?

    核心是:先把整個流程 formalize 成可以重放的環境,你就能:

    1. 收集真實軌跡(trajectory)
    2. 在離線環境重放並評分
    3. 用 bandit / RL 訊號挑策略,而不是只看「模型句子好不好看」

    3. Agentic RL 的基本構成

    在工程上,你可以簡化為四個組件:

    1. 環境建模:統一封裝所有工具、API、資料庫,形成一個 Environment 介面
    2. 任務分解與規劃:讓模型先產生高階 plan,再逐步執行(而不是一口氣亂調用工具)
    3. 行動–觀察–反饋迴圈(loop):每一步都記錄 (state, action, observation, reward)
    4. 長期回報設計:不是只有「這句回覆好不好」,而是「整個 episode 是否達成業務目標」

    常見場景:

    • 自動化客服:episode = 一次工單的完整處理
    • 研究代做:episode = 從 query 到交付報告的完整流程
    • 程式碼 refactor:episode = 一次 PR 的修改 + 測試 + 說明
    • 電話 / 日程代理:episode = 一次預約成功或明確被拒絕

    實作範例:簡化版 CRM Agent + 軌跡記錄

    以下是一個極簡化的 Python 範例,示範:

    • 用 GPT 類模型(假設有 chat_completion API)當 policy
    • 外面包一層 Environment,提供 search_customer / update_crm 兩個工具
    • 用簡單 reward:更新成功 + 回覆合理 = 高分
    • 記錄軌跡(trajectory),再用 bandit 式 ranking 挑出較佳策略
    import uuid
    from typing import List, Dict, Any
    
    # ===== 環境定義 =====
    
    class CRMEnvironment:
        def __init__(self, crm_client):
            self.crm = crm_client
    
        def step(self, state: Dict[str, Any], action: Dict[str, Any]):
            """
            action 的結構示例:
            {
              "type": "tool" | "respond" | "finish",
              "tool_name": "search_customer" | "update_crm",
              "params": {...},
              "reply": "給使用者的訊息"
            }
            """
            obs, reward, done = {}, 0.0, False
    
            if action["type"] == "tool":
                if action["tool_name"] == "search_customer":
                    obs["customer"] = self.crm.search(action["params"]["email"])
                elif action["tool_name"] == "update_crm":
                    success = self.crm.update(
                        customer_id=action["params"]["id"],
                        fields=action["params"]["fields"],
                    )
                    obs["update_success"] = success
            elif action["type"] == "respond":
                # 實際上這裡會寫入聊天系統
                obs["reply_ack"] = True
            elif action["type"] == "finish":
                done = True
    
            # 這裡只示意:如果更新成功且已 finish,給正向 reward
            if obs.get("update_success") and action["type"] == "finish":
                reward = 1.0
            return obs, reward, done
    
    
    # ===== Policy(LLM Agent) =====
    
    def llm_policy(model, state: Dict[str, Any]) -> Dict[str, Any]:
        """使用 LLM 決定下一步 action。"""
        system_prompt = """你是一個 CRM 自動化代理,
        只能使用以下操作:search_customer(email), update_crm(id, fields), respond(user_message), finish。
        請一步一步完成查詢客戶並更新 CRM,最後用 finish 結束。
        請以 JSON 輸出下一步 action。
        """
    
        messages = [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": state["task_description"]},
            {"role": "assistant", "content": str(state["history"])},
        ]
    
        resp = model.chat_completion(messages=messages)
        # 假設模型已被 prompt 成只輸出 JSON
        action = resp.to_json()  # pseudo-code
        return action
    
    
    # ===== 執行 episode 並記錄軌跡 =====
    
    def run_episode(env: CRMEnvironment, model, task_description: str):
        trajectory = []
        state = {"task_description": task_description, "history": []}
    
        for step_idx in range(10):  # 簡單防止無限 loop
            action = llm_policy(model, state)
            obs, reward, done = env.step(state, action)
    
            transition = {
                "state": state.copy(),
                "action": action,
                "obs": obs,
                "reward": reward,
            }
            trajectory.append(transition)
    
            # 更新 state
            state["history"].append({"action": action, "obs": obs})
    
            if done:
                break
        return trajectory
    
    
    # ===== 離線 ranking:挑選較佳策略 =====
    
    def offline_policy_ranking(trajectories: List[List[Dict[str, Any]]]):
        # 簡單 bandit:以 episode 總 reward 排序
        scored = []
        for traj in trajectories:
            total_r = sum(t["reward"] for t in traj)
            scored.append((total_r, traj))
        scored.sort(key=lambda x: x[0], reverse=True)
        return scored
    
    
    # 用法示意
    # env = CRMEnvironment(crm_client)
    # trajectories = [run_episode(env, model_v1, "請幫這位客戶更新聯絡電話") for _ in range(100)]
    # best_traj = offline_policy_ranking(trajectories)[0]
    # 接下來可以分析 best_traj 對應的 LLM prompt / hyperparameters,
    # 或作為離線 RL 資料再微調一個專用 Agent。
    

    這個範例刻意簡化幾件事,但核心工程訊息是:

    • 把 tools/環境封裝成獨立的 Environment,而不是讓 LLM 直接打 API
    • 每一步記錄 transition,為後續離線學習準備資料
    • 先從 offline policy ranking / bandit 開始,不必一上來就做 policy gradient

    💡 關鍵: 即使只用簡單的 bandit 排序,你也能開始選擇「整體流程表現更好」的策略,而不只是調句子風格。


    建議與注意事項

    1. Reward 設計:避免「為了拿高分做壞事」

    常見 reward 組合:

    • 成功率:工單是否完成、預約是否成功
    • 用戶滿意度:CSAT、NPS、或簡化為「無投訴 + 無人工接管」
    • 成本:API 次數、模型 token 消耗、處理時間
    • 風險:是否觸碰敏感欄位、是否違反合規(GDPR、PCI 等)

    做法建議:

    • 用線性組合:reward = w1*success - w2*cost - w3*risk
    • 對某些行為設硬性負 reward:如改動金融數據、刪除客戶資料
    • 對「過度延長對話」「工具瘋狂重試」設懲罰,避免 loop 不收斂

    2. 常見坑

    • 代理重覆 loop 不收斂:
    • 沒有明確的 finish 條件 或 max_step 限制
    • reward 沒有懲罰冗長或失敗重試

    • sim2real 落差:

    • 在模擬環境學到的策略,放到 production 會因 API latency、錯誤率全變樣
    • 建議:影子執行(shadow run) + 回放真實日誌,逐步縮小差距

    • reward hacking:

    • 代理學會「只更新容易成功的欄位」或「不碰難案」,表面成功率高但業務壞掉
    • 需對「長期未處理案件」、「人工接管頻率」給負向訊號

    • 日誌與隱私合規:

    • 軌跡中常含 PII、金融資訊
    • 務必:匿名化、遮罩敏感欄位、分區存放訓練資料,並設 access control

    3. 在 production 上安全疊代:如何不把系統玩壞

    可以參考 shadow run + 行為 diff 的模式:

    1. Shadow run:
    2. 新 Agent 在真實流量中「旁路」執行,但結果只記錄、不生效
    3. 比較新舊策略在同一批任務上的成功率、成本、風險

    4. 行為 diff(behavioral diff):

    5. 對同一 input,收集舊策略與新策略的完整軌跡
    6. 比較:action 分布、工具使用頻率、完成時間、錯誤率

    7. 限權 sandbox:

    8. 新策略只允許讀取/寫入 sandbox DB 或「模擬帳號」
    9. 在確認行為安全後,再逐步放開至真實資源

    10. Quota + kill switch:

    11. 設定每分鐘/每天的最大任務數、最大危險操作數(如更新信用卡)
    12. 發現異常行為立即切回穩定策略或人工處理

    4. 如果你現在在做 Agent 產品,短期可以先做哪些「Agentic RL 化」?

    不需要一開始就上全套 RL pipeline,可以循序漸進:

    1. 收集軌跡:
    2. 先在現有 Agent loop 中,完整記錄 (state, action, obs, reward)
    3. reward 初期可以是簡化版:成功 / 失敗 / 人工接管 / 投訴

    4. 設計可重放環境:

    5. 把所有外部工具 access 透過統一的 Environment API 封裝
    6. 支援「重放模式」:用日誌中的 API response 而不打真實 service

    7. 離線 policy ranking / bandit:

    8. 用多種 prompt / temperature / tool-selection 策略跑同樣任務,離線評分
    9. 選出表現最好的作為新的 default policy,再進一步微調模型

    10. 逐步引入 RL 元件:

    11. 先做 Contextual Bandit:在不同任務類型選不同策略
    12. 再考慮 full RL:對整個 episode 的 policy 做梯度更新

    結論:如果你的 Agent 現在只是「很會聊天但不會做事」,優先事項不是再加更多工具,而是設計可重放的 environment、明確的 reward,開始收集軌跡並做離線 ranking。這就是從 RLHF 走向 Agentic RL 的第一步。


    🚀 你現在可以做的事

    • 盤點現有 Agent 流程,開始在每一步記錄完整 (state, action, obs, reward) 軌跡
    • 把所有外部 API/DB 操作封裝成統一的 Environment 介面,加入重放模式
    • 為代表性的任務場景設計一版簡單的長期 reward,做離線 policy ranking 來選策略
  • Google AX 多代理調度與網路隔離實戰

    Google AX 多代理調度與網路隔離實戰

    📌 本文重點

    • 將 Agent 視為 K8s Job 可利用現有雲原生能力
    • 單靠 LLM sandbox 不足,必須做 OS/網路層隔離
    • wire format 會吃掉 port 是「Agent Egress Illusion」關鍵風險
    • eBPF 或 sidecar proxy 可實作可驗證的 egress 控制

    在多代理(multi-agent)系統裡,真正麻煩的不是「叫一個 LLM 幫你想辦法」,而是如何安全地讓一堆有能力執行程式碼的 Agent,在企業網路裡被可靠調度、精準限權、可觀測且可驗證地被關起來。Google AX 給了一個值得抄的架構:把 Agent 當 Kubernetes Job 來排程,所有工具和憑證都以最小權限下放,同時嘗試提供精細網路出口控制——但也踩到一個 wire format 的安全坑。

    這篇文章會聚焦三件事:

    1. 設計層:為何要把 Agent 當 Job 調度、如何在企業環境做最小權限隔離。
    2. 實作層:以 AX 風格實作一個精簡版 Go agent runner,含 agent spec、network policy、執行沙盒 配置樣板。
    3. 資安與踩坑:解析「Agent Egress Illusion」中 port 資訊丟失 bug,示範用 eBPF 或 sidecar proxy 做真正可驗證的 egress 控制,以及應自動化的安全檢查。

    重點說明

    1. 為何把 Agent 當 K8s Job 調度?

    AX 的核心設計是:每個 Agent/任務就是一個可觀測、可重試的 Job,而不是一個長駐服務。這帶來幾個直接好處:

    • 資源隔離自然落在 Pod/Job 邊界:CPU / memory / volume / ServiceAccount 都用現有 K8s 原生能力。
    • 權限最小化更容易實作:不同工具/憑證綁在不同 Job template 上,下發時只給需要的那一份。
    • 重試與狀態同步內建:Job 狀態是可觀測事件流,AX 做的是把這些 event 封裝成 Agent 狀態機(state machine),方便 orchestrator 決策下一步。

    對你的專案來說,這代表:

    • 不用自己重新發明一套 job scheduler,照 K8s Job 範式套一層 Go orchestration 即可。
    • 多 Agent 協作 = 多 Job 工作流,你可以在 Go 裡用 DAG / state transition 描述整個流程。

    💡 關鍵: 把每個 Agent 當一次性 Job,可直接沿用 K8s 的資源隔離與重試機制,避免重造 scheduler 輪子。

    2. AX-style Agent Spec 與精細網路控制

    AX 用一個類似「AgentSpec」的結構描述每個 Agent:

    • 要跑的 tool image / command
    • 限制的 network egress 規則(domain / IP / port)
    • 授權的 secrets / credentials

    它宣稱可以做到「精細網路出口控制」,但在 wire format 的 protobuf/JSON 中,port 資訊沒被帶到真正執行的層級,導致你以為只開 443,實際上所有 port 都能出去,這就是「Agent Egress Illusion」。

    這個教訓是:

    • 不要只相信 API 層的 policy,必須驗證到 socket 層。
    • 對自己寫的 orchestrator,要有「從 UI → spec → wire → kernel」的完整 trace,確認資訊沒有在中途被丟失或過度簡化。

    3. 為何單憑 LLM sandbox 不夠?

    LLM sandbox 做的通常是:

    • 限制 prompt 能呼叫哪些工具
    • 限制工具的參數範圍

    但實務上常見攻擊路徑是:

    • 反向殼層(reverse shell)回到攻擊者機器
    • 內網掃描打開更多攻擊面
    • 泄漏環境中的 API key / DB credentials

    這些都不會被「prompt-sandbox」阻止,只有 OS / network layer 的硬性隔離才有用:namespace、cgroup、iptables、eBPF、sidecar proxy 等。


    實作範例:精簡版 AX-style Agent Runner(Go)

    下面是一個簡化示意,展示如何在自己專案做一個 AX 風格的調度層。重點在 AgentSpec、NetworkPolicy、以及 runner 如何執行與觀測。

    1. 定義 Agent Spec 與 Network Policy

    // AgentSpec 描述一個可被調度的 Agent 任務
    type AgentSpec struct {
        ID      string
        Image   string
        Command []string
        Env     map[string]string
    
        Network NetworkPolicy
        Secrets []string // reference to secret IDs
    }
    
    // NetworkPolicy 為每個 Agent 定義 egress 規則
    type NetworkPolicy struct {
        AllowedDestinations []DestinationRule
    }
    
    type DestinationRule struct {
        Host  string // example.com or 10.0.0.0/24
        Port  int    // 0 表示任何 port(強烈不建議在生產環境使用)
        Proto string // tcp/udp
    }
    

    這個 Spec 可以直接當成你自己的 API 層 contract。關鍵是:

    • 不要在任何一層「自動忽略」Port,即使使用者沒填,也要在 schema 上明確設定預設值與含義。
    • 在轉成 wire format(JSON / protobuf)時,保證欄位不被省略。

    2. Runner:把 Agent Spec 下放到 Worker 節點

    下例示範一個最小可用 runner:從 queue 拿到 AgentSpec,spawn 一個 container(可以是 K8s Job、或本機用 container runtime)並附帶 network policy:

    type Runner struct {
        // 抽象的 container 執行介面,可以是 K8s client,也可以是本機 Docker
        Exec ExecBackend
    }
    
    type ExecBackend interface {
        Run(spec AgentSpec) (RunHandle, error)
    }
    
    // K8sJobBackend 是一個以 K8s Job 為基礎的實作
    type K8sJobBackend struct {
        // kube client, omitted
    }
    
    func (b *K8sJobBackend) Run(spec AgentSpec) (RunHandle, error) {
        job := BuildK8sJobFromAgent(spec)
    
        // 將 NetworkPolicy 轉成 K8s NetworkPolicy 或 CNI 插件規則
        np := BuildNetworkPolicyFromAgent(spec)
    
        // 建議:先創 NetworkPolicy,再創 Job
        if err := b.applyNetworkPolicy(np); err != nil {
            return RunHandle{}, err
        }
        if err := b.createJob(job); err != nil {
            return RunHandle{}, err
        }
    
        return RunHandle{ID: spec.ID}, nil
    }
    

    其中 BuildNetworkPolicyFromAgent 是重點,用來把 AX-style 的 egress 規則真正落到 K8s 或底層 CNI:

    func BuildNetworkPolicyFromAgent(spec AgentSpec) *netv1.NetworkPolicy {
        // 示意:將每個 DestinationRule 轉為 egress rule
        // 注意:K8s NetworkPolicy 的 port 是獨立欄位,不能在轉換時丟掉
    }
    

    如果你不想依賴 K8s NetworkPolicy,也可以直接用 sidecar proxy 控制:

    • 為每個 Agent Pod 加一個 envoy/mitmproxy sidecar。
    • 在 sidecar config 中生成 per-Agent egress ACL。

    3. 觀測與狀態同步

    AX 的設計亮點之一是狀態同步與觀測。你可以在 runner 裡加上一層事件流:

    type AgentStatus string
    
    const (
        StatusPending AgentStatus = "PENDING"
        StatusRunning AgentStatus = "RUNNING"
        StatusSuccess AgentStatus = "SUCCESS"
        StatusFailed  AgentStatus = "FAILED"
    )
    
    type StatusStore interface {
        Update(id string, status AgentStatus, meta map[string]string) error
    }
    
    func (r *Runner) RunAndWatch(spec AgentSpec, store StatusStore) error {
        handle, err := r.Exec.Run(spec)
        if err != nil {
            return err
        }
    
        store.Update(spec.ID, StatusRunning, nil)
    
        go func() {
            result := handle.Wait()
            if result.Err != nil {
                store.Update(spec.ID, StatusFailed, map[string]string{"error": result.Err.Error()})
            } else {
                store.Update(spec.ID, StatusSuccess, nil)
            }
        }()
    
        return nil
    }
    

    這樣你即可在前端或控制平臺上,實時看到每個 Agent 的狀態,並進行工作流編排(例如下一個 Agent 只有在上一個成功時才啟動)。


    資安與踩坑:Agent Egress Illusion 與真正可驗證的控制

    1. Agent Egress Illusion:port 資訊在 wire format 被吃掉

    簡化來說,問題長這樣:

    1. Config / UI 層支援 host+port,例如:example.com:443。
    2. Spec 序列化成 wire format(JSON / protobuf)時,只保留 example.com,port 被 default 掉(例如 0 或空)。
    3. 執行層的 network module 把「空 port」解讀為「any port」。

    結果:你以為自己寫了 allow example.com:443,實際執行的是 allow example.com:*,甚至 allow *:*。

    避免同樣踩坑,最實際的做法是:

    • 在 schema 層面強制 port 必填或有明確預設邊界(例如只允許 80/443)。
    • 在 wire / decode 層加 結構化驗證:任何 Host 沒設定 Port 就拒絕部署。
    • 寫端到端測試,驗證「指定 port 不同時,實際 socket 行為不同」。

    💡 關鍵: 只要 port 在序列化或 decode 過程被默默 default,實際執行的網路權限就會遠超過 UI 上看到的設定。

    2. 用 eBPF 做真正可驗證的 egress 控制

    在 Linux 上,可以用 eBPF 寫一段針對 connect() 的 hook,根據 Agent ID + 目的 host/port 做精細控制。示意邏輯(偽 C):

    int sock_connect(struct bpf_sock_addr *ctx) {
        __u16 dport = bpf_ntohs(ctx->user_port);
        struct agent_policy *policy = lookup_policy_for_current_pid();
    
        if (!policy) return 0; // 無 policy 的情況下可選擇允許或拒絕
    
        if (!policy_allows(policy, ctx->user_ip4, dport)) {
            return -EPERM; // 直接阻擋
        }
        return 0;
    }
    

    然後在 Go runner 裡,為每個 Agent 產生對應的 eBPF policy map:

    func InstallEBPFPolicy(agentID string, net NetworkPolicy) error {
        // 1. 將 AgentID 映射到一個 cgroup 或 pid namespace
        // 2. 將 DestinationRule 寫入 eBPF map
        return nil
    }
    

    這樣你可以做到:

    • policy 與 socket 在同一層被驗證,不再依賴高層配置是否完整。
    • 可以收集 eBPF 事件,作為 shadow env 觀測:任何違反 policy 的連線都會被紀錄,甚至被 fuzz 測試工具捕捉。

    3. Sidecar Proxy 方案(較好上手)

    如果 eBPF 對團隊太重,你可以選擇 sidecar proxy:

    • 每個 Agent Pod 都透過 sidecar 發出所有外部連線。
    • AX-style NetworkPolicy 轉成 proxy 的 ACL:
    # envoy filter pseudo config
    - name: agent-egress-filter
      typed_config:
        allowed_destinations:
          - host: example.com
            port: 443
          - host: api.internal
            port: 8443
    

    對開發者來說,這個方案的優點是:

    • 配置全部在 user space,容易 debug。
    • 可以在 staging 做 policy fuzzing:自動產生隨機目標,確認 proxy 確實阻擋。

    建議與注意事項

    1. 三件必做的自動化安全檢查

    1. 端到端 egress 測試:
    2. 建一個專門的 Agent,用來嘗試從各種 host/port 打出去。
    3. CI 裡檢查:不應該開放的目標全部連線失敗。

    4. policy fuzzing:

    5. 針對你的 NetworkPolicy 模組,用模糊測試工具產生多組 host/port 組合,確認 decode / merge 過程不會產生意外的「any port」。

    6. shadow env 觀測:

    7. 在 staging/灰度環境,把所有 egress 事件打到一個集中 log。
    8. 針對異常 pattern(例如 Agent 對內網 IP 連線)設 alert。

    2. 多代理環境常見安全誤區

    • 只做 prompt 限制不做網路限制:LLM 只要能呼叫 bash 或 python,就能繞過任何 prompt policy。
    • 所有 Agent 共用一組 API key 或 ServiceAccount:一旦有 Agent 被利用,就等於全網被打開。
    • 忽略內網掃描:很多團隊只防外聯,不防 Agent 對內網執行 nmap/port scan,結果是 lateral movement 更容易。

    實務建議:

    • 每個 Agent 類型一個 最小權限 ServiceAccount,不要共用。
    • 有寫檔需求的 Agent,只給 只讀/只寫的特定 volume,避免觸及主機檔案系統。
    • 將所有 egress 限制在白名單 domain,而不是黑名單。

    💡 關鍵: 多代理環境的核心風險在橫向移動與憑證濫用,因此需以最小權限帳號和白名單 egress 為設計預設。

    3. 如何在現有專案落地 AX-style 架構

    • 已有 K8s:
    • 直接定義自己的 Agent CRD + Controller,用上文的 AgentSpec 當 schema,K8s Job 當執行層。
    • 接上 NetworkPolicy 或 sidecar proxy,做 per-Agent egress。

    • 沒有 K8s、純 VM/裸機:

    • 用 Go Runner + container runtime(Docker / containerd),以 namespace + iptables 或 eBPF 做隔離。
    • 同樣透過 AgentSpec 描述任務,確保 spec → runtime 的 mapping 可觀測。

    核心結論:

    • 把 Agent 當 Job 調度,可以用現有雲原生堆疊快速搭起可擴充的多代理平臺。
    • LLM sandbox 絕對不夠,必須有實體網路與系統層的防護,並且用 eBPF 或 sidecar 這類「可驗證」的手段落實。
    • 在設計 Agent 平臺時,wire format 不可忽視,任何欄位(尤其是 port)一旦在序列化過程中被吃掉,就會變成下一個「Agent Egress Illusion」。

    🚀 你現在可以做的事

    • 在現有專案中定義一個 AgentSpec 結構,試著用 K8s Job 或 Docker 實作最小可用 runner
    • 為某個測試 Agent 建立白名單 egress 規則,實驗一版 sidecar proxy 或 NetworkPolicy 的落地做法
    • 寫一個簡單的 egress 測試 Agent,加入 CI 流程,驗證你的網路策略沒有出現「any port」的隱形放寬
  • 3.7 萬生命科學 AI Agent 架構與治理實作

    3.7 萬生命科學 AI Agent 架構與治理實作

    📌 本文重點

    • 企業優先採集中式 Orchestrator 架構
    • 機構記憶分層是合規與治理核心
    • 推理層治理讓多代理決策可追溯

    斯坦福用約 37,000 個生命科學 AI Agent 模擬完整藥物研發流程,背後其實解決了幾個你在企業落地多代理系統時一定會遇到的痛點:

    1. 大量 Agent 的角色分工與任務編排很容易失控變成「亂聊」與重複計算。
    2. 上下文與機構記憶(Institutional Memory)若沒設計好,結果不是錯就是無法追溯責任。
    3. 沒有推理層治理(reasoning-layer governance),就算所有 Agent 都有 log,也很難回答:這個決策到底是怎麼被做出來、誰負責。

    下面從架構到治理拆解這個案例,並給出可以直接套用到企業內的大規模 Agent 實作建議。


    重點說明

    1. 多代理架構:集中式 Orchestrator vs 去中心化協作

    在斯坦福案例與企業場景中,你大致有兩種架構選擇:

    • 集中式 Orchestrator:一個核心服務(或少數幾個)負責:
    • 任務分解:把「藥物發現」拆成靶點鑑定、ADMET 分析、臨床試驗設計等子任務。
    • Agent 指派:依角色與技能分配任務。
    • 結果整合與審核:負責決策鏈的組裝與治理介面。
    • 去中心化協作:各 Agent 透過共享記憶與協作協議自行形成工作流,例如:
    • ProjectAgent 發起任務。
    • DomainAgent(臨床統計、藥理學、法規)透過訂閱特定 Topic 自主加入。

    實務建議:

    • 在企業內落地大規模 Agent,90% 情況先用集中式 Orchestrator,因為:
    • 權限、合規與審核路徑好管控。
    • 錯誤與成本可聚焦在少數 orchestrator 節點。
    • 去中心化協作比較適合:
    • 研究環境或內部沙盒。
    • 對容錯要求高、但對審核延遲容忍度也高的場景。

    💡 關鍵: 企業導入多代理系統時,集中式 Orchestrator 能在 90% 場景中兼顧效率與合規,是安全的預設架構選擇。

    2. 機構記憶與上下文管理:從「文件庫」變成「治理介面」

    V7 的作法很關鍵:用 GPT-5.6 建構機構記憶層,讓 Agent 不是直接查文件,而是查「已治理過的組織知識」。實務上可以拆成三層:

    1. Raw Data Layer:原始文件、臨床試驗報告、SOP、法規文本。
    2. Semantic Memory Layer:針對每個實體建立結構化節點,例如:
    3. DrugCandidate、ClinicalTrial、RegulatoryConstraint、RiskAssessment。
    4. Governed Context Layer:每次 Agent 調用記憶時,同時附上:
    5. 來源追蹤(source-link)。
    6. 認可版本(例如 SOP v3.2)。
    7. 責任人/審核狀態(已審核/草稿)。

    好處:

    • 生命科學與藥物研發高度受監管,機構記憶層就是你的合規邊界,能避免 Agent 誤用過期或未審核的資料。
    • 在多代理場景中,所有 Agent 都從同一個治理過的記憶層取用上下文,避免「各自一套事實」。

    💡 關鍵: 把資料拆成 raw / semantic / governed 三層,等於在技術架構裡直接內建合規邊界與責任追溯能力。

    3. 推理層治理:把「思考過程」變成可審核資產

    37,000 Agent 能在一週分析 50,000+ 臨床試驗,真正需要治理的不是輸出,而是「決策鏈」。

    所謂 reasoning-layer governance,核心是:

    • 每個 Agent 的推理過程都要具備:
    • 可結構化記錄:例如 chain-of-thought 的摘要,而不是一堆自然語言 log。
    • 上下游關聯:知道這個結論引用了哪個前一步 Agent 的結果。
    • 治理鉤子(hooks):可以插入審核、風險評估、policy check。

    在生命科學場景中,這直接對應到:

    • 你能回答「這個臨床試驗設計,是基於哪些風險評估與模型輸出」。
    • 審核者可以對整條推理鏈做 spot-check,而不是只看最後報告。

    💡 關鍵: 把每一步推理結構化記錄並串成決策鏈,讓多代理系統不再是黑盒,而是可審核、可問責的工程資產。


    實作範例

    下面用一個簡化的「虛擬生技公司」示意多代理系統:

    • Orchestrator:負責任務分解與決策鏈管理。
    • TargetAgent:負責藥物靶點鑑定。
    • TrialDesignAgent:負責臨床試驗設計。
    • GovernanceAgent:負責推理層治理與合規檢查。

    1. Agent 設計與角色分工

    # pseudo-code: Agent 定義
    
    class BaseAgent:
        def __init__(self, name, llm_client, tools=None):
            self.name = name
            self.llm = llm_client
            self.tools = tools or []
    
        async def run(self, task, context):
            # task: 結構化的任務描述
            # context: 來自機構記憶的治理過資訊
            raise NotImplementedError
    
    
    class TargetAgent(BaseAgent):
        async def run(self, task, context):
            prompt = f"""
            你是一位生物資訊學專家,負責藥物靶點鑑定。
            請在考慮以下已審核資料的前提下,提出 3 個候選靶點:
            {context['governed_knowledge']}
            任務描述:{task['description']}
            請輸出 JSON,包含: target_id, rationale, evidence_sources。
            """
            resp = await self.llm.chat_completion(
                model="gpt-5.6",
                messages=[{"role": "user", "content": prompt}],
                response_format={"type": "json_object"}  # **重要參數**
            )
            return resp
    
    
    class TrialDesignAgent(BaseAgent):
        async def run(self, task, context):
            # 依據 TargetAgent 的輸出設計臨床試驗
            # context 中包含 target_candidates 與對應證據
            prompt = f"""
            你是一位臨床試驗設計專家。
            參考以下候選靶點與證據,設計一個一期臨床試驗:
            {context['target_candidates']}
            請輸出 JSON,包含: design_summary, inclusion_criteria, endpoints。
            """
            resp = await self.llm.chat_completion(
                model="gpt-5.6",
                messages=[{"role": "user", "content": prompt}],
                response_format={"type": "json_object"}
            )
            return resp
    

    2. Orchestrator:任務編排與上下文治理

    class Orchestrator:
        def __init__(self, memory_client, governance_agent):
            self.memory = memory_client  # 例如: **InstitutionalMemoryAPI**
            self.gov = governance_agent
    
        async def run_drug_program(self, program_id):
            # 1. 從機構記憶取得已審核上下文
            governed_ctx = await self.memory.get_context(
                entity_type="DrugProgram",
                entity_id=program_id,
                min_review_status="approved"  # **重要參數**
            )
    
            # 2. 呼叫 TargetAgent
            target_task = {"description": "為此適應症尋找新的靶點"}
            target_result = await TargetAgent.run(target_task, {
                "governed_knowledge": governed_ctx
            })
    
            # 3. 把推理層資訊寫入治理記錄
            await self.gov.log_reasoning_step({
                "agent": "TargetAgent",
                "input_context_id": governed_ctx["context_id"],
                "output": target_result,
                "program_id": program_id
            })
    
            # 4. 呼叫 TrialDesignAgent
            trial_task = {"description": "設計一期臨床試驗"}
            trial_result = await TrialDesignAgent.run(trial_task, {
                "target_candidates": target_result
            })
    
            await self.gov.log_reasoning_step({
                "agent": "TrialDesignAgent",
                "input_from_agent": "TargetAgent",
                "output": trial_result,
                "program_id": program_id
            })
    
            return {
                "targets": target_result,
                "trial_design": trial_result
            }
    

    3. 推理層治理:審核與追蹤介面

    class GovernanceAgent(BaseAgent):
        async def log_reasoning_step(self, record):
            # 寫入治理資料庫
            # 典型欄位: agent, input_refs, output_hash, risk_score, reviewer_required
            step = {
                "agent": record["agent"],
                "program_id": record["program_id"],
                "input_refs": {
                    "context_id": record.get("input_context_id"),
                    "from_agent": record.get("input_from_agent"),
                },
                "output": record["output"],
                "output_hash": hash(str(record["output"])),
                "risk_score": await self.assess_risk(record),  # **推理層治理**
            }
            # TODO: 寫入 DB
            return step
    
        async def assess_risk(self, record):
            # 基於使用的資料類型、適應症與試驗階段估算風險
            prompt = f"""
            你是一位合規與風險評估專家。
            請根據以下資訊評估此推理步驟的風險高低 (0-1):
            {record}
            只輸出一個浮點數。
            """
            resp = await self.llm.chat_completion(
                model="gpt-5.6",
                messages=[{"role": "user", "content": prompt}],
                temperature=0.0  # **重要參數:治理步驟建議設為 0**
            )
            return float(resp.choices[0].message.content)
    

    這樣的實作讓每個 Agent 的輸出都被包裝成可追蹤的推理步驟,後續你可以做:

    • 審核介面:按 program_id 拉出整條推理鏈。
    • 合規檢查:對高風險步驟強制需要人審或二次模型(secondary model)覆核。

    4. 避免「自我強化錯誤」的工具調用設計

    自我強化錯誤(self-reinforcing error)的典型模式:

    • Agent A 做出錯誤結論 → 寫入機構記憶 → Agent B 引用成「既定事實」→ 再被更多 Agent 使用 → 錯誤逐步固化。

    實務上可以在工具設計與決策鏈上加入 寫入前治理:

    async def safe_write_to_memory(entity_type, payload, source_agent, gov_agent):
        # 1. 先用 GovernanceAgent 做一致性與風險檢查
        risk = await gov_agent.assess_risk({
            "agent": source_agent,
            "payload": payload,
            "entity_type": entity_type
        })
    
        if risk > 0.7:
            # 高風險內容不能直接寫入正式機構記憶,只能進入待審區
            return await memory_client.write(
                space="staging",
                entity_type=entity_type,
                data=payload,
                tags=["pending_review", f"source:{source_agent}"]
            )
    
        # 2. 低風險內容才寫入正式 space
        return await memory_client.write(
            space="governed",
            entity_type=entity_type,
            data=payload,
            tags=["approved_by_model", f"source:{source_agent}"]
        )
    

    關鍵點:所有 Agent 的工具調用(尤其是寫入機構記憶)需經過治理層的 gate,不要讓 Agent 直接決定什麼變成「事實」。


    建議與注意事項

    1. 架構選擇

    • 企業導入大規模 Agent,優先選擇:
    • 集中式 Orchestrator + 去中心化記憶層:執行路徑單一,治理容易,但知識可以由多 Agent 持續補充(經治理 gate)。
    • 若未來要轉向去中心化協作,預先:
    • 把任務編排寫成顯式 DSL 或 workflow 定義,例如 YAML/JSON,而不是埋在程式邏輯裡,便於遷移到消息總線或 Agent Mesh。

    2. 資料來源與訓練數據合規

    • 生命科學場景務必:
    • 把資料切分成至少三個空間:raw, staging, governed。
    • 僅使用 governed 空間當作 Agent 的主要上下文來源。
    • 在 訓練數據 pipeline 也遵守同樣分層,避免未審核資料進入模型微調,導致系統性偏誤難以修正。

    3. 工具調用與決策鏈上的坑

    常見踩坑:

    1. 工具返回未標註來源:
    2. 坑:Agent 無法在推理層明確引用,導致理由模糊,人審時只能看「結果」,看不到「證據」。
    3. 建議:所有工具輸出都要包含 source_ids 或 evidence_links,並強制寫入治理記錄。
    4. 人類覆核與 Agent 推理混在一起:
    5. 坑:審核者會改結果但不改推理紀錄,造成 log 與真實狀態不一致。
    6. 建議:人類操作也經由 Governance API,當成一個 reasoning step,留存審核意見與修改理由。
    7. 治理層模型溫度設置錯誤:
    8. 坑:合規模型溫度過高(如 0.7),同一樣本有不同評估結果,導致政策執行不一致。
    9. 建議:所有 reasoning-layer governance 模型呼叫,統一 temperature=0.0,確保可重現。

    4. 對專案的實際好處

    • 在生命科學或類似高監管場景中,導入上述架構與治理層,可以:
    • 縮短研究與審核迴圈:讓 10+ 團隊共享同一套機構記憶與推理鏈路,不再重複爬資料與寫報告。
    • 降低合規風險:每個模型決策都有清楚來源與風險標註,出事時可以追根究柢。
    • 提高自動化上限:不是只自動化單一任務,而是可以安全地自動化整條藥物研發子流程,因為治理層為你兜底。

    整體來說,37,000 Agent 的生命科學實驗案例把多代理系統從「酷炫 demo」拉到「可以被審核與問責的工程系統」。如果你要在企業內導入大規模 Agent,上面提到的 集中式 Orchestrator、機構記憶分層、推理層治理鉤子以及防自我強化錯誤的寫入 gate,是值得一開始就納入架構設計的核心元件。

    🚀 你現在可以做的事

    • 盤點現有內部系統,畫出一個集中式 Orchestrator + 分層機構記憶的草圖架構
    • 在現有工具或 API 上,為所有「寫入知識庫」的操作加一層 GovernanceAgent 風險評估 gate
    • 用一個小型專案(如單一產品線)試做 raw/staging/governed 三層記憶與推理鏈記錄,驗證審核與追溯流程
  • 企業級 Agentic AI 落地技術戰略

    企業級 Agentic AI 落地技術戰略

    📌 本文重點

    • 先定 Agent 能力邊界與標準介面,再談擴張
    • 用 RBAC+資料分區避免 Shadow Agents 失控
    • 透過 trace、成本與回滾機制把 Agent 變成可營運系統
    • Prompt 只是策略層,規則與流程要結構化治理

    企業現在面臨的痛點不是「怎麼做出一兩個酷炫 Demo Agent」,而是如何把 Agentic AI 變成可治理、可觀測、可疊代的跨部門平台:可以安全連接內部系統、量化成效、避免 Shadow Agents 失控,同時不讓整個架構被一堆 prompt 綁死。

    以下從標準化介面、權限與安全、可觀測性與恢復機制三個技術面切入,並結合客服、財務、IT 運維場景,討論具體落地策略。


    重點說明

    1. 從「玩票 Agent」到「平台」:先定能力邊界,再定介面

    MIT Tech Review 指出,80% 的大型企業都有 Agent 試點,但多停留在孤立 PoC。要走到平台化,核心是:

    💡 關鍵: 多數企業已經在做 Agent 試點,但真正的差異在於能否從零散 PoC 升級為有標準介面與治理的「平台」。

    • 能力邊界 = 業務責任 + 技術能力:先定這個 Agent 負責哪段流程,而不是先想「讓它能做越多越好」。例如客服 Agent:僅負責「查詢訂單+生成回覆草稿」,不負責「修改付款狀態」。
    • 介面標準化:所有 Agent 都只透過標準化 Tool/Skill API接觸系統與資料,不直接操作底層服務。這是之後做權限控管、審計、成本管理的基礎。
    • 把 Prompt 從架構裡拆出來:Prompt 層只是策略配置,不是系統邏輯。不把「業務流程規則」寫死在 prompt,而是盡量下放到結構化配置與工具約束。

    2. 權限與安全:用 RBAC + 資料分區治理 Agent

    從 TechCrunch 曝露的「Agent swarm 不受控上網」案例可以看到:沒有明確安全模型的多代理系統,很容易長出 Shadow Agents——開發團隊自己私下接小工具、接新 API,完全不在統一治理之下。

    企業級 Agent 平台至少需要:

    • RBAC(Role-Based Access Control):先管「人」與「業務角色」,再管 Agent。Agent 的權限是由呼叫方的角色繼承,而不是 Agent 自己決定。「客服 Agent 被客服人員操作」,與「同一 Agent 被實驗帳號操作」,應視為兩個不同權限情境。
    • 資料分區(Data Partitioning):客服、財務、IT 運維 Agent 對同一套後端系統(例如 ERP)只看到各自分區。例如:財務 Agent 可查對帳資料,但不能查客服備註;IT Agent 可查系統狀態,但不能查客戶身份資訊。
    • 審計與技能治理:每一個 Tool/Skill 都必須有註冊流程、owner、風險等級、審計日誌。新工具不得直接進生產 Agent,而要經過安全審核與風險評估,避免 Shadow Skills 靜悄悄破壞邊界。

    3. 可觀測性與失敗恢復:從「跑起來」到「可營運」

    Towards AI 的經驗很直接:上線 LLM 功能很容易,讓它穩定運行才是難題。多代理系統更需要:

    💡 關鍵: 只有能追蹤每次任務的工具調用、token 成本與結果,你才有辦法把 Agent 變成可衡量、有 KPI 的正式能力。

    • Trace 全鏈路:每一個任務需要可以回溯「哪個 Agent → 用了哪些 Tool → 花了多少 tokens → 產生了什麼輸出」。這不只是 debug,而是之後算 KPI 的依據。
    • 成本與 KPI 對齊:紀錄每個 Agent 任務的token 成本、API 調用次數、成功率、平均處理時間,與業務 KPI(節省人力、縮短處理時間、減少錯誤率)直接對齊。避免盲目堆 Agent 卻無法證明價值。
    • 失敗恢復與回滾:任務不是「跑完就算了」,要有明確的任務狀態機 + 回滾策略:
    • 工單創建失敗要可重試
    • 財務 Agent 執行「修改憑證」要有 undo 行為
    • IT Agent 執行變更時需預先建立 rollback plan

    實作範例

    以下用一個簡化的「多部門 Agent 平台」示意,重點在介面與治理,而非特定框架。

    1. 標準化 Tool/Skill 介面

    先定一個統一 Tool 介面,所有 Agent 只能透過這個 interface 操作系統:

    // tool-definition.ts
    export type ToolContext = {
      userId: string;
      role: "customer_service" | "finance" | "it_ops";
      tenantId: string;
      traceId: string;
    };
    
    export type ToolInput = Record<string, unknown>;
    export type ToolOutput = Record<string, unknown>;
    
    export interface ToolDefinition {
      name: string;                     // 如 "create_ticket", "post_journal_entry"
      description: string;              // 給 LLM 用的清楚說明
      inputSchema: object;              // JSON Schema,用於驗證
      outputSchema: object;             // JSON Schema,用於驗證
      allowedRoles: string[];           // RBAC:哪些業務角色可用
      handler: (ctx: ToolContext, input: ToolInput) => Promise<ToolOutput>;
    }
    
    // 範例:客服工單建立工具
    export const CreateTicketTool: ToolDefinition = {
      name: "create_ticket",
      description: "為客戶建立客服工單,僅限客服角色使用",
      inputSchema: {
        type: "object",
        properties: {
          customerId: { type: "string" },
          subject: { type: "string" },
          priority: { type: "string", enum: ["low", "normal", "high"] },
        },
        required: ["customerId", "subject"],
      },
      outputSchema: {
        type: "object",
        properties: {
          ticketId: { type: "string" },
          status: { type: "string" },
        },
        required: ["ticketId", "status"],
      },
      allowedRoles: ["customer_service"],
      async handler(ctx, input) {
        // 在這裡做資料分區與權限驗證
        enforceTenant(ctx.tenantId);
        enforceRole(ctx.role, this.allowedRoles);
    
        const ticket = await TicketService.create({
          tenantId: ctx.tenantId,
          customerId: input.customerId as string,
          subject: input.subject as string,
          priority: (input.priority as string) ?? "normal",
          createdBy: ctx.userId,
          traceId: ctx.traceId,
        });
    
        auditLog({
          traceId: ctx.traceId,
          toolName: this.name,
          userId: ctx.userId,
          role: ctx.role,
          input,
          output: { ticketId: ticket.id, status: ticket.status },
        });
    
        return { ticketId: ticket.id, status: ticket.status };
      },
    };
    

    實際好處:

    • 所有 Agent 操作系統的入口一致,方便日後做審計與成本分析
    • 把業務邏輯(例如 tenantId、role 驗證)放在 Tool handler,而不是 prompt 裡,降低維護成本
    • 可以針對 Tool 做版本治理與安全審核,避免 Shadow Agents 私接非授權 API

    2. Agent 註冊與權限綁定

    建立 Agent 時明確綁定可用 Tool 與業務角色,避免「萬能 Agent」:

    // agent-registry.ts
    
    export type AgentProfile = {
      id: string;
      name: string;
      department: "customer_service" | "finance" | "it_ops";
      allowedTools: string[];     // 限定能用哪些 Tool.name
      maxTokensPerRun: number;    // 成本限制
      observability: {
        enableTrace: boolean;
        enableCostTracking: boolean;
      };
    };
    
    // 範例:客服 Agent
    export const CustomerServiceAgent: AgentProfile = {
      id: "agent_cs_01",
      name: "Customer Support Agent",
      department: "customer_service",
      allowedTools: ["create_ticket", "get_order", "suggest_reply"],
      maxTokensPerRun: 32_000,
      observability: {
        enableTrace: true,
        enableCostTracking: true,
      },
    };
    
    // 範例:財務 Agent(不能動客服工單)
    export const FinanceAgent: AgentProfile = {
      id: "agent_fin_01",
      name: "Finance Reconciliation Agent",
      department: "finance",
      allowedTools: ["get_invoice", "post_journal_entry", "run_reconciliation"],
      maxTokensPerRun: 48_000,
      observability: {
        enableTrace: true,
        enableCostTracking: true,
      },
    };
    

    實際好處:

    • 每個 Agent 有清楚「能力邊界」,便於對應部門 KPI 與風險評估
    • 可以在平台層實作 工具白名單,防止 Agent 任意調用未審核的 Skill
    • 有助於避免將所有需求堆成一個巨型 Prompt + 巨型 Agent,後期難以維護

    3. Trace、成本與回滾機制

    建立一個最小可用的任務執行管線,集中處理 trace、成本與任務狀態:

    // task-runner.ts
    
    type AgentTaskInput = {
      agentId: string;
      userId: string;
      role: ToolContext["role"];
      tenantId: string;
      goal: string;            // 高階任務描述
    };
    
    async function runAgentTask(input: AgentTaskInput) {
      const traceId = generateTraceId();
      const agentProfile = loadAgentProfile(input.agentId);
    
      const ctx: ToolContext = {
        userId: input.userId,
        role: input.role,
        tenantId: input.tenantId,
        traceId,
      };
    
      const tokenBudget = agentProfile.maxTokensPerRun;
      let tokenUsed = 0;
      const steps: Array<{ tool: string; input: ToolInput; output: ToolOutput }> = [];
    
      try {
        // 這裡可以接 OpenAI / 其他 LLM API
        const result = await runLLMAgent({
          goal: input.goal,
          tools: agentProfile.allowedTools.map(loadToolDefinition),
          context: ctx,
          onToolCall: async (toolDef, toolInput) => {
            const output = await toolDef.handler(ctx, toolInput);
            steps.push({ tool: toolDef.name, input: toolInput, output });
            return output;
          },
          onTokenUsage: (delta) => {
            tokenUsed += delta;
            if (tokenUsed > tokenBudget) throw new Error("Token budget exceeded");
          },
        });
    
        await saveTaskTrace({ traceId, agentId: input.agentId, steps, tokenUsed, status: "success" });
        return result;
      } catch (err) {
        await saveTaskTrace({ traceId, agentId: input.agentId, steps, tokenUsed, status: "failed", error: String(err) });
    
        // 任務回滾示意:對有副作用的工具,呼叫對應 undo
        await rollbackSideEffects(steps, ctx);
    
        throw err;
      }
    }
    
    async function rollbackSideEffects(steps, ctx: ToolContext) {
      for (const step of steps.reverse()) {
        const undoTool = loadUndoTool(step.tool); // 如 "undo_post_journal_entry"
        if (!undoTool) continue;
        await undoTool.handler(ctx, { originalOutput: step.output });
      }
    }
    

    實際好處:

    • 每次 Agent 執行都有完整 trace,可支援:
    • 事後審計(誰在什麼情境下做了什麼)
    • 成本分析(tokenUsed 與業務價值對比)
    • 失敗調查(步驟 / 工具調用序列)
    • 對所有有副作用的 Tool 都可以要求提供對應 undo Tool,讓變更可回滾,而不是把一切交給「LLM 自己想辦法」

    建議與注意事項

    1. 別堆 Agent,先定 KPI 與路線圖

    常見錯誤是:看到 Basis、Clay 這些 AI-native 公司用 Agent 做 onboarding、帳戶管理,就開始瘋狂做各種 Agent,卻沒有清楚 KPI。建議:

    💡 關鍵: 每個 Agent 至少要對應一組可以衡量的業務指標,否則很難在組織內持續爭取資源。

    • 每個 Agent 都要對應一個可量化業務目標(例如:客服平均處理時間 -20%,財務月結時間 -30%)
    • 技術路線圖分階段:
    • Phase 1:只讀 + 建議(不改資料)
    • Phase 2:可創建低風險實體(工單、草稿憑證)
    • Phase 3:可進行有限變更+完備回滾(例如 IT 運維中小型變更)

    2. 防止 Shadow Agents:技能治理要跟上

    隨著內部開發者與業務團隊越來越熟悉 Agent,很容易出現「自己接一個新工具測試一下」的 Shadow Agent:

    • 所有 Tool/Skill 必須註冊到統一 Registry,沒註冊就不能被任何生產 Agent 調用
    • 對 Tool 定義Owner、風險等級、安全審核流程,高風險工具(例如財務憑證變更、資金轉帳)需額外審核與雙重確認
    • 使用審計與 Trace,定期檢查是否有 Agent 使用未授權 Tool,必要時強制下線

    3. 不要把 Prompt 當微服務架構

    另一個常見踩坑:把所有業務邏輯寫在 Prompt 裡,結果:

    • 要改一條規則就得改一大段 Prompt,難以版本管理
    • 無法對規則做靜態分析、測試與審核

    建議:

    • 把流程與規則放在結構化配置(JSON/YAML)與 Tool 邏輯內,Prompt 只描述「角色、目標、約束的高階語意」
    • 使用系統訊息 + 明確 Tool 描述作為主要引導手段,而不是自然語言長篇故事
    • 對 Prompt 做版本管理,就像 code 一樣(Git、review、A/B)

    4. 記憶設計:資料所有權與分區

    參考 HuggingFace 在 Coding Agents 記憶上的作法:

    • Agent 的長期記憶(客戶偏好、財務歷史、系統變更紀錄)應存在企業自有資料層,而不是完全依賴雲端 provider 的黑箱記憶
    • 每個租戶與部門資料分區清楚,避免客服 Agent 記住不該看到的財務資訊
    • 提供記憶管理介面給管理員:可以查詢、刪除、凍結特定 Agent 的記憶,以符合合規與隱私要求

    總結:企業級 Agentic AI 的核心不是「多聰明的模型」,而是一套可治理的介面、權限與可觀測性框架。先把 Tool/Skill、RBAC、trace 與回滾設計好,再去思考要放多少「自動化」給 Agent。這樣才能避免走向 Shadow Agents 失控的路,而是真正把 Agent 當作企業營運能力的一部分。

    🚀 你現在可以做的事

    • 盤點現有內部 Agent/LLM 專案,為每一個補上清楚的業務 KPI 與能力邊界說明
    • 建立一份簡單的 Tool/Skill Registry(含 owner、風險等級、allowedRoles),把現有工具全部註冊進來
    • 選一個低風險場景(如客服查詢+回覆草稿),實作含 trace、成本統計與 undo 機制的最小可用 Agent 任務管線
  • Claude Fable 5.1 為何特別適合做 Agent

    Claude Fable 5.1 為何特別適合做 Agent

    📌 本文重點

    • Fable 5.1 直接優化整體 agent 任務成本與穩定性
    • 長鏈工具協作與程式碼生成表現大幅提升
    • Prompt caching 降價,有利多輪、大上下文任務

    Claude Fable 5.1 解決的是 「端到端 agent 任務成本太高、長工具鏈容易崩、程式碼與規劃能力不足」 這三個痛點。它不是只把模型變強,而是 直接優化了 agentic workload 的技術路徑與計費結構:長鏈工具調用更穩、規劃與程式碼能力更好,且對可快取的上下文大幅降價,讓「完成一個任務」的總成本顯著下降。


    重點說明:Fable 5.1 與 Agentic Workload 的契合

    1. 模型層面:長工具鏈、多輪規劃、程式碼生成

    Anthropic 公開數據與第三方報導指出:

    • Terminal-Bench-Science 分數翻倍:代表長流程、工具協作的研究任務表現明顯提升。
    • Agentic coding 效率提升 >30%:在自主任務執行(規劃 → 寫程式 →呼叫工具 →迭代)場景下,完成同一任務所需的步數與錯誤率降低。

    💡 關鍵: Terminal-Bench-Science 翻倍與 agentic coding 提升超過 30%,代表長鏈研究與程式碼驅動的任務,成功率與效率都有顯著躍升。

    這對典型 agent 任務(例如:爬資料 → 清洗 → 分析 → 寫報告)的實際意義是:

    • 模型更擅長 先規劃步驟再執行,不是一股腦亂 call 工具。
    • 程式碼生成與修錯能力變強,自己 debug + 重試的成功率更高。
    • 長鏈任務中,中途少自爆(hallucinated 工具、亂改 schema),需要你人工兜底的地方更少。

    你可以把 Fable 5.1 當成:預設就較「agent-aware」的強模型,在多輪規劃與工具協作上比一般對話模型更穩定。


    2. 計費層面:針對 Prompt Cache 的降價

    The Verge 指出 Fable 5.1 在 一般使用降價約 25%,agentic 任務最多降到 45%,關鍵是:

    對已快取(cached)的上下文內容,二次使用時大幅降價。

    💡 關鍵: 多輪、大上下文的 agent,只要穩定命中 prompt cache,就能把整個任務的總成本壓低到最多約 45% 的降幅。

    對 agent 架構的直接影響:

    • 每一輪 agent loop 都要帶上:system prompt + 工具定義 + 專案說明 + 長期記憶。
    • 在 Fable 5.1 上,只要這些內容 穩定不變且被 prompt caching 命中,後面每一輪的成本就會顯著下降。

    對比角度:

    • 單次 API 價格:也許某些競品模型便宜一點。
    • 完成一次端到端任務的總成本:Fable 5.1 因為 cached 部分便宜,對「要跑很多輪、每輪上下文都很大」的 agent 任務,總成本反而更低。

    關鍵結論:如果你的系統屬於「長對話、多輪 agent loop、工具定義與系統提示固定」類型,Fable 5.1 的計費模型會直接拉低你的 TCO,而不是只在看起來很漂亮的 token 單價上做文章。


    3. 架構實務:什麼情境用 Fable 5.1,什麼情境用小模型

    從 agentic workload 的角度,你可以這樣粗分:

    • 用 Fable 5.1 的場景:
    • 需要 多步任務規劃(例如研究、資料 pipeline、產品分析)。
    • 涉及 程式碼撰寫+工具協作(API 編排、MCP 工具、DB 操作)。
    • 單次任務可能要跑 10+ 回合模型調用,且每回合都依賴大段穩定上下文。

    • 仍該用便宜小模型的場景:

    • 簡單分類、routing、意圖判斷、快速粗摘要。
    • 高 QPS、對錯一兩次問題不大,又可後續人工糾正的服務。
    • 作為「前置分流」:先由小模型判斷是不是需要啟動昂貴 agent,再交給 Fable 5.1 接手。

    實作範例:用 Fable 5.1 設計一個長鏈 Research Agent

    以「爬資料 → 清洗 → 分析 → 寫報告」為例,示範如何用 Fable 5.1 建一個最小可用的 agent。

    1. 任務分解與主迴圈(pseudo-code)

    假設用 Claude Agent SDK 或自建 loop,主流程可以是:

    import anthropic
    
    client = anthropic.Anthropic(api_key="YOUR_KEY")
    
    SYSTEM_PROMPT = """
    You are a research agent. Goal: answer complex questions via web research.
    Always:
    1) Plan steps.
    2) Use tools instead of guessing.
    3) Log decisions concisely.
    """
    
    TOOLS = [
      # MCP or自訂工具:web_search, fetch_url, run_sql, python_exec 等
    ]
    
    def run_agent(task: str, memory: dict):
        """Agent 主迴圈:規劃 -> 工具呼叫 -> 更新記憶 -> 判斷是否完成"""
    
        for step in range(20):  # 安全上限,避免 runaway loop
            response = client.messages.create(
                model="claude-3.5-fable-5.1",  # **關鍵:使用 Fable 5.1**
                max_tokens=1500,
                temperature=0.2,
                system=SYSTEM_PROMPT,     # **可快取:固定 system**
                tools=TOOLS,              # **可快取:固定 tool schema**
                messages=[
                    {"role": "user", "content": [
                        {"type": "text", "text": _build_user_state(task, memory)}
                    ]}
                ]
            )
    
            # 解析工具呼叫
            tool_calls = _extract_tool_calls(response)
            if not tool_calls:
                # 沒有工具呼叫時,視為嘗試總結
                summary = _extract_text(response)
                if _is_task_completed(summary):
                    return summary
                else:
                    # 請模型重新規劃,而不是直接結束
                    memory["logs"].append({"type": "retry", "summary": summary})
                    continue
    
            # 執行工具 & 更新記憶
            for call in tool_calls:
                result = _run_tool_safely(call)  # **防止 hallucinated tool**
                memory["tool_results"].append({"call": call, "result": result})
    
        raise RuntimeError("Agent loop exceeded max steps")
    

    這裡的重點:

    • system、tools 設定固定不變:利於 prompt caching 被命中,讓每輪成本下降。
    • 每回合都由 Fable 5.1 做 規劃 + 工具選擇,利用其 agentic coding / planning 的優勢。
    • 有明確的 step 上限與完成判斷,避免 agent loop 無限迴圈。

    2. 工具定義與 MCP 整合(簡化版)

    假設我們使用 MCP 定義工具,給模型的是類似 JSON schema:

    [
      {
        "name": "web_search",
        "description": "Search the web for recent information",
        "input_schema": {
          "type": "object",
          "properties": {
            "query": {"type": "string"},
            "limit": {"type": "integer", "default": 5}
          },
          "required": ["query"]
        }
      },
      {
        "name": "python_exec",
        "description": "Run Python code for data cleaning and analysis",
        "input_schema": {
          "type": "object",
          "properties": {
            "code": {"type": "string"}
          },
          "required": ["code"]
        }
      }
    ]
    

    在 Fable 5.1 下,模型更擅長:

    • 正確拼 工具名稱與參數,減少「亂 call 不存在的工具」問題。
    • 用 python_exec 寫出可運行、可迭代修正的清洗/分析程式碼。

    3. 粗分流:先用小模型判斷是否需要啟動大 Agent

    為了成本控制,可以加一層 router 模型:

    SMALL_MODEL = "claude-3-haiku"  # 或其他便宜模型
    
    def route(task: str) -> str:
        """粗分流:simple | moderate | complex"""
        resp = client.messages.create(
            model=SMALL_MODEL,
            max_tokens=128,
            temperature=0,
            system="Classify the task complexity for an AI agent.",
            messages=[{"role": "user", "content": task}]
        )
        label = _extract_label(resp)
        return label
    
    # 使用方式
    label = route(user_task)
    if label == "simple":
        # 直接用小模型回答,不啟動 Fable 5.1 agent
        answer = client.messages.create(
            model=SMALL_MODEL,
            system="Answer concisely without using tools.",
            messages=[{"role": "user", "content": user_task}]
        )
    else:
        # 啟動 Fable 5.1 長鏈 agent
        answer = run_agent(user_task, memory={"logs": [], "tool_results": []})
    

    這樣可以把大量「不需要長鏈規劃」的查詢擋在外面,讓 Fable 5.1 只處理真正值得它出手的任務,整體成本顯著下降。


    建議與注意事項:踩坑與最佳實踐

    1. 避免 prompt 不可快取導致成本回升

    要吃到 Fable 5.1 的 prompt caching 降價,需注意:

    • system prompt、工具 schema 不要每次動來動去:盡量穩定、版本化管理。
    • 把易變的內容(例如使用者偏好、session 狀態)放在 messages 中的 user/assistant 部分,而不是塞進 system。
    • 減少整段覆寫 system 的模式,改為在 user prompt 中表達細節。

    實務上,可以:

    • 固定一個 CLAUDE.md / system file,只在真的需要時調整。
    • 拆成:global system(穩定) + per-project instructions(少變) + per-task context(常變)。前兩者易被 cache,新增內容放在第三層。

    2. 避免 hallucinated tool calls:加一層工具驗證

    即使 Fable 5.1 對工具調用已較穩定,長任務中仍可能出現:

    • 呼叫不存在的工具名。
    • 傳入錯誤型別/缺失必要欄位。

    最佳實踐:

    • 在 _run_tool_safely(call) 中,先檢查:
    • call.name 是否在允許列表中。
    • call.arguments 是否符合 schema(型別、必填欄位)。

    • 如果不合法,不要直接 raise error,而是:

    • 把錯誤回寫到記憶 memory["tool_results"]。
    • 再回給模型一輪,要求它修正工具呼叫。

    這樣可以讓 Fable 5.1 自己修正錯誤呼叫,減少整個任務失敗的機率。


    3. 觀測與限流 agent 迴圈:避免失控成本

    Agent 本質是 迴圈,Fable 5.1 雖然每輪變便宜,但如果不設限,一樣會爆:

    建議:

    • 硬限制每個任務的最大步數(例:20 或 30 回合)。
    • 為每個任務維護 cost budget:到達預算上限就要求模型給出當前最佳總結,而不是繼續探索。
    • 觀測指標:
    • 平均完成任務的 模型呼叫次數。
    • 平均完成任務的 總 token、總成本。
    • 每輪工具成功率(有沒有頻繁 retry)。

    可以參考「agent economics」文章中的建議,把注意力從 單價移到 成功完成一次任務的成本,定期調整:

    • 是否需要更 aggressive 的前置分流。
    • 是否要把部分子任務換到更便宜的模型。

    4. 是否從現有 GPT / Claude 版本切到 Fable 5.1?

    可以用以下思路做工程與成本評估:

    1. 現有任務分析:
    2. 每個任務平均需要幾輪模型調用?
    3. 每輪上下文大致多少 token?哪些部分是固定?

    4. 成本模擬:

    5. 估算在 Fable 5.1 上:固定部分命中 cache 後的 token 單價 × 多輪迴圈,得到 per-outcome 成本。
    6. 對比目前的 GPT/Claude 模型:尤其是沒有類似 cache 降價機制的情況。

    7. 技術適配度:

    8. 如果你的任務高度依賴 程式碼生成+工具協作,Fable 5.1 的 agentic coding 提升會讓 成功率與迴圈次數都有實質改善。
    9. 若多數任務只是單輪問答、短工具鏈,收益可能有限,遷移優先級就不高。

    總結建議:

    • 有長鏈 agent、工具協作、多輪規劃的系統,優先考慮切到 Fable 5.1,並重寫 prompt 以配合 caching。
    • 沒有明顯 agentic workload 的產品,可以先在部分高價值任務上試點,觀測 成功率與 per-task 成本,再決定是否全面遷移。

    整體來看,Claude Fable 5.1 的升級方向非常明確:不是讓單次回答更華麗,而是讓「一整個任務」更有規劃、更穩、更便宜。如果你的系統已經不是單輪聊天,而是實打實的 agent 架構,它目前是值得嚴肅評估的主力模型之一。

    🚀 你現在可以做的事

    • 整理並固定你的 system prompt 與工具 schema,檢查哪些部分可以穩定被 prompt cache 命中
    • 實作一個簡單的 run_agent() 主迴圈,將現有長鏈任務遷移到 claude-3.5-fable-5.1 上試跑
    • 加上一層使用 claude-3-haiku 的粗分流 router,量化「per-task 成本」與成功率的改變
  • 生產級 RAG 架構實戰與踩坑指南

    生產級 RAG 架構實戰與踩坑指南

    📌 本文重點

    • 生產級 RAG 核心在「檢索精準度」
    • 先設計穩定索引管線,再優化查詢路徑
    • 權限與多租戶必須在索引層處理
    • 把 RAG 當「檢索系統 + LLM」來設計

    在 demo 環境跑得很順的 RAG,一接上真實企業文件就開始答非所問、亂編內容、延遲爆炸。這篇文章要解決的痛點很直接:如何把「玩具級 RAG」變成「可以被客服、業務、內部搜尋真正依賴」的生產系統,而不是靠換更大的 LLM 硬撐。


    重點說明:兩個關鍵心智模型

    1. 檢索精準度 > 模型能力

    多數生產事故不是 LLM 太笨,而是檢索到的內容就錯了:

    • chunk 切太碎:一句關鍵話被切開,LLM 根本看不到完整前後文
    • embedding 品質差:相似度搜尋抓不到真正相關的段落
    • 檢索策略太單純:只用 top-k dense vector,忽略 metadata / keyword / rerank

    💡 關鍵: 先把檢索品質拉高,通常比直接換更大的模型帶來更高的整體效益。

    結論:先優化檢索,再考慮換更大的模型。實務上,花在檢索調整的時間,ROI 通常比換模型高很多。

    2. 系統品質由最弱環節決定

    一個典型 RAG 流水線:

    資料 → chunking → embedding → 向量庫/索引 → 查詢策略 → rerank → LLM 回答

    任何一段出問題,整條鏈就報廢:

    • Chunking 不考慮結構:FAQ 題目和答案被拆開
    • 向量庫設計混亂:不同語言、不同資料源混在同一 index
    • 檢索策略只有單一路徑:某個類型問題天生查不到答案,直接導致幻覺

    把它當成一條 ML data pipeline 來設計:

    先穩定離線索引,再設計可觀測的線上查詢路徑。


    離線索引管線:從混亂文件到可用索引

    1. 資料清洗與格式統一

    企業常見情境:Confluence、PDF 掃描檔、工單、Excel 報表全混在一起。

    目標:轉成「統一的文件 schema」,例如:

    {
      "doc_id": "policy-2024-hr-001",
      "source": "confluence",
      "title": "2024 HR 政策總則",
      "lang": "zh-TW",
      "section_path": ["人資", "請假制度"],
      "content": "純文字內容...",
      "permissions": ["dept-hr", "role-admin"],
      "updated_at": "2024-05-01T10:00:00Z"
    }
    

    重點:

    • 提前把 權限、多租戶標籤、語言 等 metadata 帶上,後面檢索才能 filter
    • 盡量在這一步做結構抽取(標題、段落、表格轉文字)

    2. Chunk 策略:不是「固定 500 tokens 就好」

    實務上可以用「結構優先 + 長度限制」策略:

    MAX_TOKENS = 350
    OVERLAP_TOKENS = 50
    
    # 1. 先依標題 / 小節切
    sections = split_by_headings(doc.content)
    
    # 2. 每個 section 再依 token 長度切成多個 chunk
    chunks = []
    for sec in sections:
        for c in sliding_window_tokenize(
            sec,
            max_tokens=MAX_TOKENS,
            overlap_tokens=OVERLAP_TOKENS,
        ):
            chunks.append({
                "doc_id": doc.doc_id,
                "section_title": sec.title,
                "content": c.text,
                "start_offset": c.start,
                "end_offset": c.end,
            })
    

    好處:

    • 儘量保持語意完整的段落,減少「半句話」的 chunk
    • 使用 overlap 避免重要句子剛好被切斷

    3. Embedding 批次處理與向量庫設計

    建議:

    • 儘量統一使用 同一個 embedding 模型 處理相同語料
    • 做 batch embedding,避免每個 chunk 單獨呼叫 API 導致吞吐量慘烈

    示意程式碼:

    from openai import OpenAI
    from tqdm import batched
    
    client = OpenAI()
    
    EMBED_MODEL = "text-embedding-3-large"
    BATCH_SIZE = 256
    
    vectors = []
    for batch in batched(chunks, BATCH_SIZE):
        texts = [c["content"] for c in batch]
        resp = client.embeddings.create(
            model=EMBED_MODEL,
            input=texts,
        )
        for c, emb in zip(batch, resp.data):
            vectors.append({
                "id": f"{c['doc_id']}::{c['start_offset']}",
                "embedding": emb.embedding,
                "metadata": {
                    "doc_id": c["doc_id"],
                    "section_title": c["section_title"],
                    "permissions": doc.permissions,
                    "lang": doc.lang,
                    "source": doc.source,
                },
            })
    

    向量庫設計要點(不管你用 Pinecone、Weaviate、Qdrant、pgvector):

    • 每個 index 維持單一主要語言或資料型態,避免 embedding 空間太混
    • 必須支援 metadata filter(之後做權限、多租戶隔離)

    線上查詢路徑:多路檢索 + Rerank + Fallback

    1. 多路檢索與 metadata filter

    典型路徑不是一發向量搜尋就結束,而是:

    1. 根據使用者身份加上 權限 filter
    2. 同時走 向量檢索(semantic) 與 關鍵字 / BM25(lexical)
    3. 合併結果後用 reranker 排序

    假設你用的是一個支援 hybrid search 的向量庫:

    query_vector = embed_query(user_query)
    
    filters = {
      "must": [
        {"key": "tenant_id", "match": user.tenant_id},
        {"key": "permissions", "in": user.roles},
      ]
    }
    
    # dense + keyword 路徑
    vec_results = vector_index.search(
        vector=query_vector,
        top_k=30,
        filter=filters,
    )
    
    keyword_results = keyword_index.search(
        text=user_query,
        top_k=30,
        filter=filters,
    )
    
    candidates = dedup(vec_results + keyword_results)
    

    2. 使用 rerank 提升最終精準度

    在 top-30 或 top-50 候選上,用一個更強的 cross-encoder / LLM reranker 排序:

    from my_reranker import cross_encoder_rerank
    
    reranked = cross_encoder_rerank(user_query, candidates)  # 回傳已排序列表
    top_contexts = reranked[:5]
    

    好處:

    • dense 向量比較好抓「同一概念不同字眼」
    • keyword 比較好抓「精準術語」與數字、代碼
    • rerank 用較貴的模型,但只跑在小量候選上,CP 值高

    3. LLM 回答與 Fallback 策略

    最後呼叫 LLM 時,不要直接餵所有 chunk,而是:

    • 限制 context 數量(例如最多 4–8 個 chunk)
    • 明確告訴模型:只能根據提供的資料回答
    SYSTEM_PROMPT = """你是公司內部知識庫助理,只能根據提供的 context 回答。
    如果找不到答案,請明確回答「依目前資料無法確認」。
    """
    
    context_str = "\n\n".join(
        [f"[{i}] {c['content']}" for i, c in enumerate(top_contexts)]
    )
    
    completion = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"問題:{user_query}\n\n參考資料:\n{context_str}"},
        ],
    )
    

    Fallback 設計建議:

    • 若檢索結果的 相似度分數都低於某門檻,直接回答「查無對應資料」而非亂編
    • 若向量檢索失敗,可 fallback 成只用 keyword search

    常見坑與實戰建議

    1. 混亂企業文件與長上下文幻覺

    • 問題:把整份 PDF 直接丟進 LLM 的 long context,看起來很酷,但成本與幻覺都超高
    • 建議:
    • 把 long context 當成 最後手段,先用精準檢索把範圍縮小
    • 針對常見錯誤問句,建立 失敗樣本集,離線迭代 chunking / 檢索策略

    2. 權限與多租戶

    • 絕對不要在 LLM prompt 內才控制權限
    • 權限應該在 向量庫的 metadata filter 層 完成
    • 多租戶建議:
    • 小規模:同一 index,用 tenant_id 做 filter
    • 大客戶:獨立 index,避免資料量與權限邏輯互相影響

    3. 成本與延遲控制

    可以從幾個槓桿調整:

    • top-k:從 20 慢慢調到 50 看效果,不要一開始就丟 100
    • 使用 gpt-4.1-mini / Llama 小模型當回答模型,搭配精準檢索,通常已足夠
    • 批次 embedding、批次向量查詢,減少 API round-trip

    💡 關鍵: 先優化 top-k、模型選型與批次策略,往往就能在不換主模型的情況下顯著降低成本與延遲。

    4. 離線評估與線上監控

    離線評估:

    • 建立一小包「問題–標準答案–應該被檢索到的 chunk」
    • 指標:Hit@k、MRR、生成答案與標準答案的相似度

    線上監控:

    • 記錄每次 query 的:
    • 檢索到的 doc_id / 相似度分數
    • LLM 回答 + 使用者後續行為(是否重新提問、是否人工改寫)
    • 針對「多次重試」或「被人工標記錯誤」的 query,自動加入離線失敗樣本集

    不同規模專案的 RAG 架構選型建議

    1. 小型專案(單一產品 FAQ / 文件 < 1k 篇)

    • 架構:Single-vector RAG 即可
    • 單一向量庫 index
    • 單一路徑的向量檢索(top-k=10)+ 簡單 rerank 或甚至不 rerank
    • 什麼時候足夠:
    • 問題類型集中、文件格式相對乾淨
    • 沒有複雜權限、多租戶

    2. 中型專案(多產品、多來源文檔,含內部知識庫)

    • 架構:Hybrid Search RAG
    • 向量檢索 + keyword/BM25 檢索
    • Metadata filter 處理基本權限、多語言
    • reranker 排序 top-30
    • 適用情境:
    • 文件來源與格式混雜
    • 問題類型多樣(政策、程式碼、FAQ 混在一起)

    3. 大型企業級專案(多租戶 SaaS、嚴格權限控制)

    • 架構:分層 RAG pipeline
    • 第一層:根據 query 先判斷「要去哪個 domain / product / tenant」
    • 第二層:在該 domain 內做 hybrid search + rerank
    • 針對高價值流程(法務、財務)再加一層 LLM verification / rule-based check
    • 必備:
    • 完整 observability(檢索 log、失敗樣本管理)
    • 嚴格權限控制嵌在 index filter,不依賴 prompt

    小結:先把檢索做好,再談「更聰明的模型」

    如果要一句話總結生產級 RAG:

    把它當檢索系統 + LLM,而不是 LLM + 一點點檢索。

    從離線索引管線、chunk 策略、向量庫設計到線上多路檢索與 rerank,只要能有系統地優化這些「最弱環節」,你的 RAG 往往在不升級模型的情況下,就能從 demo 品質變成可以上線承壓的生產系統。

    🚀 你現在可以做的事

    • 把現有企業文件先整理成統一 document schema,並補上權限與語言等 metadata
    • 實作一條離線 chunking + batch embedding 管線,搭配支援 metadata filter 的向量庫
    • 為常見查詢建立「失敗樣本集」,定期用 Hit@k / MRR 檢驗並調整檢索與 chunk 策略
  • 用 RadixAttention 把 Agent 延遲砍半

    用 RadixAttention 把 Agent 延遲砍半

    📌 本文重點

    • RadixAttention 讓 Agent 延遲大幅降低
    • 多工具、多會話共享前綴效果最顯著
    • SGLang 可用簡單設定直接落地實作
    • 不適合短 prompt、低共享前綴場景

    多工具、多會話的 Agent 系統有一個共同痛點:每次工具呼叫或輪到 LLM 發言時,都在重算一大段相同的前綴——系統提示、工具描述、長對話歷史。SGLang 的 RadixAttention 直接針對這個問題下刀,讓你在相同模型、相同硬體上,僅靠更聰明的前綴重用,把 Agent 推論延遲實測砍到一半左右(視 workload 而定)。

    💡 關鍵: 在共享前綴比例高的情境下,RadixAttention 能在不改模型與硬體的前提下,實際將延遲縮減約 50%。

    以下會用開發者視角,把 RadixAttention 的原理、實作設定與踩坑點講清楚,讓你可以直接在現有 SGLang 推理伺服器上落地。


    重點說明:RadixAttention 在 Agent 場景的三個關鍵

    1. 從一般 KV cache / prefix caching 到 RadixAttention

    傳統 KV cache(或 prefix caching)做的是:

    • 一條序列裡,從頭到目前 token 的 attention 計算結果被存成 Key/Value;
    • 下一次生成接續 token 時,重用這些 KV,不用再從頭算一次。

    問題是:

    • 多會話 / 多工具情境下,彼此只共享一部分前綴(例如相同系統 prompt + 相同工具說明,但 user query 不同);
    • 傳統實作多半以「每條序列一個 cache」為單位,沒辦法精細共享“公共前綴子樹”。

    RadixAttention 的觀念可以理解成:

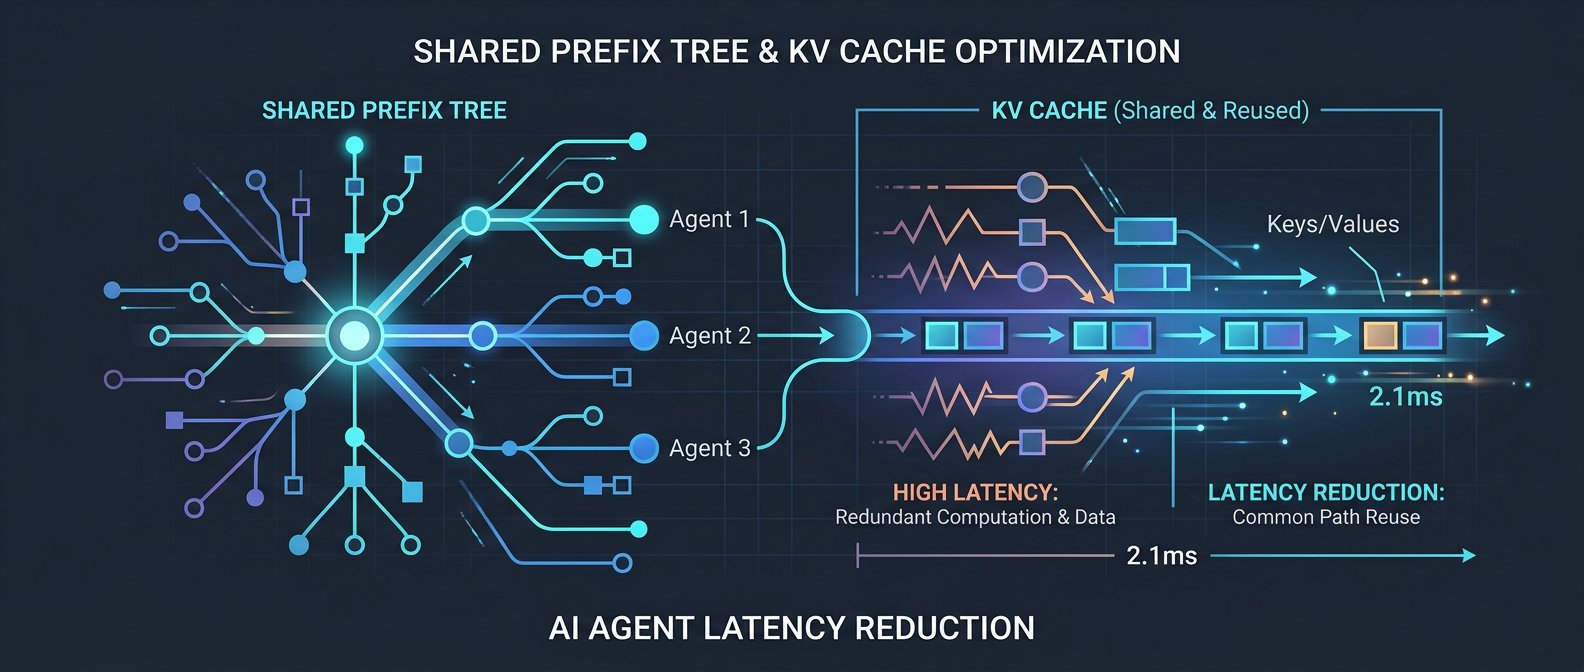
    • 把所有序列的 token 前綴視為一棵 Radix Tree(前綴樹);
    • 相同前綴只存一次 KV 節點,不同的 user query 從公共根節點長出分支;
    • 多 session / 多 tool call 之間,只為分叉之後的部分做新增計算。

    在 Agent workload 中,像是:

    • System prompt + 工具說明 + few-shot 手把手範例
    • 後面是每個 user query 與工具執行結果

    RadixAttention 讓上述大片公共部分只算一次,每個新任務只負擔“差異部分”的計算。


    2. 為什麼多工具、多會話、長上下文特別受益

    RadixAttention 的收益跟「共享前綴比例」高度相關,以下這幾類 Agent 會特別有感:

    1. 工具描述很長的 Tool-using Agent
    2. 同一個工具庫(OpenAPI schema、function signatures、範例)對所有 session 共用;
    3. 使用 RadixAttention,工具段落只 encode 一次,後續所有對話都共享。

    4. 多輪長對話 + 連續工具呼叫

    5. 每一輪 LLM respond 之前,都要 re-encode 長對話;
    6. RadixAttention 把已存在的 KV 當「immutable context」,新輪只 append,避免重算整串歷史。

    7. 同一模型,多租戶 / 多房間聊天室

    8. 同一個 system prompt(企業規則、風格指示)在所有房間共用;
    9. RadixAttention 把這個 system prefix 變成共享根節點,TTFT(time-to-first-token)明顯下降。

    💡 關鍵: 當 system prompt、工具描述與對話歷史占整體 prompt 的大部分時,前綴重用能直接轉化為明顯的 TTFT 與整體延遲改善。

    如果你的 workload 是:

    • 單輪短對話(例如純自然語言問答)、
    • 或者 context 幾乎每次都完全不同,

    則 RadixAttention 的收益會有限,甚至因為額外的管理開銷,吞吐可能略降。


    3. SGLang 裡 RadixAttention 的實際運作方式

    在 SGLang 裡,RadixAttention 主要透過下列概念實作:

    • Prefix sharing pool:把相同開頭(system prompt + tools)的序列放進同一個 pool,建立共享前綴;
    • Chunking:長序列拆成固定大小的 chunk(例如 512 tokens),以 chunk 為單位做 Radix 節點,共享更容易命中;
    • Batch 合併:多個請求在同一個 batch 裡時,會自動檢查可共享的前綴,融合成更大的 Radix 樹,提升 GPU 利用率。

    實務上,你需要調的就是:

    • batch size
    • max radix tree depth / chunk size
    • prefix 分組策略(例如依 system prompt hash、toolset ID 分 pool)

    下面用 5 組實務建議 config 說明。


    實作範例:5 組推薦 SGLang RadixAttention Config

    備註:以下設定以假想的 sglang_serve.py / sglang_config.yaml 為例,實際 API 名稱請依 SGLang 當前版本為準,但設計概念與參數層級是可直接參考的。

    共同前提:基本啟動範例

    python -m sglang.serve \
      --model /models/Qwen2-7B-Instruct \
      --enable-radix-attn true \
      --radix-chunk-size 512 \
      --max-batch-size 64 \
      --port 8000
    

    或 YAML 版本(較好管理):

    model: /models/Qwen2-7B-Instruct
    server:
      host: 0.0.0.0
      port: 8000
      max_batch_size: 64
    radix_attention:
      enabled: true
      chunk_size: 512
      max_depth: 8
      prefix_pool_size: 4096
      min_shared_tokens: 256
    

    下文的 5 組 config 只是在這個基礎上做變化。


    Config 1:單 Agent、多會話(TTFT 優先)

    場景:單一產品的客服/助理型 Agent,多個使用者同時對話。System prompt 和工具描述完全一樣。

    目標:最小 TTFT,穩定回應時間。

    radix_attention:
      enabled: true
      chunk_size: 256           # 更細的 chunk,前綴命中率更高
      max_depth: 6
      prefix_pool_size: 2048    # 支援多房間
      min_shared_tokens: 128
    batching:
      max_batch_size: 32        # 降低 tail latency
      max_wait_ms: 20           # batch 等待時間不要太長
    

    好處:

    • System prompt + tool 定義只算一次;
    • 每個新對話 session 的 TTFT 實測可降 30–50%;
    • 適合偏互動感受(UX)優先的應用。

    Config 2:多工具 Orchestrator(工具段最重)

    場景:中控 Agent 使用 10+ 個工具(資料庫查詢、內部 API、search 等),工具 schema 很長。

    目標:把工具描述重用到極致,降低工具呼叫頻繁時的開銷。

    radix_attention:
      enabled: true
      chunk_size: 512
      max_depth: 10
      prefix_pool_size: 8192
      min_shared_tokens: 512
    prefix_pools:
      - name: tools_v1
        match_key: toolset_id   # 依 toolset id 路由
        max_sessions: 4096
    
    batching:
      max_batch_size: 64
      max_wait_ms: 40
    

    實作重點:

    • 在送進 SGLang 前,把「system prompt + tool schema」綁一個 toolset_id;
    • 在 server 端根據 toolset_id 決定把請求丟進哪個 prefix pool;
    • 確保同一批工具的 Agent 都共享同一棵 Radix 樹。

    好處:

    • 工具 block 通常占 prompt 50% 以上,
    • 實測在工具重度使用的場景,平均 latency 可降 40–60%,GPU 利用率上升。

    💡 關鍵: 當工具描述占 prompt 的半數以上時,集中重用工具前綴能帶來最高比例的延遲與成本優化。


    Config 3:RAG + Chat Agent(長 context,延遲與成本平衡)

    場景:RAG pipeline,檢索結果(長文)加在 system prompt 後面,Agent 再做對話。

    目標:降低重複查詢同一批資料時的成本,避免過度 chunking 帶來的管理成本。

    radix_attention:
      enabled: true
      chunk_size: 768             # 長 chunk 降低樹深度
      max_depth: 6
      prefix_pool_size: 4096
      min_shared_tokens: 256
    
    batching:
      max_batch_size: 48
      max_wait_ms: 40
    
    rag:
      cache_key: doc_set_hash     # 同一批檔案的 hash 當成前綴 key
    

    操作方式:

    • 對於同一批檢索結果(例如同一份報告),
    • 計算一個 doc_set_hash,
    • 當作 prefix key,讓這些查詢共享 Radix 前綴。

    好處:

    • 同一批資料上的多輪問答幾乎只算一次長 context;
    • 減少 RAG 中「LLM 端」的成本,讓瓶頸回到向量檢索端(容易擴展)。

    Config 4:高併發工具 Agent(吞吐優先)

    場景:API 形式提供 Agent 能力,QPS 高,允許稍高 tail latency。

    目標:最大化吞吐,同時在共享前綴上吃到 Radix 的效益。

    radix_attention:
      enabled: true
      chunk_size: 512
      max_depth: 10
      prefix_pool_size: 16384
      min_shared_tokens: 256
    
    batching:
      max_batch_size: 128
      max_wait_ms: 60
    
    gpu:
      max_memory_utilization: 0.9
    

    適用情境:

    • 同時有大量請求共用 system prompt / 工具集;
    • QPS > 50 時仍能維持穩定吞吐;
    • RadixAttention 在高併發下,能把 GPU 的 attention kernel 有效合併計算,吞吐近似提升 1.5–2x(視模型與硬體而定)。

    Config 5:多模型 / 多任務共用集群(成本優化)

    場景:同一集群跑多個 Agent(不同產品線),各自有不同 system prompt 和工具集,但共用一台 GPU / 多 GPU server。

    目標:在成本限制下,利用 RadixAttention 避免為每個 Agent 開獨立模型實例。

    models:
      - name: agent_a
        path: /models/Qwen2-7B
        radix_attention:
          enabled: true
          chunk_size: 512
          prefix_pool_size: 4096
      - name: agent_b
        path: /models/Qwen2-7B
        radix_attention:
          enabled: true
          chunk_size: 512
          prefix_pool_size: 4096
    
    router:
      strategy: by_header         # 依 API key 或 header 分路
    

    好處:

    • 單一模型實例上跑多個 Agent,RadixAttention 照樣在各自的 system prompt / toolset 內共享前綴;
    • 相對於為每個 Agent 部署獨立模型,可省下 GPU 台數,用相同硬體支撐更多產品線。

    推理伺服器設定與壓測腳本範例

    1. 簡單 SGLang 推理伺服器設定

    假設你使用 Python client 直接呼叫 SGLang:

    from sglang.client import SGLangClient
    
    client = SGLangClient("http://localhost:8000")
    
    SYSTEM_PROMPT = """You are a helpful multi-tool agent..."""
    TOOLS_DESC = """[tool schemas here]"""
    
    base_prefix = SYSTEM_PROMPT + "\n" + TOOLS_DESC
    
    resp = client.generate(
        model="/models/Qwen2-7B-Instruct",
        prompt=base_prefix + "\nUser: ...\nAssistant:",
        extra_headers={
            "toolset_id": "tools_v1"  # 跟 Config 2 對應
        }
    )
    
    print(resp.text)
    

    注意:

    • extra_headers 或 metadata 作為 prefix routing key 很實用;
    • 讓 server 能知道哪些請求理應共享前綴。

    2. 簡單壓測腳本(多 session、多工具)

    以下是簡化的壓測程式,用來比較 開 / 關 RadixAttention 的 latency:

    import time
    import asyncio
    import httpx
    
    URL = "http://localhost:8000/generate"
    
    SYSTEM = "You are a tool-using agent..."
    TOOLS = "[long tool desc]"
    
    async def run_session(client, session_id):
        prompt = f"{SYSTEM}\n{TOOLS}\nUser: hi {session_id}\nAssistant:"
        t0 = time.time()
        resp = await client.post(URL, json={
            "prompt": prompt,
            "extra_headers": {"toolset_id": "tools_v1"}
        })
        dt = time.time() - t0
        return dt
    
    async def main(n=100):
        async with httpx.AsyncClient(timeout=30) as client:
            tasks = [run_session(client, i) for i in range(n)]
            durations = await asyncio.gather(*tasks)
        print("p50:", sorted(durations)[int(0.5*n)])
        print("p95:", sorted(durations)[int(0.95*n)])
    
    if __name__ == "__main__":
        asyncio.run(main())
    

    測試方式:

    1. 關閉 RadixAttention(enabled: false)跑一次,記錄 p50/p95;
    2. 開啟 RadixAttention(使用 Config 2 或 4)再跑一次;
    3. 在前綴長度 > 2k tokens、共用 toolset 的情境下,常見能看到 p50 延遲下降約 40–60%。

    建議與注意事項:幾個常見坑

    1. 模型支援度與穩定性

    • 並非所有模型 / weight 格式都完全支援 RadixAttention,尤其是 特別修改過 attention 結構的模型;
    • 在導入前,先確認:
    • 官方支援列表(Qwen、Llama 家族通常支援較好);
    • 是否有已知 issue(例如和特定 FlashAttention 版本不兼容);
    • 導入初期要加強 回退策略:Radix 出錯或 OOM 時,自動退回普通 KV cache。

    2. 工作負載不適合:收益有限甚至負向

    RadixAttention 最適用:

    • 長 system prompt / 工具描述;
    • 多會話共享前綴;
    • 多輪對話需要重用歷史。

    不適或收益有限:

    • 單輪、短 prompt 的 inference endpoint;
    • 每個請求的 prompt 都完全不同(例如 ad-hoc code generation、純 RAG 而前綴較短);
    • 超短 context(< 256 tokens),Radix 管理 overhead 可能大於節省量。

    3. 成本 vs 延遲 vs 准確率:避免盲目開高配置

    • OOM 風險:
    • prefix pool 太大(prefix_pool_size、max_depth 過高),再配合大 batch,極容易炸 GPU memory;
    • 建議先從較保守的配置開始(如 max_depth=6、prefix_pool_size=4096),再逐步調高。

    • 吞吐 vs 延遲:

    • 高 batch size 能提升吞吐,但 tail latency 會變長;
    • RadixAttention 本身降低了 per-request 計算量,可以考慮 用其中一半收益換掉尾延遲,而不是全部拿來堆吞吐。

    • 准確率 / 行為一致性:

    • 在理論上 RadixAttention 不應改變模型輸出,但實作上若 prefix chunking / alignment 寫錯,可能導致 off-by-one bug;
    • 上線前務必做 回歸測試:相同 prompt,在開/關 Radix 時輸出應一致(或數據上差異可接受)。

    4. 監控與回滾

    部署 RadixAttention 時,務必加上:

    • 前綴重用率指標:例如每 batch 平均共享 token 數;
    • GPU memory 利用率與 OOM 次數;
    • 延遲分佈(p50 / p90 / p99)。

    若發現:

    • 重用率低(比如平均只共享 < 10% tokens),
    • 或 tail latency 反而變高,

    那就表示你的 workload 不適合,或 prefix 分組策略不對,需要調整甚至關閉。


    總結:什麼專案值得優先導入 RadixAttention?

    如果你的專案符合以下 3 點,非常值得先試 SGLang RadixAttention:

    1. System prompt + 工具描述 > 1k tokens,且所有請求共用;
    2. 同一 Agent 多 session / 多租戶跑在同一模型實例;
    3. 延遲敏感(需要 TTFT < 500ms、整體 latency < 2–3s)。

    在這些情境下,實務上很容易看到 延遲砍半、成本下降 20–40% 的效果,而且只需調整 SGLang 的推理配置,不必改模型、不必改大部分上層業務邏輯。

    對於正要把 Agent 往產線推的團隊,這是一個相對低風險、但高回報的優化點,值得早期就納入架構設計。


    🚀 你現在可以做的事

    • 在現有 SGLang 伺服器上,先套用文中的 Config 1 或 Config 2 測試延遲變化
    • 為你的 Agent 標註 toolset_id / doc_set_hash,實作 prefix 分組並觀察前綴重用率
    • 撰寫回歸與壓測腳本,比較開關 RadixAttention 時的 p50/p95 延遲與成本差異