
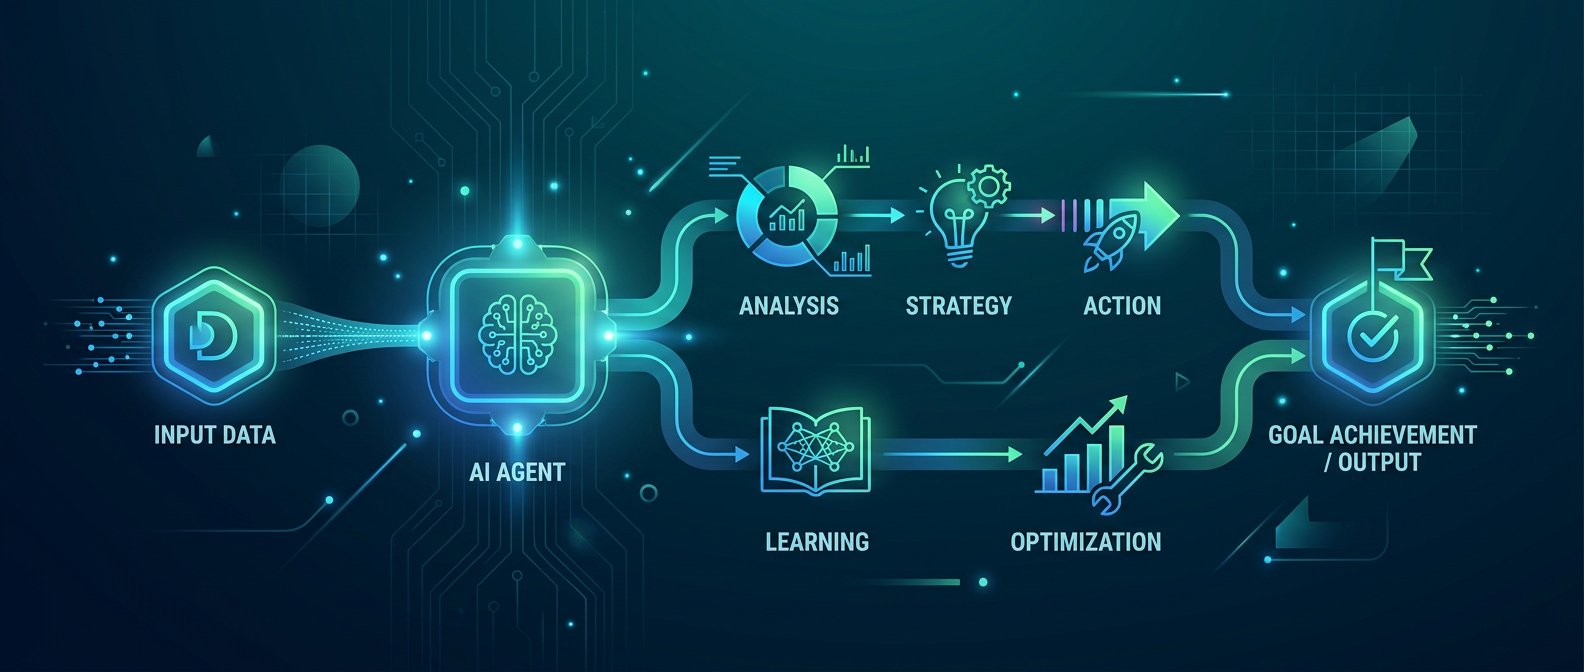
📌 本文重點
- Fable 5.1 直接優化整體 agent 任務成本與穩定性
- 長鏈工具協作與程式碼生成表現大幅提升
- Prompt caching 降價,有利多輪、大上下文任務
Claude Fable 5.1 解決的是 「端到端 agent 任務成本太高、長工具鏈容易崩、程式碼與規劃能力不足」 這三個痛點。它不是只把模型變強,而是 直接優化了 agentic workload 的技術路徑與計費結構:長鏈工具調用更穩、規劃與程式碼能力更好,且對可快取的上下文大幅降價,讓「完成一個任務」的總成本顯著下降。
重點說明:Fable 5.1 與 Agentic Workload 的契合
1. 模型層面:長工具鏈、多輪規劃、程式碼生成
Anthropic 公開數據與第三方報導指出:
- Terminal-Bench-Science 分數翻倍:代表長流程、工具協作的研究任務表現明顯提升。
- Agentic coding 效率提升 >30%:在自主任務執行(規劃 → 寫程式 →呼叫工具 →迭代)場景下,完成同一任務所需的步數與錯誤率降低。
💡 關鍵: Terminal-Bench-Science 翻倍與 agentic coding 提升超過 30%,代表長鏈研究與程式碼驅動的任務,成功率與效率都有顯著躍升。
這對典型 agent 任務(例如:爬資料 → 清洗 → 分析 → 寫報告)的實際意義是:
- 模型更擅長 先規劃步驟再執行,不是一股腦亂 call 工具。
- 程式碼生成與修錯能力變強,自己 debug + 重試的成功率更高。
- 長鏈任務中,中途少自爆(hallucinated 工具、亂改 schema),需要你人工兜底的地方更少。
你可以把 Fable 5.1 當成:預設就較「agent-aware」的強模型,在多輪規劃與工具協作上比一般對話模型更穩定。
2. 計費層面:針對 Prompt Cache 的降價
The Verge 指出 Fable 5.1 在 一般使用降價約 25%,agentic 任務最多降到 45%,關鍵是:
對已快取(cached)的上下文內容,二次使用時大幅降價。
💡 關鍵: 多輪、大上下文的 agent,只要穩定命中 prompt cache,就能把整個任務的總成本壓低到最多約 45% 的降幅。
對 agent 架構的直接影響:
- 每一輪 agent loop 都要帶上:system prompt + 工具定義 + 專案說明 + 長期記憶。
- 在 Fable 5.1 上,只要這些內容 穩定不變且被 prompt caching 命中,後面每一輪的成本就會顯著下降。
對比角度:
- 單次 API 價格:也許某些競品模型便宜一點。
- 完成一次端到端任務的總成本:Fable 5.1 因為 cached 部分便宜,對「要跑很多輪、每輪上下文都很大」的 agent 任務,總成本反而更低。
關鍵結論:如果你的系統屬於「長對話、多輪 agent loop、工具定義與系統提示固定」類型,Fable 5.1 的計費模型會直接拉低你的 TCO,而不是只在看起來很漂亮的 token 單價上做文章。
3. 架構實務:什麼情境用 Fable 5.1,什麼情境用小模型
從 agentic workload 的角度,你可以這樣粗分:
- 用 Fable 5.1 的場景:
- 需要 多步任務規劃(例如研究、資料 pipeline、產品分析)。
- 涉及 程式碼撰寫+工具協作(API 編排、MCP 工具、DB 操作)。
-
單次任務可能要跑 10+ 回合模型調用,且每回合都依賴大段穩定上下文。
-
仍該用便宜小模型的場景:
- 簡單分類、routing、意圖判斷、快速粗摘要。
- 高 QPS、對錯一兩次問題不大,又可後續人工糾正的服務。
- 作為「前置分流」:先由小模型判斷是不是需要啟動昂貴 agent,再交給 Fable 5.1 接手。
實作範例:用 Fable 5.1 設計一個長鏈 Research Agent
以「爬資料 → 清洗 → 分析 → 寫報告」為例,示範如何用 Fable 5.1 建一個最小可用的 agent。
1. 任務分解與主迴圈(pseudo-code)
假設用 Claude Agent SDK 或自建 loop,主流程可以是:
import anthropic

client = anthropic.Anthropic(api_key="YOUR_KEY")

SYSTEM_PROMPT = """
You are a research agent. Goal: answer complex questions via web research.
Always:
1) Plan steps.
2) Use tools instead of guessing.
3) Log decisions concisely.
"""

TOOLS = [
  # MCP or自訂工具:web_search, fetch_url, run_sql, python_exec 等
]

def run_agent(task: str, memory: dict):
    """Agent 主迴圈:規劃 -> 工具呼叫 -> 更新記憶 -> 判斷是否完成"""

    for step in range(20):  # 安全上限,避免 runaway loop
        response = client.messages.create(
            model="claude-3.5-fable-5.1",  # **關鍵:使用 Fable 5.1**
            max_tokens=1500,
            temperature=0.2,
            system=SYSTEM_PROMPT,     # **可快取:固定 system**
            tools=TOOLS,              # **可快取:固定 tool schema**
            messages=[
                {"role": "user", "content": [
                    {"type": "text", "text": _build_user_state(task, memory)}
                ]}
            ]
        )

        # 解析工具呼叫
        tool_calls = _extract_tool_calls(response)
        if not tool_calls:
            # 沒有工具呼叫時,視為嘗試總結
            summary = _extract_text(response)
            if _is_task_completed(summary):
                return summary
            else:
                # 請模型重新規劃,而不是直接結束
                memory["logs"].append({"type": "retry", "summary": summary})
                continue

        # 執行工具 & 更新記憶
        for call in tool_calls:
            result = _run_tool_safely(call)  # **防止 hallucinated tool**
            memory["tool_results"].append({"call": call, "result": result})

    raise RuntimeError("Agent loop exceeded max steps")
這裡的重點:
- system、tools 設定固定不變:利於 prompt caching 被命中,讓每輪成本下降。
- 每回合都由 Fable 5.1 做 規劃 + 工具選擇,利用其 agentic coding / planning 的優勢。
- 有明確的 step 上限與完成判斷,避免 agent loop 無限迴圈。
2. 工具定義與 MCP 整合(簡化版)
假設我們使用 MCP 定義工具,給模型的是類似 JSON schema:
[
  {
    "name": "web_search",
    "description": "Search the web for recent information",
    "input_schema": {
      "type": "object",
      "properties": {
        "query": {"type": "string"},
        "limit": {"type": "integer", "default": 5}
      },
      "required": ["query"]
    }
  },
  {
    "name": "python_exec",
    "description": "Run Python code for data cleaning and analysis",
    "input_schema": {
      "type": "object",
      "properties": {
        "code": {"type": "string"}
      },
      "required": ["code"]
    }
  }
]
在 Fable 5.1 下,模型更擅長:
- 正確拼 工具名稱與參數,減少「亂 call 不存在的工具」問題。
- 用
python_exec寫出可運行、可迭代修正的清洗/分析程式碼。
3. 粗分流:先用小模型判斷是否需要啟動大 Agent
為了成本控制,可以加一層 router 模型:
SMALL_MODEL = "claude-3-haiku"  # 或其他便宜模型

def route(task: str) -> str:
    """粗分流:simple | moderate | complex"""
    resp = client.messages.create(
        model=SMALL_MODEL,
        max_tokens=128,
        temperature=0,
        system="Classify the task complexity for an AI agent.",
        messages=[{"role": "user", "content": task}]
    )
    label = _extract_label(resp)
    return label

# 使用方式
label = route(user_task)
if label == "simple":
    # 直接用小模型回答,不啟動 Fable 5.1 agent
    answer = client.messages.create(
        model=SMALL_MODEL,
        system="Answer concisely without using tools.",
        messages=[{"role": "user", "content": user_task}]
    )
else:
    # 啟動 Fable 5.1 長鏈 agent
    answer = run_agent(user_task, memory={"logs": [], "tool_results": []})
這樣可以把大量「不需要長鏈規劃」的查詢擋在外面,讓 Fable 5.1 只處理真正值得它出手的任務,整體成本顯著下降。
建議與注意事項:踩坑與最佳實踐
1. 避免 prompt 不可快取導致成本回升
要吃到 Fable 5.1 的 prompt caching 降價,需注意:
- system prompt、工具 schema 不要每次動來動去:盡量穩定、版本化管理。
- 把易變的內容(例如使用者偏好、session 狀態)放在 messages 中的 user/assistant 部分,而不是塞進 system。
- 減少整段覆寫 system 的模式,改為在 user prompt 中表達細節。
實務上,可以:
- 固定一個 CLAUDE.md / system file,只在真的需要時調整。
- 拆成:global system(穩定) + per-project instructions(少變) + per-task context(常變)。前兩者易被 cache,新增內容放在第三層。
2. 避免 hallucinated tool calls:加一層工具驗證
即使 Fable 5.1 對工具調用已較穩定,長任務中仍可能出現:
- 呼叫不存在的工具名。
- 傳入錯誤型別/缺失必要欄位。
最佳實踐:
- 在
_run_tool_safely(call)中,先檢查: call.name是否在允許列表中。-
call.arguments是否符合 schema(型別、必填欄位)。 -
如果不合法,不要直接 raise error,而是:
- 把錯誤回寫到記憶
memory["tool_results"]。 - 再回給模型一輪,要求它修正工具呼叫。
這樣可以讓 Fable 5.1 自己修正錯誤呼叫,減少整個任務失敗的機率。
3. 觀測與限流 agent 迴圈:避免失控成本
Agent 本質是 迴圈,Fable 5.1 雖然每輪變便宜,但如果不設限,一樣會爆:
建議:
- 硬限制每個任務的最大步數(例:20 或 30 回合)。
- 為每個任務維護 cost budget:到達預算上限就要求模型給出當前最佳總結,而不是繼續探索。
- 觀測指標:
- 平均完成任務的 模型呼叫次數。
- 平均完成任務的 總 token、總成本。
- 每輪工具成功率(有沒有頻繁 retry)。
可以參考「agent economics」文章中的建議,把注意力從 單價移到 成功完成一次任務的成本,定期調整:
- 是否需要更 aggressive 的前置分流。
- 是否要把部分子任務換到更便宜的模型。
4. 是否從現有 GPT / Claude 版本切到 Fable 5.1?
可以用以下思路做工程與成本評估:
- 現有任務分析:
- 每個任務平均需要幾輪模型調用?
-
每輪上下文大致多少 token?哪些部分是固定?
-
成本模擬:
- 估算在 Fable 5.1 上:固定部分命中 cache 後的 token 單價 × 多輪迴圈,得到 per-outcome 成本。
-
對比目前的 GPT/Claude 模型:尤其是沒有類似 cache 降價機制的情況。
-
技術適配度:
- 如果你的任務高度依賴 程式碼生成+工具協作,Fable 5.1 的 agentic coding 提升會讓 成功率與迴圈次數都有實質改善。
- 若多數任務只是單輪問答、短工具鏈,收益可能有限,遷移優先級就不高。
總結建議:
- 有長鏈 agent、工具協作、多輪規劃的系統,優先考慮切到 Fable 5.1,並重寫 prompt 以配合 caching。
- 沒有明顯 agentic workload 的產品,可以先在部分高價值任務上試點,觀測 成功率與 per-task 成本,再決定是否全面遷移。
整體來看,Claude Fable 5.1 的升級方向非常明確:不是讓單次回答更華麗,而是讓「一整個任務」更有規劃、更穩、更便宜。如果你的系統已經不是單輪聊天,而是實打實的 agent 架構,它目前是值得嚴肅評估的主力模型之一。
🚀 你現在可以做的事
- 整理並固定你的
system prompt與工具 schema,檢查哪些部分可以穩定被 prompt cache 命中- 實作一個簡單的
run_agent()主迴圈,將現有長鏈任務遷移到claude-3.5-fable-5.1上試跑- 加上一層使用
claude-3-haiku的粗分流 router,量化「per-task 成本」與成功率的改變
發佈留言