
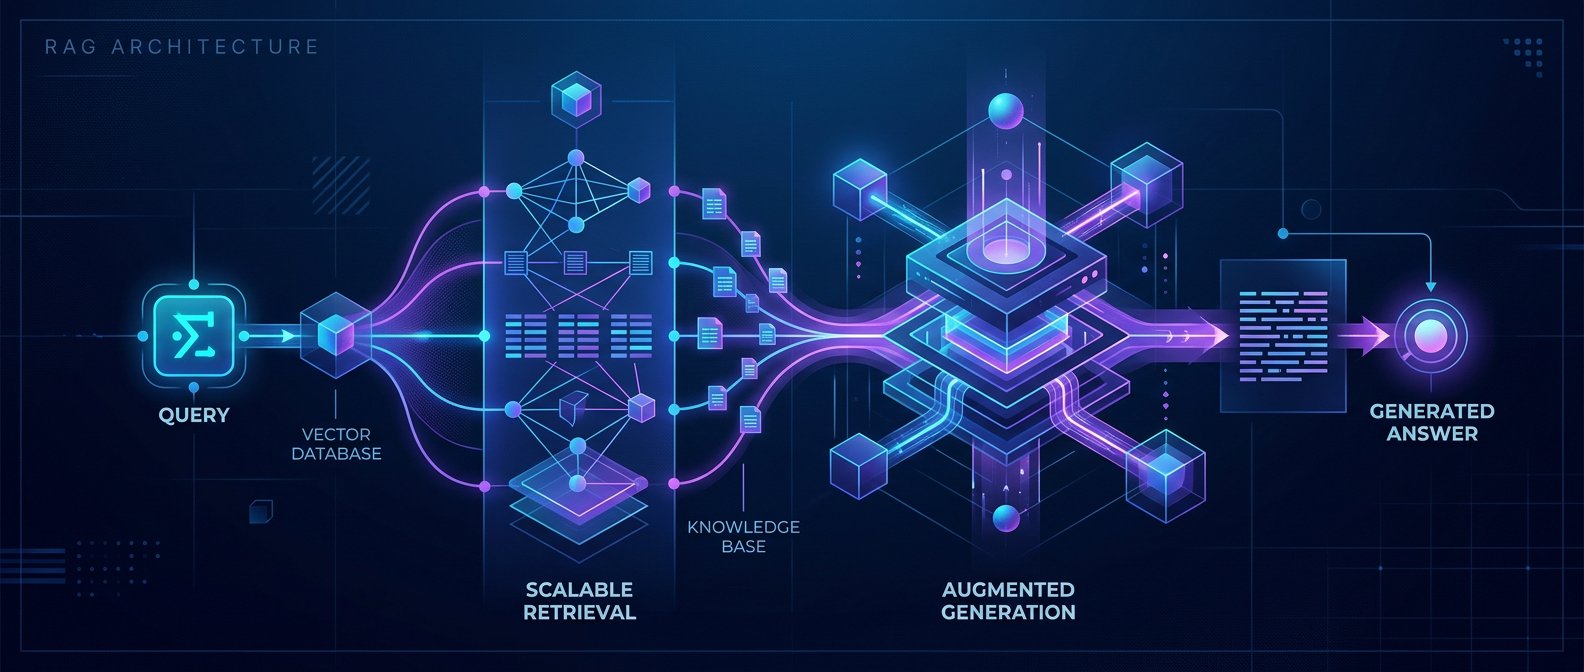
📌 本文重點
- 生產級 RAG 核心在「檢索精準度」
- 先設計穩定索引管線,再優化查詢路徑
- 權限與多租戶必須在索引層處理
- 把 RAG 當「檢索系統 + LLM」來設計
在 demo 環境跑得很順的 RAG,一接上真實企業文件就開始答非所問、亂編內容、延遲爆炸。這篇文章要解決的痛點很直接:如何把「玩具級 RAG」變成「可以被客服、業務、內部搜尋真正依賴」的生產系統,而不是靠換更大的 LLM 硬撐。
重點說明:兩個關鍵心智模型
1. 檢索精準度 > 模型能力
多數生產事故不是 LLM 太笨,而是檢索到的內容就錯了:
- chunk 切太碎:一句關鍵話被切開,LLM 根本看不到完整前後文
- embedding 品質差:相似度搜尋抓不到真正相關的段落
- 檢索策略太單純:只用
top-k dense vector,忽略 metadata / keyword / rerank
💡 關鍵: 先把檢索品質拉高,通常比直接換更大的模型帶來更高的整體效益。
結論:先優化檢索,再考慮換更大的模型。實務上,花在檢索調整的時間,ROI 通常比換模型高很多。
2. 系統品質由最弱環節決定
一個典型 RAG 流水線:
資料 → chunking → embedding → 向量庫/索引 → 查詢策略 → rerank → LLM 回答
任何一段出問題,整條鏈就報廢:
- Chunking 不考慮結構:FAQ 題目和答案被拆開
- 向量庫設計混亂:不同語言、不同資料源混在同一 index
- 檢索策略只有單一路徑:某個類型問題天生查不到答案,直接導致幻覺
把它當成一條 ML data pipeline 來設計:
先穩定離線索引,再設計可觀測的線上查詢路徑。
離線索引管線:從混亂文件到可用索引
1. 資料清洗與格式統一
企業常見情境:Confluence、PDF 掃描檔、工單、Excel 報表全混在一起。
目標:轉成「統一的文件 schema」,例如:
{
  "doc_id": "policy-2024-hr-001",
  "source": "confluence",
  "title": "2024 HR 政策總則",
  "lang": "zh-TW",
  "section_path": ["人資", "請假制度"],
  "content": "純文字內容...",
  "permissions": ["dept-hr", "role-admin"],
  "updated_at": "2024-05-01T10:00:00Z"
}
重點:
- 提前把 權限、多租戶標籤、語言 等 metadata 帶上,後面檢索才能 filter
- 盡量在這一步做結構抽取(標題、段落、表格轉文字)
2. Chunk 策略:不是「固定 500 tokens 就好」
實務上可以用「結構優先 + 長度限制」策略:
MAX_TOKENS = 350
OVERLAP_TOKENS = 50

# 1. 先依標題 / 小節切
sections = split_by_headings(doc.content)

# 2. 每個 section 再依 token 長度切成多個 chunk
chunks = []
for sec in sections:
    for c in sliding_window_tokenize(
        sec,
        max_tokens=MAX_TOKENS,
        overlap_tokens=OVERLAP_TOKENS,
    ):
        chunks.append({
            "doc_id": doc.doc_id,
            "section_title": sec.title,
            "content": c.text,
            "start_offset": c.start,
            "end_offset": c.end,
        })
好處:
- 儘量保持語意完整的段落,減少「半句話」的 chunk
- 使用 overlap 避免重要句子剛好被切斷
3. Embedding 批次處理與向量庫設計
建議:
- 儘量統一使用 同一個 embedding 模型 處理相同語料
- 做 batch embedding,避免每個 chunk 單獨呼叫 API 導致吞吐量慘烈
示意程式碼:
from openai import OpenAI
from tqdm import batched

client = OpenAI()

EMBED_MODEL = "text-embedding-3-large"
BATCH_SIZE = 256

vectors = []
for batch in batched(chunks, BATCH_SIZE):
    texts = [c["content"] for c in batch]
    resp = client.embeddings.create(
        model=EMBED_MODEL,
        input=texts,
    )
    for c, emb in zip(batch, resp.data):
        vectors.append({
            "id": f"{c['doc_id']}::{c['start_offset']}",
            "embedding": emb.embedding,
            "metadata": {
                "doc_id": c["doc_id"],
                "section_title": c["section_title"],
                "permissions": doc.permissions,
                "lang": doc.lang,
                "source": doc.source,
            },
        })
向量庫設計要點(不管你用 Pinecone、Weaviate、Qdrant、pgvector):
- 每個 index 維持單一主要語言或資料型態,避免 embedding 空間太混
- 必須支援 metadata filter(之後做權限、多租戶隔離)
線上查詢路徑:多路檢索 + Rerank + Fallback
1. 多路檢索與 metadata filter
典型路徑不是一發向量搜尋就結束,而是:
- 根據使用者身份加上 權限 filter
- 同時走 向量檢索(semantic) 與 關鍵字 / BM25(lexical)
- 合併結果後用 reranker 排序
假設你用的是一個支援 hybrid search 的向量庫:
query_vector = embed_query(user_query)

filters = {
  "must": [
    {"key": "tenant_id", "match": user.tenant_id},
    {"key": "permissions", "in": user.roles},
  ]
}

# dense + keyword 路徑
vec_results = vector_index.search(
    vector=query_vector,
    top_k=30,
    filter=filters,
)

keyword_results = keyword_index.search(
    text=user_query,
    top_k=30,
    filter=filters,
)

candidates = dedup(vec_results + keyword_results)
2. 使用 rerank 提升最終精準度
在 top-30 或 top-50 候選上,用一個更強的 cross-encoder / LLM reranker 排序:
from my_reranker import cross_encoder_rerank

reranked = cross_encoder_rerank(user_query, candidates)  # 回傳已排序列表
top_contexts = reranked[:5]
好處:
- dense 向量比較好抓「同一概念不同字眼」
- keyword 比較好抓「精準術語」與數字、代碼
- rerank 用較貴的模型,但只跑在小量候選上,CP 值高
3. LLM 回答與 Fallback 策略
最後呼叫 LLM 時,不要直接餵所有 chunk,而是:
- 限制 context 數量(例如最多 4–8 個 chunk)
- 明確告訴模型:只能根據提供的資料回答
SYSTEM_PROMPT = """你是公司內部知識庫助理,只能根據提供的 context 回答。
如果找不到答案,請明確回答「依目前資料無法確認」。
"""

context_str = "\n\n".join(
    [f"[{i}] {c['content']}" for i, c in enumerate(top_contexts)]
)

completion = client.chat.completions.create(
    model="gpt-4.1-mini",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"問題:{user_query}\n\n參考資料:\n{context_str}"},
    ],
)
Fallback 設計建議:
- 若檢索結果的 相似度分數都低於某門檻,直接回答「查無對應資料」而非亂編
- 若向量檢索失敗,可 fallback 成只用 keyword search
常見坑與實戰建議
1. 混亂企業文件與長上下文幻覺
- 問題:把整份 PDF 直接丟進 LLM 的 long context,看起來很酷,但成本與幻覺都超高
- 建議:
- 把 long context 當成 最後手段,先用精準檢索把範圍縮小
- 針對常見錯誤問句,建立 失敗樣本集,離線迭代 chunking / 檢索策略
2. 權限與多租戶
- 絕對不要在 LLM prompt 內才控制權限
- 權限應該在 向量庫的 metadata filter 層 完成
- 多租戶建議:
- 小規模:同一 index,用
tenant_id做 filter - 大客戶:獨立 index,避免資料量與權限邏輯互相影響
3. 成本與延遲控制
可以從幾個槓桿調整:
top-k:從 20 慢慢調到 50 看效果,不要一開始就丟 100- 使用
gpt-4.1-mini/ Llama 小模型當回答模型,搭配精準檢索,通常已足夠 - 批次 embedding、批次向量查詢,減少 API round-trip
💡 關鍵: 先優化
top-k、模型選型與批次策略,往往就能在不換主模型的情況下顯著降低成本與延遲。
4. 離線評估與線上監控
離線評估:
- 建立一小包「問題–標準答案–應該被檢索到的 chunk」
- 指標:
Hit@k、MRR、生成答案與標準答案的相似度
線上監控:
- 記錄每次 query 的:
- 檢索到的
doc_id/ 相似度分數 - LLM 回答 + 使用者後續行為(是否重新提問、是否人工改寫)
- 針對「多次重試」或「被人工標記錯誤」的 query,自動加入離線失敗樣本集
不同規模專案的 RAG 架構選型建議
1. 小型專案(單一產品 FAQ / 文件 < 1k 篇)
- 架構:Single-vector RAG 即可
- 單一向量庫 index
- 單一路徑的向量檢索(
top-k=10)+ 簡單 rerank 或甚至不 rerank - 什麼時候足夠:
- 問題類型集中、文件格式相對乾淨
- 沒有複雜權限、多租戶
2. 中型專案(多產品、多來源文檔,含內部知識庫)
- 架構:Hybrid Search RAG
- 向量檢索 + keyword/BM25 檢索
- Metadata filter 處理基本權限、多語言
- reranker 排序
top-30 - 適用情境:
- 文件來源與格式混雜
- 問題類型多樣(政策、程式碼、FAQ 混在一起)
3. 大型企業級專案(多租戶 SaaS、嚴格權限控制)
- 架構:分層 RAG pipeline
- 第一層:根據 query 先判斷「要去哪個 domain / product / tenant」
- 第二層:在該 domain 內做 hybrid search + rerank
- 針對高價值流程(法務、財務)再加一層 LLM verification / rule-based check
- 必備:
- 完整 observability(檢索 log、失敗樣本管理)
- 嚴格權限控制嵌在 index filter,不依賴 prompt
小結:先把檢索做好,再談「更聰明的模型」
如果要一句話總結生產級 RAG:
把它當檢索系統 + LLM,而不是 LLM + 一點點檢索。
從離線索引管線、chunk 策略、向量庫設計到線上多路檢索與 rerank,只要能有系統地優化這些「最弱環節」,你的 RAG 往往在不升級模型的情況下,就能從 demo 品質變成可以上線承壓的生產系統。
🚀 你現在可以做的事
- 把現有企業文件先整理成統一
document schema,並補上權限與語言等 metadata- 實作一條離線 chunking + batch embedding 管線,搭配支援 metadata filter 的向量庫
- 為常見查詢建立「失敗樣本集」,定期用
Hit@k/MRR檢驗並調整檢索與 chunk 策略
發佈留言