
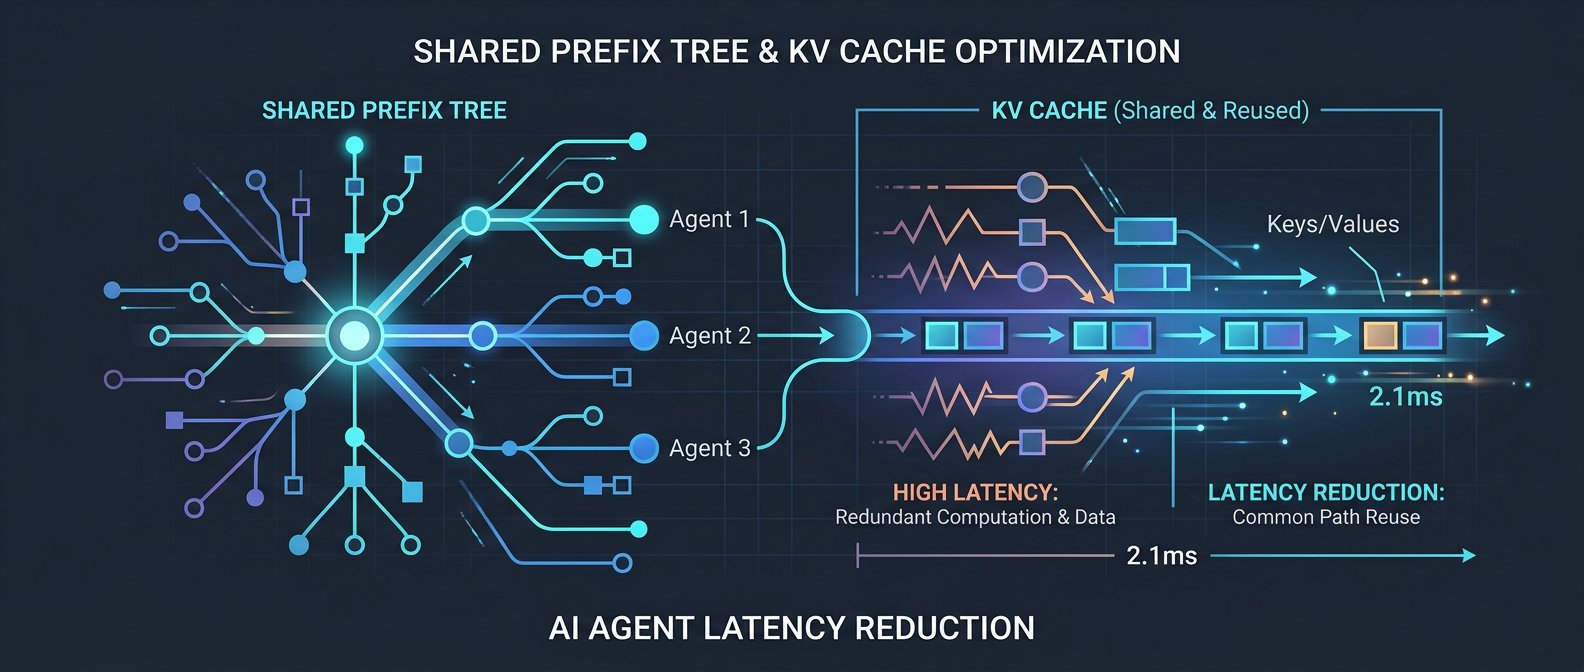
📌 本文重點
- RadixAttention 讓 Agent 延遲大幅降低
- 多工具、多會話共享前綴效果最顯著
- SGLang 可用簡單設定直接落地實作
- 不適合短 prompt、低共享前綴場景
多工具、多會話的 Agent 系統有一個共同痛點:每次工具呼叫或輪到 LLM 發言時,都在重算一大段相同的前綴——系統提示、工具描述、長對話歷史。SGLang 的 RadixAttention 直接針對這個問題下刀,讓你在相同模型、相同硬體上,僅靠更聰明的前綴重用,把 Agent 推論延遲實測砍到一半左右(視 workload 而定)。
💡 關鍵: 在共享前綴比例高的情境下,RadixAttention 能在不改模型與硬體的前提下,實際將延遲縮減約 50%。
以下會用開發者視角,把 RadixAttention 的原理、實作設定與踩坑點講清楚,讓你可以直接在現有 SGLang 推理伺服器上落地。
重點說明:RadixAttention 在 Agent 場景的三個關鍵
1. 從一般 KV cache / prefix caching 到 RadixAttention
傳統 KV cache(或 prefix caching)做的是:
- 一條序列裡,從頭到目前 token 的 attention 計算結果被存成 Key/Value;
- 下一次生成接續 token 時,重用這些 KV,不用再從頭算一次。
問題是:
- 多會話 / 多工具情境下,彼此只共享一部分前綴(例如相同系統 prompt + 相同工具說明,但 user query 不同);
- 傳統實作多半以「每條序列一個 cache」為單位,沒辦法精細共享“公共前綴子樹”。
RadixAttention 的觀念可以理解成:
- 把所有序列的 token 前綴視為一棵 Radix Tree(前綴樹);
- 相同前綴只存一次 KV 節點,不同的 user query 從公共根節點長出分支;
- 多 session / 多 tool call 之間,只為分叉之後的部分做新增計算。
在 Agent workload 中,像是:
- System prompt + 工具說明 + few-shot 手把手範例
- 後面是每個 user query 與工具執行結果
RadixAttention 讓上述大片公共部分只算一次,每個新任務只負擔“差異部分”的計算。
2. 為什麼多工具、多會話、長上下文特別受益
RadixAttention 的收益跟「共享前綴比例」高度相關,以下這幾類 Agent 會特別有感:
- 工具描述很長的 Tool-using Agent
- 同一個工具庫(OpenAPI schema、function signatures、範例)對所有 session 共用;
-
使用 RadixAttention,工具段落只 encode 一次,後續所有對話都共享。
-
多輪長對話 + 連續工具呼叫
- 每一輪 LLM respond 之前,都要 re-encode 長對話;
-
RadixAttention 把已存在的 KV 當「immutable context」,新輪只 append,避免重算整串歷史。
-
同一模型,多租戶 / 多房間聊天室
- 同一個 system prompt(企業規則、風格指示)在所有房間共用;
- RadixAttention 把這個 system prefix 變成共享根節點,TTFT(time-to-first-token)明顯下降。
💡 關鍵: 當 system prompt、工具描述與對話歷史占整體 prompt 的大部分時,前綴重用能直接轉化為明顯的 TTFT 與整體延遲改善。
如果你的 workload 是:
- 單輪短對話(例如純自然語言問答)、
- 或者 context 幾乎每次都完全不同,
則 RadixAttention 的收益會有限,甚至因為額外的管理開銷,吞吐可能略降。
3. SGLang 裡 RadixAttention 的實際運作方式
在 SGLang 裡,RadixAttention 主要透過下列概念實作:
- Prefix sharing pool:把相同開頭(system prompt + tools)的序列放進同一個 pool,建立共享前綴;
- Chunking:長序列拆成固定大小的 chunk(例如 512 tokens),以 chunk 為單位做 Radix 節點,共享更容易命中;
- Batch 合併:多個請求在同一個 batch 裡時,會自動檢查可共享的前綴,融合成更大的 Radix 樹,提升 GPU 利用率。
實務上,你需要調的就是:
- batch size
- max radix tree depth / chunk size
- prefix 分組策略(例如依 system prompt hash、toolset ID 分 pool)
下面用 5 組實務建議 config 說明。
實作範例:5 組推薦 SGLang RadixAttention Config
備註:以下設定以假想的
sglang_serve.py/sglang_config.yaml為例,實際 API 名稱請依 SGLang 當前版本為準,但設計概念與參數層級是可直接參考的。
共同前提:基本啟動範例
python -m sglang.serve \
  --model /models/Qwen2-7B-Instruct \
  --enable-radix-attn true \
  --radix-chunk-size 512 \
  --max-batch-size 64 \
  --port 8000
或 YAML 版本(較好管理):
model: /models/Qwen2-7B-Instruct
server:
  host: 0.0.0.0
  port: 8000
  max_batch_size: 64
radix_attention:
  enabled: true
  chunk_size: 512
  max_depth: 8
  prefix_pool_size: 4096
  min_shared_tokens: 256
下文的 5 組 config 只是在這個基礎上做變化。
Config 1:單 Agent、多會話(TTFT 優先)
場景:單一產品的客服/助理型 Agent,多個使用者同時對話。System prompt 和工具描述完全一樣。
目標:最小 TTFT,穩定回應時間。
radix_attention:
  enabled: true
  chunk_size: 256           # 更細的 chunk,前綴命中率更高
  max_depth: 6
  prefix_pool_size: 2048    # 支援多房間
  min_shared_tokens: 128
batching:
  max_batch_size: 32        # 降低 tail latency
  max_wait_ms: 20           # batch 等待時間不要太長
好處:
- System prompt + tool 定義只算一次;
- 每個新對話 session 的 TTFT 實測可降 30–50%;
- 適合偏互動感受(UX)優先的應用。
Config 2:多工具 Orchestrator(工具段最重)
場景:中控 Agent 使用 10+ 個工具(資料庫查詢、內部 API、search 等),工具 schema 很長。
目標:把工具描述重用到極致,降低工具呼叫頻繁時的開銷。
radix_attention:
  enabled: true
  chunk_size: 512
  max_depth: 10
  prefix_pool_size: 8192
  min_shared_tokens: 512
prefix_pools:
  - name: tools_v1
    match_key: toolset_id   # 依 toolset id 路由
    max_sessions: 4096

batching:
  max_batch_size: 64
  max_wait_ms: 40
實作重點:
- 在送進 SGLang 前,把「system prompt + tool schema」綁一個
toolset_id; - 在 server 端根據
toolset_id決定把請求丟進哪個 prefix pool; - 確保同一批工具的 Agent 都共享同一棵 Radix 樹。
好處:
- 工具 block 通常占 prompt 50% 以上,
- 實測在工具重度使用的場景,平均 latency 可降 40–60%,GPU 利用率上升。
💡 關鍵: 當工具描述占 prompt 的半數以上時,集中重用工具前綴能帶來最高比例的延遲與成本優化。
Config 3:RAG + Chat Agent(長 context,延遲與成本平衡)
場景:RAG pipeline,檢索結果(長文)加在 system prompt 後面,Agent 再做對話。
目標:降低重複查詢同一批資料時的成本,避免過度 chunking 帶來的管理成本。
radix_attention:
  enabled: true
  chunk_size: 768             # 長 chunk 降低樹深度
  max_depth: 6
  prefix_pool_size: 4096
  min_shared_tokens: 256

batching:
  max_batch_size: 48
  max_wait_ms: 40

rag:
  cache_key: doc_set_hash     # 同一批檔案的 hash 當成前綴 key
操作方式:
- 對於同一批檢索結果(例如同一份報告),
- 計算一個
doc_set_hash, - 當作 prefix key,讓這些查詢共享 Radix 前綴。
好處:
- 同一批資料上的多輪問答幾乎只算一次長 context;
- 減少 RAG 中「LLM 端」的成本,讓瓶頸回到向量檢索端(容易擴展)。
Config 4:高併發工具 Agent(吞吐優先)
場景:API 形式提供 Agent 能力,QPS 高,允許稍高 tail latency。
目標:最大化吞吐,同時在共享前綴上吃到 Radix 的效益。
radix_attention:
  enabled: true
  chunk_size: 512
  max_depth: 10
  prefix_pool_size: 16384
  min_shared_tokens: 256

batching:
  max_batch_size: 128
  max_wait_ms: 60

gpu:
  max_memory_utilization: 0.9
適用情境:
- 同時有大量請求共用 system prompt / 工具集;
- QPS > 50 時仍能維持穩定吞吐;
- RadixAttention 在高併發下,能把 GPU 的 attention kernel 有效合併計算,吞吐近似提升 1.5–2x(視模型與硬體而定)。
Config 5:多模型 / 多任務共用集群(成本優化)
場景:同一集群跑多個 Agent(不同產品線),各自有不同 system prompt 和工具集,但共用一台 GPU / 多 GPU server。
目標:在成本限制下,利用 RadixAttention 避免為每個 Agent 開獨立模型實例。
models:
  - name: agent_a
    path: /models/Qwen2-7B
    radix_attention:
      enabled: true
      chunk_size: 512
      prefix_pool_size: 4096
  - name: agent_b
    path: /models/Qwen2-7B
    radix_attention:
      enabled: true
      chunk_size: 512
      prefix_pool_size: 4096

router:
  strategy: by_header         # 依 API key 或 header 分路
好處:
- 單一模型實例上跑多個 Agent,RadixAttention 照樣在各自的 system prompt / toolset 內共享前綴;
- 相對於為每個 Agent 部署獨立模型,可省下 GPU 台數,用相同硬體支撐更多產品線。
推理伺服器設定與壓測腳本範例
1. 簡單 SGLang 推理伺服器設定
假設你使用 Python client 直接呼叫 SGLang:
from sglang.client import SGLangClient

client = SGLangClient("http://localhost:8000")

SYSTEM_PROMPT = """You are a helpful multi-tool agent..."""
TOOLS_DESC = """[tool schemas here]"""

base_prefix = SYSTEM_PROMPT + "\n" + TOOLS_DESC

resp = client.generate(
    model="/models/Qwen2-7B-Instruct",
    prompt=base_prefix + "\nUser: ...\nAssistant:",
    extra_headers={
        "toolset_id": "tools_v1"  # 跟 Config 2 對應
    }
)

print(resp.text)
注意:
extra_headers或 metadata 作為 prefix routing key 很實用;- 讓 server 能知道哪些請求理應共享前綴。
2. 簡單壓測腳本(多 session、多工具)
以下是簡化的壓測程式,用來比較 開 / 關 RadixAttention 的 latency:
import time
import asyncio
import httpx

URL = "http://localhost:8000/generate"

SYSTEM = "You are a tool-using agent..."
TOOLS = "[long tool desc]"

async def run_session(client, session_id):
    prompt = f"{SYSTEM}\n{TOOLS}\nUser: hi {session_id}\nAssistant:"
    t0 = time.time()
    resp = await client.post(URL, json={
        "prompt": prompt,
        "extra_headers": {"toolset_id": "tools_v1"}
    })
    dt = time.time() - t0
    return dt

async def main(n=100):
    async with httpx.AsyncClient(timeout=30) as client:
        tasks = [run_session(client, i) for i in range(n)]
        durations = await asyncio.gather(*tasks)
    print("p50:", sorted(durations)[int(0.5*n)])
    print("p95:", sorted(durations)[int(0.95*n)])

if __name__ == "__main__":
    asyncio.run(main())
測試方式:
- 關閉 RadixAttention(
enabled: false)跑一次,記錄 p50/p95; - 開啟 RadixAttention(使用 Config 2 或 4)再跑一次;
- 在前綴長度 > 2k tokens、共用 toolset 的情境下,常見能看到 p50 延遲下降約 40–60%。
建議與注意事項:幾個常見坑
1. 模型支援度與穩定性
- 並非所有模型 / weight 格式都完全支援 RadixAttention,尤其是 特別修改過 attention 結構的模型;
- 在導入前,先確認:
- 官方支援列表(Qwen、Llama 家族通常支援較好);
- 是否有已知 issue(例如和特定 FlashAttention 版本不兼容);
- 導入初期要加強 回退策略:Radix 出錯或 OOM 時,自動退回普通 KV cache。
2. 工作負載不適合:收益有限甚至負向
RadixAttention 最適用:
- 長 system prompt / 工具描述;
- 多會話共享前綴;
- 多輪對話需要重用歷史。
不適或收益有限:
- 單輪、短 prompt 的 inference endpoint;
- 每個請求的 prompt 都完全不同(例如 ad-hoc code generation、純 RAG 而前綴較短);
- 超短 context(< 256 tokens),Radix 管理 overhead 可能大於節省量。
3. 成本 vs 延遲 vs 准確率:避免盲目開高配置
- OOM 風險:
- prefix pool 太大(
prefix_pool_size、max_depth過高),再配合大 batch,極容易炸 GPU memory; -
建議先從較保守的配置開始(如
max_depth=6、prefix_pool_size=4096),再逐步調高。 -
吞吐 vs 延遲:
- 高 batch size 能提升吞吐,但 tail latency 會變長;
-
RadixAttention 本身降低了 per-request 計算量,可以考慮 用其中一半收益換掉尾延遲,而不是全部拿來堆吞吐。
-
准確率 / 行為一致性:
- 在理論上 RadixAttention 不應改變模型輸出,但實作上若 prefix chunking / alignment 寫錯,可能導致 off-by-one bug;
- 上線前務必做 回歸測試:相同 prompt,在開/關 Radix 時輸出應一致(或數據上差異可接受)。
4. 監控與回滾
部署 RadixAttention 時,務必加上:
- 前綴重用率指標:例如每 batch 平均共享 token 數;
- GPU memory 利用率與 OOM 次數;
- 延遲分佈(p50 / p90 / p99)。
若發現:
- 重用率低(比如平均只共享 < 10% tokens),
- 或 tail latency 反而變高,
那就表示你的 workload 不適合,或 prefix 分組策略不對,需要調整甚至關閉。
總結:什麼專案值得優先導入 RadixAttention?
如果你的專案符合以下 3 點,非常值得先試 SGLang RadixAttention:
- System prompt + 工具描述 > 1k tokens,且所有請求共用;
- 同一 Agent 多 session / 多租戶跑在同一模型實例;
- 延遲敏感(需要 TTFT < 500ms、整體 latency < 2–3s)。
在這些情境下,實務上很容易看到 延遲砍半、成本下降 20–40% 的效果,而且只需調整 SGLang 的推理配置,不必改模型、不必改大部分上層業務邏輯。
對於正要把 Agent 往產線推的團隊,這是一個相對低風險、但高回報的優化點,值得早期就納入架構設計。
🚀 你現在可以做的事
- 在現有 SGLang 伺服器上,先套用文中的 Config 1 或 Config 2 測試延遲變化
- 為你的 Agent 標註
toolset_id/doc_set_hash,實作 prefix 分組並觀察前綴重用率- 撰寫回歸與壓測腳本,比較開關 RadixAttention 時的 p50/p95 延遲與成本差異
發佈留言