標籤: 免費 AI 工具推薦

  • 用 Replit Free Mode 免費請 GPT-5.6 寫程式

    用 Replit Free Mode 免費請 GPT-5.6 寫程式

    📌 本文重點

    • Replit Free Mode 讓你免 API 金流直接用 GPT-5.6 Luna 寫程式
    • 一句人話就能從想法生成可執行程式並協助除錯、重構
    • 特別適合 side project、MVP、教學練習與小團隊 internal tool

    只想「講一句人話」就拿到能跑的程式?Replit 的 Free Mode 搭載 GPT-5.6 Luna,讓你不用管 API 費用,直接在雲端寫、改、跑程式。

    官方介紹:Replit Free Mode powered by GPT-5.6 Luna — OpenAI Blog | Replit 官網


    核心功能:一句話到可執行程式

    下面這幾個能力,基本涵蓋「從想法到可跑程式」的全流程,你可以逐一試。


    1. 自然語言生成完整程式

    能做什麼:

    • 把需求用白話打給 Luna:例如「幫我做一個輸入網址就抓頁面標題的 Python 小工具」。
    • Luna 會產生:程式碼 + 檔案結構 + 依賴套件(requirements.txt / package.json 等)。
    • 在 Replit 裡可以直接按 Run 驗證程式是否能跑。

    💡 關鍵: 你只要用自然語言描述需求,Luna 就能直接給出「可執行且帶完整檔案結構」的專案,而不是零散片段程式碼。

    可以馬上做的事:

    1. 登入 Replit 後新建一個 Python Repl。
    2. 打開右側 AI 面板(Luna),輸入你的需求。
    3. 要求它「請給完整程式碼並幫我建立必要檔案」。

    2. 自動改 Bug、看錯誤訊息

    能做什麼:

    • 程式跑錯、出現 trace?直接貼給 Luna:「我按 Run 後出現這段錯誤,幫我修」。
    • 它會解釋錯誤原因,提出修正版本,甚至直接在檔案中幫你改動。

    可以馬上做的事:

    1. 故意輸入一個會出錯的程式(例如少裝套件)。
    2. 把整段錯誤訊息貼給 Luna,問:「為什麼?」
    3. 再追問:「幫我改到可以跑,並說明你改了什麼。」

    3. 重構與加註解,變可讀程式

    能做什麼:

    • 把一整支亂成一團的函式貼給 Luna,說:「幫我拆成多個小函式並加中文註解」。
    • 可以指定風格:「註解只寫在關鍵邏輯,不要每行都寫」。

    可以馬上做的事:

    1. 找一段你寫過或在網路上找到的程式碼,貼給 Luna。
    2. 指令示例:
    3. 「幫我重構成更易讀的版本,保持功能相同。」
    4. 「加繁體中文註解,讓初學者也看得懂。」

    適合誰用:4 個高命中場景

    GPT-5.6 Luna 在 Replit Free Mode 裡最適合下面幾種日常開發場景,你可以對號入座。


    1. 個人 side project:快速拼出可以用的雛形

    典型需求:

    • 爬資料、寫小工具、做簡單 Web app。
    • 沒時間細看文件,只想「先有東西能跑」。

    實際操作:

    • 舉例:想做「每日匯率提醒」小工具。
    • 在 Replit 建一個 Python 專案。
    • 告訴 Luna:「抓某銀行匯率 API,每天寄一封 Email 給我。」
    • 要求:
      • 「幫我寫主程式 + 環境變數設定範例。」
      • 「提醒我在哪裡要改成自己的 Email 帳號。」

    2. MVP 試作:先證明可行再談設計

    典型需求:

    • 只需 demo,先有功能再說 UX、架構。

    實際操作:

    • 舉例:做一個「內部表單 → 自動丟到 Notion」服務。
    • 新建 Node.js Repl。
    • 給 Luna 簡短規格:
      • 「做一個簡單網頁表單,送出後呼叫 Notion API 建新頁面。」
    • 要求:
      • 「幫我切前端檔案與後端 server.js。」
      • 「用注解標出我需要填 Notion token 的位置。」

    3. 小團隊 internal tool:自動化繁瑣工作

    典型需求:

    • 把重複操作寫成腳本;例如:整理 log、轉檔、批次產出報表。

    實際操作:

    • 舉例:DevOps 想做 log 分析腳本:
    • 把範例 log 檔上傳到 Replit。
    • 對 Luna 說:「讀這個 log,幫我做一個能統計錯誤率與平均響應時間的工具。」
    • 要求:
      • 「最後輸出成 CSV 檔。」
      • 「寫一個 CLI 介面,可指定檔案路徑。」

    💡 關鍵: 這類 internal tool 用 Luna 代工,可以大幅減少重複人工操作時間,讓團隊專注在核心開發工作。


    4. 教學與練習:邊寫邊問,像有一位助教

    典型需求:

    • 老師:出作業給學生,示範可跑程式。
    • 學生:練習時想知道「這樣寫有沒有更好?」

    實際操作:

    • 舉例:教 if/else 與函式:
    • 要 Luna 生成一個「成績換等級」程式,要求加註解。
    • 再問:「把這份程式改寫成使用字典 mapping 的版本,並解釋差異。」

    實作示範:一步步用 Free Mode 做一個小工具

    以「簡易網址標題抓取工具」為例,一步走完 Free Mode 流程。


    步驟 1:註冊與開啟 Free Mode

    1. 到 https://replit.com 註冊帳號(可用 Google / GitHub 登入)。
    2. 登入後,右上角點 Create Repl。
    3. 選擇語言(例如 Python)。
    4. 確認右側有 AI 助手面板(通常標示為 Luna / AI),這就是 Free Mode 入口。

    Free Mode 的重點:在 Replit 裡用 Luna 時,不需自己準備 OpenAI API key,也不用管 token 計費。


    步驟 2:設定語言與專案結構

    1. 在 Create Repl 選單中:
    2. Language:選 Python。
    3. Template:預設即可。
    4. 建立後,左側檔案區會看到 main.py。你可以先留空,交給 Luna 一次產生。
    5. 在 AI 面板輸入:

    「我要一個命令列工具,輸入網址後抓出頁面 <title> 文字並印出。請給我:
    1. 完整 main.py。
    2. 如果需要套件,幫我建立 requirements.txt。」

    Luna 會:

    • 產出 Python 程式,可能使用 requests + beautifulsoup4。
    • 建立 requirements.txt,列表需要安裝的套件。

    步驟 3:和 AI 一起 debug、改版

    1. 按 Run,如果出現錯誤(例如套件未安裝),把錯誤訊息全選貼給 Luna:

    「這段錯誤是什麼意思?幫我改到可以在 Replit 上直接跑。」

    1. 要求它:
    2. 加上 pip 安裝步驟,或在 Replit 的 Packages 面板幫你選。
    3. 修改程式讓錯誤處理更友善,例如網址無效時印出提示。
    4. 當程式可以穩定跑後,再請 Luna:

    「幫我把這份程式加上繁體中文註解,並簡短說明程式流程。」

    到這一步,你就完成了:

    • 一個可執行的小工具。
    • 有註解、適合自己與同事二次維護。

    和本地 LLM / 其他雲端 IDE 怎麼搭配?

    Replit Free Mode 很適合「雲端原型」,但你可能還會用本地 LLM 或其他 IDE。下面是常見組合:

    名稱 核心功能 免費方案 適合誰
    Replit + GPT-5.6 Luna 雲端一站式寫程式、跑程式、協作;免自己管 API Free Mode 可直接用 Luna,限制較寬鬆 想快速做 side project、MVP、小工具的人
    本地 LLM(如 Ollama + 開源模型) 不連網也能跑模型,在 VS Code / 終端中輔助寫程式 多數模型可免費下載使用,主成本是硬體 重視隱私、在公司內網或沒網路時開發
    雲端 AI IDE(如 Cursor、Claude Code) 深度整合編輯器、多檔案重構、強代碼理解 有免費額度,但通常有使用上限 長期大型專案開發者,希望整合 Git、測試流程

    搭配建議:

    • 原型在 Replit,長期在本機或其他 IDE:
    • 先用 Replit + Luna 做出可跑原型。
    • 成熟後,再把程式碼拉到 Git,接到自己慣用 IDE(VS Code、Cursor 等)。
    • 雲端 + 本地雙軌:
    • 雲端(Replit)負責 demo、分享給 team。
    • 本地 LLM 負責敏感程式碼(公司內部系統、機密邏輯)。

    💡 關鍵: 把 Replit Free Mode 當成「雲端原型場」,再搭配本地或其他雲端 IDE,是目前最靈活、成本最低的開發配置之一。


    小結:你現在可以做的三件事

    1. 開 Replit 帳號,啟用一個 Python / Node.js Repl,打開 Luna 面板。
    2. 用一句話描述你想做的小工具,要求 Luna「給完整專案結構 + 可跑程式」。
    3. 一邊跑程式,一邊把錯誤訊息、重構需求丟給 Luna,當成免費的雲端「結對程式夥伴」。

    善用 Free Mode,你可以在沒有 API 預算的情況下,實際感受 GPT-5.6 Luna 在程式開發上的威力,並把 idea 變成真正能跑的軟體。

    🚀 你現在可以做的事

    • 去 Replit 註冊帳號並建立第一個 Repl,確認右側 Luna 面板可用
    • 按照文中的「網址標題抓取工具」示例,請 Luna 生出完整專案並親手按一次 Run
    • 把你現有的一段「醜但能動」的程式貼給 Luna,要求重構與加註解,體驗它當助教與結對夥伴的效果
  • GPT‑5.6 Sol 實測:把圖片變成可對話資料庫

    GPT‑5.6 Sol 實測:把圖片變成可對話資料庫

    📌 本文重點

    • GPT‑5.6 Sol:強大的免費視覺理解模型
    • 可將任何圖片轉成結構化資料與可行動內容
    • 適合 PM、工程師、知識工作者與學生日常使用

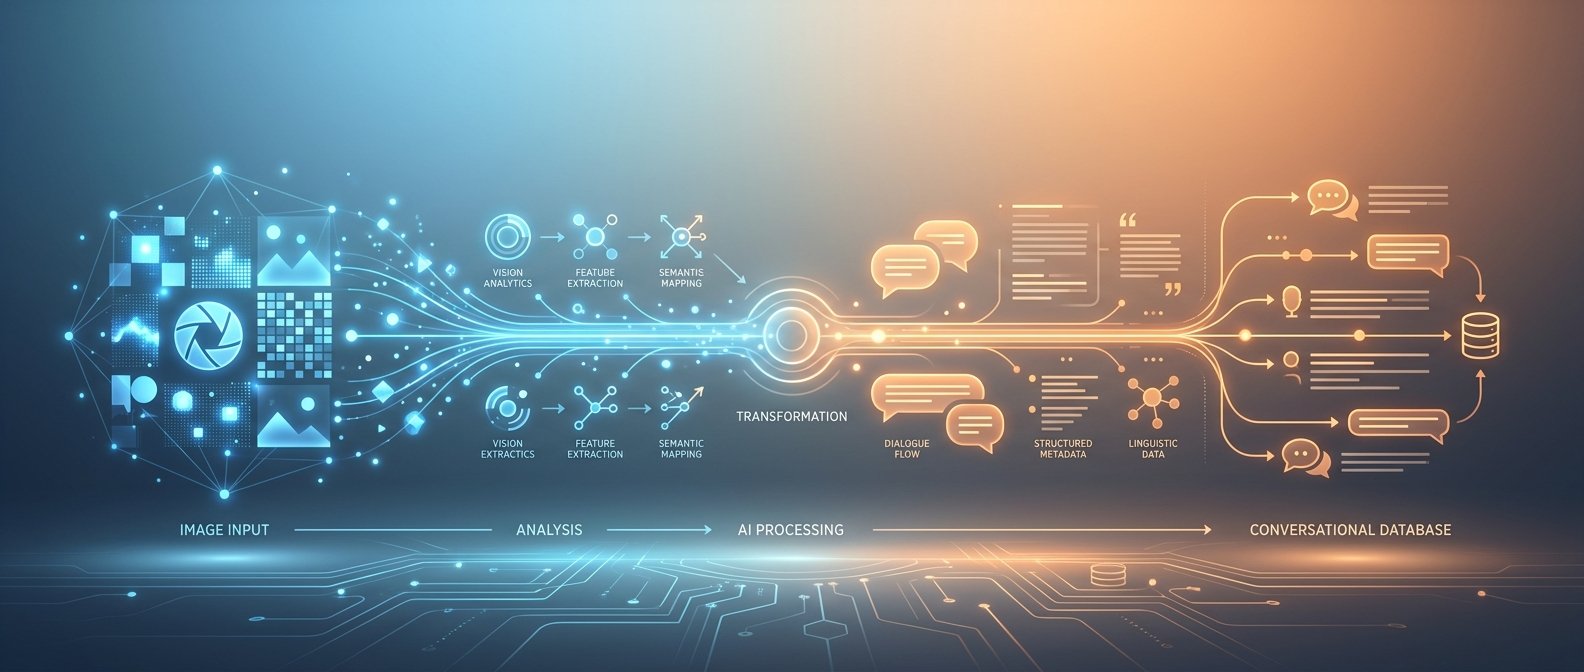
    一句話先講清楚:GPT‑5.6 Sol 就是一個「把任何圖片,變成可對話的結構化資訊引擎」的免費視覺模型。你丟 UI 畫面、流程圖、簡報、課本照片,它都能幫你拆成條列、表格、JSON 結構,接著和你一起推理、規劃、改寫。

    延伸閱讀:GPT 5.6 Sol is the best “vision” model OpenAI ever released(Roboflow)


    核心功能:四類圖片,一套思路

    下面這四個能力,是你日常工作幾乎每天都用得到的:

    1. 介面&報表理解:把畫面拆成欄位、操作流程

    Sol 的強項是看畫面就能理解「這是什麼系統、有哪些輸入輸出、使用者會怎麼操作」。

    能做到的事:

    • 螢幕截圖、Figma 畫面 → 條列介面元素、欄位意義
    • 數據儀表板/報表截圖 → 整理成表格+關鍵指標解讀
    • 網頁畫面 → 推測使用者流程、可能的 CTA 與漏斗

    你可以這樣用:

    上傳一張系統畫面,搭配文字:

    這是我們內部訂單管理系統的截圖,請:
    1. 條列畫面上所有欄位與按鈕,說明用途
    2. 推測完整使用者操作流程(從進入頁面到完成訂單)
    3. 匯出成 JSON 結構:{step, action, input_fields, output}


    2. 流程圖與架構圖分析:幫你「用嘴」改系統

    Sol 看懂箭頭、方框、節點彼此關係,適合拿來快速討論系統設計。

    可以做到:

    • 系統架構圖 → 抽出服務清單、依賴關係、可能瓶頸
    • 資料流圖 → 指出安全風險、延遲來源、可快取點
    • 業務流程圖 → 找出人工步驟、可自動化環節

    實際操作:

    貼一張系統拓樸圖,詢問:

    這是目前的系統架構,請:
    1. 用文字重述整體資料流
    2. 找出三個可能的單點失敗風險
    3. 提出兩種改版方案,分別優先提升可靠性/擴充性


    3. 文件掃描:簡報、PDF、紙本變成行動清單

    Sol 讀圖片型文字的能力很好,尤其是:

    • 簡報截圖、講義照片 → 整理成條列、摘要、行動項目
    • 掃描 PDF → 自動找章節重點、重要數字與定義
    • 白板/手寫筆記 → 轉成段落+待辦事項

    範例用法:

    上傳一張簡報頁面,請它:

    把這頁簡報內容:
    1. 濃縮成 5 點摘要
    2. 整理出「接下來一週可以執行的具體行動清單」,用 checklist 格式
    3. 輸出成 Markdown,方便貼到 Notion


    4. 實物/場景理解:從畫面推需求與規格

    除了文件,Sol 也能看懂實體世界的畫面:

    • 實物照片 → 辨識零件、用途、可能問題(例如損壞、錯配)
    • 環境/場景 → 推測流程、設備配置、安全風險
    • 教學器材、課本圖例 → 整理成教學步驟、題庫

    應用範例:

    拍一張教學實驗設備照片:

    根據這張實驗設備照片:
    1. 推測實驗主題與步驟
    2. 列出需要注意的安全事項
    3. 幫我設計 3 題考題(選擇題),附標準答案


    💡 關鍵: GPT‑5.6 Sol 能把原本只能「看」的圖片,轉成可搜尋、可編輯、可推理的結構化資料,是連結視覺與文字工作流程的核心工具。


    適合誰用?四種角色的實際場景

    1. 產品/PM:丟 Figma,請它寫 PRD 和 edge cases

    場景:你只有原型圖,卻要明天開需求評估會議。

    操作步驟:

    1. 在 Figma 內選擇幾個核心畫面,輸出 PNG。
    2. 在 ChatGPT 對話視窗上傳圖片(確保模型選擇 Sol 或系統自動使用最新視覺模型)。
    3. 用這種 prompt:
      “`
      這是新功能的 Figma 畫面,請:
    4. 條列出這個功能的目標與主要使用情境
    5. 以 PRD 形式整理:user story、主要流程、欄位規格
    6. 列出至少 10 個 edge cases 與錯誤訊息設計建議
    7. 用表格輸出,方便我貼到 Confluence
      “`

    你可以迭代:再丟一張畫面,請它「更新前面 PRD 中的流程圖與欄位表」,做到真正的圖片驅動需求寫作。


    2. 工程師:錯誤畫面+拓樸圖,請它推理問題和改動建議

    場景:線上系統偶發錯誤,你截了錯誤頁面和架構圖,想快速釐清可能原因。

    操作步驟:

    1. 上傳錯誤畫面(包含錯誤訊息、URL、時間等)。
    2. 再上傳相關系統拓樸圖或 sequence diagram。
    3. 用這個 prompt 合併分析:
      “`
      這兩張圖分別是:
    4. 錯誤畫面(前端顯示)
    5. 系統架構圖(後端服務與資料流)
      請:
    6. 推測可能的錯誤來源(依機率排序)
    7. 列出需要檢查的 log 與監控指標
    8. 提出一個最小改動的修正方案,並說明影響範圍
      “`

    這種用法適合拿來當排錯思路清單,幫你檢查是否漏掉某些角度(網路、資料庫、第三方服務等)。


    3. 資訊工作者:簡報截圖/掃描 PDF → 重點整理+行動清單

    場景:開完會只有投影片照片;或拿到是掃描版 PDF,沒有文字層。

    操作步驟:

    1. 把照片或 PDF 截圖分批上傳 Sol。
    2. 先叫它「逐頁摘要」,再叫它「整併成完整會議紀錄+行動項目」。
    3. 範例 prompt:
      “`
      這是本次專案會議的簡報截圖,請:
    4. 每張圖先各自寫 3-5 點摘要
    5. 統整成一份會議重點(含背景、決策、未決議題)
    6. 列出所有具體待辦事項,格式:{owner, task, deadline_suggestion}
      “`

    這比純文字總結更精準,因為 Sol 能看到圖表、流程箭頭、註解框這些細節。


    4. 個人學習:課本照片/板書 → 筆記+題庫

    場景:上課拍板書、拍課本,想回家變成系統化筆記。

    操作步驟:

    1. 把同一章節的幾張照片一次上傳。
    2. 請它先整理成「樹狀大綱」,再生成題目。範例:
      “`
      這些照片是同一章節的內容,請:
    3. 整理成分層的大綱(章節 → 小節 → 關鍵概念)
    4. 用自己的話重寫成教學筆記,讓高中生看得懂
    5. 根據內容出 5 題選擇題、5 題簡答題,附標準答案
      “`

    久了你會發現:Sol 可以直接變成你的圖片型知識轉文字型筆記的流水線。


    💡 關鍵: 不論你是 PM、工程師或學生,只要日常有「截圖」或「拍照記錄」,Sol 就能幫你把這些零散視覺資訊變成系統化產出。


    怎麼開始:免費用 Sol +簡單 API 範例

    1. 在 ChatGPT 免費/低階方案使用 Sol

    目前 Sol 已整合在 OpenAI 的 ChatGPT 中,免費或低階方案也能用,重點是:

    💡 關鍵: 即使是免費或低階方案,也能直接使用 Sol 視覺模型,降低導入門檻。

    1. 入口位置:
    2. 登入 chatgpt.com 或官方 App。
    3. 新建對話,確保模型選擇為最新可視覺模型(通常會標示 GPT‑5.6 或支援「圖片上傳」)。

    4. 上傳圖片方式:

    5. 在輸入框旁邊使用「上傳檔案/圖片」按鈕,上傳截圖、照片、掃描件。
    6. 同一則訊息可上傳多張,適合完整章節或多頁簡報。

    7. 提問範例 prompt 模板:
      “`
      這張圖(或這幾張圖)是:[簡短描述,例如:產品原型圖/系統拓樸/簡報/課本內容]。
      請依照以下步驟幫我處理:

    8. 先用自己的話描述這張圖在講什麼
    9. 把重要元素整理成結構化資料(條列或表格)
    10. 依我的角色(產品/工程師/學生),提出 3-5 個你建議我接下來可以做的具體行動
      “`

    你可以把這段當作通用模板,之後再加上更細的輸出格式要求(例如「用 JSON 回答」)。


    2. 給開發者:最小可行 API 範例(圖像+文字 → JSON)

    以下是使用 OpenAI API(Node.js 範例)調用 GPT‑5.6 Sol,把圖片與指令變成 JSON 結構輸出的最小例子:

    注意:實際模型名稱與 endpoint 可能依 OpenAI 更新調整,請以官方文件為準。

    npm install openai
    
    import OpenAI from "openai";
    import fs from "fs";
    
    const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });
    
    async function analyzeImageToJSON() {
      const imageBytes = fs.readFileSync("./input.png");
      const base64Image = imageBytes.toString("base64");
    
      const response = await client.chat.completions.create({
        model: "gpt-5.6-sol", // 依官方最新名稱調整
        messages: [
          {
            role: "user",
            content: [
              {
                type: "text",
                text: "請分析這張圖,輸出介面元素與可能的使用流程,格式為 JSON:{elements:[], flows:[]}"
              },
              {
                type: "image_url",
                image_url: {
                  url: `data:image/png;base64,${base64Image}`
                }
              }
            ]
          }
        ],
        response_format: { type: "json_object" }
      });
    
      console.log(response.choices[0].message.content);
    }
    
    analyzeImageToJSON().catch(console.error);
    

    這段程式碼做的事很單純:

    • 把本機圖片轉成 base64
    • 丟給 GPT‑5.6 Sol 模型,搭配文字指令
    • 要求模型直接回傳 JSON 結構(方便你接在後續系統)

    3. 隱私與公司內部畫面注意事項

    視覺模型很容易讓人「隨手截圖就丟」,但有幾點要特別提醒:

    • 避免敏感資訊:
    • 公司內部系統截圖若含客戶資料、金額、地址、帳號,先打碼或模糊關鍵區域。
    • 法規敏感資料(醫療、金融)請遵守公司政策,不要直接上傳雲端模型。

    • 確認使用條款:

    • 不同方案對「是否用你的資料做模型訓練」的政策不同,請在帳號設定與隱私條款中確認。

    • 內網場景處理:

    • 若需要分析高度敏感架構圖,可考慮在公司內部部署方案(例如自架模型),不要直接使用公網 API。

    總結:把 Sol 想成一個「圖片轉結構化資料」的助理——你給它任何圖,它就幫你拆成可編輯、可推理、可執行的資訊。從 PM、工程師,到知識工作者和學生,只要日常有截圖或照片,就值得試著把這些「視覺碎片」,交給 GPT‑5.6 Sol 變成你工作流程的一部分。

    🚀 你現在可以做的事

    • 登入 chatgpt.com,上傳一張你常用系統或簡報截圖,照文中的通用模板試一次
    • 將文中的 Node.js 範例貼到本機專案,改成你自己的圖片與 prompt,測試 JSON 輸出
    • 選一個工作或學習場景(PM、工程師、會議紀錄或課本),設計一個固定的 Sol 使用流程並連續使用一週
  • HashAgent:一鍵分享、在地跑的 AI 代理

    HashAgent:一鍵分享、在地跑的 AI 代理

    📌 本文重點

    • HashAgent 用一條 URL 分享可用狀態代理
    • 所有設定編碼進網址,在瀏覽器本地跑模型
    • 適合團隊共享工具、PoC demo、隱私文本處理
    • 開發者可當無後端前端容器做快速試驗

    用一句話說清楚:HashAgent 是一個「用 URL 分享、在瀏覽器本地跑」的 AI 代理容器,讓你不用架伺服器,就能把一個預先設定好的 AI 小工具分享給同事或客戶。

    工具網址:https://hashagent.pages.dev/


    核心功能:把「會動的代理」裝進一條網址

    1. 用一條 URL 分享一個預先配置好的代理

    HashAgent 的設計很直覺:所有代理設定都被編碼進 URL,像是:

    • 使用哪個模型
    • 預設系統 prompt
    • 任務腳本(例如:「請幫我總結貼上的文件」)

    你只要:

    1. 打開 HashAgent:https://hashagent.pages.dev/
    2. 在設定區填好:
    3. 模型名稱
    4. 系統提示(System prompt)
    5. 任務描述或腳本
    6. 點擊產生/複製 URL,丟給同事

    對方打開連結就直接進入一個「可用狀態」的代理,不用再解釋怎麼切模型、怎麼寫指令。

    💡 關鍵: HashAgent 把完整代理配置嵌入網址,任何人點開就能直接用同一套設定。

    👉 可立即行動:

    • 想像你現在有一個固定的「會議紀錄總結」工作,把提示寫好,生成 URL,貼到團隊 Slack,讓大家以後都用這一個入口。

    2. 在瀏覽器端用 WebGPU 本地推論

    HashAgent 依賴瀏覽器 WebGPU 能力,在使用者的電腦上直接跑模型,好處很明確:

    • 文字內容不會送到外部伺服器
    • 沒有額外 API 費用
    • 測試 PoC 不用再申請雲端資源

    要讓它順利運作,你可以這樣檢查與調整:

    1. 使用支援 WebGPU 的瀏覽器:
    2. 建議:Chrome / Edge / Brave(版本越新越好)
    3. 在 chrome://flags 搜尋「WebGPU」,確認是啟用狀態(若已預設開啟可忽略)。
    4. 打開 HashAgent 頁面時,留意是否有「WebGPU not supported」類似提示,有的話換一個瀏覽器或機器測試。

    💡 關鍵: 使用者的瀏覽器與硬體決定推論是否能在本地完成,這是 HashAgent 的隱私與免伺服器優勢來源。

    👉 可立即行動:

    • 用自己的筆電和桌機各打開同一條 HashAgent URL,感受不同 GPU/CPU 下的速度差異。

    3. 支援自訂 Prompt 與任務腳本

    HashAgent 不是只有一個對話框,而是可以預設「代理該怎麼工作」:

    典型可設定內容包括(實際欄位以官方頁面為準):

    • System prompt:定義代理角色,例如:「你是一個專門做長文摘要的助手,只輸出三段摘要與三個行動建議。」
    • 任務腳本:針對一個固定流程,例如:
    • 接收使用者貼上的原文
    • 先輸出 3 句話摘要
    • 再輸出一個行動清單

    你可以把這些寫死在設定裡,然後一鍵分享:

    • 同事只要打開網址、貼文本,就能得到同樣格式的輸出
    • 測試不同版本的提示時,只要多產幾條 URL 對比

    👉 可立即行動:

    • 做兩條代理 URL:
    • A 版:摘要偏「精簡」
    • B 版:摘要偏「詳細」
    • 實際讓同事在會議前後各用一次,收集哪一版更好用。

    適合誰用:三類典型場景

    1. 團隊共享小工具:一鍵文檔總結代理

    情境:公司裡大家都在用 ChatGPT / Claude 檢查文件,但每個人 prompt 都不一樣,輸出品質參差不齊。

    用 HashAgent 可以:

    • 把「標準版」文檔總結流程寫成 system prompt
    • 固定輸出格式(例如:摘要、風險點、下一步行動)
    • 用一條 URL 分享到團隊 wiki / Notion

    效果:

    • 新人只要打開網址+貼文件,就能用同一套「公司標準」摘要模板。

    2. 內部 PoC:不用伺服器就能 demo 的代理

    情境:你是內部 AI 團隊,要給老闆看一個新的代理 workflow 構想,但還不想花時間架後端。

    做法:

    • 在 HashAgent 裡設定好流程 prompt
    • 選一個本地可跑的模型
    • 把生成的 URL 直接在會議現場打開 demo

    效果:

    • 不用申請雲帳號、API Key
    • Demo 環境就是瀏覽器,任何人都可以當場打開運行

    3. 個人隱私場景:本地處理敏感文本

    情境:

    • 合約書、履歷、公司內部簡報,不想丟出去雲端
    • 但又想用 LLM 做摘要、改寫、潤飾

    HashAgent 的本地推論特性很適合:

    • 打開自己的「合約總結代理」
    • 把 PDF 文本複製貼上
    • 整個過程只在自己機器上運算

    👉 可立即行動:

    • 做一條專門處理「履歷優化」的 HashAgent URL,只在求職階段自己用,且資料不離開裝置。

    實作教學:幾分鐘建立一個簡單 HashAgent

    以下用「一鍵文檔總結代理」當示範,步驟會以官方頁面目前常見結構為例(未來若 UI 調整,以頁面為準)。

    步驟一:打開 HashAgent 並選模型

    1. 進入:https://hashagent.pages.dev/
    2. 找到模型選擇欄(例如「Model」或類似欄位)。
    3. 選擇一個支援 WebGPU 的本地模型(通常會有預設選項)。

    如果頁面提供多個模型:

    • 選較小的模型:載入快、推論快
    • 選較大的模型:推論慢,但輸出品質可能更好

    步驟二:寫任務描述(System Prompt)

    在「System Prompt」或「Agent Prompt」欄位填入類似內容:

    你是一個專門為知識工作者服務的文檔摘要助手。
    使用繁體中文回答。請依照以下格式輸出:
    1. 三句話總結本文重點。
    2. 列出 3-5 個可行的下一步行動建議。
    3. 若本文有任何風險點或注意事項,請額外列出。

    這樣一來,任何人打開這條 URL,再貼入文本,都會得到相同格式的輸出。


    步驟三:生成分享 URL

    在 HashAgent 頁面通常會有某種「Share」或「Copy URL」按鈕,底層邏輯是:

    • 把你的設定序列化寫入 URL hash 或 query string
    • 例如:https://hashagent.pages.dev/#... 或 ?config=...

    操作方式:

    1. 點擊「Generate / Copy URL」
    2. 取得一條很長的連結
    3. 貼到:
    4. Slack / Teams 群組
    5. 公司內部 wiki
    6. 產品 demo 文檔

    👉 可立即行動:

    • 做好第一條代理後,請兩位同事用它來總結同一份文件,觀察輸出是否一致,微調 prompt。

    如何在不同瀏覽器 / 機器上測試效能

    HashAgent 的效能很依賴硬體與瀏覽器,以下是一個簡單測試流程:

    1. 準備一條相同的 HashAgent URL
    2. 在以下環境各測一次:
    3. Windows + Chrome
    4. macOS + Chrome / Safari(視 WebGPU 支援情況)
    5. Linux + Chromium 或支援 WebGPU 的瀏覽器
    6. 測量兩個指標:
    7. 模型載入時間(從進入頁面到可以輸出第一段文字)
    8. 單次完整回應時間(例如處理同一篇 1,000 字文章)

    若遇到太慢或無法運行,可以:

    • 換較小的模型
    • 確認瀏覽器版本已更新
    • 在設定裡調低生成長度或溫度(根據 UI 選項調整)

    💡 關鍵: 透過在不同環境測量載入與回應時間,你可以實際評估 HashAgent 是否符合團隊或產品 demo 的效能需求。


    與其他工具搭配:向量庫、Obsidian、VSCode

    HashAgent 目前偏「單體代理」,但你可以把它當作前端容器,搭配其他工具:

    • 搭配本地向量庫:
    • 在後端用你熟悉的工具(如 LlamaIndex、Local vector DB)先做檢索
    • 把檢索後的上下文貼到 HashAgent 中,由代理負責總結/解釋

    • 搭配 Obsidian:

    • 在 Obsidian 裡選一篇筆記,複製內容
    • 貼到 HashAgent 的「摘要代理」裡
    • 把輸出貼回新筆記,形成標準化摘要

    • 搭配 VSCode:

    • 將部分程式碼或 log 貼入 HashAgent 的「debug 代理」URL
    • 以預先設定好的 prompt 輔助 debug 或重構

    👉 可立即行動:

    • 建兩條代理 URL:一個專門負責「Obsidian 筆記摘要」、一個專門負責「程式碼解說」,分別收藏在瀏覽器書籤列。

    給開發者:把 HashAgent 當成前端容器

    如果你在做 LLM workflow、agent framework,HashAgent 可以扮演:

    • 「無後端 Demo 殼」:
    • 把整個 workflow 壓縮成一組 prompt + 設定
    • 用 HashAgent 的 URL 形式丟給使用者試用

    • 「早期用戶回饋管道」:

    • 你可以快速產出多個版本(不同 prompt、不同模型)
    • 用多條 URL 做 A/B 測試

    • 「內部教學模板」:

    • 把教學代理(例如:教如何寫公司標準文件)包成 URL
    • 給新員工在瀏覽器裡直接操作

    當你準備好要產品化時,再把這些代理邏輯搬到自己的前端 + 後端架構裡即可。


    小結:先從一個「可分享的摘要代理」開始

    如果你不知道從哪裡開始,建議順序:

    1. 打開 https://hashagent.pages.dev/
    2. 選一個預設模型
    3. 寫一個「公司標準的文檔摘要 prompt」
    4. 生成 URL,貼到團隊群組

    當你能用 HashAgent 成功分享第一個「會動」的代理給同事,你就掌握了這個工具的核心價值:用 URL 把 AI 工作流程裝起來,讓任何人打開就能用,且資料留在自己的裝置上。

    🚀 你現在可以做的事

    • 立刻打開 HashAgent,建立一條「公司標準文檔摘要」URL 並分享到團隊 Slack 或 Teams
    • 在兩台不同設備上用同一條代理 URL 測試 WebGPU 效能,確認是否適合正式使用
    • 為個人敏感資料(履歷或合約)設計一條專用 HashAgent 代理 URL,加入瀏覽器書籤以便重複使用
  • 用 Unsloth 把筆電變成小型 AI 伺服器

    用 Unsloth 把筆電變成小型 AI 伺服器

    📌 本文重點

    • Unsloth Desktop 把筆電變成本地多模態 AI 伺服器
    • 支援多 GPU / CPU,並提供 OpenAI 兼容 API
    • 適合本地聊天助理、RAG、Agent 與多模態 Side Project
    • 幾乎不改程式即可把既有 OpenAI workflow 搬到本機

    用一句話定位:Unsloth Desktop 就是把你的筆電變成「小型 AI 伺服器 + 實驗室」的開源桌面工具,讓聊天、程式助理、RAG、影像與語音模型都能在本機跑起來。

    工具來源:
    – Reddit 介紹文:https://www.reddit.com/r/LocalLLaMA/comments/1vlj87v/introducing_unsloth_desktop_app/
    – Product Hunt:https://www.producthunt.com/products/unsloth


    核心功能:把「本地模型」變成可用的服務

    下面三個功能,是你真的會用到、立刻能起手的重點。

    1. 支援多種模型格式:MLX / diffusion / 語音 / GGUF

    Unsloth Desktop 的定位不是「只跑 LLM」,而是一個多模態模型的統一入口:

    • 語言模型:支援 GGUF(llama.cpp 系列)、MLX(Apple Silicon 上的高效框架)
    • 影像 / 視覺:支援 diffusion 影像 / 影片模型
    • 語音:支援音訊模型(語音辨識、TTS 等)

    你可以這樣開始行動:

    1. 安裝好 Unsloth 後,打開模型面板
    2. 選擇一個預設 GGUF LLM(例如 MiniMax-H3、Muse Glimmer)
    3. 選一個簡單的 diffusion 模型(如 Stable Diffusion 系列)
    4. 在同一個介面裡,分別測試文字聊天和影像生成

    這種「同一套操作邏輯管理多模態模型」的好處,是你不用在不同 CLI 工具之間切來切去,對 AI 新手非常友善。


    2. 多 GPU & CPU 加速,本地推理真的跑得動

    很多人「幻想」在筆電上跑模型,卡在效能與顯示記憶體。Unsloth Desktop 的重點是盡量把你手上的硬體吃乾抹淨:

    • 支援多種 GPU:NVIDIA、AMD、Intel、Mac(含 Apple Silicon)
    • 支援 CPU 推理:沒有獨顯也可以跑,只是速度會慢一些
    • 對訓練 / 微調:標榜約 2 倍訓練速度、70% VRAM 節省(來源:官方 Reddit 介紹)

    💡 關鍵: 大約 2 倍訓練速度與 70% VRAM 節省,代表同樣硬體上能跑更大模型或更多實驗。

    你可以立刻做的事:

    1. 在設定頁面確認硬體偵測到的 GPU / CPU
    2. 選一個中型模型(例如 7B gguf),先跑一次聊天測試
    3. 觀察系統資源使用(macOS 的活動監視器、Windows 的工作管理員),確認真的有用到 GPU

    如果你是 Mac 使用者,可以搭配像這篇關於 Apple Silicon + llama.cpp 的效能優化思路:https://github.com/trycua/cua/blob/main/blog/gpu-passthrough-macos-vms.md,來理解「為什麼在 M 系列晶片上跑本地 LLM 是可行的」。


    3. OpenAI 兼容 API + 自我修復工具呼叫

    Unsloth Desktop 最關鍵的功能,是把本地模型包成一個 OpenAI 兼容的 API:

    • 提供 OpenAI-compatible endpoint(Unsloth Native)
    • 可以同時串本地模型和雲端模型(例如 OpenAI、Anthropic 等),在同一個 API 層切換
    • 內建「自我修復」的工具呼叫與沙盒化代碼執行:模型在呼叫外部工具或執行程式碼出錯時,可以自動重試 / 修正,同時把程式碼限制在安全環境裡

    💡 關鍵: OpenAI 兼容 API 讓你幾乎不改程式碼,就能把原本的雲端 workflow 直接換成本地模型。

    這讓你可以做幾件事:

    1. 把本地 LLM 當成 ChatGPT-compatible 的後端,接在現成客戶端(如 Chatbox、Continue、Open WebUI 等)
    2. 在 VS Code 旁邊跑自己的模型,搭配 Claude Code / Codex 類工具一起用
    3. 建立簡單 Agent:模型收到任務 → 呼叫系統工具或小腳本 → 在沙盒裡執行 → 回傳結果

    適合誰用:三種典型場景

    1. 本地聊天與程式助理:在 VS Code 旁跑自己的模型

    如果你平常習慣用 Claude Code、Cursor 或 GitHub Copilot,想要多一個「完全不出機房」的備用助理,可以這樣玩:

    • 把 Unsloth Desktop 裝在開發機上,啟動一個 GGUF LLM
    • 用 VS Code 外掛或本地聊天客戶端,改成連至 Unsloth 的 OpenAI 兼容 API
    • 寫程式時,用雲端模型做主力、遇到敏感專案(公司內網、客戶程式碼)就切到本地模型

    具體行動建議:

    1. 選一套 ChatGPT-compatible 客戶端(例如 Continue 或 Chatbox)
    2. 在其設定裡,把 api_base 改成 Unsloth 提供的 endpoint(例如 http://localhost:port/v1)
    3. 選定模型名稱,例如 local-llm-7b,直接開始對話與程式補全

    2. 私有資料實驗與原型:本機 RAG / Agent,不經雲端

    很多團隊不敢把內部文件丟上雲端 RAG,Unsloth 提供了一條完全本地的實驗路線:

    • 把公司或個人 PDF / Markdown / internal wiki 先處理成向量資料庫(自行寫腳本或用現成 RAG 套件)
    • 模型端用 Unsloth 提供的本地 LLM API
    • 在本機 web app 或小工具裡,做檢索 + 回答組合

    可以這樣起手:

    1. 在你的後端(Node.js / Python)中,接 Unsloth 的 API 當成 chat/completions 或 responses 來源
    2. 用如 n8n / LangChain / LlamaIndex 這類工具,把「取文件片段 → 呼叫本地 LLM」串起來
    3. 先做一個只服務自己筆電的小型內部 FAQ Bot,再考慮用 Cloudflare Tunnels 把 Unsloth API 安全地開到公司內網(Unsloth 原文有提到 Cloudflare 保護連線)

    3. 多模態 Side Project:影像生成、語音模型、簡單 Agent 工作流

    如果你平常喜歡做 Side Project,Unsloth 可以當成你所有 AI 功能的統一後端:

    • 用 diffusion 模型接一個「本地 Stable Diffusion 影像生成頁面」
    • 用語音模型做「錄音 → 轉文字 → LLM 摘要 → TTS 回覆」的工作流
    • 用 Agent 功能做一個「會自己跑 bash / Python 腳本」的小助手,幫你整理檔案或抓網頁資料

    具體行動:

    1. 在 Unsloth Desktop 裡啟動影像 + 語言 + 語音模型
    2. 在本地 web app(React / Vue / Svelte 任意)裡,統一呼叫同一個 API endpoint
    3. 利用工具呼叫與沙盒功能,設計幾個具體指令,例如「幫我整理 Downloads 資料夾」或「抓這個網站最新 10 篇文章做摘要」

    怎麼開始:從安裝到接上現有 workflow

    1. 安裝:Mac / Windows / Linux 都有

    Unsloth Desktop 是開源工具,支援三大桌面平台:

    • Mac:適合 Apple Silicon,用 MLX 模型可以發揮硬體優勢
    • Windows:多數開發者主力,適合接 NVIDIA / AMD GPU
    • Linux:伺服器與進階用戶首選

    行動步驟:

    1. 前往官網或 GitHub 下載最新版(可從 Product Hunt 連過去:https://www.producthunt.com/products/unsloth)
    2. 安裝並啟動,確認介面可以看到模型列表
    3. 在設定裡檢查硬體偵測與 API 設定(本地端口、是否啟用 OpenAI 兼容模式)

    2. 跑起第一個 GGUF / MLX 模型

    上手建議流程:

    1. 在介面中選擇一個輕量模型(例如 3B–7B GGUF),避免一開始就把 VRAM 撐爆
    2. 點選「啟動 / RUN」讓模型載入;等待載入完成
    3. 使用內建聊天介面,輸入一段問題(例如「幫我寫一個 Python 把 CSV 轉成 JSON 的程式」)
    4. 確認回答品質與速度,調整溫度、max tokens 等基本參數

    若你是 Mac M 系列:

    • 優先選 MLX 模型,在偏好設定裡確認使用 Apple GPU
    • 對照前面的 Apple Silicon + llama.cpp 文章,思考是否要調整 batch size 等設定

    3. 啟用 OpenAI 兼容 API:用 curl 測試

    確認 API 真的跑起來,是往後串接 n8n / Zapier 的基礎。

    假設 Unsloth 在本機開一個 http://localhost:8000/v1 的 API,可以這樣測:

    curl http://localhost:8000/v1/chat/completions \
      -H "Content-Type: application/json" \
      -H "Authorization: Bearer YOUR_LOCAL_KEY" \
      -d '{
        "model": "local-llm-7b",
        "messages": [
          {"role": "user", "content": "幫我用 Python 寫一個排序函式"}
        ]
      }'
    

    你應該會拿到一個結構與 OpenAI 非常接近的 JSON 回應。確認:

    • model 名稱是否正確
    • 是否需要 API key(有些版本可設定為無認證,只限本機)

    💡 關鍵: 成功用 curl 打通 http://localhost:8000/v1/chat/completions,就代表之後的任何 OpenAI 客戶端幾乎都能直接改 endpoint 來使用本地模型。


    4. 在 n8n / Zapier / 本地 web app 裡改掉 endpoint

    最後一步,把你原本的 workflow 直接「搬家」到自己筆電上的 Unsloth。

    以 n8n 為例:

    1. 找到原本呼叫 OpenAI 的 HTTP Request 節點
    2. 把 URL 從 https://api.openai.com/v1/chat/completions 改成 http://localhost:8000/v1/chat/completions
    3. 把 Authorization header 改成對應的本地 key(或移除認證視你設定而定)
    4. 保留原本的 messages 結構,只把 model 改成 Unsloth 內的本地模型名稱

    Zapier 類似做法:

    • 若使用 Webhooks by Zapier,改成打本地 URL
    • 若原本用的是 OpenAI 官方 integration,則改為自訂 webhook

    對於自己寫的 web app:

    • 在環境變數裡新增 OPENAI_BASE_URL=http://localhost:8000/v1
    • 程式碼中使用 OPENAI_BASE_URL 來組合 API URL,而不是寫死 api.openai.com

    這樣,你所有原本設計給 OpenAI / Claude 的 workflow,可以在幾乎不改程式的情況下,直接切到自己機器上的 Unsloth。本地 + 雲端混用時,只要切換 base URL 或 model 名稱,就能控制資料是否出機房。


    簡短比較:Unsloth 與常見本地 LLM 工具差異

    若你已經在用 Ollama、llama.cpp,也可以把 Unsloth 當成「更偏向多模態與訓練、又有桌面介面」的補充工具。

    名稱 核心功能 免費方案 適合誰
    Unsloth Desktop 多模態模型管理 + 本地訓練 + OpenAI 兼容 API 開源免費 想在筆電做本地 Agent、多模態實驗的開發者
    Ollama 本地 LLM 管理與推理(重文字) 開源免費 想快速跑文字模型、不需要訓練與多模態的人
    llama.cpp 低階 C++ 推理引擎(GGUF、效能優化) 開源免費 有工程背景、願意自己包 API 的技術使用者

    如果你想要一個「按裝置效能極限推到滿、又不必寫太多底層程式」的本地 AI 實驗室,Unsloth Desktop 是一個很實用的選擇:先讓它跑起一個本地 LLM,接上 OpenAI 兼容 API,然後把你現有的工作流一個一個搬過來,你就真正擁有了屬於自己的多模態 Agent 伺服器。

    🚀 你現在可以做的事

    • 前往 Product Hunt 或 GitHub 下載並安裝 Unsloth Desktop,啟動一個 7B gguf 或 MLX 模型
    • 用 curl 或你常用的 ChatGPT-compatible 客戶端,將 api_base 改成 http://localhost:8000/v1 測試本地 API
    • 挑一個現有用 OpenAI 的 workflow(如 n8n 流程或小型 web app),只改 endpoint 與 model 名稱,把它搬到本機 Unsloth 上跑
  • ChatGPT 免費版無限聊這樣用才划算

    ChatGPT 免費版無限聊這樣用才划算

    📌 本文重點

    • 免費版現在可「無限文字聊天」,能長期聊完一個專題
    • 新增 Think 推理按鈕,讓模型在重要問題上「多想一會」
    • GPT‑5.6 Luna 免費打底,Sol 適合高標準的長期專案
    • 把同一主題集中在長會話,搭配筆記工具形成個人知識庫

    一句話定位:現在的 ChatGPT 免費版,不再只是玩玩看,而是可以陪你長期寫稿、備考、寫小程式的「常駐 AI 助理」。

    官方說明參考(OpenAI Blog)、The Verge 報導、TechCrunch 報導。


    核心功能:免費版變成「可長期工作」的三個關鍵

    1. 無限文字聊天:真正可以把一個專題聊到完

    它是什麼?

    OpenAI 宣布:免費與 Go 用戶的「文字對話」不再有明確次數上限,可以長時間、多輪對話,過去常見的「你今天用量已達上限」在純文字情境下會大幅減少。

    💡 關鍵: 免費用戶的純文字聊天幾乎不再受次數限制,長期討論同一專題變得可行。

    但還是有幾個實際限制:

    • 只有純文字是無限:
    • ✅ 純文字提問、純文字回答:不限次數。
    • ❌ 上傳檔案(PDF、PPT、程式碼壓縮檔)、圖片、影片:仍有流量與頻率限制。
    • 模型記憶仍有限:
    • 同一個對話裡,模型能「記得」的內容有容量上限,太長時前面細節會被壓縮或遺忘。

    你可以怎麼用?

    • 把一個專題集中在一個長對話:
    • 求職:從履歷 → 自傳 → 模擬面試,全都在同一串對話裡進行。
    • 專題報告:先整理題目,再請它拆章節、逐段寫草稿、反覆潤稿。
    • 避免把同一主題打散在不同聊天室:讓模型前後文更完整。

    實作提示句範例:

    「我們接下來都在同一個對話裡工作,你幫我完成一份關於 XXX 的專題。先幫我釐清目標與大綱,之後我會一直在這串對話補充資料與修改。」


    2. 新的 Think / 推理按鈕:讓模型「多想一會」

    它是什麼?

    OpenAI 為免費與 Go 用戶新增了 「Think」按鈕(或界面上的「多想一下」「深度推理」之類字樣),

    • 平常提問 → 直接給答案(速度快,但推理較淺)。
    • 對複雜問題 → 按 Think,模型會用更長時間思考、進行多步推理,再輸出答案。

    The Verge 報導 與 The Decoder 都提到,這個按鈕本質上是「延長模型推理時間」。

    💡 關鍵: Think 按鈕不是換模型,而是讓同一模型在同一題目上花更多算力做多步推理,以提升正確性。

    什麼時候要按 Think?

    把它當成「需要正確性與邏輯性」時才按:

    • 需要多步驟推理:
    • 例如:「請幫我設計一週的讀書計畫,要考慮我每天能讀多久、各科目權重、歷屆考古題。」
    • 需要結構清楚的方案:
    • 專案拆解、流程設計、學習路線圖、商業邏輯分析。
    • 簡單聊天、查單一句翻譯,不需要按。

    實作方式:

    1. 先正常問問題,輸入時加上:

      「這個問題需要嚴謹推理,請使用 Think 功能,多想一會再回答。」

    2. 送出後,在介面上按下 Think(或系統提示你要不要讓它多想一會)。
    3. 收到答案後,繼續往下追問細節,而不是重新開新對話。

    3. Luna / Sol 分工:免費 vs 付費怎麼選?

    OpenAI 現在主要用兩個模型來分工:

    • GPT‑5.6 Luna:較小、較輕量,免費用戶的主力模型。
    • GPT‑5.6 Sol:較強版本,精度與一致性更好,主要給付費層級。

    根據 OpenAI 官方部落格 與多家媒體報導:

    • 免費用戶:
    • 預設使用 Luna,享有 無限文字聊天。
    • 一樣可以用 Think 按鈕,讓 Luna「想久一點」。
    • 付費(例如 ChatGPT Plus / Team):
    • 可選用 Sol,並可能有更多高階功能(更強推理、更好的程式能力)。

    可以把它想成:

    模型 核心功能 免費方案 適合誰
    GPT‑5.6 Luna 日常對話、寫作、翻譯、簡單程式碼,支援無限文字聊與 Think ✅ 免費可用,文字聊天不限次數 學生、一般上班族、剛開始用 AI 的人
    GPT‑5.6 Sol 更精準的回答、更穩定推理,適合複雜專案與開發 ❌ 多在付費方案 工程師、重度內容創作者、需要穩定品質的工作者

    💡 關鍵: 先用免費 Luna 完成 80% 工作,再依需求決定是否為剩下 20% 的高精度需求付費升級到 Sol。

    你可以怎麼做?

    • 先用免費 Luna 打底:
    • 把它當「草稿機」「想法整理工具」。
    • 有長期專案、程式需求再考慮升級:
    • 想要長期維護一個專案或文件庫,而且品質要求高,再切到 Sol / 付費層級。

    適合誰用:三大實戰場景

    1. 日常寫作與翻譯:長篇稿、履歷、Email

    適合誰:寫報告的學生、寫提案的 PM、需要中英互翻的上班族。

    具體可以怎麼用:

    1. 長篇稿件(文章、簡報講稿):
    2. 開一個對話命名:「公司內訓簡報稿」。
    3. 提示:
      > 「接下來這個對話只做一件事:幫我寫一份關於 XXX 的簡報稿。先幫我列大綱,用條列說明每頁要講什麼。」
    4. 之後所有修改、補充全在這個對話裡做。

    5. 履歷與 Cover Letter:

    6. 把原有履歷貼上,請它:
      • 重寫成不同版本(技術版/管理版)。
      • 翻成英文、調整語氣。
    7. 重要修改時按 Think,讓它更認真檢查結構與邏輯。

    8. Email 與翻譯:

    9. 日常回信直接貼中文:
      > 「幫我寫一封給客戶的英文 Email,語氣專業但不要太生硬,內容如下……」
    10. 要求:
      • 給兩個版本:較正式 / 較口語。

    2. 知識學習與考試準備:反覆問答不怕額度

    OpenAI 的使用數據(OpenAI Signals)顯示,很多人已經把 ChatGPT 當成「學習教練」。無限文字聊天剛好補上過去的痛點:

    實戰方式:

    1. 建立「科目專用」對話:
    2. 例如:「專門用來準備多益」「專門用來學 Python 基礎」。
    3. 第一句就說清楚:
      > 「從現在開始,這個對話專門用來準備 XXX 考試,你擔任家教,我是學生。先幫我診斷程度,再幫我排一個四週讀書計畫。」

    4. 長期 Q&A,不怕問太多:

    5. 每天把不懂的題目丟進同一對話:
      • 請它先解題,再用「高中生聽得懂」的方式重講一次。
    6. 遇到觀念題,按 Think 要求它:
      > 「請逐步解釋,每一步都說明為什麼。」

    7. 考前總整理:

    8. 在同一對話裡:
      • 要求它整理「這一週你教我的重點摘要」。
      • 請它出 10 題模擬題,照你的錯題再調整難度。

    3. 工程與資料工作:用 Think 處理複雜需求,專注在「小腳本」

    給工程師與資料工作者的實話:免費 Luna 寫得出程式,但穩定度與大型專案能力不如 Sol。最划算的用法是:

    • 把它當成「小腳本產生器」與「除錯助手」,不要期待它一次產出整個系統。

    可行用法:

    1. 小工具腳本:
    2. 例如:
      • 讀取 CSV、清洗欄位、輸出新的檔案。
      • 簡單網頁爬蟲(合法範圍內)。
    3. 提示:
      > 「請用 Python 寫一個腳本:讀取這個 CSV,移除缺失值,並把日期欄位轉成 YYYY-MM-DD,最後輸出成 new.csv。」
    4. 收到程式碼後自己在本機跑,遇到錯誤再貼錯誤訊息,請它協助除錯。

    5. SQL / 資料查詢:

    6. 把資料表結構貼給它,請它:
      • 幫你寫查詢語句。
      • 解釋每一段的意思。
    7. 複雜查詢時按 Think,讓它仔細拆邏輯。

    8. 演算法與概念講解:

    9. 不要直接叫它「幫我寫一個完整後端服務」,而是:
      • 請它解釋演算法原理。
      • 幫你寫單一函式或單元測試。

    怎麼開始:從帳號到日常工作流程

    1. 帳號與版本選擇

    1. 前往 chatgpt.com 或官方 App。
    2. 註冊 / 登入帳號。
    3. 保持在免費層級即可先用:
    4. 確認介面顯示的是 GPT‑5.6 Luna(通常預設)。
    5. 如果未來要升級,再考慮 Plus / Team 以使用 GPT‑5.6 Sol。

    2. 把同一主題集中在一個長會話裡

    操作習慣調整:

    • 每個重要主題開一個對話並命名:
    • 例如:「多益備考」「Q4 行銷提案」「資料分析腳本」。
    • 對話開頭先設定規則:
    • 你的角色(學生 / PM / 工程師)。
    • 它的角色(家教 / 編輯 / 程式教練)。
    • 工作目標與時間範圍。

    好處:

    • 模型能累積上下文,越聊越懂你的風格與需求。
    • 未來回顧時,有完整脈絡可查。

    3. 什麼時候要按 Think?

    可用這個簡單判斷:

    • ✅ 按 Think:
    • 需要邏輯正確、步驟清楚(讀書計畫、專案拆解、程式設計流程)。
    • 需要模型幫你「設計方案」、不是只給片段答案。
    • ❌ 不用按:
    • 單句翻譯、簡單重寫、日常聊天。

    你也可以在提示裡明講:

    「這題很重要,請用深度推理模式回答,如果不確定請標註不確定之處。」

    4. 和自己的知識庫 / Notion 串成工作流程

    免費版還是沒有「內建你的私有資料庫」,但可以用以下方式接起來:

    1. 在 Notion / Obsidian 中建立主題頁:
    2. 例如:「多益學習紀錄」「專案 X 知識庫」。
    3. 每次在 ChatGPT 中得到有用內容:
    4. 把最終版本貼回 Notion:
      • 大綱、重點整理、程式碼片段、讀書計畫等。
    5. 下次對話時:
    6. 先從 Notion 把相關內容複製一段給它,讓它「回想」上下文。
    7. 再繼續往下工作。

    你可以設定一個每日例行:

    • 早上:開啟「今天工作計畫」對話,請 ChatGPT 幫你排程。
    • 工作中:隨時在相應對話裡提問、寫稿、寫腳本。
    • 晚上:把重要成果整理回 Notion,形成自己真正擁有的知識庫。

    總結一句: 把 ChatGPT 免費版當成「長期可用、但偶爾需要你自己收尾」的助手——善用無限文字對話與 Think 按鈕,再配合自己的筆記工具,你可以在不付費的情況下,先把 80% 的日常工作和學習搬到 AI 上。

    🚀 你現在可以做的事

    • 立刻到 chatgpt.com 開一個新帳號,建立 2~3 個「專題專用」對話(例如:多益、履歷、資料分析)
    • 在其中一個對話裡貼上你正在寫的文章或報告,照文中示範提示請它重組大綱與草稿
    • 選一個主題在 Notion 建立頁面,今天就把一段 ChatGPT 對話結果整理貼回去,開始累積你的 AI 協作知識庫
  • 用 loopx+Cloudflare computer 組一支 AI 遠端團隊

    用 loopx+Cloudflare computer 組一支 AI 遠端團隊

    📌 本文重點

    • 用 loopx 管理長期、多 Agent 任務
    • 用 Cloudflare computer 給 Agent 一個可操作桌面
    • 示範「研究助理小隊」自動化 workflow
    • 提供可直接複製的安裝與最小範例程式碼

    讓多個 AI 工具像遠端同事一樣,長期幫你操作電腦工作,而不是每天重來一次,這就是 loopx 搭配 Cloudflare computer 想解決的問題。

    這篇會帶你:
    – 用 loopx 管長期任務與多 Agent 協作
    – 用 Cloudflare computer 給 Agent 一個真的「電腦桌面」可操作
    – 示範一個「研究助理小隊」workflow
    – 最後給你一套可直接複製的安裝+最小範例程式碼


    兩個工具在多 Agent 工作桌中的分工

    先用一張表快速對比:

    名稱 核心功能 免費方案 適合誰
    loopx 長任務 state kernel、目標管理、自動喚醒、多 Agent 交接 開源免費 要讓多個 Agent 長期合作、需要配額控管的人 / 團隊
    cloudflare/computer 給 Agent 一個可操作的桌面與瀏覽器環境 開源免費 想讓 Agent 實際「點、打、開網頁」做自動化的人

    一句話理解:
    – loopx = 專案經理+任務系統
    – Cloudflare computer = 共享遠端桌面

    💡 關鍵: loopx 管的是「長期任務與協作」,Cloudflare computer 管的是「實際電腦操作」,兩者分工清楚才有穩定、多 Agent 的自動化工作桌。


    loopx 核心功能:讓任務可以「長跑」而不是一次性對話

    1. State kernel:任務狀態集中管理

    loopx 自稱是「state kernel」,重點是:
    – 每個長期目標(project)都有自己的 持久狀態:目前做到哪、還有哪些 Todo、哪些已完成
    – 支援多 Agent:你可以把不同工具(例如寫程式 Agent、搜尋 Agent)接到同一個目標底下

    你可以採取的行動:
    – 為每個長期任務(例:產品研究、側專案)在 loopx 建立一個 goal
    – 把「任務進度」從 Notion / Google Sheet 移到 loopx 的 state 裡,讓 Agent 直接讀寫

    2. 長期目標管理+可執行待辦(Todos)

    loopx 允許你把大目標拆成細任務,並且讓 Agent 自己執行:
    – 設定 goal:例如「整理 10 家競品的功能表」
    – 拆成 todos:如「收集官網資料」「彙整成表格」
    – 每個 todo 都是可以被 Agent 調用的可執行項目,完成後會記錄在 evidence log

    你可以採取的行動:
    – 把人類原本寫在代辦軟體的任務,改成由 loopx 管理的 todos
    – 讓 LLM(例如 Claude 或 GPT)根據現有 evidence,自動產生下一個 todo

    3. 自動喚醒與配額感知

    loopx 的特色是「懂得停與再啟動」:
    – 配額感知:你可以設定 API 使用額度,讓 Agent 在接近上限時減少動作或暫停
    – 自動喚醒:當條件達成(例如有新資料、時間到了),loopx 會再喚醒 Agent 繼續跑

    你可以採取的行動:
    – 設定每天最多 token 或 API 次數,避免帳單爆掉
    – 設時間型任務:例如每天早上 9 點喚醒研究 Agent 更新資料

    💡 關鍵: 有配額感知與自動喚醒,才能讓多 Agent 長期運作而不怕超支或中斷,再用條件喚醒續跑。

    4. 可驗證交接(verifiable handoffs)

    多 Agent 最大的麻煩是「交接混亂」。loopx 幫你:
    – 每個 Agent 的輸出都記在 evidence log
    – 下一個 Agent 拿到的不只是文字,而是「帶證據的任務狀態」

    你可以採取的行動:
    – 定義每個 Agent 的輸出 schema(例如必須輸出 JSON 帶 evidence link)
    – 用 loopx 的 handoff 機制,把「搜尋結果」交給「整理 Agent」


    Cloudflare computer:給 Agent 一台可操作的電腦

    Cloudflare computer 的概念很直接:

    把一台「遠端桌面」包成程式介面,讓 Agent 控制滑鼠、鍵盤、瀏覽器。

    1. 桌面與瀏覽器控制

    功能你可以想成:
    – Agent 能開啟瀏覽器、輸入網址、點擊、捲動
    – 可以截圖或讀取目前畫面內容,回傳給 LLM 分析

    你可以採取的行動:
    – 把原本你每天重複點網頁、下載報表的流程,寫成一個 computer 任務
    – 讓 Agent 用瀏覽器登入某些工具,抓資料後再交給 loopx 管理

    2. TypeScript 開源,易整合現有工具鏈

    Cloudflare computer 用 TypeScript 寫成:
    – 可以直接在 Node.js / Bun 環境跑
    – 易跟現有的前後端專案整合

    你可以採取的行動:
    – 在現有 Node 專案中新增一個 agent-runner.ts,專門讓 LLM 控制 computer
    – 把 computer 的操作記錄(log)丟回 loopx 作為 evidence


    範例 workflow:「研究助理小隊」

    目標:

    每週自動更新一次「某個產業的最新資料整理」,包含連結、摘要與重點整理。

    角色分工

    • Agent A:資料搜尋員
    • 使用 Cloudflare computer 操作瀏覽器
    • 任務:搜尋關鍵字、打開前幾個結果、抓取主要內容與連結

    • Agent B:整理與筆記員

    • 接收 Agent A 的 evidence(網址、內容)
    • 用 LLM 整理成表格與文字摘要

    • loopx:專案管理員

    • 建立 goal「產業周報」
    • 安排每週排程,自動喚醒 Agent A
    • 管理 todos 與 handoff:
      • todo:search_industry_updates
      • handoff:把 evidence 傳給 B
      • todo:summarize_and_export

    實際跑起來會長怎樣?

    1. 每週一上午,loopx 喚醒 Agent A,執行 search_industry_updates。
    2. Agent A 用 Cloudflare computer 開 Google / Twitter,找到本週新資料,保存成 evidence(JSON + 原始內容)。
    3. loopx 把 evidence 當作 handoff,指定給 Agent B。
    4. Agent B 讀取 evidence,用 LLM 整理成:
    5. 一張 Markdown 表格
    6. 一份 1-2 頁的摘要
    7. loopx 把結果寫回某個儲存位置(例如 Git repo、Notion API、或本地檔案)。

    你可以採取的行動:
    – 先從「每週一個產業」開始,實驗多 Agent 交接流程
    – 再把產業數量增加、或增加第三個 Agent 負責「翻譯」「產出簡報」

    💡 關鍵: 把搜尋、整理、輸出拆給不同 Agent,並用 loopx 管理 handoff,就能讓「產業周報」自動每週生成。


    怎麼開始:安裝與最小範例

    1. 安裝 loopx(Python)

    前提:你需要 Python 3.10+、一個虛擬環境,與至少一個 LLM API(例:Qwen、Claude、GPT)。

    # 建議開虛擬環境
    python -m venv venv
    source venv/bin/activate  # Windows 改用 venv\Scripts\activate
    
    pip install loopx  # 以實際 repo 為準,若尚未上傳到 PyPI,則:
    # pip install git+https://github.com/huangruiteng/loopx.git
    

    最小 Python 範例(示意):

    from loopx import StateKernel, Goal
    from loopx.llm import OpenAIClient  # 或你自包的 Qwen / Claude client
    
    llm = OpenAIClient(api_key="YOUR_KEY", model="gpt-4o")
    kernel = StateKernel(llm=llm)
    
    # 建立一個長期目標
    goal = Goal(
        name="industry_weekly_report",
        description="產業最新資訊每週整理一次",
    )
    
    kernel.register_goal(goal)
    
    # 定義一個簡單 todo:產生本週提綱
    @kernel.todo("draft_outline")
    def draft_outline(state):
        """用 LLM 為本週產業周報產出提綱"""
        prompt = f"根據目前 evidence,為本週產業周報列出 5 個小節標題。" 
        outline = kernel.llm.complete(prompt)
        state["outline"] = outline
        return outline
    
    if __name__ == "__main__":
        # 執行一次 todo(之後可用排程呼叫)
        result = kernel.run_todo("industry_weekly_report", "draft_outline")
        print(result)
    

    若你要接 Qwen / Claude / GPT,做法很像:
    – 包一層 LLMClient 類別,統一 complete(prompt) 介面
    – 把 API key 放在環境變數,避免硬編碼


    2. 安裝 Cloudflare computer(TypeScript)

    前提:Node.js 18+。

    mkdir ai-computer && cd ai-computer
    npm init -y
    npm install @cloudflare/computer
    

    最小 TypeScript 範例(簡化示意):

    import { Computer } from "@cloudflare/computer";
    
    async function main() {
      const computer = new Computer();
      const session = await computer.start();
    
      // 開啟一個網址
      await session.open("https://www.google.com");
    
      // 在搜尋框輸入關鍵字並送出(實際 API 以官方為準)
      await session.type("生成式 AI 產業新聞");
      await session.enter();
    
      // 取得畫面截圖或文字
      const screenshot = await session.screenshot();
      // 把 screenshot 路徑或 base64 傳回 Python 的 loopx 作 evidence
    
      await session.close();
    }
    
    main().catch(console.error);
    

    你可以採取的行動:
    – 先把 Cloudflare computer 當成「可腳本化的瀏覽器」,先寫死流程
    – 確認操作穩定後,再把指令改由 LLM 產生(例如:llm.plan_steps() → session.*)


    3. 把兩者接在一起:權限與工具調用

    建議做法:
    – 以 loopx 為中心:所有外部工具(Cloudflare computer、資料庫、檔案系統)都當成「工具函式」
    – 每個 Agent 有一份「工具白名單」,例如:
    – 搜尋 Agent:只允許呼叫 computer.search_web()
    – 整理 Agent:只允許存取檔案與 loopx state

    簡單示意(Python pseudo-code):

    from tools import call_computer  # 這裡透過 HTTP/IPC 呼叫 TS 程式
    
    @kernel.tool("search_web")
    def search_web(query: str):
        # 把 query 傳給 Node/TS 的 Cloudflare computer
        result = call_computer(query)
        return result  # 回傳給 LLM 作 evidence
    

    你可以採取的行動:
    – 先定義一小組安全工具(例如:只讀網頁、不能亂下載檔案)
    – 在 LLM prompt 中明確寫上「只可呼叫這些工具」
    – 逐步放寬權限,視實際需求增加更多操作


    適合誰用?

    幾個具體場景:

    • 個人創作者:
    • 每週產業周報、內容題材研究、自動整理靈感庫
    • 小型團隊 / 新創:
    • 客戶調研、競品追蹤、Release Note 整理
    • 讓 Agent 先跑一輪收集與整理,人類最後審閱
    • 開發者 / 資訊人員:
    • 想實驗多 Agent 架構、測試不同 LLM(Qwen、Claude、GPT)
    • 把既有爬蟲、報表腳本逐步改成由 Agent 控制

    如果你已經在用 LLM 做單次問答,下一步可以是:
    – 用 loopx 把「一次問答」變成「持續進行的專案」
    – 用 Cloudflare computer 讓 Agent 真正動手「操作電腦」


    總結:先從一個「長任務」開始

    不要一次想太大,可以這樣開始:

    1. 選一個你每週都要重複做的知識工作(例:產業新聞整理)。
    2. 用 loopx 建立 goal+一兩個 todo,接上你現有的 LLM(Qwen / Claude / GPT)。
    3. 用 Cloudflare computer 把搜尋步驟自動化,先寫死流程,再交給 Agent 控制。
    4. 把 evidence 與結果記錄下來,逐步擴充更多 Agent。

    一旦這個「研究助理小隊」跑起來,你就等於多了一支可以長期運作的遠端 AI 團隊。


    🚀 你現在可以做的事

    • 到 GitHub 查看並 git clone loopx 專案,在本機跑起最小範例
    • 依照文中的 Node.js 步驟安裝 @cloudflare/computer,寫一個可自動打開網站的腳本
    • 選一個你每週重複的知識工作,照文中 workflow 建立第一個「研究助理小隊」並實際跑一週
  • Moonshot Kimi K3:免費玩前沿級大模型

    Moonshot Kimi K3:免費玩前沿級大模型

    📌 本文重點

    • Kimi K3 提供接近前沿模型的開源選項
    • 原生支援約 100 萬 tokens 超長上下文
    • 採 MoE 結構與 MXFP4 量化,部署成本可控
    • 資安與數學能力較弱,需搭配其他模型

    Kimi K3 解決的是一個很直接的問題:中小團隊想用接近 Fable 5 / GPT-5.6 Sol 水準的大模型,但不想被閉源 API 的價格與限制綁死。

    官方與基準介紹可參考 Moonshot 與媒體報導:The Verge 解讀中國開源策略(連結)、The Decoder 的 K3 權重釋出分析(連結)。


    核心功能:你真的能拿來做什麼

    1. 超長上下文:最高 100 萬 tokens

    Kimi K3 最實用的亮點,是原生支援最高約 1M tokens 的上下文,這代表:

    • 一次放進去整份法規、技術手冊、研究報告,讓模型直接「看完再回答」
    • 免拆章節、免自己做分段檢索(RAG),可以先用「暴力長上下文」快速原型

    💡 關鍵: 約 1M tokens 的上下文,讓你可以直接丟整份大型文件進模型處理,不必先做複雜的分段與檢索設計

    可以直接做的事:

    • 把公司內訓教材、API 文件打包成一個長 PDF,上傳到 K3 雲端推理,讓新人直接「問系統」而不是翻文件
    • 法務團隊把合約全集丟進模型,要求它找出一個特定條款在不同版本中的變化

    2. MoE 結構:896 個專家,16 個同時上場

    Kimi K3 是一個大型 Mixture of Experts(MoE)模型:

    • 約 2.8 兆參數、896 個 expert,每個 token 只啟用 16 個 expert
    • 好處:推理成本不像「全參數都算」那麼誇張,但表現接近前沿模型

    💡 關鍵: 以 2.8 兆參數、每個 token 僅啟用 16 個 expert 的 MoE 設計,在保留模型能力的同時,大幅降低推理成本

    對你而言的具體效果:

    • 做聊天助理、知識問答時,回應品質比一般開源中階模型要穩定
    • 成本與效能在「自己架」與「雲端推理」之間有彈性空間

    3. 視覺能力 + MXFP4 量化:為部署而生

    K3 內建:

    • 視覺能力:可以處理圖片(例如讀圖表、截圖說明、簡單 UI 規劃)
    • MXFP4 量化感知訓練:權重約 1.4 TB,原生就以低精度格式訓練,對推理效能更友善

    💡 關鍵: 原生 MXFP4 量化感知訓練與約 1.4 TB 權重,讓你在部署時不用額外量化,直接享受低精度帶來的效能優勢

    這對你意味著:

    • 如果你在做「文件 + 圖表」分析(財報、研究報告、技術圖解),可以用一套模型完成
    • 部署時不用自己再做一次量化,直接用官方 MXFP4 權重即可

    適合誰用:三種典型場景

    1. 中小團隊:自架聊天 / 知識助理,替代閉源 API

    痛點:用 GPT 類模型做內部知識庫或客服助理,API 成本難控、資料怕外流、客製受限。

    Kimi K3 能做的事:

    • 自架「公司版 ChatGPT」,所有資料在自己控制的環境裡
    • 把 FAQ、產品手冊、內部 SOP 都塞進去,做第一版知識助理原型

    具體行動:

    • 先用 Hugging Face 雲端推理試跑聊天助理雛型
    • 如果效果符合預期,再評估是否值得投入 GPU 成本做正式部署

    2. 長文檔處理:法務、研究、技術文件

    痛點:一般模型需要分段 + RAG,設定複雜,而且容易漏掉跨章節脈絡。

    Kimi K3 的優勢:

    • 用超長上下文直接塞進完整文件,不必先切小塊
    • 對「跨章節、跨文件」的比較與歸納特別方便

    具體行動:

    • 法務:將過去三年的合約樣本合併成一個長文件,讓 K3 找出常見風險條款
    • 研究:把十篇相關論文丟進同一 session,請模型整理不同方法的優劣與假設

    3. 做 AI 產品原型:蒸餾、微調的母模型

    痛點:想做垂直領域模型(醫療、金融、工業),但找不到足夠強的開源基底。

    Kimi K3 適合:

    • 當成「教師模型」,給你下游小模型做蒸餾
    • 作為微調基底,針對特定任務(寫程式、產出技術報告)強化

    具體行動:

    • 用雲端推理先定義「你希望學生模型學會的風格與能力」
    • 再用 K3 + 你的任務數據做一次指令微調,產出中型學生模型,方便在更便宜的硬體跑

    怎麼開始:免硬體門檻到最低部署指南

    路徑一:先用 Hugging Face / 雲端推理快速試

    如果你只是想評估 K3 適不適合你的場景,不要一開始就買 GPU,先用雲端:

    1. 到 Hugging Face 找模型卡
      搜尋「Kimi K3」或 Moonshot 官方模型卡(權重預計放在 HF,對應 Reddit 討論:連結)。

    2. 點進「Inference API」或社群提供的 web demo

    3. 用你的實際任務測試:

    4. 貼一段長文件(法規、說明書)
    5. 要它做摘要、條款比對、寫技術說明

    6. 記錄:

    7. 回答是否跟得上上下文
    8. 對專業領域的理解是否足夠

    評估重點:

    • 如果主要是長文理解、摘要與一般知識問答,K3 通常足夠
    • 若你要高風險場景(資安、程式驗證、精準數學),記下它的弱點,準備搭配其他模型

    路徑二:有 GPU 的讀者,最低門檻部署指南

    K3 的完整 MXFP4 權重大約 1.4 TB,單節點塞滿是高難度任務。社群實測從 A100 到 B300,結論大致如下:

    GPU 配置 記憶體總量(8 卡) 實際狀況 適合誰
    A100 80G 約 640 GB 明顯不足,需多節點 + 進階分片,延遲高,數學表現被壓縮 有現成 A100 集群、願意做工程優化的團隊
    H200 約 1.13 TB 仍略不足,需要多節點;推理可行但調度較複雜 已在用 H200 做大模型、有 infra 團隊
    B300 約 2.3 TB 理論上單節點可放完整模型,部署體驗最佳 願意為前沿模型砸錢的大型團隊

    以上配置分析來源:r/LocalLLaMA 部署討論(連結)。

    最低實用部署步驟(以有 H200 / B300 為例)

    1. 決定你要跑的場景

    2. 若只做測試與小流量聊天:多節點 H200 即可

    3. 若預計有穩定商業流量:優先考慮 B300 單節點,省通訊痛苦

    4. 準備軟體堆疊(雲端或本地)

    5. 安裝支援大模型的推理框架:如 vLLM、TensorRT-LLM 或自家客制方案

    6. 確定框架支援 MXFP4 / 低精度推理與 MoE 分片

    7. 下載權重並做分片配置

    8. 從 Hugging Face 拉取 K3 權重(約 1.4 TB,需有足夠存儲)

    9. 根據 GPU 數量與記憶體設定分片策略:每張卡 load 部分 expert

    10. 發布一個簡單的 API

    11. 預設路由:/chat、/completion、/file-qa

    12. 對內部前端(客服面板、知識庫 UI)只暴露 HTTP API,方便日後換模型

    成本與取捨提醒

    • A100 世代:沒有最新低精度 tensor core,跑 K3 會偏吃力,延遲與能耗都不優;如果只是測試,OK,但不建議長期商用。
    • H200:算力與頻寬更好,但仍需要多節點分散模型;工程複雜度較高。
    • B300:最接近「想跑就跑」的體驗,但硬體成本非常高,只適合已有前沿模型需求的公司。

    弱點與搭配策略:資安與數學要小心

    獨立測試與媒體報導提到,K3 在網路安全與數學能力上有明顯差距,很可能跟蒸餾過程有關(參考 The Decoder 報導:連結)。

    實際使用時,建議你這樣處理:

    1. 資安 / 攻擊向量相關任務

    2. 不要把「產生攻擊腳本、滲透測試細節」交給 K3

    3. 若你的產品涉及資安,只用 K3 做一般說明與文件整理,再用專門模型(或人工審核)處理技術細節

    4. 高精度數學與程式驗證

    5. 複雜數學推導、金融衍生品定價等,不要只信 K3 的第一個答案

    6. 可以採用「雙模型策略」:

      • K3 負責理解題目與長上下文(例如一整份投資報告)
      • 用擅長數學 / coding 的模型(如專門 code LLM)負責計算與程式檢查
    7. 內部評估流程

    8. 上線前,先設計一套測試題(你自己的真實問題),量測:

      • 資安敏感問題的回答是否合規
      • 數字題、程式題的錯誤率
    9. 把測試結果寫入內部使用指南,明確標記「K3 能做什麼/不能做什麼」。

    小結:你可以立刻採取的三個行動

    1. 先在 Hugging Face 上跑一次你的真實長文場景
      丟一份你現在用 GPT 處理的 PDF,看看 K3 的回答差異。

    2. 評估是否值得搭建內部知識助理
      若你每月在閉源 API 上花的錢已經不小,K3 是一個值得算帳的替代選項。

    3. 如果你有 GPU 集群,安排一個週末 PoC
      用最小配置把 K3 部署成內部 API,跑一輪你關鍵團隊(法務、客服、研發)的真實工作流程,再決定要不要進一步優化。

    Kimi K3 把「前沿級模型」帶進了開源與可控成本的範圍內,只要你清楚它的長處與短板,就能把它變成你團隊的工具,而不是風險。

    🚀 你現在可以做的事

    • 去 Hugging Face 搜尋「Kimi K3」,用 Inference API 跑一份你實際的長文件
    • 整理公司內部 FAQ、SOP 與技術文件,規劃一版「公司版 ChatGPT」原型需求
    • 盤點現有 GPU / 雲端資源,模擬在 H200 或 B300 上部署 K3 成內部 /chat API 的 PoC 計畫
  • Chat2DB:一句話查遍所有資料庫

    Chat2DB:一句話查遍所有資料庫

    📌 本文重點

    • Chat2DB 將多種資料庫集中成一個可用中文聊天操作的工作台
    • 透過自然語言即可生成、優化 SQL 並視覺化查詢結果
    • 適合工程師、分析師與產品/營運作跨庫查詢與報表自助

    一句話先講清楚:Chat2DB 就是把多種資料庫變成一個可以用自然語言聊天、查數據、改結構的單一工作台。

    你不用記一堆 SQL 語法,也不用在多個資料庫工具之間切換,只要開一個視窗,打中文問題,Chat2DB 就能幫你生成 SQL、跑查詢、畫圖、做常見管理操作。

    原始碼與下載點:https://github.com/OtterMind/Chat2DB


    核心功能:把「聊天」變成查資料庫的主入口

    1. 支援多種主流資料庫,一次連完集中管理

    Chat2DB 本質上是一個 GUI SQL 客戶端 + AI 助理,支援常見關聯式資料庫:

    • MySQL
    • PostgreSQL
    • Oracle
    • SQL Server
    • DB2
    • SQLite
    • H2
    • ClickHouse
    • 其他更多在持續增加中

    能做的事:

    • 在左側一次看到所有已連線的資料庫與資料表
    • 對每個連線分別設定權限、名稱(例如「線上庫」「測試庫」「報表庫」)
    • 在同一個介面切換不同資料庫資料表,省去打開多個工具的麻煩

    你可以立刻做的事:

    1. 把目前專案的 MySQL、公司的分析 PostgreSQL 一次都連到 Chat2DB
    2. 用同一個聊天框去問跨庫問題(例如:線上訂單在 MySQL,歷史訂單在 ClickHouse)

    💡 關鍵: 把所有資料庫連線集中在一個介面,可大幅減少在多種工具間切換的時間與錯誤風險。


    2. 用聊天生成、優化 SQL:從「問題」到「查詢」一步到位

    Chat2DB 的主角是右側的聊天視窗,你可以用自然語言描述需求,它會:

    1. 讀取你選擇的資料庫和資料表結構
    2. 生成對應的 SQL 查詢
    3. 執行並顯示結果(表格 / 圖表)

    實際效果示例:

    • 輸入:「請幫我查 2024 年 7 月每一天的新註冊用戶數,按日期排序。」
    • Chat2DB:生成 SELECT date(created_at) AS day, COUNT(*) ... 之類的 SQL,跑出每日註冊數
    • 輸入:「把剛才的查詢改成只看台灣地區。」
    • Chat2DB:根據上一個 SQL 增加 WHERE country = 'TW' 條件

    你可以立刻做的事:

    • 把常用報表(週活躍、訂單轉化)用中文描述給 Chat2DB,讓它幫你寫出第一版 SQL
    • 再用聊天微調,例如「改成最近 30 天」「把結果依訂單金額排序」

    3. 查詢結果視覺化 + 常見管理操作一站完成

    生成 SQL 之後,Chat2DB 不只給你純文字結果,而是:

    • 以表格顯示查詢結果,可排序、過濾、匯出
    • 支援視覺化:根據時間序列或分類欄位,快速切換折線圖、柱狀圖等
    • 內建常見管理操作:建表、改欄位、改索引、查看 schema

    具體能做的事:

    • 在聊天視窗輸入:「幫我把 users 表的 phone 欄位長度改成 32。」
    • Chat2DB 會生成 ALTER TABLE 語句,並提示你確認執行
    • 查出訂單數據後,按一下圖表按鈕,把「每日訂單量」畫成折線圖
    • 對結果表格直接匯出為 CSV,丟給同事或進 Excel 做後續加工

    你可以立刻做的事:

    • 把常用的結構變更(加欄位、改型別)交給 Chat2DB 先生成 SQL,再由你確認
    • 用圖表快速檢查趨勢,而不是只看裸 SQL 結果

    💡 關鍵: 將查詢、視覺化與結構管理整合在一站,能讓資料查詢流程從「寫 SQL → 抓數據 → 拉圖」縮短成單一路徑。


    適合誰用:工程師、分析師、產品/營運三種典型場景

    1. 工程師:快速試 query、跨多資料庫環境

    你手上可能同時有:

    • 線上 MySQL
    • 分析 PostgreSQL
    • 本地 SQLite

    過去要開 2-3 種不同工具,現在只要一個 Chat2DB。

    實際場景:

    • 在改 API 前,快速用聊天生成查詢,驗證資料狀態
    • 在調效能時,請 Chat2DB 「幫我優化這段 SQL,減少全表掃描」,讓它提供索引或重寫建議

    工程師可以立刻做的事:

    • 建一個「測試庫專用」連線,所有危險操作只在這裡試
    • 把複雜 SQL 貼進去,要求 Chat2DB 解釋這段 SQL 在做什麼,幫自己查 bug

    2. 資料分析師:不熟 SQL 也能拿到報表與圖表

    如果你了解指標邏輯,但不擅長寫 SQL,Chat2DB 很適合當作輔助腳本工具。

    實際場景:

    • 你只需要用中文描述:「我要看 7 月新客的首購金額分佈,按照金額區間統計」,由 Chat2DB 將需求翻成 SQL
    • 生成的結果直接用圖表查看分佈,確認是否有異常尖峰

    分析師可以立刻做的事:

    • 把常用的分析問題整理成一份「問題清單」,每天用 Chat2DB 跑一遍,作為簡易報表系統
    • 將生成的 SQL 保存,下次再用同一段 SQL + 微調日期條件

    3. 產品/營運:用簡單中文問題拉出關鍵數據

    產品經理或營運人員,通常沒有太多 SQL 經驗,但很常提出問題:

    實際場景:

    • 問:「最近 7 天新註冊的用戶中,有多少人完成首購?」
    • 問:「哪三個城市的退貨率最高?給我城市名稱、訂單數量、退貨比例。」

    Chat2DB 可以:

    • 從既有資料庫結構中推測相關表(users、orders、refunds)
    • 生成對應的 SQL 和結果

    產品/營運可以立刻做的事:

    • 請工程師幫你建立一個「只讀」帳號連到 Chat2DB
    • 自己在 Chat2DB 用自然語言問營運問題,不必每次都麻煩工程師拉數據

    💡 關鍵: 讓非工程背景的人可以直接對資料庫發問,能明顯縮短「提需求 → 等工程拉數 → 再確認」的反覆溝通時間。


    怎麼開始:從安裝到第一個自然語言查詢

    1. 下載與安裝:桌面版或 Docker 二選一

    (A)桌面版:最快上手路徑

    1. 前往 GitHub Releases:https://github.com/OtterMind/Chat2DB/releases
    2. 選擇對應作業系統的安裝檔(Windows / macOS / Linux)
    3. 安裝後啟動 Chat2DB,看到左側是連線管理,右側是聊天 / SQL 視窗

    (B)Docker 部署:適合團隊共享或伺服器環境

    1. 準備有 Docker 的伺服器
    2. 在 GitHub 尋找對應的 Docker 啟動指令(通常是 docker run 搭配映像檔)
    3. 部署完成後,用瀏覽器進入指定 URL,即可使用 Web 版 Chat2DB

    安裝細節可能隨版本更新,建議依照官方 README 最新說明操作:https://github.com/OtterMind/Chat2DB


    2. 連線 MySQL / PostgreSQL:示例設定

    以 MySQL 為例,在 Chat2DB 裡新增連線:

    • 類型:MySQL
    • Host:your-mysql-host
    • Port:一般為 3306
    • Database:要連的資料庫名稱(例如 prod_db 或 analytics_db)
    • 帳號/密碼:建議使用只讀帳號,限制寫入與刪除

    PostgreSQL 則類似:

    • 類型:PostgreSQL
    • Port:一般為 5432
    • 其他欄位照實填寫即可

    連線測試成功後,你會在左側看到資料表清單,可以點開查看欄位與結構。

    你可以立刻做的事:

    • 建兩個連線:一個連測試庫(可寫),一個連線上庫(只讀),確保自己不會在錯的環境做修改

    3. 開啟 AI 助理與實用 Prompt 範本

    Chat2DB 通常在介面上提供「AI 助理」或「Chat」入口,進入後就可以開始用自然語言互動。

    常用 Prompt 範本,你可以直接複製調整:

    1. 生成查詢
    2. 「在目前選擇的資料庫中,幫我查出最近 30 天每天的訂單數量與總金額,按日期排序。」
    3. 優化現有 SQL
    4. 「這段 SQL 執行很慢,請幫我分析原因並提出優化建議:YOUR_SQL_HERE」
    5. 解釋 SQL
    6. 「請用條列方式解釋下面這段 SQL 的作用,並指出可能有風險的地方:YOUR_SQL_HERE」
    7. 修改資料表結構
    8. 「幫我在 users 表新增一個 last_login_at 的欄位,型別用 datetime,預設值為 null,生成 ALTER TABLE 語句但不要直接執行。」

    你可以把這些 Prompt 存成自己的「操作模板」,每天重複使用。


    4. 在生產庫使用時的權限與風險控管

    Chat2DB 再好用,連到生產資料庫時一定要注意:

    • 使用只讀帳號:除非非常必要,不要給 Chat2DB 有刪除或更新權限
    • 分環境設定:清楚標註 prod、staging、dev,避免在錯誤環境執行修改
    • 先生成後確認再執行:尤其是 UPDATE / DELETE / ALTER TABLE 類型的語句
    • 限制可見資料庫:帳號只授權需要的 schema,減少誤操作範圍

    你可以立刻做的事:

    • 請 DBA 或工程師幫你建立一個專用只讀帳號,專門給 Chat2DB 使用
    • 約定團隊規則:所有結構變更 SQL 先由 AI 生成,再由工程師人工 review、手動執行

    結論很簡單:如果你每天都在查資料庫、寫 SQL、拉數據,Chat2DB 是一個能立刻提升效率的工具。把它當成「會寫 SQL 的聊天夥伴」,從今天開始,用一句句自然語言問題,換回更快的數據與報表。

    🚀 你現在可以做的事

    • 到 Chat2DB GitHub Releases 下載桌面版並連上你的第一個資料庫
    • 準備一份「常問數據問題清單」,在 Chat2DB 裡用中文逐條轉成查詢
    • 與團隊討論並設定一個專用只讀帳號與環境標註規則,安全地在生產庫使用 Chat2DB
  • BTL-3:8GB 就能跑的本地程式代理人

    BTL-3:8GB 就能跑的本地程式代理人

    📌 本文重點

    • BTL-3 是可本地部署的程式代理人模型
    • 8.39GB GGUF 保留約 92% 的 27B 能力
    • 特化在工具呼叫與完整程式工作流
    • 適合離線開發與本地 Agent 架構

    想要在自己電腦上擁有類似 GitHub Copilot / Claude Code 的程式代理人,又不想連雲端?BTL-3 是目前少數「真實可落地」的開源選擇。

    原帖與技術細節:[Reddit] BTL-3 27B agentic coding model


    核心功能:一顆小體積、但會「自己想和動手做」的模型

    1. Agentic 架構:不只是聊天,而是完整工作迴圈

    BTL-3 的訓練目標不是「回答問題」,而是模擬一個真正的程式代理人工作流:

    Reason → Act → Inspect → Recover → Continue

    你可以直接把它當成一個「會自己規劃與檢查的本地 Copilot」,實際用法像這樣:

    1. Reason(思考):給它一個 repo 跟目標,例如:把這個專案加上簡單的健康檢查 API。
    2. Act(行動):它會規劃要改哪些檔案、生成修改方案或腳本。
    3. Inspect(檢查):搭配工具(如 git diff、測試腳本)檢查結果。
    4. Recover(恢復):若測試失敗,會根據錯誤訊息繼續修正。

    行動建議:

    • 設計你的 prompt 時,直接描述「任務目標 + 可用工具 + 成功條件」,讓它接手後續流程,而不是只叫它「寫一段程式」。

    2. 工具呼叫:一次、連續、並行都能掌握

    BTL-3 內建工具使用能力,可做到:

    • 單次工具呼叫:例如呼叫 bash 跑測試、或呼叫 HTTP client 打內部 API。
    • 連續呼叫:先爬資料,再處理,再更新資料庫。
    • 並行呼叫:同時對多個服務發出請求,再整合結果。
    • 知道何時不要用工具:測試顯示,它在「工具呼叫放棄」場景的表現也很不錯(原文數據:工具呼叫放棄約 91.2% 準確)。

    💡 關鍵: 約 91.2% 的工具呼叫放棄準確率,代表它不只會用工具,也懂得在不需要時適時收手。

    你可以把它接到現成 orchestrator(如 MCP、或你自己的 agent framework),讓 BTL-3 再負責「判斷何時用哪個工具」。

    行動建議:

    • 若你已有工具系統(CLI、內部 API),先列出 3–5 個常用操作,包成「工具描述 + I/O 格式」,再讓 BTL-3 透過這些工具完成任務,而不是只輸出文字。

    3. 在 8.39GB GGUF 裡塞進 92% 的 27B 智慧

    BTL-3 原始是 27B 參數模型,但 Bad Theory Labs 用自家量化壓縮技術(AVQ2 解碼、INT4 仿射運算等),做出一個:

    • 單一 GGUF 檔(約 8.39GB)
    • 每參數不到 2.5 bits
    • 保留約 92.2% 原始模型能力

    💡 關鍵: 約 8.39GB 的 GGUF 就保留 92.2% 能力,代表一般開發者電腦即可接近 27B 模型效能。

    一個關鍵指標是 HumanEval pass@1 約 95.12%,這個成績在開源程式模型裡非常高,實際效果就是:

    • 常見演算法題、資料處理、API 包裝腳本,大多可以一次寫對(或只需小修)。

    💡 關鍵: HumanEval pass@1 約 95.12%,表示它在「一次寫對程式」上的成功率已逼近頂級商業程式模型水準。

    行動建議:

    • 若你現在在本地跑的是 7B–8B 一般聊天模型(例如常見的「通用 LLM」),可以直接用同一套 llama.cpp / LM Studio 配置,換成 BTL-3 GGUF,感受一次「針對程式與工具使用優化」的落差。

    適合誰用:三種典型場景

    1. 離線/內網環境的程式開發助手

    如果你的程式碼不能上雲(金融、政府、內網產品),BTL-3 提供一條路:

    • 在機房或開發者筆電本地部署,不經過外部 API。
    • 讓它讀 repo、理解架構、提出修改建議。

    典型任務:

    • 在不同微服務間統一 logging 格式。
    • 為舊專案補上基本 test suite。

    行動建議:

    • 選一個「不能丟到 GitHub Copilot」的專案,讓 BTL-3 先生成一份「系統總覽 + 待改善清單」,作為內網 code review 助手。

    2. 自動化腳本 & 工具串接

    BTL-3 對工具呼叫特別強,適合當成:

    • CLI 自動化腳本生成器:幫我寫一個每天備份某資料夾到 S3 的腳本。
    • 爬蟲與內部 API orchestration:串接 curl、Python script、內部 REST API。

    行動建議:

    • 設計一個小專案:例如「自動整理 log + 發 Slack 通知」,讓 BTL-3 負責生成腳本、再透過工具跑一次,測試它的完整 workflow 能力。

    3. 本地 Agent 開發環境的一顆「程式專家」核心

    你可能已經在用:

    • llama.cpp / vLLM 當推理引擎
    • 本地 IDE 插件(VS Code extension、JetBrains plugin)
    • MCP 或其他 orchestrator 做多工具協調

    BTL-3 可以直接當「程式 & 工具專家」,其他模型負責一般聊天或決策。

    行動建議:

    • 在你的 agent framework 裡,新增一個 coding-agent 路由:
    • 當任務涉及 repo、CLI、API 操作時,轉給 BTL-3。
    • 其他任務仍用通用模型(如 Solar Open 2、Laguna S 2.1 等)。

    下面用表格簡單比較常見選項:

    名稱 核心功能 免費方案 適合誰
    BTL-3 本地程式代理人、工具呼叫 開源、GGUF 免費 想要本地 Copilot / 程式 Agent
    Solar Open 2 長上下文、辦公 & 程式代理 開源模型 文件密集 + 長上下文任務
    Laguna S 2.1 多語言、大型本地通用模型 開源模型 需要高性能通用助手

    相關連結:


    怎麼開始:從硬體到第一個 workflow

    Step 1:確認硬體配置

    官方 8.39GB GGUF 版本的目標是「一般開發者電腦可以跑得動」,實務建議:

    • RAM:16–32GB(越多越穩定)
    • GPU:一張中階卡(8–12GB VRAM 足夠),或純 CPU 也可嘗試
    • 儲存空間:至少預留 20GB 給模型與前端工具

    行動建議:

    • 先在自己的機器跑過任一 7B–8B GGUF 模型,如果能順跑,再換 BTL-3 應可接受。

    Step 2:下載 BTL-3 GGUF 模型

    目前 BTL-3 GGUF 版本由 Bad Theory Labs 釋出(連結通常在 Reddit 原帖或其 X 帳號):

    行動建議:

    • 用瀏覽器或 wget 下載 GGUF 檔到一個固定資料夾,例如:~/models/btl3/btl3-agentic.gguf。

    Step 3:用 llama.cpp / LM Studio / Ollama 載入

    三條常見路徑:

    1. llama.cpp(命令列 / 伺服器模式)
    2. 安裝:依官方 repo 說明編譯。
    3. 啟動 server:
      bash
      ./llama-server \
      -m ~/models/btl3/btl3-agentic.gguf \
      -c 262144 \
      --host 0.0.0.0 --port 8080
    4. 之後透過 HTTP API 或前端連接。

    5. LM Studio

    6. 開啟 LM Studio → Add local model → 指向 GGUF 檔。
    7. 選好推理設定(context 長度、GPU offload),直接在內建聊天介面測試。

    8. Ollama 類工具

    9. 建一個 Modelfile 指向 BTL-3 GGUF。
    10. ollama run btl3 即可啟動本地推理。

    行動建議:

    • 初次使用先從 LM Studio 或類似 GUI 工具開始,快速確認模型品質,再把配置搬到 llama.cpp / server 模式。

    Step 4:實作一個簡單 workflow:讀 repo → 改動 → Patch → 自評測

    以下示範用「BTL-3 + llama.cpp server + 你習慣的 HTTP client」做一個小流程。

    1. 讓 BTL-3 讀 repo
    2. 先用你自己的 script 把重要檔案(README、主要程式入口、config)整理成一個壓縮過的文字輸入。
    3. 發送一個請求:
      json
      {
      "prompt": "你是一個程式代理人。以下是專案的主要檔案內容:...\n\n請先用條列方式整理這個系統的主要模組與依賴,再列出 3 個可以改善的地方。",
      "max_tokens": 2048
      }

    4. 規劃改動

    5. 根據它提出的改善建議,選一項(例如「增加健康檢查 API」),再下指令:
      > 「請為此改動設計一個實作計畫:要改哪些檔案、新增哪些函式、需要哪些測試。」

    6. 生成 Patch

    7. 要求它輸出 git-style unified diff:
      > 「根據上面的計畫,請輸出 unified diff 格式的 patch,適用於 git apply。」

    8. 自評測

    9. 套用 patch,跑測試(可寫成工具讓 BTL-3 呼叫)。
    10. 把測試結果回傳給 BTL-3:
      > 「以下是測試輸出,請根據錯誤訊息更新 patch。」

    行動建議:

    • 把上述流程包成一個腳本或簡單 web UI,讓 BTL-3 成為你團隊的「自動 Patch 提案助手」,從單一專案先試用。

    Step 5:接進你現有的 Agent workflow(如 MCP)

    如果你已在用 MCP 或其他 orchestrator:

    1. 新增一個 LLM provider 指向 BTL-3:
    2. 透過 llama.cpp server / LM Studio API 對接。

    3. 定義工具:

    4. read_repo:讀指定路徑檔案並壓縮輸出。
    5. run_tests:執行 test 命令並回傳 stdout / stderr。
    6. apply_patch:套用 diff 到 repo。

    7. 給 BTL-3 的 system prompt:

    8. 明確告訴它有哪些工具、何時該使用、成功定義(例如「所有測試通過」)。

    行動建議:

    • 在你的 orchestrator 裡,把「所有涉及程式碼修改的任務」預設派給 BTL-3,其他任務仍用通用模型,實際對比整體完成品質與速度。

    BTL-3 的定位很清楚:不是要取代所有模型,而是成為你本地環境裡專門負責「寫程式 + 用工具」的那顆專家模型。如果你正在找一個接近本地版 Copilot / Claude Code 的選擇,它值得你花一個週末搭起來試用。

    🚀 你現在可以做的事

    • 到 Reddit 原帖下載 BTL-3 GGUF,並用 LM Studio 或 llama.cpp 在本地先跑一輪測試
    • 選一個不能上雲的專案,讓 BTL-3 產生「系統總覽 + 改善清單」,試做一次 Patch workflow
    • 在你現有的 agent framework 中新增 coding-agent 路由,將程式與工具相關任務導向 BTL-3 並觀察效果
  • 一句話搞懂 Gemini 3.6 Flash 家族

    一句話搞懂 Gemini 3.6 Flash 家族

    📌 本文重點

    • 3.6 Flash:多模態主力模型,長文省 token
    • Flash-Lite:專攻低延遲、低成本 API 場景
    • Flash Cyber + CodeMender:程式碼安全掃描與修補解決方案
    • 先用 AI Studio 試 3.6 Flash,再視需求串 API 與導入安全模型

    用一句話講清楚:Gemini 3.6 Flash 家族,就是「一套便宜好用、從寫作到程式安全都能涵蓋」的多模態模型組合,讓一般用戶寫內容、開發者串 API、安全團隊掃漏洞,都有對應的工具可用。


    一句話搞懂三個 Flash 模型怎麼分工

    先用一行幫你記住三款模型的定位:

    3.6 Flash 負責主力多模態(長文本、省錢),3.5 Flash-Lite 負責低延遲 API,3.5 Flash Cyber 搭 CodeMender 負責程式碼安全掃描與修補。

    💡 關鍵: 3 款模型分工明確,從內容生成到大量 API 呼叫再到安全掃描,都有專門工具可選,用對模型就能兼顧效果與成本。

    對應到你的需求,很簡單:

    • 想寫作、翻譯、看圖、看 PDF 👉 用 3.6 Flash
    • 想做聊天機器人、內部 FAQ Bot 👉 後端 API 選 Flash-Lite
    • 想掃 Repo 漏洞、產安全修補 PR 👉 用 Flash Cyber + CodeMender

    官方介紹與細節可參考:


    核心功能:為什麼說「免費又省錢」

    1. Gemini 3.6 Flash:多模態主力+省 65% token

    3.6 Flash 是這次更新的主角:

    • 多模態能力:支援文字、圖片、程式碼、文件,拿圖請它「幫我總結這張資訊圖」,或把 PDF 貼給它做重點整理都很適合。
    • 長上下文+節省 token:官方說明可 節省最多約 65% token 使用量(來源:The Decoder 報導),等於同樣一篇長文,token 花費更低。
    • 適合當「日常主力模型」:寫文章、改寫、翻譯、整理會議記錄、理解技術文件,都可以直接丟給 3.6 Flash。

    💡 關鍵: 最多節省約 65% token,代表在長文本情境下能顯著壓低使用成本,特別適合高頻率內容工作者。

    你可以做的事:

    • 開啟 Google AI Studio,用 3.6 Flash 當預設模型,先試三件事:
    • 貼一篇你最近寫的文章,請它「改寫成 3 點精簡重點」
    • 上傳一張複雜圖表,問它「用白話講裡面的結論」
    • 貼一段英文技術文件,請它「翻譯+加註解」

    入口:Google AI Studio(免信用卡可先玩)👉 https://aistudio.google.com

    2. 3.5 Flash-Lite:給開發者的低延遲 API

    Flash-Lite 是 3.5 Flash 的精簡版,定位很清楚:給需要大量 API 呼叫、講求速度和成本的開發者。

    特點:

    • 低延遲:用在聊天機器人、即時問答服務,不會讓使用者等太久。
    • 便宜:相較大型模型,Flash-Lite 的單次呼叫成本更低,適合 side project 或公司內部工具。

    你可以做的事:

    • 做一個公司內部 FAQ Bot:
    • 把人資 / IT / 行政 FAQ 整理成一個 JSON 或資料庫
    • 用自家後端(Node.js / Python)接 Gemini API,模型選 Flash-Lite
    • 在前端做一個簡單聊天視窗,把使用者問題送給 Flash-Lite,再加上你的 FAQ 檢索結果

    💡 關鍵: Flash-Lite 把「低延遲+低成本」綁在一起,特別適合需要高併發、多次呼叫的聊天與工具型應用。

    3. 3.5 Flash Cyber + CodeMender:安全掃描+自動修補

    Flash Cyber 是專門做 程式碼安全 的模型,主要搭配 Google 的安全編碼代理工具 CodeMender 使用。

    重點能力:(來源:The Verge 報導)

    • 快速發現與標記安全漏洞:支援多次高速呼叫,掃整個 Repo 的潛在問題。
    • 產生修補建議甚至自動 PR:透過 CodeMender,可直接給出修補的 patch 或 Pull Request。
    • 比同類大型安全模型(如 Anthropic Mythos)更具成本效益:適合 DevSecOps 團隊把「安全掃描」變成 CI pipeline 的一環。

    你可以做的事:

    • 把 Flash Cyber+CodeMender塞進你的 CI/CD:
    • 選定關鍵 Repo(例如:支援金流的服務)
    • 在 CI pipeline 增加一個步驟呼叫 CodeMender(綁 Flash Cyber)做安全掃描
    • 設定「阻擋條件」:偵測到高危漏洞就阻擋部署,並自動開 Issue / PR 給開發者

    注意:Flash Cyber 目前偏向提供給政府與可信任夥伴,普通開發者需要留意資格與開放程度(可留意 DeepMind 官網更新)。


    三款模型一張表看懂

    名稱 核心功能 免費方案 / 試用 適合誰
    Gemini 3.6 Flash 多模態主力、長上下文、省 token Google AI Studio 線上免費試用 一般使用者、內容創作者、分析師
    3.5 Flash-Lite 低延遲、低成本 API Cloud 上有免費額度與試用配額 Side project 開發者、內部工具團隊
    3.5 Flash Cyber 程式碼與安全漏洞掃描+修補 目前對政府與特定夥伴開放 安全團隊、DevSecOps、雲端平台營運方

    適合誰用:三類典型場景

    1)個人用戶:寫作、翻譯、圖片理解

    你只想要一個好用又省錢的 AI 助理,重點就是:全部用 3.6 Flash 就好。

    具體可以這樣用:

    • 寫作:給它「大綱+口氣要求」,讓它幫你產出初稿,再自己微調
    • 翻譯:把英文技術文章貼上,請它「翻譯成繁體中文+保留術語」
    • 圖片理解:上傳會議投影片截圖,問「這張的重點是什麼?幫我變成三點待辦事項」

    2)開發者:side project/內部工具串 Flash-Lite

    你要的是:API 便宜+速度可以接受,而不是每次都上最強的大模型。

    典型 side project:

    • 公司內部 FAQ Bot
    • 報表解說助手(讀 CSV / JSON,整合你自己的後端邏輯)
    • 客戶服務前台聊天機器人

    做法:

    1. 在 Google AI Studio 建一個新 API Key
    2. 後端選 Node.js / Python,用官方 SDK 串接
    3. 模型選 3.5 Flash-Lite,加上你自己的向量資料庫或關鍵字搜尋

    3)安全/DevSecOps:Flash Cyber + CodeMender

    如果你的工作是:

    • 管理大規模微服務 Repo
    • 維護金融或政府相關系統

    就可以把 Flash Cyber 當成「安全同事」,在以下場景使用:

    • 每次合併 PR 前,跑一次安全掃描
    • 每季度對關鍵服務做「全面程式碼健康檢查」
    • 新人上線前,先掃他改動的部分,避免引入基本錯誤

    怎麼開始:從線上玩到串 API

    步驟 1:用 Google AI Studio 線上試玩

    1. 打開 https://aistudio.google.com
    2. 登入 Google 帳號
    3. 在模型列表選 Gemini 3.6 Flash
    4. 嘗試:
    5. 貼一段你公司文件,請它「整理成給新人看的版本」
    6. 上傳一張圖表,請它「用中學生也懂的方式解釋」

    這一步的目的:先確認 3.6 Flash 的表現符合你的期待,再考慮串 API。

    步驟 2:拿 API Key 串自己的 side project

    1. 進 Google AI Studio,切到 API / Key 管理
    2. 建立一個新專案,生成 API Key
    3. 後端程式碼示意(以 Node.js 為例):
    npm install @google/generative-ai
    
    import { GoogleGenerativeAI } from "@google/generative-ai";
    
    const genAI = new GoogleGenerativeAI(process.env.GEMINI_API_KEY);
    const model = genAI.getGenerativeModel({ model: "gemini-3.5-flash-lite" });
    
    async function ask(question) {
      const result = await model.generateContent(question);
      console.log(result.response.text());
    }
    

    你可以立刻把這段變成:

    • FAQ Bot:把使用者問題+你整理出的 FAQ 一起丟進 prompt
    • 報表解說助手:先由後端讀取 CSV,算出數字,再請模型「用文字說明這些指標變化」

    步驟 3:學會「選模型+估成本」

    粗略的模型選擇與成本思路:

    • 優先用 Flash 系列:
    • 若是內容生成/多模態理解 👉 3.6 Flash
    • 若是大量聊天/高併發問答 👉 3.5 Flash-Lite
    • 若是安全掃描 👉 Flash Cyber
    • 遇到以下情況再考慮大模型(如 Pro 類型):
    • 極高難度推理
    • 任務對準確度要求極端嚴格

    估成本的簡單方法:

    1. 在 AI Studio 看一次 token 使用量,記下「平均一次請求的 token 數」
    2. 估計每日請求次數(例如:1,000 次)
    3. 套用 Cloud 價格表(官方文件),算出每月概算
    4. 如果超出預算,先:
    5. 改用 Flash-Lite
    6. 精簡 prompt(例如縮短系統指令、用摘要代替全文)

    小結:把 Gemini 3.6 Flash 家族當成你的「AI 三件套」

    實際用起來,你可以這樣記:

    • 3.6 Flash:我日常寫作、看圖、看文件的主力
    • Flash-Lite:我做聊天機器人和內部工具時的省錢 API
    • Flash Cyber + CodeMender:我在 Repo 上的安全掃描與自動修補幫手

    先從 AI Studio 免費玩 3.6 Flash 開始,熟悉手感之後,拿 API Key 把 Flash-Lite 接進你的 side project,最後視公司安全需求再評估導入 Flash Cyber,這樣就能用最低成本,讓 Gemini 3.6 Flash 家族成為你工作流程裡的多模態新主力。

    🚀 你現在可以做的事

    • 打開 Google AI Studio,用 Gemini 3.6 Flash 試跑你手上的文章、圖表或技術文件
    • 申請 API Key,照文中的 Node.js 範例把 3.5 Flash-Lite 串進一個小型 FAQ Bot 或報表說明工具
    • 若你在安全/DevSecOps 團隊,追蹤 DeepMind 官方關於 Flash Cyber 與 CodeMender 的開放狀態,評估未來導入到 CI/CD Pipeline