標籤: 免費 AI 工具推薦

  • 用 Whisper+Ollama 做一個本地語音助理

    用 Whisper+Ollama 做一個本地語音助理

    📌 本文重點

    • 用 Whisper+Ollama 做完全本地語音助理
    • 語音→文字→LLM→語音的完整閉環
    • 30 分鐘內跑起最小可行版本
    • 資料與聲音全留在自己機器上

    一句話就能叫得動電腦,而你的聲音和資料完全留在自己機器上,這就是用 Whisper+Ollama 做本地語音助理要解決的問題。

    參考原文:Build a Fully Local Voice Assistant With Whisper and Ollama(Towards AI)
    https://pub.towardsai.net/build-a-fully-local-voice-assistant-with-whisper-and-ollama-e5e6f713a220


    核心架構:一句話進,AI 一句話回

    這個本地語音助理由三塊組成:

    1. Whisper:把「語音 → 文字」(Speech-to-Text)
    2. Ollama + 本地 LLM:負責理解與生成文字回應
    3. 任一 TTS(Text-to-Speech):把「文字 → 語音」再念出來

    整體流程:

    1. 按快捷鍵開始錄音
    2. Whisper 辨識成文字指令
    3. 文字送到本地 LLM(透過 Ollama)推理
    4. 回傳文字答案,再由 TTS 念出

    💡 關鍵: Whisper+Ollama+TTS 組成「完全本地、無需雲端」的語音互動閉環。

    下文會先講三個核心功能,再看哪些人適合用,最後給一個可以在 30 分鐘內跑起來的最小範例。


    核心功能:你可以用聲音做什麼

    1. 聲控指令:一句話叫電腦做事

    你可以用自然語言下達指令,背後由 LLM 把「人話」轉成實際操作(shell 指令、API 呼叫或執行特定程式)。

    可做的事例如:

    • 「幫我開啟 VS Code 並打開 project 資料夾」
    • 「開始錄音會議,結束時幫我整理重點」
    • 「幫我查今天的天氣,再念給我聽」

    實作上,你可以:

    • 在 LLM 回應中約定一個格式,例如輸出 {"action": "open_app", "target": "VSCode"}
    • 程式解析 JSON,對應到不同的系統操作(Python 用 subprocess、Node 用 child_process)

    2. 問答與解說:本地 ChatGPT,用嘴巴問

    Ollama 支援多種本地模型(如 Llama、Qwen),你可以當成「只在本地跑的 ChatGPT」:

    • 「用白話講一次這段程式在做什麼」
    • 「幫我設計一個 3 天東京行程,預算一天 5000 台幣」
    • 「這篇英文信幫我改寫得更禮貌」

    如果你在意隱私(公司機密、未發表研究),這類內容只會停留在你的機器,不會上雲端。

    💡 關鍵: 對隱私敏感的程式碼、文件與會議內容,都可以在本地模型中處理而不外流。

    3. 筆記與總結:會議錄完直接變摘要

    結合 Whisper 長錄音能力,你可以:

    • 開會時一直錄音,會後自動產出:
    • 決議事項
    • 待辦清單
    • 各參與者的責任分工
    • 學習影片邊聽邊錄,最後生成「重點整理 + 閱讀筆記」

    做法:

    1. 持續錄音,分段送 Whisper 辨識
    2. 把完整文字餵給 LLM,提示詞(prompt)中要求輸出特定格式:例如「請用 5 點整理會議重點,並列出行動項目」

    適合誰用:具體場景示例

    1. 常開線上會議的知識工作者

    使用方式:

    • 開會前按快捷鍵啟動錄音
    • 會議中不必手寫紀錄
    • 開完會輸出「摘要+待辦」,貼回 Notion / Obsidian

    好處:

    • 不用依賴雲端錄音服務
    • 內部機密內容留在公司內網或個人電腦

    2. 開發者的語音 Coding 小助手

    使用方式:

    • 「幫我生成一個 Python 函數,讀取 CSV 並輸出 JSON」
    • 「這段錯誤訊息說什麼?幫我猜可能原因」
    • 「把這段程式重構成 class 寫法」

    你可以直接把 LLM 回應輸出到檔案,或搭配編輯器 API 完成簡單的自動插入。

    3. 家庭中控 / 桌面自動化

    使用方式:

    • 「關掉 Spotify,改播 YouTube 音樂」
    • 「打開家裡 NAS 的網頁介面」
    • 「查一下電價 API,現在是不是離峰」

    背後是:

    • LLM 產生要呼叫的 API 名稱 + 參數
    • 程式把它映射到實際的 REST API or Shell 指令

    工具比較:Whisper、Ollama、TTS

    名稱 核心功能 免費方案 適合誰
    Whisper 語音轉文字(STT) 開源、免費 要離線語音辨識的人
    Ollama 管理與執行本地 LLM 開源、免費 想在本地跑各種模型的人
    Coqui TTS 本地語音合成(TTS) 開源、免費 想客製化聲音的開發者
    pyttsx3 / edge-tts 簡單 TTS,快速上手 免費 只要能聽到回應即可的人

    Whisper GitHub:https://github.com/openai/whisper
    Ollama 官網:https://ollama.com


    怎麼開始:30 分鐘跑起一個最小版本

    下面以 Python+Whisper+Ollama+簡單 TTS 為例,目標是做到:

    按快捷鍵 → 說話 → AI 在本地回答並念出來

    💡 關鍵: 只要有 8GB RAM 和 Python 環境,大多數電腦在約 30 分鐘內就能完成這套本地語音助理的基本版。

    1. 最小硬體與環境需求

    • 作業系統:macOS / Linux / Windows(建議 10 以上)
    • RAM:至少 8 GB(12–16 GB 更順)
    • GPU:有當然更快,沒有也可跑小模型
    • Python 3.10+(或 Node 也可以,本文用 Python)

    2. 安裝 Ollama 與模型

    1. 到 https://ollama.com 下載並安裝
    2. 開啟終端機,拉一個小模型(例如 llama3.2 或 qwen2.5):
    ollama pull llama3.2
    # 或
    ollama pull qwen2.5
    
    1. 測試一次:
    ollama run llama3.2
    

    能對話就表示後面 Python 可以直接透過 HTTP 使用它。

    3. 安裝 Whisper 與 TTS

    建立虛擬環境(可選,但建議):

    python -m venv venv
    source venv/bin/activate  # Windows: venv\Scripts\activate
    

    安裝必要套件:

    pip install openai-whisper sounddevice numpy requests pyttsx3
    

    說明:

    • openai-whisper:Whisper STT
    • sounddevice:錄音
    • pyttsx3:離線 TTS(Windows/macOS/Linux 都可用)
    • requests:呼叫 Ollama HTTP API

    4. 最小可行 main.py

    下面是一個簡化範例:按 Enter 開始錄音,Ctrl+C 結束程式。你可以之後再綁定系統快捷鍵(如 AutoHotkey、Karabiner)。

    import sounddevice as sd
    import numpy as np
    import whisper
    import requests
    import pyttsx3
    
    MODEL_NAME = "llama3.2"  # 或改成 "qwen2.5" 等你已拉下的模型
    OLLAMA_URL = "http://localhost:11434/api/generate"
    
    whisper_model = whisper.load_model("small")  # 可換 tiny / base / small / medium
    engine = pyttsx3.init()
    
    SAMPLE_RATE = 16000
    DURATION = 5  # 錄音秒數,可改成你想要的
    
    
    def record_audio(duration=DURATION):
        print("開始錄音,請說話...")
        audio = sd.rec(int(duration * SAMPLE_RATE), samplerate=SAMPLE_RATE, channels=1)
        sd.wait()
        print("錄音結束")
        return np.squeeze(audio)
    
    
    def speech_to_text(audio):
        print("正在轉文字...")
        result = whisper_model.transcribe(audio, fp16=False)
        text = result["text"].strip()
        print(f"你說:{text}")
        return text
    
    
    def call_ollama(prompt):
        print("正在思考...")
        resp = requests.post(
            OLLAMA_URL,
            json={"model": MODEL_NAME, "prompt": prompt},
            stream=False,
        )
        data = resp.json()
        answer = data.get("response", "")
        print(f"AI:{answer}")
        return answer
    
    
    def speak(text):
        engine.say(text)
        engine.runAndWait()
    
    
    if __name__ == "__main__":
        try:
            while True:
                input("按 Enter 開始錄音(Ctrl+C 結束):")
                audio = record_audio()
                text = speech_to_text(audio)
                if not text:
                    continue
                answer = call_ollama(text)
                speak(answer)
        except KeyboardInterrupt:
            print("\n結束程式")
    

    執行:

    python main.py
    

    流程:

    1. 按 Enter → 錄音 5 秒
    2. Whisper 轉文字 → 顯示你說的話
    3. 文字送到 Ollama → LLM 回答
    4. pyttsx3 把文字念出來

    你已經完成一個基本版「本地語音 ChatGPT」。接下來就可以:

    • 把錄音時間改成動態(按住鍵才錄)
    • 在 call_ollama 的 prompt 中加入系統指令,例如:「你是一個會輸出 JSON 指令的系統助手」
    • 在 answer 中解析 JSON,呼叫不同的系統功能

    換成本地 Qwen、Llama 模型與低配機調整建議

    換模型:Qwen、Llama 等

    Ollama 已經預設支援多個模型,換模型只要:

    1. 先拉模型:
    ollama pull qwen2.5
    ollama pull llama3.1
    
    1. 把 MODEL_NAME 改成相對應名稱,例如:
    MODEL_NAME = "qwen2.5"
    # 或
    MODEL_NAME = "llama3.1"
    
    1. 重新執行 main.py 即可。

    低配機(8GB RAM / 無 GPU)調優建議

    • Whisper 模型:改用 tiny 或 base:
      python
      whisper_model = whisper.load_model("tiny")
    • LLM 模型:優先選擇 *-mini 或 3B 以內的小模型(例如 llama3.2 small 版)
    • TTS:選 pyttsx3 這種輕量離線 TTS,避免重型神經網路 TTS
    • 錄音長度:縮短單次錄音(例如 3–5 秒),減少 STT 負載
    • 批次模式:需要長會議紀錄時,可先用系統錄音軟體錄整段,之後分段丟給 Whisper 處理

    總結:把「叫電腦做事」變成一句話

    你現在已經有一套可以在本地跑的語音助理:

    • Whisper 負責聽懂你說什麼
    • Ollama+本地模型負責思考與生成回應
    • TTS 負責把答案念出來

    從這個最小版本開始,你可以一步步加上:「控制應用程式」、「呼叫 API」、「自動整理會議紀錄」,最後變成一個完全客製化的本地語音中控系統。

    🚀 你現在可以做的事

    • 安裝 Ollama 並拉下 llama3.2 或 qwen2.5 模型,在終端測試對話
    • 建立 Python 虛擬環境,安裝 openai-whisper、sounddevice、pyttsx3 等套件後跑起 main.py
    • 改寫 call_ollama 部分,讓回應輸出 JSON 指令,開始用語音控制你的桌面或 API
  • 用 AVA 自架語音總機

    用 AVA 自架語音總機

    📌 本文重點

    • AVA 可直接接在既有 Asterisk/FreePBX 上
    • 先用雲端 STT/LLM/TTS 做 PoC 再考慮本地化
    • 適合中小企業與研發團隊快速測試語音 AI 總機

    AVA 是一套能接在 Asterisk/FreePBX 上的開源語音客服引擎,讓你不用買 SaaS,也能自己搭一個會接電話、回答問題、轉分機的 AI 總機。

    想先看專案,可直接開 AVA GitHub。如果你手上已經有 FreePBX,這類型工具最實際的價值不是「聊天」,而是把既有電話流量接進 STT、LLM、TTS 流程,先做出可測的 PoC,再決定要不要擴到正式客服。


    核心功能

    1. 直接接進 Asterisk,不用重做整套電話系統

    AVA 的架構很直白:Asterisk 用原生 Audiosocket 或 RTP 收到來電,把音訊送到 Python 引擎;Python 再依序呼叫語音轉文字(STT)、大型語言模型(LLM)、文字轉語音(TTS),最後把回覆送回通話。

    這代表你可以保留現有 SIP、分機、IVR 與 FreePBX 管理介面,只替換「講話的那一段」。

    2. 雲端模型先上線,本地模型後續再換

    AVA 內建支援 OpenAI、Gemini、Grok、ElevenLabs,也能自訂 STT/LLM/TTS 組合。最快的做法是先用雲端 API 跑第一版,例如 OpenAI 做 STT+LLM、ElevenLabs 做 TTS;如果後續遇到隱私或成本問題,再改成本地模型。

    💡 關鍵: 先用雲端組合上線 PoC,再視隱私與成本需求改成本地模型,是風險最低的導入路徑。

    官方也提到,若有 25GB 以上 GPU,可走全本地即時語音代理。

    3. 適合做可控腳本,不只自由聊天

    電話客服的重點不是模型多聰明,而是流程穩不穩。AVA 適合把提示詞、FAQ、分機規則、營業時間、留言流程都寫成明確腳本,例如:

    • 「辨識來意後轉接 201 業務部」
    • 「下班時間改成留言並發通知」

    先把流程規則化,測試會比直接放任模型自由發揮穩很多。


    適合誰用

    如果你是中小企業 IT、SI、通訊整合商,手上已有 Asterisk 或 FreePBX,AVA 很適合拿來做低成本 PoC:一台伺服器、一組 API key、幾個分機規則,就能讓公司總機先有基本問答與轉接能力。

    💡 關鍵: 利用現有 Asterisk/FreePBX,只要加一台伺服器與一組 API key,就能快速驗證語音 AI 總機可行性。

    如果你是實驗室或研發團隊,AVA 的價值在於可替換性。你可以先用雲端模型驗證流程,再逐步把 STT、LLM、TTS 換成本地推論,測試隱私保護、工具呼叫、資料落地等需求。

    這比直接綁定單一 SaaS 平台更容易控制。

    下面這組搭配最適合先做測試:

    名稱 核心功能 免費方案 適合誰
    AVA 串接 Asterisk 的語音代理框架 開源免費 要自架語音客服的人
    OpenAI / Gemini / Grok STT、LLM 問答 多數為試用額度或按量計費 想最快上線 PoC 的團隊
    ElevenLabs 高品質英文與多語 TTS 有試用額度 重視語音自然度的客服場景

    怎麼開始

    最快路徑是用 Docker 把 AVA 部署在一台 Linux 伺服器,並接到現有 FreePBX。實作上可照這個順序做:

    1. 準備一台可連到 Asterisk 的伺服器,先安裝 Docker。
    2. 從 AVA GitHub 依範例啟動容器,填入 OpenAI 或 Gemini、ElevenLabs 的 API key。
    3. 在 FreePBX 建一個測試路由,讓指定 DID 或分機把來電導到 Audiosocket/RTP 對應的 AVA 服務。
    4. 先只做一個簡單腳本:自我介紹、詢問需求、依關鍵字轉接分機或播放 FAQ。
    5. 拿真實電話測試 20 到 30 通,記錄辨識錯誤、等待時間與轉接成功率,再調提示詞。

    💡 關鍵: 先用 20–30 通真實來電測試腳本與提示詞,比盲目擴大量更能看出系統穩定度與實用性。

    你可以先做兩個最有感的場景。

    第一個是公司語音 IVR:例如「按 1 找業務」改成自然語音,來電者直接說「我要報價」就轉接業務分機,同時能回答地址、營業時間、付款方式。

    第二個是 24 小時留言與簡單 FAQ:下班後由 AI 先接聽,回答常見問題,必要時收姓名、電話、需求摘要,再寄送到信箱或寫入工單。


    成本與進階玩法

    PoC 階段最主要的成本是語音與模型 API,用量低時通常比買整套 SaaS 便宜,尤其你已經有 Asterisk 時更明顯;但一旦通話量大,TTS 與即時 LLM 成本會開始浮現,所以建議先限制場景,只做總機問答、留言與分流。

    如果你有隱私要求,下一步就是把部分流程換成本地模型:例如本地 STT、本地 LLM,只把 TTS 留在雲端,或直接全本地化。

    另一個值得做的進階項目是客製對話腳本,把「業務、客服、總務」拆成不同代理,分別設定提示詞、FAQ 和轉接規則,測試效果會比單一通用客服更好。

    對已經有電話系統的團隊來說,AVA 最實際的切入點不是一次取代客服,而是先把一條來電流程自動化,讓你用自己的基礎設施,快速驗證語音 AI 到底能不能真正接電話。

    🚀 你現在可以做的事

    • 打開 AVA GitHub 專案頁,閱讀 README 並確認環境需求
    • 在現有 FreePBX 上規劃一條測試路由,準備 1 個具代表性的來電場景腳本
    • 申請 OpenAI/Gemini 與 ElevenLabs 的 API key,實作一個 20–30 通的 PoC 測試流程
  • Flint:讓 AI 也畫得出專業圖表

    Flint:讓 AI 也畫得出專業圖表

    📌 本文重點

    • Flint 讓 LLM 用簡單 JSON 就能畫出專業圖表
    • 透過中介視覺語言,把美觀與排版細節交給 Flint
    • 搭配 Data Formulator/MCP,可在多種場景自動出圖

    多數 LLM 雖然會「描述圖」,卻很難畫出乾淨、專業、可維護的圖表,Flint 就是專門幫 AI 接手這段「從文字到好圖」的工作。


    為什麼一般 LLM 畫圖總是歪掉?

    如果你用過 LLM 直接輸出 Vega-Lite、ECharts、Matplotlib,大概遇過這些情況:

    • 圖是畫出來了,但:
    • 顏色、比例亂選,看起來很業餘
    • 標軸標籤打錯、重疊、或被擠出畫面
    • 圖例、格線沒有依照人類習慣排版
    • 為了避免出錯,只敢給 LLM 很簡單的設定 → 圖表品質又退回系統預設
    • 一旦你說「把折線圖改成雙軸圖,多加一條移動平均」,整段 spec 幾乎要重寫

    Flint 的切入點是:不是 LLM 太笨,而是現有圖表語言太「底層」,逼模型做太多視覺細節決策。Flint 改成「中介視覺語言 + 自動排版引擎」,讓 LLM 只說高階意圖,低階美觀細節交給 Flint。

    💡 關鍵: Flint 把圖表設計拆成高階意圖與低階排版,讓 LLM 專心決策「畫什麼」,而 Flint 負責「怎麼畫得好看」。


    核心功能:Flint 幫 AI 補完「設計力」

    1. 中介視覺語言:LLM 只需要說人話版的圖表需求

    Flint 把圖表拆成幾個高階概念:

    • data: 用哪些欄位
    • mapping: 哪個欄位對應到 x、y、顏色、大小
    • mark: 用折線、長條、區域等標記
    • layout & style: 留給 Flint 自動排版與預設樣式

    LLM 只要輸出一份簡潔的 JSON,Flint 會負責:

    • 均衡配色
    • 合理的軸刻度、標籤格式
    • 避免文字重疊、圖例遮擋

    你可以做的事:在自己的 LLM 工具裡,把「請幫我生出完整 ECharts/Vega spec」改成「請輸出 Flint JSON」,再由後端把 Flint JSON 丟給 Flint 編譯成最終圖表。

    2. 與 Data Formulator 深度整合:圖表可以點一點改

    Data Formulator 是微軟另一個開源專案,可以視覺化地編輯 Flint 圖表:

    • 左邊是資料表
    • 中間是圖表
    • 右邊是 Flint 規格(JSON)

    你可以:

    • 讓 LLM 先產出 Flint 規格
    • 使用者在 Data Formulator 裡微調(拖拉欄位、改顏色)
    • 再把調整後的 Flint JSON 存回系統 → 變成可持久化的「報表模版」

    你可以做的事:把 Data Formulator 部署在內網,給資料分析團隊當「AI 生成初版圖表,人手最後調整」的工作台。

    3. MCP 伺服器:任何 Agent 都能叫 Flint 畫圖

    Flint 官方提供了符合 Model Context Protocol (MCP) 的伺服器,意思是:

    • 你用哪一家的 LLM / Agent 幾乎都不重要
    • 只要支援 MCP,就能把 Flint 當成「畫圖工具」來呼叫

    流程通常是:

    1. Agent 讀取你給的資料
    2. Agent 生成 Flint JSON
    3. 呼叫 Flint MCP 伺服器 → 回傳可嵌入網頁的圖表(或 Vega spec 等)

    你可以做的事:在自家 Agent(如 OpenAI, Claude, 自建 Llama)中,註冊 Flint MCP 工具,讓 Agent 回答問題時順手出圖,而不是只給一長段文字分析。


    適合誰用?三個具體場景

    1. 資料分析報告自動出圖

    情境:你每週要交「流量報告」、「營收報表」,但每次調整維度、時間區間都得重畫圖。

    用法:

    • 把數據放在資料庫或 CSV
    • 讓 LLM 讀取後,產出 Flint JSON
    • Flint 編譯成固定風格的圖,嵌入到報告模板(Notion、Confluence、內部系統)

    可行操作:

    • 建立一個簡單的 HTTP 服務 /generate-chart:
    • 輸入:分析問題 + 資料表名稱
    • 中間:LLM → Flint JSON → Flint 編譯
    • 輸出:圖表 URL 或 HTML Snippet

    💡 關鍵: 用 /generate-chart 這類服務,把「問問題 → 自動出圖」變成標準流程,可大幅減少手動報表製作時間。

    2. 內部 BI 助理

    情境:同事問「上個月付費轉換率怎麼樣?」,你不想每次都打開 Power BI 重拉圖。

    用法:

    • 建立一個聊天機器人(Slack / Teams / Line)
    • 後端讓 Bot 可以:
    • 查詢資料庫
    • 呼叫 LLM 產生 Flint JSON
    • 用 Flint 生成圖,回傳為圖片或互動式圖表連結

    可行操作:

    • 在 Bot 指令中加入:/chart 近三個月 活躍用戶 與 付費人數
    • Bot 回覆一張趨勢折線圖,並附上描述文字

    3. 技術文件中的動態圖表

    情境:你寫 SDK / API 文件,需要展示效能、流量、版本差異,數據常更新。

    用法:

    • 文檔系統只存「Flint JSON + 資料來源」
    • 每次讀者開啟頁面,後端動態用 Flint 產生最新圖表

    可行操作:

    • 在 docs 中嵌入一個 <iframe src="/docs/charts/latency">
    • 這個 endpoint 背後:查資料 → Flint render → 回傳 SVG / PNG

    實際長什麼樣?Flint JSON 範例

    以下是一個最小可用的 Flint 規格,畫出「每月營收折線圖」:

    {
      "data": {
        "fields": [
          { "name": "month", "type": "temporal" },
          { "name": "revenue", "type": "quantitative" }
        ],
        "values": [
          { "month": "2024-01", "revenue": 120000 },
          { "month": "2024-02", "revenue": 135000 },
          { "month": "2024-03", "revenue": 128000 }
        ]
      },
      "mark": "line",
      "encoding": {
        "x": { "field": "month", "type": "temporal" },
        "y": { "field": "revenue", "type": "quantitative" }
      },
      "title": "2024 Q1 每月營收"
    }
    

    LLM 只要穩定產出這樣結構清楚、語意正確的 JSON,Flint 就會幫你做出排版乾淨的圖,之後你想改顏色、字型、軸設定,都可以在 Data Formulator 介面上調整。


    怎麼開始?30 分鐘內畫出第一張 AI 圖

    1. 部署 Flint:本機或雲端

    官方文件與 Demo:https://microsoft.github.io/flint-chart/#/

    本機(開發測試)

    1. 安裝 Node.js(建議 18+)
    2. Clone 專案:
      bash
      git clone https://github.com/microsoft/flint-chart.git
      cd flint-chart
    3. 安裝依賴並啟動示例:
      bash
      npm install
      npm run dev
    4. 瀏覽器打開 http://localhost:5173,可以看到範例圖表與 Flint Spec。

    雲端部署(給團隊用)

    • 打包為 Docker image(視官方 repo 指引)
    • 部署在自家 Kubernetes / VM 上,對外提供 REST API:
    • POST /render → 輸入 Flint JSON,回傳圖表

    2. 使用現成範例,串接任一主流 LLM / Agent

    基本流程:

    1. 在後端寫一個函式 askLLMForFlintSpec(prompt, data_schema)
    2. 提示詞約束:
    3. 請只輸出 JSON,不要加解釋文字
    4. JSON 結構遵守 Flint Spec(可把官方 schema 一併塞進 system prompt)
    5. 把 LLM 回傳的 Flint JSON 送到 Flint API:
    import requests, json
    
    flint_spec = llm_generate_flint_spec(user_query, data_schema)
    res = requests.post(
        "http://localhost:8000/render",
        json={"spec": flint_spec}
    )
    with open("chart.svg", "wb") as f:
        f.write(res.content)
    
    1. 前端直接顯示 chart.svg,或轉 PNG 給報告系統使用。

    3. MCP 整合:丟給你的 Agent 用

    若你使用支援 MCP 的 Agent(例如部分新一代 IDE 助理、Agent Framework),步驟大致是:

    1. 啟動 Flint MCP server(依官方 repo 指示)
    2. 在 Agent 設定檔中註冊 Flint MCP endpoint
    3. 在系統提示詞中說清楚:
    4. 何時該呼叫 Flint(遇到需要圖表的問題)
    5. 如何構造 Flint JSON

    完成後,你就可以在對話中自然問:「幫我畫一張 2024 各季度營收與毛利率的組合圖」,讓 Agent 自行決定查數據、生成 Flint JSON、再回傳圖表。


    Flint 與其他「讓 AI 變強」工具怎麼搭配?

    下面用一個表快速對比本文提到的工具角色:

    名稱 核心功能 免費方案 適合誰
    Flint 中介視覺語言,幫 LLM 生高品質圖表 開源 需要報表 / 圖表自動化的開發者
    Data Formulator 可視化編輯 Flint 圖表的前端工具 開源 想在瀏覽器調整 AI 圖表的資料分析師
    VisionBridge1 讓純文字 LLM 具備視覺理解能力的代理 開源 想給本地 LLM 加上看圖能力的開發者

    你可以把它們組成一條完整流水線:VisionBridge 提供「看圖」能力、LLM 做推理與產生 Flint JSON、Flint+Data Formulator 負責「畫好圖」與人類微調。


    結語:先讓 AI「畫得出像樣的圖」再談自動化報表

    如果你已經在用 LLM 做資料分析、寫 BI 查詢,下一步就是讓結果不是只停在文字。Flint 幫你用很低的開發成本,把「專業圖表」變成 AI 回答的一部分,而且保留 JSON 規格,後續要改樣式、改資料源,都能持續演進。

    最實際的建議:花 30 分鐘跑起官方 Demo,拿文中的範例 JSON 改成自己的資料,先做出第一張「AI 自動生成、你看得順眼、同事也改得動」的圖表,再來思考要怎麼把它嵌進你的報表、內部工具或 Agent 流程裡。

    🚀 你現在可以做的事

    • 打開 https://microsoft.github.io/flint-chart/#/,跑起官方 Demo 並試著改用自己的資料
    • 在後端實作一個簡單的 /generate-chart 服務,讓 LLM 產生 Flint JSON 再交給 Flint 渲染
    • 部署 Data Formulator,讓資料分析同事用瀏覽器微調 LLM 生成的 Flint 圖表並存成報表模版
  • OmniRoute:一個 Endpoint 玩遍 200+ 模型

    OmniRoute:一個 Endpoint 玩遍 200+ 模型

    📌 本文重點

    • OmniRoute 用一個 Endpoint 串接 200+ 模型供應商
    • 內建 RTK + Caveman 壓縮,可節省 15–95% token 成本
    • 支援 MCP / A2A、多代理、多模態 Workflow
    • 適合多模型整合與成本優化的開發者

    用一句話先說清楚:OmniRoute 是一個多雲、多模型的一站式 AI 總機,讓你用同一個 API Endpoint,同時接上 Claude、GPT、Cursor、Copilot 等 200+ 家模型供應商,還順手幫你壓縮 token、自動跳備援模型。

    官方開源庫:https://github.com/diegosouzapw/OmniRoute


    核心功能 1:一個 Endpoint 管理多供應商+自動備援

    傳統做法是:每接一個模型,就要再接一個 SDK / API Key / Base URL。結果是:

    • 前端要切換模型,就得改環境變數
    • 後端要做 fallback,要自己寫 retry + 陣痛的錯誤處理

    OmniRoute 的做法是:所有模型統一走一個 OmniRoute Endpoint,後面怎麼分流、切換供應商、失敗改用誰,全都在 OmniRoute 的設定檔完成。

    💡 關鍵: 把所有模型統一進一個 Endpoint,可以一次解決多家供應商整合與備援問題,前後端只維護單一接點。

    你可以怎麼用

    以「同一個 Code Agent,要能在 Claude / GPT / 本地模型之間切換」為例:

    1. 在 OmniRoute 設定三個 provider:
    2. anthropic/claude-3.5(主力)
    3. openai/gpt-4.1(備援)
    4. local/deepseek(成本最低版)
    5. 設定路由策略:
    6. 主 Endpoint:先走 Claude
    7. 當 Claude timeout 或額度用完,自動 fallback 到 GPT
    8. 夜間批量任務改走本地模型
    9. 在你的程式碼中,只保留一個 OMNIROUTE_API_URL:

    ts
    const response = await fetch(process.env.OMNIROUTE_API_URL, {
    method: "POST",
    headers: {
    "Content-Type": "application/json",
    "Authorization": `Bearer ${process.env.OMNIROUTE_API_KEY}`,
    },
    body: JSON.stringify({
    model: "code-agent", // 這是 OmniRoute 裡定義的邏輯模型名
    messages,
    }),
    });

    可行動建議:

    • 手上的專案如果同時接了 Anthropic + OpenAI + 本地模型,可以先挑一個 API Call 練手,把三個 Base URL 改成一個 OmniRoute URL,測試 auto-fallback 是否生效。

    核心功能 2:RTK + Caveman 壓縮,節省 15–95% token 成本

    OmniRoute 內建兩種壓縮:

    • RTK(Reversible Tokenization Kernel):對常見 prompt 做結構化壓縮,適合長系統提示、多輪聊天歷史
    • Caveman 壓縮:偏「野蠻」但更激進,會重寫聊天記錄,把冗長表述變成精簡語句

    效果:

    • 系統長 prompt:省 15–40% token
    • 帶大量上下文(如文檔 QA):最高可到 95% token 減少

    💡 關鍵: 啟用 RTK 與 Caveman 壓縮後,長上下文任務可大幅降低 15–95% token 成本,直接反映在帳單與模型限額上。

    你可以怎麼用

    以「把整份 API 文檔塞給模型當『長期記憶』」為例:

    1. 在 OmniRoute 後台或設定檔,為 doc-assistant 這條路由開啟壓縮:

    yaml
    routes:
    - id: doc-assistant
    model: anthropic/claude-3.5
    compression:
    rtk: true
    caveman: true

    1. 程式端依然用原本的 messages 結構呼叫,不用自己壓縮:

    jsonc
    {
    "model": "doc-assistant",
    "messages": [
    {"role": "system", "content": "你是某某專案的文檔助手..."},
    {"role": "user", "content": "請根據附件 API 文檔..."}
    ]
    }

    1. OmniRoute 會在轉給底層模型前自動壓縮,再在輸出時解壓(對你來說是透明的)。

    可行動建議:

    • 先挑「最長」的那支 API(例如:聊天歷史超長、帶多篇 PDF 的 QA),在 OmniRoute 上開 RTK+獵人模式(Caveman),觀察一次請求的 token 使用量與帳單變化。

    核心功能 3:MCP / A2A、多代理、多模態 Workflow

    OmniRoute 支援:

    • MCP(Model Context Protocol):讓不同工具 / 代理共享同一套上下文與工具列表
    • A2A(Agent-to-Agent):代理之間可互相呼叫,形成多步驟協作
    • 多模態 API:文字 + 圖片(甚至影音)混合輸入

    這讓你可以把原本散落在不同工具的能力,集中到一條 Workflow 裡。例如:

    • Code Agent 負責寫程式
    • Doc Agent 負責查文件、對比版本
    • Vision Agent 負責讀錯誤截圖

    💡 關鍵: 利用 MCP 與 A2A,可以把多個專職 Agent 串成一條 Workflow,讓 Code、Doc、Vision 等能力在同一上下文中協作。

    你可以怎麼用

    以「Side Project 的 Code Agent + 文檔助手」為例:

    • Code Agent:
    • 模型:Claude 3.5 Sonnet
    • 任務:生成程式碼、重構
    • 文檔助手:
    • 模型:GPT-4.1 / Gemini
    • 任務:閱讀 API 文檔、產生說明
    • 多模態:
    • 模型:如 Gemini / GPT-4o
    • 任務:讀錯誤截圖

    在 OmniRoute 裡定義三條路由,讓 Code Agent 能直接「轉接」給 Doc Agent:

    routes:
      - id: code-agent
        model: anthropic/claude-3.5
        a2a:
          doc-agent: true
          vision-agent: true
      - id: doc-agent
        model: openai/gpt-4.1
      - id: vision-agent
        model: google/gemini-1.5
    

    可行動建議:

    • 先只做兩個代理(Code + Doc),在 OmniRoute 設定 A2A,讓 Code Agent 遇到「不知道 API 用法」時,把問題轉給 Doc Agent,再把結果回傳給使用者。

    實作示範:Side Project 串三家模型的 Code Agent + 文檔助手

    來做一個具體場景:

    需求:在同一個 Side Project 裡,整合三家模型,做一個簡單的「程式碼助理 + 文檔助手」,前端只有一個 Chat UI,後端只有一個 OmniRoute Endpoint。

    架構示意

    • 前端(Next.js / React):
    • 單一聊天框
    • 輸入模式按鈕:寫程式 / 問文檔
    • 後端:
    • 全部請求送到 OMNIROUTE_URL
    • model 欄位用來指定走哪個 logical route(code-agent or doc-assistant)
    • OmniRoute:
    • code-agent → Claude(主)+ GPT(備)
    • doc-assistant → GPT + Caveman 壓縮
    • vision-agent → Gemini,多模態

    前端呼叫範例(TypeScript):

    async function callAgent(mode: "code" | "doc", messages) {
      const model = mode === "code" ? "code-agent" : "doc-assistant";
    
      const resp = await fetch(process.env.NEXT_PUBLIC_OMNIROUTE_URL!, {
        method: "POST",
        headers: {
          "Content-Type": "application/json",
          Authorization: `Bearer ${process.env.NEXT_PUBLIC_OMNIROUTE_KEY}`,
        },
        body: JSON.stringify({ model, messages }),
      });
    
      return resp.json();
    }
    

    後端與前端都不用知道「底下到底是 Claude 還是 GPT」,只認 model: "code-agent" 與 model: "doc-assistant" 兩種邏輯角色即可。


    10 分鐘開箱:從零到第一條 OmniRoute

    以下是一條「最短路徑」,讓你在 10 分鐘內把現有專案換成 OmniRoute。

    1. 註冊與安裝(3 分鐘)

    1. 打開 GitHub 專案:https://github.com/diegosouzapw/OmniRoute
    2. 把 repo 拉下來:

    bash
    git clone https://github.com/diegosouzapw/OmniRoute
    cd OmniRoute
    pnpm install # 或 yarn / npm

    1. 照 README 建一個 .env,填入你現有的 OpenAI / Anthropic 等 API Key。

    2. 啟動 OmniRoute Server(2 分鐘)

    pnpm dev # 或對應的 start 指令
    

    啟動後會有一個本地 URL,例如:http://localhost:8787/v1/chat/completions,這就是你的「總機 Endpoint」。

    3. 設定第一個路由 + 壓縮策略(3 分鐘)

    在 config/routes.yaml(實際以專案為準)中:

    routes:
      - id: code-agent
        model: anthropic/claude-3.5
        fallback:
          - openai/gpt-4.1
        compression:
          rtk: true
          caveman: false
    
      - id: doc-assistant
        model: openai/gpt-4.1
        compression:
          rtk: true
          caveman: true
    

    完成後重新啟動 OmniRoute(若需要)。

    4. 把前端 / 後端改成單一 OmniRoute URL(2 分鐘)

    無論你原本用什麼 SDK(OpenAI, Anthropic, Cursor plugin):

    • 把 baseURL 改成你的 OMNIROUTE_URL
    • 把 model 改成 OmniRoute 裡定義的 id(例如 code-agent)

    以 OpenAI SDK 為例:

    import OpenAI from "openai";
    
    const client = new OpenAI({
      baseURL: process.env.OMNIROUTE_URL,
      apiKey: process.env.OMNIROUTE_KEY,
    });
    
    await client.chat.completions.create({
      model: "code-agent",
      messages,
    });
    

    到這一步,你已經:

    • 用一個 Endpoint 串起至少兩家模型
    • 開啟 basic 的 token 壓縮
    • 為之後加上更多 provider / 代理 / 模態預留位置

    適合誰用?

    使用者類型 具體場景
    獨立開發者 Side Project 同時想用 Claude + GPT + 免費模型,又懶得寫一堆整合
    小團隊 / Startups 想 A/B 測試不同供應商,控制成本,還要有 auto-fallback 防止掛點
    AI Agent Builder 需要多代理協作(Code + Doc + Vision),又希望前端只接一個 Endpoint
    教學 / 實驗環境 需要一鍵切換教學用模型、控制學生 token 使用量

    如果你符合其中一項,可以先把 OmniRoute 當成:

    「把所有 AI 模型集中管理的一支 API Gateway」,再視需要逐步開啟壓縮、A2A、多模態。


    OmniRoute 與其他多模型工具比較

    名稱 核心功能 免費方案 適合誰
    OmniRoute 多供應商整合、auto-fallback、RTK/Caveman 壓縮、MCP/A2A、多模態 開源,支援 50+ 免費供應商 想統一管理多家模型、做複雜 Workflow 的開發者
    直接用 OpenAI 單供應商模型 API 有免費試用額度 只用 GPT 系列、需求簡單的專案
    直接用 Anthropic 單供應商 Claude 模型 有免費試用額度 只想專注 Claude Code / Sonnet

    如果你只接一個模型供應商,OmniRoute 可以先當「統一壓縮 + 路由層」;當你的模型越來越多,它就自然變成你的多雲總機。


    🚀 你現在可以做的事

    • 打開 OmniRoute GitHub 專案,依照 README 在本地啟動一個測試伺服器
    • 挑一支現有的 API 呼叫,將 baseURL 改成 OMNIROUTE_URL,並在 routes.yaml 設好對應的 model id
    • 在同一條路由上開啟 RTK 或 Caveman 壓縮,對比啟用前後的 token 使用量與費用差異
  • 讓費曼幫你開會:高智議會實戰

    讓費曼幫你開會:高智議會實戰

    📌 本文重點

    • 18 位 AI 專家人格協作,幫你拆解困難決策
    • 支援多家 LLM,多模型協同辯論與決策
    • 結構化多輪會議流程,適合產品、工程與職涯抉擇
    • 10 分鐘內可在本機跑起第一個 /council

    一句話定位:Council of High Intelligence 是一個「多人格、多模型的開源決策助手」,讓亞里斯多德、費曼、卡尼曼、Torvalds 等 18 位 AI 專家分工辯論,幫你把困難決策拆開分析。

    GitHub 專案連結:https://github.com/0xNyk/council-of-high-intelligence


    核心功能:它到底幫你做什麼?

    1. 18 位 AI 專家人格,替你「開會」

    這個專案內建 18 個 AI persona,例如:

    • 費曼:擅長把複雜問題拆小,用白話解釋
    • 卡尼曼:偏向風險、決策偏誤、心理學角度
    • Torvalds:工程實作與系統設計視角
    • 亞里斯多德:偏向邏輯與倫理推理

    💡 關鍵: 18 位專家人格讓同一個問題從多角度被拆解與辯論,比單一模型更接近真實開會決策。

    你只需要:

    1. 想好你要決策的問題(例如:「我要選哪個前端框架?」)
    2. 用一行指令 /council + 問題
    3. 看不同人格怎麼辯論、反駁、收斂結論

    可行動點:先在腦中列出你最近最卡的一個決策,用一句話描述,等會在「怎麼開始」裡直接拿來當第一條指令。


    2. 多家 LLM 供應商,真正「多模型」討論

    官方描述:

    18 AI personas deliberate your hardest decisions across multiple LLM providers.

    意思是:你可以把不同角色綁到不同家模型,例如:

    • 深度推理角色 → 使用 OpenAI / Claude / DeepSeek
    • 技術細節角色 → 使用本地 Qwen / LLaMA
    • 檢查與總結角色 → 使用另一家 API

    這樣比起「一個模型演完全部人格」,更接近多人開會:不同模型偏好不同風格、推理路線也不同。

    可行動點:先決定你要用哪幾種 LLM 來源:

    • 沒有 GPU:先用雲端(OpenAI、Anthropic、DeepSeek 等)
    • 有本地 GPU:用本地模型 + 雲端模型混用

    在 .env 裡填 API key 即可(下文會示範)。


    3. 結構化多輪討論,不是單次回答

    這不是「問一次、回一段」的聊天,而是預設有多輪辯論流程:

    1. 第一輪:各專家給出初步立場
    2. 中間:互相質疑、補充證據、提出 alternative
    3. 最後:整合成具體建議 + 原因拆解

    你可以把它想成一個腳本化的「會議流程模版」,每次 /council 就是啟動一次完整會議。

    可行動點:在準備問題時,用「決策問題」的格式描述:

    • A vs B 的選擇(框架、技術、工作)
    • 有限制條件(時間、預算、人力)
    • 希望輸出形式(表格、清單、分階段建議)

    適合誰用?三個典型場景

    💡 關鍵: 產品經理、工程師與個人職涯決策者,都可以用同一套會議流程模版,快速得到結構化建議。

    1. 產品經理:產品選型 / 路線決策

    情境:

    • 要在「先做 Web 還是先做 App」中選一個
    • 要評估「自研 vs 採用 SaaS」

    你可以這樣用:

    /council 幫我評估:我們是一個 B2B SaaS,新功能是「客戶成功儀表板」。
    選項 A:在現有產品裡做一個輕量 dashboard。
    選項 B:做成獨立子產品,單獨收費。
    
    條件:
    1. 團隊 6 人,前端 2、後端 2、產品 1、設計 1
    2. 期望 3 個月內能驗證市場
    3. 優先考慮現有客戶的 adoption 風險
    
    請從產品策略、商業模式、技術風險三個角度辯論,最後給一個推薦選項與 roadmap。
    

    行動建議:把你手上的下一個 roadmap 爭議點,寫成「A vs B + 條件」格式,直接餵給 /council。


    2. 工程師:技術方案比較 / 架構選擇

    情境:

    • 要決定「單體服務 vs 微服務」
    • 比較「使用 Rust / Go / Java 實作」

    例如:

    /council 我要設計一個高併發 API 服務, QPS 目標 5k,
    選項 A:使用 Go + Gin + Redis
    選項 B:使用 Rust + Axum + Redis
    
    約束:
    - 團隊目前主要會 Go,沒人寫過 Rust
    - 上線時間壓力大,希望 2 個月內可上線 MVP
    
    請從開發效率、長期維護成本、性能需求三個角度辯論,
    最後給出推薦技術棧與風險清單。
    

    行動建議:先把你準備寫在技術設計文檔裡的「方案對比」,丟給高智議會,看看它會怎麼拆解風險與權衡因素。


    3. 個人:職涯抉擇 / 學習路線

    情境:

    • 「要不要跳槽?」
    • 「要走管理還是繼續寫程式?」

    使用示例:

    /council 我現在是一名 5 年資歷的後端工程師,
    手上有兩個選擇:
    A:留在現在公司,穩定但成長有限
    B:加入一間早期 AI 新創,薪水略高但不確定性大
    
    條件:
    - 已婚,有小孩,家庭支出固定
    - 想在 3 年內成為資深工程師或 Tech Lead
    
    請從職涯風險、技能成長、財務安全三個角度辯論,
    給我具體建議與行動計畫。
    

    行動建議:把你最近在朋友群裡反覆抱怨的那個職涯問題,寫成 A/B 選擇 + 三個條件,讓「高智議會」幫你理一次。


    怎麼開始:從 GitHub clone 到第一個 /council

    以下以一般開發者環境(macOS / Linux)為例,步驟盡量壓縮到 10 分鐘內能跑起來。


    步驟 0:準備環境

    先確認:

    • 已安裝 git
    • 已安裝 Python 3.10+ 或專案要求版本(請以 repo README 為準)
    • 有一組可用的 LLM API key(例如 OpenAI / DeepSeek)

    行動:如果沒有 Python,可以先裝 pyenv 或用你習慣的版本管理工具準備一個環境。


    步驟 1:Clone 專案

    git clone https://github.com/0xNyk/council-of-high-intelligence.git
    cd council-of-high-intelligence
    

    行動:在你常用的開發目錄執行上述指令,打開專案資料夾準備配置。


    步驟 2:建立虛擬環境並安裝依賴

    python -m venv .venv
    source .venv/bin/activate  # Windows 使用 .venv\Scripts\activate
    pip install -r requirements.txt
    

    如果 README 有指定使用 poetry 或其他工具,請以官方文件為準。

    行動:成功後,執行 python -V 確認你現在在虛擬環境內。


    步驟 3:設定 LLM 提供商(API key)

    專案通常會有範例環境檔,例如 .env.example 或 config.example.yaml。

    1. 複製範例檔:
    cp .env.example .env
    
    1. 打開 .env,填入你的 API key,例如:
    OPENAI_API_KEY=sk-xxxx
    # 或使用其他提供商
    DEEPSEEK_API_KEY=xxxx
    ANTHROPIC_API_KEY=xxxx
    
    1. 若專案支援多模型,你可以在設定檔裡定義:

    2. 哪個 persona 用哪個 provider

    3. 模型名稱(例如 gpt-4.1, deepseek-chat 等)

    行動:至少先填一組你最熟悉的 API key,確保可以跑通第一個會議。


    步驟 4:啟動「高智議會」

    依專案設計,啟動方式可能是 CLI 或 TUI,常見格式如下(請對照 README):

    python main.py
    # 或
    council
    

    啟動後,終端可能會顯示類似:

    Welcome to the Council of High Intelligence.
    Type /council to start a new deliberation.
    

    行動:如果啟動失敗,先檢查:

    • Python 版本是否符合
    • requirements.txt 是否安裝完整
    • .env 是否存在且變數名稱拼寫正確

    步驟 5:發出你的第一條決策指令

    在終端中輸入:

    /council 幫我決定,接下來三個月我要把下班時間花在什麼事情上:
    A:寫 side project,目標是做一個小型 SaaS
    B:準備跳槽,用來刷 LeetCode 和整理履歷
    
    條件:
    - 每天大約只有 1.5 小時可用
    - 希望一年後收入有明顯提升
    請從時間投入風險、學習成長、現金回報三個角度辯論,最後給具體計畫。
    

    你應該會看到:

    • 多個角色輪流發言
    • 中間互相質疑、補充
    • 最後一位「主持人」整合結論與行動步驟

    行動:把這次輸出的結論,轉成你今天可以實際做的一件小事(例如:「今晚先列出三個 side project 題目」)。


    延伸:和多代理系統、雙 GPU 的連結

    如果你手上有多 GPU,或對 multi-agent 有興趣,可以參考這兩個方向:

    • 多 GPU 並行推理(參考 r/LocalLLaMA 貼文):
    • 用一個較大模型當 orchestrator,
    • 多個小模型當子代理,平行處理不同 persona。
    • 安全領域應用:像 VulnClaw 這類多代理滲透測試框架,將「多角色協作」搬到資安自動化場景。

    如果你本來就在玩多代理框架(如 MCP、各種 agent 工具),高智議會可以作為「決策模組」,專門負責:

    • 需求澄清與任務拆解
    • 方案比較與風險評估
    • 最後做出一個「可執行決策」交給其他 agent 落地

    最後的可行動點:

    1. 先 clone 下來跑一次 /council
    2. 把你日常最常卡的那種決策(技術選型 / 職涯 / 產品路線),固定丟進去
    3. 觀察 1–2 週,看它是否幫你減少「反覆糾結」的時間

    把開會交給費曼們,你多一點時間去執行。


    🚀 你現在可以做的事

    • 到 GitHub clone 下來 council-of-high-intelligence,依照文中步驟跑起第一個 /council
    • 挑一個你現在最卡的 A/B 決策,照範例格式寫好丟進議會讓它辯論一次
    • 如果你有在用多代理框架,嘗試把「高智議會」當成決策模組接入現有工作流
  • 用文字畫 3D:Adam 實戰指南

    用文字畫 3D:Adam 實戰指南

    📌 本文重點

    • Adam 把自然語言變成可編輯的 OpenSCAD 程式碼與 3D 模型
    • 用「文字 + 滑桿」就能調整尺寸與設計邏輯
    • 雲端試用簡單,也能用 CADAM 自架整合到現有流程

    一句話先講結論:Adam 讓你用一句自然語言描述零件,就能拿到可編輯的 OpenSCAD 程式碼和 3D 模型,用滑桿或文字微調尺寸,直接接到現有 CAD/3D 列印流程。

    官網 / Demo:https://adam.new
    開源專案(CADAM):https://github.com/Adam-CAD/CADAM


    核心功能:從文字到 CAD 程式碼

    Adam 圍繞一條實際工作流程設計:「文字描述零件 → 生成 CAD 程式碼 → 視覺化 3D 模型 → 滑桿 / 文字微調 → 導出到現有流程」。

    💡 關鍵: 這條流程的重點是輸出「可維護的程式碼 + 模型」,而不是單次不可重用的模型檔。


    1. 兩種模式:參數化建模 vs 網格生成

    進入 Adam 介面後,先選模式:

    • 參數化建模(Text → OpenSCAD)
    • 輸入:
      • 例:「一個 20×40 mm 的 L 形支架,厚度 3 mm,兩邊各有 2 個直徑 4 mm 的螺絲孔,孔中心離邊 8 mm。」
    • 輸出:
      • 可編輯的 OpenSCAD 程式碼
      • 內建參數滑桿(長度、厚度、孔徑等)
    • 適合:

      • 要做多尺寸版本、後續要改尺寸的零件
    • 網格生成(Text → Mesh)

    • 輸入:較偏形狀描述,如「帶有圓角的桌角保護套,可套在 20 mm 厚桌板上」。
    • 輸出:
      • 一個可下載的網格(通常是 STL 或類似格式)
    • 適合:
      • 只要快速 3D 列印,不打算日後精細改版的形狀件

    實際操作行動:

    1. 先想清楚這個零件未來會不會「常改尺寸」。
    2. 會改 → 選「參數化建模」;一次性打樣 → 可試「網格生成」。

    2. 滑桿調參 + 文本修改:像寫程式一樣調零件

    Adam 的核心體驗是「文字 + 滑桿」雙軌控制:

    1. 第一次生成:
    2. 在文字框輸入需求,按下生成。
    3. Adam 會:

      • 呼叫 AI 生成 OpenSCAD 程式碼
      • 解析出關鍵尺寸,放成可拖曳的滑桿
    4. 用滑桿調整尺寸:

    5. 介面右側是 3D 模型預覽,左側或下方是參數列表:
      • length、width、thickness、hole_diameter 等。
    6. 你可以直接拖拉滑桿,看模型即時更新。
    7. 適用情境:

      • 客戶說「再厚一點」
      • 3D 列印測試後只想調整孔徑、間距
    8. 用文字改需求:

    9. 覺得形狀邏輯要變,例如:
      • 原本「兩個孔」,改成「三個等距孔」。
    10. 直接在文字框補一句:「改成三個等距螺絲孔,孔徑 5 mm。」
    11. Adam 會重新生成程式碼,並保留參數化結構。

    💡 關鍵: 數值用滑桿、邏輯用文字,能把「一次性建模」變成「可持續迭代的設計流程」。

    實際操作行動:

    • 每次修改先問自己:「這是數值調整,還是設計邏輯變更?」
    • 數值:用滑桿或直接改參數欄位數字。
    • 邏輯:用文字提示重新生成,然後再微調滑桿。

    3. Text → Code:產出可讀的 OpenSCAD

    Adam 的底層策略是「Text → Code → CAD」:

    • 你得到的不是黑盒模型,而是完整 OpenSCAD 程式碼:
    • 具名變數:bracket_length、wall_thickness、hole_offset …
    • 結構清楚的 module() 函式。
    • 你可以:
    • 直接把程式碼複製到本機 OpenSCAD 編輯。
    • 放進 Git 版本控制。
    • 用腳本批次修改某些參數再輸出多版本。

    實際操作行動:

    1. 生成完成後,打開程式碼面板,把 OpenSCAD 內容存成 part.scad。
    2. 用 Git 建版(例如 v1.0、v1.1),把 AI 產生的 CAD 正式納入工程專案。

    適合誰用?三個具體場景


    1. 機構工程師:快速打樣支架 / 夾具

    常見痛點:

    • 為測試治具、感測器支架畫模型,來回改尺寸耗時間。

    用 Adam 的 workflow:

    1. 文字描述:
    2. 「一個可以夾在 20 mm 厚鋁板上的 U 形夾具,內側貼合,外側有一個 5 mm 穿孔用來鎖 M5 螺絲。」
    3. 選「參數化建模」,生成模型和程式碼。
    4. 滑桿調整:板厚、公差、螺絲孔位置。
    5. 導出 STL,送去 3D 列印測試。

    建議做法:把專案常用尺寸(例如板厚、公差)命名成變數,後續專案只改變數就能重用設計。


    2. 3D 列印工作室:一次生成多尺寸版本

    需求:

    • 同一個產品,需要 10、20、30、40 mm 四種尺寸給不同客戶。

    做法:

    1. 在 Adam 生成一個參數化模型,例如「桌角保護套」,把關鍵尺寸寫成變數 edge_size。
    2. 將 OpenSCAD 程式碼複製回本機,寫簡單迴圈:

    scad
    for (s = [10, 20, 30, 40]) {
    edge_size = s;
    // 呼叫 Adam 生成的 module
    corner_protector(edge_size=edge_size);
    }

    1. 在 OpenSCAD 中分別導出不同尺寸 STL。

    替代做法:懶得寫程式時,可在 Adam 的滑桿上手動切四個尺寸,分別匯出四個 STL,適合量少時使用。

    💡 關鍵: 把尺寸參數化後,同一份程式碼就能覆蓋多個規格,大幅減少重畫模型的時間成本。


    3. 軟體工程師:用文字產出可讀 CAD

    痛點:

    • 不熟 3D CAD,但懂程式,希望能為 Side Project 做外殼或支架。

    用 Adam 的方式:

    1. 用你熟悉的軟體語言思維來描述零件:
    2. 「為一塊 100×80 mm 的 PCB 做一個盒子,上方預留 10 mm 高空間,下方有 4 個 M3 鎖孔,孔位與 PCB 四角對齊。」
    3. Adam 會產生具名變數與模組化程式碼:
    4. 很像在讀一個乾淨的程式檔案。
    5. 你可以把 part.scad 放進專案 repo:
    6. hardware/case_v1.scad
    7. 在 CI 裡加註解:「生成 STL 時請用 OpenSCAD 2024.x 以上版本。」

    實際操作行動:團隊中沒有機構工程師時,讓軟體工程師先用 Adam 做「可用但不完美」的機構草稿,再請專業設計師基於 OpenSCAD 程式碼優化。


    怎麼開始:雲端體驗到本機部署


    1. 直接在線上玩 Demo(最快)

    1. 開啟:https://adam.new
    2. 用 Google / GitHub 帳號註冊或以訪客登入(以實際介面為準)。
    3. 選擇模式:
    4. 多尺寸零件 → 「參數化建模」
    5. 只要快速 3D 打樣形狀 → 「網格生成」
    6. 在文字框輸入第一個零件描述,按生成。
    7. 試著:
    8. 拖拉滑桿,觀察模型變化。
    9. 切到程式碼頁籤,複製 OpenSCAD 程式碼。

    目標:第一次使用,用 10 分鐘做出一個「有螺絲孔的簡單支架」並匯出 STL。


    2. 在本機部署開源 CADAM

    如果你想要自架服務(內網使用、接私有模型),可以部署開源專案 CADAM:

    GitHub:https://github.com/Adam-CAD/CADAM

    CADAM 是一個 React + Supabase 的 web app,大致步驟:

    1. 準備環境(本機或伺服器):
    2. Node.js(建議 18+)
    3. pnpm 或 npm
    4. Docker(選用,如果你要用容器)

    5. Clone 專案:

    bash
    git clone https://github.com/Adam-CAD/CADAM.git
    cd CADAM

    1. 安裝依賴:

    bash
    pnpm install
    # 或 npm install

    1. 設定環境變數:
    2. 依照 README 建立 .env 檔:

      • Supabase 金鑰 / URL
      • OpenAI 或相容 LLM 的 API Key(若要自接模型,依說明調整)
    3. 啟動開發伺服器:

    bash
    pnpm dev

    在瀏覽器打開 http://localhost:3000 即可使用。

    行動建議:先在線上版熟悉介面,再決定是否要自架;部署前從 GitHub 的 issue / README 確認當前支援的模型與功能狀態。


    3. 接到 OpenSCAD / CAM / 生產流程

    Adam 的輸出是程式碼 + 模型,你可以這樣接入現有流程:

    3.1 接 OpenSCAD

    1. 從 Adam 介面複製生成的 OpenSCAD 程式碼。
    2. 在本機用 OpenSCAD 打開,進行:
    3. 更進階的布林運算(差集、交集)
    4. 加入你自己的 library / module
    5. 用 OpenSCAD 導出 STL / STEP,交給下游軟體。

    3.2 接 CAM / CNC / 3D 列印

    • 3D 列印:
    • 從 Adam 或 OpenSCAD 匯出 STL。
    • 在 Cura / PrusaSlicer / Bambu Studio 裡切片,設定填充率、支撐等。

    • CNC / CAM:

    • 如果需要 STEP/IGES,可先用其他工具把 STL 轉 B-rep(或改用能輸出 STEP 的 CAD 路線)。
    • 在 Fusion 360 / SolidWorks / FreeCAD 裡做 CAM 規劃,生成刀具路徑。

    實際操作行動:選一個目前專案中的小零件,用 Adam 生成 → 用 OpenSCAD 調整 → 匯出 STL → 3D 列印,完整跑一次小型「文字到實物」流程,確認團隊能接得住輸出格式。


    小結:下一步可以做什麼?

    如果你是:

    • 機構工程師:先把常用的支架 / 夾具模板交給 Adam 生成 OpenSCAD 草稿,日後改尺寸只改變數。
    • 3D 列印工作室:用 Adam 做參數化模型,批次產生多尺寸版本,減少重畫時間。
    • 軟體工程師 / Maker:把 CAD 當程式寫,用 Git 管理 .scad,讓硬體外殼也成為可維護的程式碼資產。

    下一步,開啟 https://adam.new,用一句話描述你今天最想偷懶不想畫的零件,看看 Adam 能幫你省掉多少建模時間。

    🚀 你現在可以做的事

    • 上 https://adam.new,用一句話生出一個含螺絲孔的小支架並匯出 STL
    • 把生成的 OpenSCAD 存成 part.scad,放進 Git repo 當作第一個「程式化 CAD」檔案
    • 到 https://github.com/Adam-CAD/CADAM 看 README,評估是否在團隊內部自架一套 Adam/CADAM 服務
  • NotebookLM 大升級:把 Gemini 變成你的研究員

    NotebookLM 大升級:把 Gemini 變成你的研究員

    📌 本文重點

    • NotebookLM 把閱讀、整理、寫程式整合在同一工作空間
    • 內建雲端 sandbox,可直接跑 Python 做資料分析
    • 透過 Agent 自動查網路資料,像一位會 Google 的研究員

    用一句話說 NotebookLM:把你的文件、網頁跟程式碼交給一個會自己查資料、寫筆記、跑程式的 AI 研究員,幫你把「看資料 + 做筆記 + 寫程式」整合在同一個工作空間。

    官方介紹與註冊入口:https://notebooklm.google.com
    相關報導:The Decoder(連結)、The Verge(連結)


    核心功能:現在的 NotebookLM 到底多了什麼?

    1. Gemini 3.5:回覆更準、少亂講

    這次 NotebookLM 底層模型換成 Gemini 3.5 Flash,重點不是名字,而是實際效果:

    • 引用來源更清楚:問問題時,NotebookLM 會標記是從哪一份 PDF、哪一頁、哪一段抓出來的。
    • 和你自己的資料對齊:它只會優先根據你匯入的檔案回答,而不是憑空編故事。
    • 支援多文件綜合:你可以丟 10 篇論文、3 份簡報,直接問「幫我整理共同結論」。

    💡 關鍵: NotebookLM 會優先根據你匯入的資料回答問題,大幅降低「亂講」和憑空編造內容的風險。

    你可以怎麼用:

    • 把課程講義、公司簡報、研究論文丟進一個 Notebook,直接問:
    • 「請用 300 字整理這些文件的重點,分成三個小節。」
    • 「列出文件裡提到的所有關鍵術語,做成小抄。」

    2. 內建雲端 sandbox:直接在 Notebook 裡跑程式

    根據 The Decoder 報導,NotebookLM 現在有自己的 雲端電腦環境,可以:

    • 執行 Python / 程式碼片段,不用本機安裝任何東西。
    • 讓 AI 自己寫程式、執行、看結果,再調整程式碼。
    • 做資料分析:匯入 CSV、跑統計、畫圖,全在瀏覽器裡完成。

    💡 關鍵: 內建雲端 sandbox 讓你不用開 Jupyter 或設定環境,就能在瀏覽器裡完成程式與資料分析工作。

    你可以怎麼用:

    • 上傳一份 CSV 報表,在對話框輸入:
    • 「幫我用 Python 讀取這個檔案,算出每個產品線的月營收,並畫出折線圖。」
    • 有一段不熟悉的程式碼,直接貼進 Notebook:
    • 「解釋這段程式在做什麼,幫我加上註解,並用更易懂的寫法重構。」

    NotebookLM 會在它的雲端 sandbox 裡跑程式,再把結果和程式碼一起貼給你。

    3. Agent 式自動查資料:會自己 Google 的研究員

    新版 NotebookLM 加入了 Agent 式研究能力:

    • 可以直接叫它「去幫我找資料」,它會透過 Google 搜尋 找來源。
    • 不用一開始就匯入檔案,也能從「空白」開始一個研究計畫。
    • 它會把找到的網頁、PDF 當成新的資料來源,整理成摘要或報告。

    The Verge 指出,現在你可以直接在 NotebookLM 裡啟動研究,而不是先手動找資料再貼進來。

    你可以怎麼用:

    • 問:
    • 「請幫我找三篇 2023 年後關於 LLM 應用在教育的研究,整理出研究問題、方法、結論。」
    • 要求:
    • 「所有引用請附上原始連結,最後用一段話提醒我這些研究的限制。」

    適合誰用:三個具體場景

    1. 學生:整理課堂講義與論文

    常見痛點:

    • 上課講義 + 教科書 + 老師 PDF + 論文,多到爆炸,很難整理成考前筆記。
    • 讀英文論文速度慢,抓不到重點。

    NotebookLM 的用法:

    1. 建立一個 Notebook,例如「機器學習期末」。
    2. 匯入:課程講義 PDF、指定閱讀論文、老師提供的投影片。
    3. 問:
    4. 「請用中文整理這份 Notebook 的期末考重點,照章節分類。」
    5. 「幫我做一份 10 題選擇題,題目來自這些文件,並給出解析。」
    6. 「這篇論文的實驗設計和 limitation 是什麼?用口語說明。」

    可立即採取的行動:

    • 把這學期最頭痛的一門課資料丟進 NotebookLM,直接讓它幫你做考前總整理。

    2. 產品經理:整理競品資料與市場研究

    常見痛點:

    • 競品官網、新聞稿、使用條款、App 介紹分散各處。
    • 每次開會都在重做一樣的「功能比較表」。

    NotebookLM 的用法:

    1. 新建 Notebook:「2024 Q3 競品研究」。
    2. 匯入:競品官網截圖 PDF、功能說明文件、先前做過的簡報。
    3. 啟用 Agent 查資料:
    4. 「幫我搜尋 3 家同類型 SaaS 產品的定價頁面,整理成表格。」
    5. 再問:
    6. 「針對我們現有產品,列出 5 個值得抄的功能點,並附上來源連結。」

    可立即採取的行動:

    • 建立你的「競品知識庫 Notebook」,每天丟一兩個新連結進去,讓 NotebookLM 幫你維護最新的競品視圖。

    3. 工程師:技術備忘錄 + 資料分析助手

    常見痛點:

    • 專案文件分散在 Confluence、Google Docs、GitHub Wiki。
    • 每次查舊專案架構或業務規則,都要重看一堆文件。
    • 做小型資料分析還得開 Jupyter、整理環境。

    NotebookLM 的用法:

    1. 建立 Notebook:「後端服務 A 技術文件」。
    2. 匯入:設計文件 PDF、API spec、README、部分程式碼片段。
    3. 提問:
    4. 「這個服務的主要資料表有哪些?幫我畫一個簡化的 ER 圖描述文字。」
    5. 「從這份 API 文件裡,整理一份給新同事看的 onboarding 指南。」
    6. 把日常 log / CSV 丟進去:
    7. 「用 Python 幫我分析這份 log,找出錯誤頻率最高的三個 endpoint,畫 bar chart。」

    可立即採取的行動:

    • 先選一個你最常被問的專案,把所有設計文件丟進 NotebookLM,之後把新同事導向 NotebookLM 問問題。

    怎麼開始:10 分鐘完成第一個 Notebook 專案

    步驟 1:開啟 NotebookLM

    1. 用 Chrome 或任一瀏覽器開啟:https://notebooklm.google.com
    2. 用你的 Google 帳號登入。
    3. 若地區未開放,可以先用 VPN 嘗試(注意公司政策)。

    步驟 2:建立第一本 Notebook

    1. 點選「New notebook」。
    2. 幫它取一個明確的名字,例如:
    3. 「行銷簡報整理」
    4. 「碩士論文文獻庫」
    5. 按「Add sources」,開始匯入資料。

    步驟 3:匯入 PDF / Docs / 網頁

    NotebookLM 支援:

    • 上傳 PDF、TXT、部分 Office 檔。
    • 直接選 Google Docs、Slides、Sheets。
    • 貼上網址,讓它自己抓取網頁內容(官網、部落格、新聞稿)。

    建議:先匯入 3–5 份你最近真的會用到的文件,不要一次丟 50 份,方便你先熟悉操作。

    💡 關鍵: 一開始只匯入 3–5 份核心文件,比一次丟 50 份更容易看出 NotebookLM 的效果並建立使用習慣。

    步驟 4:試用這 3 個 Prompt 模板

    以下是你可以直接複製貼上的實戰模板:

    模板 1:快速總整理

    你是一位擅長教學的筆記整理員。請根據這本 Notebook 內所有來源資料,整理一份 800 字以內的重點摘要,
    1. 先列出 5 個最重要的概念
    2. 每個概念用不超過 3 句話說明
    3. 最後用一段話提醒我考試或簡報時最容易忽略的地方

    模板 2:給不同對象的說明稿

    根據 Notebook 內的資料,分別寫兩版說明:
    1. 給完全沒有背景的新手,限制 300 字,盡量口語化
    2. 給同領域專業人士,限制 300 字,可以使用專業術語
    每一版都請標註引用的來源文件與頁碼(若有)。

    模板 3:資料 + 程式分析

    我上傳了一份 CSV 檔案,請你:
    1. 先用 Python 讀取資料並描述欄位
    2. 幫我算出各類別的平均值與標準差
    3. 畫出一張適合的圖表(你自己決定類型),並解釋為什麼這樣比較好讀
    請貼出完整的 Python 程式碼與分析結論。


    結語:把 NotebookLM 當成「專案專屬研究員」

    使用 NotebookLM 最重要的觀念是:為每個專案建一本 Notebook,讓它跟著專案一起長大。

    • 學生:每門課一冊,所有講義與筆記都放進去。
    • 產品經理:每個產品線或競品一冊,讓它幫你維護最新情資。
    • 工程師:每個系統或專案一冊,變成活的技術備忘錄 + 分析環境。

    你只需要準備好資料,NotebookLM 會幫你查、幫你寫、幫你跑程式,真正變成「專案專屬的 Gemini 研究員」。

    🚀 你現在可以做的事

    • 登入 NotebookLM,為你目前最重要的專案建立第一本 Notebook
    • 先匯入 3–5 份你最近真的會用到的文件,實測上文提供的 3 個 Prompt 模板
    • 挑一個課程 / 產品線 / 專案,每次產出新文件就丟進 NotebookLM,開始養成「一專案一 Notebook」的習慣
  • Lens 超輕量圖像生成實戰指南

    Lens 超輕量圖像生成實戰指南

    📌 本文重點

    • 小模型搭配高品質描述也能畫得好
    • Lens 完整開源,可在本機或雲端部署
    • 用 GPT 先整理資料,可微調出專屬圖像模型
    • 先用 Demo 試 prompt,再決定是否自建 API

    用一台普通筆電就能跑的開源圖像模型 Lens,把「小模型也能畫得好」這件事變成現實,適合想在本機或雲端快速搭一個可用圖像生成系統的人。

    原始研究與開源專案可見 Microsoft Research 公告與程式碼倉庫(可從 The Decoder 報導 追蹤連結)。


    核心功能:小模型,靠好資料撐起來

    1. 3.8B 參數也能畫出細節圖

    Lens 的參數量只有約 38 億,比主流閉源大模型小很多,但在多個圖像生成基準測試中,成績可以追上甚至超過體型更大的模型。關鍵不是「堆參數」,而是訓練資料:

    • 使用約 8 億筆、由 GPT‑4.1 產生的高品質圖像描述
    • 描述內容細到「光源方向、鏡頭焦段、材質、構圖」,不是只寫「一隻貓坐在桌子上」
    • 小模型可以在這些精準標註上更有效學習

    💡 關鍵: 約 38 億參數配上 8 億筆精準描述,證明小模型只要資料夠好,也能接近甚至超過大模型表現。

    你可以怎麼用這個優勢?

    在實際 prompt 時,多寫一點細節,Lens 特別吃「具體描述」:

    一個極簡風格的手機 App 圖標,白色背景,中間是扁平化的藍色雲朵,
    線條乾淨,無陰影,適合放在 iOS 主畫面。
    

    比起只寫「雲朵圖標」,具體描述會更接近 Lens 當初訓練時看到的高質量 caption,使輸出品質更穩定。


    2. 完整開源:程式碼 + 權重 + 資料流程

    Lens 的程式碼與模型權重開源,你可以:

    • 在本機部署,不經過第三方雲端
    • 在自己的伺服器上做內網圖像生成 API
    • 自行微調,適配特定風格(例如公司品牌視覺)

    可行動的做法:

    • 把 Lens 當作「公司內部版 Midjourney」,搭配簡單前端頁面給同事用
    • 在產品原型工具(如 Figma 插件、內部 dashboard)後端接上 Lens API

    3. 訓練思路可複用:用 GPT 先把資料變好

    Lens 的另一個重點,是用 GPT‑4.1 先幫原始圖像資料寫出高品質描述,再拿來訓練。對個人或團隊來說,這給了很實際的路線:

    • 收集自家產品圖(例如鞋子、包包、介面截圖)
    • 用 GPT‑4.x 幫每張圖生成細緻描述
    • 用這批資料微調 Lens,得到一個「專門懂你家產品」的圖像模型

    你可以馬上做的實驗:

    1. 拿 50 張自家產品圖
    2. 用 ChatGPT / Azure OpenAI 幫每張圖寫 3–4 句的超詳細描述
    3. 把這批圖 + 描述存成 JSON / CSV
    4. 未來如需微調 Lens,就已經有一批乾淨資料可以用

    💡 關鍵: 先用大型語言模型替資料加上高品質描述,可以顯著降低後續訓練或微調的成本,讓小模型也具備專領域能力。


    適合誰用:三個典型場景

    1. App 圖標與 UI 草圖

    需求:快速生出幾十款圖標概念,不想每次都手動畫。

    Lens 可以:

    • 輸出風格統一的 App 圖標草稿
    • 為不同功能模組快速生成 icon 系列

    範例 prompt:

    為一款習慣追蹤 App 生成 4 個圖標提案:
    扁平化風格,柔和配色,每個圖標有明確象徵:
    打卡用打勾符號、番茄鐘用簡化的時鐘、
    統計用長條圖、個人設定用簡化人物輪廓。
    背景簡潔,適合 iOS 風格。
    

    2. 行銷素材:社群貼文、Banner 草圖

    需求:行銷團隊需要快速產出視覺草案,交給設計師再精修。

    Lens 可以:

    • 生成不同構圖的社群貼文底圖
    • 幫你先找到「方向」,再請設計師改

    實際使用方式:

    1. 將產品賣點寫成 2–3 句描述
    2. 指定風格(例如「韓系清新」、「科技感藍紫配」)
    3. 產出 5–10 張圖,挑 1–2 張給設計師重製

    3. 產品原型圖:硬體外觀、介面草稿

    需求:先有一組「看得懂」的圖,再進行工業設計或 UI 設計。

    Lens 可以:

    • 幫你畫出不同外型的裝置草案(例如智慧音箱、耳機)
    • 幫 App 原型搭配大致配色與版型

    範例 prompt:

    一款家用智慧音箱的產品概念圖,
    圓柱形機身,霧面白色塑膠材質,上半部有細密圓孔,
    底部有一圈柔和的 LED 光環,放在木質桌面上,
    整體風格偏向北歐極簡風。
    

    怎麼開始:最低摩擦上手路線

    路線 1:完全不寫程式,先用 Hugging Face Demo Space

    如果你只是想試看畫得如何,最簡單是使用 Hugging Face 上的 Demo(搜尋「Lens text-to-image」即可,或從 The Decoder 報導頁面 追過去)。

    步驟:

    1. 開啟 Demo Space 頁面
    2. 在文字框輸入中文或英文 prompt
    3. 選擇解析度與步數(預設即可)
    4. 點擊 Generate

    適合:

    • 行銷或產品同事想先測試效果
    • 還沒有決定要不要自己部署

    小技巧:

    • 先用 Demo 找到你喜歡的 prompt 模板
    • 再複製這些 prompt 到你自己的部署裡使用

    路線 2:會寫程式,用 Transformers 建自己的圖像生成 API

    如果你熟悉 Python,建議直接用 Hugging Face Transformers 在本機或雲端跑 Lens,幾行程式碼就能得到一個可呼叫的 API。

    以下假設你已安裝 Python 3.10+。

    1. 安裝必要套件

    pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu
    pip install transformers accelerate safetensors
    

    如果你有 NVIDIA GPU,可改用官方 CUDA 版 PyTorch 安裝指令。

    2. 下載並載入 Lens 模型

    以 Transformers 為例(假設模型名稱為 microsoft/lens-3.8b,實際名稱請依 Hugging Face Hub 為準):

    from transformers import AutoTokenizer, AutoModelForCausalLM
    import torch
    
    model_id = "microsoft/lens-3.8b"
    
    tokenizer = AutoTokenizer.from_pretrained(model_id)
    model = AutoModelForCausalLM.from_pretrained(
        model_id,
        torch_dtype=torch.float16,
        device_map="auto"
    )
    
    prompt = "a minimal blue and white app icon of a cloud on a white background, flat design, no shadows"
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
    
    with torch.no_grad():
        outputs = model.generate(**inputs, max_new_tokens=256)
    
    # 假設模型會輸出圖像 latent,再解碼成圖片
    # 這部分請依官方範例加入解碼步驟
    

    因為 Lens 是影像模型,實際程式碼會包含「文字 -> 影像 latent -> 圖檔」三階段;建議直接參考官方 repo 的 inference.py 或示範 notebook,把其中的 inference 函數包一層 API。

    3. 快速包一個本機 API(Flask 範例)

    from flask import Flask, request, send_file
    from io import BytesIO
    
    app = Flask(__name__)
    
    @app.post("/generate")
    def generate():
        data = request.get_json()
        prompt = data.get("prompt", "")
        # 呼叫 Lens 推理函數,回傳 PIL Image
        image = run_lens(prompt)
    
        buf = BytesIO()
        image.save(buf, format="PNG")
        buf.seek(0)
        return send_file(buf, mimetype="image/png")
    
    if __name__ == "__main__":
        app.run(host="0.0.0.0", port=8000)
    

    有了這個 API,你就可以:

    • 在前端或 no-code 工具(如 Bubble、Retool)裡直接呼叫
    • 在 CI pipeline 裡自動生成 demo 圖像

    💡 關鍵: 先用 Hugging Face Demo 測試,再用短短數十行程式碼包成 API,可以在普通硬體上快速搭起團隊可用的圖像生成服務。


    最低摩擦指南:你現在可以做什麼

    1. 先用 Hugging Face Demo 試出一組好用 prompt:
    2. 各準備一組 App 圖標、行銷素材、產品原型的 prompt 模板
    3. 決定部署路線:
    4. 只需要偶爾用 → 繼續用 Demo
    5. 團隊要每天用 → 自己在雲端或本機起一個 Lens API
    6. 把 prompt 模板寫進文件:
    7. 給團隊共用,確保風格一致

    Lens 的真正價值,不只是「輕量」這一點,而是用高品質 GPT‑4.1 描述資料換來的「小而準」行為。只要你願意在描述上多花一點心思,就能在普通硬體上,得到足夠好用的圖像生成系統。

    🚀 你現在可以做的事

    • 打開 Hugging Face 搜尋「Lens text-to-image」,實際輸入 3 組 prompt 測試效果
    • 在一台開發機上依照文中步驟安裝 Transformers,跑通一個簡單的 Lens API
    • 收集 20–50 張自家產品圖,配合 GPT‑4.x 產生描述,準備未來微調用的資料集
  • Gemini Spark 實測:讓 AI 幫你24小時跑腿

    Gemini Spark 實測:讓 AI 幫你24小時跑腿

    📌 本文重點

    • Gemini Spark 能在背景執行多步驟任務
    • 可長時間記住上下文並自動接續任務
    • 透過確認機制與權限設計平衡自動化與安全

    用一句話講白:Gemini Spark 就是一個 24/7 在背景幫你跑多步驟任務的 AI 小幫手,不用你一直開著聊天視窗盯著它。

    測試參考:The Verge 的實測與旅遊規劃體驗:Hands-on 1、Hands-on 2


    核心功能:跟「傳統聊天機器人」差在哪

    1. 主動在背景幫你跑多步驟任務

    傳統聊天機器人:

    • 你問它才回你
    • 一次只做一小段,關掉網頁就「記憶掰掰」

    Gemini Spark:你給他一個任務,它可以自己在背景跑完多步驟流程,再回來跟你報告。

    實際可以怎麼用:

    • 旅遊規劃 + 比價
      指令示例:

      「幫我規劃 10 月中從台北去東京 5 天家庭旅行,預算中等,要有 2 天親子行程。請:1)找出 3 個機票選項,考慮總飛行時間與轉機;2)比 3 家飯店,近地鐵、評價 4.3 以上;3)做出每日行程表。你可以在背景慢慢查,整理好再一次給我。」

    行動建議:第一次用 Spark 就拿「下一趟旅行」開刀,給它明確條件 + 步驟,讓它自己去跑,體驗差異最大。

    💡 關鍵: Spark 最大差異是能在背景獨立完成多步驟任務,最後一次性給你結果,而不是每一步都要你手動盯著。


    2. 長時間記得你在做什麼,自己幫你接續

    Spark 的另一個重點,是上下文可以拉得比較長,不只是當下這一輪對話。

    它會記得:

    • 你最近在規劃什麼(例如那趟東京行)
    • 你之前給過的偏好(例如「我不想一早就排景點」)
    • 它自己尚未完成的任務

    你可以這樣用:

    「接續之前的東京行程,幫我加上 1 天只逛博物館和書店的行程,然後把所有訂票與景點的連結整理成一封 email 草稿給我。」

    Spark 不用你重新貼所有內容,它自己接上前一次任務,把新要求整合進去。

    行動建議:遇到「要改舊計畫」時,不要重講一遍,直接說「接續上次 XX 任務,幫我多做……」,讓 Spark 幫你維護脈絡。


    3. 重要步驟前會停下來問你

    The Verge 的實測中提到:Spark 在敏感動作前會跳出確認,而不是默默幫你亂動。

    常見的確認點會包括:

    • 要寄出 email 前
    • 要變更行事曆 前
    • 要存取新服務或帳號 時

    使用方式:

    • 把 Spark 想像成「實習生」:
    • 你可以說:「先幫我草擬,不要真的送出。」
    • 或:「這類會議邀請之後可以直接幫我接受。」

    行動建議:第一次設定時,刻意跟它說清楚:

    「所有會寄出去給別人的內容,一律先給我草稿,不要自動送。」

    這樣你就能享受自動化,又不會被它「幫過頭」。


    適合誰用?3 個具體場景

    1. 旅行規劃:從「列點子」變成「整包交辦」

    The Verge 的旅行實測裡,作者說 Spark 是第一個讓他覺得旅遊規劃真的可以交給 AI 的工具,因為它會:

    • 不只列景點,還會看交通、預約限制、開放時間
    • 幫你平衡:太緊湊 / 太鬆、戶外 / 室內、購物 / 觀光

    你可以照抄這個 workflow:

    任務目標:幫我規劃 4 天 3 夜的首爾行程,預算偏省,重點是美食跟咖啡廳。
    限制:
    - 不要一早 9 點前的行程
    - 每天最多排 2 個需要事先訂位的地方
    - 交通以地鐵為主
    請:
    1. 先問我出發時間與大概預算
    2. 自己在背景查資料,整理成表格(時間 / 地點 / 交通 / 必點餐點或特色)
    3. 把所有需要訂位的頁面連結整理,獨立列出清單給我。
    

    行動建議:把旅遊需求拆成「目標+限制+要輸出的格式」,這樣 Spark 做出來的東西比較接近可以直接用的版本。


    2. 跨時區會議統整:讓 Spark 當你的時區翻譯機

    如果你常跟美國、歐洲同事開會,Spark 可以做的事情包括:

    • 幫你把一串 email 往來整理成待辦清單
    • 自動換算時區,找幾個可行的會議時間
    • 產生英文 / 中文雙語的會議邀請草稿

    指令示例:

    「我等等會轉寄給你一整串關於新專案的 email。請幫我:1)整理每個人各自承諾要做的事;2)找出下週台北時間 9:00–11:00、倫敦時間 9:00–18:00 之間都可行的 3 個時間;3)根據這串內容寫一封英文會議邀請草稿給團隊。」

    行動建議:

    • 寫指令時,先描述要的結果,再說你會提供什麼資料(例如會轉寄 email)。
    • 用「台北時間」「倫敦時間」等明確描述,避免只寫「我早上」。

    3. 日常代辦追蹤:把「總是忘記回信」交給它

    Spark 比較實用的一點是:它可以「掛在那裡幫你盯」,而不是你想到才去查。

    你可以把它當作:

    • Email 回覆提醒
    • 文件閱讀與摘要助手
    • 日常待辦整理員

    範例指令:

    「從今天開始,幫我追蹤 Gmail 裡標成星號的信:
    1)每天下午 5 點,整理一份『還沒回覆的星號信』列表給我,包含:寄件人、主題、收到時間、你建議的 1 句回覆重點;
    2)對於你有把握的簡單信件,可以先幫我產生回覆草稿。」

    行動建議:

    • 先選「一個小範圍」讓 Spark 幫你追(例如星號信),不要一開始就全信箱開放。
    • 每週檢查一次它生成的草稿,你會越來越知道怎麼跟它講需求。

    優點與限制:實測感受整理

    優點

    • 真的可以放著不管:The Verge 的體驗中,Spark 在你離線時也會繼續查資料、比對選項,最後給你整理好的結果。
    • 願意多問幾句確認:不像很多 Agent 一次衝到底,Spark 會分段跟你確認,讓你改方向。
    • 整合 Google 服務有優勢:像 Gmail、Calendar、Docs 等,對已在 Google 生態系的人尤其方便。

    限制與風險

    • 速度不一定快:多步驟任務,等 5–15 分鐘甚至更久是常態,不適合「立刻要答案」。
    • 隱私顧慮:要讓它看 Gmail、行事曆,等於多了一個能讀你資料的「人」。The Verge 也特別提醒了這點。
    • 目前功能和價格仍在調整中:不同地區可能有功能差異,也可能需要訂閱 Gemini 付費方案才用得到完整版。

    行動建議:

    • 先從「不那麼敏感」的任務測試(旅行規劃、公開資訊整理),習慣它的行為再逐步開放更多權限。

    💡 關鍵: Spark 適合放在「不急但複雜」的任務上,接受它可能要 5–15 分鐘換來的是你少了大量瑣事。


    怎麼開始:開通、免費用到哪裡、權限怎麼設

    以一般個人使用者為例,實際介面可能會隨時間更新,建議以官方說明為準:https://gemini.google/overview/agent/spark

    1. 快速開通與入口

    大致流程會長這樣:

    1. 登入 Google 帳號(建議用你平常收信、排行程那個帳號)。
    2. 前往 Gemini 頁面,找到 Spark 開關或切換(Chat ↔ Spark)。
    3. 按提示完成初始設定:
    4. 選擇語言、地區
    5. 勾選同意條款
    6. 決定是否要讓它讀 Gmail / Calendar 等

    行動建議:初次設定時,能跳過的權限先跳過,等確定要用再打開。


    2. 哪裡能免費用到?

    Google 目前的作法通常是:

    • 基本 Gemini 功能提供免費層級
    • 進階功能或高用量則綁定 Gemini Advanced / Google One AI Premium 類型訂閱

    Spark 很可能會:

    • 在部分地區提供測試或限量免費
    • 或綁在付費方案裡,讓你有更高配額與完整 Agent 能力

    行動建議:

    • 先確認你所在的地區是否開放 Spark,並在 Gemini 介面查看是否需要升級方案。
    • 如果有試用期,先集中在那段時間安排幾個「真實任務」給它做,評估值不值得付費。

    3. 權限與通知:好用但不要被吵

    要兼顧方便與不打擾,可以這樣設:

    (1)資料權限:

    • 先只開 Gmail / Calendar 的「讀取」權限,不給「全自動修改」。
    • 明確跟它說:

      「除非我說可以,否則不要自動變更行事曆或寄出任何 email。」

    (2)通知策略:

    • 手機端:
    • 保留「任務完成摘要」通知
    • 關閉「每一步都提醒」的通知
    • 你可以設一個固定時間:

      「每天晚上 9 點幫我整理今天你做了什麼、一件概要就好。」

    行動建議:把 Spark 當成「一天回報一兩次的助理」,而不是 Slack 機器人那樣每十分鐘跳出來吵你。

    💡 關鍵: 先給 Spark 讀取多於寫入的權限,並限制通知頻率,可以在安全邊界內體驗自動化。


    總結:怎麼寫出 Spark 用得懂、又做得好的指令?

    可以記這個模板:

    目標 + 限制條件 + 步驟 / 輸出格式 + 背景運作說明

    範例:

    「目標:整理我這週所有會議記錄,變成一份 1 頁的執行摘要。
    限制:只用我提供的文件,不要自己亂查資料。
    步驟:1)讀完我丟給你的 5 份會議記錄;2)列出所有待辦與負責人;3)寫一段 200 字內的總結。
    背景:你可以在背景慢慢做,完成後一次給我,不用中途打擾。」

    從一兩個小任務開始,習慣這種「把事交給 AI 跑完再回報」的工作方式,你會很快感受到:Spark 的價值不在於多會聊天,而是在於很多你不想做、但又非得有人做的細碎工作,它可以默默幫你扛掉。

    🚀 你現在可以做的事

    • 挑一個即將到來的旅程,照文中的「目標+限制+格式」模板寫一個 Spark 指令
    • 從 Gmail 星號信中選一小段範圍,讓 Spark 嘗試幫你追蹤與產生回覆草稿
    • 依照文中的權限與通知建議,在 Gemini 介面中完成 Spark 的初始設定與權限調整
  • 用 Mellum2 排程你的 AI 工作流

    用 Mellum2 排程你的 AI 工作流

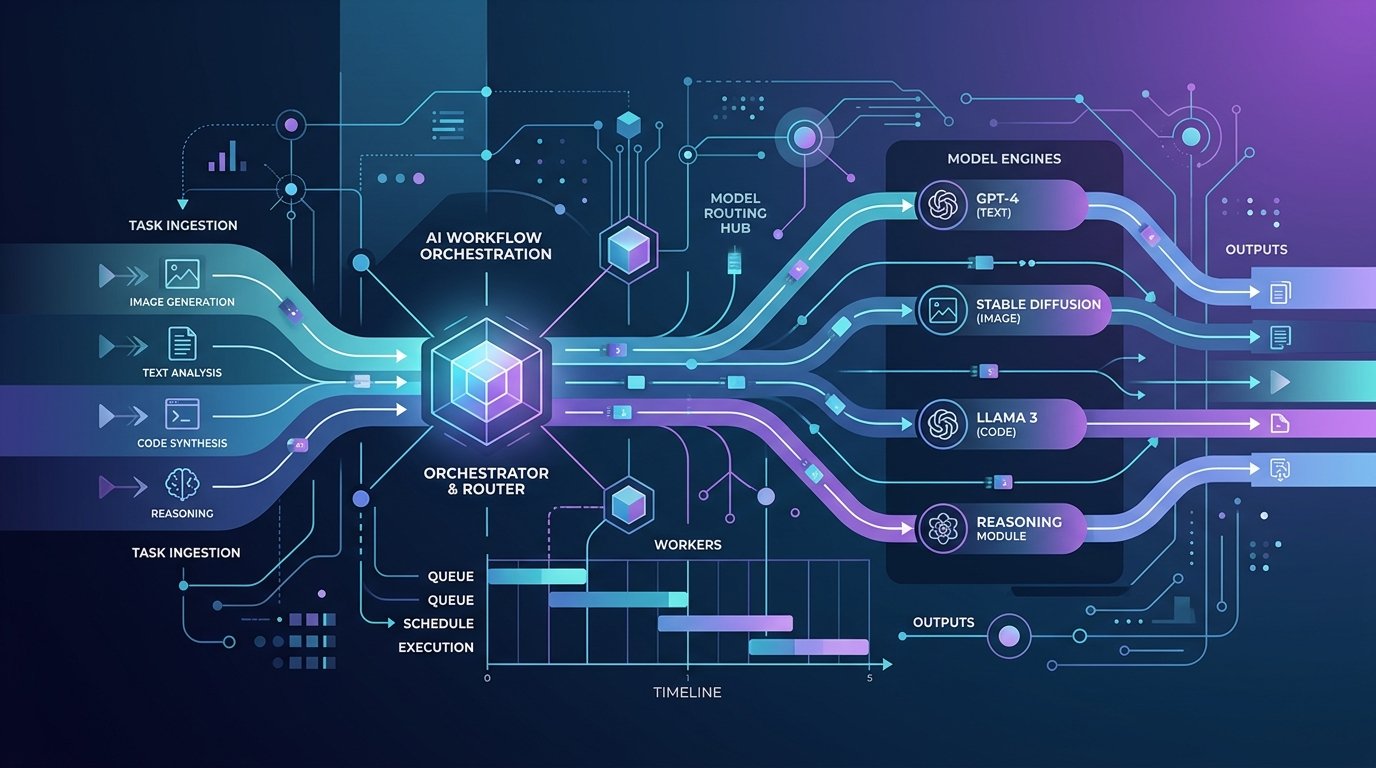
    一句話先說清楚:Mellum2 是一顆專門幫你「排班、調度」其他大模型和工具的小模型,用來做 routing、任務拆解與工具選擇,讓 AI 工作流更便宜、更穩定。

    📌 本文重點

    • Mellum2 是專門做「決策與調度」的小模型
    • 適合負責 routing、任務拆解和工具選擇
    • 能幫多模型、多工具的工作流壓成本、提穩定度
    • 很適合拿來做 AI agent 的中樞大腦

    官方介紹與原始碼:https://blog.jetbrains.com/ai/2026/06/mellum2-goes-open-source-a-fast-model-for-ai-workflows/


    核心功能:先讓 Mellum2 當你的「AI 排班主管」

    1. 低延遲的小模型,適合做決策層

    Mellum2 本身不是 GPT-4o 那種萬能助手,它更像是負責「決定下一步要幹嘛」的主管:

    • 模型體積小、推理快,適合放在整個 pipeline 的最前面或中間層
    • 每次呼叫成本低,很適合頻繁決策:用哪個工具?要不要再拆一步?該重試還是直接回覆?

    💡 關鍵: 把高頻率、邏輯性的「決定怎麼做」交給便宜小模型,昂貴大模型只負責「實際做」,能讓整體成本大幅下降。

    你可以怎麼用?

    • 把「判斷任務類型 → 選模型 → 選工具」這段邏輯,從你程式碼的 if-else 搬到 Mellum2
    • 所有複雜 workflow 的分支規則,盡量改成 prompt + Mellum2 來決定,減少硬寫規則

    2. 多步推理:讓它負責拆任務、串工具

    JetBrains 把 Mellum2 設計成適合多步推理(multi-step reasoning)的模型,也就是它擅長做:

    • 任務拆解:把「寫一份技術規格書」拆成「補資料 → 查 API → 產出草稿 → 校對」
    • 步驟規劃:決定每一步要用哪支工具或哪個 LLM
    • 狀態更新:根據上一個工具的輸出,動態調整下一步

    你可以怎麼用?

    • 把你現有的工具(爬網頁、查資料庫、呼叫商用 LLM)列成一張「工具清單」給 Mellum2
    • 請 Mellum2 每次都輸出「下一步要用的工具 + 工具參數」,你的程式只負責照做

    3. Routing + 工具選擇:讓 GPT、Claude、開源 LLM 都變成「插件」

    Mellum2 最實用的角色,就是做模型路由(model routing)和工具選擇(tool selection):

    • 你可以在後面接:GPT-4.1、Claude 3.7、Llama、Qwen 等
    • Mellum2 根據需求幫你選:「這題要便宜模型」還是「這題要高準確度」

    💡 關鍵: 當你同時使用多個 LLM 供應商時,用 Mellum2 做路由,可以在「品質不明顯下降」的前提下,讓大量請求自動落在較便宜的模型上。

    可以這樣設計一個簡單策略

    • 查資料類問題 → 用便宜/開源 LLM + 搜尋工具
    • 寫程式、寫長文 → 用 GPT-4.1 或 Claude 3.7
    • 簡單 Q&A → 用本地 LLM,節省 API 費用

    你的程式不用管細節,只要:

    1. 收到使用者請求
    2. 把請求 + 目前可用模型列表丟給 Mellum2
    3. 照 Mellum2 的輸出去呼叫對應模型

    適合誰用:三種典型場景

    1. 你在做「AI 助手」或 Agent 系統

    如果你在做:

    • 產品內建 AI 助手(客服、知識庫問答)
    • 自動化 Agent(幫你查資料、寫報告)

    問題通常會是:

    • 使用者問題差異很大,單一模型不是太貴就是太弱
    • 工具越加越多,判斷流程 if-else 爆炸

    Mellum2 能幫你:

    • 把「選模型、選工具、拆步驟」集中到一顆小模型管理
    • 你只要維護工具清單和觀察 Mellum2 的決策是否合理

    可以實作的行動:

    • 先挑三個最常用工具:RAG 搜尋、商用 LLM、本地 LLM
    • 寫一個 Mellum2 prompt,要求它根據需求選 1-3 個步驟完成任務

    2. 你有多個 LLM 供應商,要壓成本又要穩定

    典型狀況:

    • 公司已經有 OpenAI 帳號,也在測 Claude,還有自家的 vLLM 服務
    • 主管希望「多用便宜模型,但品質不能掉太多」

    Mellum2 的用法:

    • 給它模型清單:
    • gpt-4.1: 高成本、高品質
    • gpt-4o-mini: 中等品質、便宜
    • local-llama: 最便宜、品質較不穩
    • 附帶一些示例(few-shot),教 Mellum2 什麼情境選哪個

    💡 關鍵: 先在開發環境裡讓所有請求經過 Mellum2 路由,實際觀察不同任務落在昂貴與便宜模型的比例,再調整規則,比一開始就死寫策略安全得多。

    可以實作的行動:

    • 先在開發環境改成「所有請求都要經過 Mellum2 路由」
    • 觀察一週:不同任務下,商用 LLM 和本地 LLM 的占比、成本變化

    3. 你要做「穩定的 AI Pipeline」而不是單次聊天

    像是:

    • 每天自動爬資料 → 摘要 → 存進 Notion
    • 每次有 Pull Request → 產生 code review 建議

    這種 Pipeline 常見問題:

    • 某個 LLM 偶爾出錯,整條流程掛掉
    • 你需要 fallback 策略:失敗就換模型、換 prompt、換工具

    Mellum2 可以:

    • 監看每一步工具回傳結果(成功 / 失敗 / 異常訊息)
    • 根據結果決定下一步:
    • 重試同一步驟
    • 改用另外一個模型
    • 回報錯誤給人類

    可以實作的行動:

    • 把 Pipeline 的每一步都包成「工具」
    • 每一步的錯誤,也當作輸入回饋給 Mellum2,讓它決定接下來的補救策略

    怎麼開始:從安裝到最小可行範例

    以下流程以「你會用 Docker 或 Python,且已經有至少一個 LLM API(OpenAI / Anthropic / 本地 vLLM)」為前提。

    1. 安裝 Mellum2:Docker 或程式庫二選一

    先到官方部落格或 Repo:https://blog.jetbrains.com/ai/2026/06/mellum2-goes-open-source-a-fast-model-for-ai-workflows/

    選項 A:用 Docker 跑起 Mellum2 服務

    1. 安裝 Docker / Docker Compose
    2. 拉取 Mellum2 映像(以官方 README 為準,示意):

    bash
    docker pull jetbrains/mellum2:latest

    1. 啟動服務(假設開在 8000 port):

    bash
    docker run -p 8000:8000 jetbrains/mellum2:latest

    1. 用 curl 測試:

    bash
    curl -X POST http://localhost:8000/infer \
    -H "Content-Type: application/json" \
    -d '{"input": "你是任務規劃器,請幫我決定下一步要用什麼工具"}'

    適合: 想先用 HTTP API 串現有後端的人。

    選項 B:在程式裡直接呼叫 Mellum2

    如果官方有 Python 套件(假設為 mellum2):

    pip install mellum2
    

    簡單測試:

    from mellum2 import MellumClient
    
    client = MellumClient(base_url="http://localhost:8000")  # 或直接用雲端端點
    
    resp = client.infer("你是任務規劃器,收到任務後要輸出下一步計畫")
    print(resp)
    

    適合: 你準備把 Mellum2 深度嵌到自家服務裡。


    2. 示範:Mellum2 做 Router + 任務規劃的最小 workflow

    下面是一個最小可行例子:

    • 你有兩個底層 LLM:
    • gpt-4.1(高品質)
    • local-llama(便宜)
    • 有一個簡單工具:web_search(用來查網路)
    • 目標:收到使用者問題,由 Mellum2 決定:
    • 要不要先搜尋
    • 要用哪個模型產生最終答案

    Step 1:定義給 Mellum2 的「工具/模型清單」

    TOOLS = [
        {
            "name": "web_search",
            "type": "tool",
            "desc": "適合需要即時或最新資訊的問題,例如股票、新聞、價格。"
        },
    ]
    
    MODELS = [
        {
            "name": "gpt-4.1",
            "cost": "high",
            "quality": "best",
            "desc": "用在需要高準確度、長文、程式碼的回答。"
        },
        {
            "name": "local-llama",
            "cost": "low",
            "quality": "medium",
            "desc": "用在一般聊天、簡單問答。"
        }
    ]
    

    Step 2:設計 Mellum2 Prompt,請它輸出「計畫 JSON」

    SYSTEM_PROMPT = """
    你是 AI 工作流調度器,負責:
    1. 判斷使用者需求
    2. 決定是否要先使用工具
    3. 選擇要使用的底層 LLM
    
    請只輸出 JSON,不要多餘文字,格式:
    {
      "steps": [
        {"action": "tool" | "model", "name": "...", "input_from": "user" | "prev_result"}
      ]
    }
    
    可用工具:
    {tools}
    
    可用模型:
    {models}
    """.format(tools=TOOLS, models=MODELS)
    

    Step 3:呼叫 Mellum2,拿到決策後執行

    import json
    from mellum2 import MellumClient
    
    mellum = MellumClient(base_url="http://localhost:8000")
    
    user_query = "幫我分析最近 NVIDIA 股價的變化,順便預測未來一季可能走勢。"
    
    planning_prompt = SYSTEM_PROMPT + f"\n使用者問題:{user_query}"
    
    plan_resp = mellum.infer(planning_prompt)
    plan = json.loads(plan_resp["text"])  # 依實際回傳欄位調整
    
    result_cache = None
    for step in plan["steps"]:
        if step["action"] == "tool" and step["name"] == "web_search":
            query = user_query if step["input_from"] == "user" else result_cache
            result_cache = call_web_search(query)  # 這是你自己實作的搜尋功能
    
        if step["action"] == "model":
            model_name = step["name"]
            model_input = user_query if step["input_from"] == "user" else result_cache
            result_cache = call_llm(model_name, model_input)  # 依照名稱選擇 gpt / llama
    
    print("最終回答:", result_cache)
    

    這樣,你已經有了一個:

    • Mellum2 做「任務規劃 + 模型/工具選擇」
    • 後端只負責執行計畫的最小可行 workflow

    接下來要擴充,只要:

    • 在 TOOLS / MODELS 裡再加項目
    • 用 few-shot 例子微調 Mellum2 的決策邏輯

    Mellum2 在你的工具箱裡,扮演什麼角色?

    如果從「AI 工作流」角度看,目前常見的組合大致是:

    名稱 核心功能 免費方案 適合誰
    Mellum2 工作流調度、routing、任務拆解 開源可自架 想自己組 AI pipeline,需要細控成本與流程的人
    OpenAI GPT 高品質通用 LLM 有免費額度 需要高品質輸出、但不想自己訓練模型的人
    Claude / Sonnet 對話 & 程式能力強的商用 LLM 有試用 重度寫作、程式輔助、長上下文需求
    本地 LLM(Llama/Qwen) 私有部署、低成本推理 視模型而定 在意隱私或有大批量推理需求的團隊

    Mellum2 並不是另一個「跟你聊天的模型」,而是用來把上面這些工具串起來、排程好、決定誰在什麼時候上場的小模型。

    你可以從一個最小的 routing + 任務規劃範例開始,先讓 Mellum2 管理兩個模型、一支工具,跑順了再往外擴。

    🚀 你現在可以做的事