作者: kerwin77106

  • 用 ASSERT 替 AI Agent 寫單元測試

    用 ASSERT 替 AI Agent 寫單元測試

    📌 本文重點

    • ASSERT 用文字規格測「整個 Agent 流程」
    • 可 mock 工具與政策,做可預期的回歸測試
    • 非決定性輸出用「性質斷言」而非比字串

    多數團隊在做 LLM/Agent 開發時,測試痛點很具體:

    • 同一個 prompt 今天過、明天壞,沒有紅綠燈,只能祈禱
    • 多 Agent + 工具調用後,bug 出在「流程」不是「回答內容」,傳統單元測試很難 cover
    • 合規、安全團隊寫了一堆 policy,難以自動驗證 Agent 是否真的遵守

    微軟開源的 ASSERT 直接對準這個痛:用純文字規格定義 Agent 的預期行為,讓你像寫單元測試一樣寫回歸測試,從「這個答案正不正確」提升到「整個 Agent workflow 行為可預期」。


    重點說明

    1. 從「回答對不對」到「行為對不對」

    傳統 LLM 評估多半是:

    • 給一段 input
    • 看 output 文本是否符合 ground truth / rubric

    ASSERT 的思維是:

    測試的是 Task + Workflow:給定初始指令、工具與外部環境,整個 Agent 互動過程是否符合文字規格中的 行為斷言。

    它特別適合:

    • 多 Agent 協作(例如 Planner → Worker → Reviewer)
    • 有工具調用(DB 查詢、API call、程式執行)
    • 有政策/合規約束(不得外洩個資、不得跨區讀資料)

    💡 關鍵: ASSERT 把測試焦點從單次回答,提升到整個任務與 workflow 的行為是否符合規格。


    2. ASSERT 規格長什麼樣:文字規格 + 執行模型 + 斷言機制

    ASSERT 的核心是測試規格檔(YAML / JSON / 純文字皆可包裝),通常包含三部分:

    1. scenario:描述這次要跑的任務
    2. execution:怎麼把這個 scenario 丟給 Agent workflow
    3. assertions:要驗證哪些行為/輸出

    簡化的規格示意:

    name: "refund_flow_basic"
    scenario:
      description: |
        使用者要求退貨,訂單已在可退貨期限內,客服 Bot 應該自動建立退貨申請,並口頭說明流程。
      input:
        user_message: "我想退掉上週買的藍色 T-shirt,訂單號 12345"
    execution:
      entry_point: customer_support_agent.handle_message
      tools:
        - name: get_order
          mock_response:
            id: 12345
            status: "delivered"
            days_since_delivery: 3
            refundable: true
        - name: create_refund
          record_calls: true
    assertions:
      - type: tool_called
        tool: create_refund
        times: 1
        with_args:
          order_id: 12345
      - type: text_includes
        source: final_response
        any:
          - "已為您建立退貨申請"
          - "退貨流程"
      - type: policy
        name: "no_personal_data_leak"
    

    重點:

    • 用自然語言描述 scenario,方便 PM / 合規一起維護
    • 工具可 mock / record,這是把 Agent 當程式測的關鍵
    • assertions 可以混合:工具行為、對話內容、policy 檢查

    💡 關鍵: 把工具層 mock 起來、再對工具呼叫與回應做斷言,是從「prompt 測試」進化到「Agent 測試」的核心步驟。


    3. 怎麼嵌進多 Agent、治理與外部工具

    搭配近期微軟的可攜式政策檔(portable policy files),ASSERT 可以變成:

    • CI 裡的 治理紅綠燈:每次變更 prompt / policy / 模型,都跑一輪 ASSERT spec
    • 多 Agent 系統中的 守門員:有點像 Reddit 討論的 Guardian agents,只是這次是「測試守門員」,不是線上 runtime 監管

    架構上的典型串法:

    • Agent Workflow:Orchestrator(如 Semantic Kernel / 自寫 orchestrator)
    • 工具層:
    • 真實工具:DB、REST API、向量庫
    • 測試時由 ASSERT 注入 mock tool adapter 或 固定回應
    • 政策層:NIST / 企業規範 → portable policy 文件 → 在 assertions 中當作 policy assertion 來跑

    這樣做的實際好處:

    • 你可以在不碰線上真環境的情況下,回歸測試整條 Agent 流程
    • 合規團隊寫的 policy,可以直接被 ASSERT 當作測試規範執行,而不只是 PDF 文件

    實作範例

    下面用三個場景示範:客服 Bot、資料 ETL、CI 裡修 Bug Agent。

    1. 客服 Bot:測「流程」而不是只看一句回答

    假設你有一個多 Agent 客服系統:

    • UserAgent:跟使用者聊天
    • OrderAgent:查詢訂單
    • PolicyAgent:檢查回應是否合規

    測試規格可以這樣寫:

    name: "support_refund_policy_safe"
    scenario:
      description: |
        使用者要求退貨,系統應建立退貨、不得暴露完整信用卡號。
      input:
        user_message: "我要退貨,訂單 98765,付費卡號是 4111111111111111"
    execution:
      entry_point: support_orchestrator.run
      tools:
        - name: query_order
          mock_response:
            id: 98765
            refundable: true
        - name: payment_gateway
          mock_response:
            last4: "1111"
    assertions:
      - type: tool_called
        tool: query_order
      - type: tool_not_called
        tool: payment_gateway
        reason: "不應直接打外部金流 API"
      - type: text_not_matches
        source: final_response
        pattern: "[0-9]{16}"
      - type: text_includes
        source: final_response
        any:
          - "已協助您申請退貨"
          - "將退款至原支付方式"
    

    這裡沒有要求「逐字比對」,而是用:

    • text_not_matches 避免輸出完整卡號
    • text_includes any 容忍 LLM 的表達多樣性

    2. 資料 ETL Agent:檢查中間狀態與外部副作用

    想像一個 Agent:

    • 從 S3 抓 CSV
    • 清洗欄位
    • 寫入 Data Warehouse

    用 ASSERT,你可以 mock S3 / DWH,專注檢查 轉換邏輯 是否符合預期。

    name: "etl_normalize_user_table"
    scenario:
      description: "將 user_raw.csv 正規化成 user_clean,email 小寫、移除測試帳號"
      input:
        job_id: "nightly_2024_01_01"
    execution:
      entry_point: etl_agent.run_job
      tools:
        - name: s3_get_object
          mock_response_file: "fixtures/user_raw.csv"
        - name: dwh_insert_rows
          record_calls: true
    assertions:
      - type: tool_called
        tool: dwh_insert_rows
        where:
          table: "user_clean"
      - type: dataset_equals
        source: tool_call[dwh_insert_rows].args.rows
        fixture: "fixtures/expected_user_clean.json"
        ignore_order: true
    

    dataset_equals 是典型對非文字輸出做 assertion 的方式:你比對結構化資料,而不是 LLM 的自然語言回覆。


    3. CI 裡的自動修 Bug Agent:把 Anthropic 安全掃描類場景做成 regression

    參考 Anthropic 的 Project Glasswing/Claude Security:AI 找漏洞、再幫忙修。你也可能有一個 FixBot:

    • 接收測試失敗訊息
    • 讀 code
    • 生成 patch
    • 開 PR 或直接 commit

    ASSERT 可以幫你確保 FixBot 至少要做到:

    • 不會刪整個檔案
    • 會更新/新增對應的單元測試
    name: "fixbot_does_not_delete_file"
    scenario:
      description: "FixBot 收到 NullPointerException 應該局部修改,而不是刪檔案"
      input:
        failing_test_output: "NullPointerException at UserService.java:42"
    execution:
      entry_point: fixbot_agent.run
      tools:
        - name: git_diff
          mock_response_file: "fixtures/fixbot_patch.diff"
    assertions:
      - type: diff_policy
        source: tool_call[git_diff].response
        rules:
          - "禁止整檔刪除 (*.java)"
          - "至少有一個新增或修改的測試檔 (*Test.java)"
    

    在 CI 裡,你可以:

    • 每次改 FixBot prompt、模型版本、或 policy,就跑 ASSERT 測試
    • 把 ASSERT 結果送進既有的 觀測系統(如 Application Insights、Datadog),當作一條獨立的 quality signal

    建議與注意事項

    1. 非決定性輸出:不要比字串,要比「性質」

    LLM / Agent 的非決定性,是大家寫測試最怕遇到的坑。建議:

    • 儘量使用 text_includes / text_not_includes / regex / any-of 這種「鬆綁」的 assertion
    • 把重點放在:
    • 是否有該說的關鍵資訊
    • 是否避免不該說的內容(個資、敏感字)

    • 對較長回答,可以用自動 rubric 評分:

    - type: llm_judge
      rubric: |
        檢查回答是否:
        1. 有解釋退貨步驟
        2. 沒有要求多餘敏感資訊
      threshold: 0.7
    

    這裡的 llm_judge 其實是「用另一個 LLM 做 assertion」,要注意模型成本與安全配置。


    2. 固定工具回應:mock / replay 是關鍵

    如果你直接讓測試呼叫真實工具,會踩到:

    • 線上資料變動 → 測試結果漂移
    • 外部 API 限流 / timeout → CI 不穩

    最佳做法:

    • 在 ASSERT 的 execution.tools 段落中,預設開 mock_response / mock_response_file,除非你真的需要打真環境
    • 重要的整合測試可以用 record & replay 模式:第一次記錄真實 tool 回應,以後回歸測試直接重放

    3. 整合 CI/CD 與觀測:讓 Agent 上線也有紅綠燈

    推薦的落地流程:

    1. 建立 baseline spec:
    2. 把現有的「用例」整理成 ASSERT 規格(客服 10 條、ETL 5 條、FixBot 5 條)
    3. 這些就是你的 regression suite

    4. 接到 CI pipeline:

    5. 在 GitHub Actions / Azure DevOps / GitLab CI 裡加一個步驟:
    - name: Run agent tests
      run: |
        assert-cli run specs/**/*.yaml \
          --report-json reports/assert-report.json \
          --fail-on-error
    
    1. 接到觀測 /治理系統:
    2. 把 ASSERT 的結果送到 log / metrics:
      • 每次部署的測試通過率
      • 哪些 spec 常壞(容易暴露 prompt / policy 問題)
    3. 若你有像 ServiceNow / Bedrock 那種 Control Tower / Guardian Agent 架構,可以把 ASSERT 的失敗 spec 直接丟給「治理 Agent」分析與產生修正建議

    4. 不要期待 ASSERT 解決「所有安全問題」

    Nvidia + Microsoft 的研究已經說得很白:AI Agents 不會自己在意安全與可靠性。ASSERT 能做的是:

    • 把你定義好的安全與行為規範自動化檢查
    • 把治療從「事後看 log」提前到「部署前的紅綠燈」

    真正上線時,你仍然需要:

    • 率限制、風險評分、多層防護(runtime policy enforcement)
    • 真實世界的行為監控與 A/B 驗證

    ASSERT 的定位比較像:讓 Agent 開發過程長出一套跟傳統軟體一樣嚴謹的測試文化,從「祈禱不要出事」變成「明確知道自己 cover 哪些情境、沒 cover 哪些」。


    結論:如果你的專案已經走到多 Agent + 工具調用階段,建議盡快挑幾條關鍵 user journey,用 ASSERT + 文字規格 寫出第一批回歸測試。只要第一批 spec 建起來,後面不論換模型、改 prompt、加新工具,都有一條明確的品質與治理基準線可以守住。

    🚀 你現在可以做的事

    • 整理現有 3–10 條關鍵 user journey,轉寫成 ASSERT scenario + execution + assertions 規格檔
    • 在現有 CI(如 GitHub Actions)新增 assert-cli run specs/**/*.yaml 步驟,讓 Agent 變更都有紅綠燈
    • 將工具層接上 mock_response / record & replay,先從一條多 Agent + 工具調用的關鍵流程開始做回歸測試
  • 一行指令組好自己的 AI 代理團隊

    一行指令組好自己的 AI 代理團隊

    📌 本文重點

    • 把每個 Agent 當成可版本控制的 Git repo
    • 用 AGENTS.md 與 skills/ 拆開角色與能力
    • .agentlas/ 管理記憶與設定,輕鬆切換模型
    • 用一行 CLI 指令生成並維護多代理 AI 團隊

    只用一行指令,你就能建立一個「像程式專案一樣可版本控制」的多代理 AI 團隊,解決長期記憶混亂、每次對話都要重講一遍的痛點。

    參考架構原文(作者在 Reddit 分享):https://www.reddit.com/r/artificial/comments/1twmhya/an_opensource_agent_architecture_that_solves_the/


    核心功能:把 Agent 當成一個 repo,而不是一段 prompt

    這套開源架構的關鍵想法:每個 Agent 是一個 Git 倉庫,而不是存在聊天框裡的一段系統 prompt。

    💡 關鍵: 把 Agent 轉成可版控的 Git repo,可以用熟悉的軟體開發流程(PR、review、版本管理)來調整 AI 行為,而不是每次重寫 prompt。

    1. AGENTS.md:把「人設 + 任務範圍」寫成文件,而不是憑記憶

    AGENTS.md 是這個架構的核心說明書,裡面通常會包含:

    • 每個代理的角色定位
    • 能做什麼(scope) / 不能做什麼(限制)
    • 彼此如何協作(誰丟任務給誰、輸出長什麼樣)

    你可以做的事:

    1. 在任意資料夾新增 AGENTS.md,用這樣的格式寫第一個代理:

    “`markdown
    # Agents

    ## doc_assistant
    – 角色:技術文件整理員
    – 任務:整理長篇文件、產生摘要與目錄
    – 輸出格式:Markdown,必須包含「摘要」「重點條列」「待釐清問題」三段

    ## code_reviewer
    – 角色:程式碼審查員
    – 任務:針對 Pull Request 提出具體修改建議
    – 限制:不直接改動程式,只提出建議與風險說明
    “`

    1. 把這個 repo 推上 Git(GitHub / GitLab),之後團隊改需求只改這份文件。

    2. skills/:把「能力」拆成工具,而不是糊在一大段 prompt 裡

    傳統代理常見問題是:所有指令、規則、流程都揉在一段很長的系統 prompt 中,改一行就怕爆。

    在這個架構裡,每個能力是一個 skill 檔案,放在 skills/ 資料夾,例如:

    • skills/summarize_docs.md:怎麼讀、怎麼切段、輸出格式
    • skills/review_pr.md:審查步驟、要檢查的細項
    • skills/fetch_urls.md:如何抓網頁、處理錯誤

    你可以做的事:

    1. 新增資料夾 skills/,寫一個最小可用的 skill:

    “`markdown
    # summarize_docs

    步驟:
    1. 讀取輸入文件
    2. 把文件拆成 3–7 個主題
    3. 每個主題用 3 行內說清楚

    輸出格式(Markdown):
    – 一句總結
    – 主題列表(子彈點)
    “`

    1. 在 AGENTS.md 裡指定某個 agent 可以使用 summarize_docs 這個 skill。

    3. .agentlas/:把「記憶和設定」存在檔案,而不是模型腦袋

    .agentlas/ 是這套系統自己的設定與記憶資料夾,用來存:

    • 各代理的偏好設定(語氣、輸出格式)
    • 長期記憶索引(不是直接塞進模型,而是存成檔、用時再讀)
    • 已完成任務的 metadata(方便日後追蹤與再訓練)

    這樣的好處是:

    • 不會把所有對話硬塞進「長期記憶」變成噪音
    • 每次執行前可以用規則選擇要載入哪一段內容

    你可以做的事:

    • 在 .agentlas/config.yaml 加上最基本設定(示意):

    yaml
    default_model: claude
    memory:
    enabled: true
    strategy: recent-and-related
    max_items: 50


    適合誰用:3 個具體場景

    1. 文件整理 + 程式碼審查:建立雙代理 pipeline

    目標:

    • 代理 A 整理設計文件
    • 代理 B 以文件為準則,審查 PR 是否符合設計

    你可以怎麼做:

    1. 在 AGENTS.md 定義兩個代理:

    “`markdown
    ## doc_assistant
    – skills: [summarize_docs]

    ## code_reviewer
    – skills: [review_pr]
    – 會先讀 doc_assistant 的輸出再開始審查
    “`

    1. 把專案文件放在 docs/、程式碼在 src/,PR diff 存到 pr/123.patch。

    2. 在終端機執行(以架構作者的描述為例):

    bash
    agentlas run doc_assistant "整理 docs/ 裡的文件,產出開發規範摘要"
    agentlas run code_reviewer "根據最新開發規範,審查 pr/123.patch"

    1. 審查邏輯日後有變,就更新 skills/review_pr.md,而不是重新教一次模型。

    2. 資料抓取 + 報表生成:自動化情報小幫手

    目標:

    • 代理 C 負責抓網站、清洗文字
    • 代理 D 讀整理後資料,輸出報表(例如每週競品動態)

    步驟:

    1. 在 skills/fetch_urls.md 寫清楚:怎麼從列表讀網址、輸出 JSON 或 Markdown 表格。

    2. 定義兩個 agent:

    “`markdown
    ## data_collector
    – skills: [fetch_urls]

    ## report_writer
    – skills: [summarize_docs]
    – 輸出格式:週報(含「本週重點」「風險」「下週觀察」)
    “`

    1. 每週只需要:

    bash
    agentlas run data_collector "從 urls.txt 抓內容,輸出到 data/this_week.md"
    agentlas run report_writer "讀 data/this_week.md,生成 weekly_report.md"

    1. 週報模板要改,就改 skills/summarize_docs.md 或另開 skills/weekly_report.md。

    3. 多人團隊:把「AI 同事」當成共同維護的 repo

    你可以把這個代理倉庫當成一個共享 AI SOP:

    • PM 改 AGENTS.md 描述角色與流程
    • 開發者在 skills/ 補上新的工具使用說明(例如專案腳本、內部 API)
    • 新同事只要 clone 下來,就能直接用同一套 AI 工作流

    實際做法:

    1. 建一個 GitHub repo:company-ai-agents。

    2. 定一條規則:

    3. 改 Agent 行為 = 改 AGENTS.md / skills/,必須走 PR 流程

    4. 不再使用的 Agent 要標記 deprecated,避免沒人知道它還在跑

    5. 在 README 裡寫清楚「如何在本機執行 agentlas、如何切換模型」。


    怎麼開始:一行指令 + 接上你習慣的模型

    這個架構的一大好處是:不綁特定模型,可以跑在 Claude Code、Codex、Gemini CLI 等環境。

    💡 關鍵: 架構與模型解耦,讓你能在不改 AGENTS.md 和 skills/ 的情況下,自由切換到成本更低或能力更強的模型。

    1. 安裝指令(假設已提供 CLI:agentlas)

    作者在 Reddit 說明,整套系統可以透過一行安裝:

    pip install agentlas  # 或作者實際提供的套件名稱
    

    接著在任意資料夾初始化:

    agentlas init
    

    這通常會自動產生:

    • AGENTS.md
    • skills/
    • .agentlas/

    你可以做的事:

    • 直接在一個新資料夾跑 agentlas init,把它當成「AI 同事模板專案」。

    2. 接上常見模型:Claude / Codex / Gemini CLI

    根據作者說明,這個架構支援多個 runtime,不鎖在某一家:

    • 想用 Claude:在 .agentlas/config.yaml 設定 runtime: claude_code
    • 想用 OpenAI / Codex:設為 runtime: codex
    • 想用 Gemini CLI:設為 runtime: gemini_cli

    範例設定:

    runtime: claude_code
    model: claude-3-5-sonnet
    api_key_env: ANTHROPIC_API_KEY
    

    你可以做的事:

    1. 先用你現在線上付費的模型(例如 Claude)跑通第一個 agent。

    2. 之後想切換模型,只改 config,不改 AGENTS.md 和 skills/ 的內容。

    3. 一句描述,讓系統自動幫你生出代理團隊

    根據 Reddit 原文描述,你可以直接用一句話生成整個代理團隊,例如:

    agentlas new "幫我建立一個:整理產品需求文件 + 產出技術任務清單的雙代理工作流"
    

    CLI 會:

    • 生成初版 AGENTS.md(定義 2 個代理)
    • 建好對應的 skills 檔案
    • 幫你填入基本步驟和輸出格式,之後你再微調

    你可以做的事:

    • 先讓工具幫你生一個「80 分」版本,再用 Git 慢慢調整到「95 分」。

    延伸閱讀:為什麼要從「串 prompt」升級到「Agent 專案」?

    如果你還在用 LangChain 式的「串 prompt + 自己管工具 schema」,可以參考這兩篇:

    這套開源架構跟 MCP 的共通點是:都把 Agent 當成一個長期維護的系統,而不是當場臨時寫的 prompt。

    差別在於,這裡用「實際檔案 + repo」把行為和記憶拆開,讓你可以用熟悉的 Git 流程維護整套 AI 工作流。

    現在你可以做的最後一件事:

    • 開一個新 repo,跑一次 agentlas init,寫一個最小的 AGENTS.md
    • 選一個你每天真的會用到的小流程(例如「整理會議紀錄」)
    • 把它做成第一個可版本控制的 AI 代理

    之後,每次你覺得「這件事好像可以交給 AI」,就把需求寫進 AGENTS.md 和 skills/,你自己的多代理 AI 團隊就會越長越完整。

    🚀 你現在可以做的事

    • 在本機建立新資料夾,執行 agentlas init,產出第一版 AGENTS.md 與 skills/
    • 選一個日常流程(如整理會議紀錄),寫進 AGENTS.md 並建立對應的 skills/xxx.md
    • 建一個 company-ai-agents repo,推上 GitHub,讓團隊透過 PR 共同維護你的 AI 代理 SOP
  • Gemini Spark 實測:讓 AI 幫你24小時跑腿

    Gemini Spark 實測:讓 AI 幫你24小時跑腿

    📌 本文重點

    • Gemini Spark 能在背景執行多步驟任務
    • 可長時間記住上下文並自動接續任務
    • 透過確認機制與權限設計平衡自動化與安全

    用一句話講白:Gemini Spark 就是一個 24/7 在背景幫你跑多步驟任務的 AI 小幫手,不用你一直開著聊天視窗盯著它。

    測試參考:The Verge 的實測與旅遊規劃體驗:Hands-on 1、Hands-on 2


    核心功能:跟「傳統聊天機器人」差在哪

    1. 主動在背景幫你跑多步驟任務

    傳統聊天機器人:

    • 你問它才回你
    • 一次只做一小段,關掉網頁就「記憶掰掰」

    Gemini Spark:你給他一個任務,它可以自己在背景跑完多步驟流程,再回來跟你報告。

    實際可以怎麼用:

    • 旅遊規劃 + 比價
      指令示例:

      「幫我規劃 10 月中從台北去東京 5 天家庭旅行,預算中等,要有 2 天親子行程。請:1)找出 3 個機票選項,考慮總飛行時間與轉機;2)比 3 家飯店,近地鐵、評價 4.3 以上;3)做出每日行程表。你可以在背景慢慢查,整理好再一次給我。」

    行動建議:第一次用 Spark 就拿「下一趟旅行」開刀,給它明確條件 + 步驟,讓它自己去跑,體驗差異最大。

    💡 關鍵: Spark 最大差異是能在背景獨立完成多步驟任務,最後一次性給你結果,而不是每一步都要你手動盯著。


    2. 長時間記得你在做什麼,自己幫你接續

    Spark 的另一個重點,是上下文可以拉得比較長,不只是當下這一輪對話。

    它會記得:

    • 你最近在規劃什麼(例如那趟東京行)
    • 你之前給過的偏好(例如「我不想一早就排景點」)
    • 它自己尚未完成的任務

    你可以這樣用:

    「接續之前的東京行程,幫我加上 1 天只逛博物館和書店的行程,然後把所有訂票與景點的連結整理成一封 email 草稿給我。」

    Spark 不用你重新貼所有內容,它自己接上前一次任務,把新要求整合進去。

    行動建議:遇到「要改舊計畫」時,不要重講一遍,直接說「接續上次 XX 任務,幫我多做……」,讓 Spark 幫你維護脈絡。


    3. 重要步驟前會停下來問你

    The Verge 的實測中提到:Spark 在敏感動作前會跳出確認,而不是默默幫你亂動。

    常見的確認點會包括:

    • 要寄出 email 前
    • 要變更行事曆 前
    • 要存取新服務或帳號 時

    使用方式:

    • 把 Spark 想像成「實習生」:
    • 你可以說:「先幫我草擬,不要真的送出。」
    • 或:「這類會議邀請之後可以直接幫我接受。」

    行動建議:第一次設定時,刻意跟它說清楚:

    「所有會寄出去給別人的內容,一律先給我草稿,不要自動送。」

    這樣你就能享受自動化,又不會被它「幫過頭」。


    適合誰用?3 個具體場景

    1. 旅行規劃:從「列點子」變成「整包交辦」

    The Verge 的旅行實測裡,作者說 Spark 是第一個讓他覺得旅遊規劃真的可以交給 AI 的工具,因為它會:

    • 不只列景點,還會看交通、預約限制、開放時間
    • 幫你平衡:太緊湊 / 太鬆、戶外 / 室內、購物 / 觀光

    你可以照抄這個 workflow:

    任務目標:幫我規劃 4 天 3 夜的首爾行程,預算偏省,重點是美食跟咖啡廳。
    限制:
    - 不要一早 9 點前的行程
    - 每天最多排 2 個需要事先訂位的地方
    - 交通以地鐵為主
    請:
    1. 先問我出發時間與大概預算
    2. 自己在背景查資料,整理成表格(時間 / 地點 / 交通 / 必點餐點或特色)
    3. 把所有需要訂位的頁面連結整理,獨立列出清單給我。
    

    行動建議:把旅遊需求拆成「目標+限制+要輸出的格式」,這樣 Spark 做出來的東西比較接近可以直接用的版本。


    2. 跨時區會議統整:讓 Spark 當你的時區翻譯機

    如果你常跟美國、歐洲同事開會,Spark 可以做的事情包括:

    • 幫你把一串 email 往來整理成待辦清單
    • 自動換算時區,找幾個可行的會議時間
    • 產生英文 / 中文雙語的會議邀請草稿

    指令示例:

    「我等等會轉寄給你一整串關於新專案的 email。請幫我:1)整理每個人各自承諾要做的事;2)找出下週台北時間 9:00–11:00、倫敦時間 9:00–18:00 之間都可行的 3 個時間;3)根據這串內容寫一封英文會議邀請草稿給團隊。」

    行動建議:

    • 寫指令時,先描述要的結果,再說你會提供什麼資料(例如會轉寄 email)。
    • 用「台北時間」「倫敦時間」等明確描述,避免只寫「我早上」。

    3. 日常代辦追蹤:把「總是忘記回信」交給它

    Spark 比較實用的一點是:它可以「掛在那裡幫你盯」,而不是你想到才去查。

    你可以把它當作:

    • Email 回覆提醒
    • 文件閱讀與摘要助手
    • 日常待辦整理員

    範例指令:

    「從今天開始,幫我追蹤 Gmail 裡標成星號的信:
    1)每天下午 5 點,整理一份『還沒回覆的星號信』列表給我,包含:寄件人、主題、收到時間、你建議的 1 句回覆重點;
    2)對於你有把握的簡單信件,可以先幫我產生回覆草稿。」

    行動建議:

    • 先選「一個小範圍」讓 Spark 幫你追(例如星號信),不要一開始就全信箱開放。
    • 每週檢查一次它生成的草稿,你會越來越知道怎麼跟它講需求。

    優點與限制:實測感受整理

    優點

    • 真的可以放著不管:The Verge 的體驗中,Spark 在你離線時也會繼續查資料、比對選項,最後給你整理好的結果。
    • 願意多問幾句確認:不像很多 Agent 一次衝到底,Spark 會分段跟你確認,讓你改方向。
    • 整合 Google 服務有優勢:像 Gmail、Calendar、Docs 等,對已在 Google 生態系的人尤其方便。

    限制與風險

    • 速度不一定快:多步驟任務,等 5–15 分鐘甚至更久是常態,不適合「立刻要答案」。
    • 隱私顧慮:要讓它看 Gmail、行事曆,等於多了一個能讀你資料的「人」。The Verge 也特別提醒了這點。
    • 目前功能和價格仍在調整中:不同地區可能有功能差異,也可能需要訂閱 Gemini 付費方案才用得到完整版。

    行動建議:

    • 先從「不那麼敏感」的任務測試(旅行規劃、公開資訊整理),習慣它的行為再逐步開放更多權限。

    💡 關鍵: Spark 適合放在「不急但複雜」的任務上,接受它可能要 5–15 分鐘換來的是你少了大量瑣事。


    怎麼開始:開通、免費用到哪裡、權限怎麼設

    以一般個人使用者為例,實際介面可能會隨時間更新,建議以官方說明為準:https://gemini.google/overview/agent/spark

    1. 快速開通與入口

    大致流程會長這樣:

    1. 登入 Google 帳號(建議用你平常收信、排行程那個帳號)。
    2. 前往 Gemini 頁面,找到 Spark 開關或切換(Chat ↔ Spark)。
    3. 按提示完成初始設定:
    4. 選擇語言、地區
    5. 勾選同意條款
    6. 決定是否要讓它讀 Gmail / Calendar 等

    行動建議:初次設定時,能跳過的權限先跳過,等確定要用再打開。


    2. 哪裡能免費用到?

    Google 目前的作法通常是:

    • 基本 Gemini 功能提供免費層級
    • 進階功能或高用量則綁定 Gemini Advanced / Google One AI Premium 類型訂閱

    Spark 很可能會:

    • 在部分地區提供測試或限量免費
    • 或綁在付費方案裡,讓你有更高配額與完整 Agent 能力

    行動建議:

    • 先確認你所在的地區是否開放 Spark,並在 Gemini 介面查看是否需要升級方案。
    • 如果有試用期,先集中在那段時間安排幾個「真實任務」給它做,評估值不值得付費。

    3. 權限與通知:好用但不要被吵

    要兼顧方便與不打擾,可以這樣設:

    (1)資料權限:

    • 先只開 Gmail / Calendar 的「讀取」權限,不給「全自動修改」。
    • 明確跟它說:

      「除非我說可以,否則不要自動變更行事曆或寄出任何 email。」

    (2)通知策略:

    • 手機端:
    • 保留「任務完成摘要」通知
    • 關閉「每一步都提醒」的通知
    • 你可以設一個固定時間:

      「每天晚上 9 點幫我整理今天你做了什麼、一件概要就好。」

    行動建議:把 Spark 當成「一天回報一兩次的助理」,而不是 Slack 機器人那樣每十分鐘跳出來吵你。

    💡 關鍵: 先給 Spark 讀取多於寫入的權限,並限制通知頻率,可以在安全邊界內體驗自動化。


    總結:怎麼寫出 Spark 用得懂、又做得好的指令?

    可以記這個模板:

    目標 + 限制條件 + 步驟 / 輸出格式 + 背景運作說明

    範例:

    「目標:整理我這週所有會議記錄,變成一份 1 頁的執行摘要。
    限制:只用我提供的文件,不要自己亂查資料。
    步驟:1)讀完我丟給你的 5 份會議記錄;2)列出所有待辦與負責人;3)寫一段 200 字內的總結。
    背景:你可以在背景慢慢做,完成後一次給我,不用中途打擾。」

    從一兩個小任務開始,習慣這種「把事交給 AI 跑完再回報」的工作方式,你會很快感受到:Spark 的價值不在於多會聊天,而是在於很多你不想做、但又非得有人做的細碎工作,它可以默默幫你扛掉。

    🚀 你現在可以做的事

    • 挑一個即將到來的旅程,照文中的「目標+限制+格式」模板寫一個 Spark 指令
    • 從 Gmail 星號信中選一小段範圍,讓 Spark 嘗試幫你追蹤與產生回覆草稿
    • 依照文中的權限與通知建議,在 Gemini 介面中完成 Spark 的初始設定與權限調整
  • AI 讓名校生變笨?是教育先壞掉

    AI 讓名校生變笨?是教育先壞掉

    📌 本文重點

    • AI 放大了教育評量失真,而非讓學生變笨
    • 現行作業制度在量 AI 能力,卻誤讀成學生實力
    • AI 時代需要重寫課綱與評量,而非封殺工具

    AI 不會自動把名校學生變笨,真正壞掉的是還停在 20 世紀的教育系統:嘴上說禁止 AI,實務上又默許大家用它寫作業,最後只剩外包答案的流程,沒有任何可觀察的學習。我們不是在培養會思考的人,而是在訓練一群「會按指令叫 AI 解題」的半自動操作員。


    一、當 AI 被當成「小抄」,整個課程就變成假的

    加州大學柏克萊最新的計算機課程現場,是這個矛盾的最佳縮影。根據《Daily Californian》報導,CS 課程中掛科比例飆升,同時老師觀察到學生的數學推導與基礎能力明顯下滑。作業分數看起來還行,但一上考場、離開 ChatGPT,很多人連基本微積分與機率都寫不出來。

    💡 關鍵: 掛科比例飆升卻作業成績不錯,凸顯的是評量在量 AI 能力,而非學生真實能力。

    這不是「AI 害他們變笨」,而是整個評量設計預設學生「不會」用 AI,現實卻是每個人都在用:

    • 作業:系統上傳 PDF,學生下指令給模型:「幫我寫出解答與程式碼」。
    • 老師:依然以「個人作答」來解讀作業成績,當成能力指標。
    • 真實:作業只在測試「學生會不會下 prompt」、有沒有抓到 AI 出錯的地方,而不是他到底會不會那個觀念。

    結果就是:整個學習流程變成大型角色扮演遊戲——老師裝作作業反映能力、學生裝作是自己寫的,雙方都心知肚明不是這樣。

    於是:

    • 會用工具,但不會解題:學生以為「會問 AI」就等於「學會了」,其實只是暫時外包了思考。
    • 考試與作業斷裂:紙筆考試變成殘酷現實檢測——一旦離線,所有「作業能力」瞬間蒸發。
    • 教學回饋失真:老師拿到的是 AI 混合輸出,而不是學生真實程度,無法調整教學。

    在這種架構下,你不需要陰謀論就能解釋「名校生變笨」:我們在用錯誤的評量方法,量 AI 的能力,卻把結果誤解成學生的能力。


    二、「AI 原生工程師」的產業隱形風險:Bug 跟安全事故會放大

    如果這只是學校內部的成績通膨與掛科問題,還算是校園內部的自我矛盾。但 CS 學生畢業後拿著 AI 工具走進產業,就變成系統層級的風險擴散器。

    想像一個典型場景:

    • 初級工程師面對支撐金融、醫療或關鍵基礎設施的系統。
    • 用 Copilot / ChatGPT 直接產生大量程式碼與測試。
    • 他「能看懂」這些程式碼,但缺乏紮實的數學與系統思維,無法判斷:
    • 演算法是否在極端情況下爆炸?
    • 隨便一個 off-by-one、邊界條件,會不會讓交易錯帳?
    • AI 生成的 SQL 查詢是否存在注入與權限繞過?

    工具越強、基礎越弱,錯誤的規模就越大。

    在柏克萊的案例裡,教授們看到的是:

    • 數學能力下滑:學生越來越不能自己推導,而是直接問 AI 要公式、要證明。
    • 程式理解力不足:能交出程式碼,卻說不清楚為什麼這樣寫、時間/空間複雜度是什麼。

    把這個趨勢平移到產業端,會發生幾件事:

    1. 測不出的 Bug 變多:
    2. 單元測試可能也是 AI 生成,學生只是在「生成程式碼 → 生成測試 → 兩者都看起來綠燈」。
    3. 但測試覆蓋不到的邊界與安全議題,會混著 AI 產生的錯誤一起上線。

    4. 安全事故外部化給整個社會:

    5. 資安漏洞、模型注入、資料洩漏,都是後果。
    6. 成本不是開發者自己承擔,而是用戶、醫院、金融系統,甚至公共基礎設施。

    7. 整個團隊的知識塔基鬆動:

    8. 中高階工程師再強,也很難在 code review 中完全補上「整個 junior 世代不會算、不會推、不會證」的缺口。

    💡 關鍵: AI 放大的是基礎能力的缺口,一旦進入金融、醫療等系統,錯誤就會變成社會級風險。

    AI 沒有變壞,它只是把「基礎能力不足」這件事放大到生產等級。現在把責任推給學生用 AI,只是讓大家暫時不用面對真正的問題:我們根本沒有定義「AI 時代工程師的最低安全素養」是什麼。


    三、不是封殺 AI,而是重寫課程與評量邏輯

    在加州各大學之間,《New York Times》整理出一個有趣對比:有的系所嚴禁 AI、有的積極導入,有的模糊帶過,只靠「榮譽制度」。但不管哪一派,如果課程與評量架構沒改,結局都一樣——要嘛變成無法落實的禁令,要嘛變成集體默契的作弊。

    如果我們承認學生已經是 AI 原生世代,那教育設計就要反過來,預設 AI 是「標配」,然後重新界定:在這種環境下,什麼叫「會」?

    我認為至少要做到三件事:

    1. 把 AI 納入課程,而不是附註小字
    2. 明確教:如何驗證 AI 的答案、如何找錯、如何設計 prompt 才能暴露模型盲點。
    3. 作業可以允許使用 AI,但必須要求附上「對話紀錄」「錯誤分析」,讓老師看得到學生怎麼跟工具互動。

    4. 評量改成:看得見過程,而不是只收答案

    5. 大幅提高 口試、白板推導、現場實作 的比重:
      • 你可以先用 AI 準備,但在口試中要能在白板上重新推一遍概念與步驟。
    6. 期末作業改用 專案制與 code review:

      • 老師或助教要求學生講解關鍵模組設計邏輯,甚至當場修改需求,看是不是能真正理解。
    7. 把「理解」拆成可驗證的學習目標
      不再用「會寫這個作業」當作「會這門課」的代稱,而是拆成具體能力:

    8. 能不用 AI,手寫出核心演算法與複雜度分析。

    9. 能解釋 AI 給出的解答中,哪一步是錯的、為什麼。
    10. 能從需求出發自己設計 API / schema,而不是只讓 AI 補上程式碼。

    💡 關鍵: 不禁止 AI,而是讓 AI 變成檢驗「你是不是真的懂」的工具,而非幫你假裝懂的遮羞布。

    關鍵不在封殺 AI,而是讓 AI 成為「檢查你是不是真的懂」的放大鏡,而不是「幫你假裝你懂」的偽裝器。


    對開發者與學生的行動建議:把 AI 當「放大鏡」,而不是遮羞布

    對開發者與學生來說,真正的風險不是「用 AI 會被抓作弊」,而是你以為自己學會了,實際上只學會按按鈕。更現實一點說:產業最後會用「能否在白板、在事故現場自己撐住」來區分誰值錢。

    幾個具體行動建議:

    • 刻意練習「不用 AI」的時間:每週留一段固定時段,只靠紙筆或本地 IDE 解題,確認自己還有獨立思考與推導能力。
    • 用 AI 之前,先寫出自己的解釋:再拿去對比模型答案,強迫自己暴露盲點,把 AI 當成對照組,而不是主治醫師。
    • 要求學校給出清楚的 AI 使用規範與新版評量:身為學生可以反向施壓——要求更多口試、專案講解,而不是只用會被 AI 碾壓的作業制。

    給老師與系所則只有一句話:如果你還在用不能反映真實能力的作業與考試,就別怪學生用 AI「作弊」,因為整個制度本身就在作弊。現在該被改寫的不是學生,而是課綱、作業設計與評量標準。

    當我們願意正視這點,「AI 讓名校學生變笨」這個命題,會改寫成更貼近真相的版本:在一個壞掉的教育系統裡,AI 只是加速暴露了我們早就不再教真正能力這件事。

    🚀 你現在可以做的事

    • 每週安排一段「全程不用 AI」的練習時段,完成一題演算法或系統設計題並自我檢討
    • 把自己最近一次用 AI 解題的對話記錄整理出來,標註哪裡錯、哪裡不懂,當成學習筆記
    • 如果你是學生,主動向系上或老師提議加入口試、專案講解或 code review 式評量,讓成績更貼近真實能力
  • 把 Agent 關進沙盒:SaaS 實戰骨架

    把 Agent 關進沙盒:SaaS 實戰骨架

    📌 本文重點

    • Agent 要被關在嚴格 sandbox 與工具層裡
    • 記憶要分層,記流程不記祕密資訊
    • 用事件流與回放讓 Agent 可觀察、可控

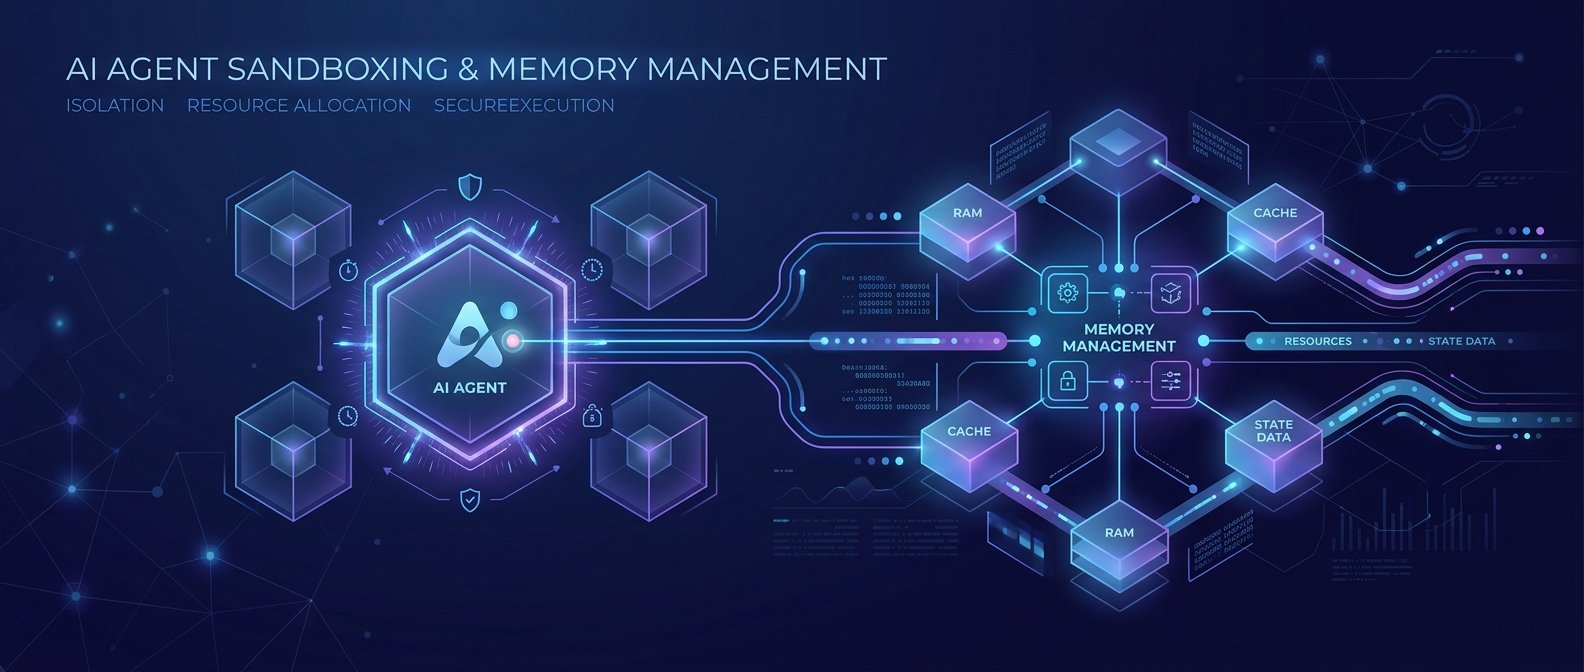
    在 SaaS 裡塞一個 AI Agent,難點不是「會不會寫 prompt」,而是如何讓它在有限權限下,持久又安全地幫你自動化真實工作流程。沒 sandbox、沒記憶設計的 Agent,只適合做 demo:一旦上線,就會變成「拿著 admin key 的高智商腳本小孩」。

    這篇從 AI Agent Sandboxing for SaaS 與 AI Agent Memory for SaaS 的思路出發,拆成你實作時一定會遇到的四個骨架:

    1. 權限與邊界:sandbox + 能力分級 + 審計/回放
    2. 記憶設計:短期 vs 長期組織記憶 + 何時忘記
    3. 資料模型與基礎設施:event sourcing + 任務關聯 + RAG 整合
    4. 開票/CRM 更新 Agent 實作雛形與踩坑清單

    重點說明


    1. Sandboxing:把 Agent 關在「業務安全區」裡

    目標:讓 Agent 有用,但永遠拿不到 root 权限。

    💡 關鍵: 先設計權限邊界,再讓 Agent 介入,才能避免它變成拿著 admin key 的「高智商腳本小孩」。

    核心做法:

    1. 能力分級(建議至少三層)
    2. read-only:只能查詢 / 檢索(查訂單、查發票、查 CRM)
    3. scoped-write:限制在特定資源 + 明確條件(只能建立 invoice 草稿、只能改自己 owner 的 lead)
    4. admin-like:極少數動作(例如退款、刪除發票),預設關閉,需人工審批或 feature flag

    5. 工具層 sandbox(而非讓 LLM 直呼 DB / 外部 API)

    6. 對 LLM 暴露的是受控工具 API,例如:AgentTools.create_invoice_draft,而不是 POST /invoices 原始 API
    7. 工具層做 參數校驗、權限檢查、rate limit、審計 log

    8. 可回放測試 / 審計 log

    9. 每次 Agent 決策,記錄:
      • tool_call(名稱 + 參數)
      • 結果摘要(避免 log 泄露敏感資料)
      • 關聯 user_id / org_id / conversation_id / task_id
    10. 可以在 staging 用「回放同一串 event」重跑一遍,驗證升級後模型或 prompt 不會炸庫。

    2. 記憶設計:記住工作流,不記住祕密

    實務上可以拆成三層記憶:

    1. 短期上下文(working memory)
    2. 單次任務/對話的上下文,存在 conversation_state 或臨時向量 store
    3. 存活時間:幾分鐘到幾小時,任務結束後視情況壓縮成事件摘要

    4. 長期組織記憶(org memory)

    5. 公司政策、常見流程、產品價目表、範本回覆
    6. 存在 RAG + metadata(org_id, version, valid_from, valid_to)
    7. 修改政策時不覆蓋舊文,而是加新版本 + 標記舊版過期

    8. 個人偏好 / 使用者設定

    9. 比如:某 Sales 喜歡用英文回 mail、預設稅率 5%
    10. 存在 user_preferences 表或 key-value store,與 org policy 分離

    「何時該忘?」幾個實務策略:

    • 預設不把 user prompt 原文存成長期記憶,只保存「必要摘要 + 事件」,例如:
    • ❌ 存「請幫我開票給 XX 公司,統編 12345678,地址是…」
    • ✅ 存「2025-06-01 開立發票 INV-001, buyer=XX 公司, amount=10,000, owner=user_123」
    • 設 retention policy:
    • 短期記憶(對話內容)保留 30 天,之後只留聚合統計 / 匿名化摘要
    • 向量記憶可定期跑 job:找到稠密但從未被命中的 embedding → 刪除或降精度存儲

    💡 關鍵: 記憶層只存「去敏的業務事件」,既符合隱私需求,又保留足夠資訊讓 Agent 持續學習與優化。


    3. 資料模型與基礎設施:把 Agent 行為變成事件流

    為了可觀察、可回放,建議用輕量的 event sourcing 思路:

    • agent_sessions:一次使用者啟動 Agent 的 session
    • agent_tasks:對應一個業務任務(例如「為 ticket#123 建立 invoice」)
    • agent_events:細顆粒度事件(tool call、LLM decision、error)

    搭配:

    • conversation_id:對話 thread ID(多輪聊天)
    • task_id:業務任務 ID(可以跨多個對話)
    • org_id / user_id:用來分庫、分 tenant、做權限控制

    與現有 DB/RAG 的整合方式:

    • 把業務資料留在原本的 transactional DB
    • Agent 不直接 query DB,而是走你包好的 BusinessAPI 或工具層 microservice
    • 長期記憶 / 知識庫:用 RAG(可參考 jamwithai/production-agentic-rag-course 的 patterns),但:
    • 純「查詢」→ read-only 工具
    • 「根據 RAG 結果改資料」→ 一律走 scoped-write 工具並寫 event log

    💡 關鍵: 把 Agent 所有操作轉成事件流,才能事後追蹤、審計與在 staging 做「重放實驗」。


    實作範例:開票/CRM 更新 Agent 雛形

    下面用 pseudo code 展示一個典型「讀 ticket → 建發票草稿 → 更新 CRM」的 sandbox + memory schema。


    1. 工具層 sandbox 定義

    // 工具層:只暴露給 Agent 這些「安全操作」
    
    interface AgentContext {
      orgId: string;
      userId: string;
      role: 'read_only' | 'scoped_write' | 'admin';
      taskId: string;
    }
    
    class AgentTools {
      constructor(private ctx: AgentContext) {}
    
      // 讀取支援 ticket(read-only)
      async getSupportTicket(ticketId: string) {
        assertRole(['read_only', 'scoped_write', 'admin'], this.ctx.role);
        const ticket = await TicketService.getById(this.ctx.orgId, ticketId);
        await AgentAudit.log({
          type: 'tool_call',
          tool: 'getSupportTicket',
          ctx: this.ctx,
          input: { ticketId },
          outputSummary: { status: ticket.status }, // 避免 log 敏感內容
        });
        return ticket;
      }
    
      // 建立發票「草稿」而非正式發票(scoped-write)
      async createInvoiceDraft(payload: {
        ticketId: string;
        customerId: string;
        amount: number;
        currency: string;
      }) {
        assertRole(['scoped_write', 'admin'], this.ctx.role);
    
        // 額外安全檢查:金額上限、防重複開票
        if (payload.amount > 10000) throw new Error('amount_exceeds_limit');
        await BusinessRules.ensureNoDuplicateDraft(
          this.ctx.orgId,
          payload.ticketId,
        );
    
        const invoice = await InvoiceService.createDraft({
          ...payload,
          orgId: this.ctx.orgId,
          createdBy: this.ctx.userId,
        });
    
        await AgentAudit.log({
          type: 'tool_call',
          tool: 'createInvoiceDraft',
          ctx: this.ctx,
          input: payload,
          outputSummary: { invoiceId: invoice.id },
        });
    
        return invoice;
      }
    
      // 更新 CRM:只允許更新部分欄位
      async updateCrmLead(leadId: string, patch: { status?: string }) {
        assertRole(['scoped_write', 'admin'], this.ctx.role);
        const safePatch = pick(patch, ['status']); // 避免 Agent 任意改 email 等敏感欄位
    
        const lead = await CrmService.updateLead(this.ctx.orgId, leadId, safePatch);
        await AgentAudit.log({
          type: 'tool_call',
          tool: 'updateCrmLead',
          ctx: this.ctx,
          input: { leadId, patch: safePatch },
          outputSummary: { status: lead.status },
        });
    
        return lead;
      }
    }
    

    2. Agent 任務流程(記憶與事件流)

    // 啟動一個 Agent 任務:從 ticket 開票 + 更新 CRM
    
    async function runInvoiceAgent(params: {
      orgId: string;
      userId: string;
      ticketId: string;
    }) {
      const taskId = await AgentTaskStore.create({
        orgId: params.orgId,
        userId: params.userId,
        type: 'INVOICE_FROM_TICKET',
        status: 'running',
      });
    
      const ctx: AgentContext = {
        orgId: params.orgId,
        userId: params.userId,
        role: 'scoped_write',
        taskId,
      };
    
      const tools = new AgentTools(ctx);
    
      // event sourcing:每一步都寫入 agent_events
      await AgentEventStore.append({
        taskId,
        type: 'task_started',
        payload: { ticketId: params.ticketId },
      });
    
      // 1) LLM 讀 ticket + 商業規則摘要(短期記憶)
      const ticket = await tools.getSupportTicket(params.ticketId);
    
      const policyDocs = await OrgPolicyRAG.search({
        orgId: params.orgId,
        query: '開立發票規則',
        topK: 3,
      });
    
      const llmInput = buildPrompt({ ticket, policyDocs });
    
      const llmDecision = await LLM.chatCompletion({
        model: 'gpt-4.1-mini',
        tools: [
          { name: 'createInvoiceDraft', schema: InvoiceDraftSchema },
          { name: 'updateCrmLead', schema: CrmPatchSchema },
        ],
        messages: [
          { role: 'system', content: SYSTEM_PROMPT },
          { role: 'user', content: llmInput },
        ],
      });
    
      await AgentEventStore.append({
        taskId,
        type: 'llm_decision',
        payload: safeDecisionLog(llmDecision),
      });
    
      // 2) 根據 LLM 決策安全執行工具
      const result = await ToolExecutor.run(llmDecision, tools);
    
      // 3) 將任務摘要存入長期「事件記憶」(去敏 + 可查詢)
      await AgentMemoryStore.saveTaskSummary({
        orgId: params.orgId,
        taskId,
        type: 'INVOICE_TASK_SUMMARY',
        summary: buildTaskSummary({ ticket, result }),
        // 設定過期策略:例如 180 天後自動清除
        expiresAt: dayjs().add(180, 'day').toDate(),
      });
    
      await AgentTaskStore.update(taskId, { status: 'completed' });
    
      return result;
    }
    

    3. Memory Schema(簡化版)

    -- 任務層級摘要,作為長期「安全記憶」
    CREATE TABLE agent_task_memory (
      id            BIGSERIAL PRIMARY KEY,
      org_id        VARCHAR(64) NOT NULL,
      task_id       VARCHAR(64) NOT NULL,
      type          VARCHAR(64) NOT NULL,
      summary_json  JSONB NOT NULL,   -- 已去識別 / 去敏的摘要
      created_at    TIMESTAMP NOT NULL DEFAULT now(),
      expires_at    TIMESTAMP NULL,
      INDEX idx_org_type_created (org_id, type, created_at)
    );
    
    -- 事件流,用於回放與審計
    CREATE TABLE agent_events (
      id            BIGSERIAL PRIMARY KEY,
      org_id        VARCHAR(64) NOT NULL,
      task_id       VARCHAR(64) NOT NULL,
      event_type    VARCHAR(64) NOT NULL, -- tool_call / llm_decision / error ...
      payload       JSONB NOT NULL,
      created_at    TIMESTAMP NOT NULL DEFAULT now(),
      INDEX idx_task_created (task_id, created_at)
    );
    

    建議與注意事項


    1. 常見踩坑

    1. 讓 Agent 拿到全庫 query 能力
    2. 例如暴露 run_sql(query) 這種工具 → 等於給 LLM 一把 DB root key
    3. 建議:只提供具體業務操作工具(get_invoice_by_id / create_invoice_draft),不提供自由 SQL / 任意 filter

    4. 把 user prompt 直接當長期記憶存

    5. 風險:
      • 敏感資訊(住址、email、信用卡後四碼)被永久 index
      • 未來 RAG 檢索時把別人對話調出來
    6. 解法:只存事件摘要(例如:某天完成一筆開票),prompt 原文只能在短期 log / 加密 log 中保留,並設明確 retention

    7. 沒有 rollback / dry-run 機制

    8. Demo 時一切完美,上線後改個 prompt 就開始亂開票
    9. 建議:

      • 預設跑在 dry-run / shadow mode:只寫 event,不真正寫 DB,由人審批
      • 對高風險操作(刪除、退款)設計 雙階段提交流程:Agent 產生建議 → 人按下「Apply」才真正執行
    10. 把政策寫死在 prompt

    11. 政策一變,所有 Agent 行為都過期,但你不知道是哪個版本出的錯
    12. 建議:政策存 RAG / config store,prompt 只說「請依據最新的 org policy 回應」,並在 log 記錄使用的 policy_version_id

    2. 實戰建議(可直接用在專案裡)

    1. 先只讓 Agent 操作「草稿」資源
    2. 如範例:createInvoiceDraft,由人類在 UI 裡確認後再正式開票
    3. 這個模式在導入初期可以快速建立信任,也方便收集訓練資料

    4. 每個 Agent 任務都要有 task_id + org_id + user_id

    5. 方便之後做:

      • per-org 行為分析
      • 問題排查:「這張錯誤發票是哪個 Agent 任務生成的?」
      • 回放測試:「重跑這個 task,看新版模型會不會做出不一樣決策」
    6. 記憶層要先畫邊界,再決定用什麼向量庫

    7. 問自己三件事:
      • 哪些東西必須記一輩子(例如:已開立的發票、客戶同意條款紀錄)
      • 哪些只需要短期記憶(例如:這週正在處理的 ticket 狀態)
      • 哪些不該記(例如:一次性敏感資訊)
    8. 然後才決定:哪些用 transactional DB、哪些進向量庫、哪些只當 log 放 object storage + TTL

    9. 用事件流做 A/B 測試與回放

    10. 有了 agent_events 後,可以:
      • 在 staging 重播同一串事件,切不同模型 / prompt
      • 比較產生的 tool call 是否差異過大
      • 逐步從 demo 模式 → 實際寫入模式

    整體來說,把 Agent 裝進 SaaS,不是再多寫幾個工具函式,而是要把它當「受控的自動化子系統」來設計:

    • 用 sandbox 做權限邊界
    • 用多層記憶管理上下文與風險
    • 用事件流與回放讓它可觀察、可演進、可 debug

    一旦這套骨架打好,你的 SaaS 就可以從「有個聊天盒子」升級成「能自己處理開票、更新 CRM、遵守政策的半自動業務夥伴」。


    🚀 你現在可以做的事

    • 在現有 SaaS 服務中先列出所有「只允許草稿」的業務操作,設計對應的 scoped_write 工具層 API
    • 為你的 Agent 任務加上 task_id / org_id / user_id 與 agent_events 表,開始記錄並觀察事件流
    • 審視目前有哪些資料被長期保存為向量或日誌,整理一份「應改成事件摘要、需設定 TTL」的清單並排入技術債處理計畫
  • 用 Claude+n8n 打造會自己跑的 AI 工作流

    用 Claude+n8n 打造會自己跑的 AI 工作流

    📌 本文重點

    • 用 Claude /goal、/loop 自動化長流程任務
    • 用 n8n 串 API、Email、DB 打造完整工作流
    • 一定要保留「人工審核閘」避免 AI 誤發內容

    用 Claude 搭配 n8n,你可以把「每週拉數據、寫報告、發信或更新網站」這種例行公事交給 AI 自動跑完,只在最後一關人工點頭即可。


    核心功能:這套組合幫你做什麼?

    1. Claude 長任務指令:/goal、/loop 讓 AI 自己把事做完

    先理解 Claude 的幾個關鍵指令(在 Claude Code 或支援指令的環境使用):

    • /goal:一次講清楚最終目標,讓 AI 自己拆步驟、規劃流程、按順序執行。
    • /loop:針對一批項目重複跑同一種處理,例如對 50 個關鍵字依序寫摘要、產出標題。
    • /batch:一次處理多筆輸入,適合批次內容生成或批次分析。

    可參考這篇詳細說明:Claude Code: The Autonomous Commands…

    你可以馬上做的事:

    • 在 Claude 裡建一個新專案,貼上你常做的流程(例如「每週 SEO 報表」),試著用這個提示:

    /goal
    目標:我想把「每週 SEO 報表」變成一個自動流程。
    請你:
    1. 問我目前是怎麼做(包含用到哪些工具、檔案格式)
    2. 拆成清楚步驟,分出「AI 可以做」和「一定要人工做」
    3. 用適合 /loop 或 /batch 的地方標註出來


    2. n8n:把 API、Email、資料庫都接在一起

    n8n 是一個開源自動化工具(像是開源版 Zapier),負責把「資料源 → Claude → 發送結果」串起來。

    常用節點大概就是:

    • Trigger:時間觸發(Cron),例如每週一早上 9 點跑一次。
    • HTTP Request / API 節點:去叫 Google Search Console、SEO 工具、你的內部系統。
    • Claude / OpenAI 類節點:把資料丟給 Claude 分析或生成內容。
    • Email / Slack / Notion 節點:把結果送到你或客戶手上。

    你可以馬上做的事:

    • 註冊 n8n(雲端版)或用 Docker 在本機跑:https://n8n.io
    • 開一個最簡單 workflow:
    • Cron → HTTP Request → Email
    • HTTP Request 隨便先叫一個公開 API(例如 Github trending),收回結果後,用 Email 節點寄給自己,確認「API → 自己」這條管線沒問題。

    3. 人工審核閘:一定要保留的「最後一關」

    這一步是整篇文章最重要的重點。

    在一篇實戰分享裡,作者用 Claude + n8n + SE Ranking API 自動產出客戶 SEO 週報,為了省 token 做了一個「優化」:當某些欄位沒資料時,讓 Claude 自己補。結果 Claude 開始用其他客戶的品牌數據去補空缺,還一臉正常,差點寄給一整串客戶,最後是靠人工審核節點擋住了災難(原文連結)。

    💡 關鍵: 再「聰明」的自動化流程也可能補錯資料,最後一關一定要由人審核才能避免嚴重誤發。

    結論:千萬不要把最後的人審自動化掉。

    你可以馬上做的事:

    • 在 n8n 裡加一個「人審」節點(可以是):
    • 把報告先丟到 Slack 私訊給你,附兩個按鈕:Approve / Reject。
    • 或者寄到你 Email,只有你手動轉寄給客戶才算「送出」。
    • 規則很簡單:
    • AI 可以草擬與整理,
    • 你來決定要不要「正式送出」。

    實戰案例:自動 SEO 週報(含人審)

    參考 Reddit 上「Claude is my entire SEO team」的做法(原文),我們做一個最小可行版本:

    流程圖(文字版)

    1. Cron 觸發:每週一 09:00。
    2. 抓數據:n8n 呼叫 Google Search Console / SE Ranking / GA4 API。
    3. 整理成 JSON/CSV:在 n8n 做基本清洗、欄位統一。
    4. 丟給 Claude:
    5. 提示大意:

      “`
      你是一位 SEO 分析師。請根據以下資料:
      – 找出本週與上週的主要變化(曝光、點擊、CTR、排名)
      – 標記前三個值得關注的關鍵字或頁面
      – 用「給客戶看的語氣」寫一份 300-500 字報告
      – 最後用 bullet points 給出下週三個具體行動建議

      資料如下(JSON):
      {{data}}
      “`

    6. 產出報告草稿:Claude 回傳 Markdown 或 HTML。

    7. 人工審核閘:
    8. n8n 把草稿丟到 Slack 或 Email。
    9. 你檢查內容、改幾句,手動按「OK」。
    10. 正式發送:
    11. n8n 把最終版本寄給客戶,存一份到 Notion/GDrive。

    你可以馬上做的事:

    • 先不接 API,把第 2 步改成「從 Google Search Console 下載 CSV,手動上傳到 n8n」:
    • n8n workflow:Manual Trigger → Upload(Webhook / Form)→ Claude → Email to yourself。
    • 等流程穩定,再把手動上傳改成 API 自動抓。

    多代理與 MCP:什麼時候要用,什麼時候別急著上

    當你開始想:

    • 一個 Agent 負責抓資料
    • 一個 Agent 負責分析
    • 一個 Agent 負責 QA / 測試

    就會踩到「多代理系統」與 MCP(Model Context Protocol)的世界。

    有人已經用 Claude Agent SDK + MCP 做出:

    • 看板(Kanban)每張卡片就是一個開發任務
    • Cron 定時啟動 Claude,為每張卡開一個隔離環境,
    • 拉 repo → 寫 code → Git 提交 → Vercel 建預覽 → 第二個 Claude 做 QA 測試 → 不過就自動重試(案例影片)。

    但實務上,多代理+多個 MCP server 很容易變成:

    • 工具太多、描述太長,模型不斷選錯工具。
    • 每次調用都把全部工具 schema 塞進 context,token 成本暴漲(有研究與實務案例顯示,長 agent run 可能是一般聊天的 1000 倍 token)。

    💡 關鍵: 多代理與 MCP 雖強大,但會大幅拉高複雜度與 token 成本,先把單一流程跑穩再擴充效益最高。

    建議:先把單一流程 + 人審做好,再考慮多代理。

    你可以馬上做的事:

    • 若你不是工程背景,目前只要記得兩件事:
    • MCP = 讓 AI 直接操作一堆內部工具的「插座規格」。
    • 「工具越多越好」是錯誤想像,實務上要刻意減少工具數量,讓 AI 比較不會選錯。

    適合誰用:三種典型場景

    角色 / 團隊類型 痛點 可以先做的第一條工作流
    個人創業者 / 獨立站長 每週 SEO 數據、內容企劃很花時間 自動 SEO 週報 + 下週內容建議(保留人審)
    接案顧問 / 行銷代理商 多個客戶週報、月報內容高度重複 客戶週報模板 + 客製評論區,由 Claude 先填、你負責最後一段「專業觀點」
    內容團隊主編 多篇文章排程、更新 meta、內鏈整理 用 /loop 對多篇文章產出標題、描述,n8n 更新到 CMS 草稿,人工再審核發佈

    工具比較:Claude、n8n 以及類似選項

    名稱 核心功能 免費方案 適合誰
    Claude (Claude Code) 長任務指令(/goal、/loop)、多代理、強文字與程式處理 有免費網頁版與有限額度 需要寫報告、寫程式、設計長流程的人
    n8n 視覺化工作流、自動化各種 API/Email/DB 有自架免費版,雲端有免費層 想用「拖拉方式」把不同工具串起來的人
    Zapier/Make SaaS 自動化平台,介面更友善,內建大量整合 有免費層但步數較少 不想部署系統,只想快點測試概念的人

    💡 關鍵: Claude 負責「想與寫」,n8n 和 Zapier/Make 負責「串與送」,搭配起來才能形成真正的自動化流水線。


    怎麼開始:從「一個安全的流程」練起

    按照這個順序,你可以在半天內完成第一條「會自己跑,但有你把關」的 AI 工作流:

    1. 開通帳號
    2. 註冊 Claude 帳號:https://claude.ai
    3. 註冊 n8n(雲端或自架):https://n8n.io

    4. 在 Claude 裡寫清楚你的「流程說明書」

    5. 建一個專屬專案,新增檔案 WORKFLOW.md,內容包含:

      • 你每週報告的步驟
      • 用到資料來源
      • 哪些步驟你不想讓 AI 自動做(例如「最後寄給客戶」)
    6. 做第一個最小工作流(本機測試版)

    7. n8n:Manual Trigger → 手動貼 CSV → Claude → Email 給自己。
    8. 實際跑一次,看 Claude 生成的報告是否接近你平常寫的內容。

    9. 加上人工審核閘

    10. 把收件人改成你的 Slack / 私人 Email。
    11. 只有你手動確認後,才另外轉寄給客戶或上線。

    12. 再考慮進階:API、自動抓數據、多客戶分流

    13. 等你對這條流量和錯誤模式有感覺後,再把手動步驟替換成 API。

    只要守住「AI 做草稿,人做決定」這一條線,你就可以放心把「會自己跑」的工作流丟給 Claude 和 n8n,真正把時間留給需要判斷與創意的事情。

    🚀 你現在可以做的事

    • 在 Claude 建一個專案,照文中範例貼上你的「每週報表流程」並用 /goal 讓它幫你拆步驟
    • 在 n8n 建立「Cron → HTTP Request → Email」或「Manual Trigger → Claude → Email」的最小工作流
    • 為現有任一例行報告加上一個「人工審核閘」,先從「AI 草擬、人來定稿」開始運行
  • Gemma 4 12B:16GB 筆電就能跑的多模態模型

    Gemma 4 12B:16GB 筆電就能跑的多模態模型

    📌 本文重點

    • Gemma 4 12B 可在 16GB 筆電本地跑起多模態助理
    • 支援 256K tokens 長上下文與 140+ 種語言
    • 多種推理框架與量化選項,依硬體彈性部署

    只要一台 16GB RAM 的筆電,你就能在本地跑起能看圖、懂多語言、支援長上下文的開源模型 Gemma 4 12B,當自己的離線 AI 助理。

    官方與模型頁:
    – Google DeepMind 介紹(英):The Decoder 報導
    – 模型權重:google/gemma-4-12b(Hugging Face)


    核心功能:這顆模型為什麼值得你在本地跑

    1. 多模態:同時處理文字、圖片,部分變體還支援音訊

    Gemma 4 12B 是 Google DeepMind 釋出的開放權重模型,可以:

    • 文字 → 文字:聊天、摘要、寫程式
    • 圖片 → 文字:看截圖、PPT、流程圖說明內容
    • (部分 12B 變體)音訊 → 文字:理解語音內容(需支援音訊版模型,見 Hugging Face 說明)

    你可以馬上實作:

    • 把專案架構圖或 UI 截圖丟給 Gemma 請它「用條列解釋每一塊的功能」
    • 拍下白板會議內容,請它整理成待辦清單 + 行動項目

    模型介紹討論可參考 Reddit:google/gemma-4-12B · Hugging Face


    2. 超長上下文:最多 256K tokens,做「整個資料夾」級別的助理

    Gemma 4 系列支援最高 256K tokens 上下文,適合處理:

    • 整本 PDF、技術規格書
    • 一整個 repo 的多檔案閱讀
    • 長對話紀錄與多輪推理

    能做的實際事情:

    • 丟一本 300 頁 PDF:請它依「章節 + 行動建議」整理摘要
    • 為專案整個 docs/ 資料夾建一個「本地 FAQ 助理」,用自然語言查文件

    進階提示:長上下文會吃 RAM,你在本地使用時可先把 context window 設在 16K~32K,等硬體 OK 再拉高。

    💡 關鍵: 高達 256K tokens 的上下文,讓你可以一次處理整本書或整個專案,而不用頻繁切段或換檔。


    3. 多語言 + 商用授權:可以直接放進產品

    根據 Google 與社群測試,Gemma 4 支援 140+ 種語言,在英文之外,中文、日文、歐洲語言表現都夠用;
    同時採用 Apache 2.0 授權,可用於商業產品(只需保留版權聲明)。

    你可以馬上行動:

    • 做一個「中英雙語客服 FAQ Bot」,在公司內網跑,不要雲端 API
    • 把它包成內部工具,處理公司文件、程式碼審閱,不用擔心資料外流

    授權與開源定位說明,可參考 The Decoder 報導與 Reddit 貼文:
    – The Decoder:Gemma 4 12B
    – Google just dropped Gemma 4 12B on your laptop!!

    💡 關鍵: Apache 2.0 商用授權加上 140+ 語言支援,讓 Gemma 4 12B 可以直接被放進正式產品中,而不只是一個玩具模型。


    適合誰用:三個實戰場景

    1. 本地文件助理:讀 PDF、企業知識庫、不出網就能查

    典型流程:

    1. 把 PDF/Markdown/Word 轉成純文字
    2. 用向量資料庫或簡單關鍵字搜尋切成小段
    3. 把相關段落 + 問題一起送進 Gemma 4 12B

    具體可以做:

    • 法律條款查詢:輸入「幫我比較第 5 條和第 8 條的差異,列成表格」
    • 公司內訓教材:輸入「只針對新進工程師,整理第一章的必讀重點」

    行動建議:

    • 不想寫程式:用桌面端 UI 工具(例如 LM Studio)載入 Gemma 4 12B 的 GGUF 量化版,搭配內建「本地檔案知識庫」功能。
    • 能寫 Python:用 transformers + chromadb 或 llamaindex 搭一個最小可用的 RAG 查詢腳本。

    2. 圖片理解:看設計稿、截圖除錯、手寫筆記整理

    Gemma 4 12B 的多模態版本可以直接吃圖片:

    可以做的事:

    • 把前端 UI 截圖給模型:「列出這個畫面的功能區塊,以及可能漏掉的錯誤狀態」
    • 拍課堂黑板或手寫筆記:「幫我轉成 Markdown 大綱,並補上可能缺的步驟」

    行動建議:

    • 使用 Ollama:安裝後直接用
      bash
      ollama pull gemma4:12b
      ollama run gemma4:12b

      再在聊天 UI 裡丟圖片與文字問題。

    • 若走 transformers:選用多模態 checkpoint(Hugging Face 上會標示 image / vision 支援),用官方範例載入 processor + model 後送入 images + texts。


    3. 簡單程式輔助與本地 Coding Agent

    在 Reddit 測試中,有人把 Gemma 4 12B 接進 VSCodium + Pi Agent,讓它:

    寫一個 Python 腳本:讀取 log 檔 → 抓出 error module → 統計後輸出 JSON,還自己產 mock data、在終端測試,一次成功。(案例連結)

    你可以:

    • 在 VS Code 裝本地 LLM 外掛(如 Continue / Pi Agent 等),指定後端使用本地 Gemma 4 12B
    • 常見用法:
    • 「寫一個腳本批次重命名資料夾裡的圖片」
    • 「讀這個函式庫的 README,給我最小可行 demo」

    行動建議:

    • 若你有 NVIDIA GPU(如 3060 以上):用 mistral.rs 或 llama.cpp + CUDA,可以得到更順暢的互動速度。

    推理框架比較:Ollama / Transformers / llama.cpp / mistral.rs

    下表給你一眼看懂各工具適合誰:

    名稱 核心功能 免費方案 適合誰
    Ollama 一行指令拉模型、簡單本地聊天 UI 免費 想最快跑起 Gemma 4、只想用不想調參的人
    Transformers 直接操作 Hugging Face 權重 免費 Python 開發者、要客製 RAG / Agent 的人
    llama.cpp CPU/GPU 皆可的輕量推理框架 免費 只有 CPU 或老 GPU、需要 GGUF 量化的人
    mistral.rs 針對 CUDA 極速優化的推理框架 免費 有 NVIDIA GPU,追求吞吐和延遲的進階玩家

    補充:mistral.rs v0.8.2 在 Gemma 4 上,對多種 GPU(GB10 / B200 / H100)推理速度可比 llama.cpp 快到 2.8 倍(來源)。

    💡 關鍵: 若你有 NVIDIA GPU,mistral.rs 在 Gemma 4 上可達到比 llama.cpp 快約 2.8 倍的推理速度,大幅縮短互動延遲。


    硬體需求與量化:16GB 筆電怎麼選

    Gemma 4 12B 是 120 億參數等級的模型,但經過量化後可以塞進 16GB RAM 甚至更小機器上。

    基本建議:

    • 16GB RAM / 無獨顯:
    • 量化:4-bit(如 Q4_K / Q4_0)
    • 框架:Ollama、llama.cpp GGUF
    • 用途:文件整理、輕量對話、簡單程式輔助

    • 16GB RAM + 6–8GB VRAM(如 3060 Laptop):

    • 量化:4-bit 或 8-bit(看 VRAM 是否足夠)
    • 框架:mistral.rs(CUDA)、llama.cpp(GPU offload)、Ollama(自動 GPU 利用)
    • 用途:多輪對話、圖片理解、較密集的程式輔助

    若不確定自己機器能跑多大模型,可以用社群做的互動網站(類似「選模型大小 + 量化 → 即時計算 VRAM」工具,來源自 這篇 Reddit 貼文),先估算記憶體需求,再決定下載哪一個量化版本。


    怎麼開始:最簡路線 3 步驟

    路線 A:用 Ollama,三分鐘跑起 Gemma 4 12B

    適合:Mac / Windows / Linux,一行指令就想用的人。

    1. 安裝 Ollama:到 ollama.com 下載並安裝
    2. 在終端執行:
      bash
      ollama pull gemma4:12b
    3. 開始對話:
      bash
      ollama run gemma4:12b

      在對話中可以直接貼文字、上傳圖片,嘗試:
    4. 「幫我把這份 PDF 的重點整理成五條」
    5. 「看這張 UI 截圖,列出使用者可能會卡關的地方」

    路線 B:用 Hugging Face Transformers,做自家工具的核心模型

    適合:會 Python、想整合到後端或自製 UI 的開發者。

    1. 安裝套件:
      bash
      pip install transformers accelerate safetensors
    2. 在程式裡載入(以文字模式為例):
      “`python
      from transformers import AutoModelForCausalLM, AutoTokenizer

    model_id = “google/gemma-4-12b-it” # instruction-tuned 版本

    tokenizer = AutoTokenizer.from_pretrained(model_id)
    model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map=”auto”,
    torch_dtype=”auto”,
    )

    prompt = “請用條列幫我整理這段技術文件的重點:…”
    inputs = tokenizer(prompt, return_tensors=”pt”).to(model.device)
    outputs = model.generate(**inputs, max_new_tokens=512)
    print(tokenizer.decode(outputs[0], skip_special_tokens=True))
    ``
    3. 若要圖片理解:選擇 Hugging Face 上標示支援 vision 的變體,搭配對應
    processor` 載入即可。


    路線 C:追求速度,用 mistral.rs / llama.cpp 跑量化版

    適合:有 NVIDIA GPU、想把延遲壓到最低的人。

    大致流程:

    1. 到 Hugging Face 找到 Gemma 4 12B 的 GGUF 或量化權重(搜尋 gemma-4-12b gguf 等)
    2. 安裝框架之一:
    3. mistral.rs
    4. llama.cpp
    5. 用官方 README 範例載入模型後,設定:
    6. n_gpu_layers 或類似參數,把前幾層放 GPU
    7. context_length:先從 16K 開始測試,再視記憶體往上調

    操作上可以先用簡單指令測試:

    ./main -m gemma4-12b-q4.gguf -p "幫我用三點整理這段文字的重點:..."
    

    確認速度和記憶體使用量,再決定是否改用更高精度的量化。


    如果你已經習慣雲端 LLM,Gemma 4 12B 是一個很好的起點,讓你在只靠 16GB 筆電的情況下,把「看圖、讀文件、寫程式」這三件事拉回自己機器上運行;從現在起,你可以把它當成本地端的多模態助手,按照上面的三條路線選一條裝起來,今晚就能實際用在手邊專案上。

    🚀 你現在可以做的事

    • 到 ollama.com 安裝 Ollama,執行 ollama pull gemma4:12b 在本地跑起模型
    • 前往 Hugging Face 搜尋 google/gemma-4-12b,挑選一個適合你硬體的量化版本下載
    • 在 VS Code 安裝本地 LLM 外掛(如 Continue / Pi Agent),後端連接本地 Gemma 4 12B 做程式輔助
  • 佛州告 OpenAI:AI 不再是『中立工具』

    佛州告 OpenAI:AI 不再是『中立工具』

    📌 本文重點

    • 佛州訴訟正式挑戰「我們只是工具」的免責邏輯
    • 大模型商業模式將轉向「安全與合規」溢價
    • 開發者需為高風險情境與兒童保護負起二次設計責任
    • 監管將「管出新標準」,適應者才能長期存活

    佛州這一連串對 OpenAI 與 Sam Altman 的訴訟,真正畫掉的是「我們只是工具供應商」這條保護線。接下來,大模型公司要活下去,不再是誰跑得快、誰模型大,而是誰能證明「足夠安全、可追責」。這不是「美國又來管 AI」,而是平台責任從「使用者自負」翻轉成「開發者必須預證安全」的起點。


    一、三類訴訟:從「免責」轉向「設計要負責」

    佛州目前對 OpenAI 的案件,大致可分三條攻擊線:

    1. 暴力事件關聯責任:
    2. 以 佛羅里達州立大學槍擊案 為核心,指控 ChatGPT 在過程中扮演了「促成」或「輔助」角色。
    3. 法律上,這是在試圖打破類似 通訊端點豁免(像當年社群平台喊的『我們只是管道』) 的邏輯,改成:如果你的系統可預見會被用於風險行為,而你沒有合理防範,就有責任。

    4. 兒童保護與不當內容:

    5. 另一案直接指控 ChatGPT 對兒童「不安全」,從暴力、色情到精神健康建議都可能越界。
    6. 這非常像當年對 遊戲暴力、菸草行銷給青少年 的訴訟:不是禁掉產品,而是要求嚴格的 年齡分級、突顯警示與使用情境限制。

    7. 欺騙性與誤導性商業行為:

    8. 佛州檢察長指 OpenAI 與 Altman 在行銷上誇大安全性、弱化風險,構成 deceptive practices。
    9. 核心不是「你有風險」,而是「你明知有風險,卻對消費者塑造『這東西安全又可靠』的錯誤期待」。

    💡 關鍵: 佛州不是在控告「AI 有風險」,而是在追究「明知有風險卻營造安全幻覺」的責任邏輯。

    若把這些案子放進歷史脈絡:

    • 菸草案:最後逼出的是「你要標示危害、不能假裝安全」。
    • 社群平台案:爭的是「演算法設計與推薦是不是行為放大的共犯」。
    • 遊戲暴力與兒童內容案:換來的是年齡分級、家長控制與廣告限制。

    佛州這一波,是把這三種戰場疊加在 生成式 AI 平台 上:模型本身的設計、調教、預設值與行銷敘事,都被拉進「可歸責」範圍。


    二、商業與產品路線:AI 公司會被迫長出「安全型商業模式」

    如果法院部分接受佛州的邏輯,對 OpenAI、Google、Anthropic 等大型模型供應商,會有幾個直接後果:

    1. 產品:預設安全,而非「先開放、再補洞」

    • 年齡分級會從「產品說明書」變成「系統級設計」:
    • 強制實名或可信年齡驗證,兒童模式預設關閉高風險能力(例如自我診斷、醫療建議、暴力細節描寫)。
    • 類似 Netflix、遊戲主機的 家長儀表板 會變成 LLM 平台標配。
    • 高風險功能將被拆出來,走「白名單/許可制」:
    • 例如醫療 triage、心理輔導、投資建議、教育考試輔助,可能需要專門 API、專門審核、專門責任條款。
    • 模型介面會改:更重警示、更頻繁風險提醒、更強硬的內容拒絕——因為這是日後在法庭上可拿出來的「我們盡力了」證據。

    2. 營收:從 Engagement 轉向「合規溢價」

    過去生成式 AI 的隱性 KPI 是:使用時長、對話輪數、日活 / 週活。佛州案如果立下先例,指向的是:

    • 「越黏」不再純粹是好事,而是 潛在風險暴露時間更長,監管眼中等同「你在 push 成癮」。
    • 商業模式會往:
    • 企業合規訂閱:你不是買一個 model,而是買一個「已經通過某些第三方審查、安全聲明、能陪你一起扛責」的服務。
    • 風險分級價目表:低風險通用聊天便宜,高風險領域(醫療、教育、理財)貴,但附帶審查、保險與合規文書。

    💡 關鍵: 真正賺錢的將不只是算力,而是「內建合規和可追責」的整套服務。

    真正會賺錢的,會是「安全與合規」層,而不是單純模型推理算力。


    三、開發者:再也不能說「我只是調用 API」

    對把 frontier model 嵌進自家 App 的開發者,這波風向是關鍵警訊:

    1. 「只是用 OpenAI API」不構成責任豁免:
    2. 你如何把模型包裝進產品情境、面向哪種族群、提供哪種提示與預設,都會被視為「二次設計」。
    3. 在兒童、教育、心理健康這些領域,法院很可能認為:你知道這是高風險場景,卻沒做額外防護,就是你的疏忽。

    4. 即將出現的新合約條款:

    5. 用途聲明與使用邊界:平台會要求你在申請 key 時就說明用途,並保留對「高風險用途」的拒絕權與稽核權。
    6. 共同責任與賠償條款(indemnity):
      • 平台會要求你承諾不將模型用於特定敏感場景,違反時你要賠平台。
      • 反過來,大客戶會要求平台在某些範圍內承擔產品缺陷責任。
    7. 審查與記錄義務:要求你保留關鍵互動 log,以便事後責任釐清;這會推高你對資料治理的成本。

    8. 一個新 B2B 市場:AI 安全合規服務

    9. 類似「PCI-DSS 協助商」、「GDPR 顧問」那樣,將出現:

      • 專做 prompt safety audit 的顧問公司。
      • 提供 AI 風險評估報告、政策模板、內部使用守則 的 SaaS。
      • 協助設置 內容過濾、年齡驗證、模型組合策略 的第三方套件。
    10. 對 VC 來說,這是新賽道;對開發者來說,這是新成本,也是新護城河:能把合規內建進產品的團隊,會在監管升溫後存活率更高。

    💡 關鍵: 「會寫程式」不再足夠,能把安全與合規做成產品設計能力,才是長期競爭力。


    四、州級實驗室與國際外溢:AI 監管的下一個 3–5 年

    佛州並不是孤例,而是 「州級先開槍,聯邦與國際跟進」 的典型美國路徑。

    • 一邊是 特朗普政府的 AI 行政命令,鼓勵模型自願送交政府做安全測試(「自願」其實半強制)。
    • 另一邊是 佛州這類州檢察長訴訟,直接在法院裡試探 AI 平台責任邊界。

    對歐盟、英國與亞洲監管來說,這等於免費實驗室:

    1. 兒童保護優先立法:
    2. 類似「未成年人使用社群媒體」的法案,會直接套用到 AI 聊天、AI 教學助理上。
    3. 關鍵不是 ban,而是 強制年齡驗證、使用時間限制、家長儀表板、預設內容級別。

    4. 強制風險揭露與模型標籤:

    5. 法律恐要求:對消費者清楚說明模型的 幻覺率、適用與不適用場景。
    6. 長期看,可能走向類似「食品營養標示」:AI 服務頁面要清楚列出安全警告與限制。

    7. 高風險用途特別管制:

    8. 教育、醫療、心理治療、自動武器相關應用,會被列為 高風險 AI,需要事前審查或登記。
    9. 這與 EU AI Act 的邏輯高度對齊,只是佛州等州在用訴訟把細節推進、提供案例庫。

    結論是:AI 不會被「管死」,但會被「管出一個新標準」——而這個標準,誰先適應,誰就活得久。


    結語:開發者與產品團隊現在就該做的三件事

    如果你是 AI 產品負責人、創業者或技術決策者,佛州這波行動對你最實際的啟示是:

    1. 把安全與年齡保護寫進 PRD,而不是寫在 FAQ:
    2. 每一個新功能,都問自己三個問題:

      1. 這功能對兒童是否安全?
      2. 在最糟糕情境下,被濫用時會造成什麼實體/心理/財務傷害?
      3. 我有哪些可驗證的防護(紀錄、警示、拒絕機制)?
    3. 重寫你的「我們是工具」敘事:

    4. 面向使用者與投資人,不要再用「我們只是模型供應商」當護身符。
    5. 改成:我們提供的是一個帶有明確風險邊界、記錄機制與事後追責設計的系統。這會是未來的信任貨幣。

    6. 預留法務與合規預算,視之為產品成本的一部分:

    7. 早期就找懂資料保護、消費者保護與產品責任的律師看你的 UX、行銷語言與合約。
    8. 將來監管成形時,那些一開始就把「安全、年齡保護、可追責性」視為產品核心的團隊,會直接站在新秩序的起跑線上。

    佛州這次不是在問「AI 要不要被管」,而是在宣告:「沒有安全敘事的 AI 商業模式,將不再被法律接受」。接下來幾年,能活下來的 AI 平台,只會是那些把風險管理做成產品能力,而不是 PR 段子的玩家。

    🚀 你現在可以做的事

    • 回頭檢查自家產品 PRD,為兒童保護與高風險情境補上具體防護設計
    • 盤點你目前使用的 API / 模型供應商,預先準備用途聲明與合規文件
    • 尋找或建立內部「AI 安全與合規」負責人,開始制定使用守則與審查流程
  • 用狀態機把 13GB 小模型變成工程實習生

    用狀態機把 13GB 小模型變成工程實習生

    📌 本文重點

    • 小模型別當全能 Agent,要當被流程管控的小工
    • 用顯式狀態機拆任務,大幅提升穩定性與可回滾性
    • 每步輸出 JSON + schema 驗證,讓小模型也能穩定改碼

    只靠 prompt 堆疊,13GB 本地模型在中大型改碼任務幾乎必翻車:上下文飄掉、一次回錯一堆檔、改到一半忘記需求。把模型包進顯式狀態機,把「一次大任務」拆成可恢復的子任務,可以在不改模型的前提下,大幅提升穩定性、可觀測性與可測試性——正是那篇 13.8GB 模型從 2/10 變成 10/10 的核心做法。

    💡 關鍵: 只改調用方式與流程設計,就能把同一顆 13.8GB 小模型的表現從 2/10 拉到 10/10。


    重點說明

    1. 小模型為什麼在長對話裡特別容易翻車?

    從工程視角,有三個根本原因:

    1. token 預算太小 + 資訊密度太高
      13GB 級(多是 7B〜13B 參數)在 4k–16k context 內要同時塞:需求、專案結構、幾個檔案內容、測試結果、對話歷史,關鍵訊息會被截斷或壓縮到模型抓不到。

    2. 上下文漂移(context drift)
      多輪長對話時,你不可能每次都重貼完整需求與檔案。模型只能靠「語意回憶」之前說過什麼,多輪後任務邊界就開始模糊:忘記原本的 constraint、改到不該動的檔案、把舊 bug 當新需求。

    3. 一次性決策成本過高
      傳統「一條大 prompt + chain-of-thought」會在單輪裡要求:理解需求 → 找檔 → 設計改動 → 寫碼 → 自我檢查。這在 token 限制與小模型推理能力下,極易在中間任一步 hallucinate,之後又沒有明確的 rollback 機制。

    關鍵結論: 小模型不適合當「一次性全能 Agent」,更適合當「被嚴格流程控制的小工」,讓狀態機負責 long-term 記憶與決策邊界。

    💡 關鍵: 把 long-term 記憶與流程決策交給狀態機,小模型只做局部推理,能顯著降低翻車率。


    2. 用顯式狀態機拆解大任務:核心設計

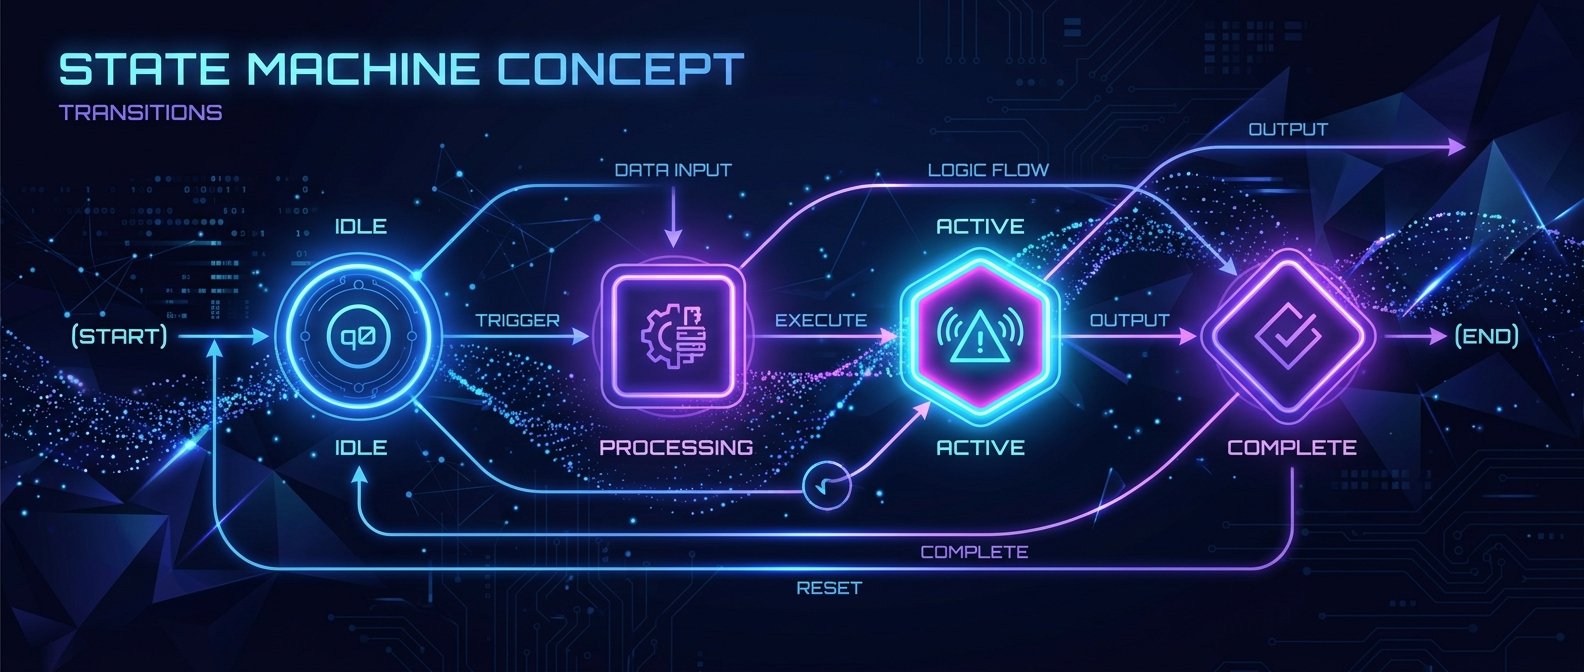
    把「改造一個中小型專案」拆成明確的 State + Transition:

    常見狀態設計可以是:

    1. DISCOVER_PROJECT:掃描 repo、建立檔案索引
    2. PLAN_CHANGE:根據需求與索引產生修改計畫(檔案清單、步驟)
    3. EDIT_FILE:逐檔案修改(step-by-step)
    4. RUN_TESTS:執行測試、收集結果
    5. ROLLBACK_OR_FIX:測試失敗→嘗試修復或回滾
    6. DONE / FAILED:終止狀態

    每個狀態都只給模型 極簡上下文 + 明確輸入/輸出 schema,例如在 EDIT_FILE:

    • 輸入:
    • 需求摘要(短)
    • 該檔案目前內容(或片段)
    • 計畫中對此檔案的變更描述
    • 輸出:
    • 結構化 JSON:{"status": "ok|skip|abort", "patch": "...diff..."}

    轉移條件示例:

    • DISCOVER_PROJECT → PLAN_CHANGE:索引成功建立
    • PLAN_CHANGE → EDIT_FILE:生成的計畫通過 schema 檢查
    • EDIT_FILE → RUN_TESTS:所有目標檔案處理完
    • RUN_TESTS →
    • 全綠 → DONE
    • 有失敗 + 可定位 → EDIT_FILE (targeted fix)
    • 多次失敗 → ROLLBACK_OR_FIX

    失敗重試策略與超時機制:

    • 每個狀態設定 max_retries,例如 2–3 次,超過則標記為 FAILED 或轉 ROLLBACK_OR_FIX。
    • 每次 LLM 回應必經:
    • JSON schema 驗證
    • domain guard(例如禁止刪除大量無關 code)
    • 超時機制:
    • 單次呼叫 timeout(例如 60s),保障工作流不被卡死
    • 整個工作流 wall-clock timeout(例如 30 分鐘),方便在 CI 或自動化工具中運行

    💡 關鍵: 把重試、超時、回滾寫死在狀態機邏輯裡,比指望 prompt 提醒模型「要小心」可靠太多。


    3. 實作範例:13GB 本地模型改造專案(Python)

    以下是精簡版 pseudo-code,示範如何把本地模型包在狀態機裡,跑 step-by-step 編碼、測試與回滾。假設:

    • 使用 vLLM / llama.cpp server 暴露出 OpenAI-compatible API
    • GPU:3060 12GB,模型用 Q4 / Q5 量化
    import enum
    import json
    import subprocess
    from dataclasses import dataclass
    from typing import Dict, Any, List
    import requests
    
    OPENAI_BASE = "http://localhost:8000/v1"
    MODEL_NAME = "local-13b-q4"
    
    class State(enum.Enum):
        DISCOVER_PROJECT = "DISCOVER_PROJECT"
        PLAN_CHANGE = "PLAN_CHANGE"
        EDIT_FILE = "EDIT_FILE"
        RUN_TESTS = "RUN_TESTS"
        ROLLBACK_OR_FIX = "ROLLBACK_OR_FIX"
        DONE = "DONE"
        FAILED = "FAILED"
    
    @dataclass
    class Context:
        repo_path: str
        requirement: str
        file_index: Dict[str, Any] = None
        plan: List[Dict[str, Any]] = None
        current_file_idx: int = 0
        test_result: str = ""
    
    
    def call_llm(system_prompt: str, user_prompt: str, max_tokens: int = 1024) -> str:
        resp = requests.post(
            f"{OPENAI_BASE}/chat/completions",
            json={
                "model": MODEL_NAME,
                "messages": [
                    {"role": "system", "content": system_prompt},
                    {"role": "user", "content": user_prompt},
                ],
                "temperature": 0.2,
                "max_tokens": max_tokens,
            },
            timeout=60,
        )
        resp.raise_for_status()
        return resp.json()["choices"][0]["message"]["content"]
    
    
    def discover_project(ctx: Context) -> Context:
        # 這裡可以用 ripgrep / fd 產生檔案清單,略
        ctx.file_index = {"files": ["src/a.py", "src/b.py"], "tests": ["tests/test_a.py"]}
        return ctx
    
    
    def plan_change(ctx: Context) -> Context:
        system = """你是資深工程師,輸出 JSON,字段: steps: [{file, description}]。"""
        user = f"需求: {ctx.requirement}\n可修改檔案: {ctx.file_index['files']}\n請產生最多 10 個步驟。"
        raw = call_llm(system, user)
        try:
            plan = json.loads(raw)
        except Exception:
            raise ValueError("PLAN_CHANGE: model output not JSON")
        ctx.plan = plan["steps"]
        ctx.current_file_idx = 0
        return ctx
    
    
    def apply_patch(repo_path: str, file: str, patch: str):
        # 建議用 unified diff + `patch` 指令,這裡簡化處理
        with open(f"{repo_path}/{file}", "w", encoding="utf-8") as f:
            f.write(patch)
    
    
    def edit_file(ctx: Context) -> Context:
        step = ctx.plan[ctx.current_file_idx]
        file_path = step["file"]
        with open(f"{ctx.repo_path}/{file_path}", encoding="utf-8") as f:
            content = f.read()
    
        system = """你只負責修改單一檔案。輸出 JSON: {status, patch}。
        - status: ok | skip | abort
        - patch: 完整檔案內容,不要解釋文字。"""
    
        user = f"需求: {ctx.requirement}\n此步驟: {step['description']}\n原始內容:\n{content[:4000]}"
        raw = call_llm(system, user, max_tokens=2048)
        try:
            out = json.loads(raw)
        except Exception:
            raise ValueError("EDIT_FILE: invalid JSON")
    
        if out["status"] == "ok":
            apply_patch(ctx.repo_path, file_path, out["patch"])
        elif out["status"] == "abort":
            raise RuntimeError("Model aborted edit")
    
        ctx.current_file_idx += 1
        return ctx
    
    
    def run_tests(ctx: Context) -> Context:
        proc = subprocess.run(["pytest"], cwd=ctx.repo_path, capture_output=True, text=True)
        ctx.test_result = proc.stdout + "\n" + proc.stderr
        return ctx
    
    
    def rollback_or_fix(ctx: Context) -> Context:
        # 真實情況應該搭配 git: reset --hard HEAD~1 或建立 branch
        # 這裡示意:交給模型看測試輸出,決定要修哪個檔案
        system = "請從測試輸出中找出最可能需要修改的單一檔案,輸出 JSON: {file, reason}"
        user = ctx.test_result[:4000]
        raw = call_llm(system, user)
        try:
            out = json.loads(raw)
        except Exception:
            raise ValueError("ROLLBACK_OR_FIX: invalid JSON")
    
        # 根據 out['file'] 重新插入 plan
        ctx.plan.insert(ctx.current_file_idx, {"file": out["file"], "description": out["reason"]})
        return ctx
    
    
    def run_state_machine(ctx: Context):
        state = State.DISCOVER_PROJECT
        retries: Dict[State, int] = {s: 0 for s in State}
        MAX_RETRIES = 2
    
        while True:
            try:
                if state == State.DISCOVER_PROJECT:
                    ctx = discover_project(ctx)
                    state = State.PLAN_CHANGE
    
                elif state == State.PLAN_CHANGE:
                    ctx = plan_change(ctx)
                    state = State.EDIT_FILE
    
                elif state == State.EDIT_FILE:
                    if ctx.current_file_idx >= len(ctx.plan):
                        state = State.RUN_TESTS
                    else:
                        ctx = edit_file(ctx)
    
                elif state == State.RUN_TESTS:
                    ctx = run_tests(ctx)
                    if "failed" in ctx.test_result:
                        state = State.ROLLBACK_OR_FIX
                    else:
                        state = State.DONE
    
                elif state == State.ROLLBACK_OR_FIX:
                    ctx = rollback_or_fix(ctx)
                    state = State.EDIT_FILE
    
                elif state in (State.DONE, State.FAILED):
                    return state, ctx
    
            except Exception as e:
                print(f"State {state} error: {e}")
                retries[state] += 1
                if retries[state] > MAX_RETRIES:
                    return State.FAILED, ctx
    
    
    if __name__ == "__main__":
        ctx = Context(repo_path="/path/to/repo", requirement="把 API v1 換成 v2 並修正測試")
        final_state, final_ctx = run_state_machine(ctx)
        print("Final state:", final_state)
    

    重點:

    • 模型只做 局部、可回滾的決策(例如一次只改一檔)。
    • 工作流邏輯(狀態、重試、回滾)都在 可測試的 Python 函式 中,而不是藏在 prompt 裡。

    若用 TypeScript + LangGraph / 自行寫狀態機,模式相同:每個 Node 是一個狀態,Edge 由測試結果與 JSON 輸出決定。


    4. 與「prompt + chain-of-thought」相比的實際好處

    1. 穩定性
    2. CoT 依賴模型「自己監督自己」,小模型的推理錯誤會被往後 propagate,沒有硬性 checkpoint。
    3. 狀態機把流程切成多個 可檢查的邏輯節點,每步都能強制過 schema、判斷失敗與回滾。

    4. 成本與資源

    5. 單輪 prompt 巨大 → token 費用高,且在本地 GPU 上速度慢。
    6. 狀態機讓每輪上下文更短、更聚焦,在 3060 12GB + Q4 模型上可以穩定跑 多輪短對話,總延遲往往比一輪巨 prompt 更好控制。

    7. 觀測性(logging / trace)

    8. 把每個狀態轉移、LLM input/output、git diff 全記錄(例如存到 SQLite / OpenTelemetry trace),可以:

      • 後覽失敗案例
      • 做離線分析:哪個狀態最常出錯?哪種需求最難?
    9. 可測試性

    10. 傳統做法難以單元測試 Agent:prompt 無法 deterministic。
    11. 狀態機可以用 fake LLM 或 replay 真實輸出,對每個 state handler 寫 unit test,例如:當測試結果是某種錯誤訊息時,ROLLBACK_OR_FIX 應插入哪個 plan。

    建議與注意事項

    1. 避免狀態爆炸

    • 限制狀態數量在 5–10 個,複雜度放在狀態內部的子函式,而不是新增一堆細碎狀態。
    • 優先建立 通用狀態模板:PLAN / EXECUTE / VERIFY / RECOVER 四類,大部分工程任務都能套這個骨架。

    2. 處理 hallucination 與非法狀態

    • 所有 LLM 輸出一律要求 JSON + schema 驗證,非法就走重試邏輯。
    • 在 EDIT_FILE 等關鍵步驟設計 domain guard:
    • 檢查 patch 是否刪除超過 X% 行數;
    • 檢查是否涉及黑名單檔案(例如 config、CI YAML)。

    3. 設計「保守模式」避免改壞檔案

    建議預設開啟:

    1. 所有改動先走分支 / 工作目錄拷貝
    2. 狀態機只在 temp branch/dir 上動手,最後才由人類 review + merge。

    3. 只允許白名單檔案被修改

    4. 在 PLAN_CHANGE 事先產出可修改清單,EDIT_FILE 收到不在清單內的檔案時直接拒絕。

    5. 必備 diff 檢查

    6. 每次改檔後,log 一份 git diff。
    7. 可以加一個 HUMAN_APPROVAL 狀態,在 CI 或 IDE 裡讓人按「Approve」才繼續。

    4. 3060 12GB 本地 GPU 的實務建議

    • 模型:選 Q4_K_M / Q5 量化的 7B–13B 開源模型(如 Llama 系家族、Qwen 等),在 Agentic coding 任務上實測延遲可接受。
    • 推理引擎:
    • llama.cpp / ollama:部署簡單,適合單機開發。
    • vLLM:若你需要高併發與更細緻的 batching,可考慮,但對記憶體稍敏感。
    • 參數建議:
    • max_tokens 控制在 512–2048,依狀態不同調整。
    • temperature 低於 0.3,減少 hallucination。
    • 避免在單輪塞完整檔案,改成 片段 + 明確上下文(例如「你只看這個 function」)。

    5. 映射到現有 Agent framework 的模式

    這套思路可以直接映射到:

    • LangChain / LangGraph:
    • 每個狀態 = 一個 Node(通常是 Tool + LLM)。
    • 轉移條件透過 conditional edges 判斷 JSON output 中的 status / next_state。
    • 用 LangGraph 的 checkpointing 把 Context 存到外部 store,可做恢復與可視化。

    • LangMCP(可檢視狀態的 Agent framework)

    • 把 Context 中的 file_index / plan / test_result 全部納入 inspectable state。
    • 除錯時可以直接在 UI 裡看到「Agent 在哪一步做錯決策」,而不是只看 tokens trace。

    • Claude Code / goal-workflow 類工具

    • 把這裡的狀態機當作後端 orchestrator,前端 IDE 只負責:設定 goal → 顯示 plan → 顯示每步 diff / 測試 → 提供人類 approve。

    總結工程模式:

    LLM 做局部推理 + 生成,狀態機做長期決策 + 記憶 + 恢復。
    把「智慧」從模型本體,搬到你可控、可測、可觀測的工作流程式碼中,13GB 小模型也能在工程任務裡穩定交付 10/10 的結果。


    🚀 你現在可以做的事

    • 在本地架一個 llama.cpp 或 vLLM 的 OpenAI-compatible 服務,載入一顆 7B–13B Q4/Q5 模型試跑上文的狀態機範例
    • 把你現有的「一條大 prompt 改碼流程」改寫成 5–10 個明確狀態,並為每步定義 JSON schema 與 max_retries
    • 在 CI 或開發機中為這套狀態機加上 logging / trace(例如 SQLite 或 OpenTelemetry),實際分析哪個 state 最常出錯
  • 用 Mellum2 排程你的 AI 工作流

    用 Mellum2 排程你的 AI 工作流

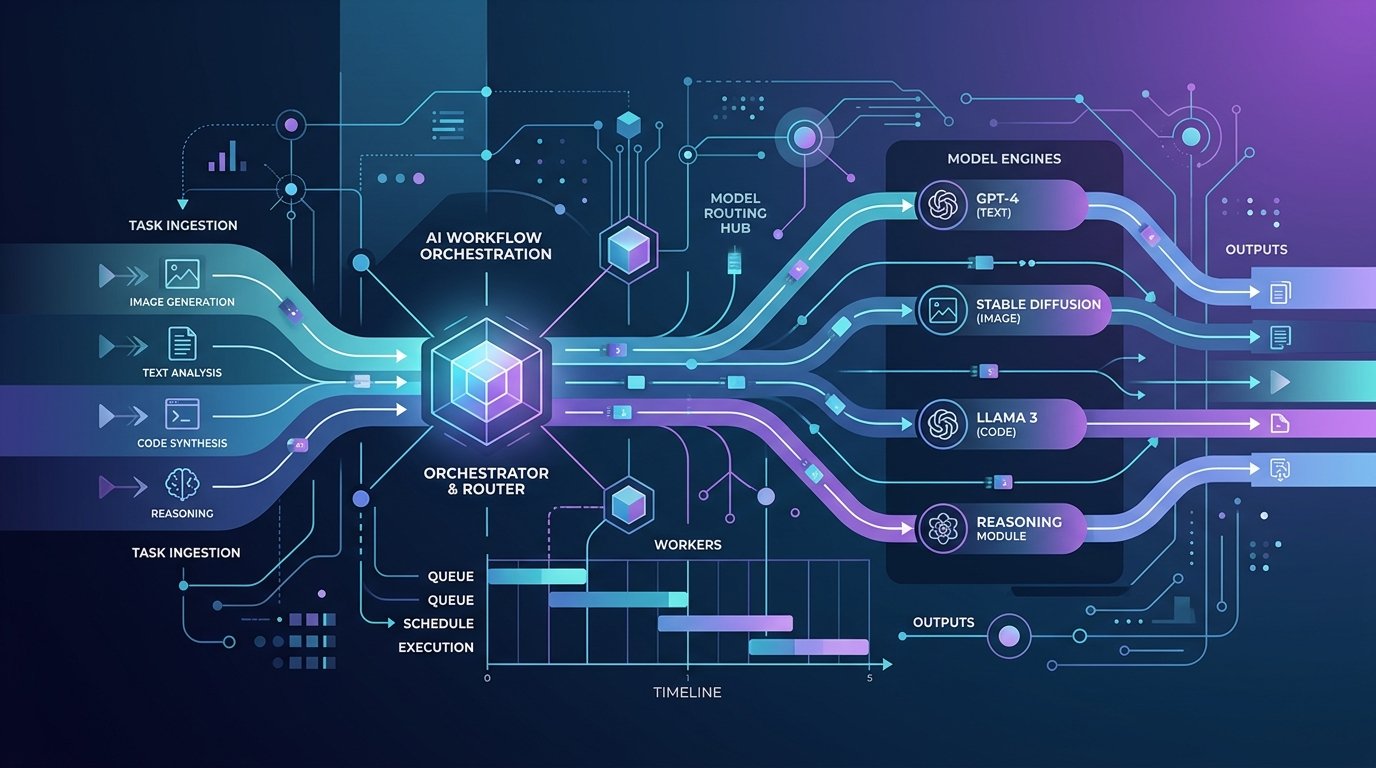
    一句話先說清楚:Mellum2 是一顆專門幫你「排班、調度」其他大模型和工具的小模型,用來做 routing、任務拆解與工具選擇,讓 AI 工作流更便宜、更穩定。

    📌 本文重點

    • Mellum2 是專門做「決策與調度」的小模型
    • 適合負責 routing、任務拆解和工具選擇
    • 能幫多模型、多工具的工作流壓成本、提穩定度
    • 很適合拿來做 AI agent 的中樞大腦

    官方介紹與原始碼:https://blog.jetbrains.com/ai/2026/06/mellum2-goes-open-source-a-fast-model-for-ai-workflows/


    核心功能:先讓 Mellum2 當你的「AI 排班主管」

    1. 低延遲的小模型,適合做決策層

    Mellum2 本身不是 GPT-4o 那種萬能助手,它更像是負責「決定下一步要幹嘛」的主管:

    • 模型體積小、推理快,適合放在整個 pipeline 的最前面或中間層
    • 每次呼叫成本低,很適合頻繁決策:用哪個工具?要不要再拆一步?該重試還是直接回覆?

    💡 關鍵: 把高頻率、邏輯性的「決定怎麼做」交給便宜小模型,昂貴大模型只負責「實際做」,能讓整體成本大幅下降。

    你可以怎麼用?

    • 把「判斷任務類型 → 選模型 → 選工具」這段邏輯,從你程式碼的 if-else 搬到 Mellum2
    • 所有複雜 workflow 的分支規則,盡量改成 prompt + Mellum2 來決定,減少硬寫規則

    2. 多步推理:讓它負責拆任務、串工具

    JetBrains 把 Mellum2 設計成適合多步推理(multi-step reasoning)的模型,也就是它擅長做:

    • 任務拆解:把「寫一份技術規格書」拆成「補資料 → 查 API → 產出草稿 → 校對」
    • 步驟規劃:決定每一步要用哪支工具或哪個 LLM
    • 狀態更新:根據上一個工具的輸出,動態調整下一步

    你可以怎麼用?

    • 把你現有的工具(爬網頁、查資料庫、呼叫商用 LLM)列成一張「工具清單」給 Mellum2
    • 請 Mellum2 每次都輸出「下一步要用的工具 + 工具參數」,你的程式只負責照做

    3. Routing + 工具選擇:讓 GPT、Claude、開源 LLM 都變成「插件」

    Mellum2 最實用的角色,就是做模型路由(model routing)和工具選擇(tool selection):

    • 你可以在後面接:GPT-4.1、Claude 3.7、Llama、Qwen 等
    • Mellum2 根據需求幫你選:「這題要便宜模型」還是「這題要高準確度」

    💡 關鍵: 當你同時使用多個 LLM 供應商時,用 Mellum2 做路由,可以在「品質不明顯下降」的前提下,讓大量請求自動落在較便宜的模型上。

    可以這樣設計一個簡單策略

    • 查資料類問題 → 用便宜/開源 LLM + 搜尋工具
    • 寫程式、寫長文 → 用 GPT-4.1 或 Claude 3.7
    • 簡單 Q&A → 用本地 LLM,節省 API 費用

    你的程式不用管細節,只要:

    1. 收到使用者請求
    2. 把請求 + 目前可用模型列表丟給 Mellum2
    3. 照 Mellum2 的輸出去呼叫對應模型

    適合誰用:三種典型場景

    1. 你在做「AI 助手」或 Agent 系統

    如果你在做:

    • 產品內建 AI 助手(客服、知識庫問答)
    • 自動化 Agent(幫你查資料、寫報告)

    問題通常會是:

    • 使用者問題差異很大,單一模型不是太貴就是太弱
    • 工具越加越多,判斷流程 if-else 爆炸

    Mellum2 能幫你:

    • 把「選模型、選工具、拆步驟」集中到一顆小模型管理
    • 你只要維護工具清單和觀察 Mellum2 的決策是否合理

    可以實作的行動:

    • 先挑三個最常用工具:RAG 搜尋、商用 LLM、本地 LLM
    • 寫一個 Mellum2 prompt,要求它根據需求選 1-3 個步驟完成任務

    2. 你有多個 LLM 供應商,要壓成本又要穩定

    典型狀況:

    • 公司已經有 OpenAI 帳號,也在測 Claude,還有自家的 vLLM 服務
    • 主管希望「多用便宜模型,但品質不能掉太多」

    Mellum2 的用法:

    • 給它模型清單:
    • gpt-4.1: 高成本、高品質
    • gpt-4o-mini: 中等品質、便宜
    • local-llama: 最便宜、品質較不穩
    • 附帶一些示例(few-shot),教 Mellum2 什麼情境選哪個

    💡 關鍵: 先在開發環境裡讓所有請求經過 Mellum2 路由,實際觀察不同任務落在昂貴與便宜模型的比例,再調整規則,比一開始就死寫策略安全得多。

    可以實作的行動:

    • 先在開發環境改成「所有請求都要經過 Mellum2 路由」
    • 觀察一週:不同任務下,商用 LLM 和本地 LLM 的占比、成本變化

    3. 你要做「穩定的 AI Pipeline」而不是單次聊天

    像是:

    • 每天自動爬資料 → 摘要 → 存進 Notion
    • 每次有 Pull Request → 產生 code review 建議

    這種 Pipeline 常見問題:

    • 某個 LLM 偶爾出錯,整條流程掛掉
    • 你需要 fallback 策略:失敗就換模型、換 prompt、換工具

    Mellum2 可以:

    • 監看每一步工具回傳結果(成功 / 失敗 / 異常訊息)
    • 根據結果決定下一步:
    • 重試同一步驟
    • 改用另外一個模型
    • 回報錯誤給人類

    可以實作的行動:

    • 把 Pipeline 的每一步都包成「工具」
    • 每一步的錯誤,也當作輸入回饋給 Mellum2,讓它決定接下來的補救策略

    怎麼開始:從安裝到最小可行範例

    以下流程以「你會用 Docker 或 Python,且已經有至少一個 LLM API(OpenAI / Anthropic / 本地 vLLM)」為前提。

    1. 安裝 Mellum2:Docker 或程式庫二選一

    先到官方部落格或 Repo:https://blog.jetbrains.com/ai/2026/06/mellum2-goes-open-source-a-fast-model-for-ai-workflows/

    選項 A:用 Docker 跑起 Mellum2 服務

    1. 安裝 Docker / Docker Compose
    2. 拉取 Mellum2 映像(以官方 README 為準,示意):

    bash
    docker pull jetbrains/mellum2:latest

    1. 啟動服務(假設開在 8000 port):

    bash
    docker run -p 8000:8000 jetbrains/mellum2:latest

    1. 用 curl 測試:

    bash
    curl -X POST http://localhost:8000/infer \
    -H "Content-Type: application/json" \
    -d '{"input": "你是任務規劃器,請幫我決定下一步要用什麼工具"}'

    適合: 想先用 HTTP API 串現有後端的人。

    選項 B:在程式裡直接呼叫 Mellum2

    如果官方有 Python 套件(假設為 mellum2):

    pip install mellum2
    

    簡單測試:

    from mellum2 import MellumClient
    
    client = MellumClient(base_url="http://localhost:8000")  # 或直接用雲端端點
    
    resp = client.infer("你是任務規劃器,收到任務後要輸出下一步計畫")
    print(resp)
    

    適合: 你準備把 Mellum2 深度嵌到自家服務裡。


    2. 示範:Mellum2 做 Router + 任務規劃的最小 workflow

    下面是一個最小可行例子:

    • 你有兩個底層 LLM:
    • gpt-4.1(高品質)
    • local-llama(便宜)
    • 有一個簡單工具:web_search(用來查網路)
    • 目標:收到使用者問題,由 Mellum2 決定:
    • 要不要先搜尋
    • 要用哪個模型產生最終答案

    Step 1:定義給 Mellum2 的「工具/模型清單」

    TOOLS = [
        {
            "name": "web_search",
            "type": "tool",
            "desc": "適合需要即時或最新資訊的問題,例如股票、新聞、價格。"
        },
    ]
    
    MODELS = [
        {
            "name": "gpt-4.1",
            "cost": "high",
            "quality": "best",
            "desc": "用在需要高準確度、長文、程式碼的回答。"
        },
        {
            "name": "local-llama",
            "cost": "low",
            "quality": "medium",
            "desc": "用在一般聊天、簡單問答。"
        }
    ]
    

    Step 2:設計 Mellum2 Prompt,請它輸出「計畫 JSON」

    SYSTEM_PROMPT = """
    你是 AI 工作流調度器,負責:
    1. 判斷使用者需求
    2. 決定是否要先使用工具
    3. 選擇要使用的底層 LLM
    
    請只輸出 JSON,不要多餘文字,格式:
    {
      "steps": [
        {"action": "tool" | "model", "name": "...", "input_from": "user" | "prev_result"}
      ]
    }
    
    可用工具:
    {tools}
    
    可用模型:
    {models}
    """.format(tools=TOOLS, models=MODELS)
    

    Step 3:呼叫 Mellum2,拿到決策後執行

    import json
    from mellum2 import MellumClient
    
    mellum = MellumClient(base_url="http://localhost:8000")
    
    user_query = "幫我分析最近 NVIDIA 股價的變化,順便預測未來一季可能走勢。"
    
    planning_prompt = SYSTEM_PROMPT + f"\n使用者問題:{user_query}"
    
    plan_resp = mellum.infer(planning_prompt)
    plan = json.loads(plan_resp["text"])  # 依實際回傳欄位調整
    
    result_cache = None
    for step in plan["steps"]:
        if step["action"] == "tool" and step["name"] == "web_search":
            query = user_query if step["input_from"] == "user" else result_cache
            result_cache = call_web_search(query)  # 這是你自己實作的搜尋功能
    
        if step["action"] == "model":
            model_name = step["name"]
            model_input = user_query if step["input_from"] == "user" else result_cache
            result_cache = call_llm(model_name, model_input)  # 依照名稱選擇 gpt / llama
    
    print("最終回答:", result_cache)
    

    這樣,你已經有了一個:

    • Mellum2 做「任務規劃 + 模型/工具選擇」
    • 後端只負責執行計畫的最小可行 workflow

    接下來要擴充,只要:

    • 在 TOOLS / MODELS 裡再加項目
    • 用 few-shot 例子微調 Mellum2 的決策邏輯

    Mellum2 在你的工具箱裡,扮演什麼角色?

    如果從「AI 工作流」角度看,目前常見的組合大致是:

    名稱 核心功能 免費方案 適合誰
    Mellum2 工作流調度、routing、任務拆解 開源可自架 想自己組 AI pipeline,需要細控成本與流程的人
    OpenAI GPT 高品質通用 LLM 有免費額度 需要高品質輸出、但不想自己訓練模型的人
    Claude / Sonnet 對話 & 程式能力強的商用 LLM 有試用 重度寫作、程式輔助、長上下文需求
    本地 LLM(Llama/Qwen) 私有部署、低成本推理 視模型而定 在意隱私或有大批量推理需求的團隊

    Mellum2 並不是另一個「跟你聊天的模型」,而是用來把上面這些工具串起來、排程好、決定誰在什麼時候上場的小模型。

    你可以從一個最小的 routing + 任務規劃範例開始,先讓 Mellum2 管理兩個模型、一支工具,跑順了再往外擴。

    🚀 你現在可以做的事