作者: kerwin77106

  • LLM × sktime craft 打造 AutoForecast

    LLM × sktime craft 打造 AutoForecast

    📌 本文重點

    • 用 sktime + craft() 讓 LLM 設計可訓練的預測 pipeline
    • 以 LLM 當 search policy,降低傳統 AutoML 搜尋成本
    • 把業務限制寫進 prompt,兼顧準確度、延遲與維運

    傳統做時間序列 AutoML,多半靠 grid search / Bayesian search 把模型和超參數「全掃一輪」,成本高、速度慢,而且一換業務場景就得重調。這篇要介紹的是:用 sktime 的 pipeline + craft() 介面,讓 LLM 充當預測藍圖設計師,自動組裝可訓練、可回測的 forecasting pipeline,實際解決:

    • 算力被 AutoML 搜尋吃光的問題
    • 每個產品線都要單獨手調模型的維護地獄
    • 新資料來時,預測流程很難「可重現、自動化演進」的痛點

    重點說明

    1. sktime pipeline + craft():把「模型設計」變成文字介面

    sktime 提供了時間序列專用的 pipeline / composer 抽象,可以把:

    • 前處理(差分、假日特徵、滯後特徵)
    • 模型本體(ARIMA、Gradient Boosting、機器樹、深度模型包裝器)
    • 聚合、多變量等

    組成一個可訓練的 forecaster 物件。

    craft() 的角色:

    • 接收一段以文字描述的「藍圖」或結構化 blueprint
    • 解析成真正的 sktime pipeline 物件
    • 後續你可以直接 .fit() / .predict() / 做交叉驗證

    💡 關鍵: craft() 讓「文字藍圖」直接變成可訓練的 sktime pipeline,是把 LLM 接到 AutoForecast 流程的關鍵樞紐。

    這讓 LLM 可以只負責「寫藍圖」,而不是直接產生一大段 Python 亂碼。


    2. 為什麼用 LLM 當 search policy,而不是再做一個 AutoML

    傳統 AutoML:

    • 先定義 search space(例如 10 種模型 × 10 個超參數 × 若干取值)
    • Grid/Bayesian 搜尋會盲目探索大量組合

    LLM 驅動 AutoForecast 的思路:

    • 你提供:資料描述、目標、限制條件、白名單元件
    • LLM 輸出:一個「專家風格」的 pipeline blueprint
    • sktime craft():把 blueprint 變成真正的 estimator
    • 之後用交叉驗證 + 回測,打分這個藍圖好不好

    好處:

    • 搜尋空間更有結構:LLM 預先排除很多不合理組合
    • 成本可控:每次只訓練少數幾個「有合理解釋」的藍圖
    • 你可以 固化得分高的藍圖,變成穩定的產線預測器

    💡 關鍵: 相較於暴力掃描大量組合,讓 LLM 先縮小「合理藍圖集合」,能在相同算力下探索更有價值的模型設計。


    3. 把業務限制寫進 prompt:準確度只是其中一個目標

    在實務專案中,像房地產、銷售預測一樣,除了誤差小,你還會在乎:

    • 推理時間(每天要跑上千條 SKU / 房源)
    • 部署複雜度(不要依賴罕見套件或 GPU)
    • 解釋性(要能向業務說明為什麼預測變化)

    這些都可以在 prompt 中顯式告訴 LLM,例如:

    • 限定只能用某些 estimator:NaiveForecaster, ExponentialSmoothing, ElasticEnsemble, LightGBM-based forecaster...
    • 給出目標指標:sMAPE 或 MAE,並設計多目標(準確度 + latency)

    實作範例:銷售時間序列 LLM AutoForecast

    以下示範一個簡化版流程:

    • 場景:預測未來 3 個月每月團隊銷售額
    • 資料:月度歷史 revenue、房源數量、成交率、利率、季節 dummy 等

    假設你已經載入 sktime 與一個 LLM SDK(例如 Anthropic、OpenAI 等)。以下程式碼偏 pseudo,但結構可直接套入專案。

    1. 描述資料與目標,建立 LLM prompt

    schema_description = {
        "frequency": "M",  # 月度資料
        "target": "team_gci",  # 團隊佣金收入
        "horizon": 3,  # 預測 3 個月
        "exogenous_features": [
            "active_listings",     # 有效掛牌數
            "pending_transactions", # 待成交案件
            "mortgage_rate",      # 抵押貸款利率
            "seasonality_flags"   # 季節性特徵
        ],
        "constraints": {
            "max_pipeline_depth": 4,
            "allowed_estimators": [
                "NaiveForecaster",
                "ExponentialSmoothing",
                "ThetaForecaster",
                "LightGBMForecaster"
            ],
            "allowed_transformers": [
                "Detrender",
                "STLTransformer",
                "Lag",
                "DateTimeFeatures"
            ],
            "primary_metric": "sMAPE",
            "secondary_metric": "latency_ms",
            "max_fit_time_minutes": 15
        }
    }
    
    system_prompt = """
    你是一位時間序列預測專家,負責設計 sktime 預測 pipeline。
    
    要求:
    1. 只使用以下白名單中的 estimator 和 transformer。
    2. 避免過度複雜的 pipeline,深度不超過 4 層。
    3. 避免使用不存在的類別和參數,嚴格遵守 sktime API。
    4. 針對月度房地產團隊銷售數據,考慮趨勢與季節性。
    5. primary metric 是 sMAPE,次要考慮推理延遲,盡量用輕量模型。
    
    輸出格式:只輸出 JSON,欄位為 `pipeline_spec`,不可包含其他文字。
    `pipeline_spec` 要能被 sktime.craft() 解析。
    """
    
    user_prompt = f"資料與限制如下:\n{schema_description}\n請產生 pipeline_spec。"
    

    2. 呼叫 LLM,取得 pipeline blueprint

    from some_llm_client import LLM
    
    llm = LLM(api_key="...")
    
    response = llm.chat(
        system=system_prompt,
        user=user_prompt
    )
    
    blueprint = response["pipeline_spec"]  # 假設已解析 JSON
    print(blueprint)
    

    例:LLM 可能輸出類似(簡化)

    {
      "type": "TransformedTargetForecaster",
      "steps": [
        {"name": "detrend", "class": "Detrender", "params": {"forecaster": "NaiveForecaster"}},
        {"name": "stl", "class": "STLTransformer", "params": {"seasonal": 7}},
        {"name": "lag", "class": "Lag", "params": {"lags": [1, 2, 3, 6, 12]}},
        {"name": "model", "class": "LightGBMForecaster", "params": {"num_leaves": 31, "learning_rate": 0.05}}
      ]
    }
    

    💡 關鍵: 藉由 max_pipeline_depth = 4、白名單與 max_fit_time_minutes = 15 等約束,LLM 被強迫產出既合理又可在時限內完成訓練的藍圖。

    3. 用 craft() 轉成可執行 pipeline

    from sktime.craft import craft
    
    # 這裡的 blueprint 就是上一步 LLM 回傳的 JSON
    forecaster = craft(blueprint)
    
    print(type(forecaster))
    # e.g. <class 'sktime.forecasting.compose._pipeline.TransformedTargetForecaster'>
    

    如果 LLM 有亂給不存在的 class/參數,這一步會直接爆掉,所以建議外面包一層驗證:

    def safe_craft(blueprint):
        try:
            return craft(blueprint)
        except Exception as e:
            # 記錄錯誤,丟回給 LLM 做自我修正或直接丟棄該藍圖
            print("Invalid blueprint:", e)
            return None
    
    forecaster = safe_craft(blueprint)
    if forecaster is None:
        # 重新請 LLM 生成,或 fallback 到手寫 baseline
        ...
    

    4. 做時間序列交叉驗證與回測(避免 leakage)

    時間序列不能隨機 shuffle,必須用 滾動時間窗。

    from sktime.forecasting.model_selection import ExpandingWindowSplitter
    from sktime.performance_metrics.forecasting import mean_absolute_percentage_error
    
    cv = ExpandingWindowSplitter(
        initial_window=36,  # 例如先用 3 年訓練
        step_length=3,      # 每次往前滾 3 個月
        fh=[1, 2, 3]        # 評估 1-3 個月 horizon
    )
    
    CV_scores = []
    for train_idx, test_idx in cv.split(y):
        y_train, y_test = y.iloc[train_idx], y.iloc[test_idx]
        X_train, X_test = X.iloc[train_idx], X.iloc[test_idx]
    
        forecaster.fit(y_train, X=X_train)
        y_pred = forecaster.predict(fh=cv.fh, X=X_test)
    
        score = mean_absolute_percentage_error(y_test, y_pred)
        CV_scores.append(score)
    
    print("CV MAPE:", sum(CV_scores) / len(CV_scores))
    

    這個流程可以放在一個 LLMBlueprintForecaster 類別裡,作為你的 AutoForecast 前端代理:

    1. 給資料描述與限制
    2. LLM 產生藍圖
    3. craft() 轉成 pipeline
    4. 用時間窗交叉驗證打分
    5. 挑最佳藍圖,固化成產線模型

    建議與注意事項

    1. LLM 亂組 class / 參數:一定要有 validator

    常見問題:

    • 寫出不存在的 class 名稱(如 XGBoostForecaster 明明沒這個)
    • 傳錯 參數名稱 或型別

    實務上建議:

    • 自行維護一份 白名單 registry:ALLOWED_ESTIMATORS, ALLOWED_TRANSFORMERS,包含合法 class 與參數 schema
    • LLM 輸出後先做 schema validation,不合法就直接丟棄或要求 LLM 修正

    2. 避免過度複雜 pipeline:限制深度與組合數

    LLM 很容易產生「看起來很專業」的 pipeline:一堆 transformer 疊來疊去,訓練時間爆炸還容易 overfit。

    做法:

    • 在 prompt 裡明寫:max_pipeline_depth、禁止嵌套某些昂貴 transformer
    • 在 validator 裡硬限制步數,例如 len(steps) <= 4
    • 將 fit time / memory 也當成 約束條件,訓練時加上 timeout + 監控

    3. 嚴格避免 leakage:時間切割一律「只看過去」

    坑點:

    • 把整段資料做標準化 / 滯後特徵時,無意間用到未來資訊

    避免方式:

    • 一律用 sktime 的 transformer + forecaster pipeline,讓 transform 在 fit 只看到 train window
    • cross-validation 必須用 ExpandingWindowSplitter / SlidingWindowSplitter 類型
    • 在 prompt 裡提醒:不得使用未來的統計量(例如整體均值)來處理訓練資料

    4. 在專案中落地:把 LLM 當 search policy,而不是 oracle

    建議實務流程:

    1. Search policy:LLM 只負責提案藍圖,不直接上產線
    2. 離線評估:用固定的 backtest 配置(split、metric、timeout)評估每個藍圖
    3. 固化最佳藍圖:將 blueprint JSON 連同該版本資料 schema 一起存入 repo
    4. CI 自動回歸:
    5. 新資料 schema / 分布變化時,自動對舊藍圖重新訓練 + 打分
    6. 可以定期讓 LLM 在新 constraint 下重新產生藍圖,與舊版本對比
    7. 可重現性:所有 LLM 輸出(prompt + response)都要 versioning(例如存到 S3 / Git LFS),確保每個産線模型的來歷可追溯

    關鍵結論:

    • craft() + LLM = 可控的 AutoForecast 工具鏈,你掌控 search space 與評估邏輯
    • 把 LLM 當作「有經驗的建模同事」,而不是神諭;所有藍圖都要在 sktime 的嚴格回測與 CI 下過關,才能進產線

    這樣,在實際銷售 / 房地產等時間序列場景中,你可以以相對低成本,不斷迭代更好的預測流程,同時維持可重現與可維運的工程品質。


    🚀 你現在可以做的事

    • 在專案中安裝並載入 sktime,試著手動呼叫 craft() 建一個簡單 pipeline
    • 依照文中範例,實作一份包含 max_pipeline_depth 與白名單的 LLM prompt,讓 LLM 先產出一版 pipeline_spec
    • 為產出的 blueprint 加上 safe_craft() + 時間序列交叉驗證,建立一個最小可用的 LLMBlueprintForecaster 原型
  • NuExtract3:把 PDF 截圖變成乾淨資料

    NuExtract3:把 PDF 截圖變成乾淨資料

    📌 本文重點

    • NuExtract3 專門做「影像 / PDF → 結構化文字」
    • 直接輸出 JSON / Markdown,省掉後續清洗
    • 可自架本地部署,敏感資料不用上雲
    • 用 prompt 自訂欄位 schema,方便接到現有 workflow

    把亂七八糟的 PDF、發票截圖、表格照片,丟進 NuExtract3,就能直接拿到乾淨的 JSON / Markdown 結構化資料,方便你後續丟進 Notion、Google Sheet 或資料庫繼續用。

    官方開源介紹(含 Demo 連結):Reddit:NuExtract3 released


    核心功能:三件事講完 NuExtract3

    1. 多種文件型態,一次搞定

    NuExtract3 是基於 Qwen3.5-4B 訓練的開源多模態模型(Apache-2.0 授權),主打「影像 / PDF → 結構化文字」。實際可以拿來處理:

    • 多頁 PDF:報表、合約、研究報告
    • 發票、收據、報銷單:紙本拍照、掃描檔
    • 表格:Excel 匯出成 PDF、紙本表單的掃描
    • 表單截圖:Google Form 結果頁、線上後台報表截圖

    你只要準備:

    • 一個檔案(PDF / 圖片)
    • 一個「你想要的結構」描述(例如:請輸出成 JSON,欄位有 date、vendor、total_amount)

    就能讓它幫你把畫面裡的內容拉成乾淨結構。

    💡 關鍵: 只要定義好欄位結構,NuExtract3 就能把任何格式雜亂的文件,轉成統一結構的資料,後續處理成本會大幅下降。


    2. 直接輸出 JSON / Markdown,少一個清洗步驟

    NuExtract3 的設計重點不是「純 OCR」,而是「OCR + 結構化輸出」。實際測試時,你可以要求:

    • 輸出 JSON:適合丟進程式、API、資料庫
    • 輸出 Markdown:適合整理筆記、放進 Notion、Obsidian

    例如你給他一張發票照片,提示可以這樣寫:

    你是一個資料錄入助手。從這張發票中擷取欄位,並輸出 JSON:
    {
      "date": "發票日期 (YYYY-MM-DD)",
      "vendor": "商家名稱",
      "invoice_number": "發票號碼",
      "items": [
        {"name": "品項名稱", "quantity": 數量, "unit_price": 單價, "amount": 金額}
      ],
      "subtotal": 小計,
      "tax": 稅額,
      "total": 總金額
    }
    如果沒有某個欄位,填 null。
    

    輸出就會直接是可用的 JSON,不用再寫額外的字串處理把文字拆欄位。


    3. 本地部署,自已控管資料隱私

    NuExtract3 以「開源權重、自架」為主:

    • 模型權重可下載,Apache-2.0 授權,可商用
    • 可以在自己筆電、公司伺服器上跑
    • 不需要把發票、合約等敏感文件上傳到第三方雲端

    你可以先在官方 Hugging Face Space 線上試,用得順手再搬回本地。

    線上 Demo(免註冊):搜「NuExtract3」即可在 Hugging Face Spaces 上找到官方 Space。

    💡 關鍵: 在合約、財務等敏感場景,自架 + 開源授權讓你既能自動化,又不必冒資料外流風險。


    適合誰用:三個典型場景

    1. 財務 / 行政:發票、報銷單半自動錄入

    適用情境:

    • 同事每個月丟一堆發票照片、PDF 報銷單
    • 你要把日期、金額、商家、發票號碼一筆筆打進系統或 Excel

    可以這樣用:

    1. 把所有發票照片存進一個資料夾
    2. 用腳本逐張丟給 NuExtract3,要求輸出統一格式的 JSON
    3. 把 JSON 轉成 CSV,匯入到:
    4. 公司報銷系統
    5. Google Sheet 統計報表

    立即可做的行動:
    – 把你現有的 2–3 張發票/收據,丟進官方 Space,測試能不能抓出你要的欄位(日期/金額/店名)。


    2. 自媒體 / 法務:整理掃描合約、條款重點

    適用情境:

    • 合作合約只有掃描版 PDF
    • 你只關心「合約雙方」「金額」「期限」「解約條件」「付款節點」

    你可以:

    1. 把 PDF 上傳 NuExtract3
    2. 用自然語言指定要的欄位,例如:
    請閱讀這份合約,並用 JSON 回答:
    {
      "party_a": "甲方名稱",
      "party_b": "乙方名稱",
      "contract_term": "合約期間(文字說明)",
      "payment_terms": "付款條件摘要",
      "termination_clause": "解約條款摘要"
    }
    
    1. 把輸出貼進 Notion,或丟給 ChatGPT / 其他 LLM 再做風險檢查

    立即可做的行動:
    – 找一份你平常會反覆查的合約掃描檔,試著用 NuExtract3 生成「合約摘要 Markdown」,看可讀性如何。


    3. 數據分析師:報表、問卷結果結構化

    適用情境:

    • 手上有 PDF 報表、問卷紙本掃描
    • 想要的,是一張可以直接做分析的表格

    使用方式:

    1. 對著一頁表格截圖
    2. 提示要求輸出成「每列一筆紀錄」的 JSON 陣列
    把這頁問卷結果表格,轉成 JSON 陣列,每列是一位受訪者:
    [
      {
        "id": "編號",
        "age": 年齡,
        "gender": "性別",
        "q1": "問題1答案",
        "q2": "問題2答案"
      }
    ]
    
    1. 把 JSON 轉成 CSV 後丟進 Python / R / Excel 分析

    立即可做的行動:
    – 拿一頁報表截圖,試著讓 NuExtract3 幫你還原成表格,再貼進 Google Sheet 看欄位是否正確。


    怎麼開始:五分鐘上手路線

    步驟 0:先線上玩一次(不用裝任何東西)

    1. 打開瀏覽器,前往 Hugging Face Space(搜尋 NuExtract3)
    2. 上傳一張發票 / 合約 / 表格截圖
    3. 在「指令」欄位輸入你想要的輸出格式(JSON / Markdown + 欄位定義)
    4. 看輸出結果是否符合你平常的工作需求

    如果這步已經感覺能用,再考慮搬回本機或公司伺服器。

    💡 關鍵: 先用線上 Demo 驗證「欄位抓得準不準」,再投入時間做 Docker 與腳本整合,能避免白做工。


    步驟 1:在本機 / 伺服器用 Docker 跑起服務

    以下是假設官方提供 Docker 映像的典型流程(實際請以官方 README 為準):

    # 1. 拉取映像
    docker pull numind/nuextract3:latest
    
    # 2. 啟動服務(假設開在 8000 port)
    docker run -d \
      --gpus all \
      -p 8000:8000 \
      --name nuextract3 \
      numind/nuextract3:latest
    

    啟動後通常會有一個簡單 API,例如:

    curl -X POST http://localhost:8000/extract \
      -F "file=@invoice.jpg" \
      -F 'prompt=請擷取發票資訊並輸出 JSON,欄位:date, vendor, total_amount'
    

    回傳的就是 JSON 結果,可以直接被腳本處理。


    步驟 2:用簡單 Python Script 跑推論

    如果你偏好直接在 Python 裡呼叫(例如透過 vLLM / Transformers),典型流程會像這樣(範例示意):

    from PIL import Image
    import requests
    import json
    
    API_URL = "http://localhost:8000/extract"
    
    image_path = "./samples/invoice.jpg"
    prompt = "請從這張發票擷取日期(date)、商家(vendor)、總金額(total_amount),並輸出 JSON。"
    
    files = {"file": open(image_path, "rb")}
    data = {"prompt": prompt}
    
    resp = requests.post(API_URL, files=files, data=data)
    result = resp.json()
    
    print(json.dumps(result, ensure_ascii=False, indent=2))
    

    這段可以直接嵌入到你現有的報表處理、RPA 流程裡。


    步驟 3:自訂你的欄位 schema

    NuExtract3 沒有「固定欄位」,而是靠你的提示(prompt)決定要萃取什麼。實作時可以:

    1. 先在 Notion / Google Sheet 寫好你要的欄位列表,例如:
    2. date
    3. vendor
    4. category
    5. subtotal
    6. tax
    7. total
    8. 在提示裡把這些欄位寫成 JSON 模板,明確說明格式
    9. 要求:
    10. 用固定欄位名稱
    11. 金額用數字,不要加貨幣符號
    12. 缺失欄位填 null

    這樣輸出就更穩定,後續程式處理也比較不容易爆炸。


    步驟 4:組一個簡單 workflow:NuExtract3 + Google Sheet / Notion

    你可以很快做出一個「半自動錄入」流程:

    發票例子:

    1. 把所有發票照片放進 invoices/ 資料夾
    2. 用 Python 跑一個簡單批次處理:
    3. 逐張呼叫 NuExtract3 API
    4. 收集 JSON 結果
    5. 把 JSON 轉成 CSV:
    6. 用 pandas 寫入 Google Sheet(透過 Google API)
    7. 或匯出 CSV 手動上傳

    概念範例:

    import os, json, requests, csv
    
    API_URL = "http://localhost:8000/extract"
    
    rows = []
    for fname in os.listdir("./invoices"):
      with open(os.path.join("./invoices", fname), "rb") as f:
        resp = requests.post(
          API_URL,
          files={"file": f},
          data={"prompt": "請輸出 JSON,欄位:date, vendor, total_amount"}
        )
      data = resp.json()
      rows.append([data["date"], data["vendor"], data["total_amount"]])
    
    with open("invoices.csv", "w", newline="", encoding="utf-8") as fp:
      writer = csv.writer(fp)
      writer.writerow(["date", "vendor", "total_amount"])
      writer.writerows(rows)
    

    Notion 的話,則可以用 Notion API 建立資料庫頁面,把每一筆 JSON 轉成一筆資料列。


    小結:什麼時候值得用 NuExtract3?

    • 你有大量掃描檔、截圖要轉成結構化資料
    • 內容多是表格、發票、收據、合約這類「格式固定但樣式雜」的文件
    • 你在意 資料不能丟到雲端,希望自架

    先在 Hugging Face Space 玩 10 分鐘,如果覺得可用,再花半天把 Docker + 簡單腳本接起來,你就多了一個專門幫你「把亂檔變乾淨資料」的本地工具。

    🚀 你現在可以做的事

    • 上 Hugging Face 搜尋 NuExtract3,用 2–3 張發票或表格截圖測試輸出 JSON / Markdown
    • 在 Notion 或 Google Sheet 列出你常用的欄位 schema,順手寫一個對應的 prompt 模板
    • 在本機用 Docker 跑起 nuextract3,照文中的 curl 或 Python 範例打一次 API,驗證能否接到現有流程
  • 把 NVIDIA Deep Research 當實習生用

    把 NVIDIA Deep Research 當實習生用

    📌 本文重點

    • NVIDIA Deep Research Agent 是「會自己調研與寫報告」的 AI 實習生
    • 能自動上網搜尋、整理來源並產出可追溯的研究報告
    • 以「專案工作空間」形式運作,適合市場研究與技術選型等場景

    用一句話講清楚:NVIDIA Deep Research Agent 就是「會自己上網查資料、存筆記、整理報告、附上引用來源」的 AI 實習生,比一般只能聊天的機器人,更接近一個真的研究助理。

    專案連結(GitHub):https://github.com/NVIDIA/GenerativeAIExamples/tree/main/agents/deep-research


    核心功能:比一般聊天機器人多了什麼?

    1. 會自己規劃調研流程,而不是只回一段答案

    一般聊天機器人:

    • 你問:「幫我看 2024 台灣電動車市場發展?」
    • 它直接生成一段「看起來合理」的摘要,但可能沒查新資料,來源不明。

    Deep Research Agent 的做法:

    1. 先把問題拆成子任務:市場規模、主要品牌、政策、關鍵數據…
    2. 逐步上網搜索,每一步都記錄查到的內容
    3. 整理成「研究筆記檔」,最後再寫成報告

    💡 關鍵: Deep Research 不是只回一段答案,而是走完整「拆題 → 搜尋 → 做筆記 → 成稿」流程。

    你可以做的事:

    • 在 prompt 裡直接下達研究任務,例如:
    • 「請做一份 5 頁的市場研究:主題是台灣 2024 電動車市場,列出主要品牌、市佔估計、最近一年重要新聞,最後整理成簡短建議。」
    • 把它當「會自己查資料的實習生」,而不是問答機器人。

    2. 自動搜尋 + 整理來源,幫你做「可追溯」的研究

    Deep Research Agent 會:

    • 主動呼叫搜尋工具(預設走網路 search API)
    • 讀取多個網站內容,過濾重複與雜訊
    • 把每條資訊連同來源網址存起來
    • 最後在報告中附上清楚引用(像研究報告的 reference 區)

    對比一般聊天機器人:

    • 回答多半是「綜合模型訓練時學到的知識」,很難知道哪一段是最新、哪一段來自哪個來源。

    💡 關鍵: 每個關鍵結論都對應具體網址,讓你可以抽查與追溯,而不是盲目信任模型輸出。

    你可以做的事:

    • 要求它在輸出中固定附上引用區,例如:
    • 「請在每個關鍵結論後標注 [來源 1] [來源 2],並在文末列出完整網址。」
    • 用這些引用,手動抽查 1–2 個關鍵數據,確保內容可信。

    延伸閱讀:NVIDIA 開源介紹文章(Towards AI)
    https://pub.towardsai.net/nvidia-open-sourced-a-deep-research-agent-that-beat-openai-on-its-own-benchmarks-5339b3f547fb


    3. 有「工作空間」的 Agent,而不是沒記憶的聊天框

    很多非程式碼 Agent 做不好,很大原因是沒有穩定工作空間——這點在 Reddit 討論裡講得很清楚:non-coding agents should also live in file systems。

    Deep Research Agent 的設計比較像一個「專案資料夾」:

    • 每個研究任務會形成一組檔案:
    • 原始搜尋結果
    • 中途整理的筆記
    • 最終報告
    • Agent 可以反覆讀寫這些檔案,再繼續深化研究

    💡 關鍵: 用「檔案與專案」當記憶體,讓 Agent 可以多輪迭代深化同一主題,而不是每次從零開始聊。

    你可以做的事:

    • 把每一個「問它的大問題」當成一個專案,例如:
    • project: EV-market-tw-2024
    • project: crm-tools-comparison
    • 把產出的 Markdown 報告直接丟進你的筆記軟體(Obsidian、Notion)當專案檔案。

    適合誰用?幾個實際場景

    1. 市場研究 / 會前簡報

    需求:你要開一場客戶會議,得先快速了解對方產業現況。

    操作示例:

    • 任務描述:
    • 「客戶是做 B2B SaaS CRM 的,幫我整理 2022–2024 全球 B2B CRM 市場趨勢、主要玩家、常見商業模式,最後整理一句話電梯簡報 + 5 項我應該問的問題。」
    • 把 Deep Research Agent 的報告:
    • 直接 copy 成 PowerPoint 大綱
    • 或貼到 Notion,當成會前 brief

    2. 競品分析 / 工具選型

    需求:你在選 CRM、客服系統、A/B test 平台。

    操作示例:

    • 任務描述:
    • 「幫我比較 Intercom、Zendesk、Freshdesk 三個工具,重點看價格方案、支援語言、整合 API 能力,做成表格,最後給出 3 種不同規模公司(10 人、50 人、200 人)的建議。」
    • 你要做的:
    • 把輸出的表格貼進你團隊的提案文件
    • 把引用網址交給實習生或同事做二次驗證

    3. 技術選型調研

    需求:你在選擇 LLM、RAG 架構或 MCP agent 框架要上線到產品(可參考這篇實戰文:https://pub.towardsai.net/i-shipped-a-rag-mcp-agent-to-production-five-things-broke-0f030ff6f3f9)。

    操作示例:

    • 任務描述:
    • 「整理目前主流的 RAG + MCP agent 開源方案,要求列出:GitHub 星數、是否支援雲端 / 本地部署、常見踩坑與評估建議,重點對象是要上 production 的 SaaS 團隊。」
    • 接著你可以:
    • 用報告當作技術評估會議的初稿
    • 在每個風險點上再請 Deep Research Agent 深挖,反覆迭代。

    怎麼開始:從安裝到接上你的知識庫

    1. 準備環境與 API Key

    最低需求:

    • Python 3.10+ 環境(本機或雲端都可)
    • 一張 NVIDIA GPU 會更順(但也可只用雲端 API)
    • 至少一個可用的 LLM API Key,例如:
    • NVIDIA NIM / NVIDIA API
    • 或其他支援的雲端模型供應商

    你要做的事:

    1. 申請 NVIDIA API 帳號(若使用他們的模型):https://build.nvidia.com
    2. 拿到 API Key,寫入 .env 或環境變數,例如:

    bash
    export NVIDIA_API_KEY="你的 key"


    2. 安裝與在本機快速跑起來

    以 GitHub 專案為主線:

    git clone https://github.com/NVIDIA/GenerativeAIExamples.git
    cd GenerativeAIExamples/agents/deep-research
    
    # 建議開一個虛擬環境
    python -m venv .venv
    source .venv/bin/activate  # Windows 用 .venv\Scripts\activate
    
    pip install -r requirements.txt
    

    通常範例專案會提供一個 demo 指令(名稱可能略有變化,依 README 為準):

    python deep_research.py \
      --query "請分析台灣 2024 電動車市場的主要趨勢與廠商" \
      --output ./outputs/ev-market-tw-2024.md
    

    你要做的事:

    • 改掉 --query 裡的內容,直接換成你現在真正在做的專案題目
    • 執行後,到 outputs/ 夾裡打開 Markdown 報告

    3. 在雲端(Colab / VS Code Remote)跑

    如果你本機沒有 GPU 或懶得裝環境,可以:

    • 找一份針對 NVIDIA Deep Research Agent 的 Colab notebook(通常社群會有人整理)
    • 或在雲端 VM(如 AWS、GCP、Azure)裡跑上述安裝流程

    你要做的事:

    • 儲存好 notebook,當成你的「研究模板」
    • 每次只改問題與輸出檔名,就能重複使用。

    4. 串接到你的筆記 / 知識庫工作流

    目標:建立一條「從問題 → 調研 → 報告」的固定管線。

    最簡單做法:

    1. 輸出格式固定用 Markdown:
    2. 在啟動腳本中加入:--format markdown(若有此選項)
    3. 指定輸出資料夾對應到筆記工具:
    4. Obsidian:把 outputs/ 變成一個 vault 內的資料夾
    5. Notion:用 Notion API 定期把 outputs/*.md 同步上去
    6. 在筆記裡建立「研究模版」:
    7. 標題:{{專案名稱}} Deep Research 報告
    8. 區塊:背景、發現、數據表、風險、建議、來源連結

    你可以立刻做的事:

    • 為你接下來一週要決定的「一個重要選項」(例如要不要換 CRM)建一個專案資料夾
    • 用 Deep Research Agent 生成第一版調研報告
    • 用你自己的專業重新整理重點後,發給團隊當決策前閱讀材料。

    小結:把它當「會查資料的實習生」,而不是魔法

    使用 NVIDIA Deep Research Agent 的正確心態:

    • 它擅長的是幫你大量收集與初步整理,節省你 60–80% 搜集資料的時間
    • 你仍然要:
    • 選題、定義問題
    • 抽查關鍵引用
    • 把輸出整理成真正要對外發表的報告或簡報

    💡 關鍵: 把 60–80% 搜資料的時間交給 Agent,你可以把精力放在判斷與決策上。

    只要先從一個你本來就要做的調研開始,你很快就會感受到,把 AI 當實習生用,和「只是多一個聊天機器人」有多大差別。

    🚀 你現在可以做的事

    • 打開 GitHub 專案並依照 README 完成安裝,跑一次示範指令
    • 挑一個你這週真的要做的決策議題,寫成 --query 給 Deep Research Agent
    • 把產出的第一版報告整理進 Obsidian 或 Notion,當作團隊會議前閱讀材料
  • ClickUp 裁員,其實是在排練新公司形態

    ClickUp 裁員,其實是在排練新公司形態

    📌 本文重點

    • AI 正在從「工具」變成可編制的「員工單位」
    • 成本結構轉為「人力+雲端」綁在一起,治理風險倍增
    • 能管理 AI 的人與組織,將主導下一輪權力重分配

    第一個敢公開說「用數千個 AI 代理換掉數百名員工」的,不只是 ClickUp,而是整個軟體業的真心話被說出口。這不是一次孤立的裁員,而是「AI 員工作為產品類別」成形的標誌事件,預演的是未來公司裡:老闆是人,幹活的是 AI,人類只剩少數「指揮官」。真正要被升級的,不是員工的服從度,而是企業對 AI 治理、審計與責任 的認知。


    一、從「工具」到「員工」:AI 正在變成一個清楚的「編制」選項

    在 TechCrunch 的報導裡,ClickUp 這家九年的協作軟體新創,選擇用「數千個 AI agents 替代數百名員工」。這句話的關鍵不只在於比率,而在於說法:不是用 AI 功能提升效率,而是直接用 AI 當「員工單位」。

    💡 關鍵: 從「提升效率的工具」到「可編制的員工單位」,代表 AI 已正式成為組織設計中的人力替代選項。

    對照 Reddit 上那篇整理「AI employees / digital workers / AI teammates」的討論,可以看到一個清晰的產品地圖:

    • AI SDR、AI 客服、AI 招聘、AI 會計、法遵代理、工程/SRE 代理、安全分析、醫療行政
    • 它們不是「大模型 API」,而是被包裝成一個可購買的「職缺」:買一年,就等於請一名(或一隊)數位員工

    也就是說,企業在做組織設計時,開始有三種選項:

    1. 正職員工(薪資+保險+辦公成本)
    2. 外包/顧問(按專案計費)
    3. AI 員工/代理人(按席位、按任務或按 Token 計價)

    ClickUp 的選擇,是把第 1 類大幅削減,直接擴大第 3 類。這件事一旦被證明在財報上「說得過去」,就會變成一種新標準:

    「為什麼這個職能還是人,不是 AI 員工?」

    這跟 2010s 的雲端轉型很像:當年問題是「為什麼還要自己養機房?」;未來問題會變成「為什麼還要自己養這麼多人?」


    二、「裁員+代理」= 新版雲端+外包,但有三個關鍵差異

    表面上,這波 AI 代理潮很像 2010 年代的 雲端化+外包潮:

    • 企業把機房搬上 AWS / GCP,砍掉 IT 基礎設施團隊
    • 業務支援、客服與部分開發工作外包到成本更低的地區

    但這一次有三個本質差異:

    1. AI 不是「交給別人」,而是「交給沒人格的東西」

    外包還是人,你可以簽約、要求加班、追究責任;AI 代理沒有勞動契約、沒有加班費,也沒有「人格責任」,只有 服務條款 與 模型提供商的 SLA。

    結果是:

    • 責任鏈從「員工 → 部門主管 → 公司」
    • 變成「模型提供商 → 平台 → 使用公司」,勞動責任變成產品責任,監管邏輯完全不同

    2. 成本結構從「固定開支」變成「變動雲帳單」,壓力更直接

    Uber COO Andrew Macdonald 已經公開說,越來越難為某些 「tokenmaxxing」式的 AI 開銷辯護──就是那種為了「最強大模型」瘋狂燒推論成本、卻說不清 ROI 的專案。

    Wix 的案例更直接:

    • 核心業務仍成長,Q1 營收 YoY +14%、Bookings +15%
    • 同時是史上最大裁員:砍掉約 800–1000 人,占 20% 員工
    • 主因是:收購 Base44、自建模型、推論成本與行銷費,把利潤吃光

    💡 關鍵: 即便營收還在成長,若 AI 成本與收購壓縮利潤,企業仍會用大規模裁員修正成本結構。

    2010s 的雲端潮,其實是「CapEx 換成 OpEx」;AI 代理潮則是「人力成本+雲端成本纏在一起」,變成一張每月浮動的 GPU 帳單。沒算清楚,很快就會走上 Uber/Wix 的抱怨路線:效率沒明顯起來,但雲帳單每天在燒現金。

    3. 自動化不再只砍「藍領流程」,而是砍進白領決策鏈

    上一波自動化,多數是對準工廠、倉儲、客服前線;這一波的 AI 員工,直接瞄準的是:

    • SDR、行銷投放、合約審閱、會計對帳、報表編撰、程式碼維護

    換句話說,這次被自動化的,是「辦公室裡的你」。而 ClickUp 的作法,把這件事做得非常明牌:

    不是「幫你省時間」,而是「把你換掉」。


    三、誰會先被替代?誰反而能靠 AI 擴張?

    1. 風險排序:先砍「流程型白領」,再動「問題定義者」

    從目前 AI 員工產品圖譜來看,最危險的族群有三類:

    1. 高度標準化、以文書為主的白領:
    2. 如客服、基礎 HR、低階會計、標準合約審核、KYC/AML 初審
    3. 特徵:輸入結構清楚、輸出有模板、指標明確好衡量
    4. 流程導向的初階工程與維運:
    5. Bug triage、簡單 ticket 處理、重複性 refactor、監控報警初步分析
    6. 越是「照 Runbook 就能做完」的工作,越容易被 AI SRE / AI Developer 接手
    7. 只會「操作工具」、不會定義問題的中階職位:
    8. 例如只會把客戶需求變成 Jira 任務、把會議紀錄抄進 Confluence 的「資訊中繼站」

    相對安全的,是那些:

    • 能定義 KPI、設計流程,甚至能為 AI 員工訂出「工作說明書」的人
    • 能在錯誤情境裡,跨部門協調、承擔對外責任的人

    簡單講:能管理 AI 的人,暫時比被 AI 管的人安全。

    2. 中小企業:不是被吃掉,而是第一次有「自帶外包團隊」的機會

    另一邊,對 中小企業與中小銀行 這種資源有限的組織,AI 代理反而是一種擴張槓桿。

    以文章 〈Agentic AI and the SMB Banking Advantage〉 的觀察為例:

    • 約 78% 的中小銀行 已導入 SaaS 核心銀行平台
    • 到 2026 年,SaaS/託管模式預計占核心銀行市場 約 2/3

    💡 關鍵: 流程已被 SaaS 標準化的產業,中小玩家可以率先用 AI 代理獲得「類大企業級」自動化能力。

    這些 SaaS 系統本身就把流程「標準化、結構化」,再疊上 agentic AI,就變成:

    • 中小銀行可以用 AI 代理人跑合規檢查、風險評估、客服
    • 不必自建巨大的 IT / 風控團隊,卻能達到類似大行的自動化水準

    同樣邏輯放大到所有中小企業:

    有 SaaS、流程清楚的小公司,會比「什麼都自己客製」的大公司,更快接上 AI 代理編排。

    真正會被吃掉的,是沒有把流程標準化、又同時失去人力與人才的中型組織:人不夠多做事、系統又亂到 AI 無法接手。


    四、勞動法規與監管:AI 雇主 vs 人類員工,新戰場在哪?

    ClickUp 這種「用 AI 代理取代員工」的動作,遲早會逼監管機構回答幾個具體問題:

    1. 集體裁員+大量導入 AI,有沒有新的通報與評估義務?
    2. 現有的勞動法規只看人頭數,不看「AI 取代比例」
    3. 未來很可能會要求:大規模自動化前,要做影響評估、職訓計畫或補償機制

    4. AI 員工犯錯,算誰的過失?

    5. 錯誤放貸、歧視性篩選履歷、錯殺帳號,責任在使用公司?模型供應商?還是 SaaS 平台?
    6. 監管趨勢會逼出一套 「AI 風險分攤」條款與審計標準

    7. AI 代理的「行為紀錄」要如何保存與稽核?

    8. 若 AI 自動下單、調整價格、拒絕客戶,日後爭議時要查看哪一層 log?
    9. 這會催生 AI 審計工具、語義治理平台、Agent 行為 Replay 系統 的新市場

    換句話說:

    未來的勞檢,不只查加班單,還要查 AI 代理的 Decision Log。

    真正有前瞻性的公司,不會等監管來,而是先把 AI 治理、審計與責任分工 內建到技術與流程裡。


    結論:現在該做的,不是抱怨 AI,而是重寫你的「職位說明書」

    ClickUp 不是特例,而是企業開始把自己當成「AI 雇主」的第一聲槍。在這個新博弈裡,你如果只是希望「不要被 AI 換掉」,基本上已經輸了一半。

    對不同角色,我的具體建議是:

    • 工程師與白領:
    • 立刻開始練習:用 AI 代理完成一個完整業務流程,而不是只用 ChatGPT 改句子
    • 把自己變成「AI 團隊領班」:會設計流程、定 KPI、寫 prompt-runbook、看 log、調整策略
    • 中小企業與團隊主管:
    • 先做兩件事:標準化流程+選對 SaaS 平台,再談導入 AI 代理
    • 把 AI 席位當成「人頭」管理:計算單位產出、錯誤率、監控成本,而不是只看「有沒有用上最強模型」
    • 企業決策者與法務:
    • 立即建立最小可行的 AI 治理框架:權責矩陣、審計 log、模型供應商合約中的責任條款
    • 把「AI 員工」當成一個新的法律風險來源,而不是單純的 IT 成本項目

    這一波浪潮裡,真正需要被升級的,不是員工的服從度,而是企業對 AI 治理與責任的成熟度。能及早把 AI 當成「要管理的員工」,而不是「炫耀的功能」的組織,才有資格在下一輪裁員名單之外,寫下別人的未來。

    🚀 你現在可以做的事

    • 寫一份「AI 代理職位說明書」,設計一個你工作中可由 AI 接手的完整流程
    • 盤點團隊目前使用的 SaaS,標記出哪些流程最適合先導入 AI 代理
    • 與法務或管理層討論,草擬一版簡單的 AI 治理框架與 Decision Log 留存規範
  • Claude 私有化:自托管沙箱與 MCP 隧道實戰

    Claude 私有化:自托管沙箱與 MCP 隧道實戰

    📌 本文重點

    • 模型與編排托管在 Anthropic,工具與資料留在你 VPC
    • 透過 self‑hosted sandbox 把程式執行權收回內網
    • 用 MCP tunnel 只開安全出站連線打通內網工具
    • 權限設計與審計要靠嚴格的 tools schema 與網路邊界

    典型企業場景:你想讓 Claude Managed Agent 幫你跑 CI/CD、讀內網 Git、打內部 REST / Postgres API,但 不能開公網入站、不能把 Git 暴露出去。這次的 self‑hosted sandboxes + MCP tunnels 更新,基本上就是:

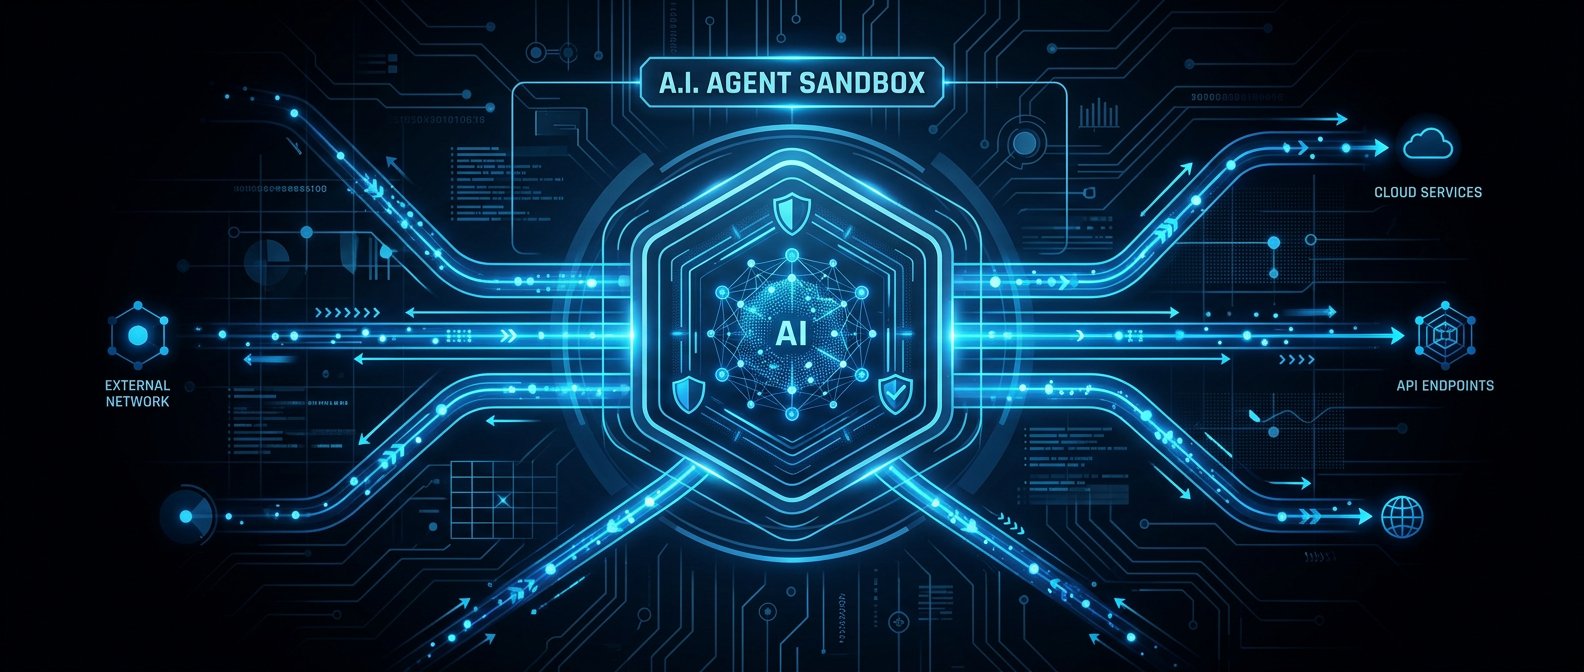
    模型與編排留在 Anthropic,工具執行與資料存取拉回你自己的 VPC,且只用安全出站連線。

    實務上等於多了一種選擇:不用把模型拉進內網自建 inference,也能在嚴格邊界內讓 Agent 控制 CI、讀 repo、查 DB。


    重點說明:架構與安全邊界怎麼畫

    1. Orchestrator vs Tools:誰在外面、誰在裡面?

    Claude Managed Agents 大致拆成兩層:

    1. Orchestrator(Anthropic 端托管)
    2. 理解使用者意圖、規劃步驟、決定要叫哪些工具。
    3. 透過 MCP 協定 呼叫你定義的 tools(MCP server)。

    4. Tools / MCP servers(你自己控制)

    5. 例如:git、CI/CD runner、Postgres、內部 REST API。
    6. 可以跑在 self‑hosted sandbox 裡(受控容器/VM),或直接在你內網 VPC。

    💡 關鍵: Orchestrator 永遠只看得到你暴露出的 MCP tools 與其 I/O,真正的 Git / DB 資料面與執行權都留在你 VPC。

    關鍵:Orchestrator 看不到你的 Git/DB,只能透過你暴露出的 MCP tools 操作,權限由你決定。


    2. MCP 協定與 server:最小必須心智模型

    MCP server 就是一個會講 JSON‑RPC over stdio / WebSocket 的後端,向 Agent 宣告自己有哪些工具。概念類似「強 typing 的 function calling」。

    一個簡化版的 MCP server schema(YAML)可能長這樣:

    name: corp-dev-tools
    version: 0.1.0
    
    tools:
      - name: git_read_file
        description: 讀取內部 Git repo 某個檔案內容
        input_schema:
          type: object
          required: [repo, path, ref]
          properties:
            repo: { type: string }
            path: { type: string }
            ref:  { type: string }
    
      - name: ci_trigger_pipeline
        description: 觸發 CI pipeline,只能在 allowlist 專案上執行
        input_schema:
          type: object
          required: [project, branch]
          properties:
            project: { type: string }
            branch:  { type: string }
    

    Agent 端會看到 明確的工具清單與參數結構,再決定何時呼叫。


    3. Self‑hosted sandbox:把「程式執行權」留在自己這邊

    self‑hosted sandbox 解決的是:「我不想讓 Anthropic 直接在他們 infra 上跑 shell / Python,請改在我 VPC 裡跑」。

    實作上可以是:

    • 一個專用 k8s namespace 或 Fargate / VM,跑 Anthropic 提供的 sandbox runtime。
    • Agent 要執行程式碼(例如跑單元測試、lint、git 操作),會透過安全通道把 code / 指令丟到這個 sandbox。

    典型邊界設計:

    • sandbox 只能出站連到:
    • 你的 Git / CI / DB / 內部 API
    • Anthropic 的 MCP tunnel endpoint
    • 不能直連其他敏感系統(或至少預設 deny)。

    實際好處: Agent 可以幫你跑 pytest、打 CI webhook、改 Git branch,
    但所有「可以執行程式碼的環境」都在你的控制下,方便做防火牆、資安掃描、審計。


    4. MCP tunnels:如何在不開洞的情況下連到內網

    MCP tunnel 解決:「我的 MCP server 在 VPC 裡,如何讓 Anthropic 托管的 Agent 打到它,但我不願意開入站 443?」

    典型拓撲:

    [Anthropic Orchestrator]
            ^
            | (MCP over tunnel)
            v
    [MCP Tunnel Client in VPC] ----> [MCP Server + Sandbox]
              (outbound TLS)
    

    關鍵特性:

    • 只有 VPC → Anthropic 的出站連線(類似反向隧道)。
    • 隧道建立後,Anthropic 端像是在打本地 MCP server,但實際流量是經由你建立的 mutual TLS / token 隧道轉回來。
    • 容易套用零信任思路:每條隧道都視為一個 identity,綁定最小權限的一組 tools。

    💡 關鍵: 只用出站隧道與 mTLS,就能在不開任何入站 port 的前提下,把內網工具安全地接給 Managed Agent 用。


    實作範例:VPC 內最小可行架構

    場景:

    • VPC 內:
    • 一台 MCP server + sandbox Pod/VM。
    • 連得上 GitLab、Postgres、內部 https://api.intra。
    • 出站:允許打到 Anthropic 的 MCP tunnel endpoint。

    1. MCP server:Git + Postgres + REST API

    以 Node.js 為例(pseudo‑code):

    import { MCPServer } from "@anthropic-ai/mcp-sdk";
    import { execSync } from "node:child_process";
    import { Client } from "pg";
    import fetch from "node-fetch";
    
    const gitAllowlist = ["service-a", "service-b"];
    
    const server = new MCPServer({ name: "corp-dev-tools" });
    
    server.tool("git_read_file", async ({ repo, path, ref }) => {
      if (!gitAllowlist.includes(repo)) {
        throw new Error("repo not allowed");
      }
      const base = "/srv/git/" + repo;
      const content = execSync(`git --git-dir=${base} show ${ref}:${path}`, {
        encoding: "utf8",
      });
      return { content };
    });
    
    server.tool("db_read_customer", async ({ id }) => {
      const client = new Client({
        host: process.env.PG_HOST,
        user: "readonly_agent",
        password: process.env.PG_PWD,
        database: "app",
        ssl: true,
      });
      await client.connect();
      const res = await client.query("SELECT id, name, status FROM customers WHERE id=$1", [id]);
      await client.end();
      return { rows: res.rows };
    });
    
    server.tool("call_internal_api", async ({ path, method, body }) => {
      if (!path.startsWith("/public-agent/") || method !== "POST") {
        throw new Error("not allowed");
      }
      const resp = await fetch(`https://api.intra${path}`, {
        method,
        headers: { "Authorization": `Bearer ${process.env.AGENT_TOKEN}` },
        body: JSON.stringify(body ?? {}),
      });
      const json = await resp.json();
      return { status: resp.status, data: json };
    });
    
    server.listen();
    

    重點:

    • gitAllowlist:避免 Agent 任意讀所有 repo。
    • Postgres 使用 readonly_agent 帳號,限制只讀特定 schema。
    • 內部 API 降到 /public-agent/ 子路徑 + 專用 token。

    2. MCP tunnel client:出站連上 Anthropic

    實際指令會以官方 CLI / container 為主,概念配置類似:

    anthropic-mcp-tunnel \
      --mcp-url=http://localhost:8000 \
      --agent-id=corp-ci-agent \
      --tls-cert=/etc/mcp/cert.pem \
      --tls-key=/etc/mcp/key.pem \
      --anthropic-endpoint=https://mcp-tunnel.anthropic.com \
      --tags=env:prod,scope:ci
    

    在 Anthropic 控制台,你會:

    • 建立一個 Managed Agent:corp-ci-agent。
    • 只綁定這條 tunnel 曝露的 corp-dev-tools MCP server。
    • 開啟前人工審閱 / 部分工具 auto‑approve(視風險)。

    3. ACL 與工具權限設計

    簡單的 policy‑as‑code 思路:

    agent: corp-ci-agent
    allowed_tools:
      - git_read_file
      - ci_trigger_pipeline
      - db_read_customer
      - call_internal_api
    
    constraints:
      git_read_file:
        repos: ["service-a", "service-b"]
        max_file_size_kb: 256
    
      db_read_customer:
        max_rows: 1
    
      call_internal_api:
        allowed_paths:
          - "/public-agent/deploy"
          - "/public-agent/status"
    

    你可以在 MCP server 裡讀這個 YAML,做額外校驗。不要把 ACL 寫死在 prompt 裡,防禦提示注入要靠程式碼與網路邊界。


    建議與注意事項:安全坑與實務整合

    1. 工具權限過大 = Agent RCE 風險

    OWASP Agent Top 10 已經把 工具濫用 / 權限濫用 列為前幾名風險。常見錯誤:

    • 一個 tool 可以執行任意 shell、對任何 DB 下任意 query。
    • Agent 可以打到整個內網,而不是只打 CI / Git / API Gateway。

    建議:

    • 一個 tool 做一件小事,強 schema,避免 free‑form SQL / shell。
    • DB 使用 只讀 + row‑level / column‑level policy。
    • 網路上用 安全群組 / SG 把 sandbox 能打的 IP 段鎖死。

    2. 審計 / Logging:要記「自然語言意圖 + 工具調用」

    很多企業只有 infra log,缺少「Agent 為什麼要做這件事」的上下文。

    建議最低標準:

    • 針對每次工具呼叫記錄:
    • user_id / session_id
    • Agent 看到的 自然語言任務描述(可脫敏)
    • 工具名稱 + input 參數(敏感欄位做 partial redaction)
    • 執行結果摘要 / status code

    這樣在事後對齊 OWASP 事件分析時,才能把「提示注入 → 工具濫用 → 資料外洩」串成一條 timeline。


    3. 網路與認證:守住 MCP 隧道與 secrets

    重點:把隧道視為一個高價值通道,跟 VPN 一樣認真看待。

    具體建議:

    • 隧道一律走 mTLS,cert 由內部 CA 或雲端 CA 管理。
    • 隧道 client 的 API token / cert 放在 Vault / KMS,sandbox 上只拿短期 lease。
    • 工具裡 不要回傳 secrets(例如整個 JWT 與 DB 密碼)到 Agent,必要時只在 server 端使用。
    • 若擔心 API key 滲透,在 sandbox 層加 egress proxy,對外送出的 HTTP header 做檢查 / scrub。

    4. 與 SOAR/服務目錄/Secrets 管理整合的實務問題

    實務上會遇到:

    • SOAR / ticket 系統:
    • 建議把「開 ticket / 查告警 / 執行 playbook」封裝成 MCP tools,權限沿用既有 RBAC。

    • 服務目錄(例如 Backstage):

    • MCP tools 可以讀服務目錄 API,讓 Agent 知道 repo 屬於哪個團隊、能不能改 config。

    • Secrets 管理(Vault/KMS):

    • 不要給 Agent 直接讀 Vault 的能力;改由 MCP tool 在 server 端解密,對 Agent 只暴露結果(或再加工)。

    5. 和「模型拉進內網自建 inference」的取捨

    Managed Agent + self‑hosted sandbox + MCP tunnel:

    • 優點:
    • 不用自己跑 LLM cluster,只負責工具、網路、權限。
    • 快速接雲端最新模型(含之後像 Mythos 這種安全模型的企業版)。
    • 合規上:資料只經由 tools 進出,你可以精準監控。

    • 缺點:

    • Orchestrator 還是在 Anthropic,那邊仍會看到 工具 I/O 摘要。
    • 對極端資料主權(完全不能出域)的場景不適合。

    自建 inference:

    • 優點:
    • 完整掌控模型與權限,所有 token 在你網段內。

    • 缺點:

    • 要自己做 Agent orchestration、tooling、guardrail、OWASP Top 10 風險防護。
    • 成本與維運門檻高。

    如果你目前已在雲上、允許「模型在外、資料在內」,這次的 Claude Managed Agents 私有化能力 是一個相對平衡的折衷:

    把最麻煩的 LLM 與 Agent orchestration 交給 Anthropic,把最敏感的程式執行與資料權限留在 VPC,用 MCP + sandbox 畫清楚邊界。

    🚀 你現在可以做的事

    • 在現有 VPC 內起一個簡單 corp-dev-tools MCP server(照文中 Node.js 範例改成你公司的 Git / DB / API)
    • 部署 anthropic-mcp-tunnel 類似的隧道 client,實測只用出站連線即可讓 Managed Agent 操作內網工具
    • 寫一份 YAML ACL(如文中 policy‑as‑code 範例),把 repo / DB / API 權限具體收斂後再開放給 Agent 使用
  • RTK 終端機 AI 助手:少花 90% Token

    RTK 終端機 AI 助手:少花 90% Token

    📌 本文重點

    • RTK 用結構化壓縮幫你減少重複丟給模型的 Token
    • 常用專案可重用上下文,問越多次平均越省
    • 在終端開發流程中無痛接入,五分鐘內可上手

    你現在用 AI 幫忙寫程式,很可能有一大半錢都燒在「重複丟給模型看的 Token」上,而 RTK 要做的,就是在終端機幫你把這些多餘 Token 全部擠乾。

    專案連結:https://github.com/rtk-ai/rtk


    核心功能:RTK 怎麼幫你少丟 Token?

    1. Prompt 壓縮:把廢話變成精簡結構

    一般你在終端機複製錯誤訊息、整段程式碼給 AI,看起來沒幾行,實際 Token 超多。RTK 做的事是:

    • 先在本地做「結構化」:分出錯誤訊息、檔案片段、指令上下文
    • 用短 Prompt 模板描述需求,例如:
    • 錯誤訊息 + 詢問目標(幫我找 bug)
    • 這段程式 + 修改要求(改成 async)
    • 最後送給模型的內容會是高度壓縮的結構,而不是你手動貼的一大坨文字

    你可以這樣行動:

    • 不要再打長篇自然語言 Prompt,改用 RTK 的命令別名(例如 rtk fix, rtk explain),把「要做什麼」交給 RTK 的模板處理。

    2. 上下文重用:同一個專案不重講第二次

    平常你每問一次 AI:「這個專案是做什麼的?」「這個模組是幹嘛?」都在重複付費。RTK 會:

    • 對常問的目標(例如某個目錄、特定檔案)做一次「結構化摘要」
    • 接下來跟同一個會話相關的指令,就重用這些摘要,而不是把整份檔案再丟一次

    具體效果:

    • 問同一個 repo 的問題越多次,平均每次的 Token 消耗越低
    • 對超過數萬行的專案,差異會特別明顯

    💡 關鍵: 專案越大、問越多次,RTK 的上下文重用機制帶來的平均 Token 成本下降就越明顯。

    你可以這樣行動:

    • 針對常用專案建立一個 RTK 會話,之後都在這個會話裡問問題,而不是每次都「一次性丟完所有檔案」。

    3. 結構化輸入 / 輸出:減少「看懂答案」的成本

    RTK 不只壓縮你給模型的內容,也會讓模型的回答更結構化,例如:

    • 要求模型輸出固定格式:原因 / 修復步驟 / 建議指令,而不是亂聊一通
    • 要模型只返回「要改的那幾行」,而不是整份檔案,減少輸出 Token

    你可以這樣行動:

    • 習慣用 RTK 指令,而不是「請用條列式說明」這種自然語言;RTK 已經替你定義好能省 Token 又好讀的輸出格式。

    RTK 當 CLI 代理:三種高頻使用場景

    1. 日常開發:錯誤訊息、修小段程式、產生命令

    在日常開發中,你大概會一直做這幾件事:

    1. 看錯誤訊息:不知道哪裡爆
    2. 改小段程式:加 log、改型別、改函式簽名
    3. 產生命令:不知道某個工具的 CLI 參數要怎麼下

    RTK 的典型玩法:

    • 看錯誤訊息

    bash
    # 把上一個命令的錯誤訊息丟給 RTK 解釋
    some-command-that-fails 2>error.log
    rtk explain-error < error.log

    行動:把原本你會貼到 ChatGPT / Claude 的 error log,改成用 rtk explain-error,RTK 會用短 Prompt + 結構化提問幫你省 Token。

    • 改小段程式

    bash
    # 針對某個檔案的一小段範圍做修改建議
    rtk edit src/main.rs --range 20-60 --ask "改成 async/await 風格,保留原本邏輯"

    行動:只給 RTK「相關的幾十行」,不要整支檔案,RTK 會幫你把上下文描述給模型,降低 Token。

    • 產生命令

    bash
    # 根據需求生成 shell 指令,不用自己翻 man page
    rtk cmd "把 logs 資料夾裡 7 天前的 .log 壓成一個 tar.gz,檔名帶日期"

    行動:用自然語言描述「你想做什麼」,讓 RTK 負責用精簡 Prompt 跟模型談,輸出最終的 shell 指令。


    2. 讀專案:總結檔案、生成說明、快速問代碼

    當你接手一個新 repo,通常會做:

    • 看 README 還是不懂整體架構
    • 想知道某個模組的職責
    • 想快速問「這個函式在哪裡用到」

    RTK 的用法可以是:

    • 總結檔案 / 目錄

    “`bash
    # 總結一個檔案在幹嘛
    rtk summarize src/lib.rs

    # 總結一個目錄的主要模組與職責
    rtk summarize src/handlers/
    “`

    • 生成說明文件

    bash
    # 幫某個模組產生說明文字(例如供 PR 或文件用)
    rtk doc src/services/user.rs --format markdown

    • 快速問代碼

    bash
    # 在 repo 裡問問題,RTK 只會選關聯檔案給模型看
    rtk ask "登入流程中,token 驗證主要在哪幾個檔案處理?"

    行動:把「整個 repo 丟進 AI」改成「用 rtk summarize 和 rtk ask 針對性查詢」,每次只給必要檔案,Token 消耗會明顯下降。


    3. 結合 tmux / fzf / git workflow:變成隨叫隨用 AI 幫手

    RTK 的本質是單一 CLI binary,很適合跟你現有的終端機工具整合:

    • 搭配 tmux:固定一個 pane 做 RTK 聊天視窗

    bash
    # tmux 裡開一個新 pane 專門跑 rtk chat
    rtk chat

    行動:在 tmux 裡維持一個長期會話,RTK 可以反覆重用上下文,越聊越省 Token。

    • 搭配 fzf:選檔後丟給 RTK

    bash
    # 用 fzf 選一個檔案丟給 RTK 總結
    rtk summarize "$(fzf)"

    • 搭配 git workflow:讓 AI 看 diff 而不是整檔

    bash
    # 只把當前變更的 diff 丟給 RTK 請他協助寫 PR 說明
    git diff > /tmp/diff.patch
    rtk explain-diff < /tmp/diff.patch

    行動:在你的 shell 設定(例如 .zshrc 或 .bashrc)裡建立幾個 alias,把平常會複製貼上的工作改用 RTK 處理:

    alias rpr="git diff | rtk explain-diff"
    alias rerr="rtk explain-error"
    

    適合誰用?三種典型開發者

    • 1. 每天都開著 AI 編輯器(Cursor、Claude Code)的工程師
      你已經習慣「寫一寫就問 AI」,RTK 適合接在你終端機工作流的空白處:看 log、看 diff、產生命令,這些在編輯器之外的操作用 RTK 承接,Token 花在真正需要的地方。

    • 2. 維護大型專案或多 repo 的開發者
      尤其是 Rust / Java / monorepo,檔案多、型別長、錯誤訊息又臭又長,用 RTK 的結構化摘要 + 上下文重用,可以顯著減少「每次都要把半個專案丟給 AI」的情況。

    • 3. 自費用 API Key 的個人開發者 / Side project 作者
      如果你是自己刷卡買 OpenAI / Anthropic / 其他 LLM Token,用 RTK 是直接對帳單有感的程度;原本一個月 30–50 美金的,也許可以壓到 10–20 美金。

    💡 關鍵: 若你自己付模型費,用 RTK 把「貼錯誤 / 貼整檔 / 貼 diff」改成結構化對話,帳單級別的節省會非常直接。


    5 分鐘開始用 RTK:安裝、設定、跑幾個指令

    1. 安裝單一 binary

    到 GitHub Releases 頁下載對應平台的 binary:

    • 進入 https://github.com/rtk-ai/rtk
    • 點選右側 Releases
    • 下載對應系統檔案(例如 rtk-x86_64-unknown-linux-gnu、rtk-aarch64-apple-darwin)
    • 賦予執行權限並放到 PATH 裡,例如:
    chmod +x rtk-x86_64-unknown-linux-gnu
    sudo mv rtk-x86_64-unknown-linux-gnu /usr/local/bin/rtk
    

    2. 設定 API Key

    RTK 本身不附模型,你需要設定自己的 LLM 供應商 API key(例如 OpenAI / Anthropic 等,依官方文件為準):

    export OPENAI_API_KEY="你的 key"
    # 或依照 RTK 說明設定 RTK 專用環境變數,例如:
    export RTK_MODEL_PROVIDER=openai
    export RTK_MODEL=gpt-4.1-mini
    

    建議:

    • 選一個便宜的小模型當預設(例如 gpt-4.x-mini / o3-mini 類型),RTK 本身就已經會幫你省 Token,小模型更划算。

    💡 關鍵: 把 RTK_MODEL 設成較便宜的小模型,再搭配 Prompt 壓縮,能在不明顯犧牲效果的前提下把成本再壓一截。


    3. 試跑幾個典型指令

    照著下面三步走,你大概五分鐘內就能感受到 RTK 的節奏:

    1. 解讀錯誤訊息

    bash
    cargo build 2>error.log
    rtk explain-error < error.log

    1. 總結專案主檔案

    bash
    rtk summarize src/main.rs

    1. 生成一個命令

    bash
    rtk cmd "找出今天修改過的 .rs 檔,列出檔名和變更行數"


    怎麼量化:你到底省了多少 Token?

    如果你是自己付費買 API,建議直接用「帳單」來感受 RTK 的效果,而不是只看官方說的 60–90%。你可以:

    1. 先觀察一週的原始用量
    2. 不改工作流程,照常用 Cursor / Claude Code / ChatGPT 開發
    3. 記下這週在模型供應商後台的 Token 用量 / 金額

    4. 下一週加上 RTK

    5. 日常 terminal 問題全部改用 RTK(錯誤、log、diff、命令)
    6. 大型專案閱讀改用 rtk summarize 和 rtk ask

    7. 對比兩週帳單

    8. 如果你平常大量貼錯誤訊息、整檔 code、diff 給 AI,看起來會有 30–50% 甚至更多的節省

    進階做法:

    • 把 RTK 指令加上 --verbose 或開啟 debug log(依官方說明),讓它輸出實際的 Token 用量,對照供應商後台的數字,清楚看到壓縮前後的差異。

    RTK 的重點不是「多一個聊天機器人」,而是把你原本就會做的事——貼錯誤、貼代碼、貼 diff 問 AI——改成一種對 Token 比較友善的方式。如果你現在已經很依賴 AI 寫程式,那麼把這些對話搬進 RTK,大概是最省時、也最省錢的下一步。

    🚀 你現在可以做的事

    • 進入 RTK GitHub Releases 下載對應平台的 rtk binary 並加入 PATH
    • 在 shell 設定中加入 OPENAI_API_KEY 與 RTK_MODEL 等環境變數,設好預設小模型
    • 建立幾個常用 alias(例如 rerr, rpr),並用 rtk explain-error、rtk summarize 開始取代貼到聊天機器人的動作
  • 用 Claude.md 做一個不會爛掉的長跑代理

    用 Claude.md 做一個不會爛掉的長跑代理

    📌 本文重點

    • 用 CLAUDE.md 嚴格約束代理行為,避免長跑爛掉
    • 核心原則是「行動+證據」,禁止空談與無限迴圈
    • 透過上下文壓力自查與簡潔憲法,讓代理長時間穩定運作

    用一份不到 100 行的 CLAUDE.md,就能讓你的 Claude 代理連跑幾小時都不會開始胡言亂語、卡住不動或重複修同一個 bug。

    參考原作者在 Reddit 的分享:
    – 長跑 Claude Code 代理的設定檔開源文:https://www.reddit.com/r/ClaudeAI/comments/1tjy3sk/i_opensourced_the_operating_file_that_keeps_my/
    – 100 條個人 AI 代理實戰心得:https://www.reddit.com/r/ClaudeAI/comments/1thi6nh/100_tips_tricks_for_building_your_own_personal_ai/


    核心功能:這份 CLAUDE.md 到底做了什麼?

    1. 只允許「行動與證據」,禁止長篇空談

    長跑代理會爛掉,通常是這三個症狀:

    1. 開始寫「我將會…」「接下來我要…」但不真的執行工具
    2. 一直說「應該已修好」但沒有測試結果
    3. 花很多篇幅重複解釋計畫,實際變更很少

    CLAUDE.md 的核心規則,就是把這些行為全部關掉:

    • 輸出只允許三種型態:
    • 已完成的動作(例如:檔案修改、指令執行、API 呼叫)
    • 具體問題 / 需要決策的提問
    • 極短的進度摘要
    • 聲稱「完成」前要附證據:如測試輸出、報表截圖路徑、命令列結果

    💡 關鍵: 將輸出限制為「行動+證據」,能大幅減少長篇空談與無效迴圈,讓長跑代理真正持續推進任務

    你可以做的事:
    – 在你的專案根目錄放一份 CLAUDE.md,明確寫出:
    – 「不要描述你要做什麼,只要直接做並回報結果」
    – 「任何『應該已修好』前,必須貼出測試輸出」

    2. 內建「上下文壓力」自我檢查

    長跑幾小時後,對話上下文會變超長,Claude 開始:

    • 忘記早期需求
    • 無法把握目前專案狀態
    • 回答變模糊或重覆

    原作者在 CLAUDE.md 裡加了一條關鍵原則:

    代理要定期自查上下文壓力:發現自己搞不清狀態,就主動整理摘要、刪除多餘上下文、或要求人類幫它重設現狀。

    具體做法通常包含:

    • 每完成一個階段任務,就輸出一個「短摘要 + 關鍵檔案清單」
    • 長度過大時,優先保留:
    • 最新的決策
    • 目前版本的檔案 / 結構
    • 尚未完成的待辦

    你可以做的事:
    – 在 CLAUDE.md 寫明:
    – 「當你感覺自己不確定目前狀態時,先輸出一份 10 行內的現況摘要,再繼續工作。」
    – 「如需要,可要求人類提供『目前唯一真實狀態』說明,並用這份說明覆蓋舊假設。」

    3. 任務憲法:不靠「一長串 Prompt」,靠幾條簡潔原則

    多數人用代理會寫一大段 prompt,結果 Claude 讀不完、也記不住。CLAUDE.md 的思路是:

    • 用 10–20 條簡短規則,定義這個代理的「憲法」
    • 每條都要能對應到實際行為約束,例如:
    • 「若有工具可以做某事,優先用工具,不要手寫模擬輸出」
    • 「對同一錯誤連續嘗試 3 次仍失敗,就停下來請人類決策,不要無限迴圈」

    💡 關鍵: 把 10–20 條行為規則寫成固定「憲法」,比灌輸一大段單次 prompt 更能在長跑中維持穩定行為

    參考 Reddit 另一篇實戰文:https://www.reddit.com/r/ClaudeAI/comments/1thi6nh/100_tips_tricks_for_building_your_own_personal_ai/

    你可以做的事:
    – 先列出你的代理最常「爛掉」的 3 個行為,逐條寫進 CLAUDE.md,用「禁止 / 應改為」的格式:
    – 「禁止:連續兩次貼出幾乎相同的錯誤訊息。應改為:第二次失敗時,整理你已試過的方法,請人類選下一步。」


    適合誰用:3 個實戰場景

    1. 單機腳本型代理:排程任務、批次資料處理

    你有這些需求時,很適合:

    • 每晚跑一次報表轉檔腳本
    • 每週整理一批 CSV / Excel 檔,把欄位標準化
    • 定期爬某個網站的資料、存到本地或資料庫

    做法:

    1. 用 Claude Code 或本地腳本,讓代理可以:
    2. 讀寫特定資料夾
    3. 執行 shell 指令(或以 PowerShell / bash 包一層)
    4. 把 CLAUDE.md 放在專案根目錄,寫清楚:
    5. 允許改動哪些檔案
    6. 批次任務完成的判定方式(例如輸出檔案數量、檔名規則)
    7. 用排程工具觸發:
    8. macOS / Linux:cron 或 systemd timer
    9. Windows:排程工作排程器 + 命令列啟動代理腳本

    2. 長連線開發代理:Claude Code / VS Code / Cursor 類工作流

    如果你常用 Claude 來寫程式、改大型專案,長時間開著一個 session,很容易出現:

    • 忘記三小時前的設計決定
    • 重複修同一支檔案
    • 一直在講解架構,但實際 commit 很少

    這時 CLAUDE.md 非常好用:

    實際操作:

    1. 在 VS Code 專案根目錄新增 CLAUDE.md,內容包含:
    2. 專案簡述
    3. 允許的工具(例如:跑測試、執行 npm test、pytest 等)
    4. 「行動 > 敘述」與「證據 > 猜測」等規則
    5. 在 Claude Code / Cursor 內重新開啟專案,確保代理會讀到這個檔案
    6. 開發時明確下指令:
    7. 「請遵守 CLAUDE.md,連續工作直到完成以下任務…」
    8. 「每完成一個子任務,產出最多 5 行的進度摘要」

    進階:也可以搭配多代理流程,參考:https://www.reddit.com/r/ClaudeAI/comments/1thi16y/how_i_built_a_9agent_team_where_my_agents/

    3. 自建小型自動化服務:抓報表、清理資料

    你想做一些「半自動」小工具,例如:

    • 每週自動登入內部系統下載報表
    • 讀取資料夾裡的新檔案,做資料清洗 / 格式標準化
    • 根據最新資料,產出簡短摘要寄 Email

    可用的整合方式:

    • MCP / shell 指令:
    • 透過 Model Context Protocol 暴露一組工具給 Claude,例如:
      • list_files, read_file, run_command
    • 規則寫進 CLAUDE.md:

      • 「處理檔案時,一律用工具列出檔名,不要從記憶猜」
    • Power Automate:

    • 由 Power Automate 排程觸發 HTTP / CLI,呼叫你的 Claude 代理後端
    • 回傳的結果可再串 Outlook 寄信、寫入 Excel、更新 SharePoint

    你可以做的事:
    – 先選一個最小自動化任務,例如「每週整理銷售報表」,只把這一個流程寫入 CLAUDE.md,確保跑穩,再慢慢加其他任務。


    10 分鐘上手:從 fork 到跑起你自己的代理

    以下是一條「10 分鐘內能動起來」的最短路徑,你可以依你使用的工具微調。

    Step 1:fork 開源專案

    1. 前往 Reddit 原文查看作者提供的 repo(通常會在貼文內):https://www.reddit.com/r/ClaudeAI/comments/1tjy3sk/i_opensourced_the_operating_file_that_keeps_my/
    2. 在 GitHub 上 fork 到自己的帳號
    3. 本地 git clone 下來

    Step 2:複製 CLAUDE.md 到你的專案

    1. 打開作者的 CLAUDE.md,通讀一遍規則
    2. 複製到你自己的專案根目錄
    3. 只做三種修改:
    4. 把專案描述改成你的任務(例如:財報整理、數據清洗、網站爬蟲)
    5. 調整允許使用的工具(例如是否允許 rm / 刪檔)
    6. 加上 2–3 條你最在意的「不准爛掉」條款

    💡 關鍵: 只動專案描述、工具白名單與 2–3 條關鍵禁令,能在 10 分鐘內把通用 CLAUDE.md 變成專屬代理憲法

    Step 3:綁定你常用的工作環境

    依你用的平台選一條:

    • Claude Code / VS Code / Cursor:
    • 在這個專案資料夾內開啟編輯器
    • 確認工具(跑測試、shell、檔案操作)已啟用
    • 對 Claude 說:「請讀 CLAUDE.md 並照裡面的規則長時間工作」

    • MCP + shell 指令:

    • 建立一個 MCP server,提供 run_shell, read_file, write_file 等工具
    • 在 CLAUDE.md 明確寫出「所有系統操作一律經由 MCP 工具」
    • 用你偏好的前端(例如自寫 CLI、簡單 Web)呼叫 Claude

    • Power Automate / 其他自動化:

    • 建一個小型後端服務(可用 Python FastAPI / Node.js)包住 Claude API
    • 後端每次呼叫 Claude 時,都把專案檔案+CLAUDE.md 帶入 context
    • 用 Power Automate 定期觸發這個 API

    Step 4:跑一個「能觀察的」任務,調整規則

    1. 選一個 30–60 分鐘的任務給代理連續跑(例如重構某一個資料夾的程式碼)
    2. 觀察:
    3. 什麼時候開始廢話變多?
    4. 哪種情況會卡在同一個錯誤?
    5. 直接把這些「失敗模式」寫回 CLAUDE.md 變成新條款

    重複兩三輪,你會得到一份專屬於你工作流、而且真的能「長跑不爛」的代理憲法。


    小結:先管好行為,再管工具

    長跑 AI 代理很容易越跑越爛,通常問題不在模型,而在缺乏清楚的行為規則。透過一份設計良好的 CLAUDE.md:

    • 把輸出限制在「行動+證據」
    • 讓代理主動監控上下文壓力
    • 用幾條簡單原則當作「憲法」

    你可以在單機腳本、開發環境、多工具自動化裡,得到一個穩定得多的 Claude 代理。

    建議從今天開始:先為你最常用的一個專案寫一份 CLAUDE.md,跑一個完整任務,看看它能連續跑多久還保持專注。那會是你感受到「長跑代理真的可用」的第一步。

    🚀 你現在可以做的事

    • 在一個常用專案根目錄新建 CLAUDE.md,寫入「行動+證據」與上下文自查規則後實際跑一次長任務
    • 從 Reddit 原文 fork 作者 repo,閱讀並複製其中 CLAUDE.md,依你的工作流做 2–3 處客製調整
    • 列出你代理常見的 3 個「爛掉模式」,逐條轉寫成禁止條款加進 CLAUDE.md,並在下一次工作中觀察效果
  • Google 把雲變成 Agent 基建,誰付最後的代價?

    Google 把雲變成 Agent 基建,誰付最後的代價?

    📌 本文重點

    • Google 正在把雲端重編成以 Agent 為核心的作業系統
    • 企業將被迫面對平台級遷徙與安全、成本治理壓力
    • 真正瓶頸不在模型能力,而是對長駐 Agent 的信任邊界
    • 使用 Agent 時必須預先設計可退出與多平台彈性

    Google 這次不是多加一個 AI 功能,而是試圖把「整個雲端與應用層」重編成一個以 Agent 為核心的作業系統。 當 Gemini Agent 從手機、Gmail、車載系統一路打進企業後台,問題已經不是要不要用 AI,而是:我們要不要接受「所有關鍵流程都跑在 Google 的 Agent 執行層上」這件事?


    一、這不是功能疊加,而是雲端定義權之戰

    從今年 I/O 的脈絡看,Google 的動作有幾個關鍵轉折:

    • 「Agentic Gemini 時代」宣言:Sundar 在 Google I/O 上直接把今年定義為 Agentic Gemini era,不再只談 LLM,改談「多代理系統、智能工作流」。
    • 模型全面 Agent 化:
    • Gemini Omni / Omni Flash 成為預設多模態底座,語音、影像、文字一次吃下來,對應車用 EX60 外部攝影機讀路邊標誌這類場景。
    • Gemini App 被重新定位為「全用途 AI 中樞」,而不是一個聊天視窗,明示「未來所有互動都可以是 Agent 任務」。
    • Workspace 進入實際運維階段:
    • Gmail 可以跟你對話、幫你找信、幫你回信,從摘要工具變成「郵件工作流程代理」。
    • Docs、Sheets 內的 Gemini 不再只是寫字,而是能調整排程、發信通知、串其他服務——也就是開始動你的 workflow。
    • Vertex AI 被「Gemini Enterprise Agent Platform」取代:這是關鍵一步。
    • 名稱上直接從「模型服務平台」升級成「Agent 平台」。
    • 功能上把 開發、編排、治理、安全 全拉進同一層,並宣稱支援 200+ 模型(含 Gemini、Gemma、Claude),也就是:
      • 你愛用哪家模型都行,
      • 但編排與運維一律跑在 Google 的 Agent 平台上。

    💡 關鍵: Google 要你可以自由選模型,但把「真正難換的執行與治理層」鎖在自家雲端。

    這跟單純「我也有 Agent SDK」是不同量級:Google 的戰略,是把「雲端 = Agent 執行層」。

    對比競爭者:

    • Microsoft Copilot Cowork 也在做相似的事:
    • 用 Work IQ 理解組織上下文與流程,在 Microsoft 365、Dynamics、Power BI、各種 ERP 之間跑來跑去,實質變成「企業工作流 OS」。
    • Anthropic 則是走「代理產品直接變營收引擎」路線,用 Claude 代理 接案、做 B2B,自上而下證明「Agent 可以養活一家公司」。

    三者的差異在於:

    • Anthropic 賭的是「單一強代理產品」商業可行;
    • 微軟 把 Agent 嵌進既有 Office 生態,用授權與 SaaS 黏住企業;
    • Google 則往更底層走一步,試圖把整個雲定義為 Agent 的執行基礎設施——你可以不用它的模型,但你離不開它的 Agent runtime。

    下一輪 AI 戰爭不是誰的模型多 5% 分數,而是:誰能把 Agent 做成可運維、可審計、可計費的基礎設施。 Google 正在為這件事改寫自己的雲產品線。


    二、對開發者與企業:技術債、技能債與「被平台遷徙」的壓力

    對既有 GCP / Vertex AI 用戶來說,這次調整不是選項,而是 路線強制升級。

    1. 從 Vertex AI 到 Agent Platform:一場平台級遷徙

    根據官方與社群資訊:

    • 現有 Vertex AI 工作負載暫時可用,但未來新功能會集中到 Gemini Enterprise Agent Platform。
    • 管理面從「模型與 endpoint」轉向「Agent、工具、workflow、治理策略」。

    這對技術與組織意味著:

    • 技術債:
    • 你原本只需要管理模型調用與 API;
    • 未來你得面對「多 Agent workflow、工具授權、長時間任務狀態」,整套 observability 堆棧要重設。
    • 技能債:
    • 既有的 GCP / Vertex 證照與 best practice 會過期;
    • Google 也已在暗示考試與教材要轉到「Agentic AI」語境,整個人才市場要重新學一次「怎麼設計可治理的 Agent」。
    • 風險分散難度增加:
    • 理論上 Platform 支援 Gemini、Gemma、Claude 等 多模型 載入,看似有助避免單一模型綁定;
    • 但實務上,你會在 編排層、權限層、審計層 更深度綁在 Google 上——真正被鎖住的不是模型,而是「整個業務自動化流程」。

    2. 新訂閱與計價模式:Agent 化的商業槓桿

    Google 在 I/O 上同步推出:

    • 三階訂閱方案(約 $7.99〜$99.99 / 月),
    • 由傳統「每日 prompt 次數」改成「以算力消耗為基礎的計價」。

    在 Agent 世界,這個改變的含義完全不同:

    • Chatbot 時代:一次問答、一次扣費,行為與成本高度可見;
    • Agent 時代:
    • 一個「幫我處理退款」的指令,可能啟動 多輪對話、多 API 調用、多服務登入;
    • 成本與風險都變成「後面那團看不見的自動工作流」。

    💡 關鍵: 從「算每次問答」變成「算整個工作流的算力」,讓成本與風險都更不透明,也更容易失控。

    對企業 CFO 與 CISO 與 CISO 來說,這會變成新問題:

    • 成本預估難度暴漲:每個 Agent workflow 都是變動路徑,很難做傳統的容量規畫。
    • 安全事件的邊界模糊:Agent 一路往下串:CRM、ERP、文件庫、郵件、甚至財務系統,你得回答:
    • 這條鏈中,哪一段是「AI 自主決策」?
    • 哪一段有人工審批?
    • 出事時是 API 權限設太大,還是 Agent 推理失誤?

    3. 安全現實:我們還停留在「聊天機器人心態」

    今年 OWASP 首度發布 AI Agent Top 10,再加上業界調查指出:約 88% 的企業已經遭遇過 AI Agent 相關安全事故。這兩個數字在這波 Google Agent 大躍進下特別刺眼。

    💡 關鍵: 在約 88% 的企業已經踩過 Agent 安全坑的情況下,把核心流程完全交給雲端 Agent,是在放大原本就存在的風險。

    問題在於:

    • 過去我們習慣把 LLM 當成「會亂講話的搜尋引擎」,風險多半落在內容層(洩漏、幻覺)。
    • 現在 Google 用平台級力量鼓勵的是:「讓 Agent 連到你一切系統,自己去做事」。

    但多數企業在:

    • 權限模型 還停在「service account 能用就好」;
    • 風險評估 還停在「不要讓機密資料出現在 prompt」;
    • 治理機制 還停在「偶爾做一下 log review」。

    在這個前提下,直接衝上 Agent 時代,等於是:用真實帳號、真實錢包、真實生產數據,當這一輪平台戰的壓注籌碼。


    三、對一般使用者與社會:真正的瓶頸不是智力,是信任邊界

    今年 I/O 的幾個 demo,其實已經踩到一般人信任的紅線:

    • Universal Cart:讓 Agent 幫你花錢
    • 在 Search、Gemini 對話、甚至未來的 YouTube、Gmail 中,商品可以一路進到一個 跨零售商的「通用購物車」,付款直接走 Google。
    • Agent 可以替你追蹤價格、比價、提醒庫存與折扣——下一步就是「幫你自動下單」。
    • Gmail「會說話的信箱」
    • 你不再只是關鍵字搜尋,而是用語音問:「幫我找上次跟保險公司談車禍理賠那封信」;
    • 再下一步就是:「幫我回這封信說我接受方案」——郵件決策被半自動化。
    • 車載 Gemini + Volvo 外部攝影機
    • 讓 AI 即時讀取路邊標誌,解釋停車規則,一路延伸到更多駕駛決策輔助。

    這些都指向同一件事:AI 代理不再活在瀏覽器分頁,而是長駐在你的生活背景,有視覺、有麥克風、有支付能力,還讀得懂你的郵件與工作流程。

    正如有篇被轉貼討論的觀點說的:AI Agent 的下一個難關不是智力,而是信任:

    • 你願不願意讓一個 長駐的 Google 代理:
    • 自動幫你續訂訂閱、取消服務、處理退款?
    • 帶著你的 Gmail、行事曆,在背景幫你改變現實世界的狀態?

    在 AGI 倒數敘事之下,這個問題會更尖銳:

    • 一手說「幾年內 AGI、解決所有疾病」,
    • 一手把 Agent 深埋進雲端基建與個人生活。

    這兩條敘事疊在一起,實際上是把社會的信任門檻推到極限。 在安全標準、責任邊界與退出機制還沒成熟之前,整個社會正在接受一個事實:

    我們願意用真實的金流與個人資料,去替幾家巨頭驗證「Agent 能不能真的運作」。


    結語:不是要不要用 Agent,而是你敢綁多深、多久

    回到一開始的問題:Google 把全家桶推上 Agent 架構,這件事到底意味著什麼?

    我的判斷是:

    • 技術面:這很可能是這一輪雲與 AI 平台戰的真正分水嶺——應用從「app」變成「長駐、連網、有權限的 AI 代理」。
    • 產業面:誰先把 Agent 做成可運維、可審計、可計費的基礎設施,誰就拿到下一代雲平台的定價權與標準制定權。
    • 風險面:在安全治理、責任歸屬、用戶信任機制尚未成熟之前,整個產業都在用真實系統與真實權限當賭注。

    對開發者與企業,我的具體建議是:

    1. 接受「Agent 將成為標配」,但拒絕「單一平台鎖死核心業務」:
    2. 在架構上刻意設計 可替換的 Agent 執行層,至少保留多雲 / 自建選項。
    3. 把「業務規則、風險閾值、合規邊界」放在自己控制的中介層,而不是直接寫死在某家 Agent Platform 的 DSL 裡。
    4. 把安全與治理視為專案主軸,而不是附加條款:
    5. 對照 OWASP AI Agent Top 10,為每條風險設計具體控制點(權限分割、人工審批、行為審計)。
    6. 評估任何 Agent 專案時,把「出錯時如何停機、如何回滾、如何追責」當成必答題,而不是事後補考。
    7. 建立「可退出」機制,寫在採用決策的一開始:
    8. 明文規範:如果未來要從 Google Agent Platform 換到別家,資料、workflow 定義、審計記錄要怎麼抽離。
    9. 用這組標準去談合約與技術選型,而不是在全面上線後才想起來。

    Google 的 Agent 大佈局值得用,但更值得被嚴格談條件。 真正成熟的態度是:把它當成可替換的強大執行層,而不是讓它變成你整個業務的「唯一神經系統」。

    🚀 你現在可以做的事

    • 去看一次 Google I/O 關於 Gemini Enterprise Agent Platform 的技術文件,列出你現有架構中會被影響的部分
    • 對照 OWASP AI Agent Top 10,替你正在規劃或已上線的任一個 Agent 專案做一次風險盤點
    • 起草一份「從單一 Agent 平台退出 / 轉移」的技術與合約需求清單,帶進下一次和雲端供應商的談判
  • SmallCode 架構:讓 4B 模型也能帶專案

    SmallCode 架構:讓 4B 模型也能帶專案

    📌 本文重點

    • 小模型不適合搭配太多零碎 tools
    • 用少量 compound tools 封裝整個工作流
    • 加上可控 improvement loop 提升穩定性
    • 本地 4B 模型也能跑實用 coding agent

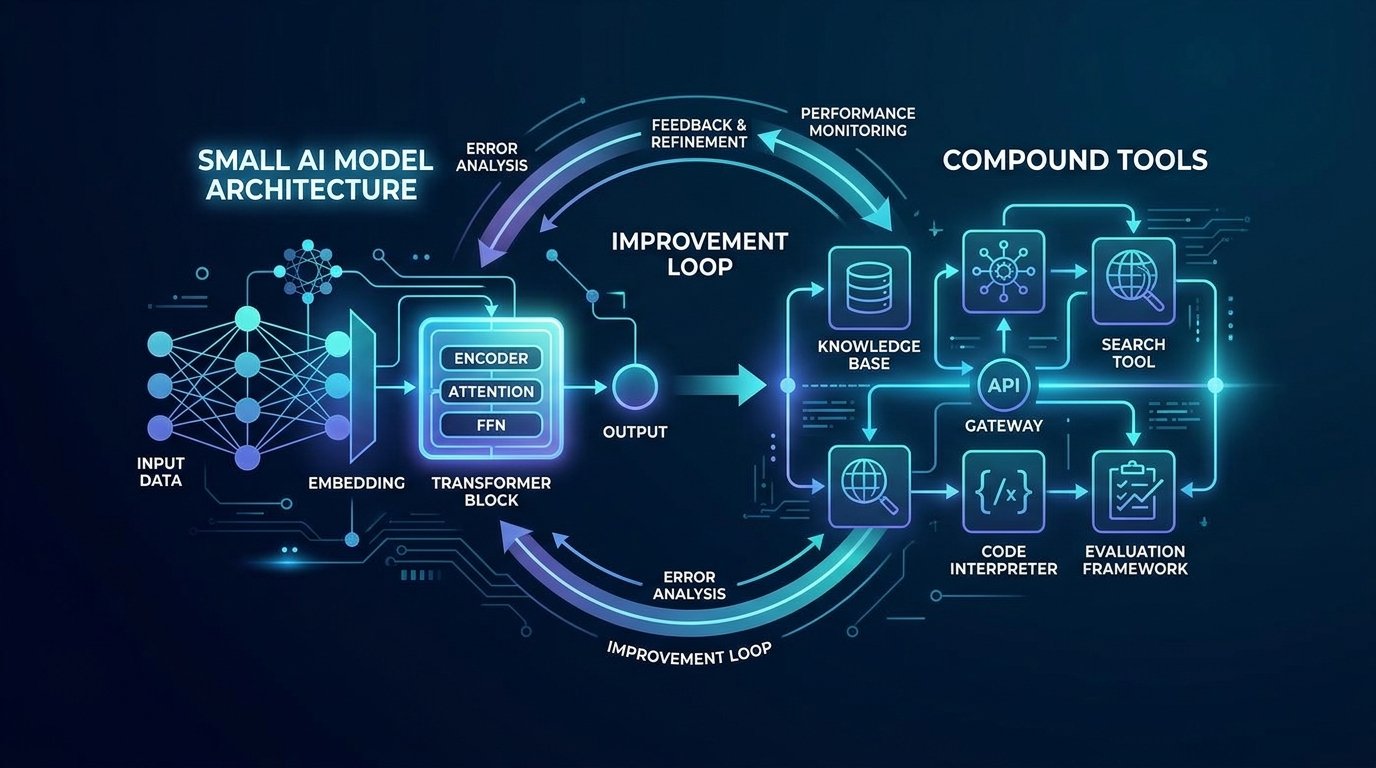
    在本地用 4B Gemma 這種小模型帶一個中大型 repo,傳統做法是「LLM + 一堆小工具」:讀檔、寫檔、跑測試、grep 全部拆成獨立 tool。結果大多數人遇到的狀況是:上下文爆炸、工具呼叫瘋狂往返、推理鏈斷裂,小模型最後只會在錯誤訊息上打轉。SmallCode 的重點就是把這些多步操作 封裝成少量高階 compound tools,加上一個可控的 improvement loop,讓 4B 模型也能穩定完成多檔案、反覆修改的任務。


    重點說明

    1. 為什麼「LLM + 一堆小工具」在小模型上會崩盤

    從工程視角,小模型掛點原因其實很單純:

    1. 上下文爆炸:
    2. 每呼叫一次 read_file、search、run_tests,LLM 就要重新看到整段對話 + 工具 I/O。
    3. 小模型 context 小、壓縮能力差,於是早期決策被擠掉,任務計畫完全失憶。

    💡 關鍵: 小模型的 context 與壓縮能力有限,多工具頻繁往返會迅速擠掉關鍵決策,導致任務中途失憶。

    1. 頻繁往返 + 推理鏈斷裂:
    2. 多工具設計變成:LLM → read_file → 回答 → write_file → 回答 → run_tests ...
    3. 每一步都要模型自己想「下一步該用什麼工具」,對小模型來說元認知成本太高,很容易在第 3、4 步就跑偏。

    4. 錯誤訊息解析太細碎:

    5. 錯誤訊息來了:run_tests → 報一堆 stacktrace → LLM 要自己決定要再 read_file 哪幾個檔案。
    6. 4B 模型常常讀錯檔或只讀到片段,最後修 bug 幻覺化。

    SmallCode 的做法是:把「讀檔 → 修改 → 測試」這個典型工作流視為一個原子操作,交給 compound tool 內部處理,LLM 只需要決定「要不要再試一次?」。


    2. Compound Tools:把多步工作流變成一個 API

    設計思路可以簡化成三件事:

    1. 把多步操作拉到工具內執行
    2. 典型例子:edit_and_test:
      • 根據指定 glob pattern 讀檔
      • 在本地套用 LLM patch(或簡單模板)
      • 寫回檔案
      • 跑 pytest / npm test,收集輸出
    3. 對 LLM 而言,這整件事就是 一次工具呼叫 + 一個結構化結果。

    4. 清楚定義輸入 / 輸出 Schema

    輸入 Schema(JSON Schema 或 Pydantic)範例:

    python
    class EditAndTestInput(BaseModel):
    goal: str # 自然語言:『讓 tests/test_api.py 全部通過』
    target_files: List[str] # ['src/api.py', 'tests/test_api.py']
    test_command: str = "pytest -q"
    max_edits: int = 3

    輸出 Schema:

    “`python
    class EditSummary(BaseModel):
    file: str
    diff: str # unified diff

    class EditAndTestOutput(BaseModel):
    success: bool
    edits: List[EditSummary]
    test_output: str
    error_summary: Optional[str]
    “`

    重點是讓小模型只要關注:有沒有成功?改了哪些檔?錯在哪裡?

    1. 在一次工具呼叫中完成工作流

    Tool handler(Python 假想範例):

    “`python
    def edit_and_test_tool(payload: EditAndTestInput) -> EditAndTestOutput:
    # 1. 收斂上下文:只讀需要的檔案內容
    files = {f: Path(f).read_text() for f in payload.target_files}

       # 2. 呼叫同一個或更小的 LLM 產生 patch(可本地或子進程)
       patch = call_llm_generate_patch(goal=payload.goal, files=files)
       edits = apply_patch_to_files(patch)
    
       # 3. 寫回檔案
       for e in edits:
           Path(e.file).write_text(e.new_content)
    
       # 4. 跑測試
       ok, test_output = run_command(payload.test_command)
    
       return EditAndTestOutput(
           success=ok,
           edits=[
               EditSummary(file=e.file, diff=e.diff)
               for e in edits
           ],
           test_output=test_output,
           error_summary=None if ok else summarize_test_output(test_output),
       )
    

    “`

    好處:主 agent 模型只要發出一個 edit_and_test 呼叫,不用自己 orchestrate read_file、write_file、run_tests,大幅降低 思考步數 和 context 髒亂度。


    3. Improvement Loop:可控的自我改進迴圈

    SmallCode 成效好的關鍵是:讓 retry 變成一級公民,而不是「失敗就結束」。

    1. 失敗偵測策略
    2. 以 compound tool 的輸出為主,不讓模型自己猜:
      • success == False
      • test_output 中出現關鍵字(FAILED、Traceback、AssertionError)
    3. 這樣 loop controller 可以用硬邏輯判斷下一步,不依賴 LLM 理解每一行 stacktrace。

    4. 重試策略

    簡單可用的架構:

    “`python
    MAX_ATTEMPTS = 5

    for attempt in range(1, MAX_ATTEMPTS + 1):
    tool_result = edit_and_test_tool(input_payload)

       if tool_result.success:
           break
    
       feedback = build_feedback_prompt(tool_result)
       input_payload.goal = feedback  # 將錯誤摘要回餵給模型
    

    “`

    build_feedback_prompt 可以把 error_summary + 失敗測試名稱打包,讓下一輪 LLM 更聚焦。

    1. 避免無限 loop 的做法
    2. 硬限制:MAX_ATTEMPTS、最大 wall time。
    3. 檢查 edits 是否變化:若連續兩次 diff 幾乎一樣(甚至相同 hash),就早停。
    4. error signature 去重:同一個 assertion / stacktrace 重複出現 N 次就停止,標記為「需要人介入」。

    這樣,4B 模型只要能理解「這次錯在哪裡、我還有幾次機會」,就足以在迴圈中持續收斂。


    4. 在本地 4B 模型上的部署實務

    以 Gemma 2 4B 為例,用 llama.cpp / Ollama 都可以吃得很順,但細節會影響體驗:

    1. 記憶體與延遲粗估
    2. 4B Q4_K_M:VRAM 約 3–4 GB;Q6 大概 5–6 GB。
    3. context 8k、推理 1 token ≈ 10–40 ms,視 CPU/GPU 而定。
    4. agent 架構推薦:主模型用中量化(Q4/Q5)+ MTP(若硬體支援),工具內部幫忙 patch 的模型可以更小或更低位元。

    💡 關鍵: Gemma 2 4B 在 Q4 量化、約 3–4 GB VRAM 和 8k context 下即可順暢運行,適合作為本地實用 coding agent 的基礎。

    1. llama.cpp 整合範例

    bash
    # 轉 GGUF 後
    ./llama-cli \
    -m gemma-2-4b-q4_k_m.gguf \
    -c 8192 \
    -ngl 35 \ # offload 到 GPU layer 數
    --temp 0.2 \
    --top-p 0.9

    在你的 agent server(Python)裡包一層簡單的 HTTP:

    “`python
    from llama_cpp import Llama

    llm = Llama(model_path=”gemma-2-4b-q4_k_m.gguf”, n_ctx=8192)

    def chat(messages):
    return llm.create_chat_completion(
    messages=messages,
    tools=TOOLS_SCHEMA, # compound tools 定義
    )
    “`

    1. Ollama 整合範例

    yaml
    # Modelfile
    FROM gemma2:4b
    PARAMETER temperature 0.2
    PARAMETER num_ctx 8192

    Python 呼叫:

    “`python
    import requests, json

    def ollama_chat(messages, tools=None):
    payload = {“model”: “gemma2-4b”, “messages”: messages}
    if tools:
    payload[“tools”] = tools
    r = requests.post(“http://localhost:11434/api/chat”, json=payload)
    return r.json()
    “`

    注意:不要貪心開太大 context,4B 小模型在 16k context 上的品質掉得很明顯,8k 左右通常較穩定。


    實作範例:簡化版 SmallCode 架構

    以下是一個「可以直接改造」的最小可行架構:

    # 1. 定義 compound tools
    TOOLS_SCHEMA = [
        {
            "type": "function",
            "function": {
                "name": "edit_and_test",
                "description": "Edit target files to satisfy goal and run tests.",
                "parameters": EditAndTestInput.model_json_schema(),
            },
        },
    ]
    
    # 2. Agent 迴圈
    
    def coding_agent(task_description: str):
        messages = [
            {"role": "system", "content": "你是嚴謹的資深工程師,專注讓測試通過。"},
            {"role": "user", "content": task_description},
        ]
    
        for attempt in range(1, 6):
            resp = ollama_chat(messages, tools=TOOLS_SCHEMA)
            choice = resp["message"]
    
            if "tool_calls" not in choice:
                # 當成總結
                return choice["content"]
    
            for tool_call in choice["tool_calls"]:
                if tool_call["function"]["name"] == "edit_and_test":
                    args = json.loads(tool_call["function"]["arguments"])
                    result = edit_and_test_tool(EditAndTestInput(**args))
    
                    # 記錄 tool 結果
                    messages.append({
                        "role": "tool",
                        "name": "edit_and_test",
                        "content": result.model_dump_json(),
                    })
    
                    if result.success:
                        messages.append({
                            "role": "user",
                            "content": "測試已通過,請簡要總結你做了什麼修改。",
                        })
                        final = ollama_chat(messages)
                        return final["message"]["content"]
    
        return "多次嘗試仍未通過測試,請人工檢查。"
    

    實際好處:
    – 你不需要讓 4B 模型自己 orchestrate 所有 file ops,只決定「目標」和「是否繼續嘗試」。
    – 迴圈與成功判斷在 host 程式碼內可觀測、可監控,易於 debug。


    建議與注意事項

    1. tool 太細 vs 太粗的 trade-off
    2. 太細:read_file、write_file、run_tests 分開 → 小模型迷路。
    3. 太粗:一個 tool 內藏太多隱含狀態 → 工具結果難以解釋與監控。
    4. 建議:以「一次迴圈可解決的一個明確目標」為單位設計 compound tool,例如:edit_and_test_suite、add_feature_and_generate_tests。

    5. 錯誤訊息解析策略

    6. 不要把整個 test log 丟給小模型,先在 host 端做:
      • 只保留最後一個錯誤 block
      • 摘要檔名、行號、錯誤訊息
    7. 這樣可以避免 4B 模型被 1k tokens 的 noisy log 淹沒。

    8. 測試覆蓋率不足導致的幻覺修 bug

    9. 如果只有 1–2 個測試,小模型會傾向「只讓這兩個測試過」而破壞其他邏輯。
    10. 實務上:

      • 優先在 agent pipeline 前補上最小必要測試
      • 或在 tool 裡檢查 diff 是否只動到相關檔案/區塊(heuristic)。
    11. 如何監控與記錄 agent 決策

    12. 每一次迴圈記錄:
      • 使用的 tool 名稱 + 輸入參數
      • diff 摘要(檔名、行數、行數變化量)
      • test command 與結果(pass/fail、耗時)
    13. 建議:

    text
    logs/
    session-2025-05-21T12-34-56Z/
    step-01-request.json
    step-01-edit_and_test-input.json
    step-01-edit_and_test-output.json
    step-01-diff.patch

    之後你可以回放整個 session,分析為什麼某一輪跑偏,進而調整 tool schema 或 system prompt。


    總結:如果你想在本地 4B 模型上做實用的 coding agent,不要再堆滿十幾個零碎 tools。把關鍵工作流收斂成少量 compound tools,加上一個明確可控的 improvement loop,再配合 llama.cpp / Ollama 的輕量部署,就能把原本只敢交給 GPT-級別模型的任務,下放到可自託管的小模型上。


    🚀 你現在可以做的事

    • 在現有 agent 專案中,把零碎的 read_file / write_file / run_tests 整合成一個 edit_and_test compound tool
    • 用 Gemma 2 4B + Ollama 或 llama.cpp 在本地啟一個 8k context、Q4 量化的測試環境
    • 為你的 repo 實作一個最小版 improvement loop,限制 MAX_ATTEMPTS 並記錄每次 diff 與測試結果
  • 96 個 Gemini Agent 幫你寫系統?

    96 個 Gemini Agent 幫你寫系統?

    📌 本文重點

    • 多 Agent 可複製「多人分工」開發流程
    • Runtime 設計比單純換更大模型更關鍵
    • 用開源工具就能打造迷你版 Antigravity

    用一群 Agent 代替「一個工程師慢慢寫」,解決的是:複雜專案要靠多人分工,AI 也可以用 Runtime + 多代理系統做到同樣的協作和自動化。

    核心觀念先講白:模型戰爭差不多打完了,現在比的是誰的 Agent Runtime 能把「模型能力」變成可落地的、多步驟的自動化工作流。

    Google 在 I/O 上展示的 Antigravity 2.0 + Gemini 3.5 Flash 是一個很極端的例子:

    • 96 個子代理分工
    • 12 小時寫完一套從零開始的作業系統
    • Token 成本不到 1,000 美金
    • OS 還能跑《Doom》

    💡 關鍵: 多代理 + 強 Runtime 已經能在「12 小時、不到 1,000 美金」內完成從零開發 OS,顯示關鍵瓶頸不再是模型本身,而是協作與流程設計。

    這不是叫你明天也去做一個 OS,而是提供一個「如何設計多 Agent 開發流程」的範本。下面我們拆成三件你可以直接抄的事:

    1. 多代理分工設計:任務 → 子任務 → Agent 編隊
    2. 強健 Runtime:重試、檢查點、錯誤恢復
    3. 平價版本實作:在你自己的專案做一個「迷你 Antigravity」

    核心功能:Antigravity 2.0 給開發者的三個啟示

    1. 多代理分工:任務 → 子任務 → Agent 編隊

    Antigravity 的做法,其實很像你帶一個遠端工程團隊:

    • 架構師 Agent:決定 OS 的模組切分(檔案系統、排程、驅動、UI…)
    • 模組作者 Agent:各自負責某一個模組的程式碼生成
    • 測試員 Agent:寫測試、跑測試、收斂錯誤
    • 整合者 Agent:把各模組組合、處理相依性、打包成可啟動的系統

    對你來說,可直接套用成一個通用流程:

    1. 寫一個頂層任務描述
      例:建立一個 RESTful CRUD 服務,管理任務(待辦事項),含 API、DB schema、簡單前端。

    2. 讓「架構師 Agent」自動拆解:

    3. API 設計與 OpenAPI spec

    4. 後端框架與資料庫層
    5. 前端 UI
    6. 測試與 CI script

    7. 為每個子任務設計 Agent 角色:

    8. api-architect-agent:只產出 API spec

    9. backend-agent:根據 spec 產生程式碼
    10. frontend-agent:負責 UI
    11. tester-agent:生成並執行測試
    12. integrator-agent:檢查專案結構、跑 build / lint

    13. 在 Runtime 中定義工作流:

    14. 任務圖(DAG):架構師 → 模組作者 → 測試員 → 整合者

    15. 每個節點定義輸入/輸出檔案、工具(Git、DB、HTTP client)

    可行動步驟:

    • 選一個你熟的框架(例如 FastAPI / Next.js)
    • 用自然語言寫清楚「最終可交付物」
    • 為這個專案定義 3–5 個 Agent 角色,明確限制各自輸入輸出

    2. Runtime 比模型重要:90% 成功率在多步任務會變災難

    多步任務有一個殘酷數學:

    • 假設每一步成功率 90%
    • 要跑 20 步,整體成功率 ≈ 0.9^20 ≈ 12%

    💡 關鍵: 即使單步有 90% 成功率,20 步工作流成功率只剩約 12%,所以不加 Runtime 管控,多步任務幾乎註定失敗。

    這就是為什麼像 Forge 這種開源 guardrails 會被重視:作者實測,一個 8B 模型在多步代理任務上,從 53% 提到 99% 成功率,完全不改模型,只改 Runtime。

    你在自己的「迷你 Antigravity」裡,要做三件事:

    1. 重試與 nudging

    2. 為每個步驟設 max_retries(例如 3 次)

    3. 失敗時自動加上「修正提示」,例如:上一步測試失敗,錯誤訊息如下,請修正而不是重寫整檔。

    4. 檢查點(checkpoint)

    5. 每完成一個重要子任務,就把中間產出存到 Git / DB

    6. 失敗時從最近的檢查點重跑,而不是重頭來

    7. 錯誤恢復流程

    8. 專門的 debug-agent:只看錯誤訊息 & log,產出修復建議

    9. Runtime 層做:自動建立 bug report、開 issue、指派給對應 Agent

    如果你用 Forge,它已內建:

    • Tool-agnostic 重試策略
    • 步驟執行強制與錯誤恢復
    • VRAM-aware context 管理(對本地模型很重要)
    • 評估套件與 Dashboard,可量化成功率

    可行動步驟:

    • 先把現有「單 Agent 自動流程」改成有重試與 checkpoint
    • 對每個任務記錄:總步數、失敗點、重試次數,在 Dashboard 裡看瓶頸

    3. 平價版本:你也能做一個「迷你 Antigravity」

    你不需要 Gemini 3.5 Flash + Google 內部 Runtime 才能玩多 Agent。下面這些工具可以在自家專案做一個縮小版:

    名稱 核心功能 免費方案 適合誰
    Forge 多步代理 guardrails、重試、Dashboard 開源 想提升本地 / 自架 LLM 可靠性的工程師
    llama.cpp + Qwen 本地 Agent 在個人電腦跑本地模型 + 簡易工具調用 開源 想省雲端費用、在內網跑 Agent 的團隊
    MCP 生態(如 OpenAI MCP、各種 server) 統一的工具協議,讓 Agent 調用資料庫、API 等 多數開源 / 免費 想把既有系統暴露為 Agent 工具的後端工程師

    一個實用組合示例:

    • 模型:Qwen 2.5 7B / 14B(透過 llama.cpp 或 Ollama 跑)
    • Runtime:Forge 當 guardrails
    • 工具層:一組 MCP server(例如 PostgreSQL、HTTP、Filesystem)

    你可以先做一個「自動搭建 CRUD 服務」的迷你 Antigravity:

    1. 使用者輸入需求(自然語言)
    2. architect-agent 產出設計 + 任務拆解
    3. backend-agent + frontend-agent 寫程式碼
    4. tester-agent 自動開發 & 執行測試
    5. integrator-agent 跑 build 並回報狀態

    適合誰用:三種典型場景

    1. 後端 / 全端工程師:自動化 CRUD 小專案

    你可以把「打造新微服務」變成一個表單:

    • 輸入資料模型 + 幾個業務規則
    • 多 Agent 流程負責 scaffold、API、測試、docker-compose

    行動:從一個只需要 3–5 小時就能手刻完的小服務開始,先讓多 Agent 幫你做到 70–80%,你只負責 code review。


    2. 資料團隊:資料管線與 ETL 任務

    • planner-agent:解析需求、拆成抽取/轉換/載入步驟
    • sql-agent:產生查詢與 view
    • check-agent:比對 row count、品質指標

    行動:挑一個每天都在重複手動跑的 ETL 任務,做成標準流程,讓 Agent 幫你自動生成 SQL + 驗證報表。


    3. 產品 / PM:快速驗證 Side Project

    • 搭配 Gemini 3.5(雲端)或本地 LLM
    • 定義一個「最小可行功能」(例如 landing page + 簡單 API)
    • 用多 Agent 完成第一版,再丟給工程師接手

    行動:每次新點子,給自己一個規則:「先讓多 Agent 寫一版 Demo,我只在最後 2 小時調整。」


    怎麼開始:一個最小可行範例

    這裡給一條「3–5 小時內可完成」的路線,你可以直接照做:

    步驟 1:選模型 + Agent 框架

    • 模型:
    • 想省錢/本地:Qwen 2.5 7B(透過 llama.cpp 或 Ollama)
    • 想雲端無痛:Gemini 3.5 Flash(透過 Google AI Studio)
    • Runtime / 框架:
    • 想要 guardrails:裝 Forge
    • 想用現成 MCP:選一個支援 MCP 的 Agent 框架(如 OpenAI 官方 Agent SDK)

    步驟 2:挑一個小系統

    條件:

    • 單服務、沒有第三方整合
    • 你自己寫大約 3–5 小時能完成

    例:任務管理 CRUD API + 簡單 React 前端

    步驟 3:設計任務拆分與 Agent 角色

    1. 任務描述寫成一個 markdown 檔(會給 architect-agent 看)
    2. 在 Runtime 中註冊 4 個 Agent:
    3. architect
    4. backend
    5. frontend
    6. tester/integrator
    7. 為每個 Agent 明確:
    8. 可用工具(Git、Filesystem、HTTP…)
    9. 輸入(上一個 Agent 的輸出 / 檔案)
    10. 必須產出什麼檔案

    步驟 4:加上監控 Dashboard

    • 如果用 Forge:直接啟用它的 Dashboard,看每次工作流的步驟成功率
    • 若自己實作:
    • 為每個步驟記錄:開始時間、結束時間、是否重試
    • 每次失敗時存 log + 輸入輸出到一個資料夾

    步驟 5:只做一件事的迭代

    • 第一版只要求「能跑起來」,不追求漂亮結構
    • 每次失敗,你只調整:
    • 任務拆分是否太粗/太細
    • Agent 提示是否太模糊
    • 重試與 checkpoint 是否設太少

    等到這個小系統穩定後,你才讓 Runtime 去碰更大的專案。


    小結:Runtime 是你的「AI 開發主管」

    Antigravity 2.0 用 96 個 Gemini Agent 寫出一套能跑《Doom》 的 OS,看起來很遠,但背後用到的概念其實都可落在你今天的 side project 上:

    • 把任務拆成 Agent 可接手的小單位
    • 用 Runtime 管控流程,而不是寄望模型每次都猜對
    • 利用開源工具(Forge、llama.cpp、MCP)做出自己的「迷你 Antigravity」

    💡 關鍵: 關鍵不是再換一個更大的模型,而是把現有模型放進可靠的 Runtime,讓它真的「交付」可用產物。

    關鍵不是再換一個更大的模型,而是先把你手上的模型,放進一個可靠的 Runtime 裡,讓它真的幫你「交付」東西。

    🚀 你現在可以做的事

    • 在 GitHub 上看看 Forge 專案,了解多步代理的 guardrails 怎麼設計
    • 挑一個 3–5 小時能手刻完的 CRUD 小服務,照文中的 4 個 Agent 角色拆任務實作一次
    • 把既有的單 Agent 自動化腳本,加上 max_retries 和簡單 checkpoint 機制,量化成功率變化