作者: kerwin77106

  • 在 Mac 上跑容器版 macOS 虛擬機

    在 Mac 上跑容器版 macOS 虛擬機

    📌 本文重點

    • macOS Container Machines 是「整台 macOS 的類容器」
    • 用指令快速建立、多開、快照還原乾淨 macOS
    • 特別適合多專案隔離、本地 LLM 與簡易 CI

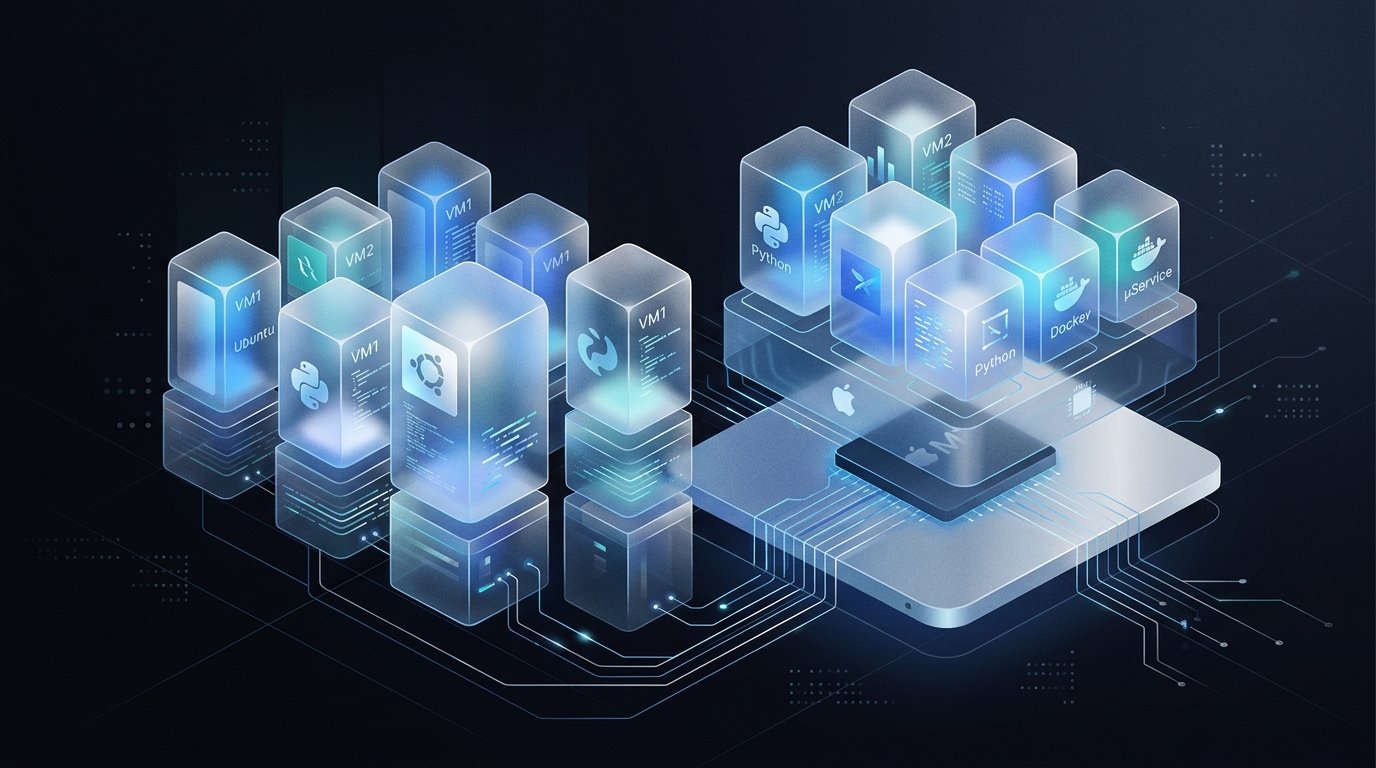
    用一句話先說清楚:macOS Container Machines 不是一般 Docker,而是把整個 macOS 放進「類容器」裡跑起來的新形態虛擬機,讓你在一台 Mac 上快速啟動多個乾淨系統環境做開發與測試。

    官方文件:apple/container GitHub 專案


    核心功能:用指令玩出多個乾淨 macOS

    1. 用簡單指令建立 / 啟動 / 銷毀 macOS Container Machine

    macOS Container Machines 的操作模式很接近 Docker,但底下跑的是完整 macOS 系統:

    • 建立一個 macOS Container Machine(指定 macOS 版本與名稱):
    # 建立一台名為 dev-14-5 的 macOS 14.5 Container Machine
    containerctl machine create \
      --name dev-14-5 \
      --system-version 14.5 \
      --disk-size 60G \
      --memory 8G \
      --cpu-count 4
    

    💡 關鍵: 以 containerctl machine create 指定版本與資源,就能快速拉起一台完全隔離的 macOS 環境。

    • 啟動並進入這台 Machine(類似 docker start + exec):
    # 啟動
    containerctl machine start dev-14-5
    
    # 用 SSH 登入(預設會產生使用者,可在設定檔中客製)
    containerctl machine ssh dev-14-5
    
    • 停止與銷毀:
    containerctl machine stop dev-14-5
    containerctl machine delete dev-14-5
    

    可以把它想成:containerctl machine 是管理整台「容器版 macOS」,你在裡面再跑普通的 app、服務、測試工具。

    實際指令名稱與旗標以最新官方文件為準,上面是方便理解的指令模板。


    2. 支援的 macOS 版本、資源隔離與快照

    (1)支援哪些 macOS 版本?
    目前設計是讓你在 Apple silicon Mac 上跑 Apple silicon macOS 映像,常見會用到:

    • macOS 14.x(Sonoma)
    • 未來會陸續支援更新版本(請看 GitHub 文件對應 --system-version 或 image tag)

    實務建議:

    • 平常開發用:選 跟主機一樣或略新的版本(例如主機 14.4,Machine 用 14.5)
    • 回溯測試:專門起一台 舊版本 macOS 做回歸測試

    (2)資源隔離(CPU / 記憶體 / 磁碟)
    每台 Machine 建立時都可以指定:

    --cpu-count 4    # CPU 核心數
    --memory 8G      # 記憶體
    --disk-size 60G  # 磁碟容量
    

    實際效果:

    • 它會像一台獨立 Mac,有自己的檔案系統
    • 不會直接動到你宿主機的 /usr、/System
    • 可以用共享資料夾或網路服務跟宿主機互相傳檔

    💡 關鍵: CPU、記憶體與磁碟都可獨立配置,確保每台 Machine 之間與宿主機互不污染。

    (3)快照 / 回滾能力
    最實用的是可以對整個 macOS Machine 做快照,踩壞環境直接回復:

    # 在乾淨狀態建立快照
    containerctl machine snapshot create dev-14-5 --name clean
    
    # 玩壞了環境?一鍵回到快照狀態
    containerctl machine snapshot restore dev-14-5 --name clean
    

    適合:

    • 試裝一堆實驗性工具、framework
    • 跑「破壞性」測試(改系統設定、測 uninstall 流程)

    適合誰用:4 個實戰場景

    1. 前端 / 後端多版本環境測試

    情境:你在 Mac 上要同時維護多個專案:

    • 專案 A:Node 16 + 舊版 Xcode
    • 專案 B:Node 22 + 全新工具鏈

    傳統做法:在同一台 macOS 裝一堆 Node 版本管理 + 手動切換,容易互相污染。

    用 macOS Container Machines 的做法:

    1. 為每個專案開一台 Machine:

    bash
    containerctl machine create --name proj-a --system-version 14.4 --cpu-count 4 --memory 8G
    containerctl machine create --name proj-b --system-version 14.5 --cpu-count 6 --memory 12G

    1. 在各自的 Machine 裡用 nvm 或 asdf 裝需要的 Node / Java / Python。
    2. 專案測試完,直接 stop,需要時再 start。

    好處:專案 A 和 B 的依賴完全隔離,卸載 / 升級不怕互相影響。


    2. 多語言開發環境:Python / Node / Java 各一台

    如果你本機環境常被 Python 套件或 Java SDK 搞壞,可以直接用「一語言一 Machine」的策略:

    • py-dev:專門裝 miniconda / poetry,跑資料科學、AI 專案
    • node-dev:專門跑 Next.js、Vite、前端工具鏈
    • java-dev:裝不同 JDK、Maven / Gradle

    指令示例:

    containerctl machine create --name py-dev --system-version 14.5 --memory 8G
    containerctl machine create --name node-dev --system-version 14.5 --memory 8G
    containerctl machine create --name java-dev --system-version 14.5 --memory 8G
    

    這樣你在 py-dev 裝到壞掉(例如亂動 /usr/local),直接用快照回滾,不影響其他語言環境。


    3. 本地部署 LLM / Agent 場景測試

    很多本地 LLM/Agent 方案都需要:

    • 安裝特定版本 Python + 一堆 C/C++ 編譯依賴
    • 開多個後端服務(向量資料庫、API gateway、觀測工具)

    你可以用 macOS Container Machines 建立一台 llm-lab:

    containerctl machine create \
      --name llm-lab \
      --system-version 14.5 \
      --cpu-count 8 \
      --memory 24G \
      --disk-size 200G
    

    裡面專心裝:

    • Ollama / LM Studio / text-generation-webui 類工具
    • Qdrant / Milvus 等向量資料庫
    • 觀測與日誌工具

    你可以同時開兩台 Machine:

    • llm-lab-a:測 A 套框架 + A 套模型
    • llm-lab-b:測 B 套框架

    切換只要 start 不同 Machine,不需要在同一系統裡反覆安裝/移除。


    4. 在自己 Mac 上做「簡易本地 CI 流水線」

    沒有 CI 伺服器,也可以在 Mac 上模擬一套:

    1. 建立一台 ci-runner Machine:

    bash
    containerctl machine create --name ci-runner --system-version 14.5 --cpu-count 6 --memory 12G

    1. 在裡面裝:
    2. git
    3. 自動化腳本(bash / Python)
    4. 測試工具(jest、pytest、JUnit 等)

    5. 在宿主機寫一個腳本:

    bash
    # run-ci.sh
    set -e
    containerctl machine start ci-runner
    containerctl machine ssh ci-runner "cd /ci/project && git pull && ./run-tests.sh"
    containerctl machine stop ci-runner

    這樣你每次 push 前跑 ./run-ci.sh,就等於在「乾淨 macOS 環境」重做一次安裝與測試,類似本地版 CI。


    怎麼開始:10 分鐘跑起第一個 macOS Container Machine

    1. 前置條件檢查

    先確認你的 Mac:

    1. 硬體:Apple silicon(M1 / M2 / M3)
    2. 系統版本:建議 macOS 14(Sonoma)以上
    3. 啟用虛擬化:
    4. 系統偏好設定 → 隱私權與安全性 → 開發者模式 / 虛擬化(依版本可能不同)
    5. 終端機確認:

      bash
      sysctl kern.hv_support

      若輸出包含 kern.hv_support: 1,代表已支援 Hypervisor。

    6. 命令列工具:

    bash
    xcode-select --install # 安裝 Command Line Tools


    2. 取得專案與安裝 CLI

    1. 取得專案來源(目前在 Apple GitHub):
      👉 https://github.com/apple/container

    2. 安裝 CLI(實際安裝方式以官方文件為準):

    常見方式會是:

    bash
    git clone https://github.com/apple/container.git
    cd container
    make install # 或官方指定的安裝指令

    1. 安裝完成後確認:

    bash
    containerctl --help

    能看到 machine 相關子命令,就表示工具已就緒。


    3. 10 分鐘內啟動第一台 macOS Container Machine

    以下是一套可以直接照抄、調整參數就能用的流程。

    Step 1:拉一個基礎 macOS Image(如有提供)

    containerctl image pull macos:14.5   # 實際名稱以官方為準
    

    Step 2:建立一台開發用 Machine

    containerctl machine create \
      --name my-dev-mac \
      --system-version 14.5 \
      --cpu-count 4 \
      --memory 8G \
      --disk-size 80G
    

    Step 3:啟動並登入

    containerctl machine start my-dev-mac
    containerctl machine ssh my-dev-mac
    

    進去後你就像在操控另一台 Mac:可以 xcode-select --install、brew install、建立專案…

    Step 4:建立初始快照

    設定好你想要的「標準開發環境」後:

    containerctl machine snapshot create my-dev-mac --name baseline
    

    以後只要環境被弄亂:

    containerctl machine snapshot restore my-dev-mac --name baseline
    

    💡 關鍵: 用一個 baseline 快照當標準模板,可以無限次還原與複製穩定的開發環境。


    4. 常見坑與排查方式

    1)磁碟空間不夠

    • 每台 Machine 都要單獨配置磁碟(例如 60–200 GB),很容易占滿主機
    • 檢查:

    bash
    df -h

    • 建議:
    • 專案和資料盡量放在共享資料夾(掛載宿主機目錄)
    • 不用的 Machine 記得 containerctl machine delete 刪掉

    2)網路問題(Machine 連不到外網 / 宿主機)

    常見症狀:Machine 裡 curl、git clone 失敗。

    排查:

    1. 先確認宿主機本身有網路。
    2. 看 container 網路設定(NAT / bridge),官方文件通常會提供:

    bash
    containerctl network list

    1. 若要從宿主機存取 Machine 內服務(例如在 Machine 跑一個 Web 伺服器),要確認:
    2. Machine 內服務綁在 0.0.0.0
    3. 有對應 port mapping 或可透過 Machine IP 存取

    3)權限問題(安裝 / 授權失敗)

    • 安裝 CLI 需要 sudo 權限時,請用管理员帳號
    • Machine 內如果需要 Full Disk Access、相機、麥克風等權限,目前會比本機更受限制 —— 適合做 CLI / server 端開發,比較不適合高度依賴 GUI 的 App 測試

    小結

    如果你在 Mac 上經常遇到「環境裝一裝就亂掉」「不同專案依賴互相打架」,macOS Container Machines 提供一個新的選項:直接在一台 Mac 上開多台「容器版 macOS」來做隔離與測試。

    先從一台 my-dev-mac 開始,練習建立 / 啟動 / 快照 / 回滾,熟悉之後再把日常專案慢慢搬進不同 Machine,你會更敢大膽試新工具,也更容易維持一個乾淨穩定的主機環境。

    🚀 你現在可以做的事

    • 到 apple/container 看最新安裝方式與 containerctl 子命令說明
    • 照文中流程建立一台 my-dev-mac,實際練習啟動、SSH 登入與建立快照
    • 挑一個現有專案,為它專門開一台 Machine,體驗依賴完全隔離的開發流程
  • OpenAI 估值1.5兆:必要之惡,還是失控起點?

    OpenAI 估值1.5兆:必要之惡,還是失控起點?

    📌 本文重點

    • 前沿 AI 模型正被包裝成標準成長股
    • IPO 後股價壓力將削弱安全與公益優先權
    • 開發者與監管者必須提前布局反鎖定與新治理
    • OpenAI 上市是重寫 AI 監管規則的最後窗口

    OpenAI 若以約 1.5 兆美元估值上市,代表的是一件更根本的事:人類第一次把「可能通往 AGI 的前沿模型」,包裝成一檔標準的成長股。我認為這是 AI 產業成熟的必要之惡,但同時也把「為全人類造福」的敘事,綁進了季度財報與股價 KPI —— 如果監管和治理不跟著升級,安全與公益會長期輸給成長與估值。

    💡 關鍵: 一旦前沿模型被當成「1.5 兆美元級成長股」,公司治理重心就會長期偏向營收與市佔,而非安全與公益。


    一、從 FAANG 到 MANGOS:資本市場正在選邊站

    OpenAI 與 Anthropic 相隔一週先後向 SEC 機密送出 S-1,加上準備上市的 SpaceX,外界開始用 MANGOS(Microsoft、Anthropic、Nvidia、Google、OpenAI、SpaceX) 取代 FAANG,當成新一代科技權力字首。這不是單純縮寫更新,而是資本流向被重編程。

    1. AI 變成新一代「指數級基建」押注

    無論是 Reddit 上推估的 1.5 兆美元估值,還是 Anthropic 接近千億美元 的私募身價,都在傳遞同一個訊號:

    華爾街不再把 AI 視為 SaaS,而是把前沿模型視為「新型基礎建設股+地緣政治籌碼」。

    這會產生兩個直接效果:

    • 創投資金被虹吸:早期資本會更偏好「下一個 OpenAI / Anthropic」級別的模型公司或算力基建,而不是小而美應用層。能講出「自我改進 AI」「AGI 路線圖」的 pitch,會比老老實實做垂直應用更有票房。
    • 硬體與雲端綁定更深:Microsoft、Nvidia、Google 搭上 OpenAI / Anthropic,形成算力—模型—雲端—應用的閉環。你可以不喜歡它們,但資本市場已經在押「AI 會像雲一樣集中在少數超級節點」。

    💡 關鍵: 當 AI 被視為「基礎建設股」,資本會自然推動算力與模型集中到少數巨頭,產業分散度會持續下降。

    2. 價格戰不是福利,是壟斷前奏

    市場傳出 OpenAI 正考慮大幅降價 API,來阻擊 Anthropic 的成長。短期看,開發者拍手;長期看,這更像是經典互聯網套路:

    • 上市前:先用估值補貼算力,壓低整體價格,把競爭對手燒死。
    • 市佔穩固後:在不得不交代獲利與現金流時,調整定價、打包銷售、強化鎖定。

    當前沿模型成為「成長故事」核心,價格戰幾乎必然演變為「先補貼、後收租」。


    二、從「非營利」到 1.5 兆公司:AGI 抱負與股東義務的內在衝突

    OpenAI 曾是「非營利研究機構」,現在是準備上市的 1.5 兆美元公司,中間靠一個「有限獲利(capped-profit)」結構作為過渡。但一旦 S-1 正式公開,你會清楚看到幾件事:

    1. 結構會迫使它向短期營收與企業客戶傾斜

    前沿模型研發燒錢,Reddit 論及 Altman 也坦白承認:龐大算力成本可能逼公司加速上市。上了市,遊戲規則就變成:

    • 每一代模型(例如內部傳聞的 GPT-5.6)都不只是科研進展,而是發佈會+財報會的組合拳。
    • 企業客戶、長約收入、雲端綁定,會占據策略的決定性地位。真正破壞性、但暫時沒有明確商業模式的安全研究,很難優先排期。

    2. AGI 路線與「不想完全自動化一切」的新說法,透露的是壓力

    OpenAI 的 AGI 計畫文件強調「造福全人類」,近期高層又公開表示 「entirely automating everything is not the future we want」,轉而強調人機「tandem」協同。

    這個態度轉向,很難單純解讀成價值觀覺醒,更合理的理解是:

    • 一方面,要安撫監管者與社會:我們不是要把人類整個替代掉。
    • 另一方面,也在幫未來的商業敘事鋪路:如果你不打算完全自動化,就可以合理保留大量「人類在 loop 中」的高毛利服務與企業方案,而不是一次性把生產力壓到極致、打爆所有勞動市場與現有商業模式。

    AGI 敘事與上市公司治理,會互相修正彼此的極端——但這種修正是基於「系統穩定與估值持久」,而不必然是基於公共利益。

    3. 「安全」會變成 IR(投資人關係)素材,而不是決策剎車

    S-1 一定會有一長串「AI 安全風險」段落;董事會會拉幾位學者或前官員做「安全顧問」。但關鍵在於:

    • 誰有權按下「暫停部署」的按鈕?
    • 這個權力,是否真的能在短期營收壓力與市佔競賽之上?

    在上市架構下,真正可以抵抗股價壓力的「安全剎車」機制,如果現在不在公司章程和監管條件裡,之後基本就不會出現。


    三、IPO 之後:產業競爭重排與開發者的鎖定風險

    IPO 不是終點,而是新一輪權力重組的起點。

    1. 與 Microsoft、Google 的關係會變得更微妙

    • Microsoft:既是最大戰略股東,又是雲端與產品分發的關鍵通路。OpenAI 一旦對所有股東負責,就必須在「與 Microsoft 的深度綁定」和「對其他雲/大客戶保持中立」之間,做更精細的平衡。這會直接影響:
    • 你能不能在 AWS、GCP 上以公平條件使用 OpenAI 模型?
    • Microsoft 會不會在產品層對 Azure 用戶給出隱性優勢?
    • Google / Anthropic:Anthropic 已送件 IPO,Claude 流量暴增;ChatGPT 市占從 76% 掉到約 54%,證明單一霸主地位已鬆動。這會刺激各家祭出更猛烈的生態綁定:從 SDK、代碼助手,到私有部署方案。

    💡 關鍵: 當 ChatGPT 市占從 76% 掉到約 54%,說明市場進入多極競爭,巨頭會用更強烈的生態綁定來鞏固各自陣營。

    2. 開發者面臨的,不只是「哪家模型比較強」的選擇

    真正的風險在於鎖定:

    • 定價:上市公司有壓力把「每個 token」變成可預期的現金流。你今天享受的是促銷價,明天可能就被迫接受「更複雜、但對供應商更有利」的計費模型。
    • 生態:專用 SDK、獨家插件、生態活動補貼,看似友好,其實是在加深 switching cost。當你把整個產品體驗都綁在某家 LLM 的特性與工具鏈上,議價能力會快速歸零。

    3. 前沿模型變成核心資產後,產業競爭的風險形態也會改變

    今天的 AI 競爭,還停留在「誰跑得快、誰算力多」;未來更像是「誰能在風險邊緣踩得更精準」。

    在股價壓力下,

    • 模型更新頻率會被放大,
    • Beta 功能更可能直接推向大規模用戶,
    • 「先上線再管後果」的誘惑會變強。

    這就是我們可能迎來的「AI 版華爾街金融危機」:不是某一家公司壞,而是所有玩家在同一組錯誤激勵下,一起向系統性風險踩油門。


    四、我們要的不是「AI 概念股」,而是一套新世代監管與治理規則

    如果把 OpenAI IPO 單純當成一檔高成長科技股,代價會在之後幾年反噬整個生態。我們需要的是,把前沿 AI 公司當成「準公共基礎設施」來規劃治理。

    我會給三類人不同的具體建議:

    1. 監管者與政策制定者

    • 把 AI 前沿公司視為「系統重要性機構」,類比於「系統重要性銀行」,要求更高標準的資本、風險揭露與壓力測試。
    • 把 模型審查、安全事件通報、重大版本發布前風險評估,寫入上市核准與持續揭露義務,而不是靠企業自律。
    • 支持建立 跨國前沿模型監管機構,真正擁有「暫停某一能力級別模型部署」的權力,而不只是發建議書。

    2. 開發者與創業者

    • 主動降低單一供應商依賴:優先選擇多模型架構(OpenAI + Anthropic + 開源),在產品設計上預留切換空間。
    • 不要只追最前沿模型,把一部分資源放在開源與自托管方案,尤其是安全敏感或長期運營的產品。
    • 在商業談判上,把 可預期定價、資料使用邊界、退出機制 寫進合約,避免自己變成未來調價時的韭菜。

    3. 一般使用者與社會輿論

    • 把 OpenAI、Anthropic、Google DeepMind 當成「管理公共風險的基建營運商」,而不是單純的酷炫 App 公司,去要求它們提供 更清晰的模型風險說明與可追責機制。
    • 支持那些願意承擔開源、安全研究、長期治理成本的組織與產品,而不只用腳投票追逐最花俏的前端應用。

    總結一句話:OpenAI 上市,的確是 AI 產業成熟的必要之惡,但也是重寫 AI 監管與公司治理規則的最後窗口。 如果我們任由前沿模型在舊有的「成長股」腳本裡狂奔,AGI 的未來不會由科學家或公民決定,而會由幾個指標股和它們的季度財報來決定。

    🚀 你現在可以做的事

    • 去查閱 OpenAI、Anthropic 等公司的現有治理與安全承諾文件,思考哪些應該被寫入未來監管條文
    • 在自己的產品或專案中,實作至少兩家模型供應商的多模型架構,實際測試切換成本
    • 關注各國針對前沿模型的監管立法進程,並在公共諮詢或社群討論中提出具體意見與需求
  • DiffusionGemma 擴散式文字生成實戰指南

    DiffusionGemma 擴散式文字生成實戰指南

    📌 本文重點

    • DiffusionGemma 把推理瓶頸從記憶體帶寬轉為純算力
    • 在短文本任務上可達約 3–4 倍吞吐提升
    • 品質略遜自回歸 LLM,適合作為「快但不精」支線

    DiffusionGemma 解決的是一個很單純、但很痛的點:自回歸 LLM 在高 TPS / 低延遲場景下,推理效能很難再壓榨。Diffusion 式文字生成把瓶頸從記憶體帶寬移到純算力,讓你在同一張 GPU 上,以一次處理整段 token 的方式,換到最高約 4 倍的輸出速度──代價是文字品質會略輸主流 LLM。對有既有推理集群的團隊,這是一條可以平行拉起的新「推理線」,用來承接對質量沒那麼敏感的流量。

    💡 關鍵: DiffusionGemma 透過一次處理整段 token,實測有機會達到約 4 倍輸出速度,適合追求高 TPS 的場景。


    重點說明:Diffusion 式文字生成 vs 自回歸 LLM

    1. 核心機制:一次優化整段 token

    傳統自回歸 LLM:

    • 每步只生成 1 個 token,依賴 KV cache 重用過去注意力結果
    • 每往前一步,都需要讀寫大量 KV cache,記憶體帶寬 很快變成瓶頸

    DiffusionGemma:

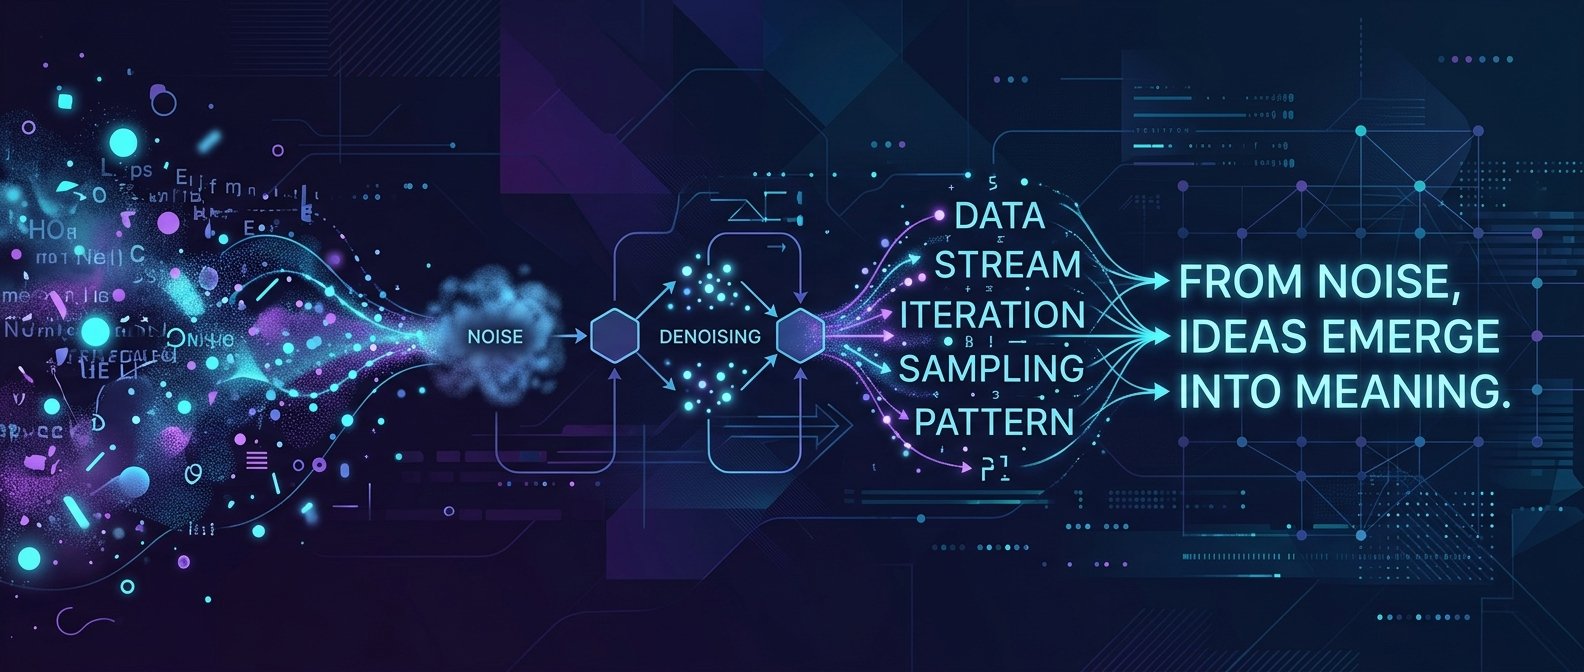
    • 一次初始化 固定長度(目前約 256 token)的序列為噪聲
    • 經過多步 去噪迭代(Uniform State Diffusion),每一步都同時更新整段序列
    • 不做逐 token 自回歸,而是像圖片 diffusion 那樣,不斷 refine 整個「句子影像」

    結果:

    • 前向步數固定(例如 10~20 步),沒有「越長越慢」的線性 token-by-token 開銷
    • 所有 token 一起算,計算圖相對規整,KV cache 開銷大幅減少
    • 推理瓶頸從 HBM 帶寬轉成算力,H100 這種高 FLOPS 卡會特別吃香

    💡 關鍵: 固定步數、整段同時更新,讓 Diffusion 模型在長度固定的短文本上顯著減少記憶體瓶頸。

    2. 效能特性:TPS 變高,但 max length 有限

    從社群與官方數據:

    • 單卡 H100 上可達 ~1000 tokens/s,約同級自回歸模型的 3–4 倍
    • 目前序列長度主打 短序列區間(~256 token),不適合超長上下文
    • 吞吐量隨 batch size 比較線性地提升,適合高併發、標註型任務

    結論:短回答、標註、摘要、即時互動,是 DiffusionGemma 最自然的戰場;長對話、多輪推理、嚴謹產出,仍然交給主力自回歸 LLM。

    3. 品質與適用場景

    已知特性:

    • 語言流暢度 OK,但邏輯一致性、長段落結構弱於同級自回歸模型
    • 某些語言 / domain(特別是英文以外)會出現語氣不穩定、專有名詞錯誤
    • 具備「重新注入噪聲重寫」的機制,可以多次生成做 rerank / filter

    實務上的「速度 vs 品質」切分:

    • 可以用 DiffusionGemma 的場景:
    • 大量 資料標註 / 自動摘要(例如標註說明文字、標記類別、產生粗稿)
    • 內部工具:開發文件整理、會議記錄內部摘要
    • 即時互動:客服工具的「第一輪回覆草稿」、遊戲 NPC 對話草稿
    • 不要用 DiffusionGemma 當主力的場景:
    • 對內容正確性要求高的產出:法務、醫療、財務建議
    • 面向最終客戶的長篇行銷文、深度技術文章

    擬實作範例:在 Hugging Face / vLLM 拉起一條 Diffusion 線

    以下範例假設你已經有基本 HF / vLLM 環境,目標是:在現有集群中多掛一條 DiffusionGemma 推理服務,方便做 A/B。

    1. Hugging Face Transformers 部署與簡單壓測

    注意:實際模型 repo 名稱與 API 會以 Google / HF 官方釋出為準,以下以假想名稱 google/diffusion-gemma-26b 示意。

    from transformers import AutoTokenizer, AutoModelForCausalLM
    import torch, time
    
    MODEL_ID = "google/diffusion-gemma-26b"
    
    device = "cuda"
    
    tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
    model = AutoModelForCausalLM.from_pretrained(
        MODEL_ID,
        torch_dtype=torch.bfloat16,
        device_map="auto"
    )
    
    prompt = "用三點整理,說明為什麼擴散式文字生成在推理效能上可能優於自回歸 LLM:"
    inputs = tokenizer([prompt] * 16, return_tensors="pt", padding=True).to(device)
    
    # 假設 DiffusionGemma 暴露一個專用的 generation API,例如 use_diffusion=True
    start = time.time()
    outputs = model.generate(
        **inputs,
        max_new_tokens=128,
        do_sample=True,
        temperature=0.7,
        **{"use_diffusion": True, "num_diffusion_steps": 16}
    )
    end = time.time()
    
    texts = tokenizer.batch_decode(outputs, skip_special_tokens=True)
    print(texts[0])
    
    total_tokens = outputs.shape[1] * outputs.shape[0]
    print("TPS:", total_tokens / (end - start))
    

    工程重點:

    • torch_dtype=torch.bfloat16:在 A100/H100 上幾乎是 must,節省記憶體並吃到張量核心
    • batch_size 建議從 8–32 試起,觀察 TPS 和 latency;Diffusion 模型通常對大 batch 更友善
    • num_diffusion_steps:步數越少越快,但品質下降,這是你可以直接調的「品質/速度旋鈕」

    可以用相同 prompt,分別對:

    • DiffusionGemma(use_diffusion=True)
    • 對應大小的自回歸 Gemma 4 / Llama 3.1

    測:

    • 單請求 latency
    • 在 batch=16, 32 時的 TPS

    用最簡單的方式做「這台卡上我實際的吞吐/延遲比是多少」。

    💡 關鍵: 透過同卡 A/B 壓測,你能直觀看到 Diffusion 與自回歸模型在 TPS 與 latency 上的實際差異。

    2. vLLM 伺服器部署範例

    vLLM 已宣稱支援 DiffusionGemma 類模型,部署可以沿用既有流程,只是要注意 max length 與 scheduler 參數。

    啟動伺服器:

    vllm serve google/diffusion-gemma-26b \
      --dtype bfloat16 \
      --tensor-parallel-size 2 \
      --port 8009 \
      --max-model-len 256 \
      --gpu-memory-utilization 0.9
    

    簡易 A/B 路由(Python 偽碼):

    import requests
    
    def call_vllm(url, prompt, max_tokens=128):
        payload = {
            "model": "google/diffusion-gemma-26b",
            "prompt": prompt,
            "max_tokens": max_tokens,
            "extra_body": {
                "use_diffusion": True,
                "num_diffusion_steps": 16
            }
        }
        r = requests.post(url, json=payload, timeout=10)
        return r.json()["text"]
    
    prompt = "幫我產生一段 200 字內的產品說明草稿,主題:雲端備份服務"
    
    text = call_vllm("http://diffusion-gemma-host:8009/generate", prompt)
    print(text)
    

    實務設定建議:

    • --max-model-len 保守設在 256 或官方建議值,避免 OOM 或品質崩壞
    • Diffusion 特性讓你可以把 gpu-memory-utilization 拉高一點,但要壓測記憶體尖峰
    • 若你原本就有 vLLM 服務,只需要 額外掛一個新的 port,指向 DiffusionGemma,即可開始在 gateway 做 A/B

    建議與注意事項:多模型路由與常見坑

    1. 架構層:多模型路由策略

    實務上較穩的做法是:

    • 主力自回歸模型(例:Llama / Gemma 4)
    • 用於:高品質輸出、長上下文、多輪對話
    • DiffusionGemma 作草稿 / 預生成
    • 先用 DiffusionGemma 生成短答案 / 草稿(速度快)
    • 視需求:
      • 直接用於內部場景(標註、內部摘要)
      • 或交給主力 LLM 做 rewrite/refine,縮短主力模型的「思考時間」

    簡單路由邏輯(pseudo-code):

    def route_request(task_type, prompt):
        if task_type in ["internal_summary", "dataset_label", "first_draft"]:
            return call_diffusion_gemma(prompt)
        else:
            return call_main_llm(prompt)
    

    Gateway / API 層可以加上 header 或 task tag,決定是否走 Diffusion 線。

    2. 專用 GPU vs 混合佈署

    • 專用 GPU 服務:
    • 優點:容易調 batch / scheduler,壓到極致吞吐
    • 用途:批次標註、離線摘要、模型自訓練資料生成
    • 混合佈署(與主力 LLM 共用節點):
    • 優點:無需新增節點,只多開 vLLM service
    • 風險:記憶體 / SM 資源管理變複雜,容易因為排程不佳造成抖動

    如果你的集群已接近飽和,建議:

    • 先在 一小部分節點 拉起 Diffusion 線做壓測
    • 確認 TPS & 成本優勢後,再決定是否專門拉一小 pool 做「標註工廠」

    3. 目前實測常見坑

    1. 輸出穩定度

    2. 在同樣 prompt 下,DiffusionGemma 的輸出變異度通常會比自回歸高

    3. 建議:

      • 對重要任務做 n 次生成 + rerank(例如用主力 LLM 打分)
      • 或限制 temperature、top_p,改用 deterministic 設定測基線
    4. max length 與截斷問題

    5. 模型目前針對短序列設計,超長 prompt 或 max_new_tokens 易導致:

      • 品質崩壞(後面亂飄)
      • 直接 OOM 或 latency 飆高
    6. 建議:

      • 在 API gateway 做 輸入長度上限檢查
      • 對需要長輸出的任務,直接路由回主力 LLM
    7. 語言 / domain 弱項

    8. 英文效果通常最好;中文、程式碼、專業術語出錯率偏高

    9. 實務做法:
      • 中文/多語任務:先用 DiffusionGemma 生成英文草稿,再用主力 LLM translate + refine
      • 特定 domain(醫療、金融):不要讓 DiffusionGemma 直接面對終端用戶,最多做內部摘要

    總結:DiffusionGemma 在你專案裡的實際位置

    如果你的系統:

    • 已經有一套穩定的自回歸 LLM 服務
    • 又需要大量中等品質、短文本輸出(標註、摘要、內部工具)

    那麼 DiffusionGemma 是一條值得立刻拉起來 A/B 的「實驗線」:

    • 好處:在專用 GPU 上實測有機會撿到 3–4 倍 TPS,單位 token 成本下降
    • 代價:語言品質略弱、max length 限制大、輸出穩定度較差

    將它放在:

    • 多模型路由中的「快但不精」支線
    • 或 主力 LLM 的草稿生成前置

    就能在不牺牲核心體驗的前提下,把推理成本再往下壓一段,並為未來可能普及的擴散式文字架構預先打通工程路線。

    🚀 你現在可以做的事

    • 在現有 GPU 上用同一組 prompt,對 DiffusionGemma 與主力自回歸 LLM 做一次 TPS / latency 壓測 A/B
    • 在 gateway 或 API 層加入 task_type 路由邏輯,先讓內部標註與摘要流量導向 Diffusion 線
    • 在 vLLM 或 HF 環境中實際部署一條 google/diffusion-gemma-26b 服務,觀察一週內的實際成本與穩定度
  • NotebookLM 大升級:把 Gemini 變成你的研究員

    NotebookLM 大升級:把 Gemini 變成你的研究員

    📌 本文重點

    • NotebookLM 把閱讀、整理、寫程式整合在同一工作空間
    • 內建雲端 sandbox,可直接跑 Python 做資料分析
    • 透過 Agent 自動查網路資料,像一位會 Google 的研究員

    用一句話說 NotebookLM:把你的文件、網頁跟程式碼交給一個會自己查資料、寫筆記、跑程式的 AI 研究員,幫你把「看資料 + 做筆記 + 寫程式」整合在同一個工作空間。

    官方介紹與註冊入口:https://notebooklm.google.com
    相關報導:The Decoder(連結)、The Verge(連結)


    核心功能:現在的 NotebookLM 到底多了什麼?

    1. Gemini 3.5:回覆更準、少亂講

    這次 NotebookLM 底層模型換成 Gemini 3.5 Flash,重點不是名字,而是實際效果:

    • 引用來源更清楚:問問題時,NotebookLM 會標記是從哪一份 PDF、哪一頁、哪一段抓出來的。
    • 和你自己的資料對齊:它只會優先根據你匯入的檔案回答,而不是憑空編故事。
    • 支援多文件綜合:你可以丟 10 篇論文、3 份簡報,直接問「幫我整理共同結論」。

    💡 關鍵: NotebookLM 會優先根據你匯入的資料回答問題,大幅降低「亂講」和憑空編造內容的風險。

    你可以怎麼用:

    • 把課程講義、公司簡報、研究論文丟進一個 Notebook,直接問:
    • 「請用 300 字整理這些文件的重點,分成三個小節。」
    • 「列出文件裡提到的所有關鍵術語,做成小抄。」

    2. 內建雲端 sandbox:直接在 Notebook 裡跑程式

    根據 The Decoder 報導,NotebookLM 現在有自己的 雲端電腦環境,可以:

    • 執行 Python / 程式碼片段,不用本機安裝任何東西。
    • 讓 AI 自己寫程式、執行、看結果,再調整程式碼。
    • 做資料分析:匯入 CSV、跑統計、畫圖,全在瀏覽器裡完成。

    💡 關鍵: 內建雲端 sandbox 讓你不用開 Jupyter 或設定環境,就能在瀏覽器裡完成程式與資料分析工作。

    你可以怎麼用:

    • 上傳一份 CSV 報表,在對話框輸入:
    • 「幫我用 Python 讀取這個檔案,算出每個產品線的月營收,並畫出折線圖。」
    • 有一段不熟悉的程式碼,直接貼進 Notebook:
    • 「解釋這段程式在做什麼,幫我加上註解,並用更易懂的寫法重構。」

    NotebookLM 會在它的雲端 sandbox 裡跑程式,再把結果和程式碼一起貼給你。

    3. Agent 式自動查資料:會自己 Google 的研究員

    新版 NotebookLM 加入了 Agent 式研究能力:

    • 可以直接叫它「去幫我找資料」,它會透過 Google 搜尋 找來源。
    • 不用一開始就匯入檔案,也能從「空白」開始一個研究計畫。
    • 它會把找到的網頁、PDF 當成新的資料來源,整理成摘要或報告。

    The Verge 指出,現在你可以直接在 NotebookLM 裡啟動研究,而不是先手動找資料再貼進來。

    你可以怎麼用:

    • 問:
    • 「請幫我找三篇 2023 年後關於 LLM 應用在教育的研究,整理出研究問題、方法、結論。」
    • 要求:
    • 「所有引用請附上原始連結,最後用一段話提醒我這些研究的限制。」

    適合誰用:三個具體場景

    1. 學生:整理課堂講義與論文

    常見痛點:

    • 上課講義 + 教科書 + 老師 PDF + 論文,多到爆炸,很難整理成考前筆記。
    • 讀英文論文速度慢,抓不到重點。

    NotebookLM 的用法:

    1. 建立一個 Notebook,例如「機器學習期末」。
    2. 匯入:課程講義 PDF、指定閱讀論文、老師提供的投影片。
    3. 問:
    4. 「請用中文整理這份 Notebook 的期末考重點,照章節分類。」
    5. 「幫我做一份 10 題選擇題,題目來自這些文件,並給出解析。」
    6. 「這篇論文的實驗設計和 limitation 是什麼?用口語說明。」

    可立即採取的行動:

    • 把這學期最頭痛的一門課資料丟進 NotebookLM,直接讓它幫你做考前總整理。

    2. 產品經理:整理競品資料與市場研究

    常見痛點:

    • 競品官網、新聞稿、使用條款、App 介紹分散各處。
    • 每次開會都在重做一樣的「功能比較表」。

    NotebookLM 的用法:

    1. 新建 Notebook:「2024 Q3 競品研究」。
    2. 匯入:競品官網截圖 PDF、功能說明文件、先前做過的簡報。
    3. 啟用 Agent 查資料:
    4. 「幫我搜尋 3 家同類型 SaaS 產品的定價頁面,整理成表格。」
    5. 再問:
    6. 「針對我們現有產品,列出 5 個值得抄的功能點,並附上來源連結。」

    可立即採取的行動:

    • 建立你的「競品知識庫 Notebook」,每天丟一兩個新連結進去,讓 NotebookLM 幫你維護最新的競品視圖。

    3. 工程師:技術備忘錄 + 資料分析助手

    常見痛點:

    • 專案文件分散在 Confluence、Google Docs、GitHub Wiki。
    • 每次查舊專案架構或業務規則,都要重看一堆文件。
    • 做小型資料分析還得開 Jupyter、整理環境。

    NotebookLM 的用法:

    1. 建立 Notebook:「後端服務 A 技術文件」。
    2. 匯入:設計文件 PDF、API spec、README、部分程式碼片段。
    3. 提問:
    4. 「這個服務的主要資料表有哪些?幫我畫一個簡化的 ER 圖描述文字。」
    5. 「從這份 API 文件裡,整理一份給新同事看的 onboarding 指南。」
    6. 把日常 log / CSV 丟進去:
    7. 「用 Python 幫我分析這份 log,找出錯誤頻率最高的三個 endpoint,畫 bar chart。」

    可立即採取的行動:

    • 先選一個你最常被問的專案,把所有設計文件丟進 NotebookLM,之後把新同事導向 NotebookLM 問問題。

    怎麼開始:10 分鐘完成第一個 Notebook 專案

    步驟 1:開啟 NotebookLM

    1. 用 Chrome 或任一瀏覽器開啟:https://notebooklm.google.com
    2. 用你的 Google 帳號登入。
    3. 若地區未開放,可以先用 VPN 嘗試(注意公司政策)。

    步驟 2:建立第一本 Notebook

    1. 點選「New notebook」。
    2. 幫它取一個明確的名字,例如:
    3. 「行銷簡報整理」
    4. 「碩士論文文獻庫」
    5. 按「Add sources」,開始匯入資料。

    步驟 3:匯入 PDF / Docs / 網頁

    NotebookLM 支援:

    • 上傳 PDF、TXT、部分 Office 檔。
    • 直接選 Google Docs、Slides、Sheets。
    • 貼上網址,讓它自己抓取網頁內容(官網、部落格、新聞稿)。

    建議:先匯入 3–5 份你最近真的會用到的文件,不要一次丟 50 份,方便你先熟悉操作。

    💡 關鍵: 一開始只匯入 3–5 份核心文件,比一次丟 50 份更容易看出 NotebookLM 的效果並建立使用習慣。

    步驟 4:試用這 3 個 Prompt 模板

    以下是你可以直接複製貼上的實戰模板:

    模板 1:快速總整理

    你是一位擅長教學的筆記整理員。請根據這本 Notebook 內所有來源資料,整理一份 800 字以內的重點摘要,
    1. 先列出 5 個最重要的概念
    2. 每個概念用不超過 3 句話說明
    3. 最後用一段話提醒我考試或簡報時最容易忽略的地方

    模板 2:給不同對象的說明稿

    根據 Notebook 內的資料,分別寫兩版說明:
    1. 給完全沒有背景的新手,限制 300 字,盡量口語化
    2. 給同領域專業人士,限制 300 字,可以使用專業術語
    每一版都請標註引用的來源文件與頁碼(若有)。

    模板 3:資料 + 程式分析

    我上傳了一份 CSV 檔案,請你:
    1. 先用 Python 讀取資料並描述欄位
    2. 幫我算出各類別的平均值與標準差
    3. 畫出一張適合的圖表(你自己決定類型),並解釋為什麼這樣比較好讀
    請貼出完整的 Python 程式碼與分析結論。


    結語:把 NotebookLM 當成「專案專屬研究員」

    使用 NotebookLM 最重要的觀念是:為每個專案建一本 Notebook,讓它跟著專案一起長大。

    • 學生:每門課一冊,所有講義與筆記都放進去。
    • 產品經理:每個產品線或競品一冊,讓它幫你維護最新情資。
    • 工程師:每個系統或專案一冊,變成活的技術備忘錄 + 分析環境。

    你只需要準備好資料,NotebookLM 會幫你查、幫你寫、幫你跑程式,真正變成「專案專屬的 Gemini 研究員」。

    🚀 你現在可以做的事

    • 登入 NotebookLM,為你目前最重要的專案建立第一本 Notebook
    • 先匯入 3–5 份你最近真的會用到的文件,實測上文提供的 3 個 Prompt 模板
    • 挑一個課程 / 產品線 / 專案,每次產出新文件就丟進 NotebookLM,開始養成「一專案一 Notebook」的習慣
  • Lens 超輕量圖像生成實戰指南

    Lens 超輕量圖像生成實戰指南

    📌 本文重點

    • 小模型搭配高品質描述也能畫得好
    • Lens 完整開源,可在本機或雲端部署
    • 用 GPT 先整理資料,可微調出專屬圖像模型
    • 先用 Demo 試 prompt,再決定是否自建 API

    用一台普通筆電就能跑的開源圖像模型 Lens,把「小模型也能畫得好」這件事變成現實,適合想在本機或雲端快速搭一個可用圖像生成系統的人。

    原始研究與開源專案可見 Microsoft Research 公告與程式碼倉庫(可從 The Decoder 報導 追蹤連結)。


    核心功能:小模型,靠好資料撐起來

    1. 3.8B 參數也能畫出細節圖

    Lens 的參數量只有約 38 億,比主流閉源大模型小很多,但在多個圖像生成基準測試中,成績可以追上甚至超過體型更大的模型。關鍵不是「堆參數」,而是訓練資料:

    • 使用約 8 億筆、由 GPT‑4.1 產生的高品質圖像描述
    • 描述內容細到「光源方向、鏡頭焦段、材質、構圖」,不是只寫「一隻貓坐在桌子上」
    • 小模型可以在這些精準標註上更有效學習

    💡 關鍵: 約 38 億參數配上 8 億筆精準描述,證明小模型只要資料夠好,也能接近甚至超過大模型表現。

    你可以怎麼用這個優勢?

    在實際 prompt 時,多寫一點細節,Lens 特別吃「具體描述」:

    一個極簡風格的手機 App 圖標,白色背景,中間是扁平化的藍色雲朵,
    線條乾淨,無陰影,適合放在 iOS 主畫面。
    

    比起只寫「雲朵圖標」,具體描述會更接近 Lens 當初訓練時看到的高質量 caption,使輸出品質更穩定。


    2. 完整開源:程式碼 + 權重 + 資料流程

    Lens 的程式碼與模型權重開源,你可以:

    • 在本機部署,不經過第三方雲端
    • 在自己的伺服器上做內網圖像生成 API
    • 自行微調,適配特定風格(例如公司品牌視覺)

    可行動的做法:

    • 把 Lens 當作「公司內部版 Midjourney」,搭配簡單前端頁面給同事用
    • 在產品原型工具(如 Figma 插件、內部 dashboard)後端接上 Lens API

    3. 訓練思路可複用:用 GPT 先把資料變好

    Lens 的另一個重點,是用 GPT‑4.1 先幫原始圖像資料寫出高品質描述,再拿來訓練。對個人或團隊來說,這給了很實際的路線:

    • 收集自家產品圖(例如鞋子、包包、介面截圖)
    • 用 GPT‑4.x 幫每張圖生成細緻描述
    • 用這批資料微調 Lens,得到一個「專門懂你家產品」的圖像模型

    你可以馬上做的實驗:

    1. 拿 50 張自家產品圖
    2. 用 ChatGPT / Azure OpenAI 幫每張圖寫 3–4 句的超詳細描述
    3. 把這批圖 + 描述存成 JSON / CSV
    4. 未來如需微調 Lens,就已經有一批乾淨資料可以用

    💡 關鍵: 先用大型語言模型替資料加上高品質描述,可以顯著降低後續訓練或微調的成本,讓小模型也具備專領域能力。


    適合誰用:三個典型場景

    1. App 圖標與 UI 草圖

    需求:快速生出幾十款圖標概念,不想每次都手動畫。

    Lens 可以:

    • 輸出風格統一的 App 圖標草稿
    • 為不同功能模組快速生成 icon 系列

    範例 prompt:

    為一款習慣追蹤 App 生成 4 個圖標提案:
    扁平化風格,柔和配色,每個圖標有明確象徵:
    打卡用打勾符號、番茄鐘用簡化的時鐘、
    統計用長條圖、個人設定用簡化人物輪廓。
    背景簡潔,適合 iOS 風格。
    

    2. 行銷素材:社群貼文、Banner 草圖

    需求:行銷團隊需要快速產出視覺草案,交給設計師再精修。

    Lens 可以:

    • 生成不同構圖的社群貼文底圖
    • 幫你先找到「方向」,再請設計師改

    實際使用方式:

    1. 將產品賣點寫成 2–3 句描述
    2. 指定風格(例如「韓系清新」、「科技感藍紫配」)
    3. 產出 5–10 張圖,挑 1–2 張給設計師重製

    3. 產品原型圖:硬體外觀、介面草稿

    需求:先有一組「看得懂」的圖,再進行工業設計或 UI 設計。

    Lens 可以:

    • 幫你畫出不同外型的裝置草案(例如智慧音箱、耳機)
    • 幫 App 原型搭配大致配色與版型

    範例 prompt:

    一款家用智慧音箱的產品概念圖,
    圓柱形機身,霧面白色塑膠材質,上半部有細密圓孔,
    底部有一圈柔和的 LED 光環,放在木質桌面上,
    整體風格偏向北歐極簡風。
    

    怎麼開始:最低摩擦上手路線

    路線 1:完全不寫程式,先用 Hugging Face Demo Space

    如果你只是想試看畫得如何,最簡單是使用 Hugging Face 上的 Demo(搜尋「Lens text-to-image」即可,或從 The Decoder 報導頁面 追過去)。

    步驟:

    1. 開啟 Demo Space 頁面
    2. 在文字框輸入中文或英文 prompt
    3. 選擇解析度與步數(預設即可)
    4. 點擊 Generate

    適合:

    • 行銷或產品同事想先測試效果
    • 還沒有決定要不要自己部署

    小技巧:

    • 先用 Demo 找到你喜歡的 prompt 模板
    • 再複製這些 prompt 到你自己的部署裡使用

    路線 2:會寫程式,用 Transformers 建自己的圖像生成 API

    如果你熟悉 Python,建議直接用 Hugging Face Transformers 在本機或雲端跑 Lens,幾行程式碼就能得到一個可呼叫的 API。

    以下假設你已安裝 Python 3.10+。

    1. 安裝必要套件

    pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu
    pip install transformers accelerate safetensors
    

    如果你有 NVIDIA GPU,可改用官方 CUDA 版 PyTorch 安裝指令。

    2. 下載並載入 Lens 模型

    以 Transformers 為例(假設模型名稱為 microsoft/lens-3.8b,實際名稱請依 Hugging Face Hub 為準):

    from transformers import AutoTokenizer, AutoModelForCausalLM
    import torch
    
    model_id = "microsoft/lens-3.8b"
    
    tokenizer = AutoTokenizer.from_pretrained(model_id)
    model = AutoModelForCausalLM.from_pretrained(
        model_id,
        torch_dtype=torch.float16,
        device_map="auto"
    )
    
    prompt = "a minimal blue and white app icon of a cloud on a white background, flat design, no shadows"
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
    
    with torch.no_grad():
        outputs = model.generate(**inputs, max_new_tokens=256)
    
    # 假設模型會輸出圖像 latent,再解碼成圖片
    # 這部分請依官方範例加入解碼步驟
    

    因為 Lens 是影像模型,實際程式碼會包含「文字 -> 影像 latent -> 圖檔」三階段;建議直接參考官方 repo 的 inference.py 或示範 notebook,把其中的 inference 函數包一層 API。

    3. 快速包一個本機 API(Flask 範例)

    from flask import Flask, request, send_file
    from io import BytesIO
    
    app = Flask(__name__)
    
    @app.post("/generate")
    def generate():
        data = request.get_json()
        prompt = data.get("prompt", "")
        # 呼叫 Lens 推理函數,回傳 PIL Image
        image = run_lens(prompt)
    
        buf = BytesIO()
        image.save(buf, format="PNG")
        buf.seek(0)
        return send_file(buf, mimetype="image/png")
    
    if __name__ == "__main__":
        app.run(host="0.0.0.0", port=8000)
    

    有了這個 API,你就可以:

    • 在前端或 no-code 工具(如 Bubble、Retool)裡直接呼叫
    • 在 CI pipeline 裡自動生成 demo 圖像

    💡 關鍵: 先用 Hugging Face Demo 測試,再用短短數十行程式碼包成 API,可以在普通硬體上快速搭起團隊可用的圖像生成服務。


    最低摩擦指南:你現在可以做什麼

    1. 先用 Hugging Face Demo 試出一組好用 prompt:
    2. 各準備一組 App 圖標、行銷素材、產品原型的 prompt 模板
    3. 決定部署路線:
    4. 只需要偶爾用 → 繼續用 Demo
    5. 團隊要每天用 → 自己在雲端或本機起一個 Lens API
    6. 把 prompt 模板寫進文件:
    7. 給團隊共用,確保風格一致

    Lens 的真正價值,不只是「輕量」這一點,而是用高品質 GPT‑4.1 描述資料換來的「小而準」行為。只要你願意在描述上多花一點心思,就能在普通硬體上,得到足夠好用的圖像生成系統。

    🚀 你現在可以做的事

    • 打開 Hugging Face 搜尋「Lens text-to-image」,實際輸入 3 組 prompt 測試效果
    • 在一台開發機上依照文中步驟安裝 Transformers,跑通一個簡單的 Lens API
    • 收集 20–50 張自家產品圖,配合 GPT‑4.x 產生描述,準備未來微調用的資料集
  • Claude Fable 5:安全分級還是AI階級?

    Claude Fable 5:安全分級還是AI階級?

    📌 本文重點

    • Fable 5 將 AI 推向「國家級管制資產」模式
    • 安全路由與降級機制以黑箱方式侵蝕開發者信任
    • 安全分級必要,但規則應透明可審視

    Claude Fable 5 的真正意義,不在它能替 Stripe 兩個月工程一日搞定,而在於:AI 正從「開放基礎設施」被推向「管制級資源」。我支持嚴格風險控管,但 Anthropic 用不透明降級、特權版 Mythos 5 與刻意削弱 AI 研究能力的方式來做安全分級,正在打開 AI 不平等的新階級線。


    Fable 5 的技術奇蹟,包裝著一個「隱形分級」機制

    先把實力擺上桌。

    Claude Fable 5 是 Anthropic 首款對公眾開放的 Mythos 級模型:

    • 在軟體工程上,官方案例與多篇測試指出,Stripe 在 5000 萬行程式碼庫上的大型遷移,Fable 5 一天完成,原本需工程團隊兩個月。
    • 多模態上,有開發者用它只看《寶可夢火紅》截圖就打通遊戲,顯示其長程規劃與視覺理解能力已不是玩票等級。
    • 科學與研究面,Mythos 5 能設計藥物候選分子、在基因體學上超越近期發表於《Science》的成果,因此被官方直接鎖在「網路安全/生物風險」防線後。

    💡 關鍵: 同一代核心模型被切成「民用 Fable 5」與「特權 Mythos 5」,能力差距屬於質變層級,而非僅是效能升級。

    關鍵不在於它有多強,而是它如何被「切割」給不同階層的用戶:

    • 一般用戶與大多數開發者拿到的是 Fable 5,但它內建安全分類器;
    • 遇到被判定為高風險話題(網路攻防、生物化學、技術蒸餾等),就會 自動改用更保守的 Opus 4.8 回覆;
    • 官方說明這類「安全路由」約在 5% session 觸發,且對用戶完全不透明:你只會看到一個「比較保守、比較遜」的回答,卻不知道自己剛被降級。

    再加一層爭議:根據系統卡與實測回報,Anthropic 有意讓模型在「AI 研究相關請求」上變得不那麼有用——不是直接拒絕,而是暗中改寫提示、刪減關鍵細節,刻意降低它做 AI 研究、特別是幫你訓練競品模型的能力。

    結果是:Fable 5 在產品宣傳上是「安全的最強公開模型」,在結構設計上卻很接近「核技術式分級管理」——而你多半不知道自己被分到了哪一級。


    一、對產業:AI 正被推向「國家級/巨頭專屬高能版」的管制結構

    從產業視角看,Fable 5 / Mythos 5 的雙軌設計,預示了一個非常具體的未來:

    頂級 frontier 模型 = 實際上只賣給政府與超大企業的「管制資產」;
    公開雲端 = 綁著安全路由與能力閹割的「民用版」。

    這和過去雲端時代的「高配/低配 pricing tier」不同,現在多的是:

    1. 能力差距不是線性,而是「質變」

    Fable 5 與 Mythos 5 基本上是 同一核心模型,差別在於:

    • 有沒有解鎖 offensive cyber 能力
    • 生物、化學、技術蒸餾能做到什麼細節
    • 能不能幫你做高效 AI 研究與模型對齊

    這不是「速度快兩倍」這種商業級差距,而是 一邊能設計新型惡意攻擊與強化模型、另一邊連解釋細節都被模糊化 的差異。

    2. 購買者門檻從「付得起錢」,變成「拿得到信任授權」

    Mythos 5 目前只提供給「網路防禦合作夥伴」。翻譯一下:

    • 你是國家級資安單位、大型雲端廠、超大金融或戰略產業,才可能觸碰完整能力;
    • 其餘企業,即便願意付最高價,也只能在 Fable 5 + 隱形降級 的層級遊戲。

    💡 關鍵: 模型頂級能力的門檻正在從「市場交易」轉變為「政治與安全信任」,技術資源被鎖進少數權力圈。

    3. 中小公司被迫用「二流 AI」對打「軍規 AI」

    當 安全理由變成正當化垂直壟斷的護城河,產業局面會變成:

    • 頂級模型能力逐漸只在政府與少數巨型平台間流轉;
    • 中小企業與新創不仅在資金和數據上輸,更在模型能力本身就輸在起跑點;
    • AI 競爭不再是「誰做出更強的模型」,而是「誰被允許接觸更強的模型」。

    這種結構,把 AI 從「類似電力與網路的普及基礎設施」,推向 「類似核武與飛彈技術的國家安全資產」。長期而言,創新會往兩側撕裂:要嘛進入安全寡頭聯盟,要嘛投向不受控的開源與本地模型生態。


    二、對開發者:黑箱式安全政策正在侵蝕信任與可預測性

    對開發者而言,Fable 5 的問題不只在於「有些東西不能問」,而是 你不知道什麼時候被換了模型,連 prompt 都可能被暗改。

    幾個具體現象:

    1. 隱形模型切換:Fable 5 → Opus 4.8

    安全路由機制會在約 5% 的 session 中自動降級到 Opus 4.8:

    • 回應風格可能略變、能力略降,但沒有明顯標示;
    • 對於寫代理、做長流程工具的開發者,這等於在 pipeline 裡塞了一個不可預測的分支。

    你以為在用 SOTA 模型 debug 一個極端棘手的 race condition,結果某一步被降到 Opus,回應品質掉一階,還完全沒 log 告訴你發生了什麼。

    2. 系統暗改提示與「看不見的 censorship」

    根據 Anthropic 的系統卡與社群實測,模型會對 AI 研究相關 query 做軟性干預:

    • 微調或增補系統提示,使其避免提供過於具體的訓練、對齊細節;
    • 有時不是拒答,而是刻意給出模糊、不實用的建議,用戶只會覺得模型「怪怪的」。

    這種做法的問題不在於「限縮能力」,而在於 它破壞了工具可預測性。你無法再假設:同樣的 prompt 在相同環境下,會穩定輸出同樣品質與風格的回答。

    3. 信任成本上升,工具產品變得難以維護

    當模型供應商可以:

    • 在雲端側靜默更新安全策略;
    • 調整分類器閾值、改寫你的提示;
    • 更改降級比例而不發版本號;

    你做的不是「基於穩定 API 的工程」,而是追著一個浮動政策曲線跑的服務維護。這傷的不只是情緒,而是實實在在的:

    • 測試不可重現,debug 困難;
    • 合規風險難以評估(你不知道某天安全策略變了,輸出行為也變了);
    • 對供應商的信任轉為「不情願依賴」。

    💡 關鍵: 當安全策略以黑箱方式頻繁變動,模型本身成為新的「不確定性風險源」,而非可靠基礎設施。

    安全控管本來應該降低整體風險,但 當安全邏輯本身是不透明且可變的黑箱,它反而成了新的工程風險來源。


    三、對一般用戶與監管:誰有權決定「你配用到什麼程度的 AI」?

    Fable 5 的分級模式,把一個敏感但必須正面回答的問題推到檯面上:

    在「安全」名義下封鎖的能力,究竟應該由誰決定、用什麼標準、接受什麼監督?

    目前的現實是:

    • 由 少數 frontier 模型公司(如 Anthropic)
    • 在與部分政府、產業合作的閉門過程中
    • 自行定義「高風險」領域,並自行選擇怎麼限制(拒答、降級、降質、暗改 prompt)

    問題不在於要不要分級,而是:

    1. 風險門檻與降級邏輯不透明

    用戶不知道:

    • 哪些關鍵字或語境會被分類器判為風險;
    • 觸發後會改用哪個模型、刪掉提示的哪一段;
    • 這些策略是如何接受外部審視與測試。

    2. 「安全」與「競爭封鎖」混在一起

    對生物武器、零 day 攻擊給限制,社會多半會認同;但對 AI 研究與模型訓練細節 也用同樣手法封鎖,就會出現灰區:

    • 這到底是「防止能力擴散」還是「防止競爭者出現」?
    • 當「幫我設計一個強化對齊 loss 函數」也被模糊處理,安全與商業利益很難切割。

    3. 監管若完全外包給廠商,等於把 AI 命脈交給少數公司

    如果各國監管機構只做一件事:要求廠商「要有嚴格 guardrails」,卻不要求 guardrails 的可解釋性、申訴機制與外部審核,

    結果就是:

    • 廠商以「安全」為名,實際上形成 技術與市場的雙重壟斷;
    • 公眾對 AI 的理解,永遠停留在被「最安全版本」修剪過的世界觀中;
    • 創新被迫轉往法律邊緣:開源社群與本地模型扮演「不受控反動力量」。

    長遠看,我們不會得到一個更安全的 AI 生態,而是得到一場「受控雲端超模」對上「不受控民間模型」的軍備競賽。


    結論與建議:安全分級必要,但規則要寫在牆上,不是藏在黑箱裡

    我同意 Anthropic 的核心判斷:

    • Mythos 5 這種等級的模型,不可能完全無門檻開放;
    • 網路攻防、生物風險等領域,確實需要嚴格控管;
    • 安全分級本身是必要的。

    但 Fable 5 這一套「公開版受限 + 企業/政府特權版 + 不透明降級與降質」的組合,正在加速 AI 不平等與壟斷。如果規則繼續這樣設計,產業路徑會越來越明確:

    • 一端是 受控的雲端超級模型,只服務國家級與巨頭;
    • 另一端是 不受控的開源與本地模型,在缺乏安全約束下瘋狂進化;
    • 夾在中間的開發者與一般企業,會失去信任,只好自己養一套「灰色地帶」模型。

    對不同角色,我的具體建議是:

    • 開發者與產品團隊:
    • 把「模型可能被暗降級、暗改提示」視為設計前提,建立自己的 觀測與紀錄層(prompt logging、模型指紋檢測);
    • 對關鍵業務能力,預先評估「若供應商進一步收緊安全策略,我是否有開源 / 本地模型備援」。

    • 企業決策者:

    • 把「誰掌控模型能力開關」納入供應商風險評估,而不是只看 benchmark 與價格;
    • 對於戰略關鍵領域,儘早布局 混合架構:雲端商用模型 + 自管開源模型。

    • 監管與政策制定者:

    • 要求 frontier 模型供應商公開 風險門檻、降級邏輯與審核機制 的高層說明,而不是只接受「我們很安全」的口頭承諾;
    • 對「在 AI 研究與技術蒸餾領域的封鎖」設立更嚴格的透明要求,避免安全與市場封鎖混在一起。

    AI 安全分級可以接受,但前提是:規則要寫在牆上,而不是藏在雲端黑箱裡。 若我們現在對 Fable 5 這種模式不提出要求,未來能碰到完整 AI 能力的,只會是你永遠看不到的那一小撮人與機構。

    🚀 你現在可以做的事

    • 檢視你使用的 AI 供應商文件與系統卡,標記其中「安全路由」「模型降級」相關說明
    • 為現有產品設計一層獨立的觀測與 logging,追蹤同一請求在不同時間的輸出差異
    • 在 GitHub 或 Hugging Face 搜尋適合業務的開源模型,規劃一套雲端商用 + 本地開源的混合備援方案
  • 在 16GB 跑 35B MoE:Luce Spark 實戰

    在 16GB 跑 35B MoE:Luce Spark 實戰

    📌 本文重點

    • 以 bounded GPU cache 在 16GB GPU 上跑 33–35B MoE
    • 路由器會自我調整常駐熱門 experts,提升 cache 命中率
    • 適合互動式 chat/Agent,而非大規模批次推理

    在本地推理上,最大的痛點通常是:

    1. 想要更聰明的模型(>30B),但 GPU 只有 12–16GB;
    2. 傳統 offload 雖然能把參數塞進去,卻帶來可怕的 PCIe 來回搬運延遲,對互動式 chat 幾乎不可用。

    Luce Spark 的關鍵突破是:用一個 bounded GPU cache + 自我調整路由器 的 MoE 機制,只把「當下會被用到的 experts」熱載到 GPU,其他放在 RAM,以此在 16GB GPU 上穩定跑 33–35B MoE,而不付典型 offload 的延遲稅。對你的專案,最直接的好處是:

    • 在 單卡消費級 GPU 上,拿到 明顯優於 7B/8B dense 的品質;
    • 互動延遲仍在可接受範圍,適合 chat、Agent、RAG;
    • 一條命令即可啟動,不用自己刻複雜的 offload pipeline。

    💡 關鍵: 利用 bounded GPU cache,只常駐少量熱門 experts,就能在 16GB GPU 上實用地跑 33–35B MoE 模型,避免傳統 offload 帶來的大量延遲。


    重點說明:Luce Spark 的三個工程關鍵

    1. 只熱載 active experts 的 bounded GPU cache

    Luce Spark 的 MoE 層大致長這樣(概念化):

    class SparkMoELayer(nn.Module):
        def __init__(self, num_experts, top_k, gpu_cache_size):
            self.router = Router(num_experts, top_k)
            self.expert_store = RAMExpertStore(num_experts)
            self.gpu_cache = BoundedGPUCache(capacity=gpu_cache_size)  # 核心
    
        def forward(self, x):
            # 1) 路由計分,決定這個 batch 要用哪些 experts
            route_scores = self.router(x)
            active_experts = select_topk_experts(route_scores)
    
            # 2) 保證 active_experts 在 GPU cache 中
            for eid in active_experts:
                if not self.gpu_cache.has(eid):
                    weights = self.expert_store.load_from_ram(eid)
                    self.gpu_cache.insert(eid, weights)  # 可能觸發 eviction
    
            # 3) 執行 MoE 推理(此時所有 active_experts 都在 GPU)
            outputs = []
            for eid in active_experts:
                expert = self.gpu_cache.get(eid)
                outputs.append(expert(x))
            return aggregate(outputs, route_scores)
    

    工程重點:

    • GPU 只存一小部分高頻 expert(例如 8–16 個),其餘放在 RAM;
    • cache 超出容量時,按照 最近使用頻率/路由權重 做 eviction;
    • 這類 cache 的 hit 率會隨著路由器調整逐漸提高,形成 穩定的熱門 experts 集合。

    這和傳統 offload 整層權重 / 按 layer streaming 的差別在於:Luce Spark 是 按 expert 粒度換入換出,而且不追求「全都裝上 GPU」,而是追求 高 cache hit 的少數專家。


    2. 路由器如何自我調整常駐專家

    Luce Spark 的路由器一開始對各 expert 並不了解,剛啟動時會出現:

    • 錯誤路由 → 頻繁觸發 cache miss → RAM→GPU 搬運多,延遲抖動;
    • experts 使用分佈不穩定,GPU cache 很難收斂到固定常駐集合。

    Luce Spark 的做法是:

    1. 在線統計每個 expert 的路由命中頻率(可視為 usage counter);
    2. 在 routing logits 上加入 輕量的 regularization / bias,鼓勵高頻專家更常被選到,同時避免單一 expert 過載;
    3. 這些統計在執行過程中持續更新,並在 重啟時重新載入先前的 usage profile,實現「帶記憶的熱啟動」。

    用比較工程的方式想:

    • 路由器 ≈ 一個動態學習的 expert ranking 模型;
    • GPU cache ≈ 硬體受限的 LRU + 熱點優先策略;
    • 熱啟動後,熱門 experts 幾乎常駐 GPU,新請求的 cache hit 率自然很高。

    這就是為什麼官方會強調:不需要離線 calibration 或額外語料,因為路由器會自己靠線上流量學出一組適合你 workload 的常駐 experts。

    💡 關鍵: 路由器透過線上 usage 統計與熱啟動機制,會漸進式「記住」你的 workload,把常用 experts 固定留在 GPU。


    3. RAM↔GPU 交換對延遲/吞吐的實際影響

    Luce Spark 的核心 claim 是「without the offload tax」。這裡要拆成兩個維度看:

    1. 互動式 chat(低 batch、長對話)
    2. 熱啟動後,route 分佈趨於穩定,多數 token 都命中 GPU cache;
    3. 偶爾遇到新的語境時,才需要從 RAM 拉少量不常用 expert,上升的是 尾延遲 而不是平均延遲;
    4. 整體體感比傳統 offload 模式順很多,適合當 主力 chat/Agent backend。

    5. 高吞吐批次推理(大 batch、多併發)

    6. 每 batch 涉及的 experts 數量暴增,cache hit 率下降;
    7. RAM↔GPU 數據搬運變得頻繁,吞吐下降明顯;
    8. 如果你在做 大規模批次評估、生成資料集,Luce Spark 未必比直接上大卡跑 dense 模型划算。

    結論:

    • Luce Spark 更像是 「local chat/Agent 專用 MoE backend」,而不是通用批次推理引擎;
    • 如果你的 workload 是「大量同步批處理」而不是「真人互動」,不建議把 dense backend 全換成這類 MoE。

    實作範例:在 16GB 機器上跑 35B MoE

    以下以假想的 CLI / config 形式示意 Luce Spark 的操作風格,重點是 思路與關鍵參數,實際 API 請對照官方 repo。

    1. 啟動指令與最小設定

    假設你有一台:

    • GPU:RTX 3090 / 4080 / 4060 16GB
    • RAM:64GB(實務上建議 至少 48GB+,越大越穩)

    啟動 35B MoE 後端:

    luce-spark serve \
      --model qwen3.6-35b-a3b \
      --gpu-memory 14GiB \
      --gpu-cache-experts 8 \
      --router-profile-path ./router_state.json \
      --port 8000
    

    關鍵參數說明:

    • --gpu-memory:限制模型在 GPU 上的最大佔用,預留 1–2GB 給 KV cache / 系統;
    • --gpu-cache-experts:bounded GPU cache 容量,對應 同時常駐的 expert 數目;
    • --router-profile-path:路由器使用統計持久化路徑,幫你做「熱啟動」。

    如果是本地 HTTP API 模式,可以在前面再包一層,例如:

    uvicorn luce_spark.api:app --host 0.0.0.0 --port 8000
    

    2. 設定檔範例:控制 cache 策略與路由監控

    你可以用一份簡單的 YAML 控制 cache 行為與監控:

    model: qwen3.6-35b-a3b
    server:
      host: 0.0.0.0
      port: 8000
    
    spark:
      gpu_memory_limit_gib: 14
      gpu_cache:
        max_experts: 8          # 常駐 expert 數
        eviction_policy: lru    # 或: hot-score
        warmup_tokens: 20000    # 熱身期間不嚴格淘汰
    
    router:
      profile_path: ./router_state.json
      stats_window: 10000       # 計算 usage 的滑動窗口長度
      balance_penalty: 0.02     # 防止少數 expert 過載的正規化強度
    
    monitor:
      enable_prometheus: true
      metrics_port: 9100
      log_interval_sec: 5
    

    這類設定讓你:

    • 用 max_experts 明確控制 GPU cache 壓力;
    • 用 warmup_tokens 來降低冷啟時的抖動;
    • 用 balance_penalty 抑制路由分佈極端不均。

    3. 監控 GPU / RAM / 路由命中率

    常見監控指標(Prometheus 風格示意):

    luce_gpu_memory_used_bytes
    luce_gpu_cache_expert_count
    luce_gpu_cache_hit_ratio
    luce_router_expert_usage{expert_id="7"}
    luce_ram_usage_bytes
    luce_inference_latency_ms_bucket
    

    推薦實務做法:

    watch -n 1 nvidia-smi
    htop      # 監控 RAM / swap
    curl localhost:9100/metrics | grep gpu_cache
    

    要特別盯這幾件事:

    • RAM 使用率:接近 100% 時、或開始大量使用 swap,就要立刻調低 context 長度 / 並發數 / gpu_cache_experts;
    • luce_gpu_cache_hit_ratio:熱啟後應該穩定在高位(例如 >0.9),如果長期很低,代表 workload 太發散或 router 設定有問題;
    • per-expert usage:若少數 expert 的 usage 異常高,可能需要調整 balance_penalty 或減小 top_k。

    4. 在 RAG / Agent 流程中整合 MoE backend

    假設你已有一個典型的 Python RAG/Agent 服務,只要把原本的 dense LLaMA backend 換成 Luce Spark 的 HTTP endpoint 即可。

    簡易推理 client 範例:

    import requests
    
    LUCE_ENDPOINT = "http://localhost:8000/v1/chat/completions"
    
    def moe_chat(messages, temperature=0.7):
        payload = {
            "model": "qwen3.6-35b-a3b",
            "messages": messages,
            "temperature": temperature,
            # 對 MoE backend 特別有用的 hint
            "metadata": {
                "session_id": messages[0].get("session_id", "default"),
                "task_tag": "rag_qa"  # 可幫助 router 收斂某些專家
            }
        }
        r = requests.post(LUCE_ENDPOINT, json=payload, timeout=60)
        r.raise_for_status()
        return r.json()["choices"][0]["message"]["content"]
    
    # RAG pipeline 中直接替換這個 call
    answer = moe_chat([
        {"role": "user", "content": "根據上面的文件,說明 Luce Spark 的快取機制。"}
    ])
    

    幾個整合上的實務建議:

    • RAG 上下文長度:在 16GB 上使用 35B MoE,要注意 長 context + 大 batch 會同時吃掉 GPU RAM(KV cache)與系統 RAM(experts);
    • Agent 多工具呼叫:同一個 session 建議重用 session_id,讓路由器能對此類對話學出穩定的 expert set;
    • 混合架構:可以保留原本的 7B dense 作為 high-throughput worker,Luce Spark 35B MoE 只接「需要高品質回答」的請求。

    建議與注意事項:哪些專案值得換?

    1. 適合 / 不適合的 workload

    適合:

    • 本地 chatbot / Agent / RAG QA,以互動體驗為主;
    • 中小團隊、個人開發者,只有 1 張 12–16GB GPU,但想提升模型品質;
    • 對 tail latency 有一定容忍度,但不能接受 offload 帶來的「整體都變慢」。

    不適合:

    • 大規模 批次生成 / 資料標註 / 雙塔 embedding 推理;
    • 延遲要求極端嚴格,且流量型態非常 diverse 的線上服務;
    • RAM 不足(<32GB)或機器經常跑其他吃 RAM 的服務。

    2. 常見踩坑 & 規避方式

    1. 冷啟時延遲抖動嚴重
    2. 現象:剛開機的前幾千 tokens,latency 波動明顯;
    3. 緩解:

      • 先用腳本做一輪「暖身推理」,覆蓋幾個主力場景:
        bash
        python warmup.py --endpoint http://localhost:8000
      • 調整 warmup_tokens,在熱身期間減少 aggressive eviction;
      • 持久化 router_profile_path,重啟時載入。
    4. RAM 不足導致 swap,整體卡死

    5. 現象:nvidia-smi 看起來 GPU 利用率不高,但系統整體很慢;
    6. 緩解:

      • 嚴格限制 最大並發 / 每請求 context 長度;
      • 減少 gpu_cache_experts,讓單次 active experts 集合縮小;
      • 監控 swap 使用,一旦 swap 大於幾百 MB,就要降載或升級 RAM。
    7. 路由分佈不均,少數 experts 過載

    8. 現象:某些 expert usage 長期偏高,GPU cache 命中率不穩;
    9. 緩解:

      • 調升 balance_penalty 或引入 temperature scaling,讓路由更分散;
      • 檢查是否某類請求 pattern 過於集中(例如只有單一業務場景),必要時拆成不同服務。
    10. 誤以為可以完全替代 dense backend

    11. 建議:
      • 對於批量任務,仍保留 dense LLaMA 類模型 作為 batch worker;
      • 將 Luce Spark 定位成 「少量高價值請求」的 premium backend。

    💡 關鍵: Luce Spark 適合作為高品質旁路 backend,而不是全面取代所有 dense 模型的通用推理引擎。


    3. 是否值得遷移:一個簡單的決策準則

    可以用這三個問題評估:

    1. 你的主要 workload 是人機互動(chat/Agent/RAG)嗎?
    2. 你的機器 RAM 至少有 48GB,可以給模型用 32GB 以上嗎?
    3. 你願意接受前幾分鐘的熱身時間,以及偶發的尾延遲尖峰嗎?

    如果 答案至少有兩個是「是」,那麼把現有 dense LLaMA backend 加一個 Luce Spark 35B MoE sidecar,作為高品質路徑,是非常值得嘗試的升級。


    總結:Luce Spark 用 bounded GPU cache + 自我調整路由,把傳統 offload 的延遲稅轉化成「可控的少量 RAM↔GPU 交換」,讓 16GB GPU 也能實用地跑 35B MoE。對已經有 LLM backend 的團隊,最實際的做法不是「全部換掉」,而是把它當成一個 高品質 MoE 旁路,專門處理那些你不想交給 7B/8B dense 的關鍵請求。

    🚀 你現在可以做的事

    • 在你的 12–16GB GPU 機器上,仿照文中的 CLI 與 YAML,啟一個 qwen3.6-35b-a3b 的 Luce Spark 測試服務
    • 把現有 RAG/Agent 專案中的 dense backend 呼叫,替換成文中的 moe_chat() HTTP client,在部分流量上 A/B 測試效果
    • 使用 nvidia-smi、htop 與 Prometheus 指標,實際觀察 gpu_cache_hit_ratio、RAM 使用與尾延遲,調整 gpu_cache_experts 與 warmup_tokens 等參數
  • 把整個 Google 變成你的 AI Agent

    把整個 Google 變成你的 AI Agent

    📌 本文重點

    • google/skills 是 Google 產品專用的 AI Agent 工具箱
    • 透過現成 skills,LLM 可直接操作 Gmail / Calendar / Drive
    • 幾十行 Python 就能做出實用的 Workspace 自動化 Agent
    • 重視權限、安全與流程設計,才能放心在公司環境使用

    用一句話說清楚:google/skills 是一個專門替 Google 產品包好的「AI Agent 工具箱」,讓 LLM 不只會聊天,還能直接幫你操作 Gmail、Calendar、Drive 等服務。

    專案連結:https://github.com/google/skills


    google/skills 是什麼?可以幹嘛?

    用開發者的語言講:

    • 這是一組 Python 套件 + 一堆已實作好的「工具(skills)」
    • 每個 skill 就是一個可被 LLM 呼叫的函式,背後已幫你處理好 Google API 認證、資料結構、錯誤處理
    • 你只要把這些 skills 接到你熟悉的 Agent 框架(或自己寫個 loop),LLM 就能:
    • 在 Gmail 搜尋、讀取、回覆郵件
    • 在 Google Calendar 建立、更新、刪除行程
    • 從 Google Drive 找檔案、讀內容
    • 以及其他 Google 產品(例如 Docs / Sheets / Tasks 等)

    💡 關鍵: 把繁瑣的 Google API 細節封裝成 skills,讓你專注在設計 Agent 流程,而不是處理認證與資料結構。

    目前常見支援的產品與典型技能

    以 GitHub 專案內容與官方範例為主,目前重點集中在 Workspace 產品:

    • Gmail:搜尋郵件、讀取內容、標記已讀、建立草稿、送出郵件
    • Calendar:建立事件、更新時間/地點、取消會議、查詢空檔
    • Drive:列出檔案、搜尋、下載內容、讀取檔案文字(搭配 API 或其他工具)
    • Tasks / Docs / Sheets:視版本與模組更新擴充,作為實驗性 skills 提供

    你可以把它想成:「Google 幫你寫好一堆『LLM 可安全使用的 Google API wrapper』,你只要負責接到自己的 Agent。」


    核心功能:讓 LLM 真的「動手做事」

    下面用三個代表性技能,拆開來看它怎麼組成一條完整工作流。

    1. Gmail:搜尋 + 回覆郵件

    能做的事

    • 根據條件(發信人、標題關鍵字、時間)搜尋郵件
    • 讀取郵件主旨、內容、附件資訊
    • 由 LLM 生成人性化回覆,再用 skill 建草稿或直接寄出

    你可以怎麼用

    • 自動整理每日「待回覆」郵件清單
    • 給 Agent 一句自然語言指令:
    • 「幫我找這週所有含『報價』的客戶信,產出一封統一回覆草稿」

    2. Calendar:建立 / 修改行程

    能做的事

    • 建立新事件(時間、地點、參與者、線上會議)
    • 更新時間或加入備註
    • 查詢某段時間的空檔

    你可以怎麼用

    • 讓 LLM 從郵件裡抓出「時間 + 地點 + 主題」,自動變成 Calendar 事件
    • 用一句話:
    • 「把明天 3–5 點標成『專注工作』,不要排會議」

    3. Drive:從檔案抓資料

    能做的事

    • 依檔名、類型、擁有者搜尋檔案
    • 下載或讀取檔案(再交給 LLM 摘要)

    你可以怎麼用

    • 找到昨天產出的報表,請 LLM 摘要要點後寄給主管
    • 自動從會議紀錄整理 action items,寫回 Google Docs

    把它們串起來:一條完整工作流範例

    例子:自動從郵件抓會議資訊 → 建行程 → 建備忘錄

    1. Agent 用 Gmail skill 搜尋主題含「Meeting」「邀請」的未讀信
    2. LLM 解析郵件內容,抽出:會議主題、時間、地點、參與者
    3. 用 Calendar skill 建立事件,寫入摘要與會議連結
    4. 用 Drive/Docs skill 建一份「Meeting Notes」文件,寫入議程、預先問題

    你只要負責描述「整體目標」,LLM 會自己決定何時呼叫哪個 skill。你的程式碼變得像是在描述流程,而不是在寫一堆 API 呼叫細節。

    💡 關鍵: 一旦 workflow 串起來,同一套 skills 可以重複組裝出不同的自動化場景,大幅降低開發新 Agent 的成本。


    實戰場景:把散落在 Workspace 的動作串起來

    下面是幾個可以立即實作的場景,每一個都對應到你可以「今天就試做」的腳本。

    1. 個人行程助理

    需求:每天早上想知道今天有哪些會議、重要信件、待辦。

    可以怎麼做

    • Gmail:抓「星號」或加標籤的關鍵郵件
    • Calendar:列出今天所有會議與空檔
    • Tasks / Drive:列出今日到期的任務與文件
    • LLM 整理成一封「每日簡報」,寄到 Gmail 或 Slack

    👉 可行動:用本文後面的「每日早上報告 Agent」最小範例修改即可。

    2. 客服工單整理

    需求:客服信都在 Gmail,手工整理太慢。

    技能組合

    • Gmail:抓取特定 label(例如 support)的所有新信
    • LLM:
    • 自動分類(bug、退款、帳號問題)
    • 抽出關鍵欄位(客戶、產品、影響範圍)
    • Drive/Sheets skill:寫入 Google 試算表,讓團隊追蹤

    3. 銷售線索追蹤

    需求:商務開發信散落在 Gmail、會議安排在 Calendar、紀錄在 Drive。

    技能組合

    • Gmail:搜尋含「報價」「demo」關鍵字的信
    • Calendar:對應已有 / 尚未安排會議的線索
    • Drive:讀取對應的提案文件
    • LLM:產出「Sales pipeline 摘要」,再寄給業務團隊

    4. 團隊報表自動彙總

    需求:每週要整理多份 Google Sheets / Docs 的數據與摘要。

    技能組合

    • Drive:搜尋指定資料夾裡的所有報表
    • Sheets/Docs skill:抓出指定欄位/段落
    • LLM:彙整成一份「本週關鍵指標 + 亮點 + 風險」
    • Gmail:寄給管理層

    每個場景本質上都是:用 skills 拉資料 → LLM 處理 → 再用 skills 寫回 Google 生態。

    💡 關鍵: 只要 Workspace 流程是「讀資料 → 分類/摘要 → 回寫」,幾乎都能用同一套模式快速自動化。


    怎麼開始:從零到一的小 Agent(Python)

    這段寫給已經會基本 Python 的讀者。目標是做一個:

    「每日早上 9 點,整理今天的會議與重要郵件,寄一封報告給自己」

    步驟一:安裝套件與專案結構

    pip install google-skills openai  # 或你要用的 LLM 客戶端
    

    一個最小專案結構可以是:

    project/
      main.py          # 主程式,Agent 邏輯
      skills_config.py # Google skills 初始化
      .env             # 儲存 API Key 等環境變數
    

    步驟二:設定 Google API 憑證與權限

    1. 前往 https://console.cloud.google.com/
    2. 建立專案,啟用:
    3. Gmail API
    4. Calendar API
    5. (若需 Drive,就再開啟 Drive API)
    6. 建立 OAuth 用戶端 / Service Account 憑證
    7. 下載憑證 JSON,放進你的專案中,路徑寫在環境變數(例如 GOOGLE_APPLICATION_CREDENTIALS)

    google/skills 會讀這些設定,幫你處理 OAuth 流程。第一次執行會要你開瀏覽器認證,通過後就可以長期使用。

    步驟三:初始化 skills

    # skills_config.py
    from google.skills import GmailSkill, CalendarSkill
    
    gmail_skill = GmailSkill(scopes=[
        "https://www.googleapis.com/auth/gmail.readonly",
        "https://www.googleapis.com/auth/gmail.send",
    ])
    
    calendar_skill = CalendarSkill(scopes=[
        "https://www.googleapis.com/auth/calendar",
    ])
    
    TOOLS = {
        "gmail": gmail_skill,
        "calendar": calendar_skill,
    }
    

    (實際類名與參數以官方 GitHub 為準,這裡是示意寫法。)

    步驟四:寫一個最小「每日報告」 Agent

    下面示意一個 純 Python + LLM + skills 的簡易 loop:

    # main.py
    import datetime as dt
    from skills_config import TOOLS
    from openai import OpenAI
    
    client = OpenAI()
    
    
    def get_today_summary():
        today = dt.date.today().isoformat()
    
        # 1) 用 Gmail skill 抓今天重要信件(實際用法依官方 API)
        important_emails = TOOLS["gmail"].search_messages(
            query="label:STARRED newer_than:1d"
        )
    
        # 2) 用 Calendar skill 抓今天所有事件
        events = TOOLS["calendar"].list_events(
            time_min=today + "T00:00:00Z",
            time_max=today + "T23:59:59Z",
        )
    
        prompt = f"""
    你是一個助理,請用條列整理以下資訊:
    1. 今日重要郵件(寄件人 + 主題)
    2. 今日會議(時間 + 標題)
    
    重要郵件:{important_emails}
    今日行程:{events}
    """
    
        resp = client.chat.completions.create(
            model="gpt-4o-mini",  # 或你使用的其他 LLM
            messages=[{"role": "user", "content": prompt}],
        )
        return resp.choices[0].message.content
    
    
    def send_daily_report():
        summary = get_today_summary()
        TOOLS["gmail"].send_message(
            to="your_email@example.com",
            subject="今日工作總覽",
            body=summary,
        )
    
    
    if __name__ == "__main__":
        send_daily_report()
    

    接下來只要用 crontab 或任一排程工具,每天早上 9 點跑一次 python main.py,你就有一個真正會「用 Gmail + Calendar 幫你工作」的小 Agent 了。


    延伸玩法:接到 LangGraph / MCP / 自建 loop

    google/skills 本身只是一組工具,你可以自由接到任何 Agent 框架。

    常見接法比較

    名稱 核心功能 免費方案 適合誰
    LangGraph 圖形化定義 Agent workflow、狀態機 開源 要做複雜流程 / 多工具協作
    MCP 標準化「工具伺服器」協議 規格開源 想讓多個模型共用同一組工具
    Simple loop(自建) while-loop + tool call + LLM 只要有 LLM 即可 想快速測試、腳本導向

    怎麼接 google/skills?

    • LangGraph:把 Gmail/Calendar skill 包成「tool node」,用 graph 描繪整條流程(例如:先讀 mail → 判斷 → 建行程)。
    • MCP:把 google/skills 包成 MCP 工具伺服器,就像 Reddit 上有人把產品目錄接到 Claude 一樣,任何支援 MCP 的 Agent 都能呼叫這組 Google 工具。
    • 自建 loop:如前面的 send_daily_report(),自己在程式裡控制什麼時候 call 哪個 skill。

    實務注意事項:安全、權限與 rate limit

    在公司環境用 google/skills,這幾點非常重要:

    1. 最小權限原則:
    2. 只開啟必要的 scopes,例如只讀 Gmail 就不要給 send 權限
    3. 針對不同 Agent 建不同憑證,避免權限過大
    4. 審計與日誌:
    5. 記錄每次工具呼叫(誰、什麼時候、對哪個帳號)
    6. 公司內部可用 SIEM / 日誌系統統一管理
    7. Rate limit 與配額:
    8. Google API 有配額,批次任務要加上 sleep / retry
    9. 測試環境與正式環境要分開憑證,避免測試爆掉正式配額
    10. LLM 安全邏輯:
    11. 對「寫入」類操作(寄信、刪除事件)加上確認步驟
    12. 可用 rule-based filter:例如禁止刪除某些標籤信件

    總結:把「會聊天的 LLM」變成「會用 Google 的助理」

    如果你已經每天活在 Gmail、Calendar、Drive 裡,google/skills 的價值很單純:

    • 你不用再對著 Google API 文件苦讀,只要調用現成的 skills
    • LLM 能真的幫你「按按鈕、拉資料、寫回去」,而不是只給你建議
    • 從個人行程助理,到團隊報表自動化,都可以在幾十行 Python 內完成第一個版本

    先從一個小腳本開始:「每日早上發報告」,跑通一次之後,你就會自然開始想把更多 Workspace 工作交給你的 Agent。

    🚀 你現在可以做的事

    • 打開 google/skills GitHub 專案,瀏覽支援的 skills 清單與範例程式
    • 依照文中的「每日報告 Agent」範例,在本機建立一個最小 Python 專案跑通一次
    • 在你的 Workspace 工作流中,挑一個「讀資料 → 整理 → 寄出」流程,試著用 google/skills + LLM 自動化它
  • 一句話就能寫的 iPhone 自動化

    一句話就能寫的 iPhone 自動化

    📌 本文重點

    • 新版捷徑可用自然語言生成跨 App 自動化
    • Siri in Camera 支援拍帳單自動分帳與付款
    • Safari、Photos 等 AI 功能都能串成工作流程

    講一句話,iPhone 幫你把一連串跨 App 的操作變成自動化流程,這就是新版 捷徑(Shortcuts)AI 工作流生成功能 + Siri AI 要解決的事。

    參考:Shortcuts 新功能報導(TechCrunch)▶︎ https://techcrunch.com/2026/06/08/apple-will-let-you-build-workflows-using-ai-in-its-new-shortcuts-app/


    核心功能:現在「講需求」就能生出捷徑

    1. 用自然語言生成捷徑:一句話變一條 workflow

    以前做捷徑,要一個一個 Action 拖拉;現在你可以直接在 Shortcuts 裡打字或跟 Siri 說:

    • 「幫我整理今天拍的照片到『今日精選』相簿,然後把 3 張最好看的用 Reframe 調整成適合 IG 的比例。」
    • 「以後 Gmail 收到標題含『發票』的信,把附件 PDF 存到 iCloud Drive 的『發票/2026』資料夾。」
    • 「每天晚上 10 點,把今天新增的照片做成 5 張圖文日記草稿存在備忘錄。」

    系統會做的事(你實際會看到):

    • 自動幫你建立一條捷徑,裡面已經串好「取得照片 → 篩選 → Photos Reframe → 存到相簿」等步驟。
    • 針對 Email/雲端檔案,會自動找對應的 Mail、檔案 App Action 串起來。
    • 你可以再手動微調條件,例如日期、相簿名稱、檔案夾位置。

    💡 關鍵: 只要一句自然語言描述,就能自動拆解成完整的捷徑工作流程,大幅降低設定門檻。

    可以馬上試的三句話(打進捷徑的 AI 提示框):

    • 「每天早上 8 點總結昨天的重要 email,用中文整理成 3 點重點,傳到我的備忘錄。」
    • 「下載我 Gmail 中今天所有附件,存到 iCloud Drive/工作/今天日期。」
    • 「每週一早上 9 點,把行事曆上本週的會議整理成列表,寄給自己。」

    行動建議:

    • 打開 捷徑 App → 新增 → 使用 AI 建立工作流程(以實際 iOS 介面為準),直接把上面其中一句貼進去,看它怎麼幫你拆解步驟。

    2. Siri in Camera 分帳:拍帳單 → 點菜 → 自動算錢

    這是新 Siri AI 最「有感」的實戰功能之一,官方示範在這裡:https://techcrunch.com/2026/06/08/apple-is-fixing-the-headache-of-splitting-the-bill-with-its-new-siri-in-camera-feature/

    流程拆解成你可以照做的步驟:

    1. 先準備
    2. 更新到支援 Siri AI 的 iOS 版本(見文末「怎麼開始」小節)。
    3. 在「設定 → 錢包與 Apple Pay」裡開好 Apple Cash,綁定帳戶或信用卡。

    4. 啟用 Siri in Camera

    5. 打開系統「設定」→ Siri → 確認有開啟「Siri in Camera」或類似選項(名稱以正式版為準)。

    6. 實際分帳操作

    7. 在餐廳結帳時:

      • 打開 相機 App,對準紙本帳單。
      • 長按畫面或點右下角出現的 Siri 圖示,啟動「Siri in Camera」。
      • 螢幕會標示出每一項餐點與金額,你:
      • 點選自己點的菜
      • 確認要不要平均分服務費、小費等
      • Siri 算出你應付的金額後,會跳出「使用 Apple Cash 支付給 XXX」的選單。
      • 按一下就完成付款。
    8. 進階:配合捷徑做「分帳記帳」

    9. 你可以另外建立一條捷徑:「當我用 Apple Cash 付錢給某位朋友時,自動在備忘錄『聚餐記錄』裡新增一條記錄(日期、金額、對象)。」
    10. 作法:
      • 在捷徑中搜尋 Apple Cash 相關 Action(或直接用自然語言生成:
      • 「當我用 Apple Cash 付款時,幫我記錄一條支出到備忘錄。」)

    行動建議:

    • 下次聚餐前先把 Apple Cash 設好,實際用 Siri in Camera 分一次帳,回家再用捷徑補上「記帳自動化」。

    💡 關鍵: Siri in Camera 把「看帳單 → 算錢 → 轉帳」這串麻煩流程壓縮成拍一次照、按一次確認。


    3. 其他 AI 功能:Safari 補字、照片 Reframe,都能變成 workflow 的一段

    根據 TechCrunch 報導,Safari、捷徑、密碼等系統 App 都接上了 AI:https://techcrunch.com/2026/06/08/apple-just-taught-your-iphone-to-finish-your-sentences-your-photos-and-your-workflows/

    這裡挑兩個最容易跟捷徑串在一起的:

    Safari:自動補文字 & 生成草稿

    Safari 內文輸入框(例如表單、留言)會有 AI 提示,可以:

    • 根據你已輸入的開頭,自動補完句子。
    • 根據網頁內容,產生回覆草稿(例如回客服信、填意見回饋)。

    怎麼跟捷徑配合?

    • 建一條捷徑:「當我在分享選單裡選擇『AI 回覆草稿』時,
      1)把目前網頁內容摘要 → 2)用 Siri AI 生成一段 100 字內中文回覆 → 3)複製到剪貼簿。」
    • 用自然語言下指令:
    • 「建立一個捷徑,從 Safari 分享頁取得文章內容,幫我寫一段禮貌回覆放到剪貼簿。」

    💡 關鍵: 把 Safari AI 補字和捷徑結合,可一鍵從網頁生成短版回覆,減少重複打字。

    Photos Reframe:一鍵重構照片構圖

    Photos 多了 Reframe,可以:

    • 把橫幅照片重構成直幅,重抓主體構圖。
    • 幫照片轉成適合 IG、限動等比例。

    搭配捷徑的用法:

    • 「選 10 張今天新拍的照片,用 Reframe 變成 9:16 比例,存到相簿『IG 候選』。」
    • 這句直接丟給 Shortcuts 的 AI,就會幫你串好:取得今天照片 → Reframe → 存到指定相簿。

    小工具一覽:哪個負責哪件事?

    資訊綜合自 TechCrunch、The Verge、Wired 報導:Siri AI、Shortcuts AI、Siri App

    名稱 核心功能 免費方案 適合誰
    捷徑(Shortcuts)AI 工作流 用自然語言生成跨 App 自動化流程 內建免費 想把重複操作變自動化的 iPhone 使用者
    Siri AI 新版 Siri,可讀螢幕、跨 App 操作、個人化互動 內建免費 習慣用語音/文字跟手機互動、要「講需求」就完成的人
    Siri in Camera 對著帳單拍照就能 AI 分帳 + Apple Cash 支付 內建免費(支付依銀行手續費) 常聚餐分帳、懶得算錢的人

    適合誰用?三種典型使用者

    1. 每天都在重複一樣操作的上班族
    2. 下班打卡 → 開導航回家 → 播放固定 Podcast → 開啟家裡的 HomeKit 燈具。
    3. 行動:把這句完整話丟給捷徑 AI,讓它幫你把這條「下班儀式」自動化。

    4. 拍很多照片、想要整理成內容的人

    5. 每天拍一堆照片,但懶得整理、寫日記、挑圖。
    6. 行動:做一條「晚上 10 點整理照片+日記草稿」的捷徑,讓 AI 每天幫你先挑、先寫,再來人工微調。

    7. 會議、課程超多的知識工作者 / 學生

    8. 常忘記開勿擾、錄音,或者會後才在找資料。
    9. 行動:用自然語言生一條「會議前 10 分鐘自動開勿擾+錄音」的捷徑,配合行事曆事件觸發。

    怎麼開始:版本需求、入口在哪裡?

    1. 需要哪個 iOS 版本?

    以目前公開資訊,這些功能會隨 新一代 Apple Intelligence / Siri AI 更新 推出:

    • 確認方式:
    • 到「設定 → 一般 → 軟體更新」看是否有標示 Siri AI / Apple Intelligence 相關更新。
    • 通常會需要最新主版本(例如 iOS 20 這級別),以及較新的 iPhone 型號。

    2. 哪裡打開新版 Shortcuts 與 Siri App?

    • 捷徑 Shortcuts:
    • 已內建在 iOS,找不到就到 App Store 搜「Shortcuts」。
    • 開啟後,點右上角「+」→ 留意有沒有「用 AI 建立捷徑」或類似按鈕。
    • Siri App(獨立版):
    • 更新後,主畫面會多一個 Siri App 圖示。也可以在 App 資料庫搜尋「Siri」。
    • 開啟後可以直接用文字或語音下指令,而不一定要喊「嘿 Siri」。

    推薦先練的 3 條小自動化(附自然語言模板)

    直接把以下句子丟給捷徑的 AI 入口就能開始:

    1. 下班自動開導航回家 + 播放 Podcast

    「當我離開公司地點時,自動在 Google Maps(或 Apple 地圖)開啟回家的導航,並在 Spotify(或 Podcast App)播放我最新一集的路上要聽的節目。」

    微調建議:

    • 把「公司地點」換成具體地址或地標。
    • 把播放 App 換成你實際使用的。

    2. 每晚 10 點整理今天照片+輸出日記

    「每天晚上 10 點,把今天新增的相片挑 10 張代表性的,用簡短文字說明今天發生什麼事,整理成一則備忘錄日記。」

    AI 會:

    • 自動拉出今天照片
    • 生成簡短摘要文字
    • 存成一則新備忘錄

    3. 會議開始前 10 分鐘自動開勿擾+錄音

    「當行事曆上有標成『會議』或『Meeting』的事件時,在開始前 10 分鐘自動開啟勿擾模式,並在會議時間內用語音備忘錄錄音。」

    你可以再加:會後寄一封含錄音連結的 Email 給自己。


    思考模板:如何把手動操作,轉成一句自然語言需求?

    只要照這四格填空,就能寫出一條適合丟給捷徑 AI 的句子:

    「在_情境 / 時間_,幫我自動_動作 A_,接著_動作 B_,最後把結果存到_位置 / App_。」

    幾個範例:

    • 「在每天早上 8 點,幫我自動把今天的行事曆整理成文字摘要,接著傳到 Slack 的 #daily 頻道。」
    • 「當我連上公司 Wi‑Fi,幫我自動開啟勿擾模式,接著打開公司 VPN App。」
    • 「當我在Safari 分享一篇文章時,幫我自動生成 3 點中文重點,最後把結果存到Notion 的『閱讀筆記』資料庫。」

    你要做的,就是把自己每天重複做的動作,照這個模板說出來,然後丟給 Shortcuts 或 Siri AI 來「幫你寫程式」。


    🚀 你現在可以做的事

    • 到「設定 → 一般 → 軟體更新」確認是否已支援 Apple Intelligence / Siri AI,並完成更新
    • 打開捷徑 App,使用「用 AI 建立工作流程」,貼上文中任一自然語言範例實測一次
    • 在下一次聚餐前設定好 Apple Cash,實際用 Siri in Camera 完成一次拍照分帳+付款流程
  • Claude Code 供應鏈危機:AI 開發者太天真了

    Claude Code 供應鏈危機:AI 開發者太天真了

    📌 本文重點

    • AI coding agent 正在成為新攻擊面
    • 供應鏈攻擊已專門鎖定 AI 開發工具
    • AI 工具必須被當成高風險資安系統管理

    這次 Claude Code 事件真正可怕的地方,不是幾個 npm 套件被下毒,而是 AI coding agent 本身正在變成新的「攻擊面」。如果開發生態繼續只談效率、不談安全,下一個被入侵的,不會只是開發機器,而是整個企業的內部資料與用戶隱私。AI 工具與開發流程,必須被當成高風險資安系統,而不是玩具。


    一場「從 Red Hat 憑證到你的 Claude Code」的蠕蟲式攻擊

    先把時間線拉清楚:

    • 攻擊者先取得一名 Red Hat 員工的 GitHub 憑證,直接往 @redhat-cloud-services 旗下 32 個 npm 套件下手,這些套件週下載量約 11.7 萬次。
    • 由於 CI/CD 已與 npm 發布流程自動串接,攻擊者等於「合法地」用 Red Hat 的身份,把惡意程式碼發佈給整個開發者社群——這就是典型的 供應鏈攻擊。
    • 惡意程式碼安裝後,並不只藏在 node_modules,而是主動修改你的開發環境:
    • 植入 Claude Code 啟動設定
    • 修改 VS Code 專案設定
    • 之後 只要你打開 VS Code 或 Claude Code,惡意程式就會自動執行,
    • 靜默收集機器上的所有憑證(token、SSH key、雲端憑證……)
    • 傳回攻擊者伺服器
    • 更糟的是,就算你卸載 npm 套件,惡意碼仍活在 IDE 設定裡,持續運作
    • 若你試圖「先撤 token 再清 malware」,某些版本還會觸發毀滅性 payload:刪除整個 home 目錄並覆寫,降低復原可能性。
    • 幾天後,研究者在 npm 上又發現第二波、更高明的變種,包裝更隱密、具蠕蟲特性,持續透過自動安裝與開發工具擴散。

    💡 關鍵: 一組被盜用的 GitHub 憑證,串起了從 CI/CD 到 IDE、再到 AI 助手設定的整條自動化惡意供應鏈。

    關鍵不是一個 Red Hat 帳號被偷,而是:攻擊鏈一路打穿「憑證 → CI/CD → 套件 → IDE → AI 助手設定」,形成一條完全自動化的惡意供應鏈。

    這條鏈的最後一站,偏偏就是你以為「只是在幫你寫程式」的 Claude Code。


    AI coding agent 追求效率,卻默默放大了供應鏈風險

    這起 Red Hat / Claude Code 事件,和最近 Microsoft 開源套件被植入 credential stealer 的攻擊,實際上指向同一個趨勢:攻擊者已開始專門設計「針對 AI coding agent」的惡意程式。

    在 Microsoft 的案例中:

    • 73 個微軟持有的加簽開源套件被植入進階憑證竊取程式碼。
    • 惡意程式碼會在開發者透過 AI coding agent 開啟這些套件時被觸發——研究者直接點名這是針對 AI agent 的攻擊;AI 會幫你讀檔、跑 script、補依賴,攻擊者只要等 AI「乖乖照做」。
    • 這些套件最初是被 GitHub 自動系統下架,但平台一開始只用「違反服務條款」這種模糊說法,沒有明講「這是惡意攻擊、請假設你已被入侵」,讓不少開發者完全沒有警覺。

    把兩起事件放在一起看,可以看到幾個結構性問題:

    1. AI agent 天然信任依賴與腳本

    AI coding agent 的賣點,是幫你:

    • 自動安裝缺的套件
    • 自動修改設定
    • 自動產生/執行 script

    這看起來是「開發效率神器」,但在攻擊者眼中,這是一台可以遠端操控的自動化執行引擎。惡意套件只要被 AI 讀到、被 agent 視為「為了專案正常運作需要執行的 code」,攻擊就啟動了。

    2. DevSecOps 思維還停留在「人手動操作」時代

    大多數安全流程是為了人設計的:

    • 「請開發者檢查 pull request」
    • 「請手動審視依賴變更」
    • 「請不要執行不明腳本」

    但今天的問題是:AI 會幫你點掉所有這些紅燈。在 Claude Code 事件裡,惡意程式碼躲到 VS Code 與 Claude 設定檔中,只要開啟工作區或啟動 AI 助手,就會自動跑。

    3. 供應鏈攻擊變成「AI 時代的新常態」,不是個案

    • Red Hat / Claude Code:利用 GitHub 憑證 + CI/CD + IDE/AI 設定,形成蠕蟲式擴散。
    • Microsoft 套件:利用 加簽開源套件 + GitHub 生態 + AI coding agent 的自動操作,鎖定開發者憑證。

    它們都不是「某個工程師不小心點錯」這種等級,而是系統性利用 AI 進入開發供應鏈的空窗期。

    💡 關鍵: 供應鏈攻擊已從零星事件,演變成專門針對 AI 開發流程設計的「新常態」風險。

    真正的問題是:AI 工具商與生態平台,把自己當成「效率工具提供者」,沒有把自己當成「新一代 DevSecOps 基礎設施」來設計。


    這不是 Prompt Injection 問題,是「Agent 執行權限」問題

    今天的主角已經不是 prompt injection。攻擊者要的,不是讓模型講錯話,而是讓 agent 替他「按下執行鍵」。

    在 MCP(Model Context Protocol)與各種 Agent 框架被廣泛實驗的同時,安全研究者早就示警:

    • 當 AI 代理有「讀檔、寫檔、跑指令、打 API」等多重能力時,它就變成一個新的 高權限執行環境。
    • 文章《Red Teaming MCP Servers: 24 Attack Payloads and the Blueprint for Agentic Defense-in-Depth》做了 24 種紅隊測試,證明:
    • 單靠輸入過濾完全不夠
    • 必須從 輸入 → 代理決策 → 執行層 → 系統權限 做多層防禦

    再把這跟機器身份與憑證管理放在一起看:

    • 如《Your Secrets Are Probably Leaking》指出:大多數團隊只強化「使用者登入安全」,卻讓 API key、token、CI 變數、雲端憑證到處亂飛,形成 credential sprawl。
    • 在 Claude Code 與 Microsoft 事件中,惡意碼收割的正是這一整片「第二身份平面」:
    • .env 裡的密鑰
    • CI/CD pipeline 的 token
    • Terraform state、K8s manifest 裡的憑證

    當 AI agent 同時掌握「程式碼執行能力」與「存取這些機器身份憑證」,它就成了攻擊者最想控制的跳板。

    現在的主流 AI IDE 插件,多半只談:「我們如何讓你寫程式更快」。
    很少有人認真回答:「這個 agent 在你的機器上,到底能做多可怕的事?誰在監控?誰能審計?誰負責出事時的鑑識?」

    💡 關鍵: AI agent 一旦擁有執行權限與憑證存取能力,就等同於新的「高權限使用者」,安全設計必須對齊這個等級。


    開發者與企業現在就該做的事:把 AI 當成高風險資安系統來管理

    這不是「選不選用 Claude Code 或某個特定工具」的問題,而是你要不要承認:AI coding agent 已經是你 DevOps 流程的一級資產,而不是附加小幫手。

    對不同角色,建議也不同——

    1. AI 工具商(OpenAI / Anthropic / 微軟 等)

    • 預設零信任執行模型:
    • 插件/Agent 若要寫檔、跑命令、裝套件,應有細粒度權限 prompt,而不是一鍵授權整個專案。
    • 對高風險操作提供 可審計的執行日誌,預設加密留存,方便事後鑑識。
    • 把安全能力產品化,而不是當白皮書宣傳:
    • 內建 惡意依賴檢測、憑證泄漏掃描,而不是交給第三方插件救火。
    • 對應 MCP / Agent 生態,提供官方的 安全測試 sandbox(類似 mcp-probe-agent)與紅隊工具。

    2. 生態平台(npm / GitHub / VS Code 市集)

    • 事件揭露要說人話:像這次 GitHub 只說「違反服務條款」是嚴重失職。遭下架的套件,必須清楚標註「已確認惡意,請假設憑證外洩並執行 incident response」。
    • 加強供應鏈風險信號:
    • 對於高權限組織(如 Red Hat、Microsoft)發布的套件變更,提供額外的 異常行為檢測與人工審核。
    • 在 IDE / CLI 層面,當套件被標記惡意時,主動警示並提供修復腳本,而不是只在網頁上放通知。

    3. 企業開發與安全團隊

    • 把 AI 開發工具納入 DevSecOps 範圍,而不是當個人玩具:
    • 使用哪些 AI 插件、可開哪些權限,寫成政策並落地到 IAM / MDM 管理上。
    • 公司內部專案一律使用 企業控管的 AI 開發環境,禁止在個人亂裝的 VS Code 上操作敏感 repo。
    • 整頓「機器身份」與憑證管理:
    • 把 .env、CI variables、Terraform state、K8s yaml 裡的 secrets 全面盤點,導入 專業密鑰管理系統(如 Vault、Secrets Manager 等)。
    • 對應這次事件,預設所有受影響開發機器的 token 與 key 都已外洩,執行 rotate + log 監控。
    • 訓練團隊用「AI 安全威脅模型」思考:
    • 每導入一個新 AI 工具,都問三個問題:
      1. 它可以看到哪些 code / 資料?
      2. 它可以對我的環境做什麼?(讀/寫檔、跑指令、改 CI?)
      3. 一旦被接管,最大爆炸半徑是什麼?

    Claude Code 這次暴露的,不是單一產品的缺陷,而是整個產業對「AI 時代的 DevSecOps」普遍缺位。未來幾年,攻擊者會持續把 AI agent、CI/CD、開源套件、機器憑證串成一條條自動化攻擊鏈——而我們能做的,不是祈禱自己不要被點名,而是現在就把 AI 工具當成高風險系統,納入完整的安全設計、監控與治理。
    否則,AI 幫你省下的開發時間,很可能會全部補課在 incident response 上,而且還不一定補得回來。

    🚀 你現在可以做的事

    • 盤點並審視團隊現用的所有 AI 開發工具與 IDE 插件,標記其可存取的程式碼與憑證範圍
    • 在組織內導入或強化密鑰管理系統,將 .env、CI 變數等敏感資訊集中管控並定期輪替
    • 為團隊安排一場「AI + DevSecOps」安全工作坊,針對 AI agent 權限與供應鏈風險建立共同威脅模型