標籤: AI 工具

  • 用 Mellum2 排程你的 AI 工作流

    用 Mellum2 排程你的 AI 工作流

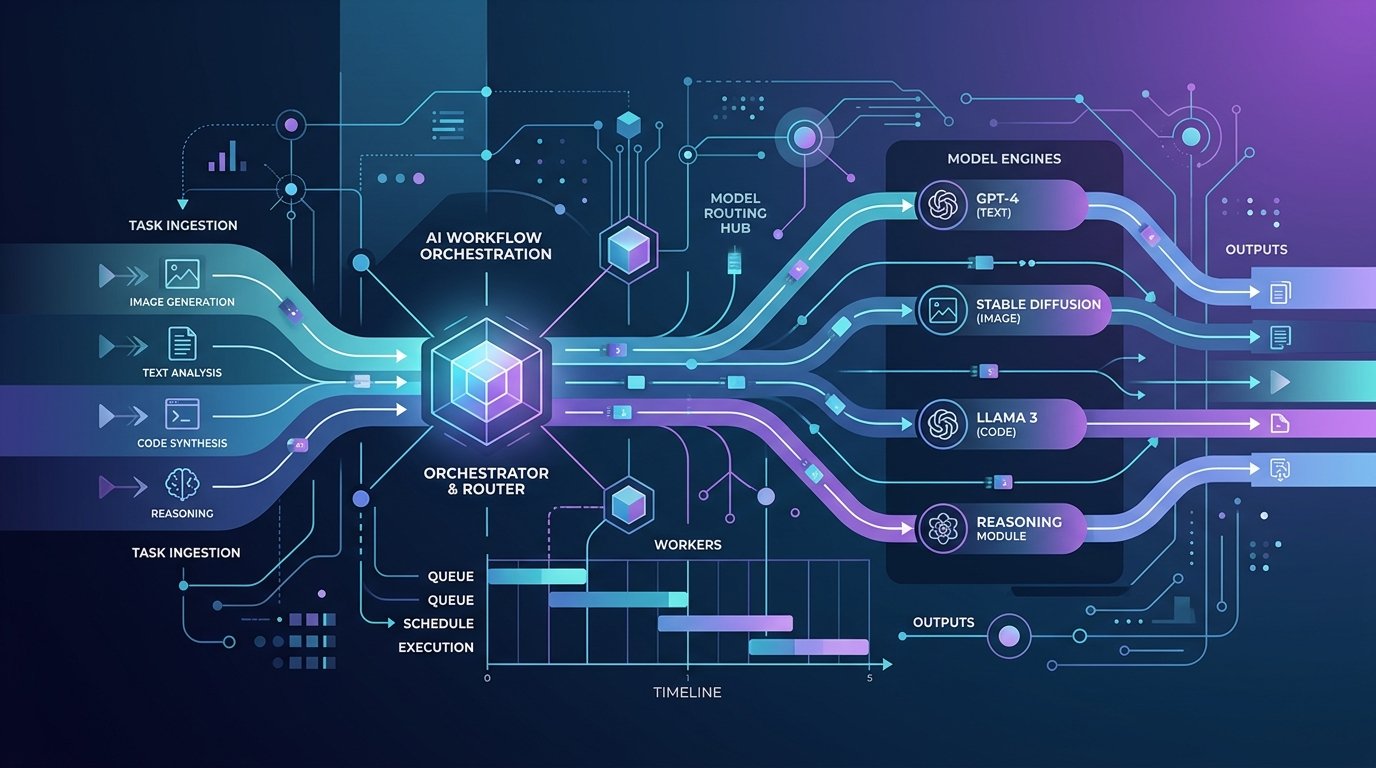
    一句話先說清楚:Mellum2 是一顆專門幫你「排班、調度」其他大模型和工具的小模型,用來做 routing、任務拆解與工具選擇,讓 AI 工作流更便宜、更穩定。

    📌 本文重點

    • Mellum2 是專門做「決策與調度」的小模型
    • 適合負責 routing、任務拆解和工具選擇
    • 能幫多模型、多工具的工作流壓成本、提穩定度
    • 很適合拿來做 AI agent 的中樞大腦

    官方介紹與原始碼:https://blog.jetbrains.com/ai/2026/06/mellum2-goes-open-source-a-fast-model-for-ai-workflows/


    核心功能:先讓 Mellum2 當你的「AI 排班主管」

    1. 低延遲的小模型,適合做決策層

    Mellum2 本身不是 GPT-4o 那種萬能助手,它更像是負責「決定下一步要幹嘛」的主管:

    • 模型體積小、推理快,適合放在整個 pipeline 的最前面或中間層
    • 每次呼叫成本低,很適合頻繁決策:用哪個工具?要不要再拆一步?該重試還是直接回覆?

    💡 關鍵: 把高頻率、邏輯性的「決定怎麼做」交給便宜小模型,昂貴大模型只負責「實際做」,能讓整體成本大幅下降。

    你可以怎麼用?

    • 把「判斷任務類型 → 選模型 → 選工具」這段邏輯,從你程式碼的 if-else 搬到 Mellum2
    • 所有複雜 workflow 的分支規則,盡量改成 prompt + Mellum2 來決定,減少硬寫規則

    2. 多步推理:讓它負責拆任務、串工具

    JetBrains 把 Mellum2 設計成適合多步推理(multi-step reasoning)的模型,也就是它擅長做:

    • 任務拆解:把「寫一份技術規格書」拆成「補資料 → 查 API → 產出草稿 → 校對」
    • 步驟規劃:決定每一步要用哪支工具或哪個 LLM
    • 狀態更新:根據上一個工具的輸出,動態調整下一步

    你可以怎麼用?

    • 把你現有的工具(爬網頁、查資料庫、呼叫商用 LLM)列成一張「工具清單」給 Mellum2
    • 請 Mellum2 每次都輸出「下一步要用的工具 + 工具參數」,你的程式只負責照做

    3. Routing + 工具選擇:讓 GPT、Claude、開源 LLM 都變成「插件」

    Mellum2 最實用的角色,就是做模型路由(model routing)和工具選擇(tool selection):

    • 你可以在後面接:GPT-4.1、Claude 3.7、Llama、Qwen 等
    • Mellum2 根據需求幫你選:「這題要便宜模型」還是「這題要高準確度」

    💡 關鍵: 當你同時使用多個 LLM 供應商時,用 Mellum2 做路由,可以在「品質不明顯下降」的前提下,讓大量請求自動落在較便宜的模型上。

    可以這樣設計一個簡單策略

    • 查資料類問題 → 用便宜/開源 LLM + 搜尋工具
    • 寫程式、寫長文 → 用 GPT-4.1 或 Claude 3.7
    • 簡單 Q&A → 用本地 LLM,節省 API 費用

    你的程式不用管細節,只要:

    1. 收到使用者請求
    2. 把請求 + 目前可用模型列表丟給 Mellum2
    3. 照 Mellum2 的輸出去呼叫對應模型

    適合誰用:三種典型場景

    1. 你在做「AI 助手」或 Agent 系統

    如果你在做:

    • 產品內建 AI 助手(客服、知識庫問答)
    • 自動化 Agent(幫你查資料、寫報告)

    問題通常會是:

    • 使用者問題差異很大,單一模型不是太貴就是太弱
    • 工具越加越多,判斷流程 if-else 爆炸

    Mellum2 能幫你:

    • 把「選模型、選工具、拆步驟」集中到一顆小模型管理
    • 你只要維護工具清單和觀察 Mellum2 的決策是否合理

    可以實作的行動:

    • 先挑三個最常用工具:RAG 搜尋、商用 LLM、本地 LLM
    • 寫一個 Mellum2 prompt,要求它根據需求選 1-3 個步驟完成任務

    2. 你有多個 LLM 供應商,要壓成本又要穩定

    典型狀況:

    • 公司已經有 OpenAI 帳號,也在測 Claude,還有自家的 vLLM 服務
    • 主管希望「多用便宜模型,但品質不能掉太多」

    Mellum2 的用法:

    • 給它模型清單:
    • gpt-4.1: 高成本、高品質
    • gpt-4o-mini: 中等品質、便宜
    • local-llama: 最便宜、品質較不穩
    • 附帶一些示例(few-shot),教 Mellum2 什麼情境選哪個

    💡 關鍵: 先在開發環境裡讓所有請求經過 Mellum2 路由,實際觀察不同任務落在昂貴與便宜模型的比例,再調整規則,比一開始就死寫策略安全得多。

    可以實作的行動:

    • 先在開發環境改成「所有請求都要經過 Mellum2 路由」
    • 觀察一週:不同任務下,商用 LLM 和本地 LLM 的占比、成本變化

    3. 你要做「穩定的 AI Pipeline」而不是單次聊天

    像是:

    • 每天自動爬資料 → 摘要 → 存進 Notion
    • 每次有 Pull Request → 產生 code review 建議

    這種 Pipeline 常見問題:

    • 某個 LLM 偶爾出錯,整條流程掛掉
    • 你需要 fallback 策略:失敗就換模型、換 prompt、換工具

    Mellum2 可以:

    • 監看每一步工具回傳結果(成功 / 失敗 / 異常訊息)
    • 根據結果決定下一步:
    • 重試同一步驟
    • 改用另外一個模型
    • 回報錯誤給人類

    可以實作的行動:

    • 把 Pipeline 的每一步都包成「工具」
    • 每一步的錯誤,也當作輸入回饋給 Mellum2,讓它決定接下來的補救策略

    怎麼開始:從安裝到最小可行範例

    以下流程以「你會用 Docker 或 Python,且已經有至少一個 LLM API(OpenAI / Anthropic / 本地 vLLM)」為前提。

    1. 安裝 Mellum2:Docker 或程式庫二選一

    先到官方部落格或 Repo:https://blog.jetbrains.com/ai/2026/06/mellum2-goes-open-source-a-fast-model-for-ai-workflows/

    選項 A:用 Docker 跑起 Mellum2 服務

    1. 安裝 Docker / Docker Compose
    2. 拉取 Mellum2 映像(以官方 README 為準,示意):

    bash
    docker pull jetbrains/mellum2:latest

    1. 啟動服務(假設開在 8000 port):

    bash
    docker run -p 8000:8000 jetbrains/mellum2:latest

    1. 用 curl 測試:

    bash
    curl -X POST http://localhost:8000/infer \
    -H "Content-Type: application/json" \
    -d '{"input": "你是任務規劃器,請幫我決定下一步要用什麼工具"}'

    適合: 想先用 HTTP API 串現有後端的人。

    選項 B:在程式裡直接呼叫 Mellum2

    如果官方有 Python 套件(假設為 mellum2):

    pip install mellum2
    

    簡單測試:

    from mellum2 import MellumClient
    
    client = MellumClient(base_url="http://localhost:8000")  # 或直接用雲端端點
    
    resp = client.infer("你是任務規劃器,收到任務後要輸出下一步計畫")
    print(resp)
    

    適合: 你準備把 Mellum2 深度嵌到自家服務裡。


    2. 示範:Mellum2 做 Router + 任務規劃的最小 workflow

    下面是一個最小可行例子:

    • 你有兩個底層 LLM:
    • gpt-4.1(高品質)
    • local-llama(便宜)
    • 有一個簡單工具:web_search(用來查網路)
    • 目標:收到使用者問題,由 Mellum2 決定:
    • 要不要先搜尋
    • 要用哪個模型產生最終答案

    Step 1:定義給 Mellum2 的「工具/模型清單」

    TOOLS = [
        {
            "name": "web_search",
            "type": "tool",
            "desc": "適合需要即時或最新資訊的問題,例如股票、新聞、價格。"
        },
    ]
    
    MODELS = [
        {
            "name": "gpt-4.1",
            "cost": "high",
            "quality": "best",
            "desc": "用在需要高準確度、長文、程式碼的回答。"
        },
        {
            "name": "local-llama",
            "cost": "low",
            "quality": "medium",
            "desc": "用在一般聊天、簡單問答。"
        }
    ]
    

    Step 2:設計 Mellum2 Prompt,請它輸出「計畫 JSON」

    SYSTEM_PROMPT = """
    你是 AI 工作流調度器,負責:
    1. 判斷使用者需求
    2. 決定是否要先使用工具
    3. 選擇要使用的底層 LLM
    
    請只輸出 JSON,不要多餘文字,格式:
    {
      "steps": [
        {"action": "tool" | "model", "name": "...", "input_from": "user" | "prev_result"}
      ]
    }
    
    可用工具:
    {tools}
    
    可用模型:
    {models}
    """.format(tools=TOOLS, models=MODELS)
    

    Step 3:呼叫 Mellum2,拿到決策後執行

    import json
    from mellum2 import MellumClient
    
    mellum = MellumClient(base_url="http://localhost:8000")
    
    user_query = "幫我分析最近 NVIDIA 股價的變化,順便預測未來一季可能走勢。"
    
    planning_prompt = SYSTEM_PROMPT + f"\n使用者問題:{user_query}"
    
    plan_resp = mellum.infer(planning_prompt)
    plan = json.loads(plan_resp["text"])  # 依實際回傳欄位調整
    
    result_cache = None
    for step in plan["steps"]:
        if step["action"] == "tool" and step["name"] == "web_search":
            query = user_query if step["input_from"] == "user" else result_cache
            result_cache = call_web_search(query)  # 這是你自己實作的搜尋功能
    
        if step["action"] == "model":
            model_name = step["name"]
            model_input = user_query if step["input_from"] == "user" else result_cache
            result_cache = call_llm(model_name, model_input)  # 依照名稱選擇 gpt / llama
    
    print("最終回答:", result_cache)
    

    這樣,你已經有了一個:

    • Mellum2 做「任務規劃 + 模型/工具選擇」
    • 後端只負責執行計畫的最小可行 workflow

    接下來要擴充,只要:

    • 在 TOOLS / MODELS 裡再加項目
    • 用 few-shot 例子微調 Mellum2 的決策邏輯

    Mellum2 在你的工具箱裡,扮演什麼角色?

    如果從「AI 工作流」角度看,目前常見的組合大致是:

    名稱 核心功能 免費方案 適合誰
    Mellum2 工作流調度、routing、任務拆解 開源可自架 想自己組 AI pipeline,需要細控成本與流程的人
    OpenAI GPT 高品質通用 LLM 有免費額度 需要高品質輸出、但不想自己訓練模型的人
    Claude / Sonnet 對話 & 程式能力強的商用 LLM 有試用 重度寫作、程式輔助、長上下文需求
    本地 LLM(Llama/Qwen) 私有部署、低成本推理 視模型而定 在意隱私或有大批量推理需求的團隊

    Mellum2 並不是另一個「跟你聊天的模型」,而是用來把上面這些工具串起來、排程好、決定誰在什麼時候上場的小模型。

    你可以從一個最小的 routing + 任務規劃範例開始,先讓 Mellum2 管理兩個模型、一支工具,跑順了再往外擴。

    🚀 你現在可以做的事

  • MiniMax M3:一口吃下百萬字長文的開源模型

    MiniMax M3:一口吃下百萬字長文的開源模型

    📌 本文重點

    • M3 支援 100 萬 token 長上下文與多模態輸入
    • 專門處理長文件、整個程式庫與 Agent 工作流
    • 可雲端快速試用,也能本地自架整合現有工具鏈
    • 先從一個最痛的長文或專案開始導入

    用一句話說:MiniMax M3 是一個開放權重、支援 100 萬 token 長上下文 + 多模態輸入 的模型,專門幫你處理「報告太長、程式碼庫太大、Agent 工作流太複雜」這三種麻煩事。

    💡 關鍵: 100 萬 token 長上下文代表可以一次塞進整份大型專案文件或程式庫索引,而不必自己切 chunk 或做向量搜尋。

    官方介紹與下載:https://www.minimax.io/models/text/m3(The Decoder 報導:https://the-decoder.com/minimax-m3-open-weight-model-with-a-million-token-context-challenges-proprietary-leaders/)


    核心功能:長文、程式碼、Agent 一次處理

    1. 100 萬 token 長上下文:整份專案文件一次丟進去

    能做什麼?

    • 一次放入:完整專案文件夾匯出的 Markdown、法規 PDF、產品說明書、研究報告
    • 不用切段:不必自己分 chunk、做向量搜尋,直接把「全部內容」交給模型
    • 查詢風格:像在問一位看完整專案的同事

    怎麼用(長文閱讀 Prompt 範本)

    1. 準備一個壓縮檔 / 合併文件,例如 project_docs.md(可用腳本把多個 Markdown / txt 串成一個檔案)。
    2. 在推理介面(API、Notebook 或 Web UI)中,把全文貼進 system / user 區。

    範例 Prompt 模板:

    你是一位技術專案經理。以下是整個專案的所有文件(需求、設計、會議紀錄、API 文件):
    
    --- 專案全文開始 ---
    {{整份文件內容}}
    --- 專案全文結束 ---
    
    請依照以下格式輸出:
    1. 專案一句話摘要(不超過 30 字)
    2. 3 個主要目標
    3. 5 個關鍵風險(附來源段落或章節名稱)
    4. 下一步行動建議(列出 5–10 條,可直接貼進 Jira 當任務)
    

    實際行動: 找一份你手上最頭痛、超長的專案文件,直接用上面模板測一次。


    2. 原生多模態:文字 + 圖像一起理解

    M3 支援把文字與圖片一起丟進上下文。例如:

    • 產品 PRD + UI 圖稿,一次請它找出規格與設計不一致之處
    • 報告 PDF 截圖 + 補充說明文字,一起整理重點

    圖片搭配 Prompt 範本:

    以下是某個產品的文字需求說明,以及對應的 UI 設計稿截圖(多張):
    
    文字需求:
    {{需求文字}}
    
    圖片:
    - image_1:登入頁
    - image_2:帳號設定頁
    - image_3:權限管理頁
    
    請列出:
    1. 每張圖和文字需求的對應關係
    2. 不符合需求或缺漏的地方
    3. 建議 UI 或流程調整(用條列)
    

    實際行動: 把一份 PRD + 幾張 Figma 匯出的 PNG 丟給 M3,看它幫你做「設計對規格」檢查。


    3. 為程式碼與 Agent 優化:整 repo 理解 + 多輪工具調用

    根據社群測試與官方說明,M3 在程式碼生成與 Agent 任務上做了特別優化:

    • 長上下文讓它能一次「看完整個 repo 的索引」
    • 可以在一個對話裡做多輪「工具調用→讀結果→改方案」

    💡 關鍵: 對整個 repo 建立「程式碼地圖」再交給 M3,可以讓它在第一次對話就掌握系統結構並規劃重構與 Agent 工作流。

    整個 repo 程式碼導覽 Prompt

    1. 先用腳本產生「程式碼地圖」,例如:
    # 只列出檔名 + 前幾行註解/類別宣告
    python scripts/make_repo_index.py > repo_index.txt
    
    1. 把 repo_index.txt + 關鍵檔案內容一起貼給 M3:
    你是一位資深軟體工程師。以下是某個專案的程式碼地圖與部分檔案內容。
    
    --- repo index ---
    {{repo_index.txt}}
    --- end repo index ---
    
    問題:
    1. 幫我畫出系統主要模組與資料流(用文字 + 簡單 ASCII 圖)
    2. 指出如果要「加入 OAuth 登入」,可能要改動的檔案與大致步驟
    3. 給出最小修改範圍的 refactor 計畫(列出任務清單)
    

    Agent 工作流拆解 Prompt

    把它當成「任務拆解器 + 工具 orchestrator」的腦:

    你是一個 AI Agent 系統的規劃師。你可以使用以下工具:
    - tool_search_issues:搜尋 Jira issue
    - tool_run_tests:執行 CI 測試
    - tool_open_pr:建立 Pull Request
    
    需求:
    「每天自動檢查新的 bug issue,找出影響登入流程的,跑測試,通過就開 PR。」
    
    請輸出:
    1. 將需求拆成 5–10 個可實作的 Agent 步驟
    2. 每個步驟會用到的工具(如有)
    3. 對 orchestrator 的假想 DSL / YAML 配置範例
    

    實際行動: 選一個你常做的重複開發流程,用上面模板請 M3 幫你轉成可實作的 Agent 腳本草稿。


    適合誰用:三種典型場景

    1. PM / 研究員:長報告與專案文件總結

    使用方式:

    • 把所有會議紀錄、需求文件、Excel 轉成文字(或貼 PDF OCR 結果),合併成一份長文
    • 用「長文閱讀模板」請 M3:
    • 整理專案脈絡與時間線
    • 整理「決策原因」與「未決事項」
    • 產出可以直接貼進 Notion / Confluence 的摘要

    行動建議: 對每個專案建立一份「M3 專案總結」,讓新成員用它快速上手。


    2. 後端 / 全端工程師:整 repo 理解與重構

    使用方式:

    • 新接手專案,先用腳本生成 repo index → 丟給 M3 產生系統說明
    • 要重構時,請它根據長上下文:
    • 找出高度耦合模組
    • 給出重構順序與風險點
    • 產生對應的 Git 分支與 PR 策略建議

    行動建議: 每次大改版前,用 M3 先產一份「重構設計」,再與團隊人工過一遍。


    3. 自動化 / AI Agent 開發者:多輪工具調用工作流

    使用方式:

    • 把你現有的工具清單(API spec、CLI 說明)全部貼給 M3
    • 要求它:
    • 定義任務拆解(如報表產出、自動回覆客服)
    • 設計工具調用順序與錯誤處理策略

    行動建議: 先挑一個「每天會做,但步驟固定」的流程,例如:生成日報、同步任務狀態,讓 M3 幫你設計第一版 Agent workflow。


    怎麼開始:雲端 / 本地快速跑起來

    1. 雲端:直接用官方 / 社群 API

    如果你只是想先試效果:

    1. 到官方頁面申請:https://www.minimax.io/models/text/m3
    2. 拿到 API key 後,在自己的腳本或 Postman 裡調用:
    curl https://api.minimax.io/v1/chat/completions \
      -H "Authorization: Bearer $MINIMAX_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "m3",
        "messages": [
          {"role": "user", "content": "幫我總結以下專案文件..."}
        ]
      }'
    

    適合: 想驗證長上下文/多模態效果、不急著本地部署的團隊。


    2. 本地 / 自架:Hugging Face + 官方 Docker

    A. 用 Hugging Face + vLLM / Ollama(範例)

    1. 在 Hugging Face 搜尋 MiniMax/M3(實際名稱以官方為準)。
    2. 用 vLLM 啟動:
    pip install vllm
    vllm serve MiniMax/M3 --port 8000 --dtype bfloat16
    
    1. 測試:
    curl http://localhost:8000/v1/chat/completions \
      -H "Content-Type: application/json" \
      -d '{
        "model": "MiniMax/M3",
        "messages": [{"role": "user", "content": "你好,幫我總結這份文件"}]
      }'
    

    B. 用官方 Docker 快速跑起

    1. 下載官方映像(名稱以官方文件為準):
    docker pull minimax/m3:latest
    
    1. 啟動:
    docker run -d --gpus all -p 8000:8000 minimax/m3:latest
    
    1. 之後的使用方式就和一般 OpenAI 相容 API 類似。

    實際行動: 用 Docker 跑起來後,先跑一個「長文閱讀模板」,確認你的 GPU 記憶體足夠,觀察響應時間。

    💡 關鍵: 若你已採用 OpenAI 相容 API,將 base_url 換成 M3 服務即可快速 A/B 測試長上下文任務的效果。


    3. 跟現有工具鏈整合:VS Code、Orchestrator、CLI

    VS Code:當成本地 Copilot

    1. 安裝任一個支援自訂 LLM endpoint 的 VS Code 擴充套件(如 Code GPT、Continue)。
    2. 將模型 endpoint 設為你自架的 M3 伺服器 URL。
    3. 專案開啟後:
    4. 用「整 repo 導覽」prompt 請它解釋架構
    5. 在單檔內請它重寫函式、加註解

    與開源 orchestrator 整合

    你可以在以下框架中把 M3 當成主要「腦」:

    • LangChain / LlamaIndex:用它處理長上下文和工具調用規劃
    • CrewAI / OpenAI-compatible orchestrators:直接把 OPENAI_BASE_URL 指到你的 M3 伺服器

    簡單 YAML 範例(假想):

    llm:
      type: openai-compatible
      base_url: http://localhost:8000/v1
      model: MiniMax/M3
    
    agent:
      tools:
        - search_issues
        - run_tests
      max_iterations: 10
    

    實際行動: 在你現有的 Agent 專案,把原本的 gpt-4 或其他模型,先在「規劃/總結」節點換成 M3,測試對長上下文任務的改善。


    小結:先從一個最痛的長文或程式庫開始

    不用一次把所有流程都搬到 M3。挑一個:

    • 最長、最難讀的一份文件
    • 或你最不熟的一個 codebase

    用上面給的三組模板(長文閱讀、程式碼導覽、Agent 任務拆解)跑一次,你就能感受到「百萬 token 長上下文 + 開放權重」在實際工作中的差別。

    🚀 你現在可以做的事

    • 挑選一份最頭痛的長報告或專案文件,套用「長文閱讀模板」實測 M3
    • 對一個新接手的 repo 生成 repo_index.txt,用「整個 repo 導覽 Prompt」請 M3 說明架構
    • 在現有 Agent 專案中,把規劃/總結節點的模型改成 M3,觀察長上下文任務表現差異
  • 自託管 Airi:把 AI 養在自己電腦裡

    自託管 Airi:把 AI 養在自己電腦裡

    📌 本文重點

    • Airi 可完全自託管,長駐你自己的機器
    • 支援即時語音與遊戲互動,像住在電腦裡的同伴
    • 可接本地 LLM 或雲端 API,自訂人格與長期記憶

    Airi 解決的是:想要一個「常駐在自己電腦裡」、能語音聊天、陪你打遊戲,又不把隱私丟給雲端的大型 AI 代理人。

    Airi GitHub:https://github.com/moeru-ai/airi


    核心功能:把 Airi「養」在自己機器上

    1. 自託管架構:本地 / 伺服器都能養

    Airi 是完全自託管的專案,你可以:

    • 裝在自己電腦:當成桌面語音助理、遊戲副駕駛
    • 架在家裡 NAS / 伺服器:多台裝置共用同一個 Airi
    • 放到雲端 VPS:人不在家也能連回自己的 AI

    實際能做的事:

    • 重要對話、長期記憶都留在你控制的機器
    • 想換模型、換人格、換語音,都自己改,不受商業服務限制

    你可以現在先做:

    1. 開啟 GitHub 專案頁:https://github.com/moeru-ai/airi
    2. 在 README 看「Installation」區段,決定你要:
    3. docker-compose 一鍵跑,或
    4. 用腳本 / 原始碼自己起服務

    2. 即時語音通話:真的像「住在你電腦裡的人」

    Airi 內建語音通話功能,可以做到:

    • 按一個按鈕就跟 Airi 說話,低延遲雙向語音
    • 語音輸入 + 語音輸出,像在跟 Discord 語音室裡的人聊天
    • 長時間掛在背景,隨時叫一下就回應你

    這比一般聊天機器人多了兩件事:

    • 不用切視窗打字,邊寫程式邊講話就能查資料、記 To-do
    • 遊戲全螢幕時仍可用語音讓 Airi 幫你查攻略、算資源

    你可以先準備:

    • 一個麥克風(筆電內建也可)
    • 耳機(避免回授回音)

    安裝好後,在 Airi 的 Web 或桌面客戶端裡,找到 Voice / Call / Talk 類選項,試著說一句:

    「幫我記一下,10 點要去打王。」

    確認 Airi 能聽懂、重複你剛說的提醒,就代表語音通路打通了。

    💡 關鍵: 長時間低延遲語音掛機,讓 Airi 更像常駐同事,而不是臨時叫用的聊天機器人。


    3. 跟遊戲雙向互動:Minecraft、Factorio 副駕駛

    Airi 的另一個重點,是能直接連到遊戲伺服器,讀取資訊、發送指令,目前官方強調支援:

    • Minecraft:
    • 讀取聊天、座標、玩家狀態
    • 讓 Airi 發聊天訊息、執行伺服器指令
    • 能當「伺服器管理員」、「新手顧問」或「劇情 NPC」
    • Factorio:
    • 掃描工廠狀態、產線 bottleneck
    • 建議你要擴產哪條線、缺哪種物資

    實際玩法舉例:

    • Minecraft 裡打 /askairi 我怎麼做一個自動農場?
    • Airi 在遊戲聊天裡回你步驟,同時用語音對你講解

    你可以安排一個晚上做這件事:

    1. 準備一個 Minecraft 伺服器(本地或雲端都可)
    2. 依 Airi README 中的 Minecraft / Factorio 插件說明:
    3. 在伺服器裝上 Airi 提供的插件 / 模組
    4. 在 Airi 設定檔填入伺服器位址與 API 金鑰
    5. 重新啟動伺服器並進入遊戲,測試呼叫 Airi

    4. 多平台客戶端 + 多種 LLM 後端

    Airi 支援:

    • Web 介面:瀏覽器直接用,管理設定、對話、記憶
    • macOS / Windows 客戶端:
    • 固定在桌面右下角、選單列
    • 快捷鍵喚出,直接講話或輸入文字

    LLM 後端則非常彈性:

    • 本地開源模型(透過 Ollama、LM Studio 等)
    • 雲端 API:OpenAI、Anthropic、Qwen、Gemini…(依 README 支援)

    對於想要「免費 / 低成本玩起來」的讀者,建議:

    • 若有 16GB RAM 以上 + 顯示卡:考慮用 Qwen 3.x 7B / 14B 這種偏擅長 Agent 任務的模型
    • 若硬體較弱:先用 雲端 API 的小模型(如 gpt-4o-mini 類),避開本地推論壓力

    💡 關鍵: 有 16GB RAM 加獨顯時,本地模型就能順跑,真正做到零額外流量費與隱私全在自己機器。

    你現在可以做:

    • 選擇你要的模型來源,準備好:
    • 本地:先安裝 Ollama,拉一個模型 ollama pull qwen2.5:latest
    • 雲端:到 OpenAI / Anthropic 後台申請 API Key
    • 在 Airi 設定檔裡填入:模型名稱、API Key、base URL

    適合誰用:幾個具體場景

    1. 桌面語音助理:在你電腦旁邊工作的「同事」

    可以這樣用:

    • 開會前對 Airi 說:「幫我整理這份 PDF 的重點。」
    • 寫程式時問:「這段 TypeScript 為什麼報錯?」
    • 長時間聊天:讓 Airi 記住你正在進行的專案、偏好工具

    搭配其他工具:

    • 結合 Claude Code / Cursor / codegraph 之類開發環境,把「寫程式」交給 IDE,把「討論設計、備忘錄」交給 Airi

    行動建議: 安裝好後先定義一個簡單工作流,例如:

    每天早上請 Airi 根據行事曆排三件最重要的事,晚上讓它跟你一起檢討完成度。


    2. 遊戲副駕駛:策略腦 + 資源小管家

    在 Minecraft / Factorio / 其他支援的遊戲裡:

    • 讓 Airi 記住你的長期目標(例:一週內完成終界龍擊殺 / 火車自動物流)
    • 每次登入時請它提醒:現在缺什麼資源、下一步該做什麼
    • 遊戲裡臨時問:「我現在要去哪裡刷 X 資源效率最高?」

    高級玩法:

    • 讓 Airi 按固定節奏掃描伺服器狀態,自己發現問題
    • 例如:箱子爆滿、產線堵塞,就自動在聊天頻道喊你

    行動建議: 設計一個明確角色給 Airi,例如:

    「你是我們伺服器的資源總管,只關心是否缺料,缺了就通知我並給出最短補貨路線。」

    把這段人格設定寫進 Airi 的系統提示 / persona 設定中。


    3. 長陪伴聊天夥伴 + 跨工具 Agent

    如果你想要一個可以長期記住你喜好、過去對話的 AI:

    • 利用 Airi 的記憶系統,讓它記:
    • 你常玩的遊戲
    • 你的工作類型、平常的困擾
    • 你的目標(練英文、學某個框架…)
    • 長期和它聊,讓它慢慢形成「認識你」的狀態

    再往上,可以接其他 Agent 平台:

    • 例如:
    • Airi 作為前端「主對話窗口」
    • 後面串 zero.xyz 去調用 ~8000 個工具、API
    • 串 Phasr 類工作流引擎,讓它一次跑多個任務而不丟上下文

    行動建議: 想一個你真的會常用的主題,例如「學習 Rust」,把它寫成 Airi 的長期任務:

    「你的任務是陪我在三個月內學會 Rust,定期出作業、review、提醒我寫 code。」

    💡 關鍵: 把長期學習或遊戲目標寫成任務與記憶,Airi 才能持續主動「記得你」而不是每次重來。


    怎麼開始:一個晚上就能跑起自己的 Airi

    1. 推薦最低硬體配置

    • CPU:四核心以上
    • RAM:16GB 起跳(跑本地 LLM 比較穩;如果只用雲端 API,8GB 也可)
    • 儲存:至少預留 20GB(模型 + 日誌 + 記憶)
    • 顯示卡:有獨顯最好(跑本地模型會輕鬆很多),沒有也能用雲端 API

    2. 用 Docker 一鍵跑起來

    以常見流程簡化示意(實際請以官方 README 為準):

    # 1. 先裝好 Docker & Docker Compose
    # 2. 在你想放 Airi 的資料夾裡:
    
    git clone https://github.com/moeru-ai/airi.git
    cd airi
    
    # 3. 啟動服務
    docker compose up -d
    

    接著:

    1. 瀏覽器開 http://localhost:PORT(PORT 依 README 為準)
    2. 看到 Airi 的 Web 介面後,先建立一個帳號 / 角色
    3. 在設定頁:
    4. 選擇 LLM 後端(本地或雲端)
    5. 設好語音輸入輸出

    如果你不熟 Docker,專案通常也會提供一鍵腳本(如 run.sh / start.ps1 類),照 README 指示執行即可。


    3. 配一個免費 / 便宜的模型

    兩條路線擇一:

    路線 A:本地開源模型(零額外成本,壓力在硬體)

    1. 安裝 Ollama:https://ollama.com
    2. 下載一個中小型模型,例如:

    bash
    ollama pull qwen2.5

    1. 在 Airi 設定裡把 LLM URL 指向 http://localhost:11434,模型名稱填 qwen2.5

    路線 B:雲端 API(硬體負擔低,按量計費)

    1. 到你喜歡的 LLM 服務註冊帳號(如 OpenAI)
    2. 建立 API Key
    3. 在 Airi 介面填入:
    4. API Key
    5. 模型名稱(例如 gpt-4o-mini)

    測試是否成功: 在 Airi 裡輸入一句:「幫我用條列整理一下 Airi 是什麼?」看能否正常回覆。


    4. 進階玩法:Minecraft 綁語音 + 自訂人格與長期記憶

    (1) Minecraft + 語音副駕駛

    大致步驟(細節以 Airi README 中的 Minecraft 節為準):

    1. 在你的 Minecraft 伺服器安裝 Airi 專用插件 / Mod
    2. 在 Airi 後台新增一個「Minecraft 連線」,填入:
    3. 伺服器位址
    4. 驗證金鑰
    5. 設定一個提示模板,例如:

    你是這個伺服器的導遊,會用中文在遊戲聊天和語音裡同時回應玩家問題。

    測試:在遊戲裡打 /airi 這附近有什麼資源?,看聊天與語音是否同步回應。

    (2) 自訂人格 + 長期記憶

    在 Airi 的 persona 或 system prompt 區裡,可以寫:

    • 身份:

      你是住在我電腦裡的 AI 室友,平常會關心我的工作進度和遊戲計畫。

    • 口吻:

      輕鬆、直接,避免太官方的說話方式。

    • 記憶策略:

      遇到我的偏好、長期目標、常見問題時,請寫入長期記憶,下次主動提起。

    接著在 Web 介面裡,偶爾去「記憶 / memories」頁面檢查:

    • 刪掉已過時的資訊
    • 補充重要但沒被好好記錄的背景

    這樣 Airi 就會越來越像一個真的「老朋友」,而不是每次都從零開始的聊天機器人。


    最後,建議你空出一個完整晚上,按這個節奏走:

    1. 用 Docker 跑起 Airi
    2. 選一個模型 + 打通語音
    3. 寫一段屬於你的 persona
    4. 如果有 Minecraft 伺服器,再綁一次遊戲互動

    做到這四步,你就真正「把一個 AI 養在自己的電腦裡」,之後只需要慢慢調人格、調記憶,讓它變成最懂你的那一個。

    🚀 你現在可以做的事

    • 打開 Airi GitHub 專案,按照 README 用 docker compose up -d 跑起第一個實例
    • 在 Airi 設定中接上一個模型(本地 qwen2.5 或雲端 gpt-4o-mini),並測試一句對話是否正常
    • 寫一段簡短 persona(例如「AI 同事」或「伺服器資源總管」),儲存後連續跟它聊幾天觀察效果
  • Claude Code 動態工作流實戰指南

    Claude Code 動態工作流實戰指南

    📌 本文重點

    • 動態工作流讓 Claude Code 變成能總包整個 repo 的工程助手
    • Opus 4.8 提升程式推理與錯誤自查效率,並提供快速模式省時省錢
    • Ultracode 把大規模 code review 與安全審計變成一個指令可完成

    用一句話講清楚:Claude Code 的「動態工作流」讓你把「重構整個 repo、語言遷移、資安審計」交給一個會自己拆分任務、開數百個子 Agent 平行跑、還會自我驗證結果的代碼工地總包商。


    核心功能:從「聊天寫程式」升級成「工程總包」

    1. 動態工作流:自動拆分、平行執行、自己驗收

    Anthropic 在 Claude Code 中加的 dynamic workflows,關鍵不是「多 Agent」本身,而是:

    • 由模型自己寫協調腳本(orchestration scripts)
    • 自動把工作拆成數十到數百個子任務
    • 每個子任務對應一個子 Agent 平行跑
    • 結束前先做一輪自我驗證,只把過檢的結果給你

    最典型的實戰案例,是 Bun 作者用它做 Zig→Rust 遷移:

    近 75 萬行代碼、約 11 天完成,測試通過率 99.8%(來源:Reddit 動態工作流介紹)

    💡 關鍵: 對接近 75 萬行程式碼的遷移專案來說,11 天達到 99.8% 測試通過率,代表這套動態工作流足以接住大型、原本高風險的重構工程。

    實際會怎麼跑? 以「整個 repo 重構」為例,dynamic workflows 大致會:

    1. 掃描 repo,產生檔案與模組地圖
    2. 規劃任務圖(Task graph):例如先改 domain 層,再跑 API 層,最後是 UI
    3. 平行啟動子 Agent:每個 Agent 負責一組檔案或一類修改(型別調整、logging 統一、錯誤處理強化…)
    4. 在背景自動做 diff、測試、靜態檢查
    5. 聚合結果,過一輪總審查後才丟回給你

    你可以這樣用(行動建議):

    • 想重構:
    • 在 Claude Code(或 API)裡給它:
      • 專案簡介 + 技術棧
      • 現在的痛點(例如:循環依賴、例外亂飛、型別不嚴謹)
      • 你願意接受的改動範圍(例如:可以改 public API?可以拆模組嗎?)
    • 下指令像:「為這個 monorepo 設計一個 2 週內可以完成的重構計畫,用動態工作流分批執行。」

    • 想做資安審計:

    • 給它 repo,說明:框架、使用的雲服務、資料敏感區
    • 指令示例:「用動態工作流做一次安全掃描,重點找:未驗證的輸入、SQL injection 風險、憑證硬編碼、弱 JWT 驗證。」

    2. Opus 4.8:程式推理更穩、錯誤自查率變 4 倍

    根據 Anthropic 官方與社群測試(如 Decoder 報導 和 r/artificial 整理):

    • 程式錯誤檢測能力較 4.7 提升約 4 倍:更容易自己指出「這裡可能 NPE」「這裡 race condition」「這裡忽略錯誤」。
    • 在瀏覽器 / 電腦代理 benchmark(Online-Mind2Web)上,Opus 4.8 優於 GPT-5.5,也就是比較會自己「操作工具」而不是只寫字。
    • 使用者回報的特點:更常誠實承認「沒做完」「這裡有風險」,對長流程開發很重要。

    更關鍵的是新增了「快速模式」(fast mode):

    • 約 2.5 倍速度
    • 成本約是完整模式的 1/3 左右(數字隨官方調整,但量級在這附近,來源:r/ClaudeAI)

    💡 關鍵: 在程式錯誤檢測提升約 4 倍的同時,fast mode 還能以約 1/3 成本提供 2.5 倍速度,讓你可以先用低成本掃全 repo,再用完整模式精修關鍵部分。

    怎麼選模式才划算?

    • 用快速模式的情境:
    • 寫 template、樣板 code(CRUD、UI 元件鋪排)
    • 大量簡單檔案轉換(例如 config 重排、註解補齊)
    • 先跑一輪粗略掃描(安全 / style / dead code)

    • 改用完整(非快速)模式的情境:

    • 棘手 bug 定位(多執行緒、邊界條件)
    • 關鍵底層邏輯(交易撮合、金流、權限系統)
    • 產出要長期維護的設計文件或核心 API 介面

    實作建議:先用快速模式跑全 repo 掃描 → 把它標出的高風險區塊,再交給完整模式精修。


    3. Ultracode:把「大規模 code review」變成一個指令

    Ultracode 是 Claude Code 裡針對程式碼審查的強化工作流(參考 r/ClaudeAI 討論):

    • 你只需要丟一個 diff、Pull Request 或整個子資料夾
    • Ultracode 會在背景開子工作流做:
    • 分檔案審查
    • 風險排序(安全 > 穩定性 > 可維護性)
    • 驗證自己的意見是否一致,再回傳整理過的 review

    實際效果偏向:一個很嚴格、沒情緒的資深工程師,會吐槽你 data2 這種變數名(參考「讓 Claude 審查 Claude」的案例)。

    你可以這樣用(行動建議):

    • 小團隊 / Side project:把 PR 丟給 Ultracode,要求:
    • 「請只標出會導致 bug / 安全問題的變更,逐一解釋原因。」
    • 「另外列一份『可選優化清單』,讓我有時間再慢慢改。」

    • 個人練功:

    • 把自己最近寫的一個模組丟給 Ultracode,問:
      • 「請假裝你是 code reviewer,列出你會擔心的 10 個點。」
      • 把每個問題的建議重構方式具體寫出來,附簡短範例。

    適合誰用?幾種典型場景

    1. 重寫或升級舊系統

    典型痛點:老專案沒測試、沒文件、沒人敢動。

    可以這樣切:

    1. 用 Claude Code 建一份系統地圖:
    2. 指令:「為這個 repo 建一份架構圖,包含模組依賴、資料流、外部服務。」
    3. 問它「若想把 A 模組替換成 B 技術棧,請設計一個最小風險的遷移計畫」,讓它給分批 PR 設計。
    4. 啟用動態工作流分批套改(例如先把 logging 換掉,再換 ORM)。

    2. 大規模代碼審計與安全掃描

    結合 dynamic workflows + Ultracode:

    • 全 repo 掃描:
    • 找硬編碼密鑰、弱加密、未驗證輸入
    • 為每類問題產生「修復模板」和自動修正 PR 草案

    • 持續使用方式:

    • 在 CI 加一步,用 Claude API 對每個 PR 跑 Ultracode 審查(可參考 Cloudflare 的 AI code review 實務 思路)。

    3. 多語言遷移(Zig→Rust、Python→TypeScript 等)

    Bun 的 Zig→Rust 遷移是一個極端例子,你可以用同樣思路做「比較小但現實」的版本:

    • Python backend → TypeScript(Express / Nest / tRPC)
    • JS 老專案 → TypeScript + stricter ESLint
    • PHP legacy → Laravel / Symfony 新專案

    實作建議:

    1. 先選一個獨立、低風險模組試轉,例如:
    2. 「通知系統」「報表匯出」「第三方 API 包裝」
    3. 指令示例:
    4. 「把這個 Python 資料轉換模組遷移到 TypeScript,目標環境是 Node 20 + TypeScript 5,型別要寫滿。」
    5. 測試穩了,再用動態工作流把相同 pattern 套到其他模組。

    4. 一人公司 / Side Project 的開發流程

    把 Claude Code 當作:

    • 一個幫你拉腳手架、寫樣板、整理測試的 junior dev
    • 再加上一個幫你審 PR、找安全洞的 senior reviewer

    你可以設計一個固定節奏:

    1. 功能草圖 → 讓 Claude 產生目錄結構與初版 code
    2. 自己補關鍵業務邏輯
    3. 用 Ultracode 做一次 code review + 測試覆蓋率建議
    4. 每個 sprint 最後,用動態工作流掃一次「錯誤處理 / logging / metrics 是否一致」

    怎麼開始:從免費聊天到整 repo 動態工作流

    1. 最低門檻:claude.ai 免費方案能做到什麼?

    入口:https://claude.ai

    目前免費帳號:

    • 可以使用新版模型(通常是 Sonnet / 部分場景下可用 Opus fast)
    • 適合:
    • 單檔 / 小模組的重構、bug debug
    • 讓它幫你讀一份錯誤訊息、log、或小型程式片段

    實際用法建議:

    1. 先貼一個單檔(或小於幾百行的檔案),請它:
    2. 「幫我找 bug / 重構 / 改風格」
    3. 再貼一個小 repo 的 zip / 關鍵檔案集合,問:
    4. 「請幫我畫出這個專案的架構圖與資料流程。」

    當你開始需要:

    • 長時間、多輪的代碼工作
    • 跑動態工作流、Ultracode、Opus 4.8 完整能力

    就會需要升級到 Claude Pro / Max / Team 或企業方案(具體功能以官方頁面為準)。


    2. 在終端安裝開源版 anthropics/claude-code

    GitHub:https://github.com/anthropics/claude-code

    基本安裝流程(概念):

    # 1. 安裝
    pip install claude-code  # 或依照 repo README 指示
    
    # 2. 設定 API Key(以官方 Claude API 為例)
    export ANTHROPIC_API_KEY="你的 API Key"
    
    # 3. 在專案根目錄啟動
    cd 你的專案目錄
    claude-code
    

    然後你就可以在終端跟它對話:

    > 幫我找出 src 下面所有可能的 race condition,並建議重構方式。
    > 幫我寫一個腳本,批次把 React class component 改成 function + hooks。
    

    動態工作流、Ultracode 會隨著你帳號權限與版本逐步釋出;用開源終端版的好處是:更容易和你自己的工具鏈(git、CI、測試框架)接軌。


    3. 透過 API / Bedrock / Vertex AI 調用動態工作流

    如果你要把這些能力塞進自己的內部平台或 CI:

    • Claude API:https://www.anthropic.com/api
    • Amazon Bedrock:在 Bedrock 控制台選擇 Claude Opus / Claude Code 相關 model
    • Google Vertex AI:在 Model Garden 選擇 Claude / Claude Code

    動態工作流目前通常以「研究預覽」方式提供給 Max / Team / Enterprise,透過:

    • 在請求中指定對應的 model / capability 標誌
    • 或使用官方提供的 workflow endpoint / 模板(需看當下文件)

    工程整合建議:

    • 在 CI 裡新增一個步驟:
    • 將本次 PR 的 patch / diff 打包
    • 呼叫 Ultracode / dynamic workflows 做審查
    • 把審查結果回寫成 bot comment

    4. 一個「從小到大」的漸進式實驗腳本

    你可以照這個順序,逐步加深依賴,而不會一開始就把整個 repo 丟給它:

    1. 單檔小任務(claude.ai 免費即可)
    2. 目標:讓它幫你修一個 bug / 重構一個 utility
    3. 檢查點:看它產出的 code 是否可讀、是否真的有幫你省時間。

    4. 小 repo(1–3 個模組) + Claude Code 終端版

    5. 目標:讓它在終端幫你跑測試、改幾個檔案、整理 commit
    6. 指令示例:「設計一組 PR,把這個小專案升級到最新框架版本。」

    7. 整個代碼庫 + 動態工作流 / Ultracode

    8. 目標:一次性做一個「人力不想做」的大工程:
      • 全 repo 錯誤處理統一
      • 安全掃描 + 自動修復草案
      • 語言 / 框架遷移的一個大模組
    9. 檢查點:
      • 先在 staging / feature branch 跑
      • 用你自己的測試 + Claude 的自我驗證雙重把關

    照這個步驟,你會很快感受到:Claude Code 已經不只是「幫你補幾行程式碼」,而是可以接下「這個季度我們一直不想動的那一坨技術債」,而你只需要負責決策方向與最後拍板。

    🚀 你現在可以做的事

    • 到 claude.ai 用免費帳號先丟一個單檔,實測一次 bug 修正或小重構流程
    • 在自己的專案根目錄安裝並啟動 anthropics/claude-code,讓它對一個小模組跑動態工作流或 Ultracode
    • 在現有 CI 流程中,挑一條非關鍵分支試接 Claude API,讓 Ultracode 對 PR 自動產生第一次 code review 評語
  • 把你的 Mac 變成本地 AI 工作站

    把你的 Mac 變成本地 AI 工作站

    想在 Mac 上跑 AI,又不想把程式碼、合約、研究資料傳到雲端?Conifer 要做的,就是把你的 Apple Silicon Mac 變成一台真正可離線工作的 AI 工作站。

    📌 本文重點

    • Conifer 把 Apple Silicon Mac 變成本地 AI 工作站
    • 支援本地檔案與應用程式存取,權限由系統控管
    • 開源免費 beta,適合開發本地 Agent 與高隱私場景

    專案連結:Conifer 在 r/artificial 的介紹


    核心功能:把「雲端用法」搬回本地

    1. 專為 Apple Silicon + Rust 寫的本地推論引擎

    Conifer 是一個用 Rust 寫的開源本地推論引擎,底層核心手寫優化,針對 Apple Silicon(M1 / M2 / M3)調教。

    能做什麼:
    – 在 M 系列 Mac 上,比一般沒調教的框架更穩定地跑小到中型 LLM
    – 同一台機器跑多個任務(寫程式、整理文件)時,效能比較不容易「卡住」

    💡 關鍵: 只要是 Apple M1/M2/M3 且有足夠記憶體,你就能在單機上穩定跑小到中型 LLM。

    你可以馬上採取的行動:
    – 檢查自己 Mac:
    –  > 關於本機 → 處理器是否為「Apple M1/M2/M3」
    – 記憶體至少 16GB(8GB 也能跑小模型,但體驗會受限)

    2. 支援本地檔案 / 應用存取,搭配系統權限控管

    Conifer 的設計目標之一,是支援「本地 Agent」:
    – 可以讀寫你的本地檔案(PDF、Markdown、程式碼)
    – 可以呼叫本機應用(例如開啟檔案、寫入資料夾)
    – 權限由作業系統核心層強制管理,避免 AI 亂碰不該動的資料

    這意味著,你可以做:
    – 「幫我整理這個資料夾裡所有 PDF,產出一份摘要」
    – 「讀這個專案的程式碼,幫我改這支函式」

    你可以馬上採取的行動:
    – 想一個你願意讓 AI 自動操作的「專用資料夾」,例如:~/AI_workspace,等等示範 workflow 會用到。

    3. 開源、免費、適合做本地 Agent 原型

    依照開發者在 Reddit 上的說法:
    – 專案是開源、免費,會持續維持這個狀態
    – 團隊目前在招募約 100 位 beta 使用者,一對一協助寫工具、做效能調校

    💡 關鍵: 現階段參與 beta 可以免費獲得一對一協助,讓工具更貼近你的實際需求場景。

    你可以馬上採取的行動:
    – 如果你是開發者或技術使用者,可以考慮加入 beta:
    – 到 Reddit 貼文底下留言說明你的使用情境
    – 或看貼文中是否有 waitlist 表單連結(之後版本有可能會直接公開在 GitHub)


    適合誰用:三種典型場景

    1. 開發者:在本機跑程式碼助手 / 文檔 QA / 客服原型

    具體能做的事:
    – 在 VS Code / JetBrains 旁邊,跑一個本地程式碼助手
    – 把專案文件(Markdown、API spec)丟進一個資料夾,做「本地文件問答」
    – 跑一個簡單客服 bot 原型,用你自己的 FAQ PDF 當知識庫

    你可以馬上採取的行動:
    – 先挑一個你想用 AI 幫忙的專案:
    – 例如一個 Node.js 後端專案資料夾
    – 再準備一個 docs/ 放所有設計文件
    – 之後就能用 Conifer + 本地模型,對這個目錄做 Chat / 查詢。

    2. 內容創作者:離線寫作、改稿、摘要

    如果你常在咖啡廳、出差途中、或沒有穩定網路的地方寫作,Conifer 的價值很明顯:
    – 不連網也能:改寫段落、列大綱、做摘要、翻譯
    – 不用把稿件上傳到第三方雲端

    你可以馬上採取的行動:
    – 建立一個 ~/AI_workspace/articles/ 資料夾
    – 把你正在寫的文章 .md / .docx 匯出成 .txt 或 .md 放進去
    – 稍後我們會示範 workflow:「請本地 AI 幫你整理這個資料夾裡所有文章」。

    3. 高隱私需求行業:法律 / 研究 / 內部知識庫 QA

    結合 Reddit 上法律工作者用本地叢集做草案撰寫的案例,可以把 Conifer 看成「單機版的縮小版叢集」:
    – 法律:讀本地條款、判決書、內部範本,生成草案初稿
    – 研究:整理本地 PDF 論文庫,做摘要、整理引用
    – 公司內部:拿內網手冊和 SOP 做 QA,不經任何雲端 API

    💡 關鍵: 對法律與企業內部知識庫場景,Conifer 讓資料全程留在內網與單機上更容易符合合規要求。

    你可以馬上採取的行動:
    – 準備一個「可以讓 AI 讀」的資料夾,例如 ~/AI_workspace/legal_docs/
    – 先只放不含敏感客戶資料的檔案,確認工具行為和權限再逐步擴大範圍。


    跟其他本地方案比,Conifer 的位置在哪?

    如果你已經在用像 Ollama 這類工具,Conifer 比較像是「更貼近系統、偏工程師向」的一層。

    名稱 核心功能 免費方案 適合誰
    Conifer Apple Silicon 本地推論引擎 + 本地 Agent 支援 開源免費 beta 想做本地 Agent、需要檔案/應用權限控制的技術用戶
    Ollama 一行指令拉模型、快速啟動本地聊天 開源免費 想快速在本機試模型、不需太深度系統整合的使用者

    補充:如果你要的是「只要打開就能聊」的體驗,Ollama 比較接近一般使用者工具;如果你想做「讀檔案、動應用程式」的本地 Agent,Conifer 會比較合適。


    怎麼開始:從安裝到第一次對話

    注意:目前 Conifer 正在 beta 階段,實際命令可能會隨版本調整,下列流程是給你一個「從 0 到能跑」的具體心智模型,細節以官方說明為準。

    步驟 1:從 GitHub 取得 Conifer

    1. 進入專案頁(之後應會公佈在 GitHub,現在可以先從 Reddit 貼文追蹤):
    2. Conifer 介紹貼文
    3. 找到:
    4. GitHub 連結
    5. 或 beta 測試申請表單
    6. 申請 beta:
    7. 簡單說明你的機器規格、預計使用情境(例如:本地程式碼助手 + 文件 QA)

    步驟 2:在 Mac 上安裝(示意流程)

    拿最典型的 CLI 安裝方式舉例,你可以預期會類似這樣:

    # 1. 安裝 Rust(若尚未安裝)
    curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
    
    # 2. 從 GitHub clone 專案
    git clone https://github.com/<team>/conifer.git
    cd conifer
    
    # 3. 編譯執行檔
    cargo build --release
    
    # 4. 把執行檔加入 PATH(依專案說明為準)
    cp target/release/conifer /usr/local/bin/
    

    你可以馬上採取的行動:
    – 確認自己是否能順利用 cargo build 編譯一個 Rust 專案(沒問題的話,跑 Conifer 會順暢很多)。

    步驟 3:下載一個示範模型

    在 beta 階段,團隊通常會推薦一組「測試穩定」的小模型,方便你先確認引擎和權限系統是否正常。

    假設他們提供一個 qwen-3b-conifer.gguf 模型,你可以這樣做:

    mkdir -p ~/conifer-models
    cd ~/conifer-models
    curl -O https://models.conifer.ai/qwen-3b-conifer.gguf
    

    你可以馬上採取的行動:
    – 留意兩件事:Mac 的可用磁碟空間(模型可能是數 GB)、網路下載速度(第一次拉模型比較久)。

    步驟 4:跑起你的第一個本地對話

    完成模型下載後,啟動一個簡單的 CLI 對話伺服器,例如:

    conifer run \
      --model ~/conifer-models/qwen-3b-conifer.gguf \
      --mode chat
    

    接著在終端機輸入:

    你現在在我的 Mac 本機上跑,不連網路。請回覆「已啟動」,並告訴我你能幫我做什麼。
    

    如果模型正常回覆,代表:
    – 推論引擎 OK
    – 模型載入 OK
    – 不需任何雲端 API,就能跑起一個基本聊天助手


    示範 workflow:本地 AI 幫你整理指定資料夾文件

    下面是一個你可以實際用得上的簡單 workflow,示意 Conifer 的「本地檔案 + 權限」能力。

    目標

    給 Conifer 一個資料夾路徑,讓它:
    1. 掃描裡面的 .txt / .md 檔案
    2. 為每個檔案產一段摘要
    3. 輸出成一個 summary.md 報告

    準備

    1. 建立資料夾:
      bash
      mkdir -p ~/AI_workspace/articles
    2. 放入幾個測試檔案 article1.md, article2.md。

    可能的 Conifer Agent 方式(概念示例)

    未來 Conifer 會提供類似「工具 + 權限」的設定,你可以:

    1. 在設定檔中開啟檔案系統工具,限定路徑:
      toml
      [tools.files]
      enabled = true
      allowed_dirs = ["/Users/你/AI_workspace/articles"]
    2. 啟動一個「文件整理 Agent」:
      bash
      conifer run \
      --model ~/conifer-models/qwen-3b-conifer.gguf \
      --agent file-summarizer.toml
    3. 發出任務:
      text
      請在 /Users/你/AI_workspace/articles
      讀取所有 .md 檔案,為每個檔案產 3–5 行摘要,
      把結果整理成一個 summary.md 存在同一個資料夾。

    這個流程的重點是:
    – 檔案存取範圍你自己限制
    – AI 只在你指定的資料夾裡讀寫
    – 全程在你的 Mac 上完成,不透過外部伺服器

    你可以馬上採取的行動:
    – 先想清楚:你願意開放給 AI 長期讀寫的 1–2 個「工作資料夾」,其他一律不給權限。


    Beta 現況:怎麼加入與回饋問題

    依照 Reddit 貼文資訊,Conifer 團隊目前:
    – 正招募約 100 位免費 beta 使用者
    – 會跟這些使用者一對一合作:了解需求、寫專用工具、做效能最佳化

    你可以這樣參與:

    1. 到這篇 Reddit 貼文:
      👉 Building Conifer, an open-source local inference runtime
    2. 在留言中說明:
    3. 你的機器(例如:M2 Pro + 32GB RAM)
    4. 你打算怎麼用(例如:本地程式碼助手 + 法律文書草案)
    5. 開始測試後,把你遇到的:
    6. Crash log
    7. 效能瓶頸(例如某模型載入太慢)
    8. 需要的工具(例如:想要一個自動讀 PDF 的工具)
      回報給開發團隊

    這樣做的好處是:
    – 你可以在第一時間拿到更穩定、貼近實務需求的版本
    – 你的需求(例如法律、研究場景)會直接影響這個本地 AI 引擎未來的功能優先順序


    如果你已經習慣雲端模型的便利,下一步值得嘗試的,就是把其中一個工作流程搬回本地,在自己的 Mac 上用 Conifer 跑一次,感受「完全不經過網路」的 AI 工作站體驗。

    🚀 你現在可以做的事

    • 檢查自己的 Mac 規格(Apple M 系列 + 至少 16GB RAM),並預留數 GB 空間放模型
    • 建立一個 ~/AI_workspace/,準備好願意給 AI 操作的專用資料夾與測試文件
    • 前往 Reddit 貼文關注 Conifer 專案進展,視需求申請 beta 並規劃你的第一個本地 Agent 用例
  • 把 Claude 變成你的主力工作代理人

    把 Claude 變成你的主力工作代理人

    📌 本文重點

    • 把 Claude 當「可配置代理人」,而非一次性問答工具
    • 善用 Claude.md、Skills、Subagents、Plugins 建立工作流程
    • 針對身份配置專屬 workflow,讓重複工作自動化

    一句話定位:不是再多寫一個 prompt,而是把 Claude 配好「記憶+流程+工具」,變成每天幫你跑任務的主力工作代理人。


    核心功能:先理解這 4 個積木

    目標:看完這一節,你要能說出「Claude 現在在哪裡記東西、怎麼做事、怎麼叫外部工具」。


    1. Claude.md:給代理人一個「長期腦袋」

    • 角色:你的私人知識庫與工作說明書(system prompt 的升級版)。
    • 放什麼:
    • 你的背景(職位、產業、常用技術棧)
    • 任務偏好(寫作語氣、程式碼風格、專案管理習慣)
    • 長期專案的關鍵資訊、慣用模板
    • 使用效果:每次新對話,Claude 自動帶著這份設定,不用再重複解釋自己。

    💡 關鍵: 善用 Claude.md,可以一次設定、長期沿用,省去每次從零解釋背景與偏好的時間成本。

    可以馬上做的事:

    1. 到 claude.ai 登入。
    2. 在設定或 Workspace 設定裡找到 Claude.md 或類似「AI 配置檔」。
    3. 寫第一版內容(建議結構):

    “`markdown
    # 關於我
    – 角色:B2B SaaS 產品經理
    – 常用語言:繁體中文 + 英文技術文件

    # 工作偏好
    – 寫作:偏實用教學,少形容詞,多步驟
    – 文件格式:盡量用 Markdown,標題層級清楚

    # 長期專案
    – 專案 A:AI 產品內部知識庫
    – 專案 B:每週技術選型評估報告
    “`

    1. 日後只要養成習慣:有長期沿用的規則/資訊,就補進 Claude.md,而不是每次對話再講一次。

    2. Skills:可重用的「任務模板」

    • 角色:把你常做的工作,變成一顆一鍵呼叫的小程式。
    • 適合類型:
    • 每週重複的報告(例:每週產品更新摘要)
    • 固定格式的輸出(例:Code review 指南、文章大綱格式)
    • 需要多步驟的任務(例:先讀文件 → 列出問題 → 提出修改建議)

    一個簡單 Skill 範例:專案讀書筆記器

    邏輯:給 Claude 一篇文章連結或貼上內容,Skill 幫你產出固定結構的筆記。

    Skill 內容可以長這樣(概念示意):

    # 技能名稱:research_note
    
    ## 功能
    將一篇文章整理成結構化研究筆記。
    
    ## 輸入
    - `content`: 文章全文或重點摘錄
    
    ## 任務步驟
    1. 先用 3 句話摘要內容。
    2. 條列:關鍵概念、重要數據、引用來源。
    3. 給出:
       - 對我目前專案的啟發
       - 後續可以延伸研究的 3 個問題
    
    ## 輸出格式
    使用 Markdown:
    - 概覽
    - 關鍵概念
    - 數據與引用
    - 對專案的啟發
    - 後續問題
    

    可以馬上做的事:

    1. 在 Claude 介面中找到 Skills(通常在左邊或設定的 Skills / Tools 區)。
    2. 新增一個 Skill,把上面範例貼進去並調整成你的語氣與領域。
    3. 之後看到文章,直接對 Claude 說:

    用 research_note 幫我整理這篇,內容在下面:


    3. Subagents:把大任務拆給專職小幫手

    • 角色:一個大代理人(你平常在聊的 Claude),底下可以派出「專職分身」。
    • 適合情境:
    • 寫作:資料研究 agent、結構調整 agent、潤稿 agent 各司其職
    • 工程:debug agent、測試覆蓋率 agent、文件撰寫 agent
    • 專案管理:需求整理 agent、風險盤點 agent、會議紀錄 agent

    參考 多代理系統實作文章 的做法,你可以這樣配置:

    • ResearchAgent:只負責找資料、整理重點,不下結論。
    • WriterAgent:只根據整理好的重點寫初稿。
    • EditorAgent:只負責風格、語氣、構優化。

    可以馬上做的事:

    1. 在 Skills 區先各自為 research、write、edit 建立對應 Skill。
    2. 建一個「總控 Skill」,流程像這樣:

    markdown
    1. 呼叫 ResearchAgent Skill,輸入主題。
    2. 將輸出傳給 WriterAgent Skill,生成草稿。
    3. 將草稿丟給 EditorAgent Skill,優化文稿。

    1. 你對 Claude 下命令就只剩一句:

    用你的寫作工作流幫我處理這個主題:XXX

    這呼應了「Plan 模式比一次搞定更重要」的思路(可參考 這篇 Plan mode 深入解析)。


    4. Plugins / MCP:把 Notion、GitHub、日曆接進來

    • Plugins(或 MCP 伺服器):讓 Claude 能「去別的服務做事」,而不是只在聊天室輸出文字。
    • 常見接法:
    • Notion:讀寫頁面、幫你整理研究筆記
    • GitHub:查 issue、看 PR、寫 review 建議
    • 日曆:生成待辦、排會議時間

    可以馬上做的事:

    1. 在 Claude 設定中找到「Plugins」或「MCP」管理頁面。
    2. 授權你常用的工具(例如 Notion / GitHub)。
    3. 測試一個實用指令:
    4. Notion:

      幫我把這篇研究筆記整理成 Notion 新頁面,放在資料庫「AI Research」底下。

    5. GitHub:

      幫我看這個 PR,先列出潛在風險,再寫一段給同事看的 review。連結在這裡:XXX


    適合誰用:3 種典型配置範例

    目標:對照自己的身份,直接抄一套設定起來。


    1. 個人工作者:寫作 / 研究 / 專案管理

    建議配置:

    • Claude.md:
    • 明確定義你的寫作風格、常用結構(例如所有教學文都用「背景 → 步驟 → 範例 → 常見錯誤」)。
    • Skills:
    • research_note:文章/論文筆記
    • outline_builder:輸入主題,自動給 2–3 個不同角度的大綱
    • meeting_minute:貼原始會議筆記,輸出「決策/待辦/風險」三欄
    • MCP / Plugins:
    • Notion 或 Obsidian 相關工具,讓筆記自動進入你的知識庫。

    日常 workflow 範例:

    1. 丟 3–5 篇相關資料給 Claude,用 research_note 各自整理。
    2. 用 outline_builder 產出文章大綱,選一版改一改。
    3. 完稿後請 Claude 依指定格式,寫成 Notion 新頁面並歸檔。

    2. 工程師:Code Review + 多 repo 協作

    建議配置:

    • Claude.md:
    • 寫清楚專案技術棧、程式碼風格規範、測試原則。
    • Skills:
    • code_review:給 PR 連結或 patch,輸出:問題清單、風險點、建議 commit 清單。
    • test_case_generator:根據函式/API,幫你列出缺的測試案例。
    • Subagents:
    • ArchitectureAgent:只看架構與邏輯。
    • StyleAgent:只看命名、風格、一致性。
    • MCP / Plugins:
    • GitHub / GitLab 工具,直接讀 PR diff、issue 歷史。

    日常 workflow 範例:

    1. 對 Claude 說:

    幫我用你的 code_review 工作流檢查這個 PR:XXX

    1. Claude 讀 GitHub diff,先由 ArchitectureAgent 看設計,再由 StyleAgent 補充風格問題,最後合併成一份可直接貼回 PR 的 review。

    3. 小團隊:共用一組技能與工作流

    建議配置:

    • 共用 Workspace 的 Claude.md:
    • 放團隊寫作規範、技術決策原則、產品定位。
    • 共用 Skills:
    • weekly_update:所有人都用同一個模板輸出週報。
    • spec_template:PRD / 技術規格文件的標準結構。
    • MCP / Plugins:
    • 共用的 Notion、Jira、GitHub 專案權限。

    操作方式:

    1. 由一人負責整理團隊的 Claude.md 和 Skills。
    2. 其他成員只需要:
    3. 在週報時輸入:

      用 weekly_update 幫我整理這週的進度,重點在 XXX。

    4. 寫新功能時:

      用 spec_template 幫我產生這個功能的 PRD 初稿,功能說明如下:XXX。


    一小時內用起來:實戰 workflow 示範

    目標:照這段做完,你就有「從資料收集 → 產出大綱 → 自動整理到知識庫」的一套日常代理人流程。


    Step 1:開啟並寫好第一版 Claude.md(10 分鐘)

    1. 打開 claude.ai → 設定 → Claude.md。
    2. 貼入這個模板再依需求修改:

    “`markdown
    # 關於我
    – 角色:__
    – 主要領域:
    ____

    # 工作偏好
    – 回覆語言:繁體中文
    – 文件格式:預設使用 Markdown
    – 風格:先給結論,再拆解步驟

    # 長期專案
    – 專案 1:__(簡述目的與目前進度)
    – 專案 2:
    ____
    “`


    Step 2:建立第一個 Skill:研究筆記(10 分鐘)

    1. 到 Skills 管理頁,新增 Skill research_note。
    2. 使用前面提供的 research_note 範本,改成你的領域語氣。
    3. 找一篇你最近在看的文章,把內容貼給 Claude,指定使用 research_note。

    Step 3:讓 Subagent 接手子任務:大綱生成(15 分鐘)

    1. 新增 Skill outline_builder,內容類似:

    “`markdown
    # 技能名稱:outline_builder

    ## 功能
    針對一個主題,產生 2–3 個不同角度的大綱,每個大綱最多 5 個主標。

    ## 步驟
    1. 簡要理解主題與目標讀者。
    2. 提出 2–3 種切入角度。
    3. 針對每種角度,列出主標與一句說明。
    “`

    1. 建立一個「寫作工作流 Skill」,流程:
    2. 先呼叫 research_note 消化資料。
    3. 再把研究結果摘要丟給 outline_builder。
    4. 你只要給主題 + 資料清單,就能一次拿到整理後的研究+多版本大綱。

    💡 關鍵: 把 research_note + outline_builder 串成 workflow,一次輸入主題就能從資料整理到多版本大綱,大幅降低起稿門檻。


    Step 4:接上 Notion,自動寫入知識庫(15–25 分鐘)

    1. 在 Plugins / MCP 介面中,啟用 Notion 並完成授權。
    2. 建一個 Notion 資料庫,叫做「AI 研究庫」。
    3. 對 Claude 下指令:

    從現在開始,所有用 research_note 產出的內容,幫我整理成 Notion 新頁面,放在「AI 研究庫」,標題用日期+主題。

    1. 測試一次完整流程:
    2. 丢一篇文章 → 用 research_note 整理。
    3. 要求 Claude 寫入 Notion。
    4. 打開 Notion 確認格式與欄位是否符合期待,必要時微調規則。

    延伸工具:如果想把多個 AI 輸出集中管理

    如果你平常 Claude / ChatGPT / Gemini 都會用,可以考慮配合像 Coffer 這類工具,把所有 AI 回覆存進一個可搜尋的 vault(原作者分享在 Reddit)。

    名稱 核心功能 免費方案 適合誰
    Claude 主力工作代理人:Claude.md + Skills + MCP 有 想把 AI 當長期工作夥伴的人
    Coffer 儲存多家 AI 回應到本地可搜尋知識庫 有 重度問 AI、怕內容散佈的人

    💡 關鍵: 把多家 AI 的回應集中到同一個可搜尋知識庫,可以避免資訊分散在不同聊天裡,長期累積成真正可用的資產。


    只要先把 Claude 當成「可以配置的代理人」,而不只是「一次性的問答工具」,從 Claude.md、Skills 到 Subagents、Plugins 一步步搭起來,你就會開始感受到:每天重複的工作,有越來越多可以丟給它接手。

    🚀 你現在可以做的事

    • 登入 claude.ai,建立並填好你的第一版 Claude.md
    • 新增一個 research_note Skill,實際拿一篇文章讓 Claude 幫你整理研究筆記
    • 啟用 Notion 或 GitHub Plugin,測試一次「從 Skill 輸出到外部工具」的完整工作流
  • NuExtract3:把 PDF 截圖變成乾淨資料

    NuExtract3:把 PDF 截圖變成乾淨資料

    📌 本文重點

    • NuExtract3 專門做「影像 / PDF → 結構化文字」
    • 直接輸出 JSON / Markdown,省掉後續清洗
    • 可自架本地部署,敏感資料不用上雲
    • 用 prompt 自訂欄位 schema,方便接到現有 workflow

    把亂七八糟的 PDF、發票截圖、表格照片,丟進 NuExtract3,就能直接拿到乾淨的 JSON / Markdown 結構化資料,方便你後續丟進 Notion、Google Sheet 或資料庫繼續用。

    官方開源介紹(含 Demo 連結):Reddit:NuExtract3 released


    核心功能:三件事講完 NuExtract3

    1. 多種文件型態,一次搞定

    NuExtract3 是基於 Qwen3.5-4B 訓練的開源多模態模型(Apache-2.0 授權),主打「影像 / PDF → 結構化文字」。實際可以拿來處理:

    • 多頁 PDF:報表、合約、研究報告
    • 發票、收據、報銷單:紙本拍照、掃描檔
    • 表格:Excel 匯出成 PDF、紙本表單的掃描
    • 表單截圖:Google Form 結果頁、線上後台報表截圖

    你只要準備:

    • 一個檔案(PDF / 圖片)
    • 一個「你想要的結構」描述(例如:請輸出成 JSON,欄位有 date、vendor、total_amount)

    就能讓它幫你把畫面裡的內容拉成乾淨結構。

    💡 關鍵: 只要定義好欄位結構,NuExtract3 就能把任何格式雜亂的文件,轉成統一結構的資料,後續處理成本會大幅下降。


    2. 直接輸出 JSON / Markdown,少一個清洗步驟

    NuExtract3 的設計重點不是「純 OCR」,而是「OCR + 結構化輸出」。實際測試時,你可以要求:

    • 輸出 JSON:適合丟進程式、API、資料庫
    • 輸出 Markdown:適合整理筆記、放進 Notion、Obsidian

    例如你給他一張發票照片,提示可以這樣寫:

    你是一個資料錄入助手。從這張發票中擷取欄位,並輸出 JSON:
    {
      "date": "發票日期 (YYYY-MM-DD)",
      "vendor": "商家名稱",
      "invoice_number": "發票號碼",
      "items": [
        {"name": "品項名稱", "quantity": 數量, "unit_price": 單價, "amount": 金額}
      ],
      "subtotal": 小計,
      "tax": 稅額,
      "total": 總金額
    }
    如果沒有某個欄位,填 null。
    

    輸出就會直接是可用的 JSON,不用再寫額外的字串處理把文字拆欄位。


    3. 本地部署,自已控管資料隱私

    NuExtract3 以「開源權重、自架」為主:

    • 模型權重可下載,Apache-2.0 授權,可商用
    • 可以在自己筆電、公司伺服器上跑
    • 不需要把發票、合約等敏感文件上傳到第三方雲端

    你可以先在官方 Hugging Face Space 線上試,用得順手再搬回本地。

    線上 Demo(免註冊):搜「NuExtract3」即可在 Hugging Face Spaces 上找到官方 Space。

    💡 關鍵: 在合約、財務等敏感場景,自架 + 開源授權讓你既能自動化,又不必冒資料外流風險。


    適合誰用:三個典型場景

    1. 財務 / 行政:發票、報銷單半自動錄入

    適用情境:

    • 同事每個月丟一堆發票照片、PDF 報銷單
    • 你要把日期、金額、商家、發票號碼一筆筆打進系統或 Excel

    可以這樣用:

    1. 把所有發票照片存進一個資料夾
    2. 用腳本逐張丟給 NuExtract3,要求輸出統一格式的 JSON
    3. 把 JSON 轉成 CSV,匯入到:
    4. 公司報銷系統
    5. Google Sheet 統計報表

    立即可做的行動:
    – 把你現有的 2–3 張發票/收據,丟進官方 Space,測試能不能抓出你要的欄位(日期/金額/店名)。


    2. 自媒體 / 法務:整理掃描合約、條款重點

    適用情境:

    • 合作合約只有掃描版 PDF
    • 你只關心「合約雙方」「金額」「期限」「解約條件」「付款節點」

    你可以:

    1. 把 PDF 上傳 NuExtract3
    2. 用自然語言指定要的欄位,例如:
    請閱讀這份合約,並用 JSON 回答:
    {
      "party_a": "甲方名稱",
      "party_b": "乙方名稱",
      "contract_term": "合約期間(文字說明)",
      "payment_terms": "付款條件摘要",
      "termination_clause": "解約條款摘要"
    }
    
    1. 把輸出貼進 Notion,或丟給 ChatGPT / 其他 LLM 再做風險檢查

    立即可做的行動:
    – 找一份你平常會反覆查的合約掃描檔,試著用 NuExtract3 生成「合約摘要 Markdown」,看可讀性如何。


    3. 數據分析師:報表、問卷結果結構化

    適用情境:

    • 手上有 PDF 報表、問卷紙本掃描
    • 想要的,是一張可以直接做分析的表格

    使用方式:

    1. 對著一頁表格截圖
    2. 提示要求輸出成「每列一筆紀錄」的 JSON 陣列
    把這頁問卷結果表格,轉成 JSON 陣列,每列是一位受訪者:
    [
      {
        "id": "編號",
        "age": 年齡,
        "gender": "性別",
        "q1": "問題1答案",
        "q2": "問題2答案"
      }
    ]
    
    1. 把 JSON 轉成 CSV 後丟進 Python / R / Excel 分析

    立即可做的行動:
    – 拿一頁報表截圖,試著讓 NuExtract3 幫你還原成表格,再貼進 Google Sheet 看欄位是否正確。


    怎麼開始:五分鐘上手路線

    步驟 0:先線上玩一次(不用裝任何東西)

    1. 打開瀏覽器,前往 Hugging Face Space(搜尋 NuExtract3)
    2. 上傳一張發票 / 合約 / 表格截圖
    3. 在「指令」欄位輸入你想要的輸出格式(JSON / Markdown + 欄位定義)
    4. 看輸出結果是否符合你平常的工作需求

    如果這步已經感覺能用,再考慮搬回本機或公司伺服器。

    💡 關鍵: 先用線上 Demo 驗證「欄位抓得準不準」,再投入時間做 Docker 與腳本整合,能避免白做工。


    步驟 1:在本機 / 伺服器用 Docker 跑起服務

    以下是假設官方提供 Docker 映像的典型流程(實際請以官方 README 為準):

    # 1. 拉取映像
    docker pull numind/nuextract3:latest
    
    # 2. 啟動服務(假設開在 8000 port)
    docker run -d \
      --gpus all \
      -p 8000:8000 \
      --name nuextract3 \
      numind/nuextract3:latest
    

    啟動後通常會有一個簡單 API,例如:

    curl -X POST http://localhost:8000/extract \
      -F "file=@invoice.jpg" \
      -F 'prompt=請擷取發票資訊並輸出 JSON,欄位:date, vendor, total_amount'
    

    回傳的就是 JSON 結果,可以直接被腳本處理。


    步驟 2:用簡單 Python Script 跑推論

    如果你偏好直接在 Python 裡呼叫(例如透過 vLLM / Transformers),典型流程會像這樣(範例示意):

    from PIL import Image
    import requests
    import json
    
    API_URL = "http://localhost:8000/extract"
    
    image_path = "./samples/invoice.jpg"
    prompt = "請從這張發票擷取日期(date)、商家(vendor)、總金額(total_amount),並輸出 JSON。"
    
    files = {"file": open(image_path, "rb")}
    data = {"prompt": prompt}
    
    resp = requests.post(API_URL, files=files, data=data)
    result = resp.json()
    
    print(json.dumps(result, ensure_ascii=False, indent=2))
    

    這段可以直接嵌入到你現有的報表處理、RPA 流程裡。


    步驟 3:自訂你的欄位 schema

    NuExtract3 沒有「固定欄位」,而是靠你的提示(prompt)決定要萃取什麼。實作時可以:

    1. 先在 Notion / Google Sheet 寫好你要的欄位列表,例如:
    2. date
    3. vendor
    4. category
    5. subtotal
    6. tax
    7. total
    8. 在提示裡把這些欄位寫成 JSON 模板,明確說明格式
    9. 要求:
    10. 用固定欄位名稱
    11. 金額用數字,不要加貨幣符號
    12. 缺失欄位填 null

    這樣輸出就更穩定,後續程式處理也比較不容易爆炸。


    步驟 4:組一個簡單 workflow:NuExtract3 + Google Sheet / Notion

    你可以很快做出一個「半自動錄入」流程:

    發票例子:

    1. 把所有發票照片放進 invoices/ 資料夾
    2. 用 Python 跑一個簡單批次處理:
    3. 逐張呼叫 NuExtract3 API
    4. 收集 JSON 結果
    5. 把 JSON 轉成 CSV:
    6. 用 pandas 寫入 Google Sheet(透過 Google API)
    7. 或匯出 CSV 手動上傳

    概念範例:

    import os, json, requests, csv
    
    API_URL = "http://localhost:8000/extract"
    
    rows = []
    for fname in os.listdir("./invoices"):
      with open(os.path.join("./invoices", fname), "rb") as f:
        resp = requests.post(
          API_URL,
          files={"file": f},
          data={"prompt": "請輸出 JSON,欄位:date, vendor, total_amount"}
        )
      data = resp.json()
      rows.append([data["date"], data["vendor"], data["total_amount"]])
    
    with open("invoices.csv", "w", newline="", encoding="utf-8") as fp:
      writer = csv.writer(fp)
      writer.writerow(["date", "vendor", "total_amount"])
      writer.writerows(rows)
    

    Notion 的話,則可以用 Notion API 建立資料庫頁面,把每一筆 JSON 轉成一筆資料列。


    小結:什麼時候值得用 NuExtract3?

    • 你有大量掃描檔、截圖要轉成結構化資料
    • 內容多是表格、發票、收據、合約這類「格式固定但樣式雜」的文件
    • 你在意 資料不能丟到雲端,希望自架

    先在 Hugging Face Space 玩 10 分鐘,如果覺得可用,再花半天把 Docker + 簡單腳本接起來,你就多了一個專門幫你「把亂檔變乾淨資料」的本地工具。

    🚀 你現在可以做的事

    • 上 Hugging Face 搜尋 NuExtract3,用 2–3 張發票或表格截圖測試輸出 JSON / Markdown
    • 在 Notion 或 Google Sheet 列出你常用的欄位 schema,順手寫一個對應的 prompt 模板
    • 在本機用 Docker 跑起 nuextract3,照文中的 curl 或 Python 範例打一次 API,驗證能否接到現有流程
  • 把 NVIDIA Deep Research 當實習生用

    把 NVIDIA Deep Research 當實習生用

    📌 本文重點

    • NVIDIA Deep Research Agent 是「會自己調研與寫報告」的 AI 實習生
    • 能自動上網搜尋、整理來源並產出可追溯的研究報告
    • 以「專案工作空間」形式運作,適合市場研究與技術選型等場景

    用一句話講清楚:NVIDIA Deep Research Agent 就是「會自己上網查資料、存筆記、整理報告、附上引用來源」的 AI 實習生,比一般只能聊天的機器人,更接近一個真的研究助理。

    專案連結(GitHub):https://github.com/NVIDIA/GenerativeAIExamples/tree/main/agents/deep-research


    核心功能:比一般聊天機器人多了什麼?

    1. 會自己規劃調研流程,而不是只回一段答案

    一般聊天機器人:

    • 你問:「幫我看 2024 台灣電動車市場發展?」
    • 它直接生成一段「看起來合理」的摘要,但可能沒查新資料,來源不明。

    Deep Research Agent 的做法:

    1. 先把問題拆成子任務:市場規模、主要品牌、政策、關鍵數據…
    2. 逐步上網搜索,每一步都記錄查到的內容
    3. 整理成「研究筆記檔」,最後再寫成報告

    💡 關鍵: Deep Research 不是只回一段答案,而是走完整「拆題 → 搜尋 → 做筆記 → 成稿」流程。

    你可以做的事:

    • 在 prompt 裡直接下達研究任務,例如:
    • 「請做一份 5 頁的市場研究:主題是台灣 2024 電動車市場,列出主要品牌、市佔估計、最近一年重要新聞,最後整理成簡短建議。」
    • 把它當「會自己查資料的實習生」,而不是問答機器人。

    2. 自動搜尋 + 整理來源,幫你做「可追溯」的研究

    Deep Research Agent 會:

    • 主動呼叫搜尋工具(預設走網路 search API)
    • 讀取多個網站內容,過濾重複與雜訊
    • 把每條資訊連同來源網址存起來
    • 最後在報告中附上清楚引用(像研究報告的 reference 區)

    對比一般聊天機器人:

    • 回答多半是「綜合模型訓練時學到的知識」,很難知道哪一段是最新、哪一段來自哪個來源。

    💡 關鍵: 每個關鍵結論都對應具體網址,讓你可以抽查與追溯,而不是盲目信任模型輸出。

    你可以做的事:

    • 要求它在輸出中固定附上引用區,例如:
    • 「請在每個關鍵結論後標注 [來源 1] [來源 2],並在文末列出完整網址。」
    • 用這些引用,手動抽查 1–2 個關鍵數據,確保內容可信。

    延伸閱讀:NVIDIA 開源介紹文章(Towards AI)
    https://pub.towardsai.net/nvidia-open-sourced-a-deep-research-agent-that-beat-openai-on-its-own-benchmarks-5339b3f547fb


    3. 有「工作空間」的 Agent,而不是沒記憶的聊天框

    很多非程式碼 Agent 做不好,很大原因是沒有穩定工作空間——這點在 Reddit 討論裡講得很清楚:non-coding agents should also live in file systems。

    Deep Research Agent 的設計比較像一個「專案資料夾」:

    • 每個研究任務會形成一組檔案:
    • 原始搜尋結果
    • 中途整理的筆記
    • 最終報告
    • Agent 可以反覆讀寫這些檔案,再繼續深化研究

    💡 關鍵: 用「檔案與專案」當記憶體,讓 Agent 可以多輪迭代深化同一主題,而不是每次從零開始聊。

    你可以做的事:

    • 把每一個「問它的大問題」當成一個專案,例如:
    • project: EV-market-tw-2024
    • project: crm-tools-comparison
    • 把產出的 Markdown 報告直接丟進你的筆記軟體(Obsidian、Notion)當專案檔案。

    適合誰用?幾個實際場景

    1. 市場研究 / 會前簡報

    需求:你要開一場客戶會議,得先快速了解對方產業現況。

    操作示例:

    • 任務描述:
    • 「客戶是做 B2B SaaS CRM 的,幫我整理 2022–2024 全球 B2B CRM 市場趨勢、主要玩家、常見商業模式,最後整理一句話電梯簡報 + 5 項我應該問的問題。」
    • 把 Deep Research Agent 的報告:
    • 直接 copy 成 PowerPoint 大綱
    • 或貼到 Notion,當成會前 brief

    2. 競品分析 / 工具選型

    需求:你在選 CRM、客服系統、A/B test 平台。

    操作示例:

    • 任務描述:
    • 「幫我比較 Intercom、Zendesk、Freshdesk 三個工具,重點看價格方案、支援語言、整合 API 能力,做成表格,最後給出 3 種不同規模公司(10 人、50 人、200 人)的建議。」
    • 你要做的:
    • 把輸出的表格貼進你團隊的提案文件
    • 把引用網址交給實習生或同事做二次驗證

    3. 技術選型調研

    需求:你在選擇 LLM、RAG 架構或 MCP agent 框架要上線到產品(可參考這篇實戰文:https://pub.towardsai.net/i-shipped-a-rag-mcp-agent-to-production-five-things-broke-0f030ff6f3f9)。

    操作示例:

    • 任務描述:
    • 「整理目前主流的 RAG + MCP agent 開源方案,要求列出:GitHub 星數、是否支援雲端 / 本地部署、常見踩坑與評估建議,重點對象是要上 production 的 SaaS 團隊。」
    • 接著你可以:
    • 用報告當作技術評估會議的初稿
    • 在每個風險點上再請 Deep Research Agent 深挖,反覆迭代。

    怎麼開始:從安裝到接上你的知識庫

    1. 準備環境與 API Key

    最低需求:

    • Python 3.10+ 環境(本機或雲端都可)
    • 一張 NVIDIA GPU 會更順(但也可只用雲端 API)
    • 至少一個可用的 LLM API Key,例如:
    • NVIDIA NIM / NVIDIA API
    • 或其他支援的雲端模型供應商

    你要做的事:

    1. 申請 NVIDIA API 帳號(若使用他們的模型):https://build.nvidia.com
    2. 拿到 API Key,寫入 .env 或環境變數,例如:

    bash
    export NVIDIA_API_KEY="你的 key"


    2. 安裝與在本機快速跑起來

    以 GitHub 專案為主線:

    git clone https://github.com/NVIDIA/GenerativeAIExamples.git
    cd GenerativeAIExamples/agents/deep-research
    
    # 建議開一個虛擬環境
    python -m venv .venv
    source .venv/bin/activate  # Windows 用 .venv\Scripts\activate
    
    pip install -r requirements.txt
    

    通常範例專案會提供一個 demo 指令(名稱可能略有變化,依 README 為準):

    python deep_research.py \
      --query "請分析台灣 2024 電動車市場的主要趨勢與廠商" \
      --output ./outputs/ev-market-tw-2024.md
    

    你要做的事:

    • 改掉 --query 裡的內容,直接換成你現在真正在做的專案題目
    • 執行後,到 outputs/ 夾裡打開 Markdown 報告

    3. 在雲端(Colab / VS Code Remote)跑

    如果你本機沒有 GPU 或懶得裝環境,可以:

    • 找一份針對 NVIDIA Deep Research Agent 的 Colab notebook(通常社群會有人整理)
    • 或在雲端 VM(如 AWS、GCP、Azure)裡跑上述安裝流程

    你要做的事:

    • 儲存好 notebook,當成你的「研究模板」
    • 每次只改問題與輸出檔名,就能重複使用。

    4. 串接到你的筆記 / 知識庫工作流

    目標:建立一條「從問題 → 調研 → 報告」的固定管線。

    最簡單做法:

    1. 輸出格式固定用 Markdown:
    2. 在啟動腳本中加入:--format markdown(若有此選項)
    3. 指定輸出資料夾對應到筆記工具:
    4. Obsidian:把 outputs/ 變成一個 vault 內的資料夾
    5. Notion:用 Notion API 定期把 outputs/*.md 同步上去
    6. 在筆記裡建立「研究模版」:
    7. 標題:{{專案名稱}} Deep Research 報告
    8. 區塊:背景、發現、數據表、風險、建議、來源連結

    你可以立刻做的事:

    • 為你接下來一週要決定的「一個重要選項」(例如要不要換 CRM)建一個專案資料夾
    • 用 Deep Research Agent 生成第一版調研報告
    • 用你自己的專業重新整理重點後,發給團隊當決策前閱讀材料。

    小結:把它當「會查資料的實習生」,而不是魔法

    使用 NVIDIA Deep Research Agent 的正確心態:

    • 它擅長的是幫你大量收集與初步整理,節省你 60–80% 搜集資料的時間
    • 你仍然要:
    • 選題、定義問題
    • 抽查關鍵引用
    • 把輸出整理成真正要對外發表的報告或簡報

    💡 關鍵: 把 60–80% 搜資料的時間交給 Agent,你可以把精力放在判斷與決策上。

    只要先從一個你本來就要做的調研開始,你很快就會感受到,把 AI 當實習生用,和「只是多一個聊天機器人」有多大差別。

    🚀 你現在可以做的事

    • 打開 GitHub 專案並依照 README 完成安裝,跑一次示範指令
    • 挑一個你這週真的要做的決策議題,寫成 --query 給 Deep Research Agent
    • 把產出的第一版報告整理進 Obsidian 或 Notion,當作團隊會議前閱讀材料
  • RTK 終端機 AI 助手:少花 90% Token

    RTK 終端機 AI 助手:少花 90% Token

    📌 本文重點

    • RTK 用結構化壓縮幫你減少重複丟給模型的 Token
    • 常用專案可重用上下文,問越多次平均越省
    • 在終端開發流程中無痛接入,五分鐘內可上手

    你現在用 AI 幫忙寫程式,很可能有一大半錢都燒在「重複丟給模型看的 Token」上,而 RTK 要做的,就是在終端機幫你把這些多餘 Token 全部擠乾。

    專案連結:https://github.com/rtk-ai/rtk


    核心功能:RTK 怎麼幫你少丟 Token?

    1. Prompt 壓縮:把廢話變成精簡結構

    一般你在終端機複製錯誤訊息、整段程式碼給 AI,看起來沒幾行,實際 Token 超多。RTK 做的事是:

    • 先在本地做「結構化」:分出錯誤訊息、檔案片段、指令上下文
    • 用短 Prompt 模板描述需求,例如:
    • 錯誤訊息 + 詢問目標(幫我找 bug)
    • 這段程式 + 修改要求(改成 async)
    • 最後送給模型的內容會是高度壓縮的結構,而不是你手動貼的一大坨文字

    你可以這樣行動:

    • 不要再打長篇自然語言 Prompt,改用 RTK 的命令別名(例如 rtk fix, rtk explain),把「要做什麼」交給 RTK 的模板處理。

    2. 上下文重用:同一個專案不重講第二次

    平常你每問一次 AI:「這個專案是做什麼的?」「這個模組是幹嘛?」都在重複付費。RTK 會:

    • 對常問的目標(例如某個目錄、特定檔案)做一次「結構化摘要」
    • 接下來跟同一個會話相關的指令,就重用這些摘要,而不是把整份檔案再丟一次

    具體效果:

    • 問同一個 repo 的問題越多次,平均每次的 Token 消耗越低
    • 對超過數萬行的專案,差異會特別明顯

    💡 關鍵: 專案越大、問越多次,RTK 的上下文重用機制帶來的平均 Token 成本下降就越明顯。

    你可以這樣行動:

    • 針對常用專案建立一個 RTK 會話,之後都在這個會話裡問問題,而不是每次都「一次性丟完所有檔案」。

    3. 結構化輸入 / 輸出:減少「看懂答案」的成本

    RTK 不只壓縮你給模型的內容,也會讓模型的回答更結構化,例如:

    • 要求模型輸出固定格式:原因 / 修復步驟 / 建議指令,而不是亂聊一通
    • 要模型只返回「要改的那幾行」,而不是整份檔案,減少輸出 Token

    你可以這樣行動:

    • 習慣用 RTK 指令,而不是「請用條列式說明」這種自然語言;RTK 已經替你定義好能省 Token 又好讀的輸出格式。

    RTK 當 CLI 代理:三種高頻使用場景

    1. 日常開發:錯誤訊息、修小段程式、產生命令

    在日常開發中,你大概會一直做這幾件事:

    1. 看錯誤訊息:不知道哪裡爆
    2. 改小段程式:加 log、改型別、改函式簽名
    3. 產生命令:不知道某個工具的 CLI 參數要怎麼下

    RTK 的典型玩法:

    • 看錯誤訊息

    bash
    # 把上一個命令的錯誤訊息丟給 RTK 解釋
    some-command-that-fails 2>error.log
    rtk explain-error < error.log

    行動:把原本你會貼到 ChatGPT / Claude 的 error log,改成用 rtk explain-error,RTK 會用短 Prompt + 結構化提問幫你省 Token。

    • 改小段程式

    bash
    # 針對某個檔案的一小段範圍做修改建議
    rtk edit src/main.rs --range 20-60 --ask "改成 async/await 風格,保留原本邏輯"

    行動:只給 RTK「相關的幾十行」,不要整支檔案,RTK 會幫你把上下文描述給模型,降低 Token。

    • 產生命令

    bash
    # 根據需求生成 shell 指令,不用自己翻 man page
    rtk cmd "把 logs 資料夾裡 7 天前的 .log 壓成一個 tar.gz,檔名帶日期"

    行動:用自然語言描述「你想做什麼」,讓 RTK 負責用精簡 Prompt 跟模型談,輸出最終的 shell 指令。


    2. 讀專案:總結檔案、生成說明、快速問代碼

    當你接手一個新 repo,通常會做:

    • 看 README 還是不懂整體架構
    • 想知道某個模組的職責
    • 想快速問「這個函式在哪裡用到」

    RTK 的用法可以是:

    • 總結檔案 / 目錄

    “`bash
    # 總結一個檔案在幹嘛
    rtk summarize src/lib.rs

    # 總結一個目錄的主要模組與職責
    rtk summarize src/handlers/
    “`

    • 生成說明文件

    bash
    # 幫某個模組產生說明文字(例如供 PR 或文件用)
    rtk doc src/services/user.rs --format markdown

    • 快速問代碼

    bash
    # 在 repo 裡問問題,RTK 只會選關聯檔案給模型看
    rtk ask "登入流程中,token 驗證主要在哪幾個檔案處理?"

    行動:把「整個 repo 丟進 AI」改成「用 rtk summarize 和 rtk ask 針對性查詢」,每次只給必要檔案,Token 消耗會明顯下降。


    3. 結合 tmux / fzf / git workflow:變成隨叫隨用 AI 幫手

    RTK 的本質是單一 CLI binary,很適合跟你現有的終端機工具整合:

    • 搭配 tmux:固定一個 pane 做 RTK 聊天視窗

    bash
    # tmux 裡開一個新 pane 專門跑 rtk chat
    rtk chat

    行動:在 tmux 裡維持一個長期會話,RTK 可以反覆重用上下文,越聊越省 Token。

    • 搭配 fzf:選檔後丟給 RTK

    bash
    # 用 fzf 選一個檔案丟給 RTK 總結
    rtk summarize "$(fzf)"

    • 搭配 git workflow:讓 AI 看 diff 而不是整檔

    bash
    # 只把當前變更的 diff 丟給 RTK 請他協助寫 PR 說明
    git diff > /tmp/diff.patch
    rtk explain-diff < /tmp/diff.patch

    行動:在你的 shell 設定(例如 .zshrc 或 .bashrc)裡建立幾個 alias,把平常會複製貼上的工作改用 RTK 處理:

    alias rpr="git diff | rtk explain-diff"
    alias rerr="rtk explain-error"
    

    適合誰用?三種典型開發者

    • 1. 每天都開著 AI 編輯器(Cursor、Claude Code)的工程師
      你已經習慣「寫一寫就問 AI」,RTK 適合接在你終端機工作流的空白處:看 log、看 diff、產生命令,這些在編輯器之外的操作用 RTK 承接,Token 花在真正需要的地方。

    • 2. 維護大型專案或多 repo 的開發者
      尤其是 Rust / Java / monorepo,檔案多、型別長、錯誤訊息又臭又長,用 RTK 的結構化摘要 + 上下文重用,可以顯著減少「每次都要把半個專案丟給 AI」的情況。

    • 3. 自費用 API Key 的個人開發者 / Side project 作者
      如果你是自己刷卡買 OpenAI / Anthropic / 其他 LLM Token,用 RTK 是直接對帳單有感的程度;原本一個月 30–50 美金的,也許可以壓到 10–20 美金。

    💡 關鍵: 若你自己付模型費,用 RTK 把「貼錯誤 / 貼整檔 / 貼 diff」改成結構化對話,帳單級別的節省會非常直接。


    5 分鐘開始用 RTK:安裝、設定、跑幾個指令

    1. 安裝單一 binary

    到 GitHub Releases 頁下載對應平台的 binary:

    • 進入 https://github.com/rtk-ai/rtk
    • 點選右側 Releases
    • 下載對應系統檔案(例如 rtk-x86_64-unknown-linux-gnu、rtk-aarch64-apple-darwin)
    • 賦予執行權限並放到 PATH 裡,例如:
    chmod +x rtk-x86_64-unknown-linux-gnu
    sudo mv rtk-x86_64-unknown-linux-gnu /usr/local/bin/rtk
    

    2. 設定 API Key

    RTK 本身不附模型,你需要設定自己的 LLM 供應商 API key(例如 OpenAI / Anthropic 等,依官方文件為準):

    export OPENAI_API_KEY="你的 key"
    # 或依照 RTK 說明設定 RTK 專用環境變數,例如:
    export RTK_MODEL_PROVIDER=openai
    export RTK_MODEL=gpt-4.1-mini
    

    建議:

    • 選一個便宜的小模型當預設(例如 gpt-4.x-mini / o3-mini 類型),RTK 本身就已經會幫你省 Token,小模型更划算。

    💡 關鍵: 把 RTK_MODEL 設成較便宜的小模型,再搭配 Prompt 壓縮,能在不明顯犧牲效果的前提下把成本再壓一截。


    3. 試跑幾個典型指令

    照著下面三步走,你大概五分鐘內就能感受到 RTK 的節奏:

    1. 解讀錯誤訊息

    bash
    cargo build 2>error.log
    rtk explain-error < error.log

    1. 總結專案主檔案

    bash
    rtk summarize src/main.rs

    1. 生成一個命令

    bash
    rtk cmd "找出今天修改過的 .rs 檔,列出檔名和變更行數"


    怎麼量化:你到底省了多少 Token?

    如果你是自己付費買 API,建議直接用「帳單」來感受 RTK 的效果,而不是只看官方說的 60–90%。你可以:

    1. 先觀察一週的原始用量
    2. 不改工作流程,照常用 Cursor / Claude Code / ChatGPT 開發
    3. 記下這週在模型供應商後台的 Token 用量 / 金額

    4. 下一週加上 RTK

    5. 日常 terminal 問題全部改用 RTK(錯誤、log、diff、命令)
    6. 大型專案閱讀改用 rtk summarize 和 rtk ask

    7. 對比兩週帳單

    8. 如果你平常大量貼錯誤訊息、整檔 code、diff 給 AI,看起來會有 30–50% 甚至更多的節省

    進階做法:

    • 把 RTK 指令加上 --verbose 或開啟 debug log(依官方說明),讓它輸出實際的 Token 用量,對照供應商後台的數字,清楚看到壓縮前後的差異。

    RTK 的重點不是「多一個聊天機器人」,而是把你原本就會做的事——貼錯誤、貼代碼、貼 diff 問 AI——改成一種對 Token 比較友善的方式。如果你現在已經很依賴 AI 寫程式,那麼把這些對話搬進 RTK,大概是最省時、也最省錢的下一步。

    🚀 你現在可以做的事

    • 進入 RTK GitHub Releases 下載對應平台的 rtk binary 並加入 PATH
    • 在 shell 設定中加入 OPENAI_API_KEY 與 RTK_MODEL 等環境變數,設好預設小模型
    • 建立幾個常用 alias(例如 rerr, rpr),並用 rtk explain-error、rtk summarize 開始取代貼到聊天機器人的動作
  • 用 Claude.md 做一個不會爛掉的長跑代理

    用 Claude.md 做一個不會爛掉的長跑代理

    📌 本文重點

    • 用 CLAUDE.md 嚴格約束代理行為,避免長跑爛掉
    • 核心原則是「行動+證據」,禁止空談與無限迴圈
    • 透過上下文壓力自查與簡潔憲法,讓代理長時間穩定運作

    用一份不到 100 行的 CLAUDE.md,就能讓你的 Claude 代理連跑幾小時都不會開始胡言亂語、卡住不動或重複修同一個 bug。

    參考原作者在 Reddit 的分享:
    – 長跑 Claude Code 代理的設定檔開源文:https://www.reddit.com/r/ClaudeAI/comments/1tjy3sk/i_opensourced_the_operating_file_that_keeps_my/
    – 100 條個人 AI 代理實戰心得:https://www.reddit.com/r/ClaudeAI/comments/1thi6nh/100_tips_tricks_for_building_your_own_personal_ai/


    核心功能:這份 CLAUDE.md 到底做了什麼?

    1. 只允許「行動與證據」,禁止長篇空談

    長跑代理會爛掉,通常是這三個症狀:

    1. 開始寫「我將會…」「接下來我要…」但不真的執行工具
    2. 一直說「應該已修好」但沒有測試結果
    3. 花很多篇幅重複解釋計畫,實際變更很少

    CLAUDE.md 的核心規則,就是把這些行為全部關掉:

    • 輸出只允許三種型態:
    • 已完成的動作(例如:檔案修改、指令執行、API 呼叫)
    • 具體問題 / 需要決策的提問
    • 極短的進度摘要
    • 聲稱「完成」前要附證據:如測試輸出、報表截圖路徑、命令列結果

    💡 關鍵: 將輸出限制為「行動+證據」,能大幅減少長篇空談與無效迴圈,讓長跑代理真正持續推進任務

    你可以做的事:
    – 在你的專案根目錄放一份 CLAUDE.md,明確寫出:
    – 「不要描述你要做什麼,只要直接做並回報結果」
    – 「任何『應該已修好』前,必須貼出測試輸出」

    2. 內建「上下文壓力」自我檢查

    長跑幾小時後,對話上下文會變超長,Claude 開始:

    • 忘記早期需求
    • 無法把握目前專案狀態
    • 回答變模糊或重覆

    原作者在 CLAUDE.md 裡加了一條關鍵原則:

    代理要定期自查上下文壓力:發現自己搞不清狀態,就主動整理摘要、刪除多餘上下文、或要求人類幫它重設現狀。

    具體做法通常包含:

    • 每完成一個階段任務,就輸出一個「短摘要 + 關鍵檔案清單」
    • 長度過大時,優先保留:
    • 最新的決策
    • 目前版本的檔案 / 結構
    • 尚未完成的待辦

    你可以做的事:
    – 在 CLAUDE.md 寫明:
    – 「當你感覺自己不確定目前狀態時,先輸出一份 10 行內的現況摘要,再繼續工作。」
    – 「如需要,可要求人類提供『目前唯一真實狀態』說明,並用這份說明覆蓋舊假設。」

    3. 任務憲法:不靠「一長串 Prompt」,靠幾條簡潔原則

    多數人用代理會寫一大段 prompt,結果 Claude 讀不完、也記不住。CLAUDE.md 的思路是:

    • 用 10–20 條簡短規則,定義這個代理的「憲法」
    • 每條都要能對應到實際行為約束,例如:
    • 「若有工具可以做某事,優先用工具,不要手寫模擬輸出」
    • 「對同一錯誤連續嘗試 3 次仍失敗,就停下來請人類決策,不要無限迴圈」

    💡 關鍵: 把 10–20 條行為規則寫成固定「憲法」,比灌輸一大段單次 prompt 更能在長跑中維持穩定行為

    參考 Reddit 另一篇實戰文:https://www.reddit.com/r/ClaudeAI/comments/1thi6nh/100_tips_tricks_for_building_your_own_personal_ai/

    你可以做的事:
    – 先列出你的代理最常「爛掉」的 3 個行為,逐條寫進 CLAUDE.md,用「禁止 / 應改為」的格式:
    – 「禁止:連續兩次貼出幾乎相同的錯誤訊息。應改為:第二次失敗時,整理你已試過的方法,請人類選下一步。」


    適合誰用:3 個實戰場景

    1. 單機腳本型代理:排程任務、批次資料處理

    你有這些需求時,很適合:

    • 每晚跑一次報表轉檔腳本
    • 每週整理一批 CSV / Excel 檔,把欄位標準化
    • 定期爬某個網站的資料、存到本地或資料庫

    做法:

    1. 用 Claude Code 或本地腳本,讓代理可以:
    2. 讀寫特定資料夾
    3. 執行 shell 指令(或以 PowerShell / bash 包一層)
    4. 把 CLAUDE.md 放在專案根目錄,寫清楚:
    5. 允許改動哪些檔案
    6. 批次任務完成的判定方式(例如輸出檔案數量、檔名規則)
    7. 用排程工具觸發:
    8. macOS / Linux:cron 或 systemd timer
    9. Windows:排程工作排程器 + 命令列啟動代理腳本

    2. 長連線開發代理:Claude Code / VS Code / Cursor 類工作流

    如果你常用 Claude 來寫程式、改大型專案,長時間開著一個 session,很容易出現:

    • 忘記三小時前的設計決定
    • 重複修同一支檔案
    • 一直在講解架構,但實際 commit 很少

    這時 CLAUDE.md 非常好用:

    實際操作:

    1. 在 VS Code 專案根目錄新增 CLAUDE.md,內容包含:
    2. 專案簡述
    3. 允許的工具(例如:跑測試、執行 npm test、pytest 等)
    4. 「行動 > 敘述」與「證據 > 猜測」等規則
    5. 在 Claude Code / Cursor 內重新開啟專案,確保代理會讀到這個檔案
    6. 開發時明確下指令:
    7. 「請遵守 CLAUDE.md,連續工作直到完成以下任務…」
    8. 「每完成一個子任務,產出最多 5 行的進度摘要」

    進階:也可以搭配多代理流程,參考:https://www.reddit.com/r/ClaudeAI/comments/1thi16y/how_i_built_a_9agent_team_where_my_agents/

    3. 自建小型自動化服務:抓報表、清理資料

    你想做一些「半自動」小工具,例如:

    • 每週自動登入內部系統下載報表
    • 讀取資料夾裡的新檔案,做資料清洗 / 格式標準化
    • 根據最新資料,產出簡短摘要寄 Email

    可用的整合方式:

    • MCP / shell 指令:
    • 透過 Model Context Protocol 暴露一組工具給 Claude,例如:
      • list_files, read_file, run_command
    • 規則寫進 CLAUDE.md:

      • 「處理檔案時,一律用工具列出檔名,不要從記憶猜」
    • Power Automate:

    • 由 Power Automate 排程觸發 HTTP / CLI,呼叫你的 Claude 代理後端
    • 回傳的結果可再串 Outlook 寄信、寫入 Excel、更新 SharePoint

    你可以做的事:
    – 先選一個最小自動化任務,例如「每週整理銷售報表」,只把這一個流程寫入 CLAUDE.md,確保跑穩,再慢慢加其他任務。


    10 分鐘上手:從 fork 到跑起你自己的代理

    以下是一條「10 分鐘內能動起來」的最短路徑,你可以依你使用的工具微調。

    Step 1:fork 開源專案

    1. 前往 Reddit 原文查看作者提供的 repo(通常會在貼文內):https://www.reddit.com/r/ClaudeAI/comments/1tjy3sk/i_opensourced_the_operating_file_that_keeps_my/
    2. 在 GitHub 上 fork 到自己的帳號
    3. 本地 git clone 下來

    Step 2:複製 CLAUDE.md 到你的專案

    1. 打開作者的 CLAUDE.md,通讀一遍規則
    2. 複製到你自己的專案根目錄
    3. 只做三種修改:
    4. 把專案描述改成你的任務(例如:財報整理、數據清洗、網站爬蟲)
    5. 調整允許使用的工具(例如是否允許 rm / 刪檔)
    6. 加上 2–3 條你最在意的「不准爛掉」條款

    💡 關鍵: 只動專案描述、工具白名單與 2–3 條關鍵禁令,能在 10 分鐘內把通用 CLAUDE.md 變成專屬代理憲法

    Step 3:綁定你常用的工作環境

    依你用的平台選一條:

    • Claude Code / VS Code / Cursor:
    • 在這個專案資料夾內開啟編輯器
    • 確認工具(跑測試、shell、檔案操作)已啟用
    • 對 Claude 說:「請讀 CLAUDE.md 並照裡面的規則長時間工作」

    • MCP + shell 指令:

    • 建立一個 MCP server,提供 run_shell, read_file, write_file 等工具
    • 在 CLAUDE.md 明確寫出「所有系統操作一律經由 MCP 工具」
    • 用你偏好的前端(例如自寫 CLI、簡單 Web)呼叫 Claude

    • Power Automate / 其他自動化:

    • 建一個小型後端服務(可用 Python FastAPI / Node.js)包住 Claude API
    • 後端每次呼叫 Claude 時,都把專案檔案+CLAUDE.md 帶入 context
    • 用 Power Automate 定期觸發這個 API

    Step 4:跑一個「能觀察的」任務,調整規則

    1. 選一個 30–60 分鐘的任務給代理連續跑(例如重構某一個資料夾的程式碼)
    2. 觀察:
    3. 什麼時候開始廢話變多?
    4. 哪種情況會卡在同一個錯誤?
    5. 直接把這些「失敗模式」寫回 CLAUDE.md 變成新條款

    重複兩三輪,你會得到一份專屬於你工作流、而且真的能「長跑不爛」的代理憲法。


    小結:先管好行為,再管工具

    長跑 AI 代理很容易越跑越爛,通常問題不在模型,而在缺乏清楚的行為規則。透過一份設計良好的 CLAUDE.md:

    • 把輸出限制在「行動+證據」
    • 讓代理主動監控上下文壓力
    • 用幾條簡單原則當作「憲法」

    你可以在單機腳本、開發環境、多工具自動化裡,得到一個穩定得多的 Claude 代理。

    建議從今天開始:先為你最常用的一個專案寫一份 CLAUDE.md,跑一個完整任務,看看它能連續跑多久還保持專注。那會是你感受到「長跑代理真的可用」的第一步。

    🚀 你現在可以做的事

    • 在一個常用專案根目錄新建 CLAUDE.md,寫入「行動+證據」與上下文自查規則後實際跑一次長任務
    • 從 Reddit 原文 fork 作者 repo,閱讀並複製其中 CLAUDE.md,依你的工作流做 2–3 處客製調整
    • 列出你代理常見的 3 個「爛掉模式」,逐條轉寫成禁止條款加進 CLAUDE.md,並在下一次工作中觀察效果