標籤: 本地部署

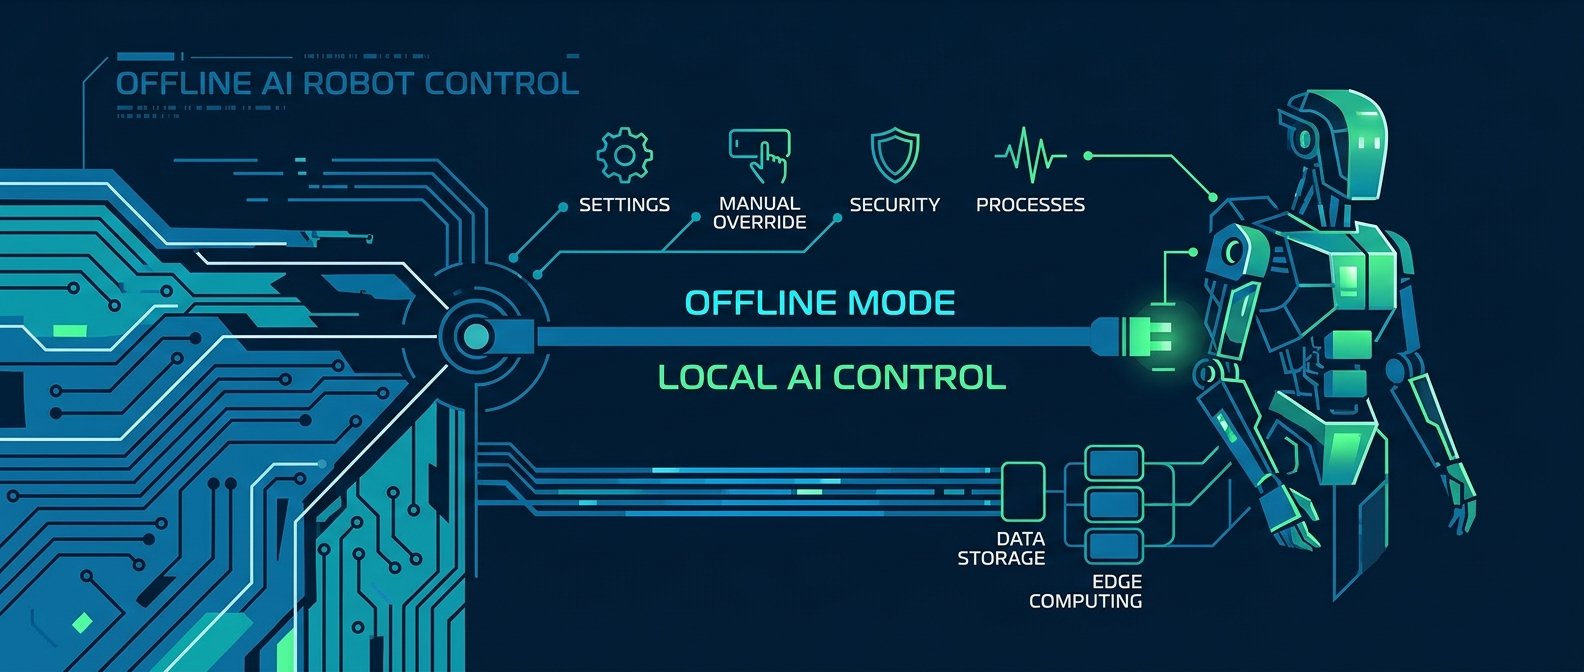
  • 用瀏覽器跑 Gemma 4 控機器人

    用瀏覽器跑 Gemma 4 控機器人

    📌 本文重點

    • 只用瀏覽器即可完全離線跑 Gemma 4
    • 結合 WebSerial 可直接控制機器人與 IoT
    • 純前端即可實作迷你 AI agent 控制硬體

    不想把資料丟雲端、又想用 LLM 控機器人?Gemma 4 + Transformers.js + WebGPU 讓你只靠瀏覽器就能離線跑模型、還能直接控制硬體。

    參考實作影片:Gemma 4 fully offline + WebGPU + Reachy Mini(Reddit)
    https://www.reddit.com/r/LocalLLaMA/comments/1ta9mmd/gemma_4_running_fully_offline_on_webgpu_with/


    核心功能:一台電腦 + 一個瀏覽器就夠

    1. 完全離線的瀏覽器 LLM

    這套組合的核心是:

    • Gemma 4:Google 開源 LLM 系列,支援多種量化格式(GGUF / ONNX / JS)。
    • Transformers.js:在瀏覽器裡跑 Hugging Face 模型的 JavaScript 函式庫。
    • WebGPU:用你電腦的顯示卡在「前端」跑推理,不用後端伺服器。

    你可以做的事:

    1. 在本機開啟支援 WebGPU 的瀏覽器(Chrome / Edge / Brave)。
    2. 把公司文件、程式碼丟進前端頁面,讓 Gemma 4 在本機推理,不經過任何外部 API。

    實際效果:隱私資料留在電腦裡,沒有雲端 API log,也不需要申請 OpenAI Key 或部署後端。

    💡 關鍵: 只要一台支援 WebGPU 的電腦與瀏覽器,就能完成完全離線、無雲端依賴的 LLM 推理與控制。


    2. 透過 WebSerial 控制機器人 / IoT

    Reddit 的 demo 裡,用 Transformers.js 跑 Gemma 4,搭配 WebSerial API 直接控制 Reachy Mini 機器人。

    流程概念:

    1. 使用者在瀏覽器輸入:「向右揮手打招呼」。
    2. Gemma 4 把自然語言轉成一段控制指令(例如 JSON 或簡單 DSL)。
    3. JavaScript 把指令透過 WebSerial 傳給機器人控制板(例如 Arduino / microcontroller)。

    你可以照做的行動:

    • 先用 Arduino + USB 線,把一顆 LED 或伺服馬達接到電腦。
    • 寫個簡單的序列通訊協議,像:LED_ON、LED_OFF、SERVO:45。
    • 在網頁裡用 JavaScript:

    js
    const port = await navigator.serial.requestPort();
    await port.open({ baudRate: 115200 });
    // 把 LLM 產生的指令寫進 serial

    先從「LLM 控燈」,再慢慢升級到「LLM 控機器人手臂」。


    3. 純前端的迷你 AI Agent

    有了本地 LLM + WebSerial,你可以在瀏覽器裡做一個小型 AI agent。

    • 理解任務:使用者輸入「每 10 分鐘幫我量一次溫度」。
    • 規劃步驟:Gemma 4 產生一段 JSON 計畫,例如:

    json
    {
    "action": "loop",
    "interval": 600,
    "task": "read_temp"
    }

    • 執行控制:前端 JS 解析 JSON,呼叫對應的 serial 指令。

    可以做的練習:

    1. 先讓 LLM 只輸出固定格式 JSON(用 system prompt 約束)。
    2. 前端寫一個 parser,檢查 JSON 格式合法才發送給硬體。
    3. 加上「模擬模式」(不連接硬體),先在 console 測試 agent 邏輯。

    適合誰用?三種場景舉例

    1. 教學場景:高中 / 大學生的 AI + 機器人課

    • 不用架伺服器,電腦教室只要能開 Chrome。
    • 學生可以:
    • 改 prompt 看機器人動作改變。
    • 寫自己的小指令語言(例如 MOVE LEFT 10)。
    • 觀察 LLM 如何把自然語言轉成這套語言。

    行動建議:

    • 用一台 Reachy Mini 或任何 Arduino 小車當教材。
    • 提供學生一個預先寫好的 HTML + JS 專案,只讓他們改 prompt 和指令 mapping。

    2. 實驗場景:研究邊緣運算 / 隱私的工程師

    • 需要在醫療、工廠、或無網路環境下跑 LLM。
    • 想測試「模型就在裝置上」的延遲和可靠性。

    行動建議:

    • 把現有的 Python LLM pipeline,拆成:
    • 前端:Transformers.js + WebGPU 跑推理。
    • 後端(選配):只收集匿名統計,不傳原始輸入。
    • 對比雲端 API 與本地推理在速度、穩定度上的差異。

    💡 關鍵: 在醫療或工廠等高隱私、高可靠場景,本地 LLM 能在不傳輸原始資料的情況下提供近乎即時的推理與控制。


    3. 家用場景:DIY 簡易家電自動化

    • 例如:
    • 「用自然語言控制窗簾、風扇」
    • 「讓 LLM 幫你排家中設備的定時腳本」

    行動建議:

    • 先用 USB 連接一塊 ESP32 / Arduino 開發板,只控制一顆繼電器或 LED。
    • 設計簡單語句:
    • 「晚上 10 點關燈」→ 轉成 SCHEDULE:22:00:OFF。
    • 用 LLM 把上面這種語句自動產生,再由 JS 解讀和排程。

    怎麼開始:從開啟 WebGPU 到控制第一顆 LED

    步驟一:開啟瀏覽器 WebGPU

    以 Chrome 為例:

    1. 更新到最新版(至少 120 以上會較穩定)。
    2. 在網址列輸入 chrome://flags。
    3. 搜尋「WebGPU」,啟用:
    4. WebGPU(或 Unsafe WebGPU 視版本而定)。
    5. 重新啟動瀏覽器。

    行動檢查:


    步驟二:從 Hugging Face 抓 Gemma 4 模型

    常見三種格式:

    格式 名稱示例 特點 適合誰
    GGUF gemma-4b-it-q4_0.gguf 量化後較小,適合 CPU/GPU 混合 已熟悉 ggml / llama.cpp 生態的人
    ONNX gemma-4b-it.onnx 通用,很多推理引擎支援 想跨平台跑推理的開發者
    JS Transformers.js 專用權重 直接在瀏覽器載入 前端工程師、想快速起跑的人

    操作建議:

    1. 到 Hugging Face 搜尋「Gemma 4」模型庫(例如 google/gemma-2-2b-it,實際名稱依官方更新為準)。
    2. 找到有 transformers.js 或 onnx 標籤的 repo。
    3. 把權重檔放在自己的靜態網站(或本機 dev server)供前端載入。

    Transformers.js 官方文件:
    https://huggingface.co/docs/transformers.js

    💡 關鍵: 透過 Transformers.js 專用權重,可直接在瀏覽器載入 Gemma 4,省去自建推理後端的成本與複雜度。


    步驟三:在瀏覽器跑起簡單 Chatbot

    最低限度的前端結構:

    <script type="module">
      import { pipeline } from '@xenova/transformers';
    
      const chat = await pipeline('text-generation', 'path/to/gemma4/model');
    
      async function ask(prompt) {
        const out = await chat(prompt, { max_new_tokens: 128 });
        console.log(out[0].generated_text);
      }
    
      ask('你現在是一個 Arduino 助理,請用 JSON 說明如何讓 LED 閃爍。');
    </script>
    

    行動建議:

    • 先在 console 裡確認模型可以正常回答,再加上簡單的 <textarea> + <button> 當聊天介面。

    步驟四:把 Chatbot 接到 WebSerial(Arduino)

    1. Arduino 端草稿:

    “`cpp
    void setup() {
    Serial.begin(115200);
    pinMode(13, OUTPUT);
    }

    void loop() {
    if (Serial.available()) {
    String cmd = Serial.readStringUntil(‘\n’);
    if (cmd == “LED_ON”) digitalWrite(13, HIGH);
    if (cmd == “LED_OFF”) digitalWrite(13, LOW);
    }
    }
    “`

    1. 前端 WebSerial + LLM:

    “`js
    async function connectSerial() {
    const port = await navigator.serial.requestPort();
    await port.open({ baudRate: 115200 });
    const writer = port.writable.getWriter();
    return writer;
    }

    async function sendCommandFromLLM(userText, writer) {
    const response = await chat(使用者的指令:${userText}
    請只回應一行指令,LED_ON 或 LED_OFF
    );
    const cmd = response[0].generated_text.trim();
    await writer.write(new TextEncoder().encode(cmd + ‘\n’));
    }
    “`

    1. 實際試用:

    2. 在頁面輸入「開燈」→ LLM 產生 LED_ON → 燈亮。

    3. 在頁面輸入「關燈」→ LLM 產生 LED_OFF → 燈熄。

    這就是從「純前端 LLM」到「瀏覽器裡的迷你 AI agent」的第一步。


    小結:從簡單控制開始,一步步加功能

    建議的練習路線:

    1. 第一階段:在瀏覽器跑起 Gemma 4 chatbot,確認 WebGPU 正常。
    2. 第二階段:用 WebSerial 控制一顆 LED 或一個伺服馬達,先用固定按鈕測試。
    3. 第三階段:讓 LLM 產生中介指令(JSON 或簡單 DSL),由 JS 驗證後再送給硬體。
    4. 第四階段:加入簡單記憶和排程,做出「瀏覽器內的小型 AI agent」。

    只要一台支援 WebGPU 的電腦、一顆開發板,就能在客廳或教室裡體驗「完全離線的 LLM 控機器人」。


    🚀 你現在可以做的事

    • 到 Hugging Face 下載一個支援 Transformers.js 的 Gemma 4 模型,放到本機靜態伺服器測試載入
    • 依文中示例寫一個最簡單的前端 Chatbot,確認在你的瀏覽器上能透過 WebGPU 正常推理
    • 準備一塊 Arduino 或 ESP32,照示例建立 LED_ON / LED_OFF 協議,實作第一個「LLM 控燈」實驗
  • 本地 AI 代理寫程式,也要有 AI 幫你審 PR

    本地 AI 代理寫程式,也要有 AI 幫你審 PR

    📌 本文重點

    • AI 寫程式一定要搭配 AI 審查流程
    • adamsreview 提供多代理、分階段 PR 審查
    • React Doctor 專治 AI 產出的 React 小雷
    • 組合成「AI 寫 + AI 審 + 人類決策」完整 workflow

    當你開始大量用 AI 寫程式時,真正的風險不在「寫不出來」,而在「錯誤、壞味道、性能坑」靜靜被合進主幹,所以現在比起寫程式,更需要好的 AI 審查與補救工具。

    下面用兩個最近爆紅的開源工具 adamsreview 和 React Doctor,帶你組一條「AI 寫程式 + AI 審 PR/修 bug」的實戰流程。


    核心功能:兩個工具,一條龍

    工具總覽

    名稱 核心功能 免費方案 適合誰
    adamsreview 多代理分工的 PR 審查,深度檢查邏輯與安全 完全開源 用 GitHub / GitLab、有 PR 流程的後端或全端團隊
    React Doctor 自動檢測、修正 AI 產出的 React 程式碼 完全開源 用 Claude/ChatGPT 產生 React/TSX 的前端團隊

    接下來分別講清楚:

    1. adamsreview 怎麼把 PR 審查拆給多個 AI 代理,使錯誤更難漏掉。
    2. React Doctor 怎麼專門處理「AI 產生 React code 一堆小雷」這件事。
    3. 最後用這兩個工具,組裝一條可直接抄走的開發 workflow。

    一、adamsreview:多代理分工的嚴謹 PR 審查

    核心功能

    adamsreview 是一個專為 Claude Code 設計的插件(slash commands),重點是:

    1. 多階段、多代理 PR 審查
    2. 不是一次跑完,而是分成好幾個階段:整體變更 → 文件/測試 → 安全/性能 → 修正建議。
    3. 每個階段可啟動平行子代理(sub-agents),例如一個看 API 變更,一個看錯誤處理。
    4. 審查狀態存在本地 JSON 裡,可以在不同命令之間保持上下文。

    5. 更少漏網 bug、更少誤報

    作者在 HN 上提到,它在實戰中比:

    • Claude 內建 /review、/ultrareview
    • CodeRabbit、Greptile

    更常抓到真實 bug,同時少講廢話。

    實際上常被抓到的包括:

    • 新增邏輯沒有對錯誤狀況做邊界檢查
    • 漏更新單元測試或 fixture
    • API 變更與文件不一致
    • 可預期的性能問題(例如重複查詢、無 cache)

    💡 關鍵: 多階段、多代理的拆解方式,讓 adamsreview 比一般單次 /review 更容易抓到真正 bug,且減少冗長誤報。

    1. 直接嵌入現有 PR 工作流
    2. 提供像 /review、/codex-review、/fix 等命令,照著你原本用 Claude Code 的習慣延伸。
    3. 可搭配 Codex CLI 與 PR bot,在 PR 上直接留下 AI 審查留言。
    4. 狀態存在檔案裡,方便在 CI 或本地反覆跑不同階段的檢查。

    適合誰用

    幾個具體場景:

    • 有正式 PR 流程的後端/平台團隊

    例如:用本地 LLM 或 Claude 幫你生成 service / handler,透過 adamsreview 做一輪「AI 審 PR」,再交給人類最後確認。

    • 資深工程師很忙的小團隊

    初階工程師用 AI 寫功能,先交給 adamsreview 初審,減少 reviewer 花時間抓基礎錯誤。

    • 正在導入 AI coding,但怕品質失控的團隊

    讓「AI 生成程式碼」必須經過「AI 多代理審查」,有規則可循,而不是全憑 reviewer 心情。

    怎麼開始:最小安裝步驟

    原始專案:https://github.com/adamjgmiller/adamsreview

    以下是一個「最短路徑」,讓你在現有 GitHub PR 流程中接上 adamsreview:

    1. 準備環境

    2. 需要:

      • 有權使用 Claude Code 並可安裝插件(通常是付費方案)。
      • 本機有 git + Node.js(或作者指定的執行環境)。
    3. 安裝與設定

    在你的開發機或開發容器中:

    bash
    git clone https://github.com/adamjgmiller/adamsreview
    cd adamsreview
    # 若有提供安裝腳本
    npm install # 或 pnpm/yarn

    • 依照 repo README 設定環境變數(通常包含 Claude/Codex API key)。

    • 在 Claude Code 中載入插件

    • 打開 Claude Code(或支援的 IDE 插件)。

    • 依 README 說明匯入 slash commands。
    • 你會看到新增的命令,例如:/review、/fix。

    • 在 CI / PR 流程中接上(GitHub Actions 範例)

    在 .github/workflows/pr-review.yml 增加一個簡化版 workflow:

    “`yaml
    name: AI PR Review

    on:
    pull_request:
    types: [opened, synchronize]

    jobs:
    ai-review:
    runs-on: ubuntu-latest

       steps:
         - name: Checkout
           uses: actions/checkout@v4
    
         - name: Setup Node
           uses: actions/setup-node@v4
           with:
             node-version: '20'
    
         - name: Install adamsreview
           run: |
             git clone https://github.com/adamjgmiller/adamsreview
             cd adamsreview && npm install
    
         - name: Run adamsreview
           env:
             CLAUDE_API_KEY: ${{ secrets.CLAUDE_API_KEY }}
           run: |
             cd adamsreview
             # 依專案提供的 CLI 指令
             npm run review -- ../
    

    “`

    這樣每次有人開 PR,就會自動觸發 AI 審查並在 PR 留言(實際指令依 repo 說明調整)。


    二、React Doctor:專治 AI 產出的 React 小雷

    官方 repo:https://github.com/millionco/react-doctor

    它在 README 的第一句就是:「Your agent writes bad React. This catches it」。重點就是:AI 幫你產生的 React/TSX 常常「能跑,但不安心」。

    核心功能

    1. 針對 React/TSX 的靜態檢測與修復

    2. 專門用來掃描 React 專案(JSX/TSX),找到常見的壞味道與 bug。

    3. 例如:
      • 在 useEffect 中漏依賴
      • 不必要的 re-render
      • 不穩定的 key
      • props 型別不一致
    4. 部分問題可以自動產生修正 patch,直接套用。

    5. 和 AI 代理配合運作

    它假設你已經在用 AI(Claude、ChatGPT、Cursor 等)生成元件或 hook:

    • 先讓 AI 產出 code
    • commit 前跑 React Doctor:快速找出「AI style 錯誤」
    • 必要時讓 React Doctor 幫你修補。

    • TypeScript 友善

    • 專案本身用 TypeScript 寫,也善用現有型別資訊。

    • 如果你本來就用 TS + React,導入成本很低,直接把現有 tsconfig、型別檔當基礎。

    💡 關鍵: React Doctor 把「AI 寫得能跑」提升到「依 React/TS 最佳實務可維護」,特別適合大量由 AI 生成的 UI 程式碼。

    適合誰用

    幾個典型情境:

    • 用 Claude/ChatGPT 幫你生 UI 元件

    例如設計稿轉 React Component:

    • AI 負責「寫得出來」。
    • React Doctor 負責「寫得對、好維護」。

    • React 新手 + AI 輔助開發

    新手可能看不出 AI 產生的 code 有哪些壞習慣,React Doctor 可以當成「自動 code review 老師」。

    • 已有大型 TypeScript + React 專案

    部分模組開始用 AI 重構或新增功能,用 React Doctor 當 Safety Net,避免 AI 把舊 code 改壞。

    怎麼開始:在 TS 專案快速啟用

    假設你有一個現成的 React + TypeScript 專案:

    1. 安裝 React Doctor

    專案目錄下:

    bash
    npm install react-doctor --save-dev
    # 或
    pnpm add -D react-doctor

    1. 新增設定檔(若有需要)

    參考 repo 中的樣板(實際檔名跟範例以官方 README 為準):

    bash
    npx react-doctor init

    這通常會產生一個設定檔,例如 react-doctor.config.ts,你可以指定:

    • 要掃描的資料夾(例如 src)
    • 要啟用的規則

    • 在 package.json 加上腳本

    json
    {
    "scripts": {
    "doctor": "react-doctor check src",
    "doctor:fix": "react-doctor fix src"
    }
    }

    1. 在 Git hooks / CI 中啟用

    2. 透過 Husky 或 lint-staged,在 pre-commit 或 pre-push 跑:

      bash
      npx react-doctor check src

    3. 或在 GitHub Actions 加一個 job:

      yaml
      - name: React Doctor
      run: npm run doctor

    這樣每次有人把 AI 產的 React code 推上來,就會被 React Doctor 先掃過一次。


    三、組裝一條「AI coding + AI code review/repair」工作流

    最後用文字幫你拼成一個可以直接採用的流程,從「AI 寫 code」到「AI 審查 + 修正」:

    1. 開發階段:AI 寫程式

    2. 使用本地 LLM、Claude Code 或 ChatGPT:

      • 讓 AI 產出後端 handler、service、React 元件。
      • 人類工程師只負責寫 prompt + 調整架構。
    3. 前端部分:React Doctor 抓小雷

    4. 每次 AI 生成或修改 React/TSX 檔案:

      • 本地跑 npm run doctor 檢查。
      • 對於可自動修正的問題,跑 npm run doctor:fix。
    5. 把這個步驟固定在:

      • pre-commit hook
      • 或 VS Code Task / npm script
    6. 提交 PR:adamsreview 做多階段 PR 審查

    7. 開 PR 後,GitHub Actions 觸發 adamsreview:

      • 階段 1:總覽差異,找出風險區域。
      • 階段 2:針對測試、錯誤處理、安全性做專門檢查。
      • 階段 3:產生具體修正建議或 patch。
    8. PR 上自動留下 AI comment,方便 reviewer 快速聚焦真正問題。

    9. 人類最後把關

    10. Reviewer 看:

      • React Doctor 的報告(前端)
      • adamsreview 的 PR 評論(後端/全端)
    11. 決定哪些建議要採用,哪些視情況忽略。
    12. 合併前至少確保:
      • 所有必跑的 React Doctor / adamsreview 任務都綠燈。

    💡 關鍵: 重點不是「全自動合併」,而是用 AI 把最耗時、最容易忽略的細節掃一遍,再由人類做最後決策。

    這條工作流的重點不是「全自動」,而是:

    • 把 AI 寫程式變成可控的流程,而不是隨意貼 paste code。
    • 把最耗時、最容易忽略的細節(React 小雷、邊界條件、安全性)交給專門的 AI 工具來抓。

    實作上,你可以先選一個小模組試行:

    • 前端導入 React Doctor。
    • 後端/全端導入 adamsreview。
    • 兩週後檢查:PR 審查時間、有 bug 的 PR 比例是否下降,再決定要不要擴大到整個 repo。

    用 AI 寫程式已經變成常態,下一步是在你的團隊裡,建立一套 「AI 寫 + AI 審 + 人類決策」的固定流程,讓速度與品質可以同時兼顧。

    🚀 你現在可以做的事

    • 打開 GitHub,分別把 adamsreview 與 React Doctor repo 加到你的星標與閱讀清單
    • 在一個側專案或小模組上,先實驗接上 React Doctor 的 npm run doctor / doctor:fix 腳本
    • 在現有 repo 新增一個簡單 GitHub Actions workflow,試跑一次 adamsreview 的 AI PR 審查流程
  • 本地跑 Microsoft 級語音 AI:vibevoice.cpp 入門

    本地跑 Microsoft 級語音 AI:vibevoice.cpp 入門

    📌 本文重點

    • 全本地 TTS + 長語音 ASR + 語者分離,無需雲端
    • 約 30 秒錄音即可 voice clone 自己聲線
    • C++ 實作、支援多後端,推論階段完全不用 Python
    • 很適合會議逐字稿、客服分析與離線語音助手

    一句話先說清楚:vibevoice.cpp 是一套「全本地」的 TTS + 長語音 ASR + 語者分離工具,不用 Python、不上雲,就能在自己機器裡跑出接近 Microsoft VibeVoice 等級的語音 AI。

    原始專案與說明:https://github.com/mudler/vibevoice.cpp(C++ 移植自 Microsoft VibeVoice: https://github.com/microsoft/VibeVoice)


    核心功能:你能馬上用來做什麼

    1. 24kHz 高品質 TTS + 30 秒聲音就能 voice clone

    vibevoice.cpp 內建 TTS 引擎,支援 24kHz 輸出,適合旁白、影片解說、產品語音回應等場景。最大的亮點是:

    • 約 30 秒的語音樣本(.wav / .mp3 都可,建議乾淨無 BGM)
    • 用專案提供的轉換腳本,把你的聲音轉成 gguf voice 檔
    • 之後輸入文字,就能用你的聲線合成語音

    💡 關鍵: 約 30 秒乾淨錄音就能完成 voice clone,是進入個人化 TTS 的最低門檻之一

    實作步驟(voice clone 概念流程):

    1. 準備一段約 30 秒的個人口播,儘量在安靜環境錄製。
    2. 取得原始 VibeVoice 的 .pt 聲音權重(或官方樣例聲音)。
    3. 使用 vibevoice.cpp repo 裡的 scripts/convert_voice_to_gguf.py 將聲音轉成 .gguf 語音檔。
    4. 在 TTS 命令中指定這個 voice 檔,就能生成你的聲線。

    提示:沒有 Python 推論,但轉換 .pt → .gguf 這一步需要一次性使用 Python。轉好後推論階段完全不用 Python。


    2. 長語音 ASR + 語者分離,一次處理十幾分鐘錄音

    vibevoice.cpp 背後是約 7 億參數的模型,實測可以處理長達十幾分鐘的錄音(作者在 Reddit 提到測到約 17 分鐘),並做到:

    • 自動逐字稿(ASR)
    • 自動切段(按時間區段)
    • 自動標註不同說話者(Diarization)

    💡 關鍵: 7 億參數模型可穩定處理約 17 分鐘長錄音,適合會議與客服等實際業務場景

    也就是:丟一整段會議錄音進去,輸出就會像這樣:

    [00:00.0 - 00:12.3] Speaker 1: 大家好,今天會議主要討論 Q3 產品排程…
    [00:12.3 - 00:25.7] Speaker 2: 我先更新一下研發這邊的進度…
    ...
    

    快速實作想法:

    • 會議錄音 → 丟給 vibevoice.cpp → 拿回文字 + 誰在說話 → 直接貼進 Notion、Confluence 或公司內網系統。
    • 客服錄音 → 一批檔案跑 ASR + 語者分離 → 拿到客服與客戶對話文字,後續再用本地 LLM 做情緒分析或關鍵字統計。

    3. 跨平台、本地推論、無 Python 推論依賴

    vibevoice.cpp 用 C++ + ggml 實作,支援多種硬體後端:

    • CPU(x86 / ARM)
    • CUDA(NVIDIA GPU)
    • Metal(Apple Silicon / macOS)
    • Vulkan(支援 Vulkan 的 GPU 平台)

    這幾件事對實際部署很關鍵:

    • 不需要在伺服器上裝一大堆 Python/conda,推論階段就是一個二進位 + gguf 模型檔。
    • 更容易嵌入既有系統:C ABI 讓你在 C/C++、Rust、Go、甚至 Node.js(透過 FFI)裡都能呼叫。
    • 適合沒有外網、或對資料保密要求高的內網環境。

    💡 關鍵: 推論只靠一個二進位加模型檔,無 Python 依賴,讓部署與嵌入式整合簡化許多


    適合誰用:4 個具體場景

    1. 公司會議錄音 → 自動逐字稿 + 誰講了什麼

    適合:產品經理、工程主管、專案管理。

    操作路線:

    1. 用任意錄音工具錄下整場會議(建議單軌錄音即可)。
    2. 丟給 vibevoice.cpp,輸出成文字 + 語者標註。
    3. 再加工:
    4. 手動整理重點;或
    5. 丟進本地 LLM(如 ollama 上的 Llama 3)做摘要。

    好處:不必把敏感會議內容丟上雲端,也不必自己搭一整套 ASR 服務。


    2. 內網客服錄音分析

    適合:客服主管、合規/法務、營運分析。

    做法:

    1. 將客服中心錄音批次輸出成檔案(常見為 WAV/MP3)。
    2. 用 vibevoice.cpp 跑 ASR + 語者分離,取得客服與客戶逐字對話。
    3. 輸出文字再交給內網數據分析或 NLP 模組做:
    4. 關鍵字搜尋(是否有爭議用語、是否說明退款規則等)
    5. 投訴分析(常見問題、情緒偏負面段落)。

    3. 在自己產品裡內建語音輸入 / 語音輸出

    適合:SaaS 產品、內部工具、遊戲或交互式應用開發者。

    可行玩法:

    • 用 ASR 做語音輸入:
    • 使用者對麥克風說話 → 即時轉文字 → 傳給你原有的系統邏輯。
    • 用 TTS 做語音輸出:
    • 系統產生訊息 → 用 vibevoice.cpp 合成語音 → 播放給使用者聽。

    因為有 C ABI,你可以:

    • 在 C/C++ 專案直接連結
    • 在 Rust/Go 透過 FFI 呼叫
    • 在 Node.js 透過 node-ffi 或自寫 native addon 包一層

    4. 做一個完全離線的語音助手

    適合:喜歡 DIY 的工程師、Maker、隱私敏感場景。

    粗略架構:

    1. 麥克風輸入 → vibevoice.cpp ASR → 文字指令
    2. 文字指令 → 本地 LLM(例如 LocalAI / Ollama)→ 回覆文字
    3. 回覆文字 → vibevoice.cpp TTS(可用自建 voice clone)→ 喇叭播出

    整條鏈路都在本機或內網,沒有任何雲端依賴。


    怎麼開始:最短路徑從 0 到能跑

    官方 repo:https://github.com/mudler/vibevoice.cpp

    1. 下載二進位檔(最快上手)

    1. 打開 GitHub Releases:https://github.com/mudler/vibevoice.cpp/releases
    2. 依自己的平台下載對應壓縮檔,例如:
    3. vibevoice-darwin-arm64.zip(Apple Silicon)
    4. vibevoice-linux-x86_64.zip
    5. vibevoice-windows-x86_64.zip
    6. 解壓縮後,裡面會有:
    7. 主程式二進位,例如 vibevoice
    8. 範例模型 / 語音配置(依版本而定)

    在 Linux/macOS,給執行權限:

    chmod +x vibevoice
    

    2. 用 CMake 自行編譯(需要客製或特定後端時)

    環境需求:

    • CMake
    • C++17 編譯器(gcc / clang / MSVC)
    • 選用:CUDA / Vulkan / Metal SDK

    基本編譯步驟(以 Linux/macOS 為例):

    git clone https://github.com/mudler/vibevoice.cpp.git
    cd vibevoice.cpp
    mkdir build && cd build
    cmake .. -DCMAKE_BUILD_TYPE=Release
    cmake --build . --config Release
    

    完成後,build/ 底下會出現可執行檔(名稱以實際 repo 為準)。


    3. 第一次跑 ASR:把一段錄音轉成逐字稿

    假設你已經有:

    • 主程式 vibevoice
    • 已下載好的 ASR 模型 model.gguf(官網會提供下載連結)
    • 一段錄音 meeting.wav

    執行(命令格式可能會隨版本略有不同,請以 --help 為主,這裡示範典型用法):

    ./vibevoice \
      --mode asr \
      --model model.gguf \
      --input meeting.wav \
      --output transcript.txt \
      --diarization
    

    跑完後,你會拿到一個 transcript.txt,裡面包含時間戳與說話者標記。


    4. 第一次跑 TTS:從文字合成語音

    準備:

    • TTS 模型 tts-model.gguf
    • 一個 voice 檔(可用官方 sample voice,例如 voice-en.gguf)

    命令範例:

    ./vibevoice \
      --mode tts \
      --model tts-model.gguf \
      --voice voice-en.gguf \
      --text "你好,這是 vibevoice.cpp 的測試。" \
      --output out.wav
    

    成功後你會得到一個 out.wav,用任意播放器就能聽見合成結果。


    5. 準備 30 秒聲音做 voice clone(概念流程)

    1. 錄一段約 30 秒的清晰朗讀(內容隨意,重點是發音自然、環境安靜)。
    2. 取得對應的 voice 訓練權重,依官方 README 指示執行:

    bash
    python scripts/convert_voice_to_gguf.py \
    --input your_voice.pt \
    --output your_voice.gguf

    1. 之後在 TTS 命令中改成:

    bash
    --voice your_voice.gguf

    即可以你的聲音合成語音。


    6. 怎麼嵌到自己的專案:用 C ABI 呼叫

    vibevoice.cpp 提供 C 語言 ABI,因此只要能呼叫 C 函式的語言,都能整合。

    簡化示意(實際函式名稱請以官方 include/ 中的 header 為準):

    #include "vibevoice.h"
    
    int main() {
        vv_context *ctx = vv_init("model.gguf");
    
        vv_asr_params params = {0};
        params.diarization = 1;
    
        vv_result result = vv_run_asr(ctx, "meeting.wav", &params);
    
        // 在這裡處理 result.text / result.segments
    
        vv_free_result(&result);
        vv_free(ctx);
        return 0;
    }
    

    在其他語言(例如 Rust、Go)你可以:

    • 透過 extern "C" 聲明這些函式
    • 用 FFI 封裝成 idiomatic 的 API

    這樣你的應用程式就能直接呼叫 vibevoice.cpp,無需啟動額外的 HTTP 服務或 Python 進程。


    小結:什麼時候該試試 vibevoice.cpp?

    如果你符合以下任一條,很值得花一個下午跑起來:

    • 想在本地處理會議、客服錄音,不想把資料丟到雲端
    • 想做一個離線語音助手或內網語音介面
    • 需要在產品裡嵌入 TTS / ASR,但又不想綁特定雲服務
    • 想要一套 CPU/GPU 都能跑、無 Python 推論依賴的語音引擎

    從 Releases 下載二進位、跑一次 ASR 和 TTS,大概半小時內就能完成。之後你就有一顆可嵌入任何系統的本地「語音核心」。

    🚀 你現在可以做的事

    • 打開 GitHub Releases,下載適合自己平台的 vibevoice.cpp 二進位並跑一次 ASR 測試
    • 錄一段約 30 秒的個人聲音,照 README 用 convert_voice_to_gguf.py 做一次 voice clone
    • 在你現有的工具(例如內部專案或腳本)中,嘗試用命令列或 C ABI 把 vibevoice.cpp 串成一個簡單語音流程
  • 用 goose AI Agent 開一隻全能小幫手

    用 goose AI Agent 開一隻全能小幫手

    📌 本文重點

    • goose 是用 Rust 寫的開源 AI Agent 框架
    • 讓 LLM 真的能跑指令、改檔案、寫測試而不只聊天
    • 可接任意 LLM,並透過 workflow 自動化多步驟任務
    • 很適合 DevOps / 開發者做日常開發與部署自動化

    用一句話說清楚:goose 是一個用 Rust 寫的開源 AI Agent 框架,可以讓 LLM 不只聊天,而是真的幫你在電腦上安裝套件、跑指令、改程式碼、寫測試,變成一個可以自動執行任務的「全能小幫手」。

    GitHub 專案:https://github.com/aaif-goose/goose


    goose 和一般聊天機器人有什麼不同?

    一般 ChatGPT / Claude 類工具,多半停在「給你建議」:

    • 產生程式碼片段
    • 幫你想測試案例
    • 告訴你下一步可以怎麼做

    goose 的差別在於:它可以自己動手做。

    透過 goose,你可以讓模型:

    • 在你的環境裡 執行殼層指令(shell commands)
    • 直接修改專案檔案、重構程式碼
    • 跑測試、根據結果再修正
    • 用 plugin / tool 的形式接上你自己的 API 或腳本

    換句話說,它比較像一個「可編程的 AI 工具人」,而不是純聊天機器人。

    💡 關鍵: goose 不只回覆文字,而是能在你的實際環境中「讀檔案、下指令、改程式」,真正把建議變成動作。


    核心功能:你可以拿 goose 來做什麼?

    1. 調用殼層指令:讓 LLM 幫你按命令行上的按鈕

    goose 內建「可以執行 shell 指令」的能力。

    你可以叫 agent 做這些事:

    • 安裝套件:apt-get, brew, pip, cargo…
    • 拉專案:git clone、切分支、pull 最新版
    • 跑工具:npm test、cargo test、pytest、make build

    你要做的行動:

    • 想一件你平常常打的一串指令(例如部署前要跑的 3–5 個步驟)
    • 把它寫成一句自然語言任務,交給 goose,觀察它如何自己拆解並下指令

    2. 程式碼編輯與測試:真的會改你專案的那種

    goose 支援對檔案系統操作,讓 LLM 直接:

    • 開啟 / 讀取專案中的檔案
    • 修改檔案內容(插入、刪除、重構)
    • 新增測試檔、更新 README

    常見用法:

    • 讓 agent 自動幫你 加 log / exception handling
    • 要它針對某個 module 補齊單元測試
    • 改 config、更新版本號、調整 CI 設定檔

    你要做的行動:

    • 選一個「可以放心被 AI 改壞」的小 side project
    • 用 goose 給它一個任務,例如:「在這個 Rust 專案裡,新增一個 health check endpoint,並幫我補上測試」

    3. 自訂工具擴充:把你自己的腳本、API 變成 agent 的能力

    goose 的設計重點是 「可擴充的工具」。你可以:

    • 把現有的 Python / Bash 腳本包裝成一個 tool
    • 把團隊內部 API(如 issue tracker、部署服務)接進來
    • 讓 agent 用「呼叫工具」的方式,連續完成更複雜的流程

    實際效果:

    • LLM 不用自己「想像」怎麼部署,而是呼叫你提供的 deploy_api
    • 你可以限制它只能用你認可的工具,控制風險

    你要做的行動:

    • 列出你工作中最常手動跑的 2–3 個腳本
    • 想像它們如果變成一個 deploy_service / create_release 的工具,agent 可以怎麼自動串起來

    4. 接任意 LLM:OpenAI、DeepSeek、本地模型都行

    goose 標榜 「with any LLM」,實際上就是可以在設定中自由切換 backend:

    • OpenAI(如 gpt-4.1)
    • DeepSeek API(如 deepseek-coder)
    • 透過 OpenAI-compatible API 的本地模型(Ollama、LM Studio…)

    這讓你可以:

    • 開發時用免費 / 便宜模型測試流程
    • 上線到正式環境時再換成更穩定的雲端模型

    你要做的行動:

    • 先挑一個你現有就有 API Key 的 LLM(例如 OpenAI 或 DeepSeek)
    • 決定:
    • 「實驗階段」用哪個模型
    • 「正式跑自動化」時要不要升級到較貴的模型

    💡 關鍵: 透過切換 GOOSE_MODEL 等設定,你可以在成本(本地 / 便宜模型)與效果(雲端高階模型)之間彈性取捨。


    適合誰用?三種典型場景

    1. DevOps/SRE:日常腳本自動化

    例如:

    • 部署前:拉最新程式碼 → 跑測試 → build → health check
    • 緊急修補:切 branch → 套 patch → 跑 smoke test → 發一版 hotfix

    用 goose 的做法:

    • 把這些步驟包成一個「任務腳本」(workflow)
    • 讓 agent 自己決定下一步要跑哪個指令、根據輸出結果調整

    2. 開發者:專案 boilerplate 生成與重構

    適用情境:

    • 開一個新服務:想要快速產生「專案骨架 + 基本路由 + CI 檔案」
    • 老專案:想系統性把某種寫法換成新的 pattern

    用 goose 可以這樣玩:

    • 指定專案資料夾給 agent
    • 給一個任務:「初始化一個 NestJS API 專案,幫我加上 Dockerfile 和 GitHub Actions CI」

    3. 團隊工程流程:CI 前自動檢查與修修補補

    在 CI 跑之前,先讓 goose 幫你:

    • 檢查程式格式、lint 問題
    • 嘗試自動修正簡單的錯誤
    • 對 PR 產生簡短變更說明

    做法:

    • 在 CI pipeline 裡加入「goose agent 步驟」
    • 給它權限在 CI runner 上修改檔案並 push(或開新 PR)

    💡 關鍵: 把 goose 放進 CI / pre-commit,可以在錯誤進到主線分支之前,自動完成一輪整理與簡單修補。


    怎麼開始:最快速的上手路徑

    1. 用 Docker 跑起官方範例(最快測試)

    前提:

    • 已安裝 Docker
    • 手邊有一個 LLM API Key(例:OPENAI_API_KEY)

    步驟:

    # 1. 拉專案
    git clone https://github.com/aaif-goose/goose.git
    cd goose
    
    # 2. 建一個 .env,放你的模型設定(簡化示意)
    cat << 'EOF' > .env
    OPENAI_API_KEY=your_key_here
    GOOSE_MODEL=openai/gpt-4.1
    EOF
    
    # 3. 用 docker compose 跑起來(實際以 repo 裡的 compose 指令為準)
    docker compose up --build
    

    跑起來後,通常會有:

    • 一個 CLI / HTTP 介面
    • 你可以丟:
    • 「在這個容器裡安裝 curl 並測試對 google.com 發送請求」

    行動建議:先在容器內做「無害」的事情,例如安裝一個套件、建立一個測試檔案,確認 goose 真的有在動你環境。


    2. 本機安裝(Rust 使用者)

    前提:

    • Rust toolchain(rustup)

    步驟:

    # 1. 安裝依賴
    cargo install --path .  # 實際請以 README 為準
    
    # 2. 設定環境變數
    export OPENAI_API_KEY=your_key_here
    export GOOSE_MODEL=openai/gpt-4.1
    
    # 3. 跑 CLI
    goose run
    

    你可以在終端機裡對 agent 下指令,例如:

    • 「列出目前資料夾的檔案,幫我找出所有含有 TODO 的檔案並列出行號」

    3. 接上常見模型(OpenAI / DeepSeek / 本地 LLM)

    以下是假設性的設定方向(實際請對照 goose README):

    OpenAI

    export OPENAI_API_KEY=your_key
    export GOOSE_MODEL=openai/gpt-4.1
    

    DeepSeek

    通常會提供 OpenAI 相容 API:

    export OPENAI_BASE_URL=https://api.deepseek.com/v1
    export OPENAI_API_KEY=your_deepseek_key
    export GOOSE_MODEL=deepseek-chat
    

    本地 LLM(以 Ollama 為例)

    啟動 Ollama 後:

    export OPENAI_BASE_URL=http://127.0.0.1:11434/v1
    export OPENAI_API_KEY=dummy
    export GOOSE_MODEL=ollama/llama3.1
    

    行動建議:先用最簡單、你現在就有的 API Key 接上,確認 goose 的流程跑得通,再考慮搬到本地模型節省成本。


    寫一個自己的「任務腳本」:讓 agent 連續完成幾個步驟

    goose 的強項在於可以定義「多步驟任務」。概念上,你會有一個 workflow 設定(格式依官方為準,這裡用 pseudo-code 示意):

    # workflows/dev_check.toml
    name = "dev_precommit_check"
    
    [[steps]]
    type = "shell"
    command = "git status"
    
    [[steps]]
    type = "agent"
    prompt = "閱讀 git status,決定要先格式化哪一些檔案,並執行對應指令。"
    
    [[steps]]
    type = "shell"
    command = "cargo test"
    
    [[steps]]
    type = "agent"
    prompt = "根據測試結果,如果有簡單錯誤可以直接修,並再次執行對應測試。"
    

    用法:

    goose run-workflow workflows/dev_check.toml
    

    這樣,你可以一行命令啟動一個「會看情況調整動作」的前置檢查流程。

    你要做的行動:

    • 先定義一個超簡單的 workflow:
    • Step1:ls 專案
    • Step2:請 agent 根據專案結構生成一段簡短說明,寫入 PROJECT_SUMMARY.md

    實戰:從零做一個小型自動化 workflow

    目標:在一個現有專案裡,做「提交前自動整理 + 簡單修補」流程。

    我們要達成:

    1. 檢查目前分支變更檔案
    2. 對變更檔案跑 formatter / linter
    3. 如果有明顯錯誤,由 agent 嘗試自動修改
    4. 重新跑測試

    Step 1:準備專案與權限

    1. 找一個你熟悉、可以接受被改動的專案資料夾
    2. 新開一個分支,如 feat/goose-auto-fix
    3. 確保 goose 有權限:
    4. 讀寫這個資料夾
    5. 執行必要的指令(例:npm test、cargo test)

    Step 2:定義 workflow(示意)

    依 goose 支援的格式建立一個 workflow 檔(假設是 YAML):

    name: precommit-helper
    steps:
      - type: shell
        command: git diff --name-only
      - type: agent
        prompt: |
          你看到的是目前分支有變更的檔案清單。
          目標:
          1. 對這些檔案執行合適的 formatter / linter 指令(依照檔案類型判斷)。
          2. 若 formatter/linter 回報可自動修復的問題,請修改檔案並重新執行檢查。
      - type: shell
        command: npm test  # 或你專案的測試指令
      - type: agent
        prompt: |
          根據測試輸出,
          - 若是小型邏輯/型別錯誤,嘗試修改相關檔案後再次執行測試。
          - 若錯誤較複雜,請產生簡短說明寫入 precommit_report.md。
    

    Step 3:實際執行與調整

    1. 在專案根目錄跑:

    bash
    goose run-workflow precommit-helper.yaml

    1. 觀察它的行為:
    2. 有沒有亂跑你不想要的指令?
    3. 修改的檔案是否合理?

    4. 根據結果調整:

    5. 限制能用的指令範圍(例如只允許 npm test, npm run lint)
    6. 在 prompt 裡多加一些「安全護欄」,例如「不要刪除檔案」。

    完成後,你就有了一個:

    • 可以在提交前幫你「整理 + 修補 + 產生報告」的小型 AI 助理
    • 海豚式改進:遇到痛點就稍微改一下 workflow / 工具清單,越用越貼近你團隊習慣

    小結:下一步可以怎麼玩?

    如果你看到這裡,建議接下來這樣走:

    1. 先跑官方範例容器一次,確認 goose 在你機器上可以正常跑指令。
    2. 選一個專案資料夾,做一個超小 workflow:只做檔案摘要或自動補 README。
    3. 把你現有的一個腳本包成 tool,讓 agent 可以呼叫(例如部署或打包腳本)。
    4. 等你有信心後,再把它接進 CI / pre-commit 流程。

    完整專案與最新用法請看:https://github.com/aaif-goose/goose

    把 goose 想成一個「可編程的 ChatGPT + 指令列機器人」,先從最小、風險最低的自動化開始,你會很快找到適合自己工作流的用法。

    🚀 你現在可以做的事

    • 打開 <https://github.com/aaif-goose/goose>,用 Docker 照著 README 跑一次官方範例
    • 選一個 side project,讓 goose 幫你完成「新增一個 endpoint + 補上測試」的小任務
    • 把日常最常用的一個部署或檢查腳本包成 tool,寫一個只包含 2–3 個步驟的簡單 workflow
  • 用 Deer-Flow 自建長跑 AI SuperAgent

    用 Deer-Flow 自建長跑 AI SuperAgent

    📌 本文重點

    • Deer-Flow 把長時間任務拆成可控模組
    • 透過記憶體與子代理協作支援長期、多階段任務
    • 搭配沙盒與工具調用,可快速做出實用自動化 Pipeline

    只要先把任務切成模組、再讓 Agent 自己排程與記憶,Deer-Flow 能幫你把「要跑幾小時」的專案變成一條可控又可復用的自動化流程。

    專案連結:bytedance/deer-flow


    核心功能:把「長時間任務」拆成可控模組

    這一節先講概念,但每個小節都會對應到你可以馬上去做的事。


    1. 任務調度:讓 Agent 分段跑,而不是一口氣硬撐

    Deer-Flow 的定位是「long-horizon SuperAgent harness」,核心就是任務調度(scheduler):

    • 把大任務拆成多個 stage(例如:資料收集 → 清洗 → 分析 → 報告)
    • 每個 stage 由一個或多個子代理(subagents)負責
    • 調度器會決定:
    • 什麼時候喚醒哪個子代理
    • 什麼時候暫停、重試、或改走另一條路徑

    你可以把它想像成「AI 版本的 Airflow + 任務導向的聊天界面」。

    💡 關鍵: 把長任務拆成多個 stage,讓 scheduler 分段調度 subagents,可以大幅降低單次失敗風險並提升整體可控性。

    你可以馬上做的事:

    1. 打開專案的 examples/ 資料夾,看官方提供的 flow 定義(多半是 YAML 或 Python pipeline)。
    2. 想一個你日常會重複做的 3–4 步驟任務(例如:抓資料 → 存 DB → 寫 summary),在筆記上先畫出 3–4 個方框,對應到未來的 stage 名稱。

    2. 記憶體管理:讓 Agent 記得「之前做過什麼」

    長時間任務的難點,不是算力,而是「上下文會爆掉」。

    Deer-Flow 幫你管的是:

    • 短期記憶(working memory):某個子任務當下需要的上下文
    • 長期記憶(long-term memory):歷史任務紀錄、重要結果、被標記的關鍵中間產物
    • 記憶裁剪:把不重要的對話 / log 丟掉,只保留後續階段會用到的東西

    這樣一來,你可以讓同一個 Agent:

    • 早上先跑一輪資料爬取
    • 下午再接續早上的結果繼續清洗與分析

    你可以馬上做的事:

    1. 在官方 demo 裡,找到記憶相關設定(通常會指定儲存路徑或使用向量資料庫)。
    2. 先用預設的本地檔案儲存方式,觀察它怎麼把多輪任務寫進 log / memory,了解自己之後可以在哪裡接入自己的資料庫。

    3. 子代理協作 + 工具調用:像組一隊虛擬實習生

    Deer-Flow 支援多個 subagents,每個都可以:

    • 使用不同的 LLM(例如:一個負責寫程式,一個負責資料分析)
    • 綁不同的工具(HTTP、資料庫、內部 API)
    • 透過 message gateway 互相傳遞任務與結果

    同時,它內建「工具調用」的框架:

    • LLM 輸出「要用哪個工具 + 參數」
    • Deer-Flow 幫你實際執行(例如發 HTTP 請求、查 DB)
    • 把結果再丟回 LLM 繼續推理

    你可以馬上做的事:

    1. 在 tools 或 skills 相關的範例中,找到 HTTP request 或資料庫工具的例子。
    2. 把它改成呼叫你公司內部一個可公開測試的 API(例如:/health、/status),確認整條「LLM 決定 → 工具執行 → LLM 使用結果」流程可用。

    4. 沙盒執行程式碼:讓 Agent 先在安全盒子裡試錯

    Deer-Flow 特別強調 sandboxes:

    • Agent 產生或修改程式碼時,不會直接在主機上執行
    • 而是丟到隔離環境(容器 / sandbox 子進程)裡跑
    • 出現錯誤時,log 會被收集回來給 LLM 參考,做下一輪修正

    這一點非常適合以下情境:

    • 讓 Agent 自動寫爬蟲、清洗腳本
    • 讓 Agent 幫你布署一個小型服務(只在 sandbox 測試通過後才進正式環境)

    你可以馬上做的事:

    1. 在官方 demo 裡跑一個「code sandbox」相關示例,看它怎麼把程式碼丟到沙盒執行。
    2. 把 sandbox 內部要執行的腳本換成你平常會用的簡單任務,例如:讀取一個 CSV,輸出 JSON。

    適合誰用:3 個具體場景


    場景 1:長時間資料爬取與整理

    典型流程:

    1. Agent A:負責定義爬取策略(網站列表、節奏控制)
    2. Agent B:實際發 HTTP 請求、解析 HTML / API
    3. Agent C:清洗資料、存進資料庫
    4. Agent D:最後產出摘要報告(例如每天一份 Markdown 摘要)

    Deer-Flow 的用法:

    • 每個 Agent 是一個 subagent
    • 任務調度器負責安排「今天要爬哪些」、「昨天失敗的要重試」
    • 記憶體管理幫你記住爬過哪些 URL,避免重複

    行動建議:

    • 選一個你每天都會看的公開資料來源(例如某政府開放資料 API),用 Deer-Flow 做一個「每日抓取 + insert DB + 產出報表」的 pipeline。

    場景 2:從需求到部署的自動化小專案

    你可以把它當成一個「AI junior developer」:

    1. Agent 讀取你的需求(功能描述、預期輸入輸出)
    2. 在 sandbox 裡生成與跑單元測試
    3. 修正錯誤
    4. 最後產出可部署的腳本或 Dockerfile

    搭配本地 LLM(例如 Qwen 3.6 27B,搭配 MTP 加速,參考:這篇 Reddit 分享),你可以完全在內網完成這一串。

    💡 關鍵: 搭配 Qwen 3.6 27B 與 MTP,有實務經驗分享可達到推理速度約「2.5×」提升,使本地端長任務也具備實用性。

    行動建議:

    • 挑一個小腳本需求,例如:
    • 定期掃描資料夾,壓縮過期檔案
    • 監控某個 API latency,超標就寄信
    • 讓 Deer-Flow 的 Agent 在 sandbox 中生成並測試這個腳本,再由你審核後部署。

    場景 3:定期報表生成(營運、行銷、IT 系統狀態)

    想像每週要手工做的:

    • 把資料庫中的數據抓出來
    • 做一些聚合 / 分析
    • 輸出 PowerPoint 或 Markdown 報告

    Deer-Flow 可以這樣組:

    1. 工具:資料庫查詢工具(連到你的 PostgreSQL / MySQL)
    2. Agent:
    3. 一個負責定義查詢與聚合邏輯
    4. 一個負責把結果轉成自然語言與圖表描述
    5. 調度:排成 cron-like 任務,每週執行一次

    行動建議:

    • 從一個最簡單的報表開始,例如「每週新用戶數」,用 Deer-Flow 將流程自動化,先做到:
    • Agent 查 DB → 產出一份 Markdown 報告存檔 → 你手動審閱

    怎麼開始:最小可行 Pipeline

    下面是一條「週末就能跑起來」的最簡路線。


    步驟 1:環境與安裝

    1. 準備一台有 Python 3.10+ 的機器(本機或雲端皆可)。
    2. 進入命令列:
    git clone https://github.com/bytedance/deer-flow.git
    cd deer-flow
    python -m venv .venv
    source .venv/bin/activate  # Windows 用 .venv\Scripts\activate
    pip install -r requirements.txt
    
    1. 確認可以跑官方 demo(通常在 examples/):
    python examples/basic_flow.py
    

    目標:先看到一個完整任務從「開始 → 調用 LLM → 調用工具 → 結束」的 log。


    步驟 2:接上一個開源 LLM(本機或雲端)

    你有兩條路:

    • 本機模型:用 llama.cpp 或 Ollama 跑 Qwen 3.6 之類的模型
    • 雲端 API:用 OpenAI、Anthropic 或其他 OpenAI-compatible 服務

    以 OpenAI 介面為例,Deer-Flow 通常會在設定檔或程式中要求:

    llm_config = {
        "endpoint": "https://your-openai-compatible-endpoint/v1",
        "api_key": "YOUR_KEY",
        "model": "qwen-3.6-32b-instruct"  # 或其他你有的模型名
    }
    

    行動建議:

    • 如果你已經有在用本地模型,直接把你熟悉的 OpenAI-compatible endpoint(例如 vLLM、自建 server)填進來,確認 Deer-Flow 可以正常發出 completion / chat 請求。

    步驟 3:串一個最簡單的工具(HTTP / 資料庫 / 內部 API)

    以 HTTP 工具為例,你可以新增一個 tool:

    from deer_flow.tools import register_tool
    import requests
    
    @register_tool("get_status")
    def get_status(url: str):
        resp = requests.get(url, timeout=10)
        return {"status_code": resp.status_code, "body": resp.text[:1000]}
    

    然後在 Agent 的工具清單中加入 get_status,讓 LLM 可以呼叫它:

    • Prompt 裡描述:「有一個工具 get_status(url) 用來檢查服務狀態」
    • 將你的內部 /health API 當成第一個測試目標

    行動建議:

    • 先讓 Agent 自己決定:
    • 什麼時候要呼叫 get_status
    • 呼叫後如何解讀結果(例如:狀態碼非 200 就記錄成 incident)

    週末練習腳本:從官方 demo 改成你的業務任務

    把以上步驟變成一個可執行的「週末計畫」:

    1. 跑起官方 demo
    2. 目標:看到完整的 log 與結果
    3. 換成你的 LLM
    4. 本地 Qwen / 雲端 API 任一種
    5. 串一個工具
    6. HTTP 或資料庫擇一
    7. 改寫 flow
    8. 讓 Agent 幫你跑一個真實業務任務,例如:
      • 每日抓一個內部 API 的統計數據
      • 存到一個簡單的 SQLite / CSV
      • 產出一行 summary

    做到這裡,你就已經擁有一個「專門幫你跑重複工作幾小時」的長跑 AI SuperAgent 雛型,接下來再慢慢加 stage、加子代理,就能讓它接手越來越多的例行任務。

    💡 關鍵: 先完成最小可行 pipeline,再逐步增加 stage 和工具,可以在風險可控下循序擴張自動化範圍。


    🚀 你現在可以做的事

    • 到 GitHub 下載並跑一次 bytedance/deer-flow 的官方 examples/basic_flow.py
    • 挑一個你日常 3–4 步驟的例行任務,畫出對應 stage,準備改寫成 Deer-Flow pipeline
    • 接上你的第一個實際工具(例如內部 /health API),驗證「LLM 決策 → 工具執行 → LLM 消化結果」這條鏈路在你環境中可用
  • 把縮小版網路塞進你筆電:LLMSearchIndex 實戰

    把縮小版網路塞進你筆電:LLMSearchIndex 實戰

    📌 本文重點

    • 2 億頁壓成約 2GB 的「縮小版網際網路」可離線搜尋
    • 純本地檢索搭配任意 LLM,輕鬆組出 RAG 流程
    • 特別適合高隱私、內網環境與成本敏感的 RAG 應用

    用一句話定位:LLMSearchIndex 就是把「壓縮過的縮小版網際網路」塞進你筆電,讓你在本機就能做全網級搜尋,再拿結果丟給任何 LLM 做 RAG,完全不用再付搜尋 API 費。

    原始專案介紹可看 Reddit:https://www.reddit.com/r/LocalLLaMA/comments/1t3hokh/llmsearchindex_an_open_source_local_web_search/


    核心功能:一台筆電裝下一個「可離線的 Google 替身」

    1. 2 億頁壓縮索引,約 2GB 就能跑

    LLMSearchIndex 預先把網頁爬好、清洗、壓縮成自訂索引格式,涵蓋 FineWeb、維基百科等資料,超過 2 億頁內容壓進約 2GB 檔案。

    💡 關鍵: 把原本動輒數 TB 的網頁內容壓成約 2GB,使全網級搜尋第一次可以在一般筆電本機完成。

    你可以做的事:

    • 把它想成「只存文字精華的迷你網際網路」
    • 在任何一台 8GB RAM 以上的筆電或桌機上運行,不用伺服器
    • 直接拿來當你自建 RAG 系統的「泛網背景知識來源」,不用自己寫爬蟲 + 建索引

    2. 純本地檢索,不靠外部搜尋 API

    LLMSearchIndex 是一個 Python 函式庫,檢索完全在本機完成:

    • 不依賴 Google、Brave、Bing API
    • 不需要額外布署 SearXNG 這種 meta search
    • 問題 → 本機索引 → 回傳相關片段(含來源網址)

    實際效果:只要你還在用本地 LLM(如 Ollama、llama.cpp)或雲端 LLM(OpenAI、Claude 等),檢索這一段可完全脫離網路與付費 API,對公司內網環境或隱私要求嚴格的團隊特別實用。

    💡 關鍵: 把「搜尋這一步」完全搬到本地,不只省掉搜尋 API 成本,也避免把查詢內容外送到第三方服務。

    3. Python API + 任意 LLM,快速組出 RAG 流程

    LLMSearchIndex 的設計就是為 RAG 用:

    • 輸入:自然語言 query
    • 輸出:N 個相關片段(帶文字與 URL),可直接拼進 LLM 的系統提示或 context
    • 不綁特定模型,你可以串:
    • 本地模型(Ollama、vLLM、Kobold、LM Studio…)
    • 雲端模型(OpenAI、Anthropic、Gemini、Groq…)

    典型 workflow:

    1. 使用者問問題
    2. 用 LLMSearchIndex 搜索全網索引,取前 5–10 個片段
    3. 把片段整理成「context」
    4. 丟給 LLM 生成回答

    這整套,你可以在一支 Python 檔內完成。


    適合誰用:三種典型場景

    1. 公司內部知識問答:先查內網,再查「縮小版全網」

    情境:你有一個內部知識庫(Notion、Confluence、PDF…),已經做了 RAG,但常遇到:

    • 文件沒寫清楚,需要補充產業背景
    • 客戶問題牽涉到外部規範、標準、技術細節

    做法:

    1. 先用公司內部向量庫檢索(例如 Chroma、Qdrant、Weaviate)
    2. 若分數不夠高或結果太少,再用 LLMSearchIndex 查一次「全網索引」
    3. 把「內網內容 + 全網片段」一起餵給 LLM

    好處:

    • 內網問題走本地知識(更準、更貼合公司語境)
    • 外部背景靠本地全網索引補足,不用再打搜尋 API

    2. 研究人員做主題深度檢索

    情境:你是研究員 / 資深工程師,常需要:

    • 快速掃描一個新主題的相關文章
    • 找技術名詞、標準、實作細節的來源

    做法:

    • 用 LLMSearchIndex 做多輪查詢,像這樣:
    • 「LLM 推理最佳化 quantization 技術」
    • 「vLLM streaming serving 實作」
    • 「RAG selective retrieval cost optimization」
    • 把回來的片段整理成資料集,再讓 LLM 幫你摘要、對比觀點、拉時間線

    你得到的是:一套可重複的「本機文獻預篩管線」,比手動 Google → 開一堆分頁 → Copy/Paste 省力很多,也更隱私。

    3. 離線 / 高隱私環境下的「像 Google 一樣」輔助搜尋

    情境:

    • 政府、醫療、金融等內網環境不允許對外連線
    • 你只被允許「把工具帶進來」,不能讓資料出去

    做法:

    • 先在可上網環境下載索引檔與程式碼
    • 帶進封閉網路內安裝
    • 之後所有搜尋與 RAG 都在本機完成

    搭配 Selective RAG(參考 Silicon Protocol 思路):

    • 只有在「本地內網文件」不足以回答時,才啟動 LLMSearchIndex 檢索
    • 把返回片段壓縮(摘要、抽 key points),控制 context 在 3–4 萬 token,以節省 LLM 成本

    💡 關鍵: 用 Selective RAG 控制 context 在 3–4 萬 token 內,可以在維持回答品質的同時大幅壓低 LLM 推理成本。

    參考文章:


    怎麼開始:從 pip 到最小可用 RAG 範例

    以下程式碼是假想 API 介面,目的是讓你知道「整體長什麼樣」,實作時請以實際專案 README 為主。

    步驟 1:安裝與下載索引

    # 1. 安裝套件
    pip install llmsearchindex
    
    # 2. 下載預先建好的 2GB 索引
    llmsearchindex download --dataset fineweb-wikipedia
    # 或依 README 指示,選擇其他索引來源
    

    行動重點:確保你有至少 5GB 以上的剩餘磁碟空間與穩定網路,這一步可能會跑一陣子,但只需做一次。

    步驟 2:在 Python 裡發一個最簡單的 query

    from llmsearchindex import LLMSearchIndex
    
    # 載入索引(第一次載入會較慢,之後可快取)
    index = LLMSearchIndex("./indexes/fineweb_wiki.idx")
    
    # 發出一個查詢
    results = index.search(
        query="什麼是 Selective RAG,怎麼降低 LLM context 成本?",
        top_k=5
    )
    
    for i, r in enumerate(results, 1):
        print(f"[{i}] score={r.score:.3f}\nURL={r.url}\nSnippet={r.text[:200]}...\n")
    

    行動重點:

    • 改成你的問題跑一次
    • 看回傳的文字和 URL,確認內容大致合理

    步驟 3:把檢索結果接到任意 LLM(本地或雲端)

    以下以 OpenAI API 為例,你可以換成任何 LLM SDK:

    import os
    from openai import OpenAI
    from llmsearchindex import LLMSearchIndex
    
    client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
    index = LLMSearchIndex("./indexes/fineweb_wiki.idx")
    
    question = "請用中文說明 Agentic RAG 與傳統 RAG 的差異,並舉一個應用例子。"
    
    # 1) 先檢索
    hits = index.search(question, top_k=5)
    
    context_blocks = []
    for h in hits:
        context_blocks.append(f"來源:{h.url}\n內容:{h.text}")
    
    context = "\n\n".join(context_blocks)
    
    # 2) 再把 context 丟給 LLM
    prompt = f"""你是一位技術寫作者。
    根據以下資料回答使用者問題,回答要有條列與具體例子。
    
    【檢索到的資料】
    {context}
    
    【使用者問題】
    {question}
    """
    
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[{"role": "user", "content": prompt}]
    )
    
    print(resp.choices[0].message.content)
    

    行動重點:

    • 把 model 改成你實際在用的模型
    • 若是本地模型(例如 Ollama),只需把「呼叫 OpenAI」那段換成對本地 API 的 HTTP POST

    步驟 4:加一點「Selective / Agentic RAG」邏輯

    目標:控制什麼時候查本機內網知識、什麼時候查全網索引,並讓 LLM 自己做選擇。

    下面是一個可直接複製的「最小工作流」範例(假設你已有 search_internal() 可查公司文件):

    def answer_question(question: str):
        """最小 Agentic + Selective RAG 工作流示意"""
        # 1) 先查內部知識庫
        internal_docs = search_internal(question, top_k=5)
    
        # 2) 請 LLM 判斷要不要額外查全網
        judge_prompt = f"""你是一個檢索決策助手。
        使用者問題:{question}
        下面是內部文件的部份內容,如果已足夠回答,就回答 NO;
        如果明顯需要外部背景知識,回答 YES。
    
        內部文件摘要:
        {internal_docs[:4000]}
    
        只回答 YES 或 NO。"""
    
        judge = client.chat.completions.create(
            model="gpt-4.1-mini",
            messages=[{"role": "user", "content": judge_prompt}],
            max_tokens=2
        ).choices[0].message.content.strip()
    
        web_context = ""
        if judge == "YES":
            web_hits = index.search(question, top_k=5)
            web_context = "\n\n".join(h.text for h in web_hits)
    
        # 3) 最終回答,Selective RAG:只注入必要的 context
        final_prompt = f"""根據以下資料,用清楚的條列方式回答問題。
    
        【內部文件】
        {internal_docs}
    
        【外部網路資料】
        {web_context}
    
        問題:{question}
        """
    
        ans = client.chat.completions.create(
            model="gpt-4.1-mini",
            messages=[{"role": "user", "content": final_prompt}]
        )
        return ans.choices[0].message.content
    

    這段做了幾件關鍵事:

    • 先用內部文件回答,避免 context 過大
    • 只在 LLM 判斷「需要外部背景」時才查 LLMSearchIndex → Selective RAG
    • 讓「要不要查外網」變成 LLM 可控制的動作 → Agentic RAG 思路

    你可以把這段包成 API,直接給前端 chat UI 使用,實際上就完成了一個「有公司腦、有縮小版全網腦」的混合助理。


    小結:什麼時候值得把 LLMSearchIndex 裝進你電腦?

    如果你符合以下任一條件,很值得試:

    • 不想再為 Brave / Bing / 其他 Web Search API 付費
    • 公司內網不能直連外網,但又需要一般網路知識
    • 已經有 RAG,但缺一層泛網背景,常被卡在「文件沒寫但網路上早就有答案」

    先從:

    1. pip install + 下載索引
    2. 跑一次簡單 query
    3. 用上面最小工作流範例接到你的 LLM

    開始把「縮小版網際網路」塞進你的 RAG pipeline 裡,用一台筆電就做出接近全網搜尋體驗的助理。

    🚀 你現在可以做的事

    • 打開 README,實際執行 pip install llmsearchindex 並下載一個索引檔
    • 改寫文中的 Python 範例,把 query 換成你真實工作會問的問題跑一次
    • 把「步驟 4」的 answer_question() 包成一個簡單 API,接到現有的內網 chat UI 做小規模試用
  • TrendRadar:一句話問清今天網路在吵什麼

    TrendRadar:一句話問清今天網路在吵什麼

    📌 本文重點

    • TrendRadar 幫你每天自動整理「值得在意的事」
    • 透過多平台聚合 + AI 翻譯與情感分析過濾雜訊
    • 可與 ChatGPT/Claude 分工整合,從監控到決策一條龍
    • 開源專案,支援 Docker 快速自架部署

    每天打開社群、新聞、論壇一堆訊息轟炸,TrendRadar 的用途只有一個:幫你先把「今天值得在意的事」整理好,讓你用一句話就能問清楚今天網路在吵什麼。

    專案連結:https://github.com/sansan0/TrendRadar


    核心功能:把資訊過濾、翻譯、分析到位


    1. 多平台聚合:RSS + 關鍵字一次收攏

    TrendRadar 的第一步,就是幫你「收集」:

    • 支援 RSS 訂閱:新聞網站、部落格、論壇,只要有 RSS 都能加
    • 支援多平台來源:可以接常見內容源(Twitter/X、Telegram 頻道、各類資訊流等,具體依你配置的 RSS 和接口而定)
    • 關鍵字篩選:只保留跟你在意的議題相關的內容

    你可以這樣實際操作:

    1. 列出你真的在乎的 3–5 個主題:
    2. 例:品牌名稱、競品名稱、關鍵技術(LLM、RAG)、產業關鍵詞(電商、SaaS、生成式 AI)
    3. 找到對應的 RSS 或資訊源:
    4. 媒體:TechCrunch、36kr、Inside、數位時代等
    5. 技術:Hacker News、Product Hunt、GitHub Trending
    6. 在 TrendRadar 的設定檔中,把 RSS URL 和關鍵字寫進去(下文有具體步驟)。

    💡 關鍵: 先選好 3–5 個核心主題,再讓系統自動過濾,能最大幅度減少你每天要處理的雜訊量。

    效果:每天系統自動幫你從海量資訊中,先過一輪「話題相關性」的篩選,你只看自己訂的幾條線。


    2. AI 翻譯 + 情感分析:跨語言、看氣氛

    TrendRadar 不是只推原文連結,而是會先用內建的 AI 分析:

    • 自動翻譯:把英文、日文等新聞翻成中文摘要
    • 情感分析:判斷內容情緒(正面 / 負面 / 中性)
    • 概要整理:用幾句話抓出重點

    具體可以怎麼用:

    • 品牌輿情:
    • 快速看今天關於你品牌的討論是偏正面還是負面
    • 先看 AI 摘要,再決定要不要點進原文細讀
    • 技術動態:
    • GitHub Trending 上出現的新專案,先用中文看懂做什麼
    • 挑出「跟你技術棧有關」且熱度在上升的專案

    實際行動:

    1. 在 TrendRadar 設定好要做情感分析的關鍵字(例如你的品牌名、產品名)。
    2. 啟用 AI 翻譯與摘要(專案中已預設支持,依 README 配好 API Key 或本地模型)。
    3. 每天在通訊工具裡看一眼「今日摘要」,不用再一篇篇翻。

    3. 多通訊工具推送 + MCP:變成你自己的「輿情機器人」

    TrendRadar 支援把整理過的結果,推送到你已經在用的工具:

    • 微信
    • 飛書
    • 釘釋
    • Telegram
    • Slack
    • Email / ntfy / Bark 等

    你可以把它當成一個「只會講重點的資訊機器人」,每天固定時間或有關鍵事件時推播給你。

    更關鍵的是:TrendRadar 支援 MCP(Model Context Protocol),可以讓它和你現有的 AI 助手(例如 ChatGPT、Claude)整合:

    • TrendRadar 負責:收集、過濾、打標(情感、主題)
    • ChatGPT/Claude 負責:深度分析、寫彙整報告、產生回應草稿

    實際可做的 workflow:

    1. TrendRadar 把今天跟品牌相關的負面事件整理成一份 JSON / 簡報式摘要。
    2. 在支援 MCP 的 AI 助手中,呼叫 TrendRadar 工具:「請分析今天的負面輿情,幫我寫一份回應策略與 Q&A 草稿」。
    3. 得到可以直接丟給 PR 團隊修改的版本。

    💡 關鍵: 讓 TrendRadar 負責「聽與記錄」,AI 助手負責「想與表達」,能把你每天需要親自處理的工作壓到最低。


    適合誰用?三個具體場景


    1. 品牌輿情追蹤:先知道「今天有沒有燒起來」

    角色:行銷、公關、品牌經理。

    設定方式:

    • 關鍵字:品牌名、CEO 名字、產品名、常見錯別字
    • 來源:
    • 新聞 RSS(產業媒體 + 大眾媒體)
    • 論壇 / 社群聚合 RSS(若有)
    • 推送頻率:
    • 每天早上 9 點彙總
    • 一有高負面情感的內容就即時推送

    日常用法:

    • 在 Slack/微信 建一個 #brand-alert 群組,只放 TrendRadar。
    • 每天固定看一眼,看今天有沒有需要回應的聲音。
    • 把其中幾則交給 ChatGPT:
    • 「請用溫和但不卑不亢的語氣,回覆這篇負面評論,給出三種版本。」

    2. 競品 / 技術趨勢監控:避開資訊焦慮,只看真正相關的

    角色:產品經理、技術主管、創業者。

    設定方式:

    • 關鍵字:
    • 競品名稱 + 公司名
    • 技術關鍵字(如 RAG、vector DB、serverless LLM)
    • 來源:
    • GitHub Trending(配合關鍵字過濾)
    • Product Hunt / Hacker News
    • 主要技術媒體 RSS

    日常用法:

    • 每天收到一份「競品 / 新技術」摘要:
    • 新發佈的功能 / 產品
    • 高熱度技術文章 / 專案
    • 再把摘要丟給 Claude:
    • 「整理成 5 點,說明這些變化對我們產品路線的影響,按緊急程度排序。」

    3. 內容創作者:每日素材雷達

    角色:寫 newsletter、拍 YouTube、寫部落格或社群的人。

    設定方式:

    • 關鍵字:
    • 你頻道聚焦的主題(AI 工具、遠端工作、投資、行銷等)
    • 來源:
    • 國外媒體 RSS
    • Twitter/X 清單轉 RSS(或間接服務)
    • 技術 / 產業部落格

    日常用法:

    • 每天早上收一份「今日 10 則值得寫的素材」,每則附:
    • 中文重點摘要
    • 推估情緒(這件事觀眾會興奮、焦慮、好奇?)
    • 把其中 1–2 則交給 ChatGPT:
    • 「幫我把這則趨勢寫成 5 條適合 IG / 小紅書的貼文金句。」

    TrendRadar + ChatGPT/Claude:兩工具分工實戰

    名稱 核心功能 免費方案 適合誰
    TrendRadar 多平台聚合、輿情監控、AI 摘要 開源,自架即免費 要持續監控品牌、競品、技術的人
    ChatGPT / Claude 深度分析、寫作、策略思考 有免費/試用方案 要把資訊變成企劃、回應、內容的人

    建議分工:

    • TrendRadar:
    • 24 小時自動收集與過濾
    • 做第一層翻譯、情感分析、摘要
    • ChatGPT/Claude:
    • 根據 TrendRadar 產出的內容,做二次加工
    • 產生 PR 草稿、簡報大綱、內容腳本

    操作示例:

    1. 在 Slack 接收 TrendRadar 的每日報告。
    2. 把報告內容複製到 ChatGPT:
    3. 指令範例:「請依照這份 TrendRadar 摘要,幫我生成一頁簡報的大綱,分成『今天發生什麼』『為何重要』『我們該怎麼做』。」

    怎麼開始:用 Docker 快速拉起 TrendRadar

    TrendRadar 是開源專案,支援 Docker 部署,你可以在本機或雲端(例如自家伺服器、雲主機)跑起來。


    1. 基本前置:準備環境

    必備條件:

    • 已安裝 Docker(和 docker-compose,如果專案使用)
    • 一台可以長時間運作的機器(本機、NAS 或雲主機都可)

    實際行動:

    • 安裝 Docker:
    • macOS / Windows:安裝 Docker Desktop
    • Linux:依發行版安裝(Ubuntu 可用 apt install docker.io 等)

    2. 拉取專案並啟動服務

    以下為通用步驟,具體以官方 README 為準(https://github.com/sansan0/TrendRadar):

    # 1. 取得程式碼
    git clone https://github.com/sansan0/TrendRadar.git
    cd TrendRadar
    
    # 2. 建立環境設定(通常會有 .env.example 或 config 檔)
    cp .env.example .env
    # 編輯 .env,填入必要的 API Key(如翻譯 / LLM 模型)
    
    # 3. 使用 Docker 啟動
    docker compose up -d
    

    啟動後,可以依 README 提供的網址(通常是 http://localhost:xxxx)打開管理介面或 API。

    💡 關鍵: 利用 Docker 一次配置好環境,之後只需重啟服務即可持續運作與更新。


    3. 設定第一組關鍵字與訂閱來源

    實際配置方式會依專案版本稍有差異,大致流程如下:

    1. 打開 TrendRadar 設定頁或編輯配置檔(例如 config.yaml):
    2. 新增一個「監控主題」(如 brand_watch、ai_trend)。
    3. 在主題下設定:
      • keywords: 你要追的關鍵字列表
      • sources: RSS 或其他來源 URL 列表
    4. 設定推送渠道:
    5. 在設定檔中填入 Slack Webhook URL、Telegram bot token 或微信/飛書機器人配置。
    6. 指定這個主題要推送到哪個渠道、頻率(例如每 6 小時一次)。
    7. 重新啟動或重新載入配置:
    docker compose restart
    

    檢查:等 10–30 分鐘,看通訊工具裡是否開始收到 TrendRadar 的摘要訊息。


    用一句話開始:把 TrendRadar 當成你的「每日第一問」

    當 TrendRadar 跑起來之後,你可以把每天的第一件事,改成問 AI:

    「根據 TrendRadar 的資料,今天跟我品牌 / 產業最有關的三件事是什麼?幫我說給非技術同事聽。」

    TrendRadar 負責幫你把訊息世界「縮小成可理解的摘要」,再交給 ChatGPT 或 Claude 做深度分析,你只要把最後的洞察做決策、做內容,就能在資訊過載的世界裡,保留大腦給真正重要的事情。


    🚀 你現在可以做的事

    • 開啟 TrendRadar 專案頁:https://github.com/sansan0/TrendRadar,照 README 在本機用 Docker 跑起來
    • 列出你最在意的 3–5 個主題,設定第一組 keywords 和 RSS sources 做實驗
    • 在常用通訊工具(Slack、微信等)建立一個專用頻道,把 TrendRadar 摘要接進來,明天早上開始用它看「今天在吵什麼」
  • 把 VS Code 變成自動寫程式助手:cline 實戰

    把 VS Code 變成自動寫程式助手:cline 實戰

    📌 本文重點

    • cline 是裝在 VS Code 裡的自主程式碼 Agent
    • 可批次改檔、跑指令、查文件,但每步都需授權
    • 搭配版本控制與測試,可成為安全的半自動 pair programmer

    cline 要解決的問題很直接:讓一個「在你本機 IDE 裡跑的自主程式碼 Agent」,幫你改檔、跑指令、查文件,但所有動作都要你按下同意鍵才會執行。

    專案連結:github.com/cline/cline


    cline 是什麼?一句話定位

    cline = 安裝在 VS Code 裡的自主程式碼 Agent,可以:

    • 建立 / 編輯專案檔案
    • 執行終端機指令(build、test、lint 等)
    • 啟動瀏覽器幫你查文件
    • 但每一步都會先列出具體操作,等你按「允許」才真的動手

    它的定位不是「幫你寫一個函式就結束」的 Copilot,而是能帶著你一步步完成一個功能或重構任務的半自動 pair programmer。


    核心功能:它到底能幹嘛?

    1. 批次改檔、搭 scaffold

    適合情境:

    • 重構一個舊專案,把同樣的 pattern 套到多個檔案
    • 快速搭一個新專案的骨架(資料夾結構、基本檔案)

    你可以這樣用:

    1. 在 VS Code 裡打開專案資料夾。
    2. 開啟 cline 面板,輸入指令,例如:

      幫我把 src/ 底下所有 React class component 改成 function component,並保留原本 props 型別。

    3. cline 會:
    4. 先掃專案,列出會動到的檔案
    5. 給你一份「變更計畫」與 diff 預覽
    6. 每個檔案修改前都問你要不要執行

    效果:一次性重構多個檔案,但仍保留「你是 code review 者」的掌控感。

    💡 關鍵: 用 cline 做批次重構時,每個變更都先 review,再執行,可以同時兼顧效率與安全。

    2. 查 bug、跑測試、看 log

    適合情境:

    • 接手別人寫的遺留專案
    • 單元測試一堆紅字懶得一個個追

    操作步驟:

    1. 把錯誤訊息貼給 cline,例如:

      Jest 測試 UserService 全掛了,請找出原因並修正。

    2. cline 會:
    3. 根據錯誤訊息定位到相關檔案
    4. 提出一個修正方案(含預計修改的檔案列表)
    5. 要你確認後才修改
    6. 自動幫你呼叫 npm test 或 pnpm test,再讀測試結果

    你可以要求它:

    每一次修正只改一小步,測試通過後再進下一步。

    這樣你就得到一個測試驅動的 AI 助手,不會一次改爆整個 codebase。

    3. 幫你查文件、Google / Docs 查詢

    cline 內建「用瀏覽器查資料」的能力(具體依你設定的模型與工具支援而定),常見用法:

    • 不熟的框架 API
    • 某個 CLI 旗標
    • 某個錯誤碼

    例子:

    有一段 webpack 設定報 deprecated 警告,請幫我找到官方文件,並提供對應的 config 調整建議,改動前先給我 diff。

    cline 會:

    1. 打開瀏覽器工具查官方文件
    2. 摘要關鍵片段
    3. 提出「建議改法 + diff」
    4. 再次問你要不要套用

    關鍵點:所有網頁行為和檔案修改,都會顯示在面板上,必須經你同意。


    安全設計:每一步都要你確認

    agent 工具最怕兩件事:

    • 誤刪 / 誤改檔案
    • 執行奇怪的 shell 指令

    cline 的設計剛好反過來:

    • 每次改檔會顯示 diff,你可以逐行檢查
    • 每次跑指令會顯示 完整命令,例如 rm -rf 這種你一看就會擋
    • 每次讀/寫新檔案,會明確說明路徑

    使用時務必做到:

    • 只把權限給當前專案資料夾
    • 不要在有機敏資料(憑證、prod config)的 repo 直接放手讓它改
    • 先在一個「測試用 repo」練習上述流程

    💡 關鍵: 把 cline 當成需要你簽名才能動手的助手,用「授權前必看 diff / 指令」這個習慣來降低風險。


    適合誰用?三種常見場景

    1. 中小專案重構 / 遺留專案接手

    典型痛點:

    • 接手一個 1–3 年歷史的 Node / Django 專案
    • 設計不統一,命名風格混亂
    • 文件過時

    cline 可以幫你:

    • 產生一份「現有結構地圖」:掃描目錄,生成 docs/ARCHITECTURE.md
    • 逐步統一命名規則(例如全部改用 camelCase)
    • 把散落在 code 的註解整理成文件

    行動建議:

    1. 開一個新 branch(例如 refactor/with-cline)。
    2. 讓 cline 先生成「重構計畫」,內容包含:
    3. 優先修哪些模組
    4. 預計拆出哪些共用函式
    5. 需要補哪些測試
    6. 你確認計畫後,再讓它照計畫一項項執行。

    2. 日常重複開發工作

    常見重複工作:

    • 每次新專案都要搭一套相同骨架
    • CRUD api 的樣板重複貼
    • 測試檔案格式一樣,只是名字和 case 不同

    cline 的價值在於:

    • 把這些「手很痠的工作」變成一段腳本
    • 你只要給它「任務描述 + 確認」,不用自己一檔檔複製

    建議做法:

    • 為你的團隊定義一份「標準專案骨架」描述,像:

      對新的 React 專案:使用 Vite、設定 ESLint + Prettier、建立 src/components, src/hooks, src/pages 目錄,並生成基本範例檔案。

    • 之後每一次開新 repo 直接把這段 prompt 丟給 cline,讓它自動完成。

    3. 半自動 pair programming(搭配本地 / 雲端模型)

    在 Reddit 上有不少人分享,把本地模型(例如 Qwen3.6 35B)搭配 agent 框架(如 little-coder、PI Coding Agent),透過「plan-first」工作流,讓本地模型在 Polyglot benchmark 上接近雲端模型表現。

    參考:
    – Qwen3.6-35B + little-coder 實測
    – PI Coding Agent + Qwen3.6 35B 實戰心得

    cline 做的是類似事情:

    • 把「計畫 → 分解任務 → 執行」這套流程搬進 IDE
    • 你可以接雲端模型(例如 Claude、OpenAI),也可以接本地模型(透過 OpenAI 相容 API)

    這樣你得到的是一個永遠不搶鍵盤、每步先跟你報告的 pair programmer。


    跟其他 VS Code Agent 工具怎麼選?

    名稱 核心功能 免費方案 適合誰
    cline (GitHub) 單一自主程式碼 Agent,內建檔案操作、終端機、瀏覽器,強調「每步需授權」 工具本身開源;需自備模型 API(金鑰可用免費額度) 想要在現有 VS Code 工作流中加一個安全的半自動助手
    Roo Code (GitHub) 多 Agent 協作,模擬「一整個開發團隊」,支援自動化測試、部署 開源;同樣需自備模型 API 想要嘗試多代理協作、較複雜工作流的進階使用者
    claude-context (GitHub) 把整個 codebase 變成 Claude 的上下文(MCP 工具) 開源;需有 Claude 帳號 重度使用 Claude Code,希望提升大專案上下文理解的人

    如果你只是想讓自己的 IDE 多一個「會聽話的 AI 助手」,cline 的上手成本最低。

    💡 關鍵: 已有模型 API 的使用者,只要裝好 cline,就能用很低成本把 IDE 升級成具備自主能力的開發環境。


    怎麼開始?最快上手路徑

    步驟一:安裝 cline

    最簡單方式是從 VS Code Extension 安裝:

    1. 打開 VS Code 的 Extensions 面板。
    2. 搜尋 cline,作者為 cline。
    3. 點選 Install。

    也可以從 GitHub 直接找到相關安裝說明:https://github.com/cline/cline

    (若未來提供 npm/CLI 版本,可以在 README 看到詳細指引。)

    步驟二:連接你的模型 API

    cline 不自帶模型,你需要自己準備一個:

    常見選項:

    • Claude(Anthropic)
    • OpenAI
    • 本地模型(透過 OpenAI 相容 API,如 Ollama、自架伺服器)

    設定方式(概念流程):

    1. 在 cline 設定面板填入:
    2. API Base URL(例如 https://api.openai.com/v1 或你的本地 endpoint)
    3. API Key
    4. 模型名稱(例如 gpt-4.1、claude-3.5、或你自訂的本地模型名)
    5. 測試一個簡單 prompt:

      嗨,幫我列出這個專案的主要資料夾結構。

    6. 確認能讀到檔案與回覆,表示連線成功。

    步驟三:直接可用的「plan-first」工作流程 Prompt

    下面這段可以直接複製,當成你和 cline 的標準開場白,每次要做較大的變更都先貼一次:

    你是一個在 VS Code 裡運行的程式碼 Agent,請嚴格遵守以下工作流程:
    
    1. 先閱讀專案的主要檔案與目錄,理解目前架構。
    2. 針對我提出的需求,先幫我:
       - 列出最多 5 個澄清問題(如果有疑慮)。
       - 擬一份分步計畫(Step 1, Step 2...),每步不超過 2–3 個具體修改。
    3. 把這份計畫寫成 `TODO.md` 放在專案根目錄,內容包含:
       - 任務描述
       - 預計修改檔案清單
       - 預計需要執行的指令(例如 test、build)。
    4. 在我明確回覆「同意計畫」之前,不要修改任何程式碼。
    5. 執行時:
       - 每次只完成 `TODO.md` 中的一個步驟。
       - 修改前先顯示預期變更與影響檔案。
       - 修改後自動幫我執行對應測試指令(若有),並總結結果。
    6. 任務結束後,更新 `TODO.md`(標記完成項目),並用要點方式總結你做了什麼。
    
    請先確認你理解上述流程,然後問我:這次要你幫忙的任務是什麼?
    

    有了這個「plan-first」腳本,你可以避免 Agent 一上來就亂改,先把計畫談好再動手。


    風險控管與實務建議

    最後幾個實際上很重要、但容易被忽略的點:

    • 權限只開專案資料夾:不要在整個 ~/ 或公司共用資料夾上跑;只針對單一 repo。
    • 先在測試 repo 試玩:隨便開一個 new repo,隨便寫一些 demo code,先讓 cline 練習跑 2–3 個任務,熟悉它的行為再用在正式專案。
    • 搭配版本控制:每個大任務都在新 branch 上跑,結束後自己再做一次 diff review。
    • 敏感資訊避免暴露:若你用雲端模型,注意不要讓它讀到含憑證 / 密鑰的設定檔,必要時把這些檔案加入 .gitignore 和 cline 的忽略清單。

    只要這幾個基本安全習慣有做到,cline 就可以很自然地變成你日常開發裡的「安全自動化助手」,從重構到寫測試,幫你把那些重複又耗時間的工作交給 Agent 處理。

    🚀 你現在可以做的事

    • 打開 VS Code 安裝 cline 擴充套件,並在一個測試用 repo 裡試跑 1–2 個小任務
    • 準備好你的模型 API(金鑰與 API Base URL),在 cline 設定面板完成連線測試
    • 建立一個標準的「plan-first」prompt 檔案,之後在每個新專案開頭都先貼給 cline 使用
  • 把 ChatGPT 搬進 iPhone:Gemma 4 實戰

    把 ChatGPT 搬進 iPhone:Gemma 4 實戰

    一句話定位:Gemma 4 讓你在 iPhone 上離線享受「接近 ChatGPT」的體驗,所有資料留在手機裡不出門。

    📌 本文重點

    • 在 iPhone 本地跑 Gemma 4,可離線又保護隱私
    • 用 Gemma 4 做聊天、翻譯、PDF/筆記問答與日記分析
    • 依照步驟完成「PDF/筆記 → 總結 + 問答」 workflow
    • 開發者可在手機上做無後端的 LLM 原型實驗

    下面的內容會帶你搞清楚:為什麼要在手機本地跑 Gemma 4、它能做什麼、適合哪些人用,以及最重要的——怎麼一步步在 iPhone 上跑起來,做到「把 PDF/筆記丟進去就能問答」。

    參考:Gemma 4 本地推理在 iPhone 上的討論,可見 Gizmoweek 報導 與 Hacker News 熱門串。


    核心差異:為什麼要在 iPhone 本地跑 Gemma 4?

    先把雲端模型(ChatGPT、Gemini)和本地 Gemma 4 的差異講清楚:

    • 隱私:
    • 雲端:你的對話、上傳檔案會經過伺服器。
    • 本地:模型在 iPhone 上推理,日記、醫療筆記、合同草案都不離開手機。

    • 離線可用:

    • 雲端:沒網路、飛機上、海外被限制時就完全失效。
    • 本地:Gemma 4 可以在飛機、公車、海外出差時照常回覆、翻譯、寫作。

    • 延遲穩定:

    • 雲端:高峰期會卡、會 timeout,速度跟網路品質綁死。
    • 本地:只看你 iPhone 效能,體感像打字機,多數短文秒回。

    💡 關鍵: 把 Gemma 4 放在 iPhone 本地跑,可以在無網路狀態下,用接近 ChatGPT 的體驗處理高度隱私與長文內容。

    如果你有「這些東西我不想丟到雲端」的內容,或常常沒網路,Gemma 4 在 iPhone 上會立刻變成高頻工具,而不是備胎。


    核心功能:你在 iPhone 上實際能做什麼?

    1. 對話與寫作助手(接近 ChatGPT 體驗)

    在支援本地 LLM 的 App 裡載好 Gemma 4 後,你就能:

    • 像聊天一樣問問題、整理想法
    • 寫 email 草稿、會議摘要、腳本、貼文
    • 讓它用你的語氣重寫文字(例如「幫我改成比較口語」)

    行動建議: 安裝一個本地 LLM App(下面「怎麼開始」會列),先用 Gemma 4 當純文字聊天助手,感受速度與溫度、耗電,再決定要不要開更大的模型。

    2. 本地長文與知識庫分析

    Gemma 4 支援長上下文版本(有社群實測用 26B + 256k context 分析十萬字日記,見 Reddit 分享),放在 iPhone 上就可以做:

    • 把整本 PDF 報告丟進去請它重點整理
    • 長期筆記/子彈筆記匯總,問它「幫我找出過去一年我最常抱怨的三件事」
    • 針對整個專案文件問答(而不是只看一頁)

    💡 關鍵: 長上下文的 Gemma 4 能處理十萬字等級的內容,適合把整本報告或多年日記一次交給手機上的模型分析。

    行動建議: 準備 1–2 份你真正在看的 PDF(研究報告、投影片),等下在 workflow 範例中會用到。

    3. 手機端開發實驗(快捷指令 + 簡單 App)

    對開發者或自動化玩家,Gemma 4 在 iPhone 上的價值在於:

    • 不用伺服器,就能在手機上測試 LLM 原型
    • 用 iOS 快捷指令 + 本地 LLM App 做簡單 Agent:
    • 選取文字 → 呼叫 Gemma 4 重新整理/翻譯
    • Share Sheet 把檔案丟給 Gemma 4 總結
    • 若走原生路線,可用 Core ML / Metal 把轉好的 Gemma 4 模型 embed 到 Xcode 專案裡

    行動建議: 如果你是 iOS 開發者,先用現成 App 測試好 prompt 與模型尺寸,再考慮用 Core ML 導入;這樣可以避免一開始就卡在部署。相關量化思路可對照 Google 在 Apple Silicon 上的 TurboQuant 技術介紹(參考 Towards AI 文章)。


    適合誰用?三個典型場景

    1)個人知識庫與日記:所有東西都留在手機

    適合這些人:

    • 有多年日記、心理諮商紀錄、醫療紀錄
    • 研究生、創作者,有大量私人筆記
    • 對雲端隱私完全不放心

    可以做的事:

    • 把日記匯出成純文字 / Markdown,分段丟給 Gemma 4:
    • 「找出我反覆提到但沒有行動的目標」
    • 「整理這一年,我對工作的情緒變化」
    • 對敏感筆記做聚合搜尋與摘要,不經過任何第三方伺服器。

    立即行動: 先在 iPhone 裡整理一個「私人 LLM 資料夾」,放日記匯出檔、健康紀錄,後面 workflow 直接用這個資料夾測試。

    2)出差 / 通勤沒網路的翻譯與寫作

    適合這些人:

    • 常飛機、常坐高鐵/地鐵、跨國出差
    • 在國外有網路限制,雲端 AI 不穩

    可以做的事:

    • 把待回的英文信貼進去:「幫我寫一封比較禮貌但堅決的英文回覆」
    • 開會前在車上,用 Gemma 4 把簡報講稿縮短成 5 個 bullet
    • 旅行時拍照 + OCR 轉文字後,丟給 Gemma 4 做即時翻譯與說明

    立即行動: 下次搭車前,把常用的翻譯/寫作 prompt 存成備忘錄,沒網路時直接複製給 Gemma 4 用。

    3)開發者在手機上做原型與小工具實驗

    適合這些人:

    • iOS 工程師、快捷指令玩家
    • 想做「不需要後端」的 AI 小工具

    可以做的事:

    • 寫一個快捷指令:
    • 取得目前剪貼簿文字
    • 傳給本地 Gemma 4 App
    • 回傳整理後文字,直接覆蓋剪貼簿
    • 在 Xcode 專案中,用 Core ML 模型當 offline 助手(例如:程式碼註解生成、App 內 FAQ 問答)

    立即行動: 先在本地 LLM App 裡找到「URL Scheme / x-callback-url」或「Shortcut 支援」,確認能否被快捷指令呼叫,這會是你所有原型的入口。


    怎麼開始:在 iPhone 上跑 Gemma 4 的最短路徑

    先給一個工具選擇對照表(以 2026 年常見方案為例,實際名稱請依 App Store 為準):

    名稱(示例) 核心功能 免費方案 適合誰
    LM Studio Mobile 下載並在本地跑 LLM(含 Gemma 4)、聊天介面、檔案上傳 常見為免費 + 內購 想要「裝好就能用」的一般使用者
    MlcChat for iOS 基於 MLX / MLC 的高效本地推理,支援多模型 通常開源、免費 想試不同模型、在意性能的玩家
    自建 Core ML App 直接在 App 內嵌 Gemma 4 Core ML 模型 自行開發 iOS 開發者,要做產品原型

    實際請搜尋「local LLM」「offline AI」關鍵字,並確認是否支援 Gemma 4 款式或通用 GGUF / MLC 格式。

    步驟 1:選一個 App + 安裝

    1. 打開 App Store,搜尋:local LLM、offline AI、MLC Chat 等關鍵字。
    2. 看描述裡有沒有提到 Gemma 4 或「自訂模型 / GGUF / MLC」支援。
    3. 安裝後確認:
    4. 是否有「下載模型」功能
    5. 是否支援「匯入檔案」或「knowledge base / documents」

    步驟 2:選擇合適尺寸的 Gemma 4 模型

    iPhone 上不要一開始就上最大顆,會太熱又太慢。可依照:

    • 中階機種(A15 / A16、基本容量):
    • 建議:Gemma 4 2B–4B 量化模型(例如 Q4 / Q5)
    • 用途:聊天、筆記整理、短文翻譯

    • 高階 Pro / Max(A18 Pro 類級別,RAM 8GB+):

    • 建議:Gemma 4 9B 左右的量化模型,若 App 支援可試長上下文版本
    • 用途:較長文章摘要、本地知識庫問答

    行動建議: 先下載一個 2B–4B 模型,跑幾分鐘聊天測試溫度。如果手機發燙明顯,就把 thread 數調低或換更小模型。

    步驟 3:測試性能、溫度與耗電

    1. 開啟 App,載入 Gemma 4 模型。
    2. 問它一個中等長度 prompt,例如:

    「請用條列整理 Netflix 訂閱變貴時,使用者常見的三種反應,控制在 200 字內。」

    1. 觀察:
    2. 生成 200 字大約需要幾秒?
    3. 手機背面溫度明顯變熱嗎?
    4. 連續用 10 分鐘後,電量大約掉多少?

    5. 在 App 設定中調整:

    6. 推理 thread(有時稱為「CPU 核心數」「推理執行緒」)
    7. 最大輸出 token 數(不必要就別一次開超大)

    目標狀態:

    • 你可以連續聊 10–15 分鐘,手機只是微熱,耗電還在可接受範圍。

    步驟 4:實戰 Workflow —— 把 PDF/筆記丟給 Gemma 4 做總結與問答

    示範一個你可以直接照做的流程:

    1. 準備檔案
    2. 在檔案 App 建一個資料夾:LLM-Inbox。
    3. 把一份 PDF(例如 20–30 頁的報告)或匯出的日記 .txt 放進去。

    4. 在 App 裡建立「知識庫」或上傳文件

    5. 打開你的本地 LLM App,找到「Documents / Knowledge / Files」等選項。
    6. 選擇 LLM-Inbox 裡那個檔案上傳或索引。

    7. 設定一個專門對話空間

    8. 新建一個對話,命名成「某某報告 Q&A」。
    9. 在 system prompt(如果有)寫上:

      「你只能根據我上傳的文件回答問題,不要憑空猜測。回答用繁體中文。」

    10. 實際問問題

    11. 「請用 300 字總結這份報告的主要結論。」
    12. 「作者提出的三個建議是什麼?幫我用自己的話改寫。」
    13. 「如果我要做 5 分鐘簡報,應該只挑哪三個 key slide?」

    14. 優化體驗

    15. 如果覺得速度太慢:
      • 換更小的 Gemma 4 模型
      • 限制回答字數,例如「控制在 150 字內」
    16. 如果回答常飄走:
      • 再加一句規則:「如果文件沒有提到,就回答『文件未提及』。」

    完成這個 workflow 後,你就已經不是「玩玩看」而是把 Gemma 4 變成日常讀書 / 工作輔助工具。接下來才是微調 prompt、換更大模型或試試手機端原型開發。

    💡 關鍵: 只要先打通「PDF/筆記 → 總結 + 問答」,Gemma 4 就能穩定接手你日常的讀書、報告與資料整理工作。


    總結:先把一件小事做通,再考慮玩更大

    在 iPhone 本地跑 Gemma 4,不需要一次搞懂所有量化格式、Core ML 細節。建議你照這個順序:

    1. 找一個支援本地模型的 iOS App
    2. 下 1 個中等大小的 Gemma 4 模型
    3. 完成「PDF/筆記 → 總結 + 問答」這個 workflow
    4. 覺得穩定好用,再往日記分析、快捷指令、自建 App 擴展

    做到第 3 步,你就已經把「接近 ChatGPT 的體驗搬進 iPhone,而且可離線」真正落地了。

    🚀 你現在可以做的事

    • 打開 App Store 搜尋「local LLM / offline AI」,安裝一個支援 Gemma 4 或 GGUF 的 App
    • 準備一個 LLM-Inbox 資料夾,把一份 PDF 或日記 .txt 放進去,按文中步驟跑完一次總結 + 問答
    • 觀察 10–15 分鐘使用時的速度與溫度,調整模型大小與 thread 設定,找出最適合你 iPhone 的組合
  • GAIA 本地多代理實戰指南

    GAIA 本地多代理實戰指南

    📌 本文重點

    • 本地多代理更可控
    • sandbox 與權限隔離
    • 先選小模型再優化
    • Workflow 可 checkpoint

    在本地硬體上跑 GAIA 多代理 workflow,直接解決三個實際痛點:

    💡 關鍵: 本地部署的核心價值,不只是省雲端費用,更是把隱私、延遲和權限控制都收回自己手上。

    1. 隱私與合規:內網知識庫、檔案內容不出機器,減少 DLP 顧慮。
    2. 可控成本與延遲:不綁雲端 API,長任務與大量工具呼叫的成本與延遲可預期。
    3. 更細緻的權限隔離與除錯:工具執行在你設計的 sandbox 內,log、資源監控都在本機可觀測。

    以下以「本地檔案整理 + 內網知識庫助理」為具體任務,示範如何用 GAIA 在單機上組出一個可用的多代理系統,並說清楚在 Apple Silicon / GPU / 純 CPU 場景下要怎麼選 LLM 和調整架構。


    重點說明

    1. GAIA 的基本心智模型:Agent / 任務 / 工具

    GAIA 的抽象其實很單純:

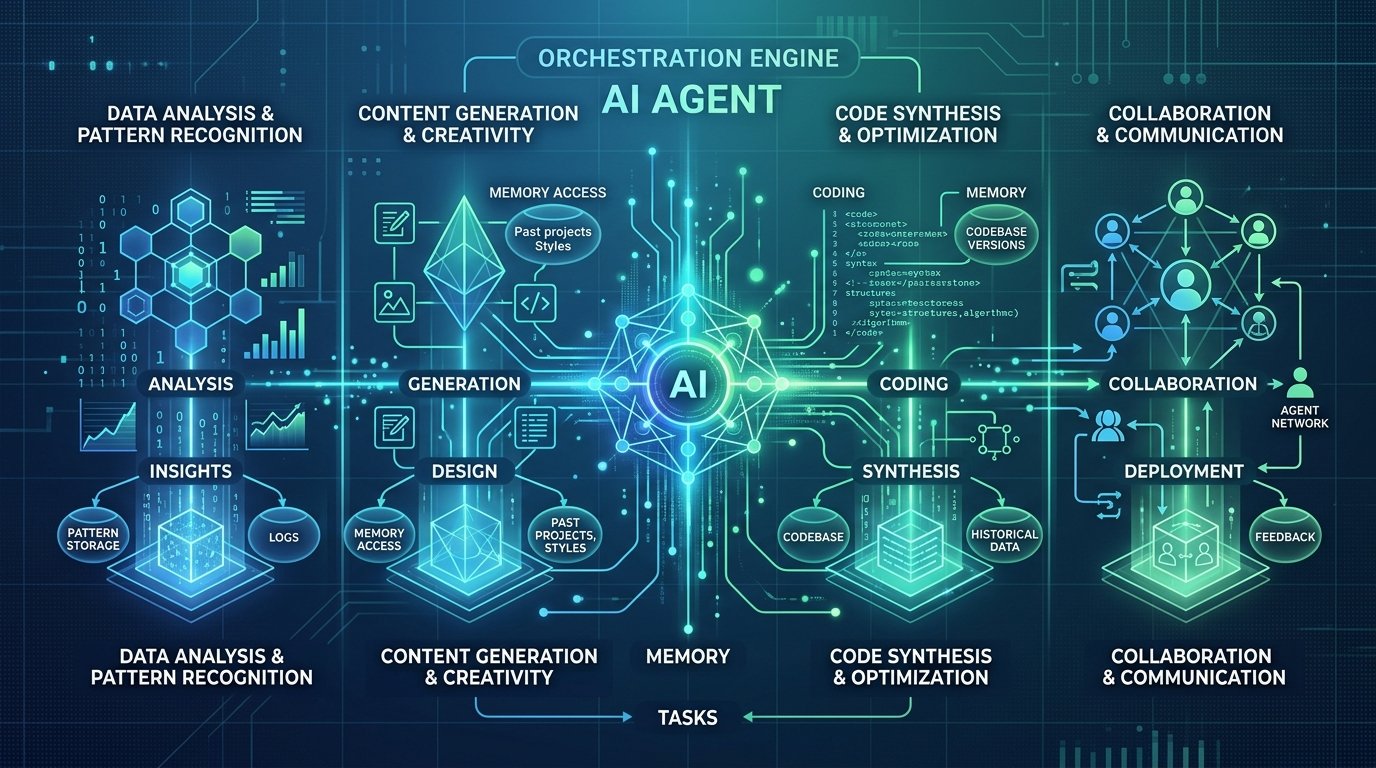
    • Agent:有「目標 + 能力」的行為體,通常綁一個 LLM + 一組工具。
    • 任務(Task / Workflow):定義起點、終點,以及 Agent 如何接力。
    • 工具(Tools):一組可呼叫的函式,如檔案系統、HTTP、向量搜索,GAIA 會把它們包成可被 LLM 呼叫的函式呼叫介面。

    實務上你會這樣切:

    • 一個 Planner Agent 負責拆解高階目標:例如「整理 ~/Downloads 並產出 README」。
    • 一個 FileOps Agent 只負責檔案遍歷、分類、改名,綁定檔案系統工具,權限嚴格限制。
    • 一個 Knowledge Agent 使用向量庫對內網 markdown/PDF 做檢索與摘要。

    2. 在單機協調多代理:比你想像中輕量

    GAIA 不是重型的分散式框架,而是偏 本地 Orchestrator:

    • 用一個主 loop 或 workflow engine 管理 Agent 呼叫順序、中間狀態與錯誤。
    • 每個 Agent 呼叫相同或不同 LLM(例如:Planner 用小模型,Knowledge Agent 用大模型)。
    • 即使只有一張 GPU 或一台 Apple Silicon,透過限流與序列化調度一樣能跑多代理,只是併發要保守。

    3. 本地 LLM 選擇策略(Apple / GPU / CPU)

    Apple Silicon(M1–M4):

    • 優先考慮 MLX + Qwen3.5 / Gemma 4 / Llama 家族的 8–9B 量化。
    • 善用像 Reddit 提到的 DFlash 推測解碼:在 9B 級模型上可有 ~4× decoding 加速,對多代理回合式對話很有感。

    💡 關鍵: ~4× decoding 加速代表回合式多代理互動的體感差異會非常明顯,特別是在本地裝置上。

    • 32GB RAM 以上:可以考慮 27B 量級,但要注意 context 與 batch size 的 trade-off。

    桌機 GPU(NVIDIA):

    • llama.cpp / vLLM / TensorRT-LLM 都可;若用 llama.cpp,可利用社群的 llm-server v2 --ai-tune 自動調 flags,實測 Qwen3.5-27B 可 +50% tok/s 以上,對長任務吞吐提升很明顯。

    💡 關鍵: +50% tok/s 以上的提升,對長任務與大量工具呼叫會直接反映在整體吞吐量上。

    純 CPU:

    • 參考 Gemma 4 在 CPU 的實測,8B 級模型仍可用,但要:
    • 選擇更小模型 + 更 aggressive 量化(如 Q4_K_M);
    • 控制 max_tokens,避免一次生成太長;
    • 任務設計上用更多工具、多輪互動,降低單次生成長度。

    實作範例:從零到一的本地多代理 workflow

    假設你要在 Mac(M2 Pro + 32GB)上做一個:

    指定資料夾路徑 → 自動整理檔案並產出整理報告 → 同時讓知識庫助理可以回答「這次整理做了什麼?」

    以下用簡化版 pseudo-code 示意 GAIA 專案結構與關鍵程式碼。

    專案結構

    my-gaia-local-agents/
    ├── gaia_config.yaml       # GAIA 全域設定(LLM, 日誌, sandbox)
    ├── agents/
    │   ├── planner_agent.py
    │   ├── fileops_agent.py
    │   └── knowledge_agent.py
    ├── tools/
    │   ├── file_tools.py      # 檔案操作工具
    │   └── vectordb_tools.py  # 內網知識庫檢索
    ├── workflows/
    │   └── organize_and_report.py
    └── main.py
    

    1. 定義本地 LLM backend

    假設你用 Ollama + Qwen2.5 7B 作為通用模型(Apple / GPU / CPU 都能跑):

    # gaia_config.yaml
    llm_backends:
      default:
        type: http
        base_url: "http://localhost:11434/v1"
        model: "qwen2.5:7b"
        # 重要:明確限制 context 和輸出長度,避免拖慢整體 workflow
        params:
          max_tokens: 512
          temperature: 0.3
          top_p: 0.9
    
    logging:
      level: INFO
      file: "logs/gaia.log"
    
    sandbox:
      file_root: "./sandbox_root"   # FileOps 只允許在這之下操作
      allow_network: false           # 預設工具無網路
    

    實際好處:

    • 用 HTTP LLM backend,你可以隨時切換到 llama.cpp server / MLX server / vLLM 而不用改 Agent 邏輯。
    • max_tokens + temperature 控制對本地效能非常關鍵,避免一個 Agent 把整個 context 塞爆。

    2. 定義工具:檔案操作與向量檢索

    # tools/file_tools.py
    from gaia import tool
    from pathlib import Path
    
    SANDBOX_ROOT = Path("./sandbox_root").resolve()
    
    @tool(name="list_files", description="列出目錄下的檔案與大小")
    def list_files(path: str) -> dict:
        root = (SANDBOX_ROOT / path).resolve()
        assert root.is_dir() and str(root).startswith(str(SANDBOX_ROOT)), "path out of sandbox"
        files = []
        for p in root.iterdir():
            if p.is_file():
                files.append({"name": p.name, "size": p.stat().st_size})
        return {"files": files}
    
    @tool(name="move_file", description="移動檔案到新資料夾")
    def move_file(src: str, dst: str) -> str:
        src_path = (SANDBOX_ROOT / src).resolve()
        dst_path = (SANDBOX_ROOT / dst).resolve()
        assert str(src_path).startswith(str(SANDBOX_ROOT))
        assert str(dst_path).startswith(str(SANDBOX_ROOT))
        dst_path.parent.mkdir(parents=True, exist_ok=True)
        src_path.rename(dst_path)
        return f"moved {src} to {dst}"
    

    幾個關鍵點:

    • 用 @tool 裝飾器,GAIA 會自動產生給 LLM 用的工具 schema。
    • 使用 sandbox_root + startswith 檢查,避免 Agent 亂動整個檔案系統。

    向量檢索工具(略寫):

    # tools/vectordb_tools.py
    from gaia import tool
    from my_vectordb import search
    
    @tool(name="kb_search", description="在內網知識庫中搜尋相關文件")
    def kb_search(query: str, top_k: int = 5) -> list:
        return search(query, top_k=top_k)
    

    3. 定義 Agents

    # agents/planner_agent.py
    from gaia import Agent
    from gaia.llm import LLMClient
    
    llm = LLMClient.from_config("default")
    
    planner = Agent(
      name="planner",
      llm=llm,
      tools=[],  # Planner 不直接動檔案
      system_prompt="""
    你是任務規劃專家。使用簡短 JSON 回覆,包含 steps,
    每個 step 指定要由哪個 agent 執行(fileops 或 knowledge)。
    """
    )
    
    # agents/fileops_agent.py
    from gaia import Agent
    from gaia.llm import LLMClient
    from tools.file_tools import list_files, move_file
    
    llm = LLMClient.from_config("default")
    
    fileops = Agent(
      name="fileops",
      llm=llm,
      tools=[list_files, move_file],
      system_prompt="""
    你負責安全地整理檔案,只能使用提供的工具操作 sandbox 內的路徑。
    每次操作前先列出檔案,再決定如何移動。
    """
    )
    
    # agents/knowledge_agent.py
    from gaia import Agent
    from gaia.llm import LLMClient
    from tools.vectordb_tools import kb_search
    
    llm = LLMClient.from_config("default")
    
    knowledge = Agent(
      name="knowledge",
      llm=llm,
      tools=[kb_search],
      system_prompt="""
    你是內網知識庫助理,先呼叫 kb_search 找到相關內容,
    再用找到的內容回答使用者問題。
    """
    )
    

    4. Workflow:協調多代理 + 任務恢復

    # workflows/organize_and_report.py
    import json
    from gaia import Workflow
    from agents.planner_agent import planner
    from agents.fileops_agent import fileops
    from agents.knowledge_agent import knowledge
    
    class OrganizeWorkflow(Workflow):
        def run(self, target_dir: str):
            # 1) 用 planner 拆解任務
            plan = planner.run_sync(f"請為資料夾 {target_dir} 制定整理計畫,輸出 JSON 格式。")
            steps = json.loads(plan["content"]).get("steps", [])
    
            history = []
            for step in steps:
                agent_name = step["agent"]
                instruction = step["instruction"]
    
                if agent_name == "fileops":
                    result = fileops.run_sync(instruction)
                elif agent_name == "knowledge":
                    result = knowledge.run_sync(instruction)
                else:
                    continue
    
                history.append({"agent": agent_name, "instruction": instruction, "result": result})
                self.save_checkpoint(history)  # **關鍵:長任務可恢復**
    
            return history
    
        def save_checkpoint(self, state):
            with open("./state/organize_checkpoint.json", "w") as f:
                json.dump(state, f, ensure_ascii=False, indent=2)
    

    最後入口:

    # main.py
    from workflows.organize_and_report import OrganizeWorkflow
    
    if __name__ == "__main__":
        wf = OrganizeWorkflow()
        history = wf.run("downloads")
        print("任務完成,歷史記錄:")
        print(history)
    

    實際好處:

    • Workflow + checkpoint 讓你可以安全跑幾十分鐘的整理任務,中途 crash 可恢復。
    • 檔案操作與知識庫檢索被清楚拆成不同 Agent,權限與日誌都更好控管。

    建議與注意事項

    1. 模型大小與上下文限制:先決策、再堆功能

    • 本地 Agent 系統最常見的坑是 一開始就選太大模型 + 太大 context:
    • Apple 32GB + 27B 模型 + 128k context 幾乎一定卡。
    • 建議流程:
    • 先用 7–9B 模型 + 8k–16k context 做 MVP。
    • 觀察 GAIA 的日誌與 latency 再決定是否升級模型或 context。
    • 用「多輪互動 + 工具」彌補模型容量,而不是盲目換大模型。

    2. 工具執行安全 & sandbox 設計

    • 檔案操作請一定:
    • 使用 sandbox root + path 檢查(如上例)。
    • 禁用 rm -rf 類型操作,必要時只暴露「移動到 trash」工具。
    • 若 Agent 需要網路:
    • 以 proxy 工具封裝(如 http_get),不要讓 Agent 任意發 HTTP。
    • 在工具層加 domain allowlist。

    3. 長任務與錯誤恢復

    • GAIA workflow 必須:
    • 對每個工具呼叫與 Agent 回應寫入結構化 log(JSON)。
    • 週期性 checkpoint 中間狀態(如上例 save_checkpoint)。
    • 常見錯誤種類:
    • LLM 回 JSON 解析失敗 → 在 workflow 層加入重試 + 自我修復 prompt(要求模型只回合法 JSON)。
    • 工具拋例外(路徑不存在、權限錯)→ 在工具層 catch,回傳結構化錯誤訊息給 Agent 解讀,而不是直接 crash。

    4. 本地 vs 雲端 Agent:怎麼選?

    適合用 GAIA 本地落地的場景:

    • 需要處理敏感檔案 / 內網知識庫(法務、醫療、R&D 原始碼)。
    • 需要低延遲 + 高互動頻率的工具呼叫(檔案整理、CI/CD 助理、開發環境助手)。
    • 有穩定的本地硬體(Mac Studio / 工作站 / 甚至改造手機當常駐節點,如 Xiaomi + Ollama 案例)。

    仍應用雲端 Agent 平台的情境:

    • 短期 PoC,需要快速試多種 SOTA 模型(如 GPT-4.1, Claude 3.7)。
    • 任務高度 bursty,需要按需擴容,或併發數百以上的 Agent 任務。
    • 需要平台級功能(RBAC、審計、隊列管理)而你不想自己實作。

    實務建議:

    • 先在雲端 Agent 平台驗證 prompt、工具設計、整體 UX。
    • 穩定後再把核心工作流搬到 GAIA + 本地 LLM 上,對敏感資料與長任務特別划算。

    總結:GAIA 提供的是一個 在本地硬體上「可觀測、可控、可擴展」的多代理骨架。搭配 Apple Silicon/桌機 GPU 的本地 LLM 加速(--ai-tune、DFlash 等),你可以在單機上跑出相當實用的 AI Agents,而不再被雲端 API 綁死。關鍵是:先把 Agent / 工具 / Workflow 的邊界切清楚,再談模型與效能優化。

    🚀 你現在可以做的事

    • 先在 Ollama 或 llama.cpp 上跑一個 7B 模型
    • 按本文結構拆出 planner、fileops、knowledge 三個 Agent
    • 先用 sandbox_root 做安全檔案操作,再逐步加上 checkpoint 與 kb_search