標籤: 多模態模型

  • GPT‑5.6 Sol 實測:把圖片變成可對話資料庫

    GPT‑5.6 Sol 實測:把圖片變成可對話資料庫

    📌 本文重點

    • GPT‑5.6 Sol:強大的免費視覺理解模型
    • 可將任何圖片轉成結構化資料與可行動內容
    • 適合 PM、工程師、知識工作者與學生日常使用

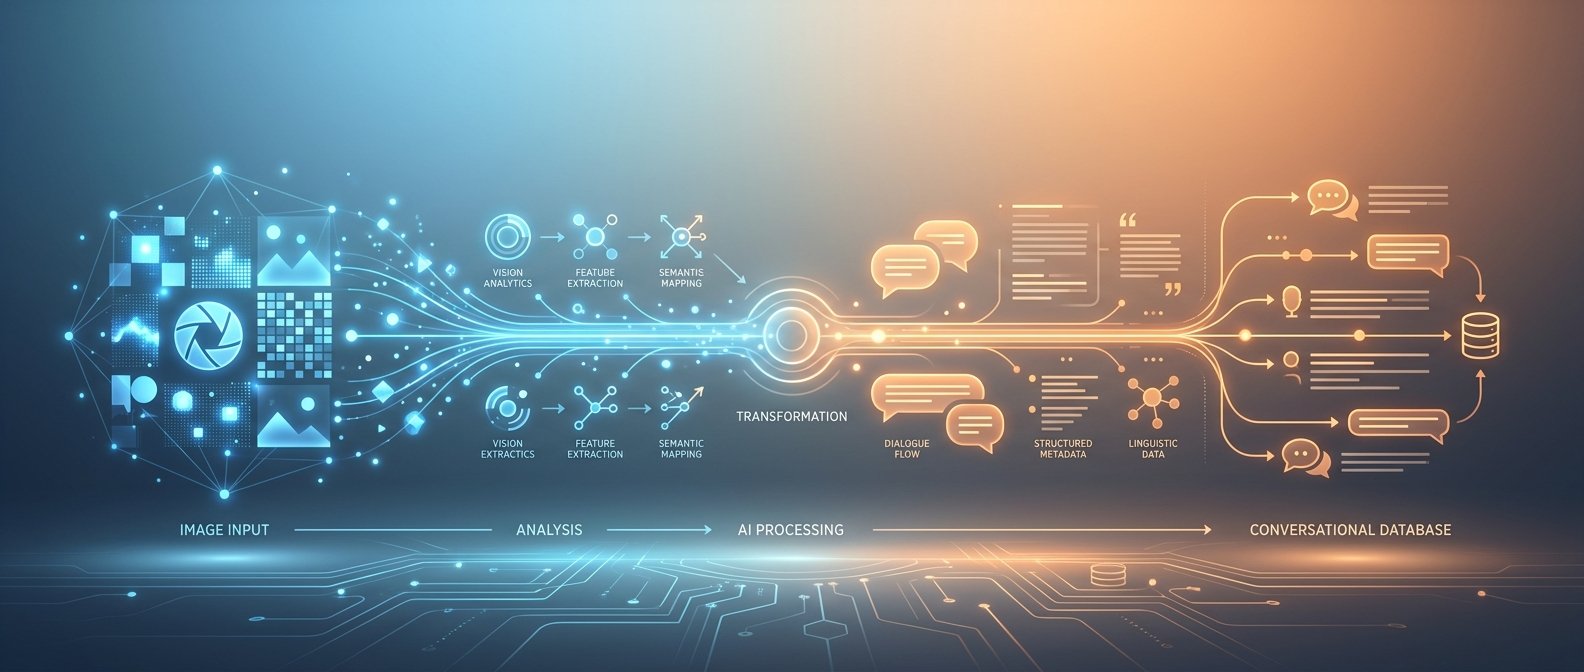
    一句話先講清楚:GPT‑5.6 Sol 就是一個「把任何圖片,變成可對話的結構化資訊引擎」的免費視覺模型。你丟 UI 畫面、流程圖、簡報、課本照片,它都能幫你拆成條列、表格、JSON 結構,接著和你一起推理、規劃、改寫。

    延伸閱讀:GPT 5.6 Sol is the best “vision” model OpenAI ever released(Roboflow)


    核心功能:四類圖片,一套思路

    下面這四個能力,是你日常工作幾乎每天都用得到的:

    1. 介面&報表理解:把畫面拆成欄位、操作流程

    Sol 的強項是看畫面就能理解「這是什麼系統、有哪些輸入輸出、使用者會怎麼操作」。

    能做到的事:

    • 螢幕截圖、Figma 畫面 → 條列介面元素、欄位意義
    • 數據儀表板/報表截圖 → 整理成表格+關鍵指標解讀
    • 網頁畫面 → 推測使用者流程、可能的 CTA 與漏斗

    你可以這樣用:

    上傳一張系統畫面,搭配文字:

    這是我們內部訂單管理系統的截圖,請:
    1. 條列畫面上所有欄位與按鈕,說明用途
    2. 推測完整使用者操作流程(從進入頁面到完成訂單)
    3. 匯出成 JSON 結構:{step, action, input_fields, output}


    2. 流程圖與架構圖分析:幫你「用嘴」改系統

    Sol 看懂箭頭、方框、節點彼此關係,適合拿來快速討論系統設計。

    可以做到:

    • 系統架構圖 → 抽出服務清單、依賴關係、可能瓶頸
    • 資料流圖 → 指出安全風險、延遲來源、可快取點
    • 業務流程圖 → 找出人工步驟、可自動化環節

    實際操作:

    貼一張系統拓樸圖,詢問:

    這是目前的系統架構,請:
    1. 用文字重述整體資料流
    2. 找出三個可能的單點失敗風險
    3. 提出兩種改版方案,分別優先提升可靠性/擴充性


    3. 文件掃描:簡報、PDF、紙本變成行動清單

    Sol 讀圖片型文字的能力很好,尤其是:

    • 簡報截圖、講義照片 → 整理成條列、摘要、行動項目
    • 掃描 PDF → 自動找章節重點、重要數字與定義
    • 白板/手寫筆記 → 轉成段落+待辦事項

    範例用法:

    上傳一張簡報頁面,請它:

    把這頁簡報內容:
    1. 濃縮成 5 點摘要
    2. 整理出「接下來一週可以執行的具體行動清單」,用 checklist 格式
    3. 輸出成 Markdown,方便貼到 Notion


    4. 實物/場景理解:從畫面推需求與規格

    除了文件,Sol 也能看懂實體世界的畫面:

    • 實物照片 → 辨識零件、用途、可能問題(例如損壞、錯配)
    • 環境/場景 → 推測流程、設備配置、安全風險
    • 教學器材、課本圖例 → 整理成教學步驟、題庫

    應用範例:

    拍一張教學實驗設備照片:

    根據這張實驗設備照片:
    1. 推測實驗主題與步驟
    2. 列出需要注意的安全事項
    3. 幫我設計 3 題考題(選擇題),附標準答案


    💡 關鍵: GPT‑5.6 Sol 能把原本只能「看」的圖片,轉成可搜尋、可編輯、可推理的結構化資料,是連結視覺與文字工作流程的核心工具。


    適合誰用?四種角色的實際場景

    1. 產品/PM:丟 Figma,請它寫 PRD 和 edge cases

    場景:你只有原型圖,卻要明天開需求評估會議。

    操作步驟:

    1. 在 Figma 內選擇幾個核心畫面,輸出 PNG。
    2. 在 ChatGPT 對話視窗上傳圖片(確保模型選擇 Sol 或系統自動使用最新視覺模型)。
    3. 用這種 prompt:
      “`
      這是新功能的 Figma 畫面,請:
    4. 條列出這個功能的目標與主要使用情境
    5. 以 PRD 形式整理:user story、主要流程、欄位規格
    6. 列出至少 10 個 edge cases 與錯誤訊息設計建議
    7. 用表格輸出,方便我貼到 Confluence
      “`

    你可以迭代:再丟一張畫面,請它「更新前面 PRD 中的流程圖與欄位表」,做到真正的圖片驅動需求寫作。


    2. 工程師:錯誤畫面+拓樸圖,請它推理問題和改動建議

    場景:線上系統偶發錯誤,你截了錯誤頁面和架構圖,想快速釐清可能原因。

    操作步驟:

    1. 上傳錯誤畫面(包含錯誤訊息、URL、時間等)。
    2. 再上傳相關系統拓樸圖或 sequence diagram。
    3. 用這個 prompt 合併分析:
      “`
      這兩張圖分別是:
    4. 錯誤畫面(前端顯示)
    5. 系統架構圖(後端服務與資料流)
      請:
    6. 推測可能的錯誤來源(依機率排序)
    7. 列出需要檢查的 log 與監控指標
    8. 提出一個最小改動的修正方案,並說明影響範圍
      “`

    這種用法適合拿來當排錯思路清單,幫你檢查是否漏掉某些角度(網路、資料庫、第三方服務等)。


    3. 資訊工作者:簡報截圖/掃描 PDF → 重點整理+行動清單

    場景:開完會只有投影片照片;或拿到是掃描版 PDF,沒有文字層。

    操作步驟:

    1. 把照片或 PDF 截圖分批上傳 Sol。
    2. 先叫它「逐頁摘要」,再叫它「整併成完整會議紀錄+行動項目」。
    3. 範例 prompt:
      “`
      這是本次專案會議的簡報截圖,請:
    4. 每張圖先各自寫 3-5 點摘要
    5. 統整成一份會議重點(含背景、決策、未決議題)
    6. 列出所有具體待辦事項,格式:{owner, task, deadline_suggestion}
      “`

    這比純文字總結更精準,因為 Sol 能看到圖表、流程箭頭、註解框這些細節。


    4. 個人學習:課本照片/板書 → 筆記+題庫

    場景:上課拍板書、拍課本,想回家變成系統化筆記。

    操作步驟:

    1. 把同一章節的幾張照片一次上傳。
    2. 請它先整理成「樹狀大綱」,再生成題目。範例:
      “`
      這些照片是同一章節的內容,請:
    3. 整理成分層的大綱(章節 → 小節 → 關鍵概念)
    4. 用自己的話重寫成教學筆記,讓高中生看得懂
    5. 根據內容出 5 題選擇題、5 題簡答題,附標準答案
      “`

    久了你會發現:Sol 可以直接變成你的圖片型知識轉文字型筆記的流水線。


    💡 關鍵: 不論你是 PM、工程師或學生,只要日常有「截圖」或「拍照記錄」,Sol 就能幫你把這些零散視覺資訊變成系統化產出。


    怎麼開始:免費用 Sol +簡單 API 範例

    1. 在 ChatGPT 免費/低階方案使用 Sol

    目前 Sol 已整合在 OpenAI 的 ChatGPT 中,免費或低階方案也能用,重點是:

    💡 關鍵: 即使是免費或低階方案,也能直接使用 Sol 視覺模型,降低導入門檻。

    1. 入口位置:
    2. 登入 chatgpt.com 或官方 App。
    3. 新建對話,確保模型選擇為最新可視覺模型(通常會標示 GPT‑5.6 或支援「圖片上傳」)。

    4. 上傳圖片方式:

    5. 在輸入框旁邊使用「上傳檔案/圖片」按鈕,上傳截圖、照片、掃描件。
    6. 同一則訊息可上傳多張,適合完整章節或多頁簡報。

    7. 提問範例 prompt 模板:
      “`
      這張圖(或這幾張圖)是:[簡短描述,例如:產品原型圖/系統拓樸/簡報/課本內容]。
      請依照以下步驟幫我處理:

    8. 先用自己的話描述這張圖在講什麼
    9. 把重要元素整理成結構化資料(條列或表格)
    10. 依我的角色(產品/工程師/學生),提出 3-5 個你建議我接下來可以做的具體行動
      “`

    你可以把這段當作通用模板,之後再加上更細的輸出格式要求(例如「用 JSON 回答」)。


    2. 給開發者:最小可行 API 範例(圖像+文字 → JSON)

    以下是使用 OpenAI API(Node.js 範例)調用 GPT‑5.6 Sol,把圖片與指令變成 JSON 結構輸出的最小例子:

    注意:實際模型名稱與 endpoint 可能依 OpenAI 更新調整,請以官方文件為準。

    npm install openai
    
    import OpenAI from "openai";
    import fs from "fs";
    
    const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });
    
    async function analyzeImageToJSON() {
      const imageBytes = fs.readFileSync("./input.png");
      const base64Image = imageBytes.toString("base64");
    
      const response = await client.chat.completions.create({
        model: "gpt-5.6-sol", // 依官方最新名稱調整
        messages: [
          {
            role: "user",
            content: [
              {
                type: "text",
                text: "請分析這張圖,輸出介面元素與可能的使用流程,格式為 JSON:{elements:[], flows:[]}"
              },
              {
                type: "image_url",
                image_url: {
                  url: `data:image/png;base64,${base64Image}`
                }
              }
            ]
          }
        ],
        response_format: { type: "json_object" }
      });
    
      console.log(response.choices[0].message.content);
    }
    
    analyzeImageToJSON().catch(console.error);
    

    這段程式碼做的事很單純:

    • 把本機圖片轉成 base64
    • 丟給 GPT‑5.6 Sol 模型,搭配文字指令
    • 要求模型直接回傳 JSON 結構(方便你接在後續系統)

    3. 隱私與公司內部畫面注意事項

    視覺模型很容易讓人「隨手截圖就丟」,但有幾點要特別提醒:

    • 避免敏感資訊:
    • 公司內部系統截圖若含客戶資料、金額、地址、帳號,先打碼或模糊關鍵區域。
    • 法規敏感資料(醫療、金融)請遵守公司政策,不要直接上傳雲端模型。

    • 確認使用條款:

    • 不同方案對「是否用你的資料做模型訓練」的政策不同,請在帳號設定與隱私條款中確認。

    • 內網場景處理:

    • 若需要分析高度敏感架構圖,可考慮在公司內部部署方案(例如自架模型),不要直接使用公網 API。

    總結:把 Sol 想成一個「圖片轉結構化資料」的助理——你給它任何圖,它就幫你拆成可編輯、可推理、可執行的資訊。從 PM、工程師,到知識工作者和學生,只要日常有截圖或照片,就值得試著把這些「視覺碎片」,交給 GPT‑5.6 Sol 變成你工作流程的一部分。

    🚀 你現在可以做的事

    • 登入 chatgpt.com,上傳一張你常用系統或簡報截圖,照文中的通用模板試一次
    • 將文中的 Node.js 範例貼到本機專案,改成你自己的圖片與 prompt,測試 JSON 輸出
    • 選一個工作或學習場景(PM、工程師、會議紀錄或課本),設計一個固定的 Sol 使用流程並連續使用一週
  • 一句話搞懂 Gemini 3.6 Flash 家族

    一句話搞懂 Gemini 3.6 Flash 家族

    📌 本文重點

    • 3.6 Flash:多模態主力模型,長文省 token
    • Flash-Lite:專攻低延遲、低成本 API 場景
    • Flash Cyber + CodeMender:程式碼安全掃描與修補解決方案
    • 先用 AI Studio 試 3.6 Flash,再視需求串 API 與導入安全模型

    用一句話講清楚:Gemini 3.6 Flash 家族,就是「一套便宜好用、從寫作到程式安全都能涵蓋」的多模態模型組合,讓一般用戶寫內容、開發者串 API、安全團隊掃漏洞,都有對應的工具可用。


    一句話搞懂三個 Flash 模型怎麼分工

    先用一行幫你記住三款模型的定位:

    3.6 Flash 負責主力多模態(長文本、省錢),3.5 Flash-Lite 負責低延遲 API,3.5 Flash Cyber 搭 CodeMender 負責程式碼安全掃描與修補。

    💡 關鍵: 3 款模型分工明確,從內容生成到大量 API 呼叫再到安全掃描,都有專門工具可選,用對模型就能兼顧效果與成本。

    對應到你的需求,很簡單:

    • 想寫作、翻譯、看圖、看 PDF 👉 用 3.6 Flash
    • 想做聊天機器人、內部 FAQ Bot 👉 後端 API 選 Flash-Lite
    • 想掃 Repo 漏洞、產安全修補 PR 👉 用 Flash Cyber + CodeMender

    官方介紹與細節可參考:


    核心功能:為什麼說「免費又省錢」

    1. Gemini 3.6 Flash:多模態主力+省 65% token

    3.6 Flash 是這次更新的主角:

    • 多模態能力:支援文字、圖片、程式碼、文件,拿圖請它「幫我總結這張資訊圖」,或把 PDF 貼給它做重點整理都很適合。
    • 長上下文+節省 token:官方說明可 節省最多約 65% token 使用量(來源:The Decoder 報導),等於同樣一篇長文,token 花費更低。
    • 適合當「日常主力模型」:寫文章、改寫、翻譯、整理會議記錄、理解技術文件,都可以直接丟給 3.6 Flash。

    💡 關鍵: 最多節省約 65% token,代表在長文本情境下能顯著壓低使用成本,特別適合高頻率內容工作者。

    你可以做的事:

    • 開啟 Google AI Studio,用 3.6 Flash 當預設模型,先試三件事:
    • 貼一篇你最近寫的文章,請它「改寫成 3 點精簡重點」
    • 上傳一張複雜圖表,問它「用白話講裡面的結論」
    • 貼一段英文技術文件,請它「翻譯+加註解」

    入口:Google AI Studio(免信用卡可先玩)👉 https://aistudio.google.com

    2. 3.5 Flash-Lite:給開發者的低延遲 API

    Flash-Lite 是 3.5 Flash 的精簡版,定位很清楚:給需要大量 API 呼叫、講求速度和成本的開發者。

    特點:

    • 低延遲:用在聊天機器人、即時問答服務,不會讓使用者等太久。
    • 便宜:相較大型模型,Flash-Lite 的單次呼叫成本更低,適合 side project 或公司內部工具。

    你可以做的事:

    • 做一個公司內部 FAQ Bot:
    • 把人資 / IT / 行政 FAQ 整理成一個 JSON 或資料庫
    • 用自家後端(Node.js / Python)接 Gemini API,模型選 Flash-Lite
    • 在前端做一個簡單聊天視窗,把使用者問題送給 Flash-Lite,再加上你的 FAQ 檢索結果

    💡 關鍵: Flash-Lite 把「低延遲+低成本」綁在一起,特別適合需要高併發、多次呼叫的聊天與工具型應用。

    3. 3.5 Flash Cyber + CodeMender:安全掃描+自動修補

    Flash Cyber 是專門做 程式碼安全 的模型,主要搭配 Google 的安全編碼代理工具 CodeMender 使用。

    重點能力:(來源:The Verge 報導)

    • 快速發現與標記安全漏洞:支援多次高速呼叫,掃整個 Repo 的潛在問題。
    • 產生修補建議甚至自動 PR:透過 CodeMender,可直接給出修補的 patch 或 Pull Request。
    • 比同類大型安全模型(如 Anthropic Mythos)更具成本效益:適合 DevSecOps 團隊把「安全掃描」變成 CI pipeline 的一環。

    你可以做的事:

    • 把 Flash Cyber+CodeMender塞進你的 CI/CD:
    • 選定關鍵 Repo(例如:支援金流的服務)
    • 在 CI pipeline 增加一個步驟呼叫 CodeMender(綁 Flash Cyber)做安全掃描
    • 設定「阻擋條件」:偵測到高危漏洞就阻擋部署,並自動開 Issue / PR 給開發者

    注意:Flash Cyber 目前偏向提供給政府與可信任夥伴,普通開發者需要留意資格與開放程度(可留意 DeepMind 官網更新)。


    三款模型一張表看懂

    名稱 核心功能 免費方案 / 試用 適合誰
    Gemini 3.6 Flash 多模態主力、長上下文、省 token Google AI Studio 線上免費試用 一般使用者、內容創作者、分析師
    3.5 Flash-Lite 低延遲、低成本 API Cloud 上有免費額度與試用配額 Side project 開發者、內部工具團隊
    3.5 Flash Cyber 程式碼與安全漏洞掃描+修補 目前對政府與特定夥伴開放 安全團隊、DevSecOps、雲端平台營運方

    適合誰用:三類典型場景

    1)個人用戶:寫作、翻譯、圖片理解

    你只想要一個好用又省錢的 AI 助理,重點就是:全部用 3.6 Flash 就好。

    具體可以這樣用:

    • 寫作:給它「大綱+口氣要求」,讓它幫你產出初稿,再自己微調
    • 翻譯:把英文技術文章貼上,請它「翻譯成繁體中文+保留術語」
    • 圖片理解:上傳會議投影片截圖,問「這張的重點是什麼?幫我變成三點待辦事項」

    2)開發者:side project/內部工具串 Flash-Lite

    你要的是:API 便宜+速度可以接受,而不是每次都上最強的大模型。

    典型 side project:

    • 公司內部 FAQ Bot
    • 報表解說助手(讀 CSV / JSON,整合你自己的後端邏輯)
    • 客戶服務前台聊天機器人

    做法:

    1. 在 Google AI Studio 建一個新 API Key
    2. 後端選 Node.js / Python,用官方 SDK 串接
    3. 模型選 3.5 Flash-Lite,加上你自己的向量資料庫或關鍵字搜尋

    3)安全/DevSecOps:Flash Cyber + CodeMender

    如果你的工作是:

    • 管理大規模微服務 Repo
    • 維護金融或政府相關系統

    就可以把 Flash Cyber 當成「安全同事」,在以下場景使用:

    • 每次合併 PR 前,跑一次安全掃描
    • 每季度對關鍵服務做「全面程式碼健康檢查」
    • 新人上線前,先掃他改動的部分,避免引入基本錯誤

    怎麼開始:從線上玩到串 API

    步驟 1:用 Google AI Studio 線上試玩

    1. 打開 https://aistudio.google.com
    2. 登入 Google 帳號
    3. 在模型列表選 Gemini 3.6 Flash
    4. 嘗試:
    5. 貼一段你公司文件,請它「整理成給新人看的版本」
    6. 上傳一張圖表,請它「用中學生也懂的方式解釋」

    這一步的目的:先確認 3.6 Flash 的表現符合你的期待,再考慮串 API。

    步驟 2:拿 API Key 串自己的 side project

    1. 進 Google AI Studio,切到 API / Key 管理
    2. 建立一個新專案,生成 API Key
    3. 後端程式碼示意(以 Node.js 為例):
    npm install @google/generative-ai
    
    import { GoogleGenerativeAI } from "@google/generative-ai";
    
    const genAI = new GoogleGenerativeAI(process.env.GEMINI_API_KEY);
    const model = genAI.getGenerativeModel({ model: "gemini-3.5-flash-lite" });
    
    async function ask(question) {
      const result = await model.generateContent(question);
      console.log(result.response.text());
    }
    

    你可以立刻把這段變成:

    • FAQ Bot:把使用者問題+你整理出的 FAQ 一起丟進 prompt
    • 報表解說助手:先由後端讀取 CSV,算出數字,再請模型「用文字說明這些指標變化」

    步驟 3:學會「選模型+估成本」

    粗略的模型選擇與成本思路:

    • 優先用 Flash 系列:
    • 若是內容生成/多模態理解 👉 3.6 Flash
    • 若是大量聊天/高併發問答 👉 3.5 Flash-Lite
    • 若是安全掃描 👉 Flash Cyber
    • 遇到以下情況再考慮大模型(如 Pro 類型):
    • 極高難度推理
    • 任務對準確度要求極端嚴格

    估成本的簡單方法:

    1. 在 AI Studio 看一次 token 使用量,記下「平均一次請求的 token 數」
    2. 估計每日請求次數(例如:1,000 次)
    3. 套用 Cloud 價格表(官方文件),算出每月概算
    4. 如果超出預算,先:
    5. 改用 Flash-Lite
    6. 精簡 prompt(例如縮短系統指令、用摘要代替全文)

    小結:把 Gemini 3.6 Flash 家族當成你的「AI 三件套」

    實際用起來,你可以這樣記:

    • 3.6 Flash:我日常寫作、看圖、看文件的主力
    • Flash-Lite:我做聊天機器人和內部工具時的省錢 API
    • Flash Cyber + CodeMender:我在 Repo 上的安全掃描與自動修補幫手

    先從 AI Studio 免費玩 3.6 Flash 開始,熟悉手感之後,拿 API Key 把 Flash-Lite 接進你的 side project,最後視公司安全需求再評估導入 Flash Cyber,這樣就能用最低成本,讓 Gemini 3.6 Flash 家族成為你工作流程裡的多模態新主力。

    🚀 你現在可以做的事

    • 打開 Google AI Studio,用 Gemini 3.6 Flash 試跑你手上的文章、圖表或技術文件
    • 申請 API Key,照文中的 Node.js 範例把 3.5 Flash-Lite 串進一個小型 FAQ Bot 或報表說明工具
    • 若你在安全/DevSecOps 團隊,追蹤 DeepMind 官方關於 Flash Cyber 與 CodeMender 的開放狀態,評估未來導入到 CI/CD Pipeline
  • MiniMax M3:一口吃下百萬字長文的開源模型

    MiniMax M3:一口吃下百萬字長文的開源模型

    📌 本文重點

    • M3 支援 100 萬 token 長上下文與多模態輸入
    • 專門處理長文件、整個程式庫與 Agent 工作流
    • 可雲端快速試用,也能本地自架整合現有工具鏈
    • 先從一個最痛的長文或專案開始導入

    用一句話說:MiniMax M3 是一個開放權重、支援 100 萬 token 長上下文 + 多模態輸入 的模型,專門幫你處理「報告太長、程式碼庫太大、Agent 工作流太複雜」這三種麻煩事。

    💡 關鍵: 100 萬 token 長上下文代表可以一次塞進整份大型專案文件或程式庫索引,而不必自己切 chunk 或做向量搜尋。

    官方介紹與下載:https://www.minimax.io/models/text/m3(The Decoder 報導:https://the-decoder.com/minimax-m3-open-weight-model-with-a-million-token-context-challenges-proprietary-leaders/)


    核心功能:長文、程式碼、Agent 一次處理

    1. 100 萬 token 長上下文:整份專案文件一次丟進去

    能做什麼?

    • 一次放入:完整專案文件夾匯出的 Markdown、法規 PDF、產品說明書、研究報告
    • 不用切段:不必自己分 chunk、做向量搜尋,直接把「全部內容」交給模型
    • 查詢風格:像在問一位看完整專案的同事

    怎麼用(長文閱讀 Prompt 範本)

    1. 準備一個壓縮檔 / 合併文件,例如 project_docs.md(可用腳本把多個 Markdown / txt 串成一個檔案)。
    2. 在推理介面(API、Notebook 或 Web UI)中,把全文貼進 system / user 區。

    範例 Prompt 模板:

    你是一位技術專案經理。以下是整個專案的所有文件(需求、設計、會議紀錄、API 文件):
    
    --- 專案全文開始 ---
    {{整份文件內容}}
    --- 專案全文結束 ---
    
    請依照以下格式輸出:
    1. 專案一句話摘要(不超過 30 字)
    2. 3 個主要目標
    3. 5 個關鍵風險(附來源段落或章節名稱)
    4. 下一步行動建議(列出 5–10 條,可直接貼進 Jira 當任務)
    

    實際行動: 找一份你手上最頭痛、超長的專案文件,直接用上面模板測一次。


    2. 原生多模態:文字 + 圖像一起理解

    M3 支援把文字與圖片一起丟進上下文。例如:

    • 產品 PRD + UI 圖稿,一次請它找出規格與設計不一致之處
    • 報告 PDF 截圖 + 補充說明文字,一起整理重點

    圖片搭配 Prompt 範本:

    以下是某個產品的文字需求說明,以及對應的 UI 設計稿截圖(多張):
    
    文字需求:
    {{需求文字}}
    
    圖片:
    - image_1:登入頁
    - image_2:帳號設定頁
    - image_3:權限管理頁
    
    請列出:
    1. 每張圖和文字需求的對應關係
    2. 不符合需求或缺漏的地方
    3. 建議 UI 或流程調整(用條列)
    

    實際行動: 把一份 PRD + 幾張 Figma 匯出的 PNG 丟給 M3,看它幫你做「設計對規格」檢查。


    3. 為程式碼與 Agent 優化:整 repo 理解 + 多輪工具調用

    根據社群測試與官方說明,M3 在程式碼生成與 Agent 任務上做了特別優化:

    • 長上下文讓它能一次「看完整個 repo 的索引」
    • 可以在一個對話裡做多輪「工具調用→讀結果→改方案」

    💡 關鍵: 對整個 repo 建立「程式碼地圖」再交給 M3,可以讓它在第一次對話就掌握系統結構並規劃重構與 Agent 工作流。

    整個 repo 程式碼導覽 Prompt

    1. 先用腳本產生「程式碼地圖」,例如:
    # 只列出檔名 + 前幾行註解/類別宣告
    python scripts/make_repo_index.py > repo_index.txt
    
    1. 把 repo_index.txt + 關鍵檔案內容一起貼給 M3:
    你是一位資深軟體工程師。以下是某個專案的程式碼地圖與部分檔案內容。
    
    --- repo index ---
    {{repo_index.txt}}
    --- end repo index ---
    
    問題:
    1. 幫我畫出系統主要模組與資料流(用文字 + 簡單 ASCII 圖)
    2. 指出如果要「加入 OAuth 登入」,可能要改動的檔案與大致步驟
    3. 給出最小修改範圍的 refactor 計畫(列出任務清單)
    

    Agent 工作流拆解 Prompt

    把它當成「任務拆解器 + 工具 orchestrator」的腦:

    你是一個 AI Agent 系統的規劃師。你可以使用以下工具:
    - tool_search_issues:搜尋 Jira issue
    - tool_run_tests:執行 CI 測試
    - tool_open_pr:建立 Pull Request
    
    需求:
    「每天自動檢查新的 bug issue,找出影響登入流程的,跑測試,通過就開 PR。」
    
    請輸出:
    1. 將需求拆成 5–10 個可實作的 Agent 步驟
    2. 每個步驟會用到的工具(如有)
    3. 對 orchestrator 的假想 DSL / YAML 配置範例
    

    實際行動: 選一個你常做的重複開發流程,用上面模板請 M3 幫你轉成可實作的 Agent 腳本草稿。


    適合誰用:三種典型場景

    1. PM / 研究員:長報告與專案文件總結

    使用方式:

    • 把所有會議紀錄、需求文件、Excel 轉成文字(或貼 PDF OCR 結果),合併成一份長文
    • 用「長文閱讀模板」請 M3:
    • 整理專案脈絡與時間線
    • 整理「決策原因」與「未決事項」
    • 產出可以直接貼進 Notion / Confluence 的摘要

    行動建議: 對每個專案建立一份「M3 專案總結」,讓新成員用它快速上手。


    2. 後端 / 全端工程師:整 repo 理解與重構

    使用方式:

    • 新接手專案,先用腳本生成 repo index → 丟給 M3 產生系統說明
    • 要重構時,請它根據長上下文:
    • 找出高度耦合模組
    • 給出重構順序與風險點
    • 產生對應的 Git 分支與 PR 策略建議

    行動建議: 每次大改版前,用 M3 先產一份「重構設計」,再與團隊人工過一遍。


    3. 自動化 / AI Agent 開發者:多輪工具調用工作流

    使用方式:

    • 把你現有的工具清單(API spec、CLI 說明)全部貼給 M3
    • 要求它:
    • 定義任務拆解(如報表產出、自動回覆客服)
    • 設計工具調用順序與錯誤處理策略

    行動建議: 先挑一個「每天會做,但步驟固定」的流程,例如:生成日報、同步任務狀態,讓 M3 幫你設計第一版 Agent workflow。


    怎麼開始:雲端 / 本地快速跑起來

    1. 雲端:直接用官方 / 社群 API

    如果你只是想先試效果:

    1. 到官方頁面申請:https://www.minimax.io/models/text/m3
    2. 拿到 API key 後,在自己的腳本或 Postman 裡調用:
    curl https://api.minimax.io/v1/chat/completions \
      -H "Authorization: Bearer $MINIMAX_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "m3",
        "messages": [
          {"role": "user", "content": "幫我總結以下專案文件..."}
        ]
      }'
    

    適合: 想驗證長上下文/多模態效果、不急著本地部署的團隊。


    2. 本地 / 自架:Hugging Face + 官方 Docker

    A. 用 Hugging Face + vLLM / Ollama(範例)

    1. 在 Hugging Face 搜尋 MiniMax/M3(實際名稱以官方為準)。
    2. 用 vLLM 啟動:
    pip install vllm
    vllm serve MiniMax/M3 --port 8000 --dtype bfloat16
    
    1. 測試:
    curl http://localhost:8000/v1/chat/completions \
      -H "Content-Type: application/json" \
      -d '{
        "model": "MiniMax/M3",
        "messages": [{"role": "user", "content": "你好,幫我總結這份文件"}]
      }'
    

    B. 用官方 Docker 快速跑起

    1. 下載官方映像(名稱以官方文件為準):
    docker pull minimax/m3:latest
    
    1. 啟動:
    docker run -d --gpus all -p 8000:8000 minimax/m3:latest
    
    1. 之後的使用方式就和一般 OpenAI 相容 API 類似。

    實際行動: 用 Docker 跑起來後,先跑一個「長文閱讀模板」,確認你的 GPU 記憶體足夠,觀察響應時間。

    💡 關鍵: 若你已採用 OpenAI 相容 API,將 base_url 換成 M3 服務即可快速 A/B 測試長上下文任務的效果。


    3. 跟現有工具鏈整合:VS Code、Orchestrator、CLI

    VS Code:當成本地 Copilot

    1. 安裝任一個支援自訂 LLM endpoint 的 VS Code 擴充套件(如 Code GPT、Continue)。
    2. 將模型 endpoint 設為你自架的 M3 伺服器 URL。
    3. 專案開啟後:
    4. 用「整 repo 導覽」prompt 請它解釋架構
    5. 在單檔內請它重寫函式、加註解

    與開源 orchestrator 整合

    你可以在以下框架中把 M3 當成主要「腦」:

    • LangChain / LlamaIndex:用它處理長上下文和工具調用規劃
    • CrewAI / OpenAI-compatible orchestrators:直接把 OPENAI_BASE_URL 指到你的 M3 伺服器

    簡單 YAML 範例(假想):

    llm:
      type: openai-compatible
      base_url: http://localhost:8000/v1
      model: MiniMax/M3
    
    agent:
      tools:
        - search_issues
        - run_tests
      max_iterations: 10
    

    實際行動: 在你現有的 Agent 專案,把原本的 gpt-4 或其他模型,先在「規劃/總結」節點換成 M3,測試對長上下文任務的改善。


    小結:先從一個最痛的長文或程式庫開始

    不用一次把所有流程都搬到 M3。挑一個:

    • 最長、最難讀的一份文件
    • 或你最不熟的一個 codebase

    用上面給的三組模板(長文閱讀、程式碼導覽、Agent 任務拆解)跑一次,你就能感受到「百萬 token 長上下文 + 開放權重」在實際工作中的差別。

    🚀 你現在可以做的事

    • 挑選一份最頭痛的長報告或專案文件,套用「長文閱讀模板」實測 M3
    • 對一個新接手的 repo 生成 repo_index.txt,用「整個 repo 導覽 Prompt」請 M3 說明架構
    • 在現有 Agent 專案中,把規劃/總結節點的模型改成 M3,觀察長上下文任務表現差異