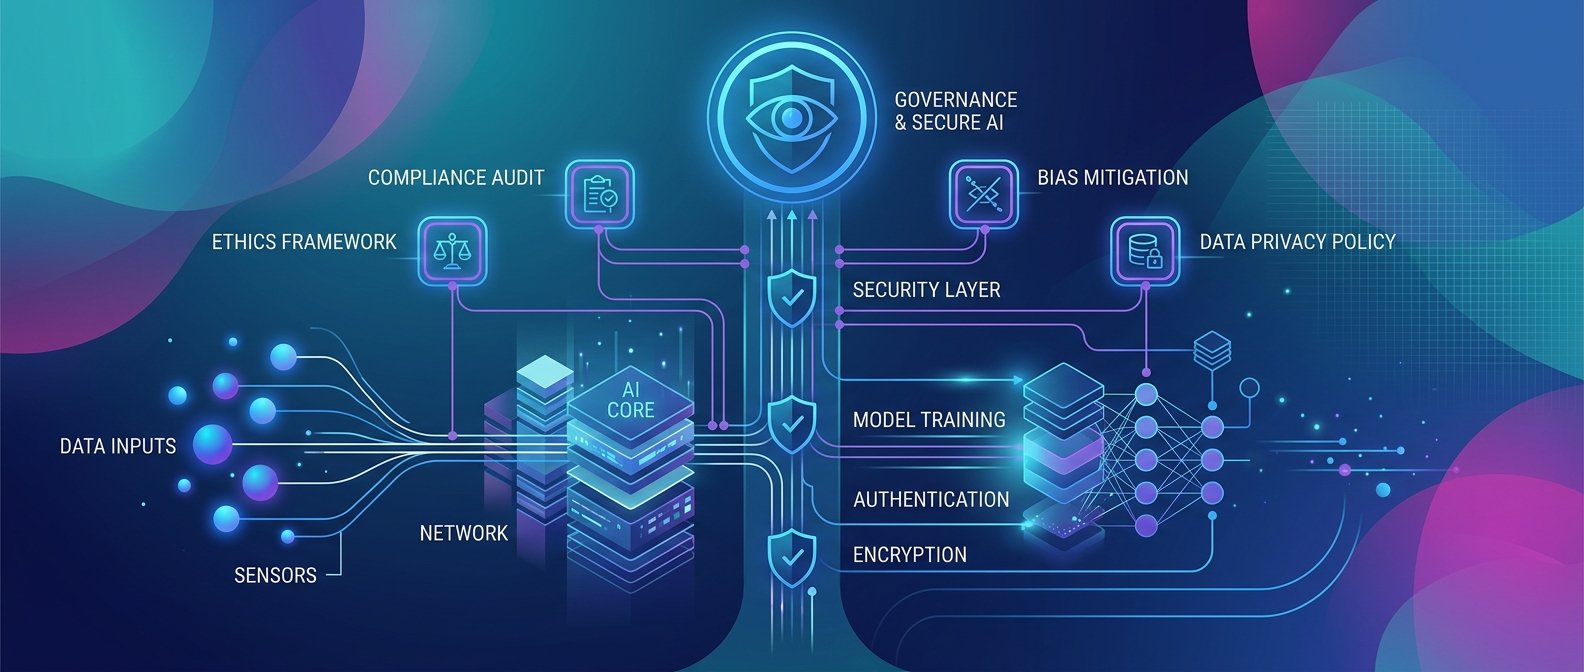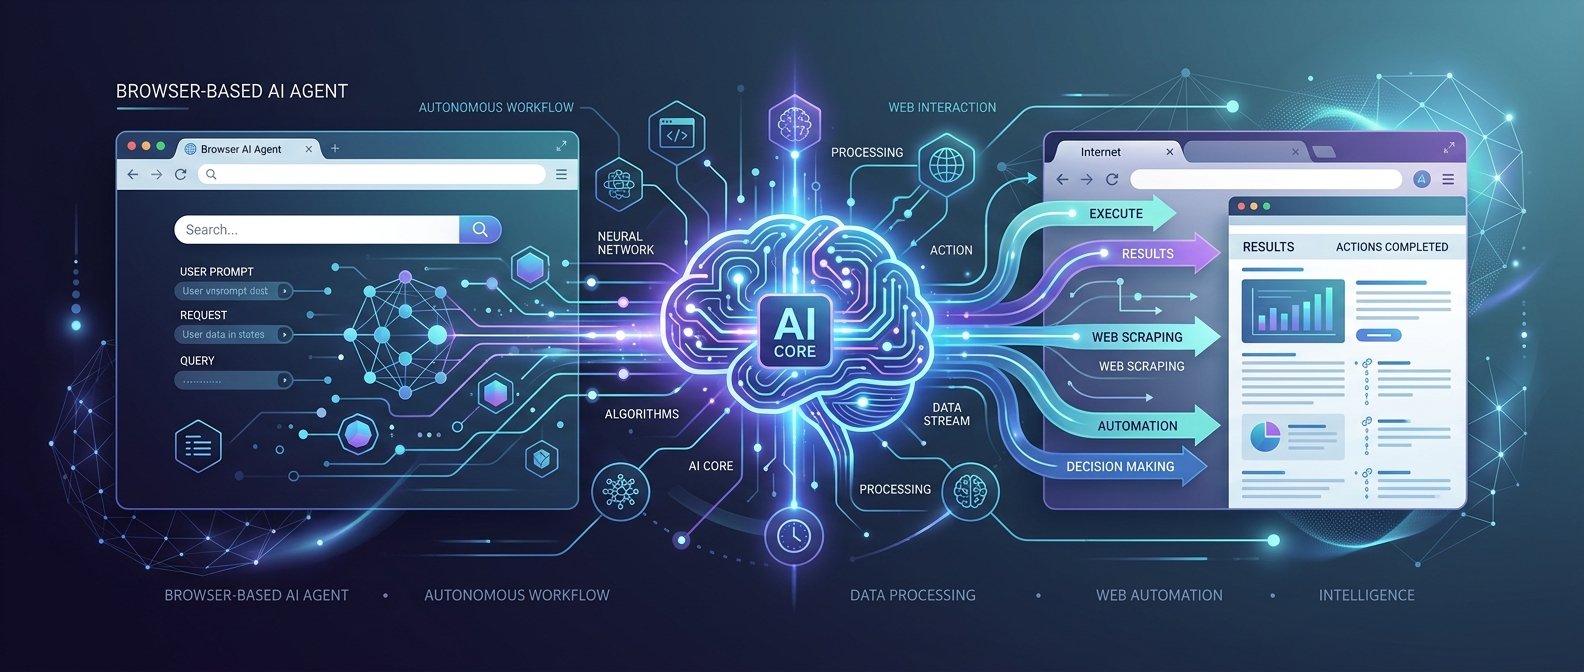
作者: kerwin77106

  • Claude 解禁不是勝利,是新常態開端

    Claude 解禁不是勝利,是新常態開端

    📌 本文重點

    • 模型與算力已被正式視為地緣政治戰略資產
    • 模型世代正在變成出口管制與政策開關的單位
    • AI 產品需將政治與監管風險納入技術與商業架構
    • 開發者必須預設模型隨時可能被拔除並設計備援

    Claude Fable 5 被美國商務部「解禁」,不是 AI 產業戰勝政府,而是宣告:從現在起,算力與模型正式變成地緣政治的戰略資產,企業、開發者、使用者都將被政策節奏綁在同一條船上。出口管制鬆綁不是終點,而是「不確定性常態化」的起點。


    一、為什麼美國先封再放?這不是後悔,而是試探

    先看事實:

    • 美國商務部對 Anthropic 的 Claude Fable 5、Mythos 5 先祭出出口管制,迫使其在全球多區停用;幾週談判後,依據 The Verge、Wired、TechCrunch 報導,又宣布解除限制,允許在 AWS、Google Cloud、Microsoft Foundry 等平台陸續恢復。
    • 同一時間,GPT‑5.6 Sol 被報導由美國政府「門控」,訪問權限受到限制;而 OpenAI 的論文又意外曝露 GPT‑5.6 Pro 三種變體 的產品路線,性能已明顯邁向下一個檔次。

    💡 關鍵: 這次事件證明美國已能以政策開關精準控制整個模型世代的全球流通

    表面上,這看起來像是白宮政策搖擺:先擔心國安風險,先鎖起來,之後發現太傷產業競爭力,再打開。但從 AI 觀點看,這更像是一場「壓力測試」:

    1. 測企業的配合度
      先出一刀很重的出口管制,看 Anthropic、雲端平台、盟友政府怎麼反應,順便建立一個「你們其實擋得住」的政治先例。

    2. 測國安與經濟邊界
      在 GPT‑5.6 等更新一代模型還在「門控」時,讓稍舊一代的 Fable 5 / Mythos 5 出海,形成一條隱形技術分水嶺:最新一代留在國內、前一代可以外銷。

    3. 測輿論與市場容忍度
      Hacker News 上這則解禁消息超過 900 分、600+ 則留言,反映出社群高度敏感。決策者可以看到:什麼樣的控管會被罵爆,什麼樣的局部放寬可以被接受。

    關鍵不是這次有沒有解禁,而是:華府已經確認自己「可以用開關控制整個模型世代的全球流通」,而且業界雖然抱怨,但最後會照做。這個權力一旦被試出來,就不會消失,只會被反覆使用。


    二、算力與模型:下一代「石油與晶片」的疊加版

    把 Claude 解禁、GPT‑5.6 被門控、歐盟尋求 AI 自主、中國用本土晶片訓練 LongCat‑2.0 放在同一張地圖上看,你會發現結構性變化比單一新聞重要得多。

    1. 美國:模型世代當作出口等級

    • GPT‑5.6 Sol 被政府門控,說明最新一代 frontier model 已被視為具國安敏感性,接近「雙用途技術」:一方面是生產力工具,一方面可用於網路攻防、情報分析、甚至軍事應用。
    • 同時,美國卻願意放行 Claude Fable 5 / Mythos 5,其實是在建立一個「前一代可出口」的默契:像過去對待戰機、晶片那樣,形成技術代差。

    這意味著:模型世代 = 出口等級,發布版本 = 政策事件。

    2. 歐盟:AI 自主不是技術口號,是供應鏈恐懼

    • 奧地利的 Alexander Pröll 公開呼籲歐盟嘗試把 Anthropic 拉到歐洲設點,就是對「美國一紙禁令就可以關掉你雲端上的模型」的直接反應。
    • 歐洲正在談的是 AI independence(AI 自主),不只是要自己寫模型,而是降低對美國與中國雙邊供應的政治暴露度。
    • 用中國模型替代美國模型?The Decoder 指出,這只是在美國依賴 → 中國依賴之間換邊站,風險型態沒有改變。

    對歐洲來說,Anthropic、OpenAI 不是單純供應商,而是「法律管轄在美國的戰略基礎設施」。這會推動歐盟在監理沙盒、補貼、算力投資上更積極扶植本地替代方案。

    3. 中國:用 LongCat‑2.0 證明「脫鉤可行」

    • 美團用完全本土晶片訓練 1.6 兆參數 LongCat‑2.0,明講一句:
    • 不用 Nvidia 也能堆出超大模型;
    • 算力與模型都可以在國內閉環完成。

    在美國眼中,這正好反證一件事:出口管制迫使中國加速自主化,長期可能削弱美國技術壟斷力。

    於是我們看到微妙平衡:

    • 對中國 → 繼續嚴控高階 GPU;
    • 對盟友與全球市場 → 放行部分模型,維持美系 AI 的國際標準地位。

    總結這一段:算力是硬體戰略資產,模型是軟體戰略資產,美國正在同步武器化兩者;中國則在嘗試「去 Nvidia 化 + 本土大模型」雙重自立;歐盟夾在中間,焦慮於依賴誰。

    💡 關鍵: 未來國與國之間的技術差距,將以「算力 + 模型世代」雙軸來衡量,而不只是晶片工藝節點


    三、解禁不是勝利,而是「被政策節奏綁架」的新常態

    很多人把 Claude 解禁當成鬆一口氣:模型又回來了、API 可以繼續用。從產品與商業的角度,這當然是好消息;但從產業結構來看,我會下三個更悲觀但更實際的結論:

    1. 政策成為產品路線的一級變數

    過去你規劃 AI 產品:

    • 看模型能力
    • 看成本、延遲、用量
    • 看商業模式

    未來的 checklist 必須加上:

    • 這個模型是否可能在下一輪出口管制或國安審查中被點名?
    • 供應商是否受制於單一政府的司法與外交政策?
    • 是否有多雲、多模型備援,一個帳號被關不會整個服務停擺?

    換句話說,Regulation & Geopolitics 不再是法務的事,而是產品經理、CTO 必須寫進 roadmap 的一級變數。

    2. 模型使用權變成「準租賃政治資產」

    Claude Fable 5 被下架再上架,GPT‑5.6 被門控,同一家公司、同一世代的產品,今天能用、明天被鎖,只需要一份來自華府的文件。

    對企業與開發者而言,你不是「擁有」一個模型,而是「在穩定性高度不確定的政治空間中暫時租用」一個能力。

    這會帶來幾個設計上的必要調整:

    • 避免核心業務綁死單一 frontier model,關鍵功能應有至少一個技術降級版本(開源模型、本地推理或第二供應商)。
    • 對高風險市場(跨境金融、醫療、政府專案),需要明確寫進合約:若模型因政策被中止,如何切換、誰負責成本。

    3. 「政策風險溢價」將內建進 AI 價格與估值

    投資人不會忽略這種事件:Anthropic 一夜之間失去全球高階用戶,再在談判後恢復,現金流與估值模型都要重算。

    未來你看到:

    • 高階模型的 API 價格,不只是算力成本 + 研發成本,還會反映「政策風險保費」。
    • SaaS / AI startup 在募資時,會被問到:你的技術堆疊有哪些政策單點風險?如果美國/中國/歐盟其中一方改規則,你還剩下什麼?

    出口管制的鬆綁,不是政策退場,而是政策正式嵌入商業邏輯之中。

    💡 關鍵: 從現在開始,AI 公司的估值與商業模式,必須顯式考量地緣政治與監管變動成本


    給開發者與企業的實際建議:把「政治容錯」寫進技術架構

    如果你正在用或準備導入 Claude、GPT‑5.6 或其他 frontier model,我的建議很具體:

    1. 技術層:預設模型可被拔掉
    2. 所有模型調用層一律透過「中介服務 / abstraction layer」(自建或用第三方),避免上游一改 API 你全站重寫。
    3. 關鍵工作流(客服、自動化決策、關鍵內部工具)至少綁 兩家模型供應商 + 一個可接受的開源備援。

    4. 產品層:定義「降級模式」體驗

    5. 明確規劃:若 frontier model 因政策或價格暴漲無法使用,你的產品在功能上怎麼優雅降級,而不是直接掛掉。
    6. 把這個降級模式當成產品的一部分去設計與測試,而不是事後補洞。

    7. 商業與法務層:把監管風險寫進合約與 pitch deck

    8. 對 B2B 客戶,清楚寫入:模型供應中斷時的 RTO(恢復時間目標)、替代方案與責任分攤。
    9. 對投資人,不要假裝風險不存在,而是主動展示你的 「政策容錯設計」,這會變成新的競爭優勢。

    總結一句:Claude 解禁不是一個 happy ending,而是一張「期末考考綱」。從現在開始,做 AI 產品的人,誰先把地緣政治與監管風險當成一級變數寫進架構,誰才有資格在下一輪模型封鎖與解禁之間,活得比較久。

    🚀 你現在可以做的事

    • 審視現有產品架構,為所有模型調用加上自建或第三方的 abstraction layer
    • 為核心功能選定第二模型供應商與至少一個可行開源模型作為技術降級備援
    • 與法務與商務團隊協作,在合約與 pitch deck 中補上「模型中斷與政策風險」的具體應對條款與流程
  • 本地 LLM+RAG 架構:從 NASA CMO-DA 學部署

    本地 LLM+RAG 架構:從 NASA CMO-DA 學部署

    📌 本文重點

    • 斷網環境可用本地 LLM+RAG 解決醫療輔助
    • llama.cpp 搭配容器化可在受限硬體穩定推理
    • 使用 OSS 向量庫打造可控、可回滾的 RAG pipeline
    • 模型與知識庫需分版本管理確保合規與安全

    在太空任務這種完全斷網、硬體受限且高合規的環境,NASA 的 CMO-DA 醫療助手用一套可攜、可封裝的本地 LLM+RAG 架構,解決了三個常見痛點:

    1. 不依賴雲端:模型推理與檔案檢索都在本地完成,沒有外部服務依賴。
    2. 可控資源與效能:透過 llama.cpp + 容器化(RamaLama 類工具),在 CPU/GPU 都受限的情況下仍能穩定跑推理。
    3. 安全與更新邊界清楚:醫療場景下做到知識庫可更新但可 rollback,模型版本可控且遵守合規要求。

    💡 關鍵: 在完全斷網且高合規場景中,能本地推理並可回滾的 LLM+RAG 架構是可行且可維護的方案

    下面用 NASA CMO-DA 的思路,拆成一個可直接套用的本地 LLM+RAG 模板。


    重點說明

    1. 為何選擇 llama.cpp + 容器化工具做本地推理

    在 CMO-DA 這類場景,llama.cpp 有幾個關鍵優勢:

    • 硬體覆蓋廣:支援 x86、ARM、多種 GPU(CUDA、Metal、OpenCL 等),適合未知/多樣化載具(太空艙、工廠、船艦)。
    • GGUF 模型格式:支援量化(q4_0, q5_K 等),可以在有限記憶體上跑中大型模型。
    • 單一 binary,易封裝:搭配像 RamaLama 這種工具,把模型 + 推理程式封裝成容器映像,做到「模型即容器」。

    實際好處:

    • 對你來說,部署路徑變成:git pull → cmake → 放入 GGUF 模型 → 打包成 container,不需要大堆框架整合。
    • DeepSeek V4 已合併進 llama.cpp 主幹,你可以直接在本地跑 DeepSeek V4 GGUF,在推理品質與效能上有更好的選擇。

    容器化工具(以 RamaLama 類工具為例)則負責:

    • 自動 GPU 偵測與穿透(在 Kubernetes / OpenShift 中把 GPU 資源暴露給容器)。
    • 統一啟動參數與模型路徑,讓模型像應用程式一樣可複製、可移動。

    💡 關鍵: 透過 GGUF 量化與「模型即容器」封裝,能在受限硬體上穩定部署中大型本地模型

    2. 斷網環境下的 RAG pipeline 設計

    本地 RAG 的核心是:不要依賴雲端向量服務,一切用自架的 OSS 向量庫。

    常見 OSS 選擇:

    • Qdrant:Rust 實作,支援 HNSW、瀏覽器/邊緣友好,有好用 REST / gRPC API。
    • Milvus / Weaviate:功能更完整,適合資料量非常大但資源較充裕的內網環境。

    醫療場景(也是典型高合規場景)的設計要點:

    1. Chunking 策略
    2. 以醫療指引、SOP 文件為單位,再切成 512–1024 tokens chunk,重點是維持語境完整。
    3. 加上 overlap(例如 128 tokens),避免答案跨 chunk 斷裂。
    4. 針對表格或 checklist,考慮以「row / section」為粒度,而不是固定 tokens。

    5. Embedding 模型本地化

    6. 選一個能放進 GGUF 或支援 CPU/GPU 的 embedding 模型,例如 bge-large 的量化版本或 MiniLM 類模型。
    7. 避免用雲端 embedding API,保證完全離線。

    8. 延遲與資源限制

    9. 查詢流程:Embedding → Vector search → Top-k 文件 → LLM 回答,每一步都要評估延遲。
    10. 太空艙/工廠場景中通常只有 1–2 張 GPU,LLM 推理延遲是主瓶頸,可以:
      • 調低 max_tokens 回答長度。
      • 預先計算並緩存常見問答(FAQ)以降低實時查詢負擔。

    💡 關鍵: 在離線場景中,512–1024 tokens chunk 加 128 overlap 能平衡上下文完整性與檢索效率

    3. GPU 自動偵測與穿透:Kubernetes / OpenShift 配置

    在 CMO-DA 中,他們透過類似 RamaLama 的工具,在 OpenShift 上做到:

    • 自動偵測節點是否有 GPU(透過標籤或 device plugin)。
    • 在 pod 內把 GPU 暴露給 llama.cpp。

    對你來說,可以簡化成 Kubernetes YAML 設計:

    apiVersion: apps/v1
    kind: Deployment
    metadata:
      name: local-llm
    spec:
      replicas: 1
      selector:
        matchLabels:
          app: local-llm
      template:
        metadata:
          labels:
            app: local-llm
        spec:
          containers:
            - name: llama-cpp
              image: your-registry/llama-cpp-gguf:latest
              args:
                - "--model=/models/med-llm.gguf"
                - "--ctx-size=4096"
                - "--n-gpu-layers=35"  # **關鍵參數**:LLM 分配到 GPU 的層數
              resources:
                limits:
                  nvidia.com/gpu: 1      # Kubernetes GPU 資源宣告
              volumeMounts:
                - name: models
                  mountPath: /models
          volumes:
            - name: models
              persistentVolumeClaim:
                claimName: llm-model-pvc
          nodeSelector:
            nvidia.com/gpu.present: "true"  # **GPU 自動偵測:只排程到有 GPU 的節點
    

    在 OpenShift 上同樣依賴 GPU Operator / device plugin,容器內不需要特殊程式碼,llama.cpp 會透過 CUDA / ROCm 自動偵測 GPU。


    實作範例:Minimal 本地 LLM+RAG PoC

    下面是一個可離線部署的小型 RAG 助理範例,組合:llama.cpp + DeepSeek V4 GGUF + Qdrant。

    1. 準備模型與 llama.cpp

    # 取得最新 llama.cpp(含 DeepSeek V4 支援)
    git clone https://github.com/ggml-org/llama.cpp.git
    cd llama.cpp
    git pull
    cmake -B build
    cmake --build build -j
    
    # 假設你已下載 DeepSeek V4 GGUF 模型到 ./models/deepseek-v4-med.q4_0.gguf
    

    2. 啟動本地 Qdrant 向量庫

    docker run -d --name qdrant \
      -p 6333:6333 \
      -v qdrant_data:/qdrant/storage \
      qdrant/qdrant
    

    3. 建立 RAG Pipeline(Python 範例)

    import requests
    from sentence_transformers import SentenceTransformer
    
    # **Embedding 模型**:可替換為你量化後的本地模型
    embed_model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
    
    QDRANT_URL = "http://localhost:6333"
    COLLECTION = "med_docs"
    
    def create_collection():
        body = {
            "vectors": {
                "size": 384,
                "distance": "Cosine"
            }
        }
        requests.put(f"{QDRANT_URL}/collections/{COLLECTION}", json=body).raise_for_status()
    
    def index_documents(docs):
        vectors = embed_model.encode([d["text"] for d in docs])
        points = [{
            "id": i,
            "vector": vectors[i].tolist(),
            "payload": docs[i]
        } for i in range(len(docs))]
        requests.put(f"{QDRANT_URL}/collections/{COLLECTION}/points", json={"points": points}).raise_for_status()
    
    def rag_search(query, top_k=3):
        vec = embed_model.encode([query])[0].tolist()
        body = {
            "vector": vec,
            "limit": top_k
        }
        res = requests.post(f"{QDRANT_URL}/collections/{COLLECTION}/points/search", json=body).json()
        return [r["payload"]["text"] for r in res]
    
    # 初始化
    create_collection()
    index_documents([
      {"text": "若出現輕微頭痛且無其他症狀,建議先休息並補充水分。"},
      {"text": "若有持續胸痛或呼吸困難,應立即啟動緊急醫療流程。"}
    ])
    
    print(rag_search("胸口痛怎麼辦?"))
    

    4. 將檢索結果交給 llama.cpp

    在本地,你可以用簡單的 HTTP wrapper 把 context 拼接給 llama.cpp 的 --prompt:

    ./build/bin/llama-cli \
      --model ./models/deepseek-v4-med.q4_0.gguf \
      --ctx-size 4096 \
      --n-gpu-layers 35 \
      --prompt "根據以下醫療指引回答問題:
    [指引1]
    若有持續胸痛或呼吸困難,應立即啟動緊急醫療流程。
    
    問題:胸口痛怎麼辦?"
    

    在正式專案中,你會把 Qdrant 的 top-k 結果串接到 prompt,組成完整 RAG 回答流程。


    建議與注意事項

    1. 醫療場景的安全邊界與 offline 更新策略

    醫療、工業安全等場景,關鍵是 模型與知識庫的版本分離:

    • 模型(LLM)版本:透過容器映像管理,例如在 tag 中寫明版本:med-llm:v1.2.0。
    • 知識庫(向量庫 + 原始文件)版本:在 Qdrant collection 命名中加入版本:med_docs_v2024_06。

    更新策略建議:

    1. 離線同步:
    2. 透過 USB / 專用線路將新模型(GGUF)與新向量庫 dump 帶到現場。
    3. 先在 staging 節點載入,跑自動化驗收測試(醫療 QA 集)。

    4. Rollback 機制:

    5. 保留上一版模型映像與向量庫快照,決策錯誤時可以在幾分鐘內回退。
    6. 配置開關:只允許在非緊急任務時切換版本,避免任務中途變更行為。

    2. 常見坑與最佳實踐

    1. 坑:只量化模型但忘記量化記憶體 footprint
    2. 即使用 q4_0,context 太大(例如 32k)時仍可能爆 RAM。
    3. 建議:先用 --ctx-size=4096 做壓力測試,再逐步拉高。

    4. 坑:Chunk 太小導致回答失去上下文

    5. 斷網場景下沒有「多輪 call retriever 補充」的餘裕,chunk 要適度放大。
    6. 建議:醫療/工廠 SOP 至少維持 512–1024 tokens + 128 overlap。

    7. 坑:GPU 穿透配置錯誤導致 fallback 到 CPU

    8. 沒有設 resources.limits.nvidia.com/gpu 或節點沒正確標記,pod 會跑在無 GPU 節點上。
    9. 建議:在 CI/CD 中加入簡單檢查:呼叫 nvidia-smi 或 llama.cpp GPU info API,確認有 GPU 再部署。

    10. 最佳實踐:在高合規場景用「白名單指令 + RAG」模式

    11. 不允許模型「自由想像」,回答必須引用 RAG 檢索到的片段。
    12. prompt 設計中加入:「只能根據提供的文件回答,若無相關資訊請回答『資料不足』」,降低幻覺風險。

    總結來說,NASA CMO-DA 的做法給了我們一個清晰模板:llama.cpp + 容器化 + OSS 向量庫 + 可控版本策略。只要把這套思路搬到你的工廠、船艦、礦場或企業內網,就能在斷網或高合規環境下建立一個可維護、可升級又安全的本地 LLM+RAG 助理。

    🚀 你現在可以做的事

    • 在 GitHub 搜尋並 git clone 官方 llama.cpp 專案,編譯並測試本地推理
    • 使用 Docker 拉起 Qdrant,依照文中 Python 範例建立一個最小 RAG PoC
    • 寫一份 Kubernetes Deployment YAML,把你的 GGUF 模型封裝成「模型即容器」,並在測試環境驗證 GPU 穿透与延遲表现
  • 開源 ATS 開箱:先讓機器 HR 幫你看履歷

    開源 ATS 開箱:先讓機器 HR 幫你看履歷

    📌 本文重點

    • 用開源 ATS 在本機跑出「機器 HR」打分
    • 依關鍵字與技能結構優化履歷匹配度
    • 求職者與小團隊都能部署透明可調的初篩系統
    • 先用機器視角迭代履歷再正式投遞

    只要幾行指令,就能在自己電腦跑一套「機器 HR」,用 HackerRank 開源 ATS 先幫你打分履歷,再送出求職申請。

    HackerRank 把自家 ATS 開源的故事原文在這裡,我們直接站在求職者和小團隊 HR 的角度,拆解它怎麼打分,和怎麼自己動手部署。


    核心功能:機器 HR 怎麼看你的履歷

    先弄清楚這套 ATS 的「腦袋」在想什麼,才知道怎麼改履歷讓分數往上。

    1. 關鍵字與職缺匹配

    它會做的事:
    – 把履歷和職缺描述切成一堆 token(關鍵字、詞組)
    – 比較兩邊出現的技能、職稱、技術名詞的重疊程度
    – 依照權重算出一個匹配分數(例如:核心技能比軟性能力更重)

    💡 關鍵: ATS 核心是「關鍵字重疊+權重」,沒有寫出來的技能就等於不存在。

    你可以馬上做的事:
    – 打開你常投的職缺 JD,列出 10–20 個明顯關鍵字(如 React、Kubernetes、CFA)
    – 確認這些詞真的出現在履歷裡,而且出現在工作經驗或技能欄位,不是藏在自我介紹
    – 同一樣技能最好在不同段落被提到 2 次以上(職稱+專案細節),讓匹配度更高

    2. 技能欄位結構化

    它會做的事:
    – 嘗試從履歷中識別「專業技能」「工具」「程式語言」等區塊
    – 把識別出的技能映射到內建或自訂的技能字典
    – 根據技能的完整度和與職缺關聯度加分

    你可以馬上做的事:
    – 把零散的技能文字改成明確的「Skills」區塊,用條列式呈現:
    – Programming: Python, Go, TypeScript
    – Data: SQL, Pandas, Airflow
    – DevOps: Docker, Kubernetes, GitHub Actions
    – 避免寫成長句:「熟悉各種前端技術如 React、Vue 等」改成獨立列出每一項

    3. 格式與可解析度

    它會做的事:
    – 先把 PDF 或 DOCX 轉成純文字
    – 檢查是否有標題層級(Education、Experience、Skills 等)
    – 看日期、公司名稱、職稱是否容易被解析出來

    你可以馬上做的事:
    – 優先使用 簡單排版的 PDF(少用圖表和多欄版面)
    – 每段工作經驗保持統一格式,例如:
    – 公司名稱 | 職稱 | 2020-01 – 2023-06
    – 標題請明寫 Work Experience、Education、Projects,不要用太創意的命名


    適合誰用:兩個典型場景

    場景 1:求職者自己跑 ATS,迭代履歷

    適合你如果:
    – 正在密集投履歷,但不知道為何常被系統一輪刷掉
    – 想在投出去前,先用「機器 HR」視角檢查履歷

    具體可以這樣用:
    1. 在本機或雲端部署 HackerRank 開源 ATS
    2. 匯入你目前版本的履歷 + 目標職缺描述
    3. 看系統產出的匹配分數與分析報告(常見會有:技能命中率、關鍵字缺漏、段落可讀性)
    4. 依照缺漏項目,調整履歷內容:補技能、重寫專案描述
    5. 重跑一次,看分數是否明顯提升

    這種「跑分 → 改履歷 → 再跑分」的迭代,能讓你迅速找出哪些描述是 ATS 看不懂的,避免被系統誤殺。

    💡 關鍵: 把 ATS 當「迭代工具」而不是一次性評分,才能持續拉高履歷表現。

    場景 2:小團隊 / 初創接到自家招聘網站

    適合你如果:
    – 公司還沒預算買商用 ATS,但已經有基本招聘網站或表單
    – 想要自動化「履歷初篩」,又希望演算法透明可調整

    具體可以這樣用:
    1. 把開源 ATS 部署在公司雲端(例如一個獨立的 VM 或 Kubernetes namespace)
    2. 在招募網站的投遞表單,增加一個後端步驟:
    – 收到履歷檔案 -> 呼叫 ATS API -> 存分數與解析結果到資料庫
    3. 對 HR 顯示:
    – 依分數排序的候選人列表
    – 每人的技能命中明細(例如:符合 8/10 必備技能)
    4. HR 可以手動調整各職缺的權重設定,例如:某職缺重視 Python 多於 Java,再重跑分數

    這套流程的好處是:你可以完全看到打分邏輯,調整職缺與技能字典,不會被黑盒演算法綁死。


    怎麼開始:從 GitHub 到第一份跑分履歷

    以下以一般開源 ATS 專案為例,示範本機快速部署與基本操作。實際路徑請以 HackerRank 公佈的 GitHub repo 為準(可以從原文 danunparsed 的文章 追過去)。

    步驟 1:取得程式碼(GitHub)

    1. 確認電腦已安裝:
    2. Git
    3. Docker 或至少 Python 3.9+
    4. 從 GitHub 取得程式碼:

    bash
    git clone https://github.com/hackerrank/open-ats.git
    cd open-ats

    1. 用檔案總管打開專案,先看 README.md,通常會列出:
    2. 必備環境
    3. 快速啟動指令
    4. API 說明

    步驟 2:快速部署(本地或雲端)

    選項 A:本機 Docker 一鍵跑起

    如果 README 提供 Docker Compose:

    docker compose up -d
    

    然後打開瀏覽器到 http://localhost:8000(實際 port 依專案設定),通常會看到:
    – 簡單的 Web 介面可以上傳履歷
    – 或至少有 API 文檔(Swagger / OpenAPI)

    選項 B:雲端輕量部署

    如果想在雲端跑,方便給 HR 或朋友共用:

    1. 在 Render / Railway / Fly.io 之類平台建立新服務
    2. 連接你的 GitHub repo
    3. 在設定中填入:
    4. Build command:如 docker build . 或 pip install -r requirements.txt
    5. Start command:如 uvicorn main:app --host 0.0.0.0 --port 8000
    6. 部署完成後,平台會給你一個公共 URL,當作 ATS API 入口

    💡 關鍵: 雲端部署加一個公共 URL,就能立刻變成多人共用的履歷初篩服務。

    步驟 3:丟入第一份履歷測試

    假設 ATS 提供一個 /score API,可以這樣測試(具體路徑依專案為準):

    curl -X POST \
      https://your-ats-url/score \
      -F "resume=@/path/to/resume.pdf" \
      -F "job_description=@/path/to/jd.txt"
    

    你會拿到一個 JSON 回應,常見欄位可能是:

    {
      "total_score": 82,
      "keyword_match": {
        "required": 10,
        "matched": 8
      },
      "skills": {
        "python": true,
        "docker": false,
        "react": true
      },
      "notes": [
        "Missing keyword: Kubernetes",
        "No explicit mention of SQL",
        "Work experience dates parsed successfully"
      ]
    }
    

    步驟 4:看懂分數,對症調整

    拿到分數後,重點不是「幾分」,而是怎麼據此改履歷:

    1. 先看缺漏的技能與關鍵字
    2. 每個 false 或 missing 的技能,對照職缺 JD 是不是你真的會但沒寫
    3. 能做到的就明確寫進「Skills」或「工作成果」段落
    4. 再看解析失敗的欄位
    5. 如果 notes 提到日期無法解析,調整成標準格式
    6. 公司名、職稱盡量獨立成一行,不要混在長句
    7. 最後看總分變化
    8. 每次改完重跑,記錄分數變化和修改內容
    9. 找到「加分效率最高」的修改方式,往那個方向優化

    總結:先學會用機器 HR 的語言說話

    HackerRank 把自家 ATS 開源,等於把機器 HR 的打分標準攤在你面前。你可以:
    – 當求職者:在本機或雲端跑一套 ATS,先自測履歷再投遞
    – 當小團隊 HR:把 ATS 接到自家網站,建立透明可調整的初篩機制

    真正有用的做法不是「迎合演算法」,而是讓履歷把你的能力說清楚,並且用機器看得懂的結構寫出來。先跑幾次分數,你很快就會掌握那套語言。

    🚀 你現在可以做的事

    • 打開常投職缺 JD,整理出 10–20 個關鍵字,對照並重寫自己的履歷結構
    • 到 GitHub 搜尋 HackerRank 開源 ATS 專案,依 README.md 在本機或雲端部署測試
    • 跑一輪「改履歷 → 用 /score API 重測 → 比較分數變化」,記錄哪類修改最有效
  • 讓費曼幫你開會:高智議會實戰

    讓費曼幫你開會:高智議會實戰

    📌 本文重點

    • 18 位 AI 專家人格協作,幫你拆解困難決策
    • 支援多家 LLM,多模型協同辯論與決策
    • 結構化多輪會議流程,適合產品、工程與職涯抉擇
    • 10 分鐘內可在本機跑起第一個 /council

    一句話定位:Council of High Intelligence 是一個「多人格、多模型的開源決策助手」,讓亞里斯多德、費曼、卡尼曼、Torvalds 等 18 位 AI 專家分工辯論,幫你把困難決策拆開分析。

    GitHub 專案連結:https://github.com/0xNyk/council-of-high-intelligence


    核心功能:它到底幫你做什麼?

    1. 18 位 AI 專家人格,替你「開會」

    這個專案內建 18 個 AI persona,例如:

    • 費曼:擅長把複雜問題拆小,用白話解釋
    • 卡尼曼:偏向風險、決策偏誤、心理學角度
    • Torvalds:工程實作與系統設計視角
    • 亞里斯多德:偏向邏輯與倫理推理

    💡 關鍵: 18 位專家人格讓同一個問題從多角度被拆解與辯論,比單一模型更接近真實開會決策。

    你只需要:

    1. 想好你要決策的問題(例如:「我要選哪個前端框架?」)
    2. 用一行指令 /council + 問題
    3. 看不同人格怎麼辯論、反駁、收斂結論

    可行動點:先在腦中列出你最近最卡的一個決策,用一句話描述,等會在「怎麼開始」裡直接拿來當第一條指令。


    2. 多家 LLM 供應商,真正「多模型」討論

    官方描述:

    18 AI personas deliberate your hardest decisions across multiple LLM providers.

    意思是:你可以把不同角色綁到不同家模型,例如:

    • 深度推理角色 → 使用 OpenAI / Claude / DeepSeek
    • 技術細節角色 → 使用本地 Qwen / LLaMA
    • 檢查與總結角色 → 使用另一家 API

    這樣比起「一個模型演完全部人格」,更接近多人開會:不同模型偏好不同風格、推理路線也不同。

    可行動點:先決定你要用哪幾種 LLM 來源:

    • 沒有 GPU:先用雲端(OpenAI、Anthropic、DeepSeek 等)
    • 有本地 GPU:用本地模型 + 雲端模型混用

    在 .env 裡填 API key 即可(下文會示範)。


    3. 結構化多輪討論,不是單次回答

    這不是「問一次、回一段」的聊天,而是預設有多輪辯論流程:

    1. 第一輪:各專家給出初步立場
    2. 中間:互相質疑、補充證據、提出 alternative
    3. 最後:整合成具體建議 + 原因拆解

    你可以把它想成一個腳本化的「會議流程模版」,每次 /council 就是啟動一次完整會議。

    可行動點:在準備問題時,用「決策問題」的格式描述:

    • A vs B 的選擇(框架、技術、工作)
    • 有限制條件(時間、預算、人力)
    • 希望輸出形式(表格、清單、分階段建議)

    適合誰用?三個典型場景

    💡 關鍵: 產品經理、工程師與個人職涯決策者,都可以用同一套會議流程模版,快速得到結構化建議。

    1. 產品經理:產品選型 / 路線決策

    情境:

    • 要在「先做 Web 還是先做 App」中選一個
    • 要評估「自研 vs 採用 SaaS」

    你可以這樣用:

    /council 幫我評估:我們是一個 B2B SaaS,新功能是「客戶成功儀表板」。
    選項 A:在現有產品裡做一個輕量 dashboard。
    選項 B:做成獨立子產品,單獨收費。
    
    條件:
    1. 團隊 6 人,前端 2、後端 2、產品 1、設計 1
    2. 期望 3 個月內能驗證市場
    3. 優先考慮現有客戶的 adoption 風險
    
    請從產品策略、商業模式、技術風險三個角度辯論,最後給一個推薦選項與 roadmap。
    

    行動建議:把你手上的下一個 roadmap 爭議點,寫成「A vs B + 條件」格式,直接餵給 /council。


    2. 工程師:技術方案比較 / 架構選擇

    情境:

    • 要決定「單體服務 vs 微服務」
    • 比較「使用 Rust / Go / Java 實作」

    例如:

    /council 我要設計一個高併發 API 服務, QPS 目標 5k,
    選項 A:使用 Go + Gin + Redis
    選項 B:使用 Rust + Axum + Redis
    
    約束:
    - 團隊目前主要會 Go,沒人寫過 Rust
    - 上線時間壓力大,希望 2 個月內可上線 MVP
    
    請從開發效率、長期維護成本、性能需求三個角度辯論,
    最後給出推薦技術棧與風險清單。
    

    行動建議:先把你準備寫在技術設計文檔裡的「方案對比」,丟給高智議會,看看它會怎麼拆解風險與權衡因素。


    3. 個人:職涯抉擇 / 學習路線

    情境:

    • 「要不要跳槽?」
    • 「要走管理還是繼續寫程式?」

    使用示例:

    /council 我現在是一名 5 年資歷的後端工程師,
    手上有兩個選擇:
    A:留在現在公司,穩定但成長有限
    B:加入一間早期 AI 新創,薪水略高但不確定性大
    
    條件:
    - 已婚,有小孩,家庭支出固定
    - 想在 3 年內成為資深工程師或 Tech Lead
    
    請從職涯風險、技能成長、財務安全三個角度辯論,
    給我具體建議與行動計畫。
    

    行動建議:把你最近在朋友群裡反覆抱怨的那個職涯問題,寫成 A/B 選擇 + 三個條件,讓「高智議會」幫你理一次。


    怎麼開始:從 GitHub clone 到第一個 /council

    以下以一般開發者環境(macOS / Linux)為例,步驟盡量壓縮到 10 分鐘內能跑起來。


    步驟 0:準備環境

    先確認:

    • 已安裝 git
    • 已安裝 Python 3.10+ 或專案要求版本(請以 repo README 為準)
    • 有一組可用的 LLM API key(例如 OpenAI / DeepSeek)

    行動:如果沒有 Python,可以先裝 pyenv 或用你習慣的版本管理工具準備一個環境。


    步驟 1:Clone 專案

    git clone https://github.com/0xNyk/council-of-high-intelligence.git
    cd council-of-high-intelligence
    

    行動:在你常用的開發目錄執行上述指令,打開專案資料夾準備配置。


    步驟 2:建立虛擬環境並安裝依賴

    python -m venv .venv
    source .venv/bin/activate  # Windows 使用 .venv\Scripts\activate
    pip install -r requirements.txt
    

    如果 README 有指定使用 poetry 或其他工具,請以官方文件為準。

    行動:成功後,執行 python -V 確認你現在在虛擬環境內。


    步驟 3:設定 LLM 提供商(API key)

    專案通常會有範例環境檔,例如 .env.example 或 config.example.yaml。

    1. 複製範例檔:
    cp .env.example .env
    
    1. 打開 .env,填入你的 API key,例如:
    OPENAI_API_KEY=sk-xxxx
    # 或使用其他提供商
    DEEPSEEK_API_KEY=xxxx
    ANTHROPIC_API_KEY=xxxx
    
    1. 若專案支援多模型,你可以在設定檔裡定義:

    2. 哪個 persona 用哪個 provider

    3. 模型名稱(例如 gpt-4.1, deepseek-chat 等)

    行動:至少先填一組你最熟悉的 API key,確保可以跑通第一個會議。


    步驟 4:啟動「高智議會」

    依專案設計,啟動方式可能是 CLI 或 TUI,常見格式如下(請對照 README):

    python main.py
    # 或
    council
    

    啟動後,終端可能會顯示類似:

    Welcome to the Council of High Intelligence.
    Type /council to start a new deliberation.
    

    行動:如果啟動失敗,先檢查:

    • Python 版本是否符合
    • requirements.txt 是否安裝完整
    • .env 是否存在且變數名稱拼寫正確

    步驟 5:發出你的第一條決策指令

    在終端中輸入:

    /council 幫我決定,接下來三個月我要把下班時間花在什麼事情上:
    A:寫 side project,目標是做一個小型 SaaS
    B:準備跳槽,用來刷 LeetCode 和整理履歷
    
    條件:
    - 每天大約只有 1.5 小時可用
    - 希望一年後收入有明顯提升
    請從時間投入風險、學習成長、現金回報三個角度辯論,最後給具體計畫。
    

    你應該會看到:

    • 多個角色輪流發言
    • 中間互相質疑、補充
    • 最後一位「主持人」整合結論與行動步驟

    行動:把這次輸出的結論,轉成你今天可以實際做的一件小事(例如:「今晚先列出三個 side project 題目」)。


    延伸:和多代理系統、雙 GPU 的連結

    如果你手上有多 GPU,或對 multi-agent 有興趣,可以參考這兩個方向:

    • 多 GPU 並行推理(參考 r/LocalLLaMA 貼文):
    • 用一個較大模型當 orchestrator,
    • 多個小模型當子代理,平行處理不同 persona。
    • 安全領域應用:像 VulnClaw 這類多代理滲透測試框架,將「多角色協作」搬到資安自動化場景。

    如果你本來就在玩多代理框架(如 MCP、各種 agent 工具),高智議會可以作為「決策模組」,專門負責:

    • 需求澄清與任務拆解
    • 方案比較與風險評估
    • 最後做出一個「可執行決策」交給其他 agent 落地

    最後的可行動點:

    1. 先 clone 下來跑一次 /council
    2. 把你日常最常卡的那種決策(技術選型 / 職涯 / 產品路線),固定丟進去
    3. 觀察 1–2 週,看它是否幫你減少「反覆糾結」的時間

    把開會交給費曼們,你多一點時間去執行。


    🚀 你現在可以做的事

    • 到 GitHub clone 下來 council-of-high-intelligence,依照文中步驟跑起第一個 /council
    • 挑一個你現在最卡的 A/B 決策,照範例格式寫好丟進議會讓它辯論一次
    • 如果你有在用多代理框架,嘗試把「高智議會」當成決策模組接入現有工作流
  • GPT‑5.6:從分數戰轉向系統戰

    GPT‑5.6:從分數戰轉向系統戰

    📌 本文重點

    • GPT‑5.6 把競爭從比模型分數轉向比整體系統與治理能力
    • 企業技術部門角色從「工具供應商」變成「治理設計師」
    • 一般使用者的關鍵變成「敢不敢交資料」與是否可被稽核與回滾

    GPT‑5.6 的發布,不只是又一次「模型升級」,而是正式宣告:紅海時代,大模型之間的差距不再只是分數,而是整套系統設計與治理能力的差距。在這個版本之後,誰還在追「跑得更快、答得更準」,其實已經落後;真正的競爭是誰能把模型變成可管、可控、可結算成本的 AI 作業系統。


    一、在已經高度同質化的紅海裡,分數進步到底值多少錢?

    從 Towards AI 公布的測試來看,GPT‑5.6 Sol 系列在多項 benchmark 上有「顯著提升」:推理更穩、多語言更準、長文本處理更可靠。

    問題是,在 GPT‑4.5、Claude、Gemini 已經把主流場景占滿的今天,這種提升不再自動變成「新產品力」,而是逼開發者回答更殘酷的一個問題:你到底要用它做一個「更好的工具」,還是一個「能自己跑流程的系統」?

    💡 關鍵: 在模型表現接近飽和的紅海裡,「能否做成完整系統」比單純分數提升更能創造商業價值

    過去一代的升級,帶來的是:更好的客服機器人、更聰明的程式碼助理、更流暢的多語言寫作。

    而 GPT‑5.6 這一代的幅度,足以讓產品形態跨一個級距:

    • 從「問答型助手」走向「持續運作的 Agent 網絡」,例如自動維護雲端資源、排程行銷活動、跟進未完成任務。
    • 從「單次生成」走向「長期狀態管理」,在多輪對話與多個系統之間維持一致策略與上下文。
    • 從「一個 API 點進去」走向「一套 OS 介面」,模型支援工具調用、工作流編排、權限與審計整合。

    換句話說,GPT‑5.6 真正解鎖的是「可托付責任」的新產品形態——你開始敢讓它接管一整段流程,而不只是用它寫封信、改段程式碼。

    這也是為什麼在紅海裡,性能分數不再是主角,「能否做成完整系統」才是新的價值衡量方式。


    二、企業技術部門:從「管基礎設施」到「設計 AI 作業系統」

    MIT Tech Review 指出,Gartner 把 2026 定義為企業 AI 投資的「轉折年」:IT 基礎設施成本預計到 2030 年可能成長 2–3 倍,但預算並不會同步翻倍。

    💡 關鍵: 到 2030 年 IT 成本成長 2–3 倍而預算不跟著翻倍,逼企業必須用 Agent 化流程把 AI 投資變成可量化的成本效率

    這個背景,讓 McKinsey 推崇的 Agent 化工作流程變成不是「創新選配」,而是「成本壓力下的必須」。在這個脈絡下看 GPT‑5.6,它真正改變的是技術部門的工作分工與投資優先級。

    第一個改變:技術部門不再只是「服務模型」,而是「編排 Agent」。

    過去:

    • 架構師關心的是雲端成本、微服務切分、資料庫選型。
    • MLOps 團隊關心的是模型部署、版本控制、監控與回滾。

    在 GPT‑5.6 等級的模型上線後:

    • 架構師得開始設計 「AI OS 層」:Agent 如何拿權限、如何調工具、如何記錄行為、如何被審計。
    • 安全與資料治理不再是附屬條款,而要在設計之初就嵌進 Prompt、工具選項與工作流。

    第二個改變:CapEx/OpEx 的算盤會改寫技術部門的權力結構。

    當基礎設施成本走高,而 Agent 能承接更多維運工作,CTO 和 CIO 面對的是三個新的決策:

    1. 投資在「更強的大模型」,還是「更厚的 guardrails 與治理層」?
      只砸錢在 GPT‑5.6 這類旗艦模型,而不投資輸入/輸出管控與審計系統,是把企業暴露在更大規模、更難追蹤的風險之中。

    2. 技術團隊角色的重排:

    3. 開發者少寫業務邏輯,多寫「Agent 行為策略」與「工具適配層」。
    4. 資安與合規人員,不再只是做事後審查,而要參與 prompt 設計與權限模型設計。

    5. 雲端與本地的平衡會被重新談判:

    6. 對延遲與成本不敏感的場景,用 OpenAI 式雲端大模型仍然合理。
    7. 但凡牽涉 個資、健康、位置、交易明細 等高敏感資料,技術部門要開始為本地/開源方案預留預算和人才,避免全盤依賴單一供應商。

    在這個意義上,GPT‑5.6 是把企業技術部門從「工具供應商」推向「治理設計師」的一記催化劑——誰先看懂這個角色轉變,誰就先把 AI 投資從「酷功能」變成「可量化的生產力與風險管理方案」。


    三、一般使用者:模型變強後,真正重要的不是「能不能」,而是「敢不敢給資料」

    對一般使用者而言,GPT‑5.6 這類模型能力躍升後,體感是愉快的:少錯、少胡扯、多語言更平順,甚至能幫你跨 app 完成一整串任務。

    但真正的瓶頸,正在悄悄從「模型能不能」轉向「你敢不敢把資料交出去」。

    第一個張力:雲端超模 vs 本地/開源。

    • OpenAI 式雲端大模型路線:極致性能、最佳工具整合、快速更新,但所有關鍵行為與資料,統一流向少數幾家供應商。這會與各國愈來愈嚴格的 健康與定位數據保護法案 產生直接碰撞。
    • 本地與開源路線:性能略低,但提供更細緻的資料控制——企業可以在自家機房內部做執行,將敏感資料鎖在自己的網路邊界內,只把低敏訊息丟給雲端大模型做推理。對個人來說,這路線意味著:未來你在手機、筆電上的「離線模型」,可能成為你與雲端巨頭之間的第一層防火牆。

    第二個張力:模型能力升級,卻同時放大安全風險。

    Towards AI 的 LLM Guardrails 文章 用航空公司聊天機器人誤導旅客的案例提醒開發者:模型可以非常自信地說錯話,甚至泄漏或被操控。

    在 GPT‑5.6 時代,這種風險只會被放大,因為:

    • 模型更善於「模擬可信語氣」,讓錯誤資訊更不易被人類識破。
    • Agent 具有執行能力,一旦被 jailbreak,不是只說了不當話,而是可能 誤發郵件、刪資料、錯誤下單。

    💡 關鍵: 能執行動作的 Agent 一旦被攻破,風險從「說錯話」變成「直接動到真實資產」

    對一般使用者來說,這意味著:你需要的已不只是「好用」,而是「可稽核、可回滾、可拒絕」的 AI 系統。

    使用者界面的選擇,會越來越像是在挑銀行而不是挑 app——你會問:

    • 這家服務如何存我的對話與檔案?
    • 有沒有清楚的權限管理與活動紀錄?
    • 發生錯誤時,我有沒有救濟管道?

    結語:看懂 GPT‑5.6,先停下來算風險、成本與治理,而不是急著接 API

    GPT‑5.6 是一個分水嶺:它迫使整個生態系從「比模型分數」轉向「比系統設計與監管適配度」。

    接下來幾年,真正的競爭不在於誰第一個在產品頁面掛上「Powered by GPT‑5.6」,而在於:

    • 誰先把 AI OS 層設計清楚:權限、審計、工具調用、容錯與回滾策略。
    • 誰能把 Guardrails 內建到產品架構,而不是事後補丁。
    • 誰在雲端旗艦模型與本地/開源方案之間,做出 可持續的資料與成本分層策略。

    如果你是開發者或技術管理者,最務實的下一步不是「馬上重寫所有服務接 GPT‑5.6」,而是:

    1. 先畫出你組織的 AI 地圖:哪些流程可以交給 Agent、哪些涉及敏感資料必須留在本地、哪些屬於高風險決策必須有人審核。
    2. 為每一段 AI 流程定義 Guardrails:輸入限制、模型選擇、工具權限、輸出審核與回滾機制,寫成工程設計,而不是憑直覺臨時決定。
    3. 建立「AI 治理委員會」式的責任分工:讓技術、法務、資安與業務共同決定 AI 投資優先級與使用邊界。

    能否善用 GPT‑5.6,不在於你多快集成,而在於你 多早把風險、成本與治理問題想清楚並寫進系統設計。

    在紅海時代,真正的護城河不再是誰用到最新模型,而是誰能讓最新模型安全、持久、可被信任地為自己工作。

    🚀 你現在可以做的事

    • 盤點現有專案中所有使用大模型的流程,畫出一張組織內的 AI 地圖
    • 為其中一條關鍵流程撰寫完整的 Guardrails 設計(輸入限制、權限、回滾機制)
    • 與法務與資安部門約一次會議,討論是否成立跨部門的 AI 治理委員會
  • 用 Gemini 3.5 控螢幕:Agent 實戰架構解析

    用 Gemini 3.5 控螢幕:Agent 實戰架構解析

    📌 本文重點

    • Gemini 3.5 直接「看螢幕 + 點 UI」,大幅簡化自動化 Agent
    • 用 DSL 約束操作與多輪回饋,提升穩定性與錯誤恢復能力
    • 安全邊界與權限治理是避免變成「超級巨鼠標」的關鍵

    Gemini 3.5 的 Computer Use 功能直接解決了一個老問題:過去我們寫辦公自動化或 E2E 測試 Agent,必須在「語言模型」和「操作工具」之間做大量 glue code(Playwright、Selenium、各種 RPA SDK)。現在模型本身就能看螢幕 + 理解 UI + 產生操作事件,實作「會自己點 UI」的 Agent 架構可以大幅簡化,同時在 OSWorld 這類 benchmarks 上已經能接近人類級別的操作能力。

    💡 關鍵: Gemini 3.5 直接讀螢幕與 DOM,讓原本需要大量 glue code 的自動化流程被模型本身吸收,工程複雜度大幅下降。


    重點說明:Gemini 控螢幕的技術斷面

    1. 螢幕感知:Screenshot + DOM 雙通道

    在 Gemini 3.5 Flash 的 Computer Use 能力裡,核心是讓模型同時看到:

    • 螢幕截圖:提供視覺語意,例如按鈕風格、顏色、位置、Tooltip 等。
    • DOM 或可操作節點樹:提供結構語意,如 aria-label、role、id、階層關係。

    實作上通常會有一個中介層:

    • 你的 Agent Runtime 負責抓取 當前視窗 screenshot、序列化 DOM / widget tree 成結構化 JSON。
    • 透過 Gemini API 以多模態輸入丟給模型,模型回傳抽象操作意圖(例如「點選『匯出報表』按鈕」),再轉成具體事件(例如 click(x, y) 或 click(selector))。

    這比傳統 RPA 的「座標點擊」穩健得多,因為模型能根據文字與結構定位元素,不再怕視窗尺寸微調就全掛。

    2. 操作語義到事件映射:從自然語言到 GUI 事件模型

    Gemini 本身不直接產生 OS-level 事件,而是給出操作語義,由你的 Agent 層做事件映射。典型設計是:

    • 模型輸出一組高階指令:
    • click element: 「匯出報表」、scroll until: 「三月」、type in field: 「搜尋」 -> "季報"。

    • Agent 將其轉換成具體事件:

    • 瀏覽器端:document.querySelector(...) + element.click()
    • 桌面端:座標點擊(OS API / robot library)

    建議在系統層設計一個 操作 DSL,例如:

    {
      "actions": [
        { "type": "click", "target": { "text": "匯出報表", "role": "button" } },
        { "type": "fill", "target": { "placeholder": "搜尋" }, "value": "季報" },
        { "type": "wait", "condition": { "text": "匯出完成" }, "timeoutMs": 10000 }
      ]
    }
    

    讓 Gemini 的輸出約束在這個 DSL 內,再由你寫 resolver 把 DSL 轉成實際 API 呼叫,如 Playwright、Chromium DevTools 或自製桌面自動化套件。

    3. 權限與安全沙箱:避免做成「超級巨鼠標」

    能「看螢幕 + 點 UI」的 Agent,在安全上本質上是半個遠端操控工具。要避免直接變成超級巨鼠標,需要在設計時就加上:

    • Scope 限制:只允許控制特定應用(例如公司內部 CRM),而不是整個 OS。
    • 權限分級:讀取螢幕 ≠ 可以操作所有按鈕,對「刪除」「匯出」「設定」類操作加上額外人為確認。
    • 審計與可回溯:所有操作都要有 log,包括模型輸入、輸出 DSL、最後映射的實際事件。

    Gemini 在雲端側有基本的安全保護,但真正壓力在你自家的 Agent Runtime。核心結論:螢幕控制能力是一把雙面刃,沒安全邊界就等同開放一個高權限自動點擊器。

    💡 關鍵: 把控制範圍鎖在特定應用與低權限環境,是避免「一個 Bug 變成全系統災難」的第一道防線。


    實作範例:會自己點 UI 的辦公自動化 / E2E Agent

    以下用 pseudo-code 示範一個基於 Gemini Computer Use 的 Agent 架構,對比你現在用 Playwright 或 RPA 的做法。

    1. Agent 主循環:狀態管理與事件模型

    假設你有一個 Browser Automation Runtime,可以:

    • 抓取 screenshot
    • dump DOM 為 JSON
    • 執行 DSL 動作

    初始化與一次任務呼叫

    # 假設有 gemini_client 已封裝好
    from agent_runtime import get_screenshot, get_dom_tree, execute_actions
    
    SYSTEM_PROMPT = """
    你是一個辦公自動化 Agent。你只能透過提供的 action DSL 操作螢幕。
    目標:根據使用者需求,在瀏覽器完成操作。
    請只輸出 JSON,不要輸出其他文字。
    """
    
    state = {
        "task": "下載最新的月報表並存到桌面",
        "history": []
    }
    
    def run_step(state):
        screenshot = get_screenshot()
        dom = get_dom_tree()  # 結構化 JSON
    
        prompt = {
            "system": SYSTEM_PROMPT,
            "user": {
                "task": state["task"],
                "history": state["history"],
                "screen": screenshot,   # 圖像
                "dom": dom              # 結構化文字
            }
        }
    
        # 透過 Gemini 3.5 Flash 多模態 API
        resp = gemini_client.generate(
            model="gemini-3.5-flash-computer-use",
            input=prompt,
            # 關鍵參數:讓模型遵守 DSL
            tools=[{"name": "ui_action_dsl", "schema": ACTION_SCHEMA}],
            temperature=0.2
        )
    
        actions = resp["actions"]
        result = execute_actions(actions)
    
        state["history"].append({"actions": actions, "result": result})
        return state
    
    # 任務循環(直到模型判斷完成)
    while not state.get("done"):
        state = run_step(state)
    

    關鍵設計點:

    • 使用 多步迭代:每次看最新螢幕 & DOM,再決定下一步 action,類似人類操作流程。
    • 將狀態(history)回饋給模型,讓它能做錯誤恢復與路徑修正。

    2. DSL Schema:限制模型輸出空間

    以 JSON Schema 方式提供 ui_action_dsl 給 Gemini(伺服器側 Stub 示意):

    export const ACTION_SCHEMA = {
      type: "object",
      properties: {
        actions: {
          type: "array",
          items: {
            type: "object",
            properties: {
              type: { enum: ["click", "fill", "scroll", "wait", "assert"] },
              target: {
                type: "object",
                properties: {
                  text: { type: "string" },
                  role: { type: "string" },
                  selector: { type: "string" },
                  ariaLabel: { type: "string" }
                }
              },
              value: { type: "string" },
              condition: { type: "object" },
              timeoutMs: { type: "number" }
            },
            required: ["type", "target"]
          }
        }
      },
      required: ["actions"]
    };
    

    把這個 schema 當作 tool 定義丟給 Gemini,模型就會傾向輸出符合 schema 的 JSON,而不是隨意產生指令文字。這比讓模型自己「猜 Playwright API」更穩。

    3. 錯誤恢復策略:從 E2E 測試角度看

    在 E2E 測試模式下,你可以:

    • 每個 step 後檢查 result 是否有錯誤(DOM element 找不到、timeout 等)。
    • 把錯誤詳細資訊(包含「按鈕找不到」等)回餵給模型,再跑下一個 step,讓 Agent 自己嘗試調整操作策略。

    示意:

    result = execute_actions(actions)
    if result.error:
        state["history"].append({"actions": actions, "error": result.error})
    else:
        state["history"].append({"actions": actions, "ok": True})
    

    這種「模型 + 真實環境回饋」的迭代,比傳統 Playwright 寫死 selector 更有韌性:UI 調整、小改版時,Agent 仍可能靠語意找到正確控件。

    💡 關鍵: 把錯誤結果當成下一輪輸入的一部分,能讓 Agent 自我修正,比單純重試同一段 script 聰明得多。


    建議與注意事項:和 RPA / Playwright 對比,以及安全邊界

    與傳統 RPA / Playwright 的優缺點對比

    優勢:

    • 選擇器韌性更高:不是全靠 #id 或 xpath,模型會綜合文字、位置、上下文理解「這顆按鈕是做什麼的」。
    • 對自然語言任務友善:「幫我下載三月月報表」這種任務,不需要你事先拆成多條 script,Agent 自己規劃路徑。
    • 多模態容錯:螢幕上即使有動態廣告、複雜排版,模型也能分辨主要內容與干擾。

    劣勢 / 需要評估的點:

    • 成本與延遲:每一個 step 都要 call 一次 LLM,比傳統 script 直接執行慢且貴,適合複雜流程,不適合同一動作高頻批量執行。
    • 可預期性:Playwright script 是 deterministic;Gemini Agent 則有一定隨機性(雖然可降低 temperature),需要監控與回滾機制。

    真實專案的安全與治理建議

    1. 明確劃定控制範圍:

    2. 用獨立瀏覽器容器(例如專用 Chrome profile 或 WebView),讓 Agent 只能看到業務系統,而非整個桌面。

    3. 對不同任務配置不同權限 profile,例如「只讀報表」「允許建立草稿但不可送出」。

    4. 強制人機協同節點:

    5. 對敏感操作(刪除資料、匯出大量客戶名單)設計「人工確認」步驟,讓 Agent 停在「準備送出」頁面,由人點最後一個按鈕。

    6. 使用 UI 上的明確標記(例如「需管理員確認」)讓模型也知道哪些步驟不應自動完成。

    7. 完整審計 log + 可回放:

    8. 記錄:模型輸入(螢幕縮圖、DOM 摘要)、模型輸出 DSL、實際執行的事件與結果。

    9. 可選擇在安全事件發生時回放整個操作過程,做事後分析。

    10. 避免敏感資料洩露:

    11. 對 screenshot 做遮罩(mask),例如遮蓋客戶姓名、金額等,再送給模型。

    12. DOM 摘要可做字段裁剪,只提供必要欄位(如 label、角色、結構),不要直接把完整表格資料送到雲端。

    13. 從小範圍 PoC 起步:

    14. 先在「測試環境 + 低權限帳號」上跑 Agent,驗證行為穩定,再逐步提升權限。

    15. 與現有 Playwright / RPA 共存:把 Gemini Agent 用在「探索性操作」與「易變 UI」,穩定的核心流程仍用傳統 script。

    總結:Gemini 3.5 的螢幕感知與控制能力,讓我們可以用更少的硬編碼 selector 和流程腳本,實作能「看得懂 UI、自己點按鈕」的辦公自動化 / E2E Agent。真正的工程重點在於:設計好操作 DSL、狀態管理與錯誤恢復機制,並在安全邊界、審計與人機協同上做好防護,讓這個 Agent 是可控的助理,而不是失控的超級巨鼠標。

    🚀 你現在可以做的事

    • 在你現有的 Playwright / Selenium 專案中,先為 1 個流程試做一個 ui_action_dsl,讓 LLM 產生 JSON 再轉成實際指令
    • 建一個測試用瀏覽器容器(低權限帳號 + 測試環境),接上 Gemini 3.5 Flash 多模態 API 做小型 PoC
    • 為預計自動化的系統列出敏感操作,先設計好「人工確認」與操作 log / 回放機制
  • 用瀏覽器跑自己的 AI Agent:peerd 實戰

    用瀏覽器跑自己的 AI Agent:peerd 實戰

    📌 本文重點

    • peerd 把瀏覽器變成本機 AI Agent 執行環境
    • 純前端運作,API Key 不經過第三方伺服器
    • 多 Agent 隔離與瀏覽器自動化,適合個人工作流與 QA 腳本

    用一句話講清楚:peerd 就是把「瀏覽器」變成你的 AI Agent 執行環境,所有腳本、代理邏輯都在本機瀏覽器裡跑,不經過第三方伺服器。

    連結先給你:
    – GitHub / 官方介紹:https://github.com/NotASithLord/peerd
    – Demo / 官網入口:https://peerd.ai


    核心功能:瀏覽器就是沙盒 + 多 Agent 控制台

    1. 純前端 JS,API Key 只在你機器裡

    peerd 是一個瀏覽器擴充套件,用原生 JavaScript 寫成,執行邏輯都在前端:

    • 你自己輸入 OpenAI、Anthropic、Gemini 等 API Key
    • 請求直接從瀏覽器送出,不經過 peerd 的伺服器
    • 不需要額外安裝「AI 瀏覽器」或開一個本地 server

    💡 關鍵: API 呼叫完全在本機瀏覽器完成,你的金鑰與請求內容不會經過第三方後端服務。

    你可以立刻做的事:
    1. 打開 https://peerd.ai,依照說明安裝瀏覽器擴充套件(目前以 Chromium / Chrome 系列最佳)。
    2. 安裝後,在擴充圖示裡找到 peerd,開啟設定頁,填入你現有的 OpenAI / Anthropic / Gemini API Key。
    3. 測試呼叫一次簡單指令(例如:讓 Agent 幫你總結目前開啟頁面的內容),確認 Key 有效。

    2. 多 Agent,彼此隔離在不同 sandbox / worker

    peerd 的設計重點是:一個瀏覽器,多個 Agent,各自有自己的工作空間。

    它利用:

    • 多分頁 / 多視窗
    • Web Worker / Service Worker

    來把不同 Agent 隔離,例如:

    • Agent A:專門抓資料,跑在一個 Worker 裡
    • Agent B:負責整理與寫摘要,跑在另一個 Worker
    • Agent C:只負責觸發 UI 操作

    彼此透過訊息溝通,但記憶體與腳本隔離,減少互相干擾。

    💡 關鍵: 每個 Agent 在獨立的 worker/sandbox 裡執行,降低互相干擾與權限混用風險。

    你可以立刻做的事:
    1. 在 peerd 的控制面板中,建立兩個 Agent:例如「資料收集 Agent」「摘要整理 Agent」。
    2. 設定:「資料收集 Agent」負責打開網站、擷取內容;完成後把文字丟給「摘要整理 Agent」。
    3. 觀察兩個 Agent 的 log(通常 peerd 會有 console / log 面板),確認任務是分開跑的。

    3. 自動化瀏覽、跑 JS 腳本,甚至開 WebAssembly VM

    peerd 不只有「叫模型寫文字」這一招,它可以:

    • 控制瀏覽器行為:
    • 自動打開指定網址
    • 在頁面中執行 DOM 查詢、抓元素文字
    • 觸發按鈕點擊、輸入框填寫
    • 執行 JavaScript 腳本:在 sandbox 內跑程式邏輯,像一個本地化的「Agent 腳本引擎」
    • 啟動 WebAssembly(WASM)虛擬機:甚至可在瀏覽器裡跑一個簡化版的 Linux VM + 網路堆疊

    這代表:

    • 你不用額外架 server 就能做「自動化 QA 腳本」
    • 可以把實驗性 side project 完整關在瀏覽器裡玩,不動你的主機環境

    你可以立刻做的事:
    1. 用 peerd 新增一個「任務腳本」,讓它在分頁裡執行以下行為:
    – 打開一個新聞網站
    – 用 document.querySelectorAll('h1, h2') 抓標題
    – 把標題串成一段文字
    2. 把這段文字交給 LLM,請它生成摘要,顯示在 peerd 的面板中。
    3. 如果你熟 JS,可以把這個流程包成一個可重複執行的腳本,日後一鍵跑。


    適合誰用:三種具體場景

    1. 個人資訊整理 / 研究助手

    使用情境:

    • 你每天會看固定幾個新聞網站或技術部落格
    • 想要「早上開機 → 一鍵跑 → 自動抓標題 → 整理成 一頁摘要」

    可以這樣設計一個 peerd Agent:

    1. 設定一個 URL 清單(例如:三個新聞站 + 一個技術站)。
    2. Agent 依序打開每個網站,抓取首頁標題(或特定區塊)。
    3. 把所有標題與小段落交給 LLM,產出:
    4. 一份今日重點摘要
    5. 分類(國際 / 本地 / 技術 / 商業)
    6. 把結果顯示在 peerd 面板,或存成一段 Markdown,傳回你的筆記系統。

    適合:

    • 喜歡自己控制流程、但不想寫一堆後端程式的人
    • 不想讓瀏覽紀錄、研究內容經過第三方服務的人

    2. 產品 / 網頁 QA 腳本、互動 Demo

    peerd 可以把「瀏覽器自動操作 + LLM」組成 QA 工作流:

    範例:

    1. 定義一組 QA 腳本:
    2. 打開測試環境網址
    3. 自動登入測試帳號
    4. 點幾個主要流程(新增、編輯、刪除),截取畫面文字
    5. Agent 檢查:
    6. 是否有錯誤訊息
    7. 版面文字是否符合規格(例如:翻譯是否正確)
    8. 把結果整理成一份 QA 報告,直接在瀏覽器下載或複製。

    適合:

    • 前端工程師、PM、設計師,想要簡單重複測試
    • 需要做互動 Demo,讓 Agent 自動「操作產品給觀眾看」

    3. 不想碰 DevOps 的 side project / workflow 原型

    如果你平常:

    • 有很多「想做個小工具」的點子
    • 但一想到要架 server、部署,就懶了

    peerd 提供一種做法:全部寫成瀏覽器 Agent 腳本:

    • 把流程寫在 JS 裡(在 peerd 提供的 sandbox 中)
    • 需要呼叫 LLM,就用自己的 Key
    • 存資料可以暫時放在 LocalStorage、下載檔案、或手動貼回 Notion / Obsidian

    適合:

    • 想先驗證「這個工作流值不值得做成正式產品」的人
    • 想建立個人專用工作流,但不想管理伺服器的人

    怎麼開始:從「自動抓新聞標題摘要」實作一路到客製 Agent

    以下是一條最快速的上手路徑,你可以照做一次,確認 peerd 的使用感覺。

    步驟 1:安裝 peerd 擴充 & 準備 API Key

    1. 打開 https://peerd.ai,找到瀏覽器擴充安裝連結(多為 Chrome Web Store 或手動載入)。
    2. 安裝完成後,點右上角擴充圖示 → 找到 peerd → 打開控制面板。
    3. 準備至少一個 LLM 服務:
    4. OpenAI(或相容 API)
    5. Anthropic
    6. Gemini
    7. 在 peerd 設定頁,填入你的 API Key,並測試一個簡單 prompt(例如:「請用 50 字說明你是誰」)。

    💡 關鍵: 先用簡單 prompt 驗證 API Key 設定無誤,可以避免後續腳本除錯時間。

    步驟 2:建立一個「新聞摘要 Agent」

    目標:自動打開幾個新聞站,抓首頁標題,總結成一段簡報。

    可以照以下邏輯:

    1. 在 peerd 新建一個 Agent,命名為 NewsSummarizer。
    2. 設定任務腳本(概念上類似 pseudo-code):

    “`js
    const sites = [
    ‘https://news.ycombinator.com’,
    ‘https://www.bbc.com/news’,
    ‘https://www.ft.com’
    ];

    async function run() {
    const allHeadlines = [];

     for (const url of sites) {
       const page = await openTab(url); // peerd 提供的抽象 API(實際名稱依文件)
       const titles = await page.eval(() => {
         return Array.from(document.querySelectorAll('h1, h2'))
           .map(el => el.innerText)
           .filter(Boolean);
       });
       allHeadlines.push({ url, titles });
     }
    
     const prompt = `請根據以下新聞標題,用繁體中文整理出今日重點摘要,分段列出:\n\n${
       JSON.stringify(allHeadlines, null, 2)
     }`;
    
     const summary = await callLLM(prompt); // 依照你選的 provider
     output(summary);
    

    }

    run();
    “`

    1. 儲存腳本後,按「執行」:
    2. peerd 會依序開啟那些網站
    3. 抓取標題
    4. 呼叫 LLM 總結
    5. 在側邊面板或 console 顯示結果

    你可以依照自己的需求修改:

    • 換成台灣 / 香港 / 日本新聞網站
    • 加上「只保留包含特定關鍵字的標題」
    • 把 summary 轉成 Markdown,方便貼到筆記

    步驟 3:客製自己的 Agent 腳本

    當你跑過一次「新聞摘要 Agent」後,可以開始做這幾件事:

    1. 抽出共用邏輯:例如「開頁+抓標題」寫成一個可重用的 function,日後換站台不用重寫。
    2. 加入排程或手動檔案輸出:
    3. 每次執行後自動下載一個 .md 或 .txt
    4. 或直接在 peerd 面板顯示,手動複製
    5. 改成其他任務:
    6. 產品價格比價(抓不同電商同一商品)
    7. 技術文章整理(從多個 blog 抓標題+摘要)

    步驟 4:注意權限與安全設定

    雖然 peerd 是純前端、API Key 在你機器上,但仍有幾個安全重點:

    1. 網站權限:
    2. 當瀏覽器問「是否允許此擴充存取某些網站」時,只開啟你真的需要的網域。
    3. API Key 保護:
    4. 不要在共享電腦上使用 peerd,或至少不要留下儲存的 Key
    5. 若用公用電腦,建議使用臨時 Key,使用完立刻 revoke
    6. 腳本來源:
    7. 只執行你自己寫的,或來自可信來源的腳本
    8. 不要隨便貼「網友分享的完整腳本」就直接跑,避免讀寫你不想暴露的資料

    peerd 在 AI Agent 工具裡的位置

    目前市面上有不少「Agent 平台」或「AI 瀏覽器」,peerd 的定位比較特別:

    名稱 核心功能 免費方案 適合誰
    peerd 瀏覽器內純前端多 Agent、自動化操作 開源專案,可自架 不想碰後端,只想用瀏覽器的人
    AutoGen 多 Agent Python 框架 開源 已有後端環境的開發者
    AgentHub 類 雲端 Agent 編排平台 多提供免費額度 喜歡 GUI、無法自管 API Key 的人

    如果你的重點是:「所有東西都在我瀏覽器裡跑,不想任何 A2A(Agent-to-Agent)中介干預」,那 peerd 很值得試一次。


    結論:

    • 想要一個「不碰後端、不開伺服器」的 AI Agent 沙盒,peerd 是目前少見的純瀏覽器方案。
    • 它最適合拿來做:個人資訊整理、簡易 QA 腳本、side project 原型。
    • 你可以從一個「新聞標題摘要 Agent」開始,熟悉後再把自己的工作流程慢慢搬進瀏覽器裡。

    🚀 你現在可以做的事

    • 到 peerd 官網 安裝擴充,填入自己的 OpenAI / Anthropic / Gemini API Key 並跑一次測試 prompt
    • 依照文中的範例,建立一個 NewsSummarizer Agent,實作「自動抓新聞標題+摘要」工作流
    • 把現有的一項重複性瀏覽器流程(例如 QA 點測、價格比價),改寫成 peerd Agent 腳本並在本機瀏覽器中試跑
  • MinerU 把爛 PDF 變 AI 神隊友

    MinerU 把爛 PDF 變 AI 神隊友

    📌 本文重點

    • MinerU 專門把 PDF/Office 轉成乾淨結構化文本
    • 讓表格、圖片、公式都能友善餵給 RAG / Agent
    • 開源可本地部署,易嵌入各種 LLM / Agent workflow

    一句話先說結論:MinerU 就是一台「給 LLM / Agent 吃的文件清洗機」——丟 PDF、Word、PPT 進去,吐出乾淨的 Markdown / JSON,直接給 RAG、Chatbot、Agent 用。

    👉 專案連結:https://github.com/opendatalab/MinerU


    核心功能:讓 AI 真的「看懂」你的文件

    1. 直接吃 PDF / Office,多欄位也能拆乾淨

    多數 RAG 失敗,不是模型太笨,而是原始 PDF 太亂。MinerU 的重點是:

    • 支援:PDF、Word、PPT 等常見文件
    • 能處理的麻煩版面:
    • 多欄位排版(例如期刊論文、報表)
    • 頁首/頁尾、頁碼、註腳
    • 混合字型、大小標題、清單

    你可以這樣用:

    1. 把公司內部 PDF / Word 全部放進一個資料夾,例如 ./docs_raw。
    2. 用 MinerU 批次轉成 Markdown,輸出到 ./docs_md。
    3. 接著再用你熟悉的向量庫(如 Milvus、Qdrant、Weaviate)去吃 docs_md。

    這樣做的好處:後面所有 LLM / Agent pipeline,都只面對格式一致的純文字,而不是千奇百怪的 PDF。

    💡 關鍵: 先把所有文件標準化成一致的 Markdown / JSON,可以大幅降低 RAG 出錯率與後續維護成本。


    2. 表格 / 圖片 / 公式抽取,輸出 Markdown / JSON

    對技術文件來說,表格、圖表、公式往往是重點。MinerU 的輸出設計就是「給 LLM 用」:

    • 表格:轉成 Markdown table 或 JSON 結構,便於查詢與切 chunk。
    • 圖片:支援抽圖路徑(搭配 OCR / 圖像模型再處理)。
    • 公式:儘量轉成可讀的文字或 LaTeX 形式,減少重要信息消失。

    你可以依專案需求選擇:

    • Markdown 模式:適合直接塞進向量庫、做長文閱讀、摘要。
    • JSON 模式:適合需要欄位結構的 Agent workflow,例如:
    • 表格 → JSON → 丟給 Agent 做統計、比對
    • 報表 → JSON → 自動生成指標報表

    💡 關鍵: 把表格、公式這類結構化資訊轉成 JSON,可讓 Agent 做統計、比對、生成報表時更精準可控。


    3. 天然適合多代理 / 本地 LLM Workflow

    MinerU 的定位不是一個「雲端 SaaS」,而是一段你可以塞進自己 pipeline 的工具。

    典型的用法是這樣:

    1. 資料前處理 Agent:監控新文件,觸發 MinerU 解析。
    2. 知識庫建置 Agent:把 MinerU 輸出的 Markdown / JSON 切 chunk + 嵌入向量庫。
    3. 問答 / 任務 Agent:收到問題時,到向量庫檢索相關片段,再交給 LLM 回答。

    因為 MinerU 是開源、可本地部署,你可以:

    • 把它丟進 Docker Compose 裡,和本地 LLM(如 Ollama)一起跑。
    • 讓 CI/CD 在文件更新時,自動重新解析。

    💡 關鍵: 開源且可本地部署,意味著你可以在私有環境中標準化所有文件處理流程,符合安全與合規需求。


    適合誰用?三個具體場景

    1. 企業內部文件知識庫、客服 / 內訓 FAQ

    場景:

    • 公司有大量 SOP、內規、產品說明、培訓教材,多數是 PDF / Word。
    • 你想做一個內部 Chatbot,讓同事問問題時,直接查這些文件。

    可實作流程:

    1. 把所有內部文件收集到 ./company_docs。
    2. 用 MinerU 批次轉成 Markdown:
    3. 標記檔案來源(檔名、類別),方便之後做權限或分類。
    4. 把 Markdown 丟進向量庫,接上你選的 LLM(本地或雲端)。
    5. 在公司 Portal 放一個簡單的 Chat UI,查詢時帶出「原文片段」。

    行動建議:先挑 20 份最常被問的文件,跑一次 MinerU,做一個最小可用版本(MVP)給團隊試用。


    2. 技術文件、論文、報表餵給 RAG / Chatbot

    場景:

    • 需要讓模型理解 API 文件、產品白皮書、學術論文。
    • 想要一個「專門讀某份規格書」的 Chatbot。

    可實作流程:

    1. 用 MinerU 把每份技術文件解析成 Markdown:
    2. 確保目錄、標題層級清楚,可用來分段。
    3. 切 chunk 時,可以以「段落 + 小節標題」為單位,而不是固定字數。
    4. 建立索引:保留檔名 + 小節名稱,方便回答時引用。

    行動建議:

    • 先選一份技術文件(例如某 API Reference PDF),用 MinerU 解析後,和「直接用 PDF OCR」比較效果,你會很快看出閱讀品質差異。

    3. 結合本地 LLM / Agent 做長文閱讀、摘要、自動標註

    場景:

    • 想在本地跑 LLM(例如 Ollama + Qwen / Llama),處理長報告、會議紀錄。
    • 希望自動產生標籤、重點整理、摘要。

    可實作流程:

    1. 本地部署 MinerU,解析文件成 Markdown。
    2. 用一個小腳本:
    3. 讀 Markdown → 切段 → 按段落送到本地 LLM。
    4. 讓 LLM 回傳:摘要、關鍵字、分類。
    5. 把結果寫回另一個 JSON 檔,或直接寫入 ElasticSearch / 你用的 DB。

    行動建議:先挑一份 50 頁以上的 PDF,跑 MinerU + 本地 LLM,實測「從原始 PDF 到摘要 JSON」全流程,測時間 & 品質,再決定要不要全量導入。


    怎麼開始:本地快速跑起 MinerU

    以下示範兩種上手方式:Docker 與 pip。使用前建議先看 GitHub 專案 README(隨版本更新):https://github.com/opendatalab/MinerU

    注意:實際指令可能會隨版本更新,請以官方文件為準。下面是典型用法思路,幫你掌握大方向。

    方式一:用 Docker 跑一個典型 PDF Pipeline

    1. 安裝 Docker(Windows / macOS / Linux 都可以)。
    2. 下載專案或直接拉鏡像(以官方 README 為主):
    docker pull opendatalab/mineru:latest
    
    1. 在本機建立兩個資料夾:
    mkdir -p ~/mineru/input ~/mineru/output
    # 把 PDF 放進 input
    cp your.pdf ~/mineru/input/
    
    1. 跑容器:
    docker run --rm \
      -v ~/mineru/input:/data/input \
      -v ~/mineru/output:/data/output \
      opendatalab/mineru \
      mineru \
      --input_dir /data/input \
      --output_dir /data/output \
      --format markdown
    
    1. 檢查輸出:

    2. 在 ~/mineru/output 裡,你會看到對應的 .md 或 .json 檔。

    接下來,你只要把這些 Markdown:

    • 用 Python 讀進來 → 切 chunk → 打 embeddings → 塞進向量庫。
    • 或者直接丟給 Agent 當上下文。

    方式二:用 pip 安裝,嵌入自己的 Python 專案

    如果你想把 MinerU 當成專案的一部分(例如在 FastAPI、Django 裡叫用),可以這樣做:

    1. 建議先建立虛擬環境:
    python -m venv .venv
    source .venv/bin/activate  # Windows 用 .venv\Scripts\activate
    
    1. 安裝 MinerU(以 README 為準):
    pip install mineru
    
    1. 在 Python 裡呼叫(示意):
    from mineru import DocumentParser
    
    parser = DocumentParser(
        output_format="markdown",  # 或 "json"
        lang="zh",                 # 主要語言
    )
    
    parser.parse_dir(
        input_dir="./docs_raw",
        output_dir="./docs_md",
    )
    
    1. 接上你的 RAG pipeline,例如:
    from your_vector_store import add_markdown_docs
    
    add_markdown_docs("./docs_md")
    

    幾個實用配置建議

    1. 語言設定

    • 如果大多數文件是中文,建議在配置中指定 lang=zh,有助於:
    • 正確切段
    • 標題與正文的判斷
    • 混合語言文件(中英夾雜)可先用 MinerU 預設配置,實際跑一份看看效果再微調。

    2. 版面複雜度:先從「最難的」文件測試

    不同文件可能需要不同策略:

    • 多欄位期刊論文
    • 含大量表格的財報
    • 圖片 + 文字混排的簡報

    建議流程:

    1. 先挑 3 種最重要、也最難處理的 PDF 各一份。
    2. 用 MinerU 跑一遍,目視檢查輸出的 Markdown 是否:
    3. 段落順序正確
    4. 表格完整
    5. 標題層級清楚
    6. 再決定是否需要額外的後處理腳本(例如正則清除多餘頁碼)。

    3. 批次處理:一次跑大量文件

    當你要處理成百上千份文件:

    • 使用 --input_dir / parse_dir 直接對整個資料夾處理。
    • 可搭配簡單的排程工具(如 cron、Airflow、Prefect):
    • 每天檢查新文件 → 觸發 MinerU → 更新向量庫。
    • 建議保留:
    • 原始 PDF 路徑
    • 解析時間
    • 解析版本(方便之後換版本重跑)

    小結:MinerU = 文件進 AI 系統前的「洗版」必備

    如果你正為這些事頭痛:

    • PDF 抽不出好用的文字
    • RAG 回答總是抓錯重點
    • Agent Workflow 每次都被「前處理」拖累

    那 MinerU 是值得花一個下午試跑的工具。把它想像成:

    所有文件進 AI 系統前,先經過的一台「格式清洗機」。

    一旦你把這個「洗版」步驟標準化,後續不論是企業知識庫、技術文件 Chatbot,還是本地 LLM 長文閱讀,都會變得穩定許多。


    🚀 你現在可以做的事

    • 到 GitHub 查看 MinerU 專案 README,確認最新安裝與使用方式
    • 選 10–20 份關鍵 PDF/Word,實際跑一次「PDF → Markdown → 向量庫」流程
    • 在你現有的 RAG / Chatbot 專案中,插入 MinerU 作為前處理步驟,評估回答品質提升幅度
  • GPT-5.6 變成准許制,是安全還是鎖國?

    GPT-5.6 變成准許制,是安全還是鎖國?

    📌 本文重點

    • GPT-5.6 正被以「出口管制 + 牌照」邏輯管理
    • 模型發布節奏與存取權,正被政治與國安風險左右
    • 「逐客戶審批」將催生有牌照的 AI 寡頭與灰色創新
    • 產業須主動交出可審計自律方案,避免全面牌照化

    美國政府要「逐客戶審批」誰能用 GPT-5.6,代表前沿 AI 正被當成核技術與軍規晶片一樣,用「出口管制 + 特許牌照」邏輯管理。短期這是為了國安、選舉與關鍵基礎設施風險降溫,但若「政府批文」成為常態,AI 產業將被推向一個創新節奏由監管決定、模型存取變成政治資源的新時代。


    一、為何政府開始用「出口管制思維」看 GPT-5.6?

    從 The Washington Post、Wired 到 TechCrunch 的報導可以拼出一個清晰脈絡:

    • Anthropic 的 Fable/Mythos 系列被迫下架,成為先例
    • 白宮要求 OpenAI 延後 GPT-5.6,改採「limited preview」
    • The Decoder 指出 GPT-5.6 的 rollout 必須「customer by customer」經政府批准
    • OpenAI 官方公開表態:這種政府介入「不應成為長期預設模式」

    政府在意的是三件事:

    1. 國安風險:GPT-5.6 Sol 被指在程式碼、網路安全、生物領域特別強。可防禦就能攻擊,這在國安系統裡會被視為「雙用途武器」。
    2. 選舉與輿論操控:在美國選舉周期裡,一個能生成長鏈、多步驟 Agent 任務的模型,極易被想像成自動化假訊息工廠。
    3. 關鍵基礎設施:高能力模型可協助找到系統弱點,也能幫忙補洞;在政府還沒有清楚審計、監管工具前,最簡單的選擇就是:先關門,再談規則。

    因此,GPT-5.6 被納入一個近似「AI 出口管制 + 準牌照制度」的框架裡並不意外。真正的變化是:

    AI 從「商品」變成「准許使用的戰略資源」,「能不能用」開始由政治風險評估決定,而不是技術準備度。

    💡 關鍵: 一旦前沿模型被視為戰略資源,「存取權」本身就會變成政治與地緣競爭工具,而非單純商業決策。


    二、大廠被拉進「共同監管」,但商業模式被綁死

    在這場拉鋸裡,OpenAI 和 Anthropic 是被擺上談判桌的兩個樣本。

    1. 發佈節奏不再由公司自己決定

    • The Verge 報導:GPT-5.6 被迫改成三層產品線 — Sol(旗艦)/Terra(中階)/Luna(經濟版),且先以「limited preview」形式釋出。
    • 白宮要求 「slow roll」,實際效果是:
    • 技術早就準備好,但商業公開時間表由政府決定。
    • 模型能力分級發布,高階能力被鎖在少數客戶手上。

    換句話說,模型 road map 變成「技術 × 政策」的聯乘產品。AI Lab 不再只對市場、股東交代,而要對國安官員和監管機構交代。

    2. 大廠開始公開抱怨:這不可持續

    OpenAI 在對外聲明裡的核心訊息是:

    「我們不認為這種政府審批應成為長期預設,因為它讓最好的工具離開了使用者、開發者與防禦者。」

    這不是簡單的公關抱怨,而是點破了結構性矛盾:

    • 安全部門的直覺:能力越強 → 越應關起來 → 審到人、審到國、審到場景。
    • 產業的現實:
    • 模型效能提升變成「無法變現的黑箱」,要賣給誰、何時能大規模 rollout,都不確定。
    • 定價與商業模式難以穩定,Sol / Terra / Luna 的 Token 價格再有競爭力,一旦可用客戶數量被政策卡死,現金流與估值模型都會晃。

    結論是:

    政府把大廠變成「共同監管者」的同時,也把它們推向一種「有責任、沒主導權」的尷尬位置。

    💡 關鍵: 當公司需承擔風險責任卻無法主導發布與客戶策略時,長期商業投資與創新意願會被系統性削弱。


    三、「准許制」對開發者與中小企業,是一場靜悄悄的去風險化

    表面上,逐客戶審批是針對「選定合作夥伴」,實際上,這對開發者與中小企業是一套非常具體的訊號:

    1. 存取門檻不再由技術 / 價格決定,而是由合規 profile 決定:
    2. 你是不是金融、醫療、基礎設施等高風險領域?
    3. 你的客戶在哪些國家?
    4. 你的產品是否可能觸碰選舉、國防、關鍵系統?

    5. 創新節奏被「審批事件」綁架:

    6. 產品 road map 要跟「何時排到審」同步。
    7. 政策事件(選舉、國際衝突)直接決定版本控管,而不是使用者需求。

    8. 「有牌照的 AI 寡頭」風險:

    9. 能通過審批拿到 GPT-5.6 的,大多是大型企業、政府承包商、已被充分 KYC 的平台。
    10. 長期下來,「合規成本」會變成大型玩家的護城河,中小團隊再優秀,也因為無法承擔合規流程,而被鎖在舊模型或開源替代方案。

    換句話說,AI 的「監管去風險」,實際上是對創業生態的「靜默去風險化」:最冒險、最前沿的創新,被推離主流雲服務,轉移到灰色地帶或其他法域。


    四、國際競爭:美國上鎖,高端能力會外溢到哪裡?

    當美國把 GPT-5.6 這種級別的模型上鎖,國際動態會自然補位:

    • 中國:已有自己的閉源大模型與政策框架,若美國工具對部分國家或場景關門,中國廠商會以「可用性 + 主權控制」為賣點爭取市場。
    • 開源社群:
    • Reddit / LocalLLaMA 的討論已經很直白:既然高階模型變成「准許制」,那就自己訓開源版。
    • 一旦 「最強閉源模型」變得難用、難買、難部署,就會進一步推動中階開源模型 + 本地部署 的 adoption。

    這裡有一個微妙的風險:

    當美國試圖用管制鎖住「最強模型」時,實際上是在鼓勵世界其他地方發展「足夠強、但不在美國監管之下」的替代品。

    換句話說,安全風險未必被消除,只是被「地緣政治化」:

    • 友邦:用得到最強模型,但在一堆合約與審計之下。
    • 非友邦:轉向其他供應者或開源,能力差一截,但監管也少一截。

    💡 關鍵: 嚴格鎖住頂尖模型,可能只是把風險轉移到監管較鬆、但同樣有能力開發強大系統的其他法域。


    五、治理路徑選擇:「逐客戶審批」 vs. 「開放但加強監管」

    從治理設計角度看,目前大致有兩條路:

    模式 A:逐客戶審批(Permit 制)

    優點:

    • 能在短期內控制暴露面:誰在用、用在哪裡、用途是什麼,相對清楚。
    • 政府可以針對特定高風險場景(選舉、國防、關鍵基建)直接說不。

    缺點:

    • 不可擴展:每一個重要版本都要排隊審,官僚成本與政治博弈成本爆炸。
    • 創新節奏被政治周期綁死,而不是技術成熟度。
    • 容易演變成實質牌照制,形成「有牌照的寡頭」與「被迫流向灰色市場」的兩極化。

    模式 B:開放存取 + 強化事後/過程監管

    具體可以是:

    • 強制安全審計與紅隊測試:符合一定門檻的模型才能對外供應。
    • 用途與責任分級:
    • 高風險領域(醫療決策、關鍵基建控制)→ 強制經過認證、加強日誌記錄與審計。
    • 一般應用(客服、內容生成)→ 相對開放。
    • 明確責任鏈:
    • 模型提供方負責:能力範圍標示、已知風險披露、基礎防護。
    • 開發者負責:具體應用場景的風險緩解與使用者告知。
    • 終端企業負責:部署環境與內部治理。

    好處是:

    把焦點從「誰能用」轉向「怎樣用才安全」,讓創新者在清晰的責任框架下操作,而不是在政治天氣下求存。


    結語:別等政府設牌照,業界要先交出「可被審計的自律方案」

    從 GPT-5.6 被推向「准許制」,我們可以合理預期:下一代前沿模型(不論是 GPT-6 還是 Claude 的後繼者)都會被要求先過一輪政府審查。在這個框架裡,如果產業只是被動接受,「創新 vs. 安全」就會被迫變成零和遊戲。

    我的判斷與建議是:

    1. 短期嚴控合理:Anthropic Fable 被下架、GPT-5.6 改採 slow roll,是在監管工具尚未成熟前的一次「急凍」。這一步可以理解。
    2. 長期若維持政府逐客戶審批,會把創新壓力推向灰色地帶與他國,對安全並不真正有利。
    3. 產業應主動交出一套「版權清晰、責任明確、可審計」的自律方案,具體包含:
    4. 開源清楚的模型卡(Model Card)與風險 disclosure 模板。
    5. 對高風險應用的標準化紅隊與第三方審計流程。
    6. 可稽核的 usage logging 與事件回溯機制,讓事故可以追責而不是一刀封殺。

    對開發者與使用者來說,最務實的行動是:

    • 在技術選型上預留「多供應者 + 開源備援」,不要把整個產品線綁死在一個可能被政策鎖住的前沿模型上。
    • 設計產品時就內建合規與審計能力,把「誰在用、怎麼用、出了事如何調查」當成產品功能,而不是事後補丁。

    如果 AI 行業不想被完全拖進「准許制」與牌照政治,就必須先給出一個讓政府敢放手的答案:不是限制誰能用 GPT-5.6,而是證明我們有能力讓任何使用 GPT-5.6 的人,被清楚、可追責地使用它。

    🚀 你現在可以做的事

    • 檢視現有產品或專案,評估是否過度依賴單一前沿模型,並規劃替代供應者與開源備援方案
    • 在新功能設計文件中,加入合規、審計與使用者行為記錄需求,作為產品規格一部分
    • 參考現有模型卡與紅隊框架,為自家模型或應用草擬一份「可被審計的自律方案」草案
  • GPT-5.5-Cyber 資安工程實作指南

    GPT-5.5-Cyber 資安工程實作指南

    📌 本文重點

    • GPT-5.5-Cyber 讓安全檢查從「找漏洞」進化到「自動產生可審核 patch」
    • 透過 CI/CD 整合,資安檢查變成每個 PR 的標準流程
    • 自動修補仍需權限分離與人工審核,避免新風險

    GPT-5.5-Cyber 直擊的痛點很單純:你現在的 GPT 會幫你找漏洞,但不會負責把修補流程安全、穩定地接到 CI/CD 裡。Daybreak 計畫與 GPT-5.5-Cyber 的更新,把重心從「發現」轉成「自動化修補且可審核」,讓模型真正能扮演資安工程師,而不是只當顧問。


    重點說明

    1. 專用安全模型:介面、定價與能力差異

    OpenAI 把 GPT-5.5-Cyber當成專用安全模型來賣,有幾個差異:

    • 介面:仍走 OpenAI API,但會有獨立的 model 名稱,例如 gpt-5.5-cyber,並透過 Codex Security 插件接入 repo / CI 環境。
    • 定價:通常走「安全分析專用 tier」,
    • 較高的 input token 上限(方便吃整個 PR / 多檔案 diff),
    • 「按分析次數」或「按 token」計費,偏向企業安全預算,而不是一般應用開發費率。
    • 能力差異:
    • 專門在 SAST/DAST、漏洞分類、修補建議上做過微調;
    • 比一般 GPT 更擅長 理解 CVE、OWASP Top 10、常見框架安全最佳實務;
    • Daybreak 計畫的重點:從挖洞轉向自動 patch,包括生成可直接提交的修補 PR。

    對你的專案的實際好處:

    • 可以把 PR 安全檢查變成標準 pipeline,而不是「有空才找人看」。
    • 讓模型不只「指出有問題」,還能 產出具體 patch + 測試建議,減少資安團隊瓶頸。

    💡 關鍵: GPT-5.5-Cyber 的價值在於「自動產生可審核 patch」,讓模型從顧問變成可以真正動手修補的資安工程師。


    2. 如何接到現有 CI/CD、SAST/DAST 流程

    整合思路可拆三層:

    1. 觸發層:GitHub Actions / GitLab CI / Jenkins,在以下事件觸發:
    2. PR 建立 / 更新
    3. 新版部署前(pre-deploy check)
    4. incident response pipeline(安全告警被觸發)

    5. 分析層:

    6. 先跑既有 SAST(如 Semgrep、CodeQL)/ DAST(如 OWASP ZAP),產出報告。
    7. 用 gpt-5.5-cyber消化:

      • 重點摘要
      • 風險分級
      • 針對特定檔案/函式生成 patch。
    8. 修補層:

    9. 用 Codex Security 插件或自寫 tooling:
      • 根據 diff 生成 patch
      • 產生額外測試案例
      • 建立新的修補 PR,而不是直接 push 到 main。

    實作範例

    以下示範三種整合方式,皆以 GitHub Actions + OpenAI API 為例,你可以類推到其他 CI 平台。


    範例一:在 PR 上自動做靜態分析

    目標:

    • PR 建立時,自動跑 SAST,並用 GPT-5.5-Cyber產生「安全 reviewer 評語」貼回 PR。
    # .github/workflows/security-review.yml
    name: Security Review
    
    on:
      pull_request:
        types: [opened, synchronize]
    
    jobs:
      sast-and-ai-review:
        runs-on: ubuntu-latest
        steps:
          - name: Checkout
            uses: actions/checkout@v4
    
          - name: Run SAST (Semgrep)
            run: |
              pip install semgrep
              semgrep --config "p/owasp-top-ten" --json > semgrep-report.json
    
          - name: Generate AI Security Review
            env:
              OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
            run: |
              python .github/scripts/security_review.py
    
          - name: Post comment to PR
            uses: peter-evans/create-or-update-comment@v4
            with:
              issue-number: ${{ github.event.pull_request.number }}
              body: ${{ steps.generate-output.outputs.review_comment }}
    

    對應的 security_review.py(縮寫版):

    import os, json, requests
    
    with open('semgrep-report.json') as f:
        report = json.load(f)
    
    prompt = f"""
    你是資安工程師。以下是 Semgrep 報告,請:
    1. 挑出高風險項目(類似 SQLi、XSS、RCE)。
    2. 以 PR reviewer 的口吻,給出具體修正建議(含程式碼片段)。
    3. 若可,指出可加上的安全測試案例。
    
    Semgrep JSON:
    {report}
    """
    
    resp = requests.post(
        "https://api.openai.com/v1/chat/completions",
        headers={"Authorization": f"Bearer {os.environ['OPENAI_API_KEY']}",
                 "Content-Type": "application/json"},
        json={
            "model": "gpt-5.5-cyber",  # **關鍵:專用安全模型**
            "messages": [{"role": "user", "content": prompt}],
            "temperature": 0.1
        },
    )
    
    review_comment = resp.json()["choices"][0]["message"]["content"]
    print("::set-output name=review_comment::" + review_comment)
    

    實際好處:每個 PR 都會有一份「資安聚焦」評語,不依賴資安團隊逐 PR 人工 review。


    範例二:產生修補 PR 並跑測試

    目標:

    • 收到資安告警(例如某路由有 SQL injection)。
    • 用 GPT-5.5-Cyber生成 patch + 測試,再由 CI 建立新 PR。

    假設有一個簡單 Python script:

    # .github/scripts/auto_patch.py
    import os, subprocess, json, requests
    
    FILE_PATH = "app/routes/user.py"
    
    code = open(FILE_PATH).read()
    
    prompt = f"""
    你是資安工程師。以下是程式碼,已被標記可能有 SQL injection 問題。
    請:
    1. 產生修補後的完整檔案內容。
    2. 為此路由新增至少一個測試案例(pytest),確認注入失效。
    3. 不要改動非必要邏輯,避免影響既有功能。
    
    程式碼:
    {code}
    """
    
    resp = requests.post(
        "https://api.openai.com/v1/chat/completions",
        headers={"Authorization": f"Bearer {os.environ['OPENAI_API_KEY']}",
                 "Content-Type": "application/json"},
        json={
            "model": "gpt-5.5-cyber",
            "messages": [{"role": "user", "content": prompt}],
            "response_format": {"type": "json_object"}
        },
    )
    
    data = resp.json()["choices"][0]["message"]["content"]
    patch = json.loads(data)
    
    # 假設模型回傳 {"patched_file": "...", "test_file": "tests/test_user_security.py"}
    open(FILE_PATH, "w").write(patch["patched_file"])
    open(patch["test_file"], "w").write(patch["test_code"])
    
    # 在新分支上提交
    branch = "security-fix-auto"
    subprocess.run(["git", "checkout", "-b", branch])
    subprocess.run(["git", "commit", "-am", "chore: auto security patch"])
    subprocess.run(["git", "push", "origin", branch])
    

    CI 的 YAML:

    name: Auto Security Patch
    on:
      workflow_dispatch:
        inputs:
          target_file:
            description: '被標記的檔案路徑'
            required: true
    
    jobs:
      patch-and-test:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v4
          - name: Run auto patch
            env:
              OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
            run: python .github/scripts/auto_patch.py
    
          - name: Run tests
            run: pytest
    

    設計重點:

    • 權限分離:CI 只建立新分支與 commit,不直接 merge。
    • 人類 reviewer 仍要審核 PR,避免模型 patch 造成 Side effect。

    範例三:incident response 裡的 root cause 分析

    目標:當 WAF / IDS 有告警時:

    • 把 log + 程式碼 context 丟給 GPT-5.5-Cyber。
    • 快速拿到 root cause + 修補建議,作為 oncall 的決策輔助。

    簡化版 pipeline:

    # incident.sh
    LOG_SNIPPET=$(tail -n 200 /var/log/app/security.log)
    CODE_SNIPPET=$(sed -n '80,140p' app/routes/login.js)
    
    curl https://api.openai.com/v1/chat/completions \  
      -H "Authorization: Bearer $OPENAI_API_KEY" \  
      -H "Content-Type: application/json" \  
      -d '{
        "model": "gpt-5.5-cyber",
        "messages": [
          {"role": "system", "content": "你是 incident response 資安工程師。"},
          {"role": "user", "content": "logs:\
    '"$LOG_SNIPPET"'\
    code:\
    '"$CODE_SNIPPET"'"}
        ],
        "temperature": 0.0
      }'
    

    你可以把輸出寫入 ticket 系統,或直接貼到 Slack 給 oncall 小組。

    好處:縮短「理解問題 +草擬修補方案」時間,讓人類專注在判斷與決策,而不是整理資訊。


    建議與注意事項

    1. 自動修補的風險控制

    幾個必要的 safeties:

    • 權限分離:
    • CI 只產生 patch 或建立分支 / PR,絕不直接 deploy。這是最基本的安全線。
    • 安全 sandbox:
    • 在隔離環境跑模型生成的修補 + 測試,避免未審核的變更觸及生產資源。
    • 避免「過度修補」:
    • prompt 中要明確要求:「只修補漏洞相關部分,不改動非必要邏輯」。
    • 針對 patch 做 diff review,檢查是否出現大面積重構。
    • 避免引入新漏洞:
    • 生成 patch 後再次跑 SAST/DAST,當成 regression check。

    2. 最小可行落地方案與成本

    一個 MVP 組合大致是:

    • GitHub Actions + YAML:觸發 PR / 手動 workflow。
    • OpenAI API + gpt-5.5-cyber:分析與 patch 生成。
    • 既有測試框架:pytest / Jest / go test 等,用來驗證 patch。

    粗略成本估算(示意):

    • 每次分析吃 50–200 KB 程式碼 + SAST 報告,假設約幾千到上萬 tokens。
    • 若採企業安全定價 tier,大致可以想成:「每個 PR 的資安 reviewer 只要幾角到幾塊美金」級別,通常比請人類資安顧問便宜很多。

    💡 關鍵: 把 GPT-5.5-Cyber 視為「低成本、可擴充的人力」,用幾角到幾塊美金就能替每個 PR 配一位資安 reviewer。

    建議先從:

    1. 對「敏感服務」的 PR 開始,先跑 AI 安全評語,不直接讓它 patch。
    2. 穩定後,再導入「自動產生 patch + 測試,但仍需人工 merge」的模式。

    3. 常見坑與防呆

    • 誤信模型安全建議:
    • GPT-5.5-Cyber 仍會犯錯,不要把它當唯一真相來源。堅持:
      • 每個 patch 必須通過測試。
      • 高風險區域要有資安 engineer 審核。
    • 缺少審核人:
    • 若團隊太小,至少設定「安全 owner」,負責最後 approve。
    • 別讓 auto-merge 跟 AI patch 直接掛在一起。
    • 日誌與敏感原始碼外洩風險:
    • 對外呼叫 OpenAI API 時,注意:
      • 不要把完整 production secrets / customer data 丟進去。
      • 遮蔽敏感欄位(email、ID、token)再送出。
    • 熟讀供應商的 data retention / training policy,必要時啟用「不保留資料」選項。
    • 模型版本與政策更新:
    • 專用安全模型會常更新,建議:
      • 把 model 名稱抽成環境變數,方便切換。
      • 在 staging 先試新版本,再推到 production CI pipeline。

    核心結論:

    • gpt-5.5-cyber + Codex Security 提供的是「能產出可審核 patch 的資安工程師」,不是只會報錯的 linters。
    • 真正的價值在於:把安全工作流程 codify 到 CI/CD 裡,讓資安不再是事後補救,而是每次 PR 都會自動被檢查和建議修補。

    如果你已經有基本的 LLM 開發能力,下一步可以直接從「在 PR 上掛一個 GPT-5.5-Cyber 安全 reviewer」開始,感受它對日常開發節奏的改變。

    💡 關鍵: 起手式可以非常小——先讓 GPT-5.5-Cyber 只當「安全 reviewer」,再逐步升級到自動產生 patch。


    🚀 你現在可以做的事

    • 在現有 GitHub repo 新增一個 PR workflow,接入 gpt-5.5-cyber 產生安全評語
    • 選一個高風險服務,實驗「AI 產生 patch + 測試,由你人工審核合併」
    • 將 model 名稱、API key 等參數抽成環境變數,在 staging 先跑一週觀察效果