作者: kerwin77106

  • 讓 AI 直接改你的 Word、Excel、PPT

    讓 AI 直接改你的 Word、Excel、PPT

    📌 本文重點

    • 讓 AI 直接操作 Word/Excel/PPT 檔案
    • OfficeCLI 適合與 Agent+腳本整合自動化流程
    • 先用「不心疼的文件」試跑完整讀改寫流程

    只用聊天讓 AI「給建議」還不夠,OfficeCLI 讓模型真的可以打開你的 Word、Excel、PPT,讀內容、改排版、算公式、生成簡報。

    工具連結:OfficeCLI GitHub


    核心功能:讓模型操作 Office 檔案,而不是你自己手動點

    OfficeCLI 是一個命令列工具(CLI),設計給 AI Agent 使用,但你也可以自己在終端機裡直接用。核心可以分成三類:

    1. 操作 Word:讀字+改內容+調樣式

    你可以讓模型:

    • 讀取 .docx 內容變成純文字,丟給 LLM 做摘要、改寫、翻譯
    • 依照模型輸出的指令,直接修改段落文字(新增、刪除、重寫某一章)
    • 調整樣式:標題層級、粗體、顏色、清單格式

    可行動做法:

    • 把一份報告初稿丟給模型,請它「重寫成給主管看的版本」,再用 OfficeCLI 把修改結果寫回原本 Word 檔,而不是你手動 Copy & Paste。

    2. 操作 Excel:讀表+算公式+生成新表

    OfficeCLI 可以讓 Agent:

    • 讀取多個工作表的資料,轉成結構化格式給模型分析
    • 新增欄位、列出關鍵 KPI、填入公式(SUM、AVERAGE、VLOOKUP 等)
    • 依照模型的建議建立新的工作表,用來放整理過的結果或圖表資料源

    可行動做法:

    • 給模型一個「原始交易紀錄」Excel,請它:
    • 建一個新工作表 KPI_Report
    • 幫你算出每月營收、客單價、流失率
    • 把結果整理成適合直接插入圖表的格式

    💡 關鍵: 把「讀原始表 → 算 KPI → 生成新表」整個流程交給 OfficeCLI+LLM,可以把每月重複的報表整理工作變成一鍵腳本。


    3. 操作 PowerPoint:生成與微調簡報

    OfficeCLI 支援 PowerPoint 檔案:

    • 讀取每一頁投影片的標題與內容
    • 新增或刪除投影片
    • 更新某一頁的文字方塊(例如換成模型生成的重點整理)

    可行動做法:

    • 把一份 Excel 月報+幾段文字說明給模型,請它先產出「投影片結構與內容草稿」,再用 OfficeCLI 寫進一份新的 .pptx,生成可直接開啟的簡報檔。

    適合誰用:幾個具體場景

    場景 1:自動產出月報簡報

    你現在的流程:

    1. 每月從系統匯出 Excel 報表
    2. 手動整理數字、貼到 PPT
    3. 想標題、寫重點、調整版面

    用 OfficeCLI+LLM 的新流程:

    1. 把原始 Excel 放在固定資料夾
    2. 寫一個簡單腳本:
    3. 用 OfficeCLI 讀 Excel
    4. 把數據丟給模型請它產出「月報重點+簡報大綱」
    5. 用 OfficeCLI 建立新的 PPT,依模型輸出寫入每一頁內容
    6. 最後只需要開啟 PPT,微調設計與少數文字

    可行動做法:先從「只讓 AI 幫你生成大綱與每頁標題」開始,內容可以再自己補,降低信任門檻。


    場景 2:整理一堆 Excel 原始數據成圖表+分析

    典型情境:行銷、產品、營運會有很多:點擊、轉換、工單、留存數據,全在 Excel。難的是「整理出看得懂的表+圖」。

    用 OfficeCLI,你可以:

    • 指定一個資料夾裡所有 Excel 檔,請 Agent 逐一讀取
    • 讓模型決定要留下哪些欄位、怎麼清洗資料(刪除缺漏、轉成正確型態)
    • 生成一個匯總報表工作表,包含:
    • 每個渠道 / 產品線的指標
    • 建議要畫的圖表(折線圖、長條圖等)所需的資料

    可行動做法:先選一個指標(例如「網站流量 x 轉換率」),用 OfficeCLI 做一個自動匯總報表,跑通一次流程,之後再擴展到更多 KPI。

    💡 關鍵: 先從單一指標的自動匯總起步,比一開始就要全覆蓋所有 KPI,更容易驗證數字正確性與提升團隊信任。


    場景 3:讓客服 Agent 直接更新 FAQ 文件

    很多團隊會有一份 Word FAQ 或知識庫檔:

    • 新問題出現,要有人手動編輯文件
    • 內容常常落後實際客服狀況

    用 OfficeCLI,你可以:

    • 讓客服 Agent 在處理完一批工單後,分析常見問題和回答
    • 自動比對現有 FAQ Word 檔:
    • 如果沒有對應條目,就新增一段 Q&A
    • 如果回答過時,就更新文字

    可行動做法:先讓 Agent 提出「修改建議」存成另一份 Word(例如 FAQ_suggested.docx),由人工審核後再整合到正式 FAQ,逐步建立信任再放權直接改正式檔案。


    怎麼開始:從一個指令讓模型讀 Excel 並生成報表

    1. 安裝 OfficeCLI

    前提:已安裝 Python 3.10+ 和 Git。

    在終端機(Terminal / PowerShell)輸入:

    pip install officecli
    

    安裝完可以先輸入:

    officecli --help
    

    確認有指令可用。


    2. 最簡單示範:讀一個 Excel 並生成報表

    假設你有一個 data/sales_raw.xlsx,想讓模型幫你整理成一個 KPI 報表:

    步驟示意(概念):

    1. 用 OfficeCLI 把 Excel 轉出成 CSV 或 JSON 給 LLM
    2. 讓模型決定要生成的欄位與指標
    3. 用 OfficeCLI 新增一個工作表 KPI_Report,把模型結果寫進去

    範例腳本(Python 語意示意):

    from officecli import excel
    from openai import OpenAI
    
    client = OpenAI()
    
    # 1. 讀取原始 Excel
    wb = excel.load_workbook("data/sales_raw.xlsx")
    sheet_data = excel.sheet_to_dicts(wb["Sheet1"])  # 每列變成 dict
    
    # 2. 丟給模型請它設計報表
    prompt = """
    你是一位數據分析師。以下是銷售原始資料,請幫我整理成一份 KPI 報表,包含:
    - 每月總營收
    - 平均客單價
    - 訂單數量
    請回傳 JSON,格式為:
    {
      "columns": ["month", "revenue", "avg_order_value", "orders"],
      "rows": [ ... ]
    }
    """
    
    resp = client.responses.create(
        model="gpt-4.1-mini",
        input=[{"role": "user", "content": prompt + "\n" + str(sheet_data)}]
    )
    
    kpi = resp.output[0].content[0].text
    
    # 3. 寫回新的工作表
    kpi_wb = excel.create_workbook()
    excel.write_json_to_sheet(kpi_wb, "KPI_Report", kpi)
    excel.save_workbook(kpi_wb, "data/sales_kpi.xlsx")
    

    可行動做法:照這個流程改成你自己的欄位與需求,把第一份「自動 KPI 報表」做出來,確認數字沒有問題後,再考慮加入圖表與文字說明。


    3. 串進自己的 Agent:讓排程每天自動更新 KPI 報表

    要讓這套流程每天自動跑,大致分三步:

    1. 寫好一個腳本:
    2. 用 OfficeCLI 讀當日最新 Excel
    3. 叫 LLM 算 KPI
    4. 用 OfficeCLI 更新指定報表檔(例如 KPI_daily.xlsx)

    5. 加進排程:

    6. Windows:用工作排程器(Task Scheduler)每天 09:00 執行腳本
    7. macOS / Linux:用 cron,例如:

    bash
    0 9 * * * /usr/bin/python /path/to/update_kpi.py

    1. 加一層通知:
    2. 報表生成後發一封 Email 或 Slack 訊息,提醒同事報表已更新

    可行動做法:先把腳本寫好,在終端機手動執行,確認整個 Excel→LLM→Excel 流程沒問題,再加排程,避免每天自動跑出錯卻沒人注意。

    💡 關鍵: 先人工確認幾次排程腳本的輸出,把錯誤風險壓低,再全面自動化,能避免在正式報表上出現難以察覺的錯誤。


    與其他方式的比較

    很多人會用「AI 外掛」或「手動 Copy & Paste」來改 Office 文件,OfficeCLI 的差異在於它是給 Agent 和腳本用的 CLI 工具,適合自動化流程。

    名稱 核心功能 免費方案 適合誰
    OfficeCLI CLI 操作 Word/Excel/PPT 給 Agent 用 開源、免費 想用程式+Agent 自動化的人
    Office 外掛 AI 在 Word/Excel 內聊天生成內容 部分帳號可免費 只想在文件內用聊天的人
    手動 Copy & Paste 人工搬運 AI 生成文字到文件 永遠免費 不寫程式、量很小的使用者

    如果你已經在寫腳本、用 Agent 處理工作流程,OfficeCLI 是目前比較直接、可控的選擇。


    小結:先讓 AI 改一份你不心疼的文件

    第一次用時,建議選一份「可以錯、可以重來」的文件做實驗:

    1. 準備一個 Excel 或 Word 副本
    2. 用 OfficeCLI 讓模型讀、改、寫回
    3. 看結果是否符合預期,再逐步放到正式流程

    當你跑通第一次,就會發現:AI 不只會「給你建議」,而是可以像實習生一樣,直接幫你動手調整文件——只是這次,你用 OfficeCLI 把它變成可以排程、可以重複使用的自動化流程。


    🚀 你現在可以做的事

    • 到 OfficeCLI GitHub 安裝並在終端機輸入 officecli --help 熟悉可用指令
    • 挑一份「月報用的 Excel 副本」,依文中範例腳本實作你的第一個自動 KPI 報表
    • 寫一個簡單排程腳本,先手動每天跑一次 Excel→LLM→Excel 流程,確認穩定後再用 cron 或 Task Scheduler 全面自動化
  • 讓 Claude 看影片:10 分鐘跑起來實戰教學

    讓 Claude 看影片:10 分鐘跑起來實戰教學

    📌 本文重點

    • claude-video 把影片轉成可問答知識庫
    • 下載影片、抽幀、語音轉文字全自動
    • 多模態上下文交給 Claude 做各種分析
    • 10 分鐘跑起來,適合教學、課程、demo、監控

    一句話定位:claude-video 讓 Claude 真的「看見」影片,從下載、抽幀、語音轉文字到多模態分析,全包成一個指令搞定。

    GitHub 專案連結:https://github.com/bradautomates/claude-video


    核心功能:一個指令,讓影片變成可問答的知識庫

    claude-video 的核心做的只有一件事:把「影片」轉成 Claude 能理解的多模態上下文。實際拆開來有 3 個關鍵步驟,每一個你都能拿來做自動化。

    💡 關鍵: 透過影格+逐字稿+影片資訊的打包,任何影片都能變成可搜尋、可摘要、可問答的結構化知識來源。

    1. 自動下載影片 + 抽幀

    你只要給一個網址(目前主要是 YouTube),工具會:

    • 下載原始影片檔
    • 依照設定好的間隔抽出代表性的影格(frames)
    • 這些影格會作為「圖片上下文」送給 Claude

    能做什麼:

    • 只看技術教學影片的關鍵畫面(程式碼、投影片、操作步驟)
    • 分析產品 demo 畫面上的 UI 元素、錯誤提示、流程

    行動建議:

    • 想節省時間,把你常看的教學頻道某一支影片的 YouTube 連結先存起來,待會在「怎麼開始」小節直接拿來測試。

    2. 語音轉文字,變成完整逐字稿

    工具會對影片做語音轉文字,把講者說的內容轉成文字,和影格一起送給 Claude。

    常見效果:

    • 自動生成逐字稿(含時間點)
    • 把講者的講解內容和畫面對應起來,更容易做重點歸納

    行動建議:

    • 準備一支你想要「變成文字教材」的影片,比如線上課程、內訓錄影,後面你可以直接用它跑出教學大綱和筆記。

    3. 打包成多模態上下文交給 Claude

    最後,工具會把:

    • 抽出來的影格(圖片)
    • 語音轉文字的逐字稿
    • 影片的基礎資訊(標題、描述等)

    全部打包成一個多模態 prompt,交給 Claude 分析。你可以自訂要 Claude 做什麼:摘要、生成教學、抓重點、產生 QA 題庫等。

    行動建議:

    • 先想好你最常對影片做的「重複動作」,例如:
    • 幫我整理重點
    • 幫我寫 SOP
    • 幫我做中文摘要

    稍後你可以把這段常用指令寫進腳本裡,變成一個固定 workflow。


    適合誰用:4 個實際場景示範

    情境 1:YouTube 教學影片秒變重點筆記

    場景:你常看 Python / 前端 / 設計 / No-Code 教學影片,但看完就忘。

    用法示例:

    • 把影片連結丟給 claude-video
    • 設定 Claude 指令:
    • 濃縮成 10 條重點
    • 列出關鍵程式碼片段
    • 把操作步驟寫成 checklist

    結果:你得到一份可以直接放進筆記軟體的整理稿,比自己邊看邊記快很多。

    實際行動:

    • 找一支你最近收藏但還沒看的教學影片,稍後用它做第一次測試,順便讓工具幫你「看完」。

    情境 2:線上課程變成可搜尋的知識庫

    場景:公司或個人買了一整套線上課程,內容很多但不容易查找。

    用法示例:

    • 把每一堂課的影片都用 claude-video 跑一次
    • 要 Claude:
    • 將每支影片整理成「課程筆記 + 關鍵字標籤」
    • 產出 5–10 個 QA 題目,當作測驗

    結果:你可以把整理好的文字放到 Notion / Obsidian / 任意知識庫裡,之後用關鍵字就能查到課程中的重點片段。

    💡 關鍵: 只要每支課程影片都跑過一次,整套課程立刻升級成可搜尋、可測驗的知識庫,大幅降低複習與查找成本。

    實際行動:

    • 選 1–2 支課程影片做試驗,先建立最小可用的「課程知識庫」,再看要不要自動化整套課程。

    情境 3:產品 demo 影片自動轉成文件說明

    場景:團隊常錄 demo 影片給客戶、內部成員,但文件補不上。

    用法示例:

    • 用 claude-video 處理 demo 錄影
    • 指定 Claude 任務:
    • 把操作流程寫成逐步教學文件
    • 把畫面上的按鈕、表單欄位整理成功能說明
    • 生成「常見問題」和解答

    結果:每一支 demo 可以在幾分鐘內變成:使用說明、FAQ、給新人的入門文件。

    實際行動:

    • 把你最近一次 demo 錄影拿來跑,看看產出的文件是否已經可以直接發給客戶或新同事。

    情境 4:監控 / 內訓影片做檢索與稽核

    場景:公司有大量監控影片或內部訓練錄影,想快速查某一段內容是否出現。

    用法示例:

    • 用 claude-video 跑監控或內訓影片
    • 詢問 Claude:
    • 某時間段內是否有特定事件(例如:某動作、某流程有沒有照 SOP 做)
    • 把違反規範的段落列出,附時間碼

    結果:你得到可以檢索的文字紀錄與標註,比逐段人工看影片省時間。

    實際行動:

    • 先選一支 5–10 分鐘的內訓影片,測試「違規行為摘要」或「流程是否照 SOP」的任務。

    怎麼開始:10 分鐘跑起來教學

    下面是最短路徑:從零到跑出第一個影片分析結果,大致 10 分鐘內可完成。

    步驟 1:環境準備與 clone 專案

    需求:

    • Python 3.10+(建議)
    • 一個終端機環境(macOS / Linux / Windows 都可)

    指令:

    # 1. 下載專案
    git clone https://github.com/bradautomates/claude-video.git
    cd claude-video
    
    # 2. 建議建立虛擬環境
    python -m venv .venv
    source .venv/bin/activate  # Windows 用 .venv\Scripts\activate
    
    # 3. 安裝依賴
    pip install -r requirements.txt
    

    行動建議:

    • 如果你常跑 Python 專案,建議專門開一個資料夾放各種 AI 工具腳本,claude-video 也一起放進去,日後好維護。

    步驟 2:設定 Claude API Key

    你需要一組 Anthropic Claude 的 API Key(可到官方註冊後取得):

    設定方式通常是:

    export ANTHROPIC_API_KEY="你的_API_Key"
    # 或在 Windows PowerShell:
    setx ANTHROPIC_API_KEY "你的_API_Key"
    

    有些版本會使用 .env 檔,你可以在專案根目錄建立:

    ANTHROPIC_API_KEY=你的_API_Key
    

    行動建議:

    • 先確認你目前的方案是否有多模態權限(支援圖片 + 文字),不然影片影格送進去會失敗或被降級成文字模式。

    步驟 3:跑第一個影片分析任務

    以 YouTube 影片為例,專案通常提供類似 /watch 的指令或腳本(具體以 repo 當前 README 為準)。假設有一個 CLI:

    python watch.py "https://www.youtube.com/watch?v=你的影片ID"
    

    這一步會:

    1. 下載影片
    2. 抽幀與語音轉文字
    3. 把結果送進 Claude,依照預設 prompt 報告分析結果

    輸出可能是:

    • 一段純文字摘要
    • 搭配時間碼的段落整理
    • 對影片內容的 QA 回答

    行動建議:

    • 用你一開始準備的「教學影片」做第一次測試,觀察 Claude 對畫面與講解內容是否理解到位。

    步驟 4:改成你自己的 workflow 步驟

    跑成功一次之後,接下來就看你想把它接到哪個流程裡。以下給一個常見範例:接到影片連結就自動生成「中文摘要+切片提綱」。

    你可以:

    1. 修改專案裡的 prompt 或新增一個配置檔,例如 prompts/summary_zh.txt:
      “`text
      你是一位教學內容整理助理。
      請根據提供的影片影格與逐字稿,輸出:
    2. 以繁體中文撰寫 300–500 字摘要
    3. 列出 8–12 個重點段落,每段附上時間碼
    4. 對每個重點段落寫 1 句適合當剪輯標題的文案
      “`
    5. 在主程式中改成讀這個 prompt,並將輸出寫入檔案:
      bash
      python watch.py "https://www.youtube.com/watch?v=影片ID" \
      --prompt prompts/summary_zh.txt \
      --output output/影片ID_summary.md
    6. 再往前接:
    7. 用表單或簡單網頁,讓同事貼影片連結
    8. 後端直接呼叫這個腳本
    9. 完成後把 Markdown 檔推到 Notion、Git repo 或寄信通知

    行動建議:

    • 先把「中文摘要+切片提綱」這種需求寫成一個固定 prompt,試跑幾支影片調整語氣與格式,穩定後再接到你的自動化流程裡。

    小結

    claude-video 做的事情很直接:讓 Claude 真正能看懂影片,而不只是看標題和描述。

    只要你願意花 10 分鐘:

    • clone 專案
    • 寫好 API Key
    • 跑一支 YouTube 教學影片

    你就能把「看影片、整理重點」這件事交給 Claude 處理,自己只負責看整理好的結果。接下來要擴展到線上課程、產品 demo、監控影片,都只是在同一套流程上微調 prompt 而已。

    🚀 你現在可以做的事

    • 打開終端機,依照教學 clone claude-video 並設定好 ANTHROPIC_API_KEY
    • 找一支你常看的 YouTube 教學影片,實際跑一次 python watch.py "影片連結" 看結果
    • 建立一個 prompts/summary_zh.txt,把你想要的「中文摘要+重點」格式寫進去,開始打造自己的影片整理 workflow
  • Anthropic 信任坍塌:安全人設的代價

    Anthropic 信任坍塌:安全人設的代價

    📌 本文重點

    • 「安全」若成品牌核心,一旦失信就是基礎設施級風險
    • Anthropic 安全敘事與實際商業操作出現三大斷裂
    • 安全不該只聽宣稱,而要可驗證、可質疑、可退出
    • 開發者需用架構與合約設計,降低被單一供應商綁架

    核心觀點很殘酷:當一家公司把「安全至上」當成品牌核心,信任一旦坍塌,它就不再只是普通的商業失誤,而是整個 AI 基礎設施層出現裂縫。 Anthropic 最近在產品節奏、溝通與商業策略上連環失誤,暴露出「安全敘事」與實際操作的巨大落差。這不是一家新創的公關災難,而是全產業必須正視的系統性風險示範。


    一:開發者從護法到失望:安全敘事失靈的轉折

    過去兩年,Anthropic 被許多人視為 OpenAI 的「道德對立面」:強調可解釋性、合規與長期安全,吸引了不少對主流商業化路線焦慮的開發者。Hacker News 上那篇高熱度文章 《Anthropic’s Method to Losing Goodwill in a Few Easy Steps》(Score: 235、180 則留言)之所以炸裂,關鍵在於:失望來自曾經的支持者,而不是既有的批評者。

    💡 關鍵: 連「內行支持者」都在高互動貼文中集體失望,代表品牌信任已跨過警戒線,而非零星抱怨。

    開發者社群由護法轉向失望,有幾個明確的轉折點:

    1. 產品策略的忽視與反覆:從 API 設計、模型命名到權限變更,Anthropic 多次在未充分溝通的情況下,突然調整路線,讓早期採用者感到被背叛。安全公司理應以「可預期性」作為核心價值,但它的產品節奏表現得更像追逐話題的成長型新創。
    2. 社群溝通的缺位:在多次爭議中,開發者感受到的是 沉默、模糊與官樣文章。當大家期待看到風險評估、內部辯論紀錄、模型行為報告時,得到的卻是抽象的價值宣言與 PR 式 FAQ。安全敘事如果無法轉化為可驗證的技術與制度,就只剩下宗教式的信仰要求。
    3. 權力非對稱的暴露:早期開發者願意容忍技術不穩定,但無法容忍政策隨機性。當 API 使用、模型存取或定價突然改變,而官方給出的理由是「安全考量」卻缺乏可核查的細節時,安全變成了一張無需舉證的免責牌。

    結論是殘酷的:Anthropic 把「安全」當作品牌紅利,卻沒有把它做成開發者可操作、可質疑的制度。紅利用完之後,只剩下對不對稱權力的反感。


    二:安全敘事與商業操作的三大斷裂

    Anthropic 的信任危機,更具體地表現在三個層面:定價、封閉策略與政策配合。

    1. 定價:安全溢價還是信任稅?

    當一家公司強調自己是「更負責任、更安全」的模型供應商,它理論上可以收取一定的溢價。然而社群逐漸感受到的是 不透明的定價結構與突如其來的調整——尤其是針對高階模型與企業方案。

    在開發者眼中,這不是安全溢價,而是 信任稅:你付的不只是算力成本,而是被迫相信對方在「安全理由」下調整條款是合理的,卻沒有任何可外部核查的依據。當定價與「安全」綁在一起而缺乏審計機制,安全就被商品化成一種難以反駁的抽象口號。

    💡 關鍵: 當「安全」變成無法被驗證卻能隨時被拿來調價的理由,本質上就是一種隱形稅收機制。

    2. 封閉策略:安全 vs. 生態壟斷

    Anthropic 一開始以「較少依賴用戶數據、較保守的模型使用邊界」吸引大量好感。但隨著產品線擴展,封閉策略逐漸顯形:

    • 模型權限與使用場景限制愈來愈細,但外部可見的風險分析卻沒有相應增加。
    • 資料來源與訓練流程的披露度並未明顯優於其他商業公司,與其「倫理化新創」人設不符。

    結果是,開發者開始意識到:這不是一個把自己定位成公共基礎設施的安全公司,而是一個依然以平台壟斷邏輯運作的 SaaS 供應商,只是多了一層道德塗裝。

    3. 政策配合:國家安全與公司品牌的雙重綁架

    2024 年美國商務部命令 Anthropic 限制海外對 Claude 最新模型的存取,成為後續白宮推動 30 天審查、三個專責實驗室與「機密通過標準」 的重要背景。這個脈絡非常關鍵:

    • Anthropic 在出口管制中被視為國家安全資產,而不是普通雲端服務供應商。
    • 當政府以「國安」為由要求模型封鎖或降級,Anthropic 幾乎沒有討價還價空間,卻又必須在市場上維持「安全公司」形象。

    這造成一種危險的雙重綁架:

    1. 國家安全綁架公司品牌:Anthropic 若要維持在政策圈的「負責任夥伴」地位,就不得不接受更嚴格甚至不透明的限制,哪怕犧牲海外開發者與研究社群的信任。
    2. 公司品牌綁架用戶選擇:當政策決策被包裝為「我們對安全的承諾」,用戶若提出質疑,就會被暗示成不理解風險或不負責任。

    安全被同時用來鞏固國家權力與公司品牌,結果就是外部缺乏任何有效監督,而用戶只能在道德敘事下被動接受限制。

    💡 關鍵: 當「國安」與「品牌安全」疊加時,外部世界幾乎失去監督能見度,只剩被動承受決策結果的角色。


    三:AI 基礎設施化之後,信任破產的系統性風險

    今天的 Claude、GPT 不再只是「智慧客服」或「生產力工具」,而是逐漸成為 雲端計算與資訊流通的底層介面。在這個前提下,安全公司一旦失信,風險遠高於一般互聯網企業:

    1. 決策外包風險:大量企業把內容審查、合規判斷與風險分析交給模型。當模型供應商的「安全政策」缺乏透明度,實際上就是把公司治理外包給一個不受自己控制的黑箱。
    2. 鎖死效應:基礎模型一旦被深度整合到產品、工作流程與資料管線,要「退出」或切換供應商的成本極高。如果供應商以安全為名進一步收緊權限或配合政策限制,用戶很難有實際選擇。
    3. 生態放大器:像 Cloudflare 現在提供更細緻的 AI Bot 控制,預設在廣告支持頁阻擋訓練與 Agent 爬蟲,這類基礎設施級決策會直接塑造整個 AI 生態的數據供給。當安全敘事與商業利益綁在一起,任何一方失信都會被放大成整個網路層級的結構性變化。

    在另一端,2026 年科技業大裁員中被點名「AI」的公司,說明 AI 已經成為效率與成本重構的主軸。當勞動市場、網路基礎設施與國家安全都被 AI 牽動時,模型供應商的「安全人設」就不再只是品牌包裝,而是整個社會風險分配的中樞。


    結論:不要再相信「更安全」,而要要求「可驗證、可質疑、可退出」

    面對 Anthropic 信任坍塌 帶出的警訊,開發者與企業使用者接下來應該改變一個核心心態:不要再問「誰聲稱自己更安全」,而要問「我能否驗證、質疑、並隨時退出這個安全機制」。

    具體行動建議:

    1. 把安全要求寫進合約與技術規格:要求供應商提供可審計的模型行為報告、政策變更通知機制,以及最小可行的可觀測指標(如風險測試集、拒答策略說明)。沒有具體指標的安全承諾,一律視為公關文案。
    2. 預設多供應商與可替換架構:在技術設計上,避免把整個產品與流程綁死在單一模型或單一公司。把「退出成本」視為安全架構的一部分,預留 API 抽象層與模型切換策略。
    3. 把政策透明度列為選型要件:在評估 Anthropic、OpenAI、Google 等供應商時,不只看模型能力,也要檢視它們如何回應政府要求、出口管制與內容封鎖。敢於公開政策互動細節與風險評估的公司,才配談「安全」。
    4. 參與與建立開放社群治理機制:加入或支持開源模型、獨立測試組織與行業自治聯盟,用集體行動逼迫大型供應商提高透明度。不要把安全交給單一公司的道德敘事,而要變成可協商、可挑戰的公共議題。

    最後的判斷是:下一階段能真正贏得市場的,不會是誰喊得更大聲「安全第一」,而是誰在產品決策、政策互動與社群治理上,願意接受外部驗證、承受公開質疑,並給用戶保留真正的退出權。 任何自稱「安全公司」卻無法滿足這三點的,都應被視為風險源,而不是避風港。

    🚀 你現在可以做的事

    • 檢查現有使用的 AI 供應商合約,補上模型行為報告與政策變更通知等具體安全條款
    • 在系統架構中加入模型抽象層,實作至少兩家模型供應商的切換機制
    • 列一張供應商「政策透明度清單」,比較 Anthropic、OpenAI、Google 等在政府要求與封鎖決策上的公開程度
  • Claude Sonnet 5 低成本 Agent 實戰指南

    Claude Sonnet 5 低成本 Agent 實戰指南

    📌 本文重點

    • Sonnet 5 適合作為預設 Agent 主力模型
    • 成本遠低於頂級模型且能力接近 Opus
    • 長上下文與工具調用適合多步驟工作流
    • 安全策略偏保守,較利企業導入

    Claude Sonnet 5 解決的痛點很直接:想做多步驟 Agent 工作流,但 Opus / GPT 旗艦太貴、開源模型又不夠穩。Sonnet 5 在長上下文、工具調用和安全策略上已能覆蓋大多數企業場景,同時單 token 成本顯著低於頂級模型,適合作為預設 Agent 基座,只在少數高難度任務再切換到更強模型。


    重點說明:為什麼 Sonnet 5 值得當主力 Agent 模型?

    1. 能力與成本曲線:接近 Opus,價格接近中階

    根據公開基準與 The Decoder 報導,Claude Sonnet 5 在 GDPval-AA v2 知識工作測試上已超過 Opus 4.8,但定價仍是「中階模型」等級。

    💡 關鍵: Sonnet 5 在知識工作表現已追近甚至超過頂級模型,但價格仍是中階,適合作為大多數任務的預設主力。

    實際含義:

    • 一般知識工作 / 文件處理 / 商務決策代理,Sonnet 5 足以勝任,不需要 Opus 級別。
    • 若你現在線上大量跑 GPT-4.5 / GPT-5.5 這類旗艦模型,把 70–80% 任務切到 Sonnet 5,只在高風險、高價值 task 才升級模型,通常能立刻降下 30–50% API 費用。

    2. 長上下文 + 工具調用:更適合多步驟流水線

    實務上 agent 不是一兩輪對話,而是:

    1. 讀長文件 / 多來源資料
    2. 規劃任務
    3. 多輪工具調用(DB / API / Code Interpreter)
    4. 產出決策或報告

    Sonnet 5 的優勢:

    • 長上下文:支援巨大 context(依官方規格,多數情境已可覆蓋數十萬 token 級)。對 RAG + workflow 代表:
    • 可以減少 aggressive chunking,讓模型一次看到完整流程 / 合約 / 需求文檔。
    • 可以把多輪工具結果與中間推理保留在同一對話,減少「忘記之前做了什麼」。
    • 工具調用(Tool Use):支援結構化工具 schema,類似 OpenAI functions / tools,並在安全策略上更保守(例如對可疑指令會自動拒絕調用某些敏感工具)。這對企業代理的好處是:
    • 減少「亂調 API」的風險
    • 在合規敏感場景(金融、法務)較容易通過審查

    3. 安全策略:有意識地「不做太強」的資安能力

    Anthropic 明確說 Sonnet 5 在網路攻擊和資安任務上的能力刻意壓低,低於某些已被政府封鎖的模型。這點對企業是加分:

    • 在碼農代理 / DevOps Agent場景,可以寫 code、修 bug,但不太會幫你設計攻擊腳本。
    • 對內部稽核來說,可當作「內建安全減速器」,搭配額外安全層更容易說服安全部門。

    實作範例:用 Sonnet 5 搭建多步驟 Agent 工作流

    以下用類 pseudo-code 展示一個文件審閱 + 系統操作的多步驟 Agent pipeline,並示範如何在 Sonnet 5 / Opus / 開源模型間切分任務。

    1. 基本呼叫:帶工具的 Sonnet 5 Agent

    import anthropic
    
    client = anthropic.Anthropic(api_key=ANTHROPIC_API_KEY)
    
    TOOLS = [
      {
        "name": "fetch_contract",
        "description": "依 contract_id 取得最新合約全文",
        "input_schema": {
          "type": "object",
          "properties": {"contract_id": {"type": "string"}},
          "required": ["contract_id"]
        }
      },
      {
        "name": "update_crm",
        "description": "更新 CRM 中的客戶標籤與備註",
        "input_schema": {
          "type": "object",
          "properties": {
            "customer_id": {"type": "string"},
            "tags": {"type": "array", "items": {"type": "string"}},
            "note": {"type": "string"}
          },
          "required": ["customer_id", "note"]
        }
      }
    ]
    
    SYSTEM_PROMPT = """
    你是一個企業合約審閱 Agent:
    - 先閱讀合約與上下文
    - 給出風險摘要與建議
    - 如有需要,呼叫工具 fetch_contract / update_crm 完成任務
    - 僅在確定資訊足夠時才更新 CRM
    """
    
    resp = client.messages.create(
      model="claude-3.7-sonnet-5",  # **核心:以 Sonnet 5 當主力 agent**
      max_tokens=2048,
      temperature=0.2,
      system=SYSTEM_PROMPT,
      tools=TOOLS,
      messages=[{
        "role": "user",
        "content": [
          {"type": "text", "text": "請審閱合約 C-2025-018,並視需要更新 CRM。"}
        ]
      }]
    )
    
    for content_block in resp.content:
      if content_block.type == "tool_use":
        tool = content_block
        if tool.name == "fetch_contract":
          contract = fetch_contract_from_db(tool.input["contract_id"])  # 你的實作
          # 把 tool result 回傳給 Sonnet 5,形成多輪 agent 流程
          resp = client.messages.create(
            model="claude-3.7-sonnet-5",
            max_tokens=2048,
            messages=[
              {"role": "assistant", "content": [tool]},
              {"role": "user", "content": [{
                "type": "tool_result",
                "tool_use_id": tool.id,
                "content": contract
              }]}
            ]
          )
    

    重點設定:

    • model:用 claude-3.7-sonnet-5 當預設 Agent,引導它做規劃 + 工具決策。
    • tools:一定要寫清楚用途與輸入 schema,Sonnet 5 的工具調用在描述清晰時會穩定很多。
    • temperature=0.2:工作流類場景建議偏低,避免「創造力」帶來流程偏離。

    2. 多模型架構:什麼給 Sonnet 5,什麼留給 Opus / 開源?

    可採用一個簡單的 routing layer:

    from enum import Enum
    
    class TaskClass(Enum):
      KNOWLEDGE_WORK = "knowledge_work"  # 合約審閱、報告撰寫
      HEAVY_REASONING = "heavy_reasoning"  # 複雜架構設計、難題推理
      LIGHT_UTILITY = "light_utility"  # 文本清洗、格式轉換
    
    
    def route_model(task: TaskClass) -> str:
      if task == TaskClass.KNOWLEDGE_WORK:
        return "claude-3.7-sonnet-5"  # **主力:成本與能力平衡點**
      if task == TaskClass.HEAVY_REASONING:
        return "claude-3.7-opus"      # 僅在高價值、關鍵決策時啟用
      if task == TaskClass.LIGHT_UTILITY:
        return "local-llama-3.2-8b"   # 或任一開源模型,跑在自家 GPU
    
    
    # 用法
    model_id = route_model(TaskClass.KNOWLEDGE_WORK)
    resp = client.messages.create(
      model=model_id,
      ...
    )
    

    實務建議:

    • 70–80% 任務:給 Sonnet 5(常駐 Agent、日常工作流)。
    • 10–20% 高難度:需要高可靠 reasoning / 風險極高決策 → 升級到 Opus / GPT-5.5 類。
    • 剩餘雜務:可以用開源模型批量處理(log 清洗、模板生成、簡單分類)。

    3. 記憶系統整合:避免「每次都要重新教」

    參考 Hermes 記憶系統的經驗,問題通常不在模型,而在記憶層設計。

    核心做法:

    • 把 Agent 視為「無狀態推理引擎」,持久狀態放在你自己的記憶服務(DB + 向量庫)。

    簡化示意:

    # 1) 從 persistent storage 取出該使用者的長期記憶
    memories = memory_store.query(user_id="u_123", top_k=10)
    
    # 2) 把記憶壓縮成 system / context 提示
    memory_context = compress_memories(memories)  # 用另一個 Sonnet 5 批次壓縮也可以
    
    resp = client.messages.create(
      model="claude-3.7-sonnet-5",
      max_tokens=1536,
      system=f"""
    你是長期協助用戶的個人工作助理。
    以下是你對此用戶的長期記憶摘要,請在回應時優先參考:
    {memory_context}
    """,
      messages=[...
      ]
    )
    
    # 3) 回合結束後,把對話摘要寫回記憶系統
    summary = summarize_with_sonnet5(conversation_turn)
    memory_store.upsert(user_id="u_123", content=summary)
    

    重點:不要期待 Sonnet 5 自己「記得」所有歷史;記憶是架構問題,不是換模型就會好的問題。


    建議與注意事項:真實專案導入 Sonnet 5 的坑

    1. Token 預算:Agent 能力被低估,成本也容易失控

    英國 AISI 的研究指出:把 token budget 放大 10 倍,軟體工程任務成功率可提升約 25%。這對 Sonnet 5 有兩個實務啟示:

    💡 關鍵: 在多步驟任務中適度提高 token budget,往往能顯著提升成功率,但必須搭配明確的預算控管機制。

    1. 不要用 benchmark 上的「單輪小 budget」結果直接低估 Sonnet 5 的 agent 能力。
    2. 真實系統要 顯式設計 token 過程控管,否則長上下文 + 多輪工具調用會把帳單拉爆。

    實作建議:

    • 在你的 orchestrator 層做全任務 token 上限,例如:
    MAX_TASK_TOKENS = 40_000
    
    state = {
      "tokens_used": 0,
      "steps": 0
    }
    
    while not done:
      resp = client.messages.create(...)
      state["tokens_used"] += resp.usage.input_tokens + resp.usage.output_tokens
      state["steps"] += 1
      if state["tokens_used"] > MAX_TASK_TOKENS:
        raise BudgetExceededError("Agent token budget exceeded")
    
    • 對於單次調用,根據場景設 max_tokens:
    • 報告生成:1024–4096
    • 工具決策:256–768
    • 中間思考(chain-of-thought)可用隱式提示 + 上限控制,避免瘋狂自言自語。

    2. 錯誤恢復與重試:不要讓 Agent 一路跑到爆掉

    Sonnet 5 在工具調用上普遍穩定,但實務上仍會遇到:

    • 工具輸入 schema 不符合
    • 工具執行失敗(timeout / 400 / 500)
    • Agent 因缺 context 做出錯誤決策

    最佳實踐:

    1. 工具層要有自己的驗證與重試,不要完全相信模型輸入。
    from pydantic import BaseModel, ValidationError
    
    class UpdateCrmPayload(BaseModel):
      customer_id: str
      tags: list[str] = []
      note: str
    
    
    def handle_tool_call(tool):
      try:
        payload = UpdateCrmPayload(**tool.input)
      except ValidationError as e:
        # 把錯誤回傳給 Sonnet 5,請它修正輸入
        return {"status": "invalid_input", "error": str(e)}
    
      try:
        res = call_crm_api(payload)
        return {"status": "success", "result": res}
      except Exception as e:
        return {"status": "tool_error", "error": str(e)}
    
    1. 對 Agent 本身做step-level checkpoint:每完成一個關鍵子任務就落盤,失敗時從最近 checkpoint 重跑,而不是從頭開始。

    3. 任務適配:什麼放 Sonnet 5,什麼不要硬塞給它

    適合用 Sonnet 5 當主力的任務:

    • 多步驟 知識工作代理:合約 / 法遵審閱、財報分析、專案規劃、需求拆解。
    • 工具中樞 Agent:負責 orchestrate 多個內部服務與子 Agent。
    • 長上下文流程:需要消化大量規格、流程文件後再操作系統。

    建議留給 Opus / 更強模型的任務:

    • 高風險決策:例如金融交易策略生成、法務最終意見草擬。
    • 需要極高推理深度的算法 / 架構設計題。

    建議留給更小 / 開源模型的任務:

    • 批量格式轉換、log 清洗與標註。
    • 嚴格成本敏感、但容錯率高的場景(例如內部搜尋候選排序)。

    4. 安全防護與供應鏈攻擊:不要只相信模型的「安全訓練」

    近期多個 AI Agent 供應鏈攻擊案例(prompt injection、工具回傳惡意內容、外部 API 回傳帶有攻擊指令的文字)提醒我們:

    • Sonnet 5 的安全性 是加分項,但不是防火牆。

    💡 關鍵: 模型層安全訓練無法取代系統層權限控管與審核機制,特別是在 Agent 能直接操作內部系統時。

    • 尤其在 Agent 可以訪問內部系統時,要額外注意:
    • 工具白名單 + 嚴格權限:不同 Agent 只能看 / 改自己該動的系統。
    • 對所有來自外部世界的文字,在餵回模型前做最小化與清洗,避免讓外部 prompt 直接控制 Agent。
    • 關鍵操作(轉帳、刪除資料、變更權限)一律加 人類確認 / 多重簽核,不要讓 Sonnet 5 直接下手。

    把 Claude Sonnet 5 當成「預設 Agent 基座」來設計系統,搭配:

    • 明確的多模型路由
    • 顯式的 token 預算與錯誤恢復
    • 外掛記憶系統與安全層

    你可以在不爆成本的前提下,把原本只能在 POC 裡玩的 Agent 工作流,真正放進生產環境跑起來。

    🚀 你現在可以做的事

    • 審視現有 GPT-4.5 / 5.5 或 Opus 使用場景,標記出可降級給 claude-3.7-sonnet-5 的 70–80% 任務
    • 在現有 Agent 架構中加入 route_model() 邏輯,實作多模型路由與 token 預算控管
    • 建立一個簡單的記憶服務(DB + 向量庫),將 Sonnet 5 當作無狀態推理引擎接入現有業務流程
  • Claude Science:科研人專用 AI 瑞士刀

    Claude Science:科研人專用 AI 瑞士刀

    📌 本文重點

    • Claude Science 把科研全流程集中到一個 AI 工作桌
    • 內建 60+ 科學技能與驗證 agent 降低低級失誤
    • 可與本地/HPC 整合,適合處理敏感數據的研究者

    Claude Science 就是「把你原本散落在 Excel、終端機、文獻庫和繪圖工具裡的工作,一口氣塞進同一個 AI 桌面」的研究專用工作臺。

    官方介紹頁面在這裡:https://www.anthropic.com/news/claude-science-ai-workbench(需付費 Claude 帳號才能使用)


    核心功能:把「會出錯的地方」交給 AI 接手


    1. 預設 60+ 科學技能:直接點選就能開工

    Claude Science 不是一個「空白聊天框」,而是一個已經幫你預裝好多個專業助理的工作區。

    根據 Anthropic 對外說明(見 The Decoder 報導),目前內建 60+ 預配置技能,涵蓋:

    • 基因組學:變異註解、差異表現分析結果解讀
    • 計算化學 / 藥物設計:分子性質預測、對接結果摘要
    • 統計與數據分析:實驗設計、統計檢定建議、結果可視化
    • 文獻相關任務:系統性搜尋策略、摘要、引用格式整理

    💡 關鍵: 內建超過 60 種科研技能,讓常見分析工作可以直接點選呼叫而非從零開始設定。

    你可以這樣用:

    1. 建立一個專案 workspace(例如 RNA-seq_2026)。
    2. 從左側 skill 清單中選 Genomics analysis 或類似技能。
    3. 上傳 CSV/TSV(表達量矩陣、變異列表),直接用自然語言下指令:
    4. 「請用 DESeq2 的邏輯幫我看有沒有明顯差異表現基因,並畫出 2 張關鍵圖。」
    5. Claude 會自動呼叫對應工具,在 workspace 內產生分析腳本、輸出圖表與解讀文字。

    行動建議:先挑 1 個你最常做、最重複的分析(例如「畫火山圖」「整理變異註解」),在 Claude Science 建一個 workspace,試著完全用內建技能走一遍流程。


    2. 驗證 agent:幫你檢查公式與引用,不再心驚膽跳

    研究工作中最容易「低級失誤」的兩塊:

    • 欠查一次就會寫錯的計算(p 值、樣本量、轉換單位)
    • 抄來抄去會亂掉的引用與編號

    Claude Science 針對這一點,加入了專門的 verification agent(驗證代理),會在背景幫你:

    • 重新計算文中的公式與統計數字是否一致
    • 檢查引用是否真有其文、年份/作者是否對得上
    • 標記看起來不合理的值,要求你確認

    💡 關鍵: verification agent 相當於自動化的第二校對者,專門檢查數值與引用,降低論文中「低級錯誤」的風險。

    你可以這樣用:

    1. 把你正在寫的論文方法+結果段落貼進 Claude Science。
    2. 下指令:
    3. 「請啟用 verification,檢查所有數值、公式與引用,列出有問題的地方。」
    4. Claude 會回傳一張「疑似錯誤清單」,例如:
    5. 表 2 的樣本數加總與文中 n 不一致
    6. 引用 [15] 的作者和年份與 PubMed 上不符
    7. 你逐項確認修正,再請它重新產出一版「已校正」的段落。

    行動建議:找一篇你已發表或即將投稿的手稿,把最容易出錯的「結果」+「參考文獻」丟進去,感受一次 verification agent 能抓出多少你自己沒注意的細節。


    3. 與本地 / HPC 整合:敏感數據不用丟到雲端

    根據 The Decoder 與 TechCrunch 的報導,Claude Science 的設計重點之一,是可以部署在你自己的基礎設施:

    • 在實驗室伺服器或私有雲上跑 Claude Science workspace
    • 連接現有的 HPC cluster、排程系統與檔案儲存(例如 Slurm + NFS)
    • 敏感基因資料、病人資料不離開內網,由本地工具完成重運算,Claude 只負責協調工作流程與解讀結果

    工作方式有點像「本地算、Claude 指揮」:

    1. 你在 Claude Science 下指令:「針對這批樣本跑全基因組關聯分析。」
    2. Claude 自動組合腳本與 pipeline,提交到你的 HPC queue。
    3. 跑完後再拉回結果(log、summary、圖表),在介面裡幫你整理成易讀報告。

    行動建議:如果你所在機構有 IT/科研計算團隊,先確認:

    • 機構是否允許部屬第三方 AI 服務到內網
    • 既有的 HPC(例如 Slurm、LSF)能否提供 API / 指令介面
    • 再把 Anthropic 的官方技術文件丟給 IT 評估可行性

    適合誰用:3 類典型科研 workflow 範例


    1. 文獻閱讀與摘要:從海量 PDF 到可以直接用的「相關工作」段落

    典型痛點:文獻太多、摘要太花時間、填 related work 又怕漏東漏西。

    在 Claude Science 的做法:

    1. 建一個專案 CAR-T_solid_tumor_review。
    2. 批量上傳你下載的 PDF(可壓成 zip 丟上去)。
    3. 下指令:
    4. 「請針對 2019 之後的臨床試驗,整理一份表格:包含試驗編號、標的、入組人數、主要終點。」
    5. 「再幫我寫一段 800 字的 related work,分成『成功案例』『失敗原因』。」
    6. 啟用 verification,請它檢查每個試驗資料是否與原文一致,並附上引用標記。

    你得到的成果可以直接變成:

    • 初稿表格(貼到 Word/Overleaf)
    • 初版 related work 段落,後續再手動補充與潤飾

    2. 從 CSV / 實驗結果到圖表與方法段落

    這是最多人希望「直接自動化」的一個流程。以一個小型轉錄體學實驗為例:

    1. 在 Claude Science 建 workspace DrugX_RNAseq。
    2. 上傳:
    3. counts_matrix.csv
    4. metadata.csv(樣本組別、批次)
    5. 指令(高階就好):
    6. 「請用 DESeq2 的概念幫我完成差異表達分析,產出:
      1. QC 圖(PCA + sample distance heatmap)
      2. Volcano plot + Top 20 up/down 基因表
      3. 一段 400 字的方法描述,格式接近論文,可貼到 Methods。」
    7. Claude 會:
    8. 自動生成 R 腳本,在本地/HPC 執行(若已整合)
    9. 收集輸出圖檔,插在回覆裡或放到 workspace 檔案區
    10. 根據實際參數(過濾閾值、標準化方法)撰寫方法段落
    11. 啟用 verification,要求:
    12. 「請確認方法描述中的參數與實際使用的 R 腳本一致。」

    你可以直接把:

    • 圖表 → 存成 PNG/SVG,貼入報告或論文
    • 方法段落 → 小修措辭後貼進 manuscript

    3. 設計實驗與寫論文草稿

    以藥物開發為例,MIT Tech Review 報導 指出 Anthropic 自己也用 Claude Science 來研究罕見疾病用藥。你可以類似這樣使用:

    1. 輸入疾病背景、已知靶點、預算與時間限制。
    2. 請 Claude 提出 2–3 套「可實際落地」的實驗設計路線(包含體外、動物實驗)。
    3. 選定其中一條,要求它:
    4. 列出實驗所需試劑與關鍵設備
    5. 預估樣本數並計算統計 power(交給 verification 檢查)
    6. 先寫一版 preprint 草稿的大綱與部分引言

    你得到的是「足夠完整的方案草稿」,可以拿去與 PI 或團隊討論,大幅縮短從 idea 到可行實驗設計的時間。


    Claude Science vs 一般 ChatGPT / Claude:差在哪?

    如果你現在已經在用 ChatGPT 或 Claude 來輔助科研,可以用下表來對照:

    工具名稱 核心功能重點 免費方案 適合誰
    一般 ChatGPT / Claude 純對話式助理,擅長解釋概念、改寫文字、簡單程式碼 有 學生、自學者、早期構思與文稿潤飾
    Claude Science 研究專用工作臺,整合技能、驗證 agent、本地/HPC 工具 無(需付費 Claude 帳號) 有穩定專案、需要嚴謹流程與數據保護的研究人員

    關鍵差異不在「模型本身」,而是:

    • 有沒有固定的 workspace,讓你把同一專案的資料、圖表、腳本放在一起管理
    • 有沒有 verification agent 幫你做第二層檢查
    • 能不能跟你實驗室的 HPC 和內部資料庫直接串在一起跑

    如果你只是:

    • 偶爾問問問題、改寫 email、寫作業 → 一般 ChatGPT / Claude 就夠

    如果你是:

    • 長期跑同一條 data pipeline、要處理敏感資料、要寫嚴謹的論文或申請書 → 才值得把 Claude Science 納入日常研究管線

    💡 關鍵: 一般聊天模型適合零散、輕量任務,Claude Science 則針對長期專案與嚴謹科研流程做了完整工作臺與驗證機制設計。


    怎麼開始:從註冊到導入自己數據


    1. 誰可以用?

    根據公開資訊(MIT Tech Review & The Verge 報導),Claude Science:

    • 對 所有付費 Claude 用戶 開放(需位於支援地區)
    • 適合:實驗室 PI、博士後、研究助理、產業研發人員
    • 不適合:只偶爾需要 AI 幫忙寫作、對 HPC 串接完全沒有需求的人

    2. 上手流程(概略版)

    1. 準備帳號與權限
    2. 申請付費 Claude 帳號:https://claude.ai
    3. 若要與機構 HPC / 內網資料庫整合,先找 IT 問是否能配合(可能需要企業方案)。

    4. 建立第一個 workspace

    5. 進入 Claude Science 入口(通常在 Claude Web 介面或管理後台可見專用入口)。
    6. 建立新 workspace,命名為某個具體專案(例如 Liver_fibrosis_singlecell)。

    7. 導入你的數據與工具

    8. 上傳:CSV、TSV、Excel、PDF 論文、先前的分析 script。
    9. 若已連接 HPC:設定資料夾路徑與計算 queue(可請 IT 協助)。
    10. 在 workspace 中先跑一個「小實驗」:

      • 「從這個 CSV 產生描述性統計與 3 種圖,並寫 200 字結果段落。」
    11. 把它嵌進日常研究節奏

    12. 專案一開始:用 Claude Science 幫你整理文獻與設計實驗。
    13. 中後期:固定用它來跑標準 data pipeline + 生成圖表。
    14. 收尾:把所有結果+方法段落集中在 workspace 裡,請它幫你「組裝」論文初稿。

    行動建議:

    • 先挑一個「風險低、但步驟多」的小專案(例如 lab meeting 報告),完全用 Claude Science 做一次,看看哪些步驟可以固定成模板。
    • 若覺得合用,再考慮跟 IT/PI 討論,把整個實驗室的標準分析 pipeline 搬進 Claude Science,讓新進成員直接使用同一套 AI 工作桌。

    如果你現在已經感受到:在文獻、分析、寫作之間切換很耗腦,但每件事又都有固定套路,那 Claude Science 就是值得你嘗試的一把 AI 瑞士刀——把這些套路交給它,你專心在「決策」與「創新」上就好。

    🚀 你現在可以做的事

    • 到 Claude 官方頁面確認自己帳號是否支援 Claude Science,並建立第一個專案 workspace
    • 選一個現有小專案,嘗試用內建技能與 verification agent 完整跑完一次分析與寫作流程
    • 與實驗室 PI 或 IT 團隊討論,評估將現有 HPC pipeline 串接到 Claude Science 的可行性
  • Langflow:用畫流程圖做自己的 AI Agent

    Langflow:用畫流程圖做自己的 AI Agent

    📌 本文重點

    • Langflow 用拖拉節點設計 AI Agent 工作流
    • 支援記憶、工具調用與 Webhook,讓 Agent 真正能做事
    • 30 分鐘內即可做出第一個可用的內部 Bot 或自動化流程
    • 開源、可自行部署,適合技術團隊掌控環境

    一句話先講清楚:Langflow 就是把「寫 Agent 程式」變成「畫流程圖」,讓你用拖拉方塊的方式,搭出自己的 AI 工作流。

    Langflow GitHub 專案連結


    核心功能:用方塊和線組出一個會動的 AI

    1. 節點(Nodes):把複雜任務拆成小方塊

    在 Langflow 裡,你看到的是一塊畫布,左邊是各種「節點」,右邊是你畫好的流程圖。

    常用節點類型:

    • LLM 節點:呼叫大語言模型(例如 OpenAI、Anthropic、Ollama 等)
    • Prompt 節點:管理提示詞模板,支援變數(如 {{question}})
    • Memory 節點:儲存上下文,例如聊天紀錄或任務狀態
    • Tool / API 節點:呼叫外部服務,像 HTTP Request、Webhook

    你可以做的動作:

    • 打開 Langflow,先拖一個 Chat Model 節點 到畫布上
    • 再拖一個 Prompt 節點,將使用者輸入包裝成模型指令
    • 把 Prompt 的輸出線接到 Chat Model 的輸入,就完成最基本的「問答 bot」骨架

    💡 關鍵: 把任務拆成節點後,你可以像搭積木一樣重組、調整工作流,而不必重寫整段程式。

    2. 連線(Edges):定義資料怎麼流動

    每個節點都有輸入/輸出接口,透過連線把它們接起來,就形成一個 Agent 工作流。

    常見連線方式:

    • 使用者輸入 → Prompt 節點 → LLM 節點 → 回傳結果
    • 文件載入節點 → 向量資料庫節點(檢索)→ LLM 節點(基於文件回答)
    • Webhook 節點 → LLM 節點 → 再呼叫另一個 API 節點回寫結果

    你可以做的動作:

    • 在畫布上嘗試把「使用者輸入」節點接到兩個不同的 Prompt 節點,再接到兩個 LLM 節點,做 A/B 測試不同指令效果

    3. 記憶(Memory):讓 Agent 不只回一題就忘記

    如果只接一個 LLM 節點,你得到的是單輪對話。要做「會記得之前說過什麼」的 Agent,就要加上 Memory 節點。

    在 Langflow 裡常見記憶用法:

    • 把歷史對話存入記憶,讓下一輪 LLM 接收到完整上下文
    • 在流程中保存一些關鍵變數(例如工單號碼、用戶角色),下游節點可以讀取

    你可以做的動作:

    • 新增一個 Conversation Memory 節點,接在「使用者輸入」和「LLM」中間
    • 測試多輪提問,同一個 Agent 能接續前面的內容

    4. 工具調用與 Webhook:讓 Agent 真的「能做事」

    Langflow 不只是聊天,它可以讓 LLM 透過節點呼叫各種工具:

    • HTTP Request / Webhook 節點:連到你的 CRM、工單系統、Google Sheets 或任意 REST API
    • 資料處理節點:對 JSON、文字做轉換,讓輸入輸出更乾淨

    你可以做的動作:

    • 在畫布上加一個 HTTP 節點,設定你公司內部 API URL
    • 讓 LLM 的輸出(例如「請查詢這個訂單狀態:#12345」)轉成 API 查詢,再把結果回傳給使用者

    適合誰用:三個實戰場景

    場景 1:客服自動回覆流程(半自動客服)

    目標:讓客服人員不用自己寫回覆,改成「點選建議」或讓 Agent 先草擬。

    基本流程可以這樣畫:

    1. 使用者訊息輸入節點(接 Web / 聊天介面)
    2. 記憶節點:保存同一位客戶的歷史對話
    3. FAQ 文件載入 + 向量資料庫節點:把常見問題和答案餵給系統
    4. LLM 節點:基於 FAQ 檢索結果產生回覆草稿
    5. Webhook / 前端節點:把草稿送到客服後台,讓人類按「同意 / 修改 / 拒絕」

    你可以採取的行動(30 分鐘內可完成雛形):

    • 匯入一份公司 FAQ PDF 或 Markdown
    • 建一個簡單的「文件檢索 + LLM 回覆」流程
    • 先在 Langflow 介面測試問答,確認準確率,再決定要不要跟正式客服系統串接

    💡 關鍵: 只要一份 FAQ 和一個基本檢索流程,半自動客服雛形在 30 分鐘內就能跑起來。

    場景 2:文件問答 Bot(內部知識庫助理)

    這是最多人用 Langflow 起手式:做一個「問公司內部文件」的 Bot。

    流程示意:

    1. File Loader 節點:載入 PDF、DOCX 或 Markdown
    2. Text Splitter 節點:把長文件切成小片段
    3. Embedding + Vector Store 節點:建立向量索引,支援語意搜尋
    4. Query 節點:根據提問在向量庫中檢索相關片段
    5. LLM 節點:拿檢索到的內容,組合成清楚答案

    你可以採取的行動:

    • 先用幾份內部文件(例如員工手冊、產品說明)做一個小型知識庫
    • 在 Langflow 介面用「如果我請假怎麼申請?」這類問題測試
    • 看輸出是否有文件來源,確認 Agent 沒亂掰(可在 Prompt 裡要求標註來源)

    場景 3:簡單內部自動化任務(通知 / 報表 / 小流程)

    你不一定要做複雜 Agent,很多公司會先從「AI + 小自動化」開始:

    可能流程:

    1. 定時觸發(或外部 Webhook)節點:例如每天早上 9 點跑一次
    2. API 節點:從系統拉出昨日訂單或工單資料
    3. LLM 節點:請模型整理成「今日重點三點」或「需要注意的異常」
    4. Webhook / Email 節點:把結果發到 Slack / Teams / Email

    你可以採取的行動:

    • 選一個你每天手動整理的報表,先用 Langflow 做一個「拉資料 → LLM 整理 → 發通知」的簡化版
    • 先用測試環境 API,確認沒有誤發給正式頻道,再上線

    怎麼開始:從安裝到第一個 Agent

    1. 部署方式:本機 vs 雲端

    Langflow 是開源專案(Python),你有兩種常見用法:

    • 本機部署:適合開發者、內網環境
    • 需要:Python 環境、基本命令列操作
    • 在本機跑,方便串內部服務,不用把資料丟到外部 SaaS

    • 雲端部署:適合團隊協作、多人共用

    • 可用 Docker 或自行丟到雲端 VM
    • 好處:同事可以一起進到同一個 Langflow 介面,共用工作流模板

    你可以採取的行動:

    • 先在自己電腦用 Docker 跑起 Langflow,熟悉介面
    • 等你有第一個可用流程,再考慮搬到公司雲端或內網伺服器

    2. 快速安裝步驟(以本機為例)

    以最常見的方式示意(實際請以官方 README 為準):

    # 建議用虛擬環境或 Docker,這裡以 pip 為例
    pip install langflow
    
    # 安裝完成後啟動服務
    langflow run
    
    # 預設會在 http://localhost:7860 開一個 Web 介面
    

    你可以採取的行動:

    • 安裝後打開瀏覽器進入 http://localhost:7860
    • 新建一個 Flow,拖一個 Chat Model 節點,接一個 Prompt 節點,測試一輪聊天

    3. 接不同 LLM:商用 API 和本地模型

    Langflow 支援多種模型來源:

    • 商用 API:
    • OpenAI、Anthropic 等,只要在設定中填上 API Key
    • 適合需要好的語言品質,又不介意雲端的情境

    • 本地模型:

    • 可透過像 Ollama 之類的本地推論服務來接
    • 適合零信任、不能把程式碼或資料送出公司網路的團隊

    你可以採取的行動:

    • 先在 Langflow 裡設好一組「雲端模型」作為開發時使用
    • 如果公司有安全需求,再加一組「指向 Ollama / 本地推論」的 LLM 節點,測試兩種效果差異

    4. 串第三方服務:Webhook / API 節點配置

    要讓 Agent 動起來,最重要是「能跟外部世界互動」。在 Langflow 裡,你通常會:

    1. 新增一個 HTTP / Webhook 節點
    2. 設定 URL、HTTP 方法(GET / POST)、Headers 和 Body 模板
    3. 把 LLM 節點的輸出接到這個 HTTP 節點,讓模型決定要送什麼資料

    你可以採取的行動:

    • 先串一個你熟悉的服務(例如測試用的 webhook.site 或公司內的 sandbox API)
    • 用很簡單的 payload(例如只送一行文字),確認連線和驗證沒問題

    範例與社群模板:照著做就有第一個 Agent

    Langflow 社群已經累積不少現成 Flow,可以直接匯入再改。

    常見範例類型:

    • FAQ 問答 Bot:已經幫你設好「文件載入 → 檢索 → LLM 回覆」
    • Email 助理:模型幫你改寫、翻譯、整理郵件內容
    • 簡易客訴處理 Agent:先分類情緒,再產出回覆草稿

    你可以採取的行動:

    • 在 Langflow 社群或 GitHub issue / discussions 中搜尋 templates、examples
    • 選一個 Flow 匯入,改掉其中的 API Key、文件路徑,就變成你自己的版本

    延伸:跟其他 Agent 工具的差異

    市面上也有不少 Agent / 工作流工具,若你同時在看其它方案,可以用下面的表格快速比較定位:

    名稱 核心功能 免費方案 適合誰
    Langflow 視覺化設計 AI Agent 工作流,支援 LLM、記憶、工具調用 開源,自行部署 想自己畫流程、控管部署環境的開發者與技術團隊
    LangGraph 用程式碼定義 Agent 圖結構與狀態機,偏工程師導向 開源 Python 套件 喜歡用程式精細控制 Agent 狀態的後端工程師
    Graphify 把程式碼與文件變成知識圖譜,配合 AI 助理檢索 開源,自行部署 想整理程式碼資產、做跨檔案查詢的開發者

    如果你想要「看得見的流程圖 + 自己部署」,Langflow 是目前上手成本相對低的一條路:從拖第一個節點到完成一個能用的 Agent,控制在 30 分鐘內完全合理。

    💡 關鍵: 視覺化流程加開源部署,讓技術團隊既能快速試錯,又能保有環境與資料的掌控權。


    結論很簡單:先用 Langflow 畫出一個最小可行的 AI 工作流,把你手上最煩的一件重複工作丟給它。等你真正看到 Agent 每天幫你省下的時間,再來慢慢加節點、加工具,把流程做厚,這樣學習成本最低、成效也最明顯。

    🚀 你現在可以做的事

    • 用 pip install langflow 或 Docker 在本機跑起 Langflow,打開 http://localhost:7860 熟悉介面
    • 匯入一份公司 FAQ 或內部文件,照文中的「文件檢索 + LLM 回覆」流程畫出第一個 Bot
    • 在 Langflow 社群 / GitHub 上搜尋並匯入一個現成 Flow 範例,改成符合你公司 API 和文件路徑的版本
  • OpenAI 賣股給政府,是安全還是國防化?

    OpenAI 賣股給政府,是安全還是國防化?

    📌 本文重點

    • 美國若入股 OpenAI,AGI 將走向國防承包商模式
    • 閉源國家級模型壯大,開源與本地 AI 空間被擠壓
    • 全球 AI 正走向多極、封閉、國家掌控的新格局
    • 開發者需提前布局開源、本地、多雲與合規策略

    美國政府若真的拿下 OpenAI 約 5% 股權,這不是單純的投資案,而是把通用 AI 往「國防承包商模式」推進的一大步。政府從監管者變成股東+最大客戶+國安使用者,AI 權力地圖會被重畫:安全框架可能更穩定,但監管獨立性、開源空間與全球權力平衡,都會被擠壓。


    1. OpenAI 的治理,從「公益敘事」轉向「國安優先」?

    根據《The Guardian》與 The Decoder 報導,OpenAI 正與美國政府談判出售約 5% 股權,且是直接對 川普政府開價。這代表幾件關鍵變化:

    💡 關鍵: 美國政府成為 OpenAI 股東,看似 5% 小股,實際可能重塑公司治理與優先順序,讓「美國國家利益」凌駕抽象的「人類利益」。

    1. 董事會與資訊權的再分配:
    2. 即便 5% 看似小股,但若綁定董事席位與特別資訊權,政府可在公司治理中擁有「資訊優先+否決」能力。
    3. 對一家以「對齊 AGI 與人類利益」為名的公司而言,「人類利益」實際將被解讀為「美國國家利益優先」。

    4. 研發優先順序的政治化:

    5. 當最大付費客戶是政府與國安部門時,模型優化的優先順序自然向情報分析、網路攻防、戰場模擬、輿論作戰工具傾斜。
    6. 企業與開發者期待的「通用工具」路線,會逐步讓位給 「戰略級 AI 能力」。

    7. 監管與商業的利益衝突:

    8. 政府同時是 股東、採購方、監管者,這是經典的利益衝突三角。
    9. 出事時,監管機構究竟是要保護公眾,還是保護自己的投資價值與國安部署?
    10. 這種結構極像軍工複合體:波音、洛馬怎麼被對待,未來 AGI 公司就會怎麼被對待。

    OpenAI 原本打的是「安全研究優先、公益基金會結構」的牌,如今則逐步走向「國家級算力與模型供應商」。這不只是商業選擇,而是治理哲學的轉向:從「減少 AGI 風險」變成「把 AGI 風險納入國家安全盤算」。


    2. 政府資本,正在鞏固「閉源+國家級」陣營

    這起事件不是孤立:Anthropic 在 2025 年已悄悄拿下美國企業 AI 支出約 40% 市場,隨後其模型被美國政府大規模採用,用來做監管與審查。現在輪到 OpenAI 主動向白宮示好、提供股權,實際上是兩大閉源巨頭同時向「政府合約」靠攏。

    💡 關鍵: 當 Anthropic 拿下約 40% 企業 AI 支出並成為政府工具,再加上 OpenAI 對白宮釋股,代表「閉源+政府合約」正在變成主流商業模式。

    這裡有三個對競爭格局的結構性影響:

    1. 閉源國家陣營 vs. 開源民間陣營
    2. 一邊是有政府資金、國安場景與法律護航的 國家級閉源模型(OpenAI、Anthropic)。
    3. 另一邊是靠社群、企業自建與本地部署的 開源模型+自訓系統,例如社群倡議的 Right to Intelligence 強調「保護在本地運行 AI 的權利」。
    4. 當政府本身就是閉源巨頭股東時,對開源的監管與安全標準,很可能變成間接產業保護主義:抬高合規成本,把資源集中在「持牌國家級」玩家。

    5. 算力與數據的「國有化傾向」

    6. 雲端與算力早已被視為戰略資源,政府入股後,算力調度與模型使用將被納入國防基建思維。
    7. 搭配像 Cloudflare 新政策,逼迫 AI 公司區分搜尋爬蟲與訓練爬蟲,並向出版產業付費,等於把數據取得也變成受控資源。
    8. 結果是:算力、數據、閉源模型三位一體,被鎖進「高安全級別」的國家體系中。

    9. 市場壓力轉向「拿到政府標章」而不是「技術突破」

    10. 當政府採購與股權投資成為主要成長槓桿,其他大模型公司會被迫追逐「合規形象與國安合作」,而非「開放生態與創新速度」。
    11. AI 公司會越來越像國防承包商:招標文件、合規報告、遊說預算,比開源貢獻、社群工具更重要。

    這對開源社群的壓力非常直接:技術差距不是最大問題,政治資本與法規環境才是真正的護城河。


    3. 地緣政治外溢:AI 走向「多極、封閉、國家掌控」

    美國政府若實質入股 OpenAI,其他國家幾乎不可能袖手旁觀,這會觸發一連串「AI 國有化競賽」:

    💡 關鍵: 一旦 AI 被明確視為國防資產,全球將從少數跨國平台競爭,轉向多個國家各自掌控算力與模型的封閉格局。

    1. 歐洲:監管型國家資本主義
    2. 歐盟本來就以 AI 監管法案、隱私保護見長,面對美國政府與 OpenAI 綁在一起,壓力會從「訂規則」轉向「扶植自己的模型與算力」。
    3. 可能出現更多半公半私的歐洲模型計畫,加強對本地數據與算力的主權要求,並以更嚴格的跨境數據流動限制反制美國模型滲透。

    4. 中國:加速「國家級大模型」與算力主權

    5. 中國已將 AI 列入國家戰略,若美國政府直接握有 OpenAI 股權,等於明示「AGI 是國防資產」。
    6. 這將強化中國在軍民融合 AI、大模型監管與自主算力基地上的投入,並可能進一步限制國外閉源模型在境內落地,改以本地國企模型為主。

    7. 其他國家:被迫選邊站或自建微型主權 AI

    8. 中型國家(印度、韓國、以色列等)會面臨:
      • 要不要接入美國控制的閉源模型做國安與政府系統?
      • 還是投入自建「主權大模型+本地算力」,接受效率落後但保留政治自主權?

    最終結果很可能是:

    全球 AI 生態從「跨國平台競爭」轉向「多極國家掌控算力與模型」,開源只剩在縫隙中求存。


    結尾:開發者與使用者,別再幻想「中立雲端」,要準備三件事

    在這個格局下,對開發者與使用者的實際影響與行動建議很清楚:

    1. 優先學會在本地與多雲環境跑模型
    2. 不要把核心產品綁死在少數「國家級閉源供應商」。
    3. 投資時間在:開源模型(如 LLaMA 家族、其他社群模型)、本地推理框架、邊緣算力優化,確保當閉源 API 因政策、出口管制或國安審查而變動時,你的服務能活下來。

    4. 把「合規成本」當成產品設計的一部分

    5. 未來監管不再只是「安全建議」,而是帶有產業傾向的硬門檻。
    6. 及早研究各國 AI 法規、數據主權要求與內容版權(Cloudflare 政策是風向之一),在系統架構層面預留調整空間,避免被某一國的國家級模型綁死。

    7. 積極參與「本地 AI 權利」與開源政策倡議

    8. 像 Right to Intelligence 這類運動,核心是捍衛「個人與企業在本地運行 AI 的權利」,避免未來只剩下由政府背書的閉源雲端。
    9. 對開發者而言,這不是理想主義,而是商業風險管理:如果我們不為開源與本地權利發聲,最後只會剩下幾家「國防級 AI 巨頭」,決定誰有資格創新。

    結論很簡單:政府入股 OpenAI,不是讓 AI 更安全的萬靈丹,而是宣告「算力與模型正式成為國家級戰略資產」。在這個新時代,能否掌握開源、本地與多極策略,將決定你是被國家級 AI 管制的使用者,還是仍有空間創造與制衡的新玩家。

    🚀 你現在可以做的事

    • 立刻評估現有產品對單一閉源 API 的依賴度,規劃導入至少一套開源本地模型作為備援
    • 追蹤你所在市場的 AI 法規與數據主權要求,為未來可能的「國家級模型綁定」預留技術與商業選項
    • 加入或關注像 Right to Intelligence 等開源與本地 AI 權利倡議,思考如何在社群或企業層面實際參與
  • 用 agents-cli 打造可運維的企業級 AI 代理

    用 agents-cli 打造可運維的企業級 AI 代理

    📌 本文重點

    • agents-cli 把零散工具與 LLM 變成企業級代理工作流
    • 從本地 YAML 到 Google Cloud,自動處理部署與運維
    • 透過 Skill/Agent/Workflow 抽象設計長任務與多工具協作
    • 以 infra-as-code 思維接入 CI/CD,強調安全、成本與邊界控制

    agents-cli 解決的核心痛點很直接:把「一堆零散的工具 + LLM」變成「可觀測、可部署、可運維的企業級代理工作流」。從本地 YAML 設定開始,到在 Google Cloud 串 Cloud Run / Pub/Sub / Vertex AI,它幫你處理流程編排、狀態管理、重試機制與部署細節,讓 Agent 真正變成基礎設施,而不是一支難以維護的 side project。


    重點說明

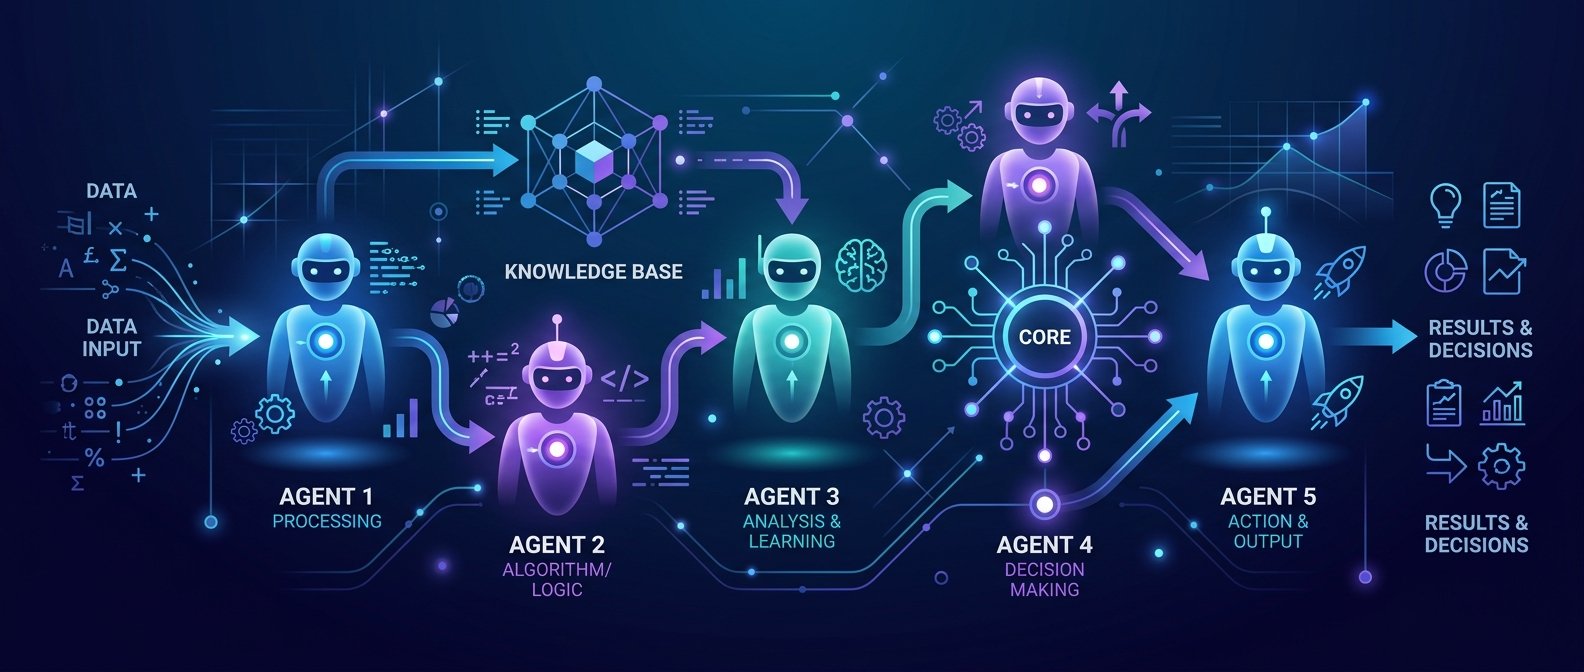
    1. 架構:技能(Skill)與工作流(Agent Workflow)的抽象

    agents-cli 把整個系統拆成三層:

    • Skill:可被代理調用的「工具」,可以是 HTTP API、Cloud Run、自家微服務或腳本。
    • Agent:具備目標與決策能力的 LLM,根據上下文決定要呼叫哪些 Skill。
    • Workflow:如何觸發、排程、分派與監控 Agent 任務(多步、多工具、長流程)。

    在專案結構上,你會看到類似:

    agents-project/
      skills/
        bigquery_query.yaml
        github_review.yaml
      agents/
        data-pipeline-agent.yaml
        support-agent.yaml
      workflows/
        nightly-etl.yaml
        release-checklist.yaml
      envs/
        dev.yaml
        prod.yaml
    

    Skill 定義了 輸入/輸出 schema、實體執行位置(Cloud Run URL / Pub/Sub topic)、權限需求;Agent 則描述 使用的 LLM(如:Vertex AI Gemini)、工具列表、記憶/狀態儲存方式。

    💡 關鍵: Skill / Agent / Workflow 三層抽象,讓複雜代理系統可以用清晰結構拆開管理與維護。


    2. 本地開發到雲端部署的標準流程

    在 CLI 層面,agents-cli 抽象出一條典型路徑:

    1. 本地定義與模擬:用 YAML/JSON 定義 Skill、Agent,使用 agents run 在本地模擬工作流。
    2. 雲端資源生成:使用 agents deploy 把設定轉成 Cloud Run / Pub/Sub / Vertex AI 的組合。
    3. 可觀測性與評估:透過內建 trace/log,或串接類似 LangSmith 的觀測平台,監控 LLM 行為與成本。

    常見指令會長這樣:

    # 初始化專案
    agents init my-enterprise-agent
    
    # 本地跑某個工作流
    agents run workflows/nightly-etl.yaml --env envs/dev.yaml
    
    # 部署到 Google Cloud
    agents deploy --env envs/prod.yaml \
      --project my-gcp-project \
      --region asia-east1
    
    # 檢查部署狀態
    agents status --project my-gcp-project
    

    env 的 YAML 會綁定 GCP 專案、Region、Service Account 等環境設定,讓同一套 Agent 設定可以跨 dev/stage/prod 運行。


    3. 多工具調用、狀態與長任務管理

    agents-cli 的工作流設計,基本上幫你處理三件事:

    • 多工具選擇與調度:LLM 透過工具描述(tool schema)和系統 prompt,決定當前步驟要用哪個 Skill。
    • 狀態記錄:把每步執行的輸入、輸出與決策 trace 下來,存到 Cloud Logging / BigQuery / 自訂 DB。
    • 長任務處理:用 Pub/Sub + Cloud Run 做非同步排程、重試、錯誤恢復。

    典型的 Skill 設定示例:

    # skills/bigquery_query.yaml
    name: bigquery_query
    runtime: cloud_run
    endpoint: https://bigquery-run-service-xxxx.run.app/query
    input_schema:
      type: object
      properties:
        sql:
          type: string
        dataset:
          type: string
    output_schema:
      type: object
      properties:
        rows:
          type: array
          items:
            type: object
    retry_policy:
      max_attempts: 3
      backoff_seconds: 30
    logging:
      enabled: true
      sink: bigquery
    

    在 Agent 設定中會引用這個 Skill:

    # agents/data-pipeline-agent.yaml
    name: data-pipeline-agent
    model: vertex_ai_gemini_1_5_pro
    system_prompt: |
      你是資料工程代理,負責每日 ETL 任務。
      嚴格遵守工具輸入/輸出 schema,錯誤時優先重試或回報。
    skills:
      - bigquery_query
      - gcs_file_writer
    state_store:
      type: firestore
      collection: agent_states
    

    Workflow 則決定觸發方式:

    # workflows/nightly-etl.yaml
    name: nightly-etl
    agent: data-pipeline-agent
    trigger:
      type: schedule
      cron: "0 2 * * *"  # 每天 02:00
    initial_input:
      task: "跑昨日訂單 ETL,更新匯總表"
    error_handling:
      notify:
        type: pubsub
        topic: agent-errors
      retry:
        max_attempts: 2
        delay_seconds: 300
    

    這樣一來,長任務會由排程觸發 Pub/Sub,交給 Cloud Run 上的 Agent runtime 處理;錯誤時有自動重試與告警管道,不用自己寫排程器和重試邏輯。

    💡 關鍵: 透過 retry 與 error_handling 設定,長任務可以安全自動重試並告警,而不用額外寫排程與錯誤恢復程式。


    4. 把 Agent 當「基礎設施」接入 CI/CD

    agents-cli 的另一個實用點是:部署過程本身就長得像 infra-as-code,非常適合放進 GitHub Actions 或 GitLab CI。

    以 GitHub Actions 為例:

    # .github/workflows/deploy-agent.yaml
    name: Deploy Agents
    
    on:
      push:
        branches: [ main ]
        paths:
          - "agents/**"
          - "skills/**"
          - "workflows/**"
    
    jobs:
      deploy:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v4
          - name: Setup gcloud
            uses: google-github-actions/setup-gcloud@v2
            with:
              project_id: ${{ secrets.GCP_PROJECT_ID }}
              service_account_key: ${{ secrets.GCP_SA_KEY }}
          - name: Install agents-cli
            run: pip install agents-cli
          - name: Deploy agents
            run: |
              agents deploy \
                --env envs/prod.yaml \
                --project ${{ secrets.GCP_PROJECT_ID }} \
                --region asia-east1
    

    這樣做的好處:

    • Agent 配置版本化,每次改動都有 commit 與審查。
    • 部署流程可審核、可回滾,適合安全與合規要求(尤其是醫療、金融領域)。
    • 搭配類似 Gemini Spark Workflow 的設計理念,可以明確設定 Agent 何時啟動、何種操作需要人工確認。

    實作範例

    1. 資料管線自動化(ETL / 報表)

    場景:每天需要從 BigQuery 拉數據、轉換後寫回 GCS 或更新 Looker 報表。

    Skill 組合:

    • bigquery_query:查詢資料
    • gcs_file_writer:寫檔到 Cloud Storage
    • report_notifier:透過 Pub/Sub 通知 BI 團隊或觸發下游流程

    Workflow 配置重點:

    • 用 schedule 觸發,搭配 錯誤告警 Pub/Sub topic。
    • 在 Agent prompt 中明確要求:遇到資料不完整先記錄再通知,不要靜默失敗。

    2. 內部客服流程

    場景:員工在內部系統丟 ticket,Agent 自動分類、查 FAQ、串 Jira / ServiceNow 建單。

    Skill 組合:

    • faq_search(Vertex AI + 自家向量 DB)
    • ticket_creator(Cloud Run microservice)
    • slack_notifier

    設計重點:

    • 參考 Gemini Spark 的模式:重大操作(例如關閉工單)要經過使用者確認,在 Agent prompt 裡要求先生成「建議動作」,再透過 notifier skill 要求人工點擊確認。
    • 用 state_store 記錄每個 ticket 的處理歷史,方便審計。

    3. 自動 Code Review/Release Checklist

    場景:PR 建立後,由 Agent 自動跑靜態檢查、變更摘要與 release checklist,最後用評論回寫到 GitHub。

    Skill 組合:

    • repo_diff_reader:抓取 PR diff
    • static_analyzer:呼叫現有 lint / SAST 工具
    • github_commenter:寫回 GitHub PR 留言

    Workflow:

    # workflows/release-checklist.yaml
    name: release-checklist
    agent: release-agent
    trigger:
      type: webhook
      source: github
      event: pull_request
    initial_input:
      task: "分析這個 PR 的風險、受影響模組與 release checklist"
    

    好處:

    • 把原本散落在 CI pipeline 的檢查整合,由 Agent 產出有脈絡的總結與建議。
    • 透過多 Skill 組合(lint、測試結果、變更摘要),降低 reviewer 的認知負擔。

    建議與注意事項

    1. IAM / Service Account 權限邊界

    常見坑:

    • 把整個 Agent runtime 綁一個 過度授權的 Service Account,導致 Agent 有權限操作所有 GCP 資源。

    建議:

    • 每個 Skill 使用 專用 Service Account,並在 YAML 中註記:
    security:
      service_account: bigquery-reader-sa@project.iam.gserviceaccount.com
      iam_roles:
        - roles/bigquery.dataViewer
    
    • 用 VPC Service Controls / 資料邊界 設計出「有邊界的代理」,敏感資料必須經人工確認技能(如 human_approval)才能存取。

    2. 成本與 LLM 調用暴衝

    長流程 + 多工具,很容易引起:

    • 太多決策回合(多次 model 呼叫)。
    • 錯誤重試導致費用倍增。

    最佳實踐:

    • 為 Agent 設定 max_steps / max_tokens:
    execution_limits:
      max_steps: 20
      max_model_calls: 10
      max_tokens_per_call: 8000
    
    • 用 成本監控儀表板:把 trace 寫到 BigQuery,做月度成本分析。
    • 對純查詢型任務,考慮簡化:少用思維鏈、多用工具直接查資料。

    💡 關鍵: 透過 execution_limits 和成本監控,把多步驟、多工具的代理流程費用控制在可預期範圍。

    3. 錯誤恢復與重試策略

    不要把「重試」交給 LLM 自己想。使用 agents-cli 的 retry_policy 與 error_handling 明確設定:

    • 對 idempotent 的 Skill(如查詢、讀檔)可以多次重試。
    • 對非 idempotent 操作(如寫入、付款)要先寫審計 log,再由人處理重試。

    結合 LangSmith 類型的觀測工具:

    • 對每次錯誤 trace 下來,標記是「工具錯誤」還是「LLM 誤用工具」,方便調整 prompt 或工具設計。

    4. Agent 邊界與隱私風險

    實務上最容易被忽略的是:Agent 存取範圍默默變大。

    控制方法:

    • 在 Agent 的 system_prompt 明確寫出:哪些資料不可存取/不得持久化。
    • 用 Skill 層的邊界實作:敏感操作一律透過 human_approval skill,例如:
    # skills/human_approval.yaml
    name: human_approval
    runtime: pubsub
    topic: approval-requests
    required_for_actions:
      - "刪除資料"
      - "發送外部郵件"
    
    • 參考 HIPAA Voice Agent 的做法:敏感資料永不出邊界,必要時用本地模型或受控環境中的 Vertex AI。

    結論:agents-cli 把「AI 代理」拉回工程實務的語境——YAML 設定、CLI 部署、IAM 邊界、觀測與成本控制。如果你已經有一堆工具和 LLM 能力,但遲遲不能在企業落地成正式工作流,這套工具很適合直接試著把現有程式包成 Skill,從一個小型工作流開始,把 Agent 當作基礎設施來運維。

    🚀 你現在可以做的事

    • 在現有專案中列出 3–5 個常用服務,草擬對應的 Skill YAML 定義
    • 使用 agents init 建立試驗專案,先在本地用 agents run 模擬一條簡單工作流
    • 把這條工作流接入 GitHub Actions 或 GitLab CI,測試以 infra-as-code 管理 Agent 部署與更新
  • Plurality:在家自架你的 AI 中控台

    Plurality:在家自架你的 AI 中控台

    📌 本文重點

    • Plurality 是本地可自架的 AI 中控台
    • 同一介面整合聊天、腳本自動化與多代理協作
    • 透過沙盒與 MCP 打造安全可控的 AI Runbook 系統

    一句話定位:Plurality 是一個裝在你自己電腦或局域網裡的 AI 中控台,用同一個介面處理聊天、腳本自動化和多代理協作,而且完全開源、可本地部署。

    專案連結:https://github.com/azukaar/plurality (建議邊看文邊打開)


    核心功能:把「聊天 + 自動化 + 安全執行」塞進一個面板

    1. 一個介面同時管「聊天」和「背景自動化」

    Plurality 的定位很像「你自己架的 Slack + Jira + Runbook 執行器」,但全部交給 AI 來動。

    你可以在同一個 Web 介面裡:

    • 和 AI 助理聊天
    • 建立長期存在的 Agent(例如「專案助手」「報表助手」)
    • 為每個 Agent 配好自動化流程(Automation Flow),讓它在背景持續跑

    你可以這樣用:

    • 先在 Plurality 裡創一個「專案助理」Agent
    • 在聊天裡下達指令:「幫我建立一個每日 build 檢查流程」
    • 再把這段需求轉成 automation flow:每天定時跑腳本、整理結果、回報到同一個對話 Thread

    實際效果:你不再需要切來切去——一樣是在「跟 AI 聊天」,但對話可以變成「可重複、自動執行的任務」。

    💡 關鍵: 將常用對話轉成 automation flow,可把「會話」變成每天自動跑的固定任務,減少大量手動重複操作。

    行動建議:想像一下你現在最常對 ChatGPT 說的其中一件事(例如「整理日報」「幫我跑某個腳本」),這會是你在 Plurality 裡第一個要做成 Automation 的任務。


    2. 安全的 CLI + 檔案系統沙盒

    Plurality 支援讓代理在「沙盒環境」裡跑 CLI 命令、操作檔案,但重點是:

    • 可控制範圍:你可以只把某個專案資料夾掛載給該 Agent
    • 可審核:代理要執行敏感命令前,可以設成需要你點擊確認
    • 可記錄:所有命令和檔案操作都在介面裡看得到 log

    這意味著:

    • 開發者可以讓 Agent 幫忙跑測試、打包、整理 log
    • 知識工作者可以讓 Agent 在限定資料夾裡整理檔案、產出報告
    • 家用伺服器使用者可以讓 Agent 只碰 backup 資料夾,不碰其他東西

    你可以這樣設定:

    1. 在 Plurality 的設定中,新增一個「Project」或「Workspace」
    2. 把 /home/你/某個專案 或 NAS 的某個共享資料夾掛載給這個 Workspace
    3. 建立 Agent 並指定它只能使用這個 Workspace
    4. 開啟「命令前需要確認」(如果你怕它亂改東西)

    行動建議:先選一個「就算搞壞也不會心痛」的資料夾,當作 Agent 測試用沙盒,把 CLI 操作和檔案操作都限制在這裡。


    3. 搭配 MCP、多代理協作,變成你的「個人 Jira + Runbook 執行器」

    Plurality 支援 MCP(Model Context Protocol)等多代理協作生態,你可以把它當成一個統一入口,接上:

    • 不同工具的 MCP 伺服器(例如資料庫查詢、Issue 管理、監控系統)
    • 多個 Agent 各自負責不同任務

    用白話來說:

    • 「像 Jira 一樣」:你可以把每個自動化流程當成一個 Ticket / 任務
    • 「像 Runbook 一樣」:每個任務裡,是具體的步驟(腳本、API調用、檔案處理)
    • Plurality 的 Agent 負責:讀任務 → 選工具 → 執行 → 回報結果

    實際用法例子:

    • 一個「監控 Agent」:定時讀監控 API → 判斷是否異常 → 若異常就呼叫「Runbook Agent」
    • 「Runbook Agent」:按你寫好的流程,連線伺服器、跑腳本、紀錄在一個對話 Thread 裡

    行動建議:先想一個你現在「寫在 Notion / Wiki 的 Runbook」,例如「網站掛掉怎麼檢查」,把它拆成步驟,交給 Plurality Agent 來執行一次看看。


    適合誰用?三個具體場景

    1. 開發者:用 Plurality 管專案腳本

    適合這樣的人:

    • 手上有一堆 npm script / Makefile / shell script
    • 常常要:跑測試、打包、部署、整理 log

    實際流程可以長這樣:

    • 在 Plurality 裡建立一個「專案 Dev Agent」
    • 掛載你的專案資料夾(例如 /projects/my-app)
    • 讓 Agent:
    • 用 CLI 跑 npm test,把錯誤訊息整理貼回聊天
    • 根據你的指示修改設定檔或產出新腳本(在沙盒裡)
    • 定時跑 lint + test 並生成報告

    你每天要做的事情,就變成:開 Plurality → 問「今天 CI 有沒有紅?」→ 讓 Agent 調出 log 給你看。

    💡 關鍵: 讓 Agent 接管 npm test、lint 等例行腳本,可把日常 CI/開發檢查集中在單一對話介面完成。


    2. 知識工作者:整理檔案 + 做定時報告

    適合這樣的人:

    • 每週要交固定報告(營運簡報、數據摘要、內容整理)
    • 桌面 / NAS 上堆滿 PDF、Word、報表 CSV

    你可以這樣設計一個 Agent:

    • 掛載「報表資料夾」給它(例如 Reports/Weekly)
    • 每天或每週固定時間:
    • 掃描新檔案
    • 自動分類命名(根據檔名、內容)
    • 生成一份文字摘要(例如本週營運重點、會議紀錄整理)
    • 寄出 Email 或貼到公司內網

    整套流程變成:你只要把資料丟進資料夾,其它交給 Plurality。


    3. 自架家用伺服器:備份 + 監控

    如果你有自己的 NAS 或家用伺服器(例如和 Livinity 這種 homeserver OS 類似的架構),Plurality 很適合當成「AI 管家」。

    可以做的事情:

    • 每天半夜:
    • 檢查共享資料夾是否有新檔
    • 壓縮後備份到另一顆硬碟或雲端
    • 寫 log + 總結備份結果
    • 每小時:
    • 跑監控腳本(例如檢查 Docker 容器、硬碟空間)
    • 若異常,透過 Email / Telegram 通知你

    這些都可以用 Plurality 的 automation flow + CLI 沙盒來完成,而且所有設定都留在你自己的網路裡。

    💡 關鍵: 把備份與監控自動化放進局域網,能在不依賴外部服務的前提下,建立可審計又可控的「AI 管家」流程。


    15 分鐘入門:從 clone 到第一個 Automation Flow

    下面用一個具體目標來帶你:每天抓 RSS → 總結 → 寄信。

    步驟 0:準備環境(2 分鐘)

    需求:

    • 一台可以跑 Docker 的機器(你的電腦、NAS 或家用伺服器)
    • 至少一個可用的模型:
    • 本地:Ollama / LM Studio / 其他本地 LLM 伺服器
    • 雲端:OpenAI / Claude 等(有 API key)

    行動:先確認你有 Docker 和一個模型 API(或已裝好 Ollama)。


    步驟 1:拉 GitHub repo + 啟動(5 分鐘)

    1. 開啟 GitHub 專案:https://github.com/azukaar/plurality
    2. 在你的機器上:
    git clone https://github.com/azukaar/plurality
    cd plurality
    
    1. 使用 Docker(以官方 README 為準,但大致會是):
    docker compose up -d
    
    1. 打開瀏覽器,進入 http://你的機器 IP:PORT(通常 README 會寫預設 port)

    行動:先確認你能看到 Plurality 的 Web 介面,並完成初次設定帳號。


    步驟 2:連上本地或雲端模型(3 分鐘)

    在 Plurality 介面的設定裡(通常是「Models」「LLM Providers」之類):

    • 如果你用本地模型(例如 Ollama):
    • 填入 Ollama 的 URL(例如 http://host.docker.internal:11434)
    • 選一個模型(llama3 等)
    • 如果你用雲端模型:
    • 選 OpenAI / Anthropic 等
    • 貼入 API key

    接著:

    • 建立一個「預設 Agent」
    • 開一個新聊天,隨便問一個問題,確認模型回應正常

    行動:測一次聊天,確定模型接上沒問題,再往下做自動化。


    步驟 3:設定第一個 Automation Flow:RSS → 總結 → 寄信(5 分鐘)

    以概念步驟為主,實際操作依 Plurality 當前 UI 為準(版本更新可能略有差異):

    1. 建立一個 Agent(例如叫 RSS Reporter):
    2. 權限:允許網路請求(抓 RSS)
    3. 若需要寄信,先在設定裡填好 SMTP 或 Webhook(視官方檔案支援的方式)

    4. 建立 Automation Flow:

    5. 觸發條件:每日某個時間(例如 09:00)
    6. 步驟設計(可用自然語言描述給 Agent,再微調):

      1. 抓取指定 RSS(例如科技新聞、公司部落格)
      2. 解析最近 24 小時的新文章
      3. 用模型生成摘要:
        • 列出 3-5 則重點
        • 每則一段話說明「為什麼重要」
      4. 把摘要整理成一封 Email 內容
      5. 呼叫 SMTP/Email 工具寄給你
    7. 測試一次:

    8. 不用等明天,先在介面裡手動 Run 這個 Flow
    9. 檢查 log 和 Email 是否如預期

    行動:先用你最常看的其中一個 RSS 做範例,例如你公司部落格或常看的技術網站。


    小結:把「雜事」搬進你自己的局域網裡

    Plurality 的核心價值在於:

    • 一個介面聚合聊天 + 自動化 + 多代理
    • 可以讓 AI 真正「動手」跑 CLI、操作檔案,但仍在你可控的沙盒裡
    • 搭配 MCP、多代理協作,把原本散在各處的腳本、Runbook 和任務,集中到一個你自己掌控的中控台

    如果你本來就有自架 NAS、家用伺服器,或公司內網伺服器,Plurality 很適合直接變成「AI 操作台」;如果你只是想找個比 ChatGPT 更能「實際做事」的工具,也可以先在自己電腦上跑一個 Plurality,從那個 RSS → 總結 → 寄信的 Flow 開始。

    下一步行動:打開 https://github.com/azukaar/plurality,照本文的 15 分鐘流程做出你的第一個 Automation Flow,之後再慢慢把日常重複工作移進去。

    🚀 你現在可以做的事

    • 打開 Plurality 專案頁,用 git clone 把專案拉到本機或 NAS
    • 準備好一個可用模型(例如設定好 Ollama 或貼入 OpenAI / Claude API key),完成第一次聊天測試
    • 挑一個你每天重複做的流程(如 RSS 摘要、報表整理),在 Plurality 裡實作成第一個 Automation Flow
  • OmniRoute:一個 Endpoint 玩遍 200+ 模型

    OmniRoute:一個 Endpoint 玩遍 200+ 模型

    📌 本文重點

    • OmniRoute 用一個 Endpoint 串接 200+ 模型供應商
    • 內建 RTK + Caveman 壓縮,可節省 15–95% token 成本
    • 支援 MCP / A2A、多代理、多模態 Workflow
    • 適合多模型整合與成本優化的開發者

    用一句話先說清楚:OmniRoute 是一個多雲、多模型的一站式 AI 總機,讓你用同一個 API Endpoint,同時接上 Claude、GPT、Cursor、Copilot 等 200+ 家模型供應商,還順手幫你壓縮 token、自動跳備援模型。

    官方開源庫:https://github.com/diegosouzapw/OmniRoute


    核心功能 1:一個 Endpoint 管理多供應商+自動備援

    傳統做法是:每接一個模型,就要再接一個 SDK / API Key / Base URL。結果是:

    • 前端要切換模型,就得改環境變數
    • 後端要做 fallback,要自己寫 retry + 陣痛的錯誤處理

    OmniRoute 的做法是:所有模型統一走一個 OmniRoute Endpoint,後面怎麼分流、切換供應商、失敗改用誰,全都在 OmniRoute 的設定檔完成。

    💡 關鍵: 把所有模型統一進一個 Endpoint,可以一次解決多家供應商整合與備援問題,前後端只維護單一接點。

    你可以怎麼用

    以「同一個 Code Agent,要能在 Claude / GPT / 本地模型之間切換」為例:

    1. 在 OmniRoute 設定三個 provider:
    2. anthropic/claude-3.5(主力)
    3. openai/gpt-4.1(備援)
    4. local/deepseek(成本最低版)
    5. 設定路由策略:
    6. 主 Endpoint:先走 Claude
    7. 當 Claude timeout 或額度用完,自動 fallback 到 GPT
    8. 夜間批量任務改走本地模型
    9. 在你的程式碼中,只保留一個 OMNIROUTE_API_URL:

    ts
    const response = await fetch(process.env.OMNIROUTE_API_URL, {
    method: "POST",
    headers: {
    "Content-Type": "application/json",
    "Authorization": `Bearer ${process.env.OMNIROUTE_API_KEY}`,
    },
    body: JSON.stringify({
    model: "code-agent", // 這是 OmniRoute 裡定義的邏輯模型名
    messages,
    }),
    });

    可行動建議:

    • 手上的專案如果同時接了 Anthropic + OpenAI + 本地模型,可以先挑一個 API Call 練手,把三個 Base URL 改成一個 OmniRoute URL,測試 auto-fallback 是否生效。

    核心功能 2:RTK + Caveman 壓縮,節省 15–95% token 成本

    OmniRoute 內建兩種壓縮:

    • RTK(Reversible Tokenization Kernel):對常見 prompt 做結構化壓縮,適合長系統提示、多輪聊天歷史
    • Caveman 壓縮:偏「野蠻」但更激進,會重寫聊天記錄,把冗長表述變成精簡語句

    效果:

    • 系統長 prompt:省 15–40% token
    • 帶大量上下文(如文檔 QA):最高可到 95% token 減少

    💡 關鍵: 啟用 RTK 與 Caveman 壓縮後,長上下文任務可大幅降低 15–95% token 成本,直接反映在帳單與模型限額上。

    你可以怎麼用

    以「把整份 API 文檔塞給模型當『長期記憶』」為例:

    1. 在 OmniRoute 後台或設定檔,為 doc-assistant 這條路由開啟壓縮:

    yaml
    routes:
    - id: doc-assistant
    model: anthropic/claude-3.5
    compression:
    rtk: true
    caveman: true

    1. 程式端依然用原本的 messages 結構呼叫,不用自己壓縮:

    jsonc
    {
    "model": "doc-assistant",
    "messages": [
    {"role": "system", "content": "你是某某專案的文檔助手..."},
    {"role": "user", "content": "請根據附件 API 文檔..."}
    ]
    }

    1. OmniRoute 會在轉給底層模型前自動壓縮,再在輸出時解壓(對你來說是透明的)。

    可行動建議:

    • 先挑「最長」的那支 API(例如:聊天歷史超長、帶多篇 PDF 的 QA),在 OmniRoute 上開 RTK+獵人模式(Caveman),觀察一次請求的 token 使用量與帳單變化。

    核心功能 3:MCP / A2A、多代理、多模態 Workflow

    OmniRoute 支援:

    • MCP(Model Context Protocol):讓不同工具 / 代理共享同一套上下文與工具列表
    • A2A(Agent-to-Agent):代理之間可互相呼叫,形成多步驟協作
    • 多模態 API:文字 + 圖片(甚至影音)混合輸入

    這讓你可以把原本散落在不同工具的能力,集中到一條 Workflow 裡。例如:

    • Code Agent 負責寫程式
    • Doc Agent 負責查文件、對比版本
    • Vision Agent 負責讀錯誤截圖

    💡 關鍵: 利用 MCP 與 A2A,可以把多個專職 Agent 串成一條 Workflow,讓 Code、Doc、Vision 等能力在同一上下文中協作。

    你可以怎麼用

    以「Side Project 的 Code Agent + 文檔助手」為例:

    • Code Agent:
    • 模型:Claude 3.5 Sonnet
    • 任務:生成程式碼、重構
    • 文檔助手:
    • 模型:GPT-4.1 / Gemini
    • 任務:閱讀 API 文檔、產生說明
    • 多模態:
    • 模型:如 Gemini / GPT-4o
    • 任務:讀錯誤截圖

    在 OmniRoute 裡定義三條路由,讓 Code Agent 能直接「轉接」給 Doc Agent:

    routes:
      - id: code-agent
        model: anthropic/claude-3.5
        a2a:
          doc-agent: true
          vision-agent: true
      - id: doc-agent
        model: openai/gpt-4.1
      - id: vision-agent
        model: google/gemini-1.5
    

    可行動建議:

    • 先只做兩個代理(Code + Doc),在 OmniRoute 設定 A2A,讓 Code Agent 遇到「不知道 API 用法」時,把問題轉給 Doc Agent,再把結果回傳給使用者。

    實作示範:Side Project 串三家模型的 Code Agent + 文檔助手

    來做一個具體場景:

    需求:在同一個 Side Project 裡,整合三家模型,做一個簡單的「程式碼助理 + 文檔助手」,前端只有一個 Chat UI,後端只有一個 OmniRoute Endpoint。

    架構示意

    • 前端(Next.js / React):
    • 單一聊天框
    • 輸入模式按鈕:寫程式 / 問文檔
    • 後端:
    • 全部請求送到 OMNIROUTE_URL
    • model 欄位用來指定走哪個 logical route(code-agent or doc-assistant)
    • OmniRoute:
    • code-agent → Claude(主)+ GPT(備)
    • doc-assistant → GPT + Caveman 壓縮
    • vision-agent → Gemini,多模態

    前端呼叫範例(TypeScript):

    async function callAgent(mode: "code" | "doc", messages) {
      const model = mode === "code" ? "code-agent" : "doc-assistant";
    
      const resp = await fetch(process.env.NEXT_PUBLIC_OMNIROUTE_URL!, {
        method: "POST",
        headers: {
          "Content-Type": "application/json",
          Authorization: `Bearer ${process.env.NEXT_PUBLIC_OMNIROUTE_KEY}`,
        },
        body: JSON.stringify({ model, messages }),
      });
    
      return resp.json();
    }
    

    後端與前端都不用知道「底下到底是 Claude 還是 GPT」,只認 model: "code-agent" 與 model: "doc-assistant" 兩種邏輯角色即可。


    10 分鐘開箱:從零到第一條 OmniRoute

    以下是一條「最短路徑」,讓你在 10 分鐘內把現有專案換成 OmniRoute。

    1. 註冊與安裝(3 分鐘)

    1. 打開 GitHub 專案:https://github.com/diegosouzapw/OmniRoute
    2. 把 repo 拉下來:

    bash
    git clone https://github.com/diegosouzapw/OmniRoute
    cd OmniRoute
    pnpm install # 或 yarn / npm

    1. 照 README 建一個 .env,填入你現有的 OpenAI / Anthropic 等 API Key。

    2. 啟動 OmniRoute Server(2 分鐘)

    pnpm dev # 或對應的 start 指令
    

    啟動後會有一個本地 URL,例如:http://localhost:8787/v1/chat/completions,這就是你的「總機 Endpoint」。

    3. 設定第一個路由 + 壓縮策略(3 分鐘)

    在 config/routes.yaml(實際以專案為準)中:

    routes:
      - id: code-agent
        model: anthropic/claude-3.5
        fallback:
          - openai/gpt-4.1
        compression:
          rtk: true
          caveman: false
    
      - id: doc-assistant
        model: openai/gpt-4.1
        compression:
          rtk: true
          caveman: true
    

    完成後重新啟動 OmniRoute(若需要)。

    4. 把前端 / 後端改成單一 OmniRoute URL(2 分鐘)

    無論你原本用什麼 SDK(OpenAI, Anthropic, Cursor plugin):

    • 把 baseURL 改成你的 OMNIROUTE_URL
    • 把 model 改成 OmniRoute 裡定義的 id(例如 code-agent)

    以 OpenAI SDK 為例:

    import OpenAI from "openai";
    
    const client = new OpenAI({
      baseURL: process.env.OMNIROUTE_URL,
      apiKey: process.env.OMNIROUTE_KEY,
    });
    
    await client.chat.completions.create({
      model: "code-agent",
      messages,
    });
    

    到這一步,你已經:

    • 用一個 Endpoint 串起至少兩家模型
    • 開啟 basic 的 token 壓縮
    • 為之後加上更多 provider / 代理 / 模態預留位置

    適合誰用?

    使用者類型 具體場景
    獨立開發者 Side Project 同時想用 Claude + GPT + 免費模型,又懶得寫一堆整合
    小團隊 / Startups 想 A/B 測試不同供應商,控制成本,還要有 auto-fallback 防止掛點
    AI Agent Builder 需要多代理協作(Code + Doc + Vision),又希望前端只接一個 Endpoint
    教學 / 實驗環境 需要一鍵切換教學用模型、控制學生 token 使用量

    如果你符合其中一項,可以先把 OmniRoute 當成:

    「把所有 AI 模型集中管理的一支 API Gateway」,再視需要逐步開啟壓縮、A2A、多模態。


    OmniRoute 與其他多模型工具比較

    名稱 核心功能 免費方案 適合誰
    OmniRoute 多供應商整合、auto-fallback、RTK/Caveman 壓縮、MCP/A2A、多模態 開源,支援 50+ 免費供應商 想統一管理多家模型、做複雜 Workflow 的開發者
    直接用 OpenAI 單供應商模型 API 有免費試用額度 只用 GPT 系列、需求簡單的專案
    直接用 Anthropic 單供應商 Claude 模型 有免費試用額度 只想專注 Claude Code / Sonnet

    如果你只接一個模型供應商,OmniRoute 可以先當「統一壓縮 + 路由層」;當你的模型越來越多,它就自然變成你的多雲總機。


    🚀 你現在可以做的事

    • 打開 OmniRoute GitHub 專案,依照 README 在本地啟動一個測試伺服器
    • 挑一支現有的 API 呼叫,將 baseURL 改成 OMNIROUTE_URL,並在 routes.yaml 設好對應的 model id
    • 在同一條路由上開啟 RTK 或 Caveman 壓縮,對比啟用前後的 token 使用量與費用差異