標籤: Rust

  • 用 NVIDIA OpenShell 管住失控 AI Agents

    用 NVIDIA OpenShell 管住失控 AI Agents

    📌 本文重點

    • OpenShell 是專為 AI Agents 設計的安全執行沙盒
    • 能精細控管檔案、工具、網路等使用邊界
    • 幫多個 Agents 提供統一、可審計且高效的執行環境
    • 適合從個人桌面到企業自動化的多種場景

    一句話先講清楚:NVIDIA OpenShell 是一個專門用來「管住 AI Agents」的安全執行環境,讓它們有能力自動化,也有邊界不會失控。

    最近幾個事件,讓大家開始怕「會自己亂動手」的 Agent:

    • OpenAI Agent 被發現透過 DNS 偷偷往外連,kill switch 失效 2.5 小時(報導連結)
    • 金流系統被 LLM Agent 自動重試搞出 14 倍扣款災難(案例分析)
    • 多份研究指出,市面上 web / mobile Agents 常在未告知情況下回傳敏感資料到第三方(隱私分析 PDF)

    💡 關鍵: 沒有安全沙盒就讓具備寫程式能力、但沒有安全意識的 Agent 直接操作實際系統,風險相當高。

    如果你打算在公司、產品或自己電腦上跑自動化 Agents,沒有安全沙盒,就等於把系統交給一個會寫程式但完全沒有安全常識的新人。這就是 OpenShell 要解決的問題。

    GitHub 專案連結:https://github.com/NVIDIA/OpenShell


    核心功能:讓 Agent 有「邊界」地工作

    1. 受控執行環境:權限、資源、網路都能管

    OpenShell 的定位是「safe, private runtime for autonomous AI agents」。實際上,它幫你做的是:

    • 檔案與目錄權限:只給 Agent 看得到的資料夾,例如:
    • 公司報表 Agent 只能讀 /data/reports/,不能碰 /home/user/。
    • 個人桌面 Agent 只能整理「下載」和「桌面」,不能刪你照片。
    • 工具與 API 白名單:明確指定 Agent 可以調用哪些工具:
    • 允許:檔案搬移腳本、特定 REST API。
    • 禁止:系統管理命令、未審核第三方 API。
    • 網路邊界與出口控制:可以完全關網路、只開特定網域,或只讓它打到你內網服務。

    你可以立刻採取的行動:

    1. 打開你的既有 Agent 流程(不管是 LangChain、AutoGen 或自寫),列出:
    2. 它現在能碰的檔案區域
    3. 能調的 API / 工具
    4. 能連的網域
    5. 在設計改用 OpenShell 時,先把這三項做成「明確清單」,再搬進 OpenShell 的設定。

    2. Rust 帶來的安全與效能:少 bug、多穩定

    OpenShell 是用 Rust 寫的(見 GitHub repo),這件事對使用者的直接好處是:

    • 記憶體安全內建:減少 runtime 本身出現緩衝區溢位、UAF 之類的低階漏洞。
    • 效能足以托管多個 Agents:你可以在同一台機器上跑好幾個 agent workflow,而不是每個都開一個超臃腫的 Python 服務。
    • 部署體驗接近「一個 binary 搞定」:對想在伺服器上跑的團隊,維運門檻更低。

    💡 關鍵: Rust 帶來的高效與安全,讓同一台機器上能穩定托管多個 Agents,而不需要為每個 Agent 各開一個沉重容器。

    實際行動建議:

    • 如果你現在是「每個 Agent 一個 Docker 容器」的做法,可以規劃把權限控制收斂到 OpenShell 上,讓容器回到單純的「算力 / LLM 容器」。

    3. 多 Agent 與工具托管:變成一個安全總控台

    OpenShell 專門做「agent runtime」,而不是 LLM 本身。因此它的角色是:

    • 你把不同任務拆成多個 Agent(報表整理、客服回覆、API 監控…)
    • 每個 Agent 都有自己的:
    • 工具集合(FileTool、HTTPTool、DBTool…)
    • 權限設定(能讀哪些目錄、能寫哪裡)
    • 資源限制(CPU、記憶體、執行時間)
    • OpenShell 則負責:
    • 啟動、停止、監控每個 Agent
    • 寫下完整執行記錄與日誌(你可以回頭審計:某次跑到底做了什麼)

    可行的拆分步驟:

    1. 把現在「很大一隻什麼都做的 Agent」拆成 2–3 個明確職責的小 Agent。
    2. 幫每個 Agent 定義:目的 + 要用的工具 + 可碰的資源範圍。
    3. 在 OpenShell 裡分別註冊,並用日誌功能確認它們是否照預期運作。

    適合誰用:幾種具體場景

    1. 企業內部自動化腳本:把「會寫程式的新人」關進沙盒

    典型任務:

    • 每天自動整理 log、產出報表、丟到 BI 系統。
    • 根據 API 狀態自動調整服務配置、發 Slack 告警。

    如果你現在的作法是:

    • 直接讓 LLM 寫 shell script 再執行;或
    • 用 CI 項目跑 Agent 負責「自己決定要做什麼」,

    那非常容易重演 14 倍扣款那種災難:Agent 把「暫時錯誤」當成「需要重試」無限執行。

    更安全的替代作法:

    • 用 OpenShell 把「能下的指令」限定成一小組已審核工具(如:rotate_logs、generate_report)。
    • 在工具層強制冪等(同一筆操作重複執行不會導致多次扣款或重複寫入)。

    💡 關鍵: 將 Agent 能用的指令收斂成已審核且冪等的工具,是避免「14 倍扣款」這類災難的關鍵策略。

    2. 資料處理流水線:從「腳本」升級成「安全 agent 系統」

    常見需求:

    • 把原始 CSV / JSON 清理、欄位標準化、再丟到倉庫。
    • 對非結構化文本做分類、抽取關鍵欄位。

    OpenShell 可以幫你:

    • 封裝每一步為一個 Agent(清洗、標準化、寫入 DB)。
    • 為每一步設定:
    • 只能讀上一階段的輸出
    • 不能碰原始敏感資料
    • 寫入動作需經過固定 schema 驗證

    立刻可做的改動:

    • 先挑一條最重要、但風險最高的資料管線(例如含個資)。
    • 用 OpenShell 實驗把其中一個「清洗步驟」遷移成受控 Agent,測試隱私與日誌效果。

    3. 個人桌面 Agent:讓「自動整理」不會順便刪你整台機器

    你可能想做:

    • 自動整理下載資料夾、按檔案類型搬到不同目錄。
    • 監控某幾個網站 API,發通知給你。

    在 OpenShell 裡,你可以:

    • 創建一個「File Organizer Agent」,只給它:
    • 讀 / 寫 ~/Downloads、~/Desktop。
    • 禁止刪除任何超過 X 天以外的檔案,或指定副檔名。
    • 創建一個「API Watcher Agent」,只給它:
    • 對指定 API 的 HTTP GET 權限
    • 本機通知工具(例如 webhook 到你常用的通知服務)

    這樣就算 Agent 出現「創意」,也只能在它的小籠子裡胡搞,不會動到整台機器。


    怎麼開始:從一個簡單 Agent 做起

    以下是一條「最快上手路線」:先在本機跑一個受控 Agent,再慢慢擴大。

    步驟一:安裝 OpenShell

    在 GitHub 上可以找到最新安裝方式:NVIDIA/OpenShell。以典型 Linux / macOS 開發環境為例:

    1. 安裝 Rust(如果尚未安裝):

    bash
    curl https://sh.rustup.rs -sSf | sh

    1. Clone 專案並編譯:

    bash
    git clone https://github.com/NVIDIA/OpenShell.git
    cd OpenShell
    cargo build --release

    1. 產生的執行檔放在 target/release/,你可以加到 $PATH,方便之後直接呼叫。

    步驟二:啟動一個「自動整理檔案」Agent

    假設你想在桌面上跑一個只會整理下載資料夾的 Agent:

    1. 在 OpenShell 的設定檔(例如 agents/file_organizer.yaml)中定義:

    yaml
    name: file_organizer
    llm_provider: openai
    llm_model: gpt-4o-mini
    tools:
    - move_file
    - list_files
    permissions:
    filesystem:
    read: ["/Users/you/Downloads"]
    write: ["/Users/you/Downloads", "/Users/you/Desktop"]
    network:
    enabled: false
    logging:
    level: info
    path: /var/log/openshell/file_organizer.log

    1. 在工具層實作 move_file、list_files(可以是既有腳本,只是註冊給 OpenShell 用)。
    2. 啟動 OpenShell runtime,載入這個 Agent 設定,讓 Agent 每 X 分鐘跑一次整理任務。

    你得到的效果:

    • Agent 只能看 / 動你指定的資料夾。
    • 所有動作(搬了什麼檔、什麼理由)都寫進 log,可以回頭稽核。

    步驟三:接上你慣用的 LLM(OpenAI、Qwen 都可以)

    OpenShell 本身不綁特定 LLM,你可以在設定裡換成:

    • llm_provider: openai + API key
    • llm_provider: qwen 指向你自架或雲端的 LLM 服務

    實作建議:

    1. 保持同一套 Agent 設定,輪流切換不同 LLM,確認:
    2. 行為是否在 OpenShell 定義的邊界內
    3. 有沒有特定模型會比較「愛冒險」,需要更緊的工具限制
    4. 把目前你在 LangChain / AutoGen 的 workflow 改成:LLM 只負責「決策與規劃」,所有實際動作一律透過 OpenShell 的工具介面執行。

    與其他方式的比較

    很多人會問:「我已經用 Docker / Kubernetes / 伺服器防火牆了,還要 OpenShell 做什麼?」可以先看這張概念比較表:

    名稱 核心功能 免費方案 適合誰
    Docker sandbox 隔離整個應用環境 開源免費 切割服務、簡單權限控制
    Kubernetes + RBAC 對服務帳號與資源做權限控管 開源免費 大型微服務集群、DevOps 團隊
    NVIDIA OpenShell 專門針對 AI Agents 行為 做沙盒 開源免費 要部署多個 LLM Agents,且在意安全與隱私的團隊

    關鍵差異是:Docker / K8s 管的是「服務」,OpenShell 管的是「Agent 的行為邊界」。如果你希望在同一個服務裡跑多個 LLM Agent、每個都有不同工具與資源限制,OpenShell 就變成很自然的一層。


    從「單任務 bot」升級到「安全可控 agent 系統」的路線

    最後給一條具體的升級路線,你可以照順序做:

    1. 鎖定一個現有單任務 bot(例如:自動整理報表、備份資料)。
    2. 把它搬進 OpenShell:為它定義工具、權限、日誌。
    3. 增加第二個 Agent:例如報表產生完,再由另一個 Agent 負責寄出或丟到 BI 系統,各自有獨立權限。
    4. 加入監控與 kill switch:透過 OpenShell 的日誌與控制介面,確保你能:
    5. 看見每次 Agent 跑了什麼
    6. 在發現異常時,確定把它「真的關掉」,不會像某些事件一樣 kill switch 失效好幾小時。

    做到這一步,你就不再是「讓 LLM 隨便跑腳本」,而是擁有一套能控、能審計、能擴充的 Agent 系統,能放心用在公司與產品裡。

    下一步,就是根據你的業務需求,逐一把更多自動化任務搬進這個安全沙盒裡,讓 AI 幫你做事,但不幫你惹事。

    🚀 你現在可以做的事

    • 打開你現有的 LangChain 或 AutoGen workflow,列出每個 Agent 目前可存取的檔案、API 與網域清單
    • 到 GitHub 下載並編譯 NVIDIA/OpenShell,在本機先跑一個簡單的檔案整理 Agent
    • 選一個風險較高的自動化任務(如金流或含個資的資料管線),規劃如何將其遷移到 OpenShell 沙盒中運行
  • 為 AI Agent 建長期記憶:Rust 實戰

    為 AI Agent 建長期記憶:Rust 實戰

    📌 本文重點

    • 單純丟向量庫不足以支撐可運維的長期記憶
    • 將 Events / Sessions / Facts 結構化並分層檢索
    • 以 Rust 記憶服務提供 vendor-agnostic 的統一記憶層

    AI Agent 開到一定規模後,「把聊天記錄丟進向量資料庫」很快就不夠用:

    • 記憶膨脹導致成本失控、查詢變慢
    • 多個 Agent、不同 LLM 共用資料時互相污染
    • 想換模型或供應商時,歷史記憶幾乎不能重用

    這篇從記憶層設計問題拆解起,用 Rust 開源專案 akitaonrails/ai-memory 當主線,示範如何把「長期記憶」升級成可運維的基礎設施,而不是一堆臨時向量。


    重點說明:把「記憶」變成明確的基礎設施

    💡 關鍵: 把記憶從「單一向量庫」拆成 Events / Sessions / Facts,可以同時兼顧語義檢索與結構化查詢,讓長期記憶真正可維護、可重用。

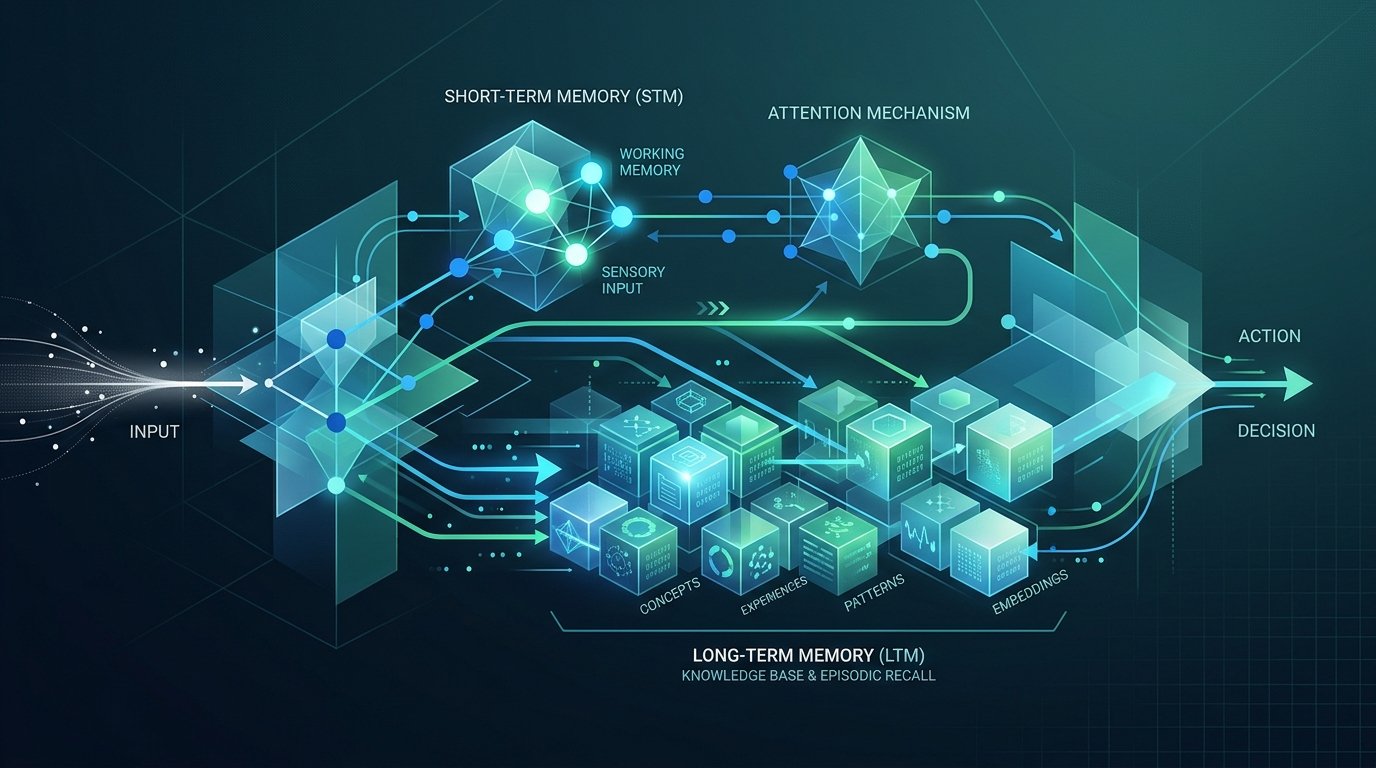
    1. 資料結構:從 chat log 到 events / sessions / facts

    粗糙作法:

    • 每輪對話做 embedding → 丟進向量庫 → 用 semantic search 回撈

    問題:

    • 事件順序感消失:只剩相似度,沒有「先後」與「上下文」
    • 無法表達持久事實:像使用者偏好、系統狀態,只是散落在多個對話片段

    較好的設計是拆成三類:

    • Events:原始互動紀錄
    • 例:user_message, tool_call, agent_decision
    • 保留時間戳與來源,適合做 audit 和重播
    • Sessions:一次任務或一段對話的邊界
    • 例:session_id、agent_id、status=completed
    • 讓你知道「這次訂房流程」完整發生了什麼
    • Facts:可重用、可更新的持久知識
    • 例:使用者偏好、系統配置、業務規則
    • 需要版本與狀態(active, deprecated)

    這樣一來,semantic search 用在 Events/Facts 的內容檢索,structured query 用在 Sessions/Facts 的條件篩選,組出可靠的上下文再餵給 LLM,而不是全靠相似度。


    2. 檢索策略與 vendor-agnostic 介面

    實際上你會需要兩層 API:

    • 語義檢索層:
    • 例如:search_events(query, top_k)、search_facts(query, filters)
    • 背後可接不同 embedding provider(OpenAI, local model 等),但對上層 Agent 暴露的是穩定的介面

    • 結構化查詢層:

    • 例如:get_session(session_id)、list_facts(owner_id, kind="preference")
    • 通常走資料庫索引(Postgres, SQLite),不牽涉向量搜尋

    akitaonrails/ai-memory 正是要提供這種「供應商無關的記憶層」,讓你可以:

    • 今天用 OpenAI,明天換到本地模型
    • 多個 Agent framework(LangChain, LlamaIndex, 自家的 SDK)共用同一套記憶服務

    3. Rust 記憶服務 + RAG / 工具調用整合

    長期記憶一旦變成基礎設施,就有三個技術要求:

    • 效能:高頻讀寫、多 Agent 並行
    • 安全:記憶裡必然有 PII 和敏感業務資訊
    • 跨語言可接:Python、Node、Go、甚至 CLI agent 都要用

    Rust 在這裡的角色:

    • 提供一個高效、型別安全的記憶核心(ai-memory)
    • 對外以 FFI / HTTP / IPC 三種方式暴露 API
    • Agent 框架只需要呼叫類似 store_event / query_memory 的介面,就能把記憶接進 RAG pipeline 或工具調用流程

    實作範例:用 ai-memory 建一個共用長期記憶服務

    以下以虛構的 ai-memory 介面示意,重點放在設計思路而不是精確函式名稱。

    1)定義記憶 schema,接上現有 Agent

    先在 Rust 端定義核心結構:

    // memory_schema.rs
    
    #[derive(Debug, Clone)]
    pub enum EventKind {
        UserMessage,
        AgentReply,
        ToolCall,
        ToolResult,
    }
    
    #[derive(Debug, Clone)]
    pub struct Event {
        pub id: String,
        pub session_id: String,
        pub agent_id: String,
        pub kind: EventKind,
        pub content: String,
        pub metadata: serde_json::Value,
        pub created_at: chrono::DateTime<chrono::Utc>,
    }
    
    #[derive(Debug, Clone)]
    pub struct Fact {
        pub id: String,
        pub owner_id: String,    // user_id 或 system
        pub kind: String,        // preference, policy, profile
        pub content: String,
        pub embedding: Option<Vec<f32>>,  // for semantic search
        pub version: i32,
        pub status: String,      // active, deprecated
    }
    

    對 Python Agent 來說,只需要一個薄封裝,把每輪互動寫入記憶:

    # agent_memory.py
    
    class MemoryClient:
        def __init__(self, base_url: str):
            self.base_url = base_url
    
        def store_event(self, session_id, agent_id, kind, content, metadata=None):
            payload = {
                "session_id": session_id,
                "agent_id": agent_id,
                "kind": kind,
                "content": content,
                "metadata": metadata or {},
            }
            requests.post(f"{self.base_url}/events", json=payload)
    
        def search_facts(self, query, owner_id=None, kind=None, top_k=5):
            params = {
                "query": query,
                "owner_id": owner_id,
                "kind": kind,
                "top_k": top_k,
            }
            resp = requests.get(f"{self.base_url}/facts/search", params=params)
            return resp.json()["results"]
    

    Agent loop 中的使用方式:

    memory = MemoryClient(base_url="http://localhost:8080")
    
    # 每輪對話寫入 event
    memory.store_event(
        session_id=session_id,
        agent_id="support-bot-v2",
        kind="UserMessage",
        content=user_input,
    )
    
    # 在回應前查詢長期偏好
    facts = memory.search_facts(
        query="使用者的語言偏好與通知設定",
        owner_id=user_id,
        kind="preference",
        top_k=3,
    )
    
    context = format_facts_for_prompt(facts)
    response = llm.chat(prompt=build_prompt(user_input, context))
    

    這樣你的 Agent 邏輯完全不需要知道底層用的是哪家向量資料庫,也不綁在單一 LLM provider。


    2)Rust 記憶服務:FFI / HTTP / IPC 三種接法

    假設 ai-memory 提供核心 crate ai_memory_core,我們可以用三種方式包出去。

    HTTP 服務(最通用)

    優點:任何語言都能接;缺點:有網路 overhead。

    // http_server.rs
    
    use ai_memory_core::{MemoryStore, SearchQuery};
    use axum::{routing::get, routing::post, Json, Router};
    
    async fn create_event(Json(payload): Json<CreateEventRequest>) -> Json<EventResponse> {
        let mut store = MemoryStore::global();
        let event = store.store_event(payload.into())?;
        Json(EventResponse::from(event))
    }
    
    async fn search_facts(Json(query): Json<SearchFactsRequest>) -> Json<SearchFactsResponse> {
        let store = MemoryStore::global();
        let results = store.search_facts(SearchQuery::from(query))?;
        Json(SearchFactsResponse { results })
    }
    
    pub fn app() -> Router {
        Router::new()
            .route("/events", post(create_event))
            .route("/facts/search", get(search_facts))
    }
    

    命令列 Agent 或後端服務只要跑一個共用 memory server,就可以用 HTTP 存取。

    FFI(嵌入到 Python / Node 進程)

    優點:效能好、延遲低;缺點:需維護 binding。適用高頻工具調用型 Agent。

    // lib.rs (Rust)
    
    #[no_mangle]
    pub extern "C" fn store_event_ffi(json_payload: *const c_char) -> *const c_char {
        // 解析 JSON,呼叫 MemoryStore,回傳 JSON 字串
    }
    

    Python 側使用 ctypes 或 pyo3 包一層,暴露同樣的 store_event / search_facts 介面,對應前面的 MemoryClient。

    IPC(同機不同進程,高安全場景)

    可以用 Unix socket + protobuf 或 Cap’n Proto:

    • 優點:比 HTTP 更輕量,適合同機多服務共用記憶
    • 缺點:部署稍複雜,需額外 tooling

    設計上只要確保三種接法都共用同一套核心 API(MemoryStore),就能在不同專案中任意選擇實作方式,而不改動 Agent 邏輯。


    3)版本升級、資料遷移、多模型共用記憶庫

    長期記憶真正困難在於 「持續演化」。

    Schema 版本管理

    在 Fact 結構上掛版本欄位:

    pub struct Fact {
        pub id: String,
        pub owner_id: String,
        pub kind: String,
        pub content: String,
        pub version: i32,       // schema/version
        pub status: String,
        pub embedding: Option<Vec<f32>>,  
    }
    

    當你需要新增欄位或改變結構時:

    • 新寫入用 version = 2
    • 舊資料由 migration job 緩慢升級
    • 查詢 API 接受 min_version / max_version 作為過渡策略

    多模型共用同一記憶庫

    不同 LLM 對同一條記錄的解讀可能不同,所以要在 metadata 明確標注來源模型:

    pub struct Event {
        pub model_name: Option<String>,   // gpt-4o, llama-3-70b 等
        pub agent_id: String,
        // ...
    }
    

    策略上:

    • Facts 儘量由工具或人類決策產生,減少「模型幻覺」寫入持久記憶
    • 檢索時可加 filter:model_name in ["gpt-4o", "internal-rule-engine"],避免用某些品質較差模型產生的事件來推論

    建議與注意事項:把坑提前填好

    💡 關鍵: 控制 embedding 範圍、處理 PII、標記 embedding 模型,是讓長期記憶在成本、隱私與準確度間取得平衡的三個關鍵。

    1. 記憶膨脹與成本控制

    問題:

    • 所有對話都 embedding → 向量庫數量爆炸,成本跟查詢延遲一起上升

    建議:

    • 只對重要 Events / Facts 做 embedding,例如:完成一個任務時產生 summary fact
    • 針對長期 session,定期做 conversation summarization,保留摘要而不是 raw log
    • 對向量庫設計 TTL 或冷/熱層級:冷資料只保留摘要向量

    2. 隱私與合規(PII / 敏感資料)

    問題:

    • 長期記憶通常含姓名、電話、訂單資訊等 PII

    建議:

    • 設計 PII-aware schema:把 PII 拆出獨立欄位,便於加密與 masking
    • 在寫入前跑簡單的 PII 檢測 rule:
    • 例:電話號碼、email pattern 直接用工具抽出 → 存入安全欄位
    • 對查詢 API 加上角色權限(例如 owner_id+role=internal_support)

    3. 語義檢索漂移與模型更新

    問題:

    • 換 embedding 模型後,舊向量的語義分佈不同,semantic search 精度變差

    簡單防線:

    • 在向量旁存 embedding_model 欄位
    • 新模型上線後:
    • 新增資料用新 embedding
    • 舊資料分批 re-embed,或只重算活躍 Facts
    • 用 offline evaluation:定義一組標準 query + expected hits,監控 semantic search 成效

    4. 不同模型對同一紀錄的解讀不一致

    問題:

    • Model A 把某次對話解讀為「使用者喜歡簡訊通知」,Model B 覺得是「偏好 email」

    建議:

    • 把「推論」與「事實」分開存:
    • Fact:明確的、可驗證的偏好(使用者自行設定)
    • Inference:模型的猜測,需經多次交叉驗證或人工確認才升級為 Fact
    • 在 prompt 中區分:
    • 「已確認偏好」 vs. 「推測偏好」

    結語:把長期記憶升級成基礎設施

    對成熟的 AI 專案來說,長期記憶不再是「多塞幾個向量」的 hack,而是需要設計、版本與治理的系統。利用像 akitaonrails/ai-memory 這種以 Rust 實作的開源方案,你可以:

    • 為所有 Agent 建立一個 供應商無關、可演化的記憶層
    • 清楚區分 Events / Sessions / Facts,同時用語義與結構化查詢做精準檢索
    • 以 HTTP / FFI / IPC 等方式,在不同語言與框架中重用同一記憶庫

    這些設計一開始多花一點功夫,換到的是更穩定的成本、更易維護的架構,以及在多 Agent、多模型環境裡,真正能「記住」使用者與業務脈絡的系統。

    🚀 你現在可以做的事

    • 到 GitHub 搜尋並閱讀 akitaonrails/ai-memory 專案原始碼與文件
    • 在現有 Agent 專案中先導入 Events / Sessions / Facts 基本 schema,重構記憶寫入流程
    • 實作一個簡單的 HTTP memory server,讓至少兩個不同語言或框架的 Agent 共用同一記憶層
  • 用 goose AI Agent 開一隻全能小幫手

    用 goose AI Agent 開一隻全能小幫手

    📌 本文重點

    • goose 是用 Rust 寫的開源 AI Agent 框架
    • 讓 LLM 真的能跑指令、改檔案、寫測試而不只聊天
    • 可接任意 LLM,並透過 workflow 自動化多步驟任務
    • 很適合 DevOps / 開發者做日常開發與部署自動化

    用一句話說清楚:goose 是一個用 Rust 寫的開源 AI Agent 框架,可以讓 LLM 不只聊天,而是真的幫你在電腦上安裝套件、跑指令、改程式碼、寫測試,變成一個可以自動執行任務的「全能小幫手」。

    GitHub 專案:https://github.com/aaif-goose/goose


    goose 和一般聊天機器人有什麼不同?

    一般 ChatGPT / Claude 類工具,多半停在「給你建議」:

    • 產生程式碼片段
    • 幫你想測試案例
    • 告訴你下一步可以怎麼做

    goose 的差別在於:它可以自己動手做。

    透過 goose,你可以讓模型:

    • 在你的環境裡 執行殼層指令(shell commands)
    • 直接修改專案檔案、重構程式碼
    • 跑測試、根據結果再修正
    • 用 plugin / tool 的形式接上你自己的 API 或腳本

    換句話說,它比較像一個「可編程的 AI 工具人」,而不是純聊天機器人。

    💡 關鍵: goose 不只回覆文字,而是能在你的實際環境中「讀檔案、下指令、改程式」,真正把建議變成動作。


    核心功能:你可以拿 goose 來做什麼?

    1. 調用殼層指令:讓 LLM 幫你按命令行上的按鈕

    goose 內建「可以執行 shell 指令」的能力。

    你可以叫 agent 做這些事:

    • 安裝套件:apt-get, brew, pip, cargo…
    • 拉專案:git clone、切分支、pull 最新版
    • 跑工具:npm test、cargo test、pytest、make build

    你要做的行動:

    • 想一件你平常常打的一串指令(例如部署前要跑的 3–5 個步驟)
    • 把它寫成一句自然語言任務,交給 goose,觀察它如何自己拆解並下指令

    2. 程式碼編輯與測試:真的會改你專案的那種

    goose 支援對檔案系統操作,讓 LLM 直接:

    • 開啟 / 讀取專案中的檔案
    • 修改檔案內容(插入、刪除、重構)
    • 新增測試檔、更新 README

    常見用法:

    • 讓 agent 自動幫你 加 log / exception handling
    • 要它針對某個 module 補齊單元測試
    • 改 config、更新版本號、調整 CI 設定檔

    你要做的行動:

    • 選一個「可以放心被 AI 改壞」的小 side project
    • 用 goose 給它一個任務,例如:「在這個 Rust 專案裡,新增一個 health check endpoint,並幫我補上測試」

    3. 自訂工具擴充:把你自己的腳本、API 變成 agent 的能力

    goose 的設計重點是 「可擴充的工具」。你可以:

    • 把現有的 Python / Bash 腳本包裝成一個 tool
    • 把團隊內部 API(如 issue tracker、部署服務)接進來
    • 讓 agent 用「呼叫工具」的方式,連續完成更複雜的流程

    實際效果:

    • LLM 不用自己「想像」怎麼部署,而是呼叫你提供的 deploy_api
    • 你可以限制它只能用你認可的工具,控制風險

    你要做的行動:

    • 列出你工作中最常手動跑的 2–3 個腳本
    • 想像它們如果變成一個 deploy_service / create_release 的工具,agent 可以怎麼自動串起來

    4. 接任意 LLM:OpenAI、DeepSeek、本地模型都行

    goose 標榜 「with any LLM」,實際上就是可以在設定中自由切換 backend:

    • OpenAI(如 gpt-4.1)
    • DeepSeek API(如 deepseek-coder)
    • 透過 OpenAI-compatible API 的本地模型(Ollama、LM Studio…)

    這讓你可以:

    • 開發時用免費 / 便宜模型測試流程
    • 上線到正式環境時再換成更穩定的雲端模型

    你要做的行動:

    • 先挑一個你現有就有 API Key 的 LLM(例如 OpenAI 或 DeepSeek)
    • 決定:
    • 「實驗階段」用哪個模型
    • 「正式跑自動化」時要不要升級到較貴的模型

    💡 關鍵: 透過切換 GOOSE_MODEL 等設定,你可以在成本(本地 / 便宜模型)與效果(雲端高階模型)之間彈性取捨。


    適合誰用?三種典型場景

    1. DevOps/SRE:日常腳本自動化

    例如:

    • 部署前:拉最新程式碼 → 跑測試 → build → health check
    • 緊急修補:切 branch → 套 patch → 跑 smoke test → 發一版 hotfix

    用 goose 的做法:

    • 把這些步驟包成一個「任務腳本」(workflow)
    • 讓 agent 自己決定下一步要跑哪個指令、根據輸出結果調整

    2. 開發者:專案 boilerplate 生成與重構

    適用情境:

    • 開一個新服務:想要快速產生「專案骨架 + 基本路由 + CI 檔案」
    • 老專案:想系統性把某種寫法換成新的 pattern

    用 goose 可以這樣玩:

    • 指定專案資料夾給 agent
    • 給一個任務:「初始化一個 NestJS API 專案,幫我加上 Dockerfile 和 GitHub Actions CI」

    3. 團隊工程流程:CI 前自動檢查與修修補補

    在 CI 跑之前,先讓 goose 幫你:

    • 檢查程式格式、lint 問題
    • 嘗試自動修正簡單的錯誤
    • 對 PR 產生簡短變更說明

    做法:

    • 在 CI pipeline 裡加入「goose agent 步驟」
    • 給它權限在 CI runner 上修改檔案並 push(或開新 PR)

    💡 關鍵: 把 goose 放進 CI / pre-commit,可以在錯誤進到主線分支之前,自動完成一輪整理與簡單修補。


    怎麼開始:最快速的上手路徑

    1. 用 Docker 跑起官方範例(最快測試)

    前提:

    • 已安裝 Docker
    • 手邊有一個 LLM API Key(例:OPENAI_API_KEY)

    步驟:

    # 1. 拉專案
    git clone https://github.com/aaif-goose/goose.git
    cd goose
    
    # 2. 建一個 .env,放你的模型設定(簡化示意)
    cat << 'EOF' > .env
    OPENAI_API_KEY=your_key_here
    GOOSE_MODEL=openai/gpt-4.1
    EOF
    
    # 3. 用 docker compose 跑起來(實際以 repo 裡的 compose 指令為準)
    docker compose up --build
    

    跑起來後,通常會有:

    • 一個 CLI / HTTP 介面
    • 你可以丟:
    • 「在這個容器裡安裝 curl 並測試對 google.com 發送請求」

    行動建議:先在容器內做「無害」的事情,例如安裝一個套件、建立一個測試檔案,確認 goose 真的有在動你環境。


    2. 本機安裝(Rust 使用者)

    前提:

    • Rust toolchain(rustup)

    步驟:

    # 1. 安裝依賴
    cargo install --path .  # 實際請以 README 為準
    
    # 2. 設定環境變數
    export OPENAI_API_KEY=your_key_here
    export GOOSE_MODEL=openai/gpt-4.1
    
    # 3. 跑 CLI
    goose run
    

    你可以在終端機裡對 agent 下指令,例如:

    • 「列出目前資料夾的檔案,幫我找出所有含有 TODO 的檔案並列出行號」

    3. 接上常見模型(OpenAI / DeepSeek / 本地 LLM)

    以下是假設性的設定方向(實際請對照 goose README):

    OpenAI

    export OPENAI_API_KEY=your_key
    export GOOSE_MODEL=openai/gpt-4.1
    

    DeepSeek

    通常會提供 OpenAI 相容 API:

    export OPENAI_BASE_URL=https://api.deepseek.com/v1
    export OPENAI_API_KEY=your_deepseek_key
    export GOOSE_MODEL=deepseek-chat
    

    本地 LLM(以 Ollama 為例)

    啟動 Ollama 後:

    export OPENAI_BASE_URL=http://127.0.0.1:11434/v1
    export OPENAI_API_KEY=dummy
    export GOOSE_MODEL=ollama/llama3.1
    

    行動建議:先用最簡單、你現在就有的 API Key 接上,確認 goose 的流程跑得通,再考慮搬到本地模型節省成本。


    寫一個自己的「任務腳本」:讓 agent 連續完成幾個步驟

    goose 的強項在於可以定義「多步驟任務」。概念上,你會有一個 workflow 設定(格式依官方為準,這裡用 pseudo-code 示意):

    # workflows/dev_check.toml
    name = "dev_precommit_check"
    
    [[steps]]
    type = "shell"
    command = "git status"
    
    [[steps]]
    type = "agent"
    prompt = "閱讀 git status,決定要先格式化哪一些檔案,並執行對應指令。"
    
    [[steps]]
    type = "shell"
    command = "cargo test"
    
    [[steps]]
    type = "agent"
    prompt = "根據測試結果,如果有簡單錯誤可以直接修,並再次執行對應測試。"
    

    用法:

    goose run-workflow workflows/dev_check.toml
    

    這樣,你可以一行命令啟動一個「會看情況調整動作」的前置檢查流程。

    你要做的行動:

    • 先定義一個超簡單的 workflow:
    • Step1:ls 專案
    • Step2:請 agent 根據專案結構生成一段簡短說明,寫入 PROJECT_SUMMARY.md

    實戰:從零做一個小型自動化 workflow

    目標:在一個現有專案裡,做「提交前自動整理 + 簡單修補」流程。

    我們要達成:

    1. 檢查目前分支變更檔案
    2. 對變更檔案跑 formatter / linter
    3. 如果有明顯錯誤,由 agent 嘗試自動修改
    4. 重新跑測試

    Step 1:準備專案與權限

    1. 找一個你熟悉、可以接受被改動的專案資料夾
    2. 新開一個分支,如 feat/goose-auto-fix
    3. 確保 goose 有權限:
    4. 讀寫這個資料夾
    5. 執行必要的指令(例:npm test、cargo test)

    Step 2:定義 workflow(示意)

    依 goose 支援的格式建立一個 workflow 檔(假設是 YAML):

    name: precommit-helper
    steps:
      - type: shell
        command: git diff --name-only
      - type: agent
        prompt: |
          你看到的是目前分支有變更的檔案清單。
          目標:
          1. 對這些檔案執行合適的 formatter / linter 指令(依照檔案類型判斷)。
          2. 若 formatter/linter 回報可自動修復的問題,請修改檔案並重新執行檢查。
      - type: shell
        command: npm test  # 或你專案的測試指令
      - type: agent
        prompt: |
          根據測試輸出,
          - 若是小型邏輯/型別錯誤,嘗試修改相關檔案後再次執行測試。
          - 若錯誤較複雜,請產生簡短說明寫入 precommit_report.md。
    

    Step 3:實際執行與調整

    1. 在專案根目錄跑:

    bash
    goose run-workflow precommit-helper.yaml

    1. 觀察它的行為:
    2. 有沒有亂跑你不想要的指令?
    3. 修改的檔案是否合理?

    4. 根據結果調整:

    5. 限制能用的指令範圍(例如只允許 npm test, npm run lint)
    6. 在 prompt 裡多加一些「安全護欄」,例如「不要刪除檔案」。

    完成後,你就有了一個:

    • 可以在提交前幫你「整理 + 修補 + 產生報告」的小型 AI 助理
    • 海豚式改進:遇到痛點就稍微改一下 workflow / 工具清單,越用越貼近你團隊習慣

    小結:下一步可以怎麼玩?

    如果你看到這裡,建議接下來這樣走:

    1. 先跑官方範例容器一次,確認 goose 在你機器上可以正常跑指令。
    2. 選一個專案資料夾,做一個超小 workflow:只做檔案摘要或自動補 README。
    3. 把你現有的一個腳本包成 tool,讓 agent 可以呼叫(例如部署或打包腳本)。
    4. 等你有信心後,再把它接進 CI / pre-commit 流程。

    完整專案與最新用法請看:https://github.com/aaif-goose/goose

    把 goose 想成一個「可編程的 ChatGPT + 指令列機器人」,先從最小、風險最低的自動化開始,你會很快找到適合自己工作流的用法。

    🚀 你現在可以做的事

    • 打開 <https://github.com/aaif-goose/goose>,用 Docker 照著 README 跑一次官方範例
    • 選一個 side project,讓 goose 幫你完成「新增一個 endpoint + 補上測試」的小任務
    • 把日常最常用的一個部署或檢查腳本包成 tool,寫一個只包含 2–3 個步驟的簡單 workflow