
📌 本文重點
- 多語場景下單一檢索技術不可靠
- Sparse + dense 混合檢索能顯著提升召回
- RRF 等穩健融合策略優於簡單加權
- 現有「只用 embedding」RAG 可漸進升級
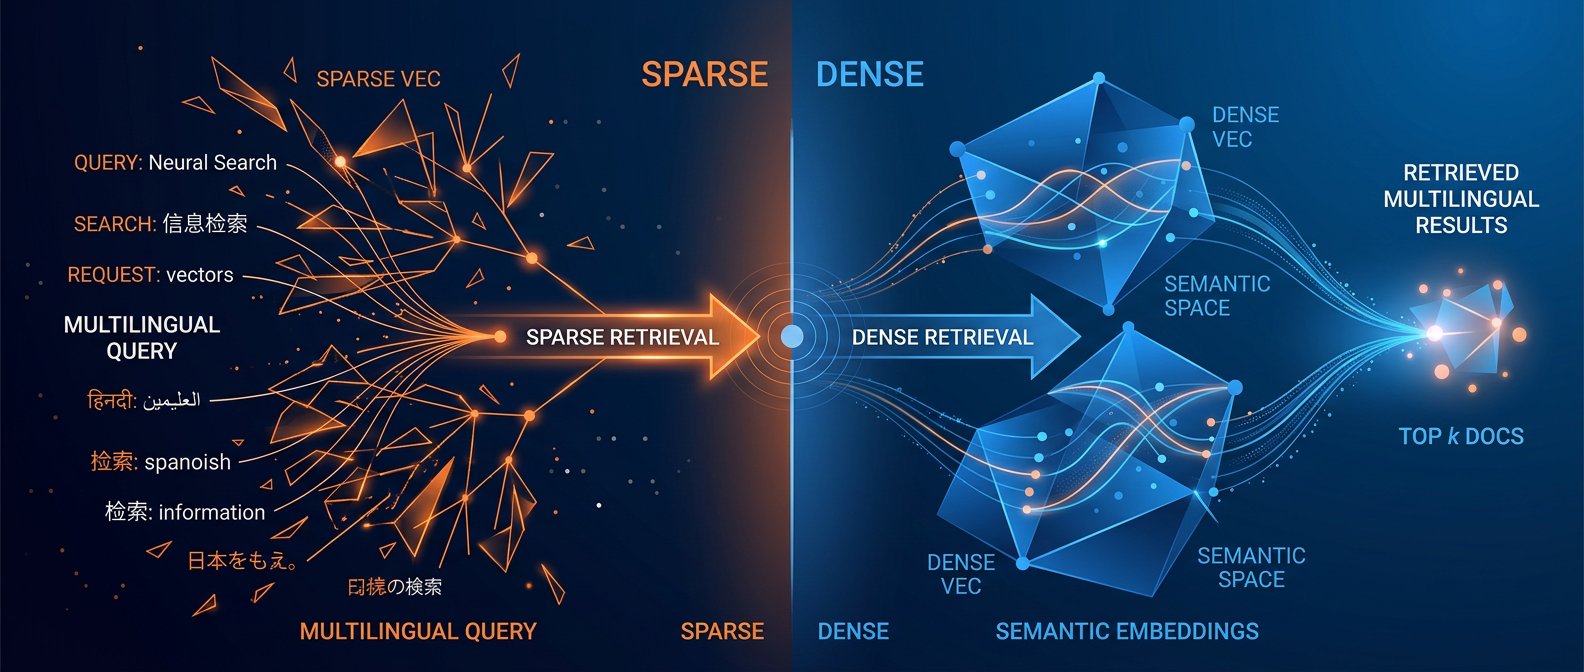
多語 RAG 最大的痛點,不是模型能力,而是檢索可靠性:民眾怎麼描述需求,和政府怎麼寫方案,永遠長得不一樣。從 MyScheme 這種多語、口語化的政府資料集可以看到,純 BM25 找不到語義相近但字面不同的文件,純 dense embedding 又容易在多語、多拼寫下語義漂移或召回太亂。本文聚焦一件事:如何用 sparse + dense 混合檢索,在現有 RAG 專案裡實際提升 recall,而不是只靠「換一個更大的 embedding 模型」。
重點說明
1. 純 BM25 vs 純 dense:多語查詢的失敗模式
以 MyScheme 的農民補助方案為例,同一個意圖可能長這樣:
farmer income support schemekisan ko har saal paisa milne wali schemeकिसानों को हर साल पैसे देने वाली योजनाfarmer ko 6000 rupees wali yojna
失敗模式很典型:
- 純 BM25
- 英文 query 找到英文文件還行,但遇到混 Hindi/English 的查詢時,停用詞與分詞完全不對齊,得分被噪音稀釋。
- 政府文件常用「PM-KISAN」「beneficiary」「disbursement」,民眾只說「har saal paisa」「6000 rupees」,詞彙不重疊直接失敗。
- 純 dense embedding
- 多語模型雖然能把 Hindi/English 映射到同一語義空間,但口語拼寫、錯字、混寫系統很容易落在 embedding 邊緣,導致相似度偏低。
- RAG 常見做法是
top-k = 5~10,一旦語義有點偏,整批召回的文件都錯,LLM 再會「瞎補」也救不回來。
💡 關鍵: 在多語口語查詢下,BM25 容易因詞彙不重疊失效,而 dense 在
top-k = 5~10時只要稍微語義偏離就會整批召回錯誤文件。
結論:lexical 是精確但太窄,dense 是寬但容易飄。混合檢索的目標就是用 sparse 捕捉字面線索、用 dense 捕捉語義,再在 ranking 階段做穩健融合。
2. Sparse + Dense Hybrid 的設計拆解
混合檢索不是「把兩個分數加起來」這麼簡單,它牽涉到幾個具體設計。
(1) 索引結構:一個引擎還是兩層系統?
- 單一引擎模式(適合小團隊):
- 用 Elasticsearch / OpenSearch 的 BM25 + 稀疏向量(如
SPLADE、ELASTICSPLADE)+ dense 向量三合一索引。 - 優點:部署簡單、一套 API;缺點:向量能力受限於 ES/OpendSearch 版本,調參空間較小。
- 兩層模式(適合大型系統):
- 第一層:search engine 做 sparse(BM25 + sparse vector)coarse recall。
- 第二層:向量資料庫(
PGVector/Qdrant)做 dense rerank / 精細相似度計算。 - 可在第二層加上
cross-encoderreranker 或 LLM-based re-ranking。
(2) 查詢改寫與 normalization
多語、多拼寫下,query preprocessing 本身就是一個模組:
- 語言偵測:
- 使用
fastText/CLD3或 LLM 自帶的語言偵測,標記 query 語言。 - Normalization:
- script normalization:全形/半形、Devanagari vs Latin transliteration。
- lowercasing、去除標點與顯而易見的 noise。
- 多語 query 擴展(選配):
- 將 Hindi query 透過 LLM 翻成英文:
किसानों को हर साल पैसे देने वाली योजना -> farmer yearly income support scheme,兩個版本都丟進檢索。
實務上,一個簡單但有效的策略是:統一把查詢轉成英文+原語言兩個 view,分別檢索,再在 ranking 層融合。
(3) Score Fusion / RRF:怎麼「穩健」地合併分數
常見幾種做法:
- 線性加權(
BM25_score * α + dense_score * β + sparse_score * γ): - 問題:不同分數尺度差很大、對參數敏感,容易在某些 query 下完全偏向單一來源。
- Reciprocal Rank Fusion(RRF):
- 每個檢索器給一個排序,對某文件的融合分數是:
[
RRF(d) = \sum_{s \in \text{sources}} \frac{1}{k + rank_s(d)}
]
k為平滑常數(常用k=60),不用調很多權重,對不同 query 分布也比較穩。
💡 關鍵: 使用
RRF搭配k=60能在多種檢索來源之間提供穩健且低參數敏感度的排序融合。
對多語 RAG,我會優先選 RRF 作為第一版融合策略,然後再針對特定語言或場景加權調整。
實作範例
以下用一個簡化架構示範:
OpenSearch:BM25 + sparse vector(透過插件或內建向量)做第一層 hybrid search。Qdrant:dense embedding 的向量查詢與 rerank。
1. OpenSearch 索引設定:文件 + 稀疏/密集向量
PUT myscheme-schemes
{
  "settings": {
    "analysis": {
      "analyzer": {
        "multilingual_analyzer": {
          "type": "custom",
          "tokenizer": "standard",
          "filter": ["lowercase", "stop_multilingual"]
        }
      },
      "filter": {
        "stop_multilingual": {
          "type": "stop",
          "stopwords": ["_english_", "_hindi_"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "title": {
        "type": "text",
        "analyzer": "multilingual_analyzer"
      },
      "description": {
        "type": "text",
        "analyzer": "multilingual_analyzer"
      },
      "sparse_vector": {
        "type": "rank_features"
      },
      "dense_vector": {
        "type": "dense_vector",
        "dims": 768,
        "index": true,
        "similarity": "cosine"
      }
    }
  }
}
說明:
multilingual_analyzer同時掛載英文和印地語 stopwords,但要注意不要過 aggressive(後面會講坑)。sparse_vector可以存像SPLADE這種模型產出的token->weight,透過rank_features來用 BM25-like scoring。dense_vector用預先算好的多語 embedding,例如Jina Embeddings/LaBSE/m3e。
2. 查詢流程:先 ES hybrid,再 Qdrant rerank
伪程式碼:
def search_myscheme(query: str):
    lang = detect_language(query)  # fastText / LLM
    norm_query = normalize_query(query, lang)

    # 1. 產生 sparse + dense 查詢向量
    sparse_q = splade_encode(norm_query)   # 稀疏向量:token->weight
    dense_q = embed_multilingual(norm_query)  # 768-d 向量

    # 2. 在 OpenSearch 做 hybrid search
    es_res = es.search(
        index="myscheme-schemes",
        body={
            "size": 50,
            "query": {
                "bool": {
                    "should": [
                        {"match": {"description": norm_query}},
                        {"rank_feature": {"field": "sparse_vector", "boost": 2}},
                        {
                          "script_score": {
                            "query": {"match_all": {}},
                            "script": {
                              "source": "cosineSimilarity(params.query_vector, 'dense_vector') + 1.0",
                              "params": {"query_vector": dense_q}
                            }
                          }
                        }
                    ]
                }
            }
        }
    )

    # 3. 把 top-50 丟進 Qdrant 用 dense similarity 做 rerank
    points = [
        {"id": doc["_id"], "vector": doc["_source"]["dense_vector"]}
        for doc in es_res["hits"]["hits"]
    ]

    qdrant_res = qdrant.search(
        collection_name="myscheme_schemes",
        query_vector=dense_q,
        search_params={"hnsw_ef": 128},
        limit=10,
        # 可以在這邊實作 RRF 或線性融合
    )

    return qdrant_res
如果想在單一 OpenSearch 裡就做 RRF,可以改成兩個子查詢各自出 top-k,再用 client 端做 RRF 合併。
3. 在現有「只用 embedding」的 RAG 上漸進式升級
典型現有流程:
# 既有做法
vec = embed(query)
results = vector_db.search(vec, top_k=10)
context = build_context(results)
answer = llm.generate(prompt_with(context, query))
漸進式升級建議:
- 第一步:加入 BM25 coarse recall
- 把 query 同時丟到 search engine:
python

   bm25_results = es_bm25_search(query, top_k=50)

   dense_results = vector_db.search(embed(query), top_k=30)

fused = rrf_fusion(bm25_results, dense_results, k=60) - 第二步:換 dense 為 multilingual + 加入 sparse
- 把原本英語 embedding 換成多語模型,再用 sparse 模型(
SPLADE)重建索引。 - 第三步:加入語言偵測與 normalization
- 先實作簡單版:
detect → normalize(lowercase+簡單清洗)→ bilingual query expansion。
💡 關鍵: 將現有「只用 embedding」流程按步驟加入 BM25、sparse 向量與語言偵測,可以在不重寫架構的情況下逐步提升召回與穩定度。
每一步都要搭配線上或離線評估,避免「看起來很厲害但實際沒有變好」。
建議與注意事項
1. 多語 stopwords 與錯誤分詞
- 坑 1:停用詞把關鍵字吃掉
- 多語 stopwords 列表往往過於粗糙,像 Hindi 裡有些詞在政府文本是關鍵字,在口語查詢卻被錯當停用詞。
-
建議先用 統計 + 標註樣本檢查停用詞對召回的影響,必要時為特定欄位(如
title)使用較少的停用詞。 -
坑 2:錯誤分詞導致 BM25 完全失效
- 非空白分隔語言(中文、某些印度語)如果切錯字,BM25 的詞頻意義直接失真。
- 解法:用 適語言分詞器(
jieba、HanLP、Indic NLP),或在部分欄位改用n-gram分詞降低風險。
2. 長文本切片策略:token 限制下如何不破壞語義
混合檢索遇到長文件(例如政策全文)時,常見坑是:
- chunk 切太細,BM25 還能找得到,但 dense embedding 像是記憶碎片,語義不完整。
- chunk 切太粗,dense 相似度還好,但 BM25 命中的字詞被大量無關文本稀釋,排序變差。
建議策略:
- 以 語段(paragraph)或條款為單位切片,長度控制在
200–400 tokens。 - 每個 chunk 保留 標題 / 小節名,讓 lexical 的命中不只在正文。
- 如果有政策層級結構,建立 hierarchical RAG:先檢索 policy,再在 policy 下檢索條款。
3. 標註與線上 A/B:怎麼確認 recall 真的變好
不要只看「LLM 回答看起來比較合理」,要量化:
- 離線標註:
- 從真實 query(或合成 query)抽樣,為每個 query 標註「有用的文件 ID」。
-
比較純 BM25、純 dense、hybrid 在
top-k的Recall@k/MRR/nDCG。 -
線上 A/B:
- 對真實使用者流量,隨機分流到
dense-onlyvshybridpipeline。 - 收集:
- 使用者是否點選推薦方案。
- 是否更快完成查詢(減少反覆搜尋)。
- 避免只用主觀「好像比較好」,用行為指標判斷。
4. 架構選型:小團隊 vs 大型系統
- 小團隊 / MVP 階段:
- 優先選一個支援向量的 search engine(
OpenSearch + k-NN plugin/Elasticsearch + vector)。 -
提示重點:一個 index 同時存 text + sparse + dense,client 端做
RRFfusion 就足夠支撐絕大部分 RAG 應用。 -
大型系統 / 高流量服務:
- 分層:
- Tier 1:search engine 做 BM25 + sparse coarse recall(
top-100~200)。 - Tier 2:向量資料庫(
PGVector/Qdrant/Milvus)做 dense rerank + optionalcross-encoder。
- Tier 1:search engine 做 BM25 + sparse coarse recall(
- 好處:
- 可以針對不同語言、資料域調不同策略,如 Hindi 專用索引、英語專用索引再做 union。
- 資源隔離:檢索與 rerank 分別 scale。
核心結論:在多語、口語化場景下,單一檢索技術不夠可靠。把 BM25、稀疏向量和密集向量結合,搭配語言偵測與穩健的 score fusion(如 RRF),可以在不大改現有 RAG 架構的前提下,顯著提升查詢召回與答案穩定度。對已經在用「只用 embedding」的專案來說,這是一條可漸進落地的技術升級路線,而不是重寫整套系統。
🚀 你現在可以做的事
- 在現有 RAG 專案中加入一個 BM25 搜尋來源,並用
RRF(k=60)與 dense 結果融合測試效果- 選定一個多語 embedding 模型(如
LaBSE或m3e),為核心資料集建立dense_vector欄位- 抽樣實際使用者查詢,標註「關鍵文件 ID」,離線比較
dense-only與hybridpipeline 的Recall@k