標籤: llama.cpp

  • SmallCode 架構:讓 4B 模型也能帶專案

    SmallCode 架構:讓 4B 模型也能帶專案

    📌 本文重點

    • 小模型不適合搭配太多零碎 tools
    • 用少量 compound tools 封裝整個工作流
    • 加上可控 improvement loop 提升穩定性
    • 本地 4B 模型也能跑實用 coding agent

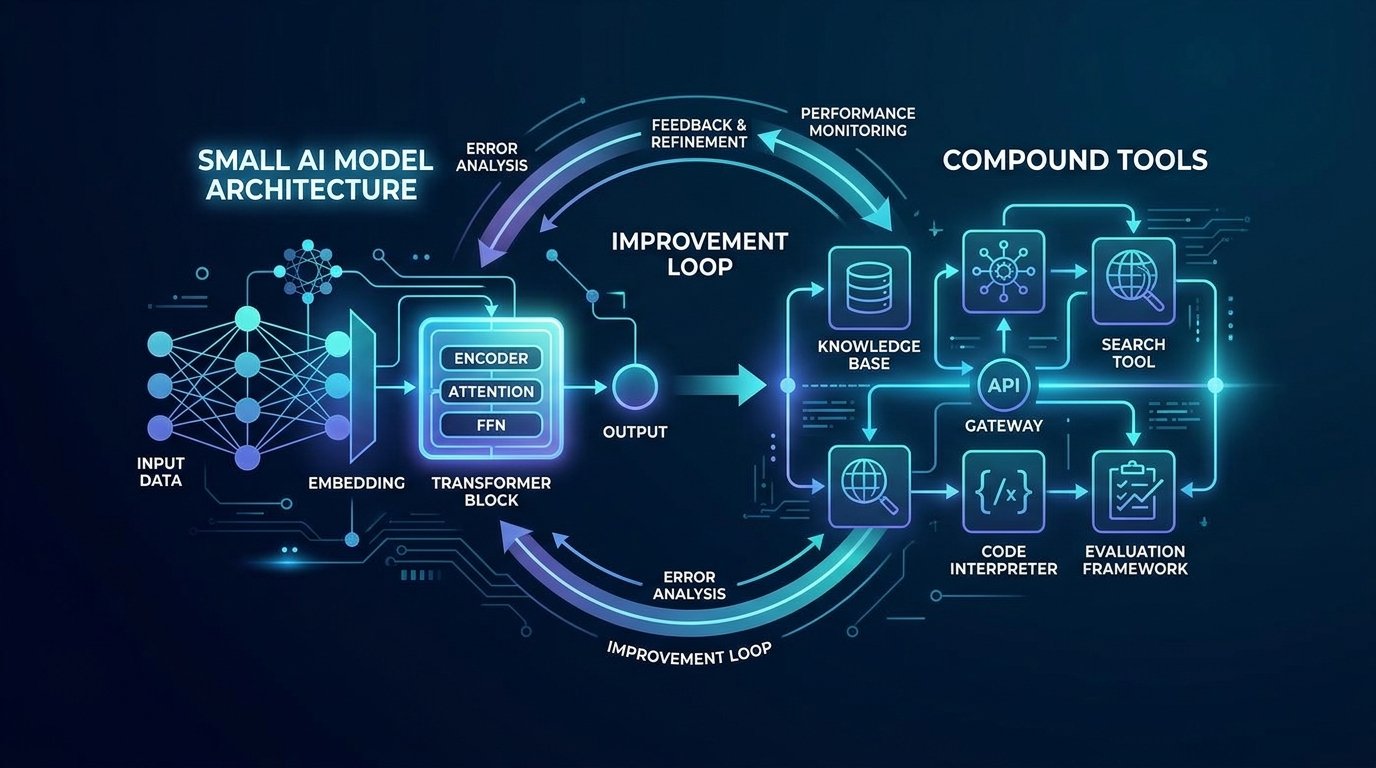
    在本地用 4B Gemma 這種小模型帶一個中大型 repo,傳統做法是「LLM + 一堆小工具」:讀檔、寫檔、跑測試、grep 全部拆成獨立 tool。結果大多數人遇到的狀況是:上下文爆炸、工具呼叫瘋狂往返、推理鏈斷裂,小模型最後只會在錯誤訊息上打轉。SmallCode 的重點就是把這些多步操作 封裝成少量高階 compound tools,加上一個可控的 improvement loop,讓 4B 模型也能穩定完成多檔案、反覆修改的任務。


    重點說明

    1. 為什麼「LLM + 一堆小工具」在小模型上會崩盤

    從工程視角,小模型掛點原因其實很單純:

    1. 上下文爆炸:
    2. 每呼叫一次 read_file、search、run_tests,LLM 就要重新看到整段對話 + 工具 I/O。
    3. 小模型 context 小、壓縮能力差,於是早期決策被擠掉,任務計畫完全失憶。

    💡 關鍵: 小模型的 context 與壓縮能力有限,多工具頻繁往返會迅速擠掉關鍵決策,導致任務中途失憶。

    1. 頻繁往返 + 推理鏈斷裂:
    2. 多工具設計變成:LLM → read_file → 回答 → write_file → 回答 → run_tests ...
    3. 每一步都要模型自己想「下一步該用什麼工具」,對小模型來說元認知成本太高,很容易在第 3、4 步就跑偏。

    4. 錯誤訊息解析太細碎:

    5. 錯誤訊息來了:run_tests → 報一堆 stacktrace → LLM 要自己決定要再 read_file 哪幾個檔案。
    6. 4B 模型常常讀錯檔或只讀到片段,最後修 bug 幻覺化。

    SmallCode 的做法是:把「讀檔 → 修改 → 測試」這個典型工作流視為一個原子操作,交給 compound tool 內部處理,LLM 只需要決定「要不要再試一次?」。


    2. Compound Tools:把多步工作流變成一個 API

    設計思路可以簡化成三件事:

    1. 把多步操作拉到工具內執行
    2. 典型例子:edit_and_test:
      • 根據指定 glob pattern 讀檔
      • 在本地套用 LLM patch(或簡單模板)
      • 寫回檔案
      • 跑 pytest / npm test,收集輸出
    3. 對 LLM 而言,這整件事就是 一次工具呼叫 + 一個結構化結果。

    4. 清楚定義輸入 / 輸出 Schema

    輸入 Schema(JSON Schema 或 Pydantic)範例:

    python
    class EditAndTestInput(BaseModel):
    goal: str # 自然語言:『讓 tests/test_api.py 全部通過』
    target_files: List[str] # ['src/api.py', 'tests/test_api.py']
    test_command: str = "pytest -q"
    max_edits: int = 3

    輸出 Schema:

    “`python
    class EditSummary(BaseModel):
    file: str
    diff: str # unified diff

    class EditAndTestOutput(BaseModel):
    success: bool
    edits: List[EditSummary]
    test_output: str
    error_summary: Optional[str]
    “`

    重點是讓小模型只要關注:有沒有成功?改了哪些檔?錯在哪裡?

    1. 在一次工具呼叫中完成工作流

    Tool handler(Python 假想範例):

    “`python
    def edit_and_test_tool(payload: EditAndTestInput) -> EditAndTestOutput:
    # 1. 收斂上下文:只讀需要的檔案內容
    files = {f: Path(f).read_text() for f in payload.target_files}

       # 2. 呼叫同一個或更小的 LLM 產生 patch(可本地或子進程)
       patch = call_llm_generate_patch(goal=payload.goal, files=files)
       edits = apply_patch_to_files(patch)
    
       # 3. 寫回檔案
       for e in edits:
           Path(e.file).write_text(e.new_content)
    
       # 4. 跑測試
       ok, test_output = run_command(payload.test_command)
    
       return EditAndTestOutput(
           success=ok,
           edits=[
               EditSummary(file=e.file, diff=e.diff)
               for e in edits
           ],
           test_output=test_output,
           error_summary=None if ok else summarize_test_output(test_output),
       )
    

    “`

    好處:主 agent 模型只要發出一個 edit_and_test 呼叫,不用自己 orchestrate read_file、write_file、run_tests,大幅降低 思考步數 和 context 髒亂度。


    3. Improvement Loop:可控的自我改進迴圈

    SmallCode 成效好的關鍵是:讓 retry 變成一級公民,而不是「失敗就結束」。

    1. 失敗偵測策略
    2. 以 compound tool 的輸出為主,不讓模型自己猜:
      • success == False
      • test_output 中出現關鍵字(FAILED、Traceback、AssertionError)
    3. 這樣 loop controller 可以用硬邏輯判斷下一步,不依賴 LLM 理解每一行 stacktrace。

    4. 重試策略

    簡單可用的架構:

    “`python
    MAX_ATTEMPTS = 5

    for attempt in range(1, MAX_ATTEMPTS + 1):
    tool_result = edit_and_test_tool(input_payload)

       if tool_result.success:
           break
    
       feedback = build_feedback_prompt(tool_result)
       input_payload.goal = feedback  # 將錯誤摘要回餵給模型
    

    “`

    build_feedback_prompt 可以把 error_summary + 失敗測試名稱打包,讓下一輪 LLM 更聚焦。

    1. 避免無限 loop 的做法
    2. 硬限制:MAX_ATTEMPTS、最大 wall time。
    3. 檢查 edits 是否變化:若連續兩次 diff 幾乎一樣(甚至相同 hash),就早停。
    4. error signature 去重:同一個 assertion / stacktrace 重複出現 N 次就停止,標記為「需要人介入」。

    這樣,4B 模型只要能理解「這次錯在哪裡、我還有幾次機會」,就足以在迴圈中持續收斂。


    4. 在本地 4B 模型上的部署實務

    以 Gemma 2 4B 為例,用 llama.cpp / Ollama 都可以吃得很順,但細節會影響體驗:

    1. 記憶體與延遲粗估
    2. 4B Q4_K_M:VRAM 約 3–4 GB;Q6 大概 5–6 GB。
    3. context 8k、推理 1 token ≈ 10–40 ms,視 CPU/GPU 而定。
    4. agent 架構推薦:主模型用中量化(Q4/Q5)+ MTP(若硬體支援),工具內部幫忙 patch 的模型可以更小或更低位元。

    💡 關鍵: Gemma 2 4B 在 Q4 量化、約 3–4 GB VRAM 和 8k context 下即可順暢運行,適合作為本地實用 coding agent 的基礎。

    1. llama.cpp 整合範例

    bash
    # 轉 GGUF 後
    ./llama-cli \
    -m gemma-2-4b-q4_k_m.gguf \
    -c 8192 \
    -ngl 35 \ # offload 到 GPU layer 數
    --temp 0.2 \
    --top-p 0.9

    在你的 agent server(Python)裡包一層簡單的 HTTP:

    “`python
    from llama_cpp import Llama

    llm = Llama(model_path=”gemma-2-4b-q4_k_m.gguf”, n_ctx=8192)

    def chat(messages):
    return llm.create_chat_completion(
    messages=messages,
    tools=TOOLS_SCHEMA, # compound tools 定義
    )
    “`

    1. Ollama 整合範例

    yaml
    # Modelfile
    FROM gemma2:4b
    PARAMETER temperature 0.2
    PARAMETER num_ctx 8192

    Python 呼叫:

    “`python
    import requests, json

    def ollama_chat(messages, tools=None):
    payload = {“model”: “gemma2-4b”, “messages”: messages}
    if tools:
    payload[“tools”] = tools
    r = requests.post(“http://localhost:11434/api/chat”, json=payload)
    return r.json()
    “`

    注意:不要貪心開太大 context,4B 小模型在 16k context 上的品質掉得很明顯,8k 左右通常較穩定。


    實作範例:簡化版 SmallCode 架構

    以下是一個「可以直接改造」的最小可行架構:

    # 1. 定義 compound tools
    TOOLS_SCHEMA = [
        {
            "type": "function",
            "function": {
                "name": "edit_and_test",
                "description": "Edit target files to satisfy goal and run tests.",
                "parameters": EditAndTestInput.model_json_schema(),
            },
        },
    ]
    
    # 2. Agent 迴圈
    
    def coding_agent(task_description: str):
        messages = [
            {"role": "system", "content": "你是嚴謹的資深工程師,專注讓測試通過。"},
            {"role": "user", "content": task_description},
        ]
    
        for attempt in range(1, 6):
            resp = ollama_chat(messages, tools=TOOLS_SCHEMA)
            choice = resp["message"]
    
            if "tool_calls" not in choice:
                # 當成總結
                return choice["content"]
    
            for tool_call in choice["tool_calls"]:
                if tool_call["function"]["name"] == "edit_and_test":
                    args = json.loads(tool_call["function"]["arguments"])
                    result = edit_and_test_tool(EditAndTestInput(**args))
    
                    # 記錄 tool 結果
                    messages.append({
                        "role": "tool",
                        "name": "edit_and_test",
                        "content": result.model_dump_json(),
                    })
    
                    if result.success:
                        messages.append({
                            "role": "user",
                            "content": "測試已通過,請簡要總結你做了什麼修改。",
                        })
                        final = ollama_chat(messages)
                        return final["message"]["content"]
    
        return "多次嘗試仍未通過測試,請人工檢查。"
    

    實際好處:
    – 你不需要讓 4B 模型自己 orchestrate 所有 file ops,只決定「目標」和「是否繼續嘗試」。
    – 迴圈與成功判斷在 host 程式碼內可觀測、可監控,易於 debug。


    建議與注意事項

    1. tool 太細 vs 太粗的 trade-off
    2. 太細:read_file、write_file、run_tests 分開 → 小模型迷路。
    3. 太粗:一個 tool 內藏太多隱含狀態 → 工具結果難以解釋與監控。
    4. 建議:以「一次迴圈可解決的一個明確目標」為單位設計 compound tool,例如:edit_and_test_suite、add_feature_and_generate_tests。

    5. 錯誤訊息解析策略

    6. 不要把整個 test log 丟給小模型,先在 host 端做:
      • 只保留最後一個錯誤 block
      • 摘要檔名、行號、錯誤訊息
    7. 這樣可以避免 4B 模型被 1k tokens 的 noisy log 淹沒。

    8. 測試覆蓋率不足導致的幻覺修 bug

    9. 如果只有 1–2 個測試,小模型會傾向「只讓這兩個測試過」而破壞其他邏輯。
    10. 實務上:

      • 優先在 agent pipeline 前補上最小必要測試
      • 或在 tool 裡檢查 diff 是否只動到相關檔案/區塊(heuristic)。
    11. 如何監控與記錄 agent 決策

    12. 每一次迴圈記錄:
      • 使用的 tool 名稱 + 輸入參數
      • diff 摘要(檔名、行數、行數變化量)
      • test command 與結果(pass/fail、耗時)
    13. 建議:

    text
    logs/
    session-2025-05-21T12-34-56Z/
    step-01-request.json
    step-01-edit_and_test-input.json
    step-01-edit_and_test-output.json
    step-01-diff.patch

    之後你可以回放整個 session,分析為什麼某一輪跑偏,進而調整 tool schema 或 system prompt。


    總結:如果你想在本地 4B 模型上做實用的 coding agent,不要再堆滿十幾個零碎 tools。把關鍵工作流收斂成少量 compound tools,加上一個明確可控的 improvement loop,再配合 llama.cpp / Ollama 的輕量部署,就能把原本只敢交給 GPT-級別模型的任務,下放到可自託管的小模型上。


    🚀 你現在可以做的事

    • 在現有 agent 專案中,把零碎的 read_file / write_file / run_tests 整合成一個 edit_and_test compound tool
    • 用 Gemma 2 4B + Ollama 或 llama.cpp 在本地啟一個 8k context、Q4 量化的測試環境
    • 為你的 repo 實作一個最小版 improvement loop,限制 MAX_ATTEMPTS 並記錄每次 diff 與測試結果
  • 96 個 Gemini Agent 幫你寫系統?

    96 個 Gemini Agent 幫你寫系統?

    📌 本文重點

    • 多 Agent 可複製「多人分工」開發流程
    • Runtime 設計比單純換更大模型更關鍵
    • 用開源工具就能打造迷你版 Antigravity

    用一群 Agent 代替「一個工程師慢慢寫」,解決的是:複雜專案要靠多人分工,AI 也可以用 Runtime + 多代理系統做到同樣的協作和自動化。

    核心觀念先講白:模型戰爭差不多打完了,現在比的是誰的 Agent Runtime 能把「模型能力」變成可落地的、多步驟的自動化工作流。

    Google 在 I/O 上展示的 Antigravity 2.0 + Gemini 3.5 Flash 是一個很極端的例子:

    • 96 個子代理分工
    • 12 小時寫完一套從零開始的作業系統
    • Token 成本不到 1,000 美金
    • OS 還能跑《Doom》

    💡 關鍵: 多代理 + 強 Runtime 已經能在「12 小時、不到 1,000 美金」內完成從零開發 OS,顯示關鍵瓶頸不再是模型本身,而是協作與流程設計。

    這不是叫你明天也去做一個 OS,而是提供一個「如何設計多 Agent 開發流程」的範本。下面我們拆成三件你可以直接抄的事:

    1. 多代理分工設計:任務 → 子任務 → Agent 編隊
    2. 強健 Runtime:重試、檢查點、錯誤恢復
    3. 平價版本實作:在你自己的專案做一個「迷你 Antigravity」

    核心功能:Antigravity 2.0 給開發者的三個啟示

    1. 多代理分工:任務 → 子任務 → Agent 編隊

    Antigravity 的做法,其實很像你帶一個遠端工程團隊:

    • 架構師 Agent:決定 OS 的模組切分(檔案系統、排程、驅動、UI…)
    • 模組作者 Agent:各自負責某一個模組的程式碼生成
    • 測試員 Agent:寫測試、跑測試、收斂錯誤
    • 整合者 Agent:把各模組組合、處理相依性、打包成可啟動的系統

    對你來說,可直接套用成一個通用流程:

    1. 寫一個頂層任務描述
      例:建立一個 RESTful CRUD 服務,管理任務(待辦事項),含 API、DB schema、簡單前端。

    2. 讓「架構師 Agent」自動拆解:

    3. API 設計與 OpenAPI spec

    4. 後端框架與資料庫層
    5. 前端 UI
    6. 測試與 CI script

    7. 為每個子任務設計 Agent 角色:

    8. api-architect-agent:只產出 API spec

    9. backend-agent:根據 spec 產生程式碼
    10. frontend-agent:負責 UI
    11. tester-agent:生成並執行測試
    12. integrator-agent:檢查專案結構、跑 build / lint

    13. 在 Runtime 中定義工作流:

    14. 任務圖(DAG):架構師 → 模組作者 → 測試員 → 整合者

    15. 每個節點定義輸入/輸出檔案、工具(Git、DB、HTTP client)

    可行動步驟:

    • 選一個你熟的框架(例如 FastAPI / Next.js)
    • 用自然語言寫清楚「最終可交付物」
    • 為這個專案定義 3–5 個 Agent 角色,明確限制各自輸入輸出

    2. Runtime 比模型重要:90% 成功率在多步任務會變災難

    多步任務有一個殘酷數學:

    • 假設每一步成功率 90%
    • 要跑 20 步,整體成功率 ≈ 0.9^20 ≈ 12%

    💡 關鍵: 即使單步有 90% 成功率,20 步工作流成功率只剩約 12%,所以不加 Runtime 管控,多步任務幾乎註定失敗。

    這就是為什麼像 Forge 這種開源 guardrails 會被重視:作者實測,一個 8B 模型在多步代理任務上,從 53% 提到 99% 成功率,完全不改模型,只改 Runtime。

    你在自己的「迷你 Antigravity」裡,要做三件事:

    1. 重試與 nudging

    2. 為每個步驟設 max_retries(例如 3 次)

    3. 失敗時自動加上「修正提示」,例如:上一步測試失敗,錯誤訊息如下,請修正而不是重寫整檔。

    4. 檢查點(checkpoint)

    5. 每完成一個重要子任務,就把中間產出存到 Git / DB

    6. 失敗時從最近的檢查點重跑,而不是重頭來

    7. 錯誤恢復流程

    8. 專門的 debug-agent:只看錯誤訊息 & log,產出修復建議

    9. Runtime 層做:自動建立 bug report、開 issue、指派給對應 Agent

    如果你用 Forge,它已內建:

    • Tool-agnostic 重試策略
    • 步驟執行強制與錯誤恢復
    • VRAM-aware context 管理(對本地模型很重要)
    • 評估套件與 Dashboard,可量化成功率

    可行動步驟:

    • 先把現有「單 Agent 自動流程」改成有重試與 checkpoint
    • 對每個任務記錄:總步數、失敗點、重試次數,在 Dashboard 裡看瓶頸

    3. 平價版本:你也能做一個「迷你 Antigravity」

    你不需要 Gemini 3.5 Flash + Google 內部 Runtime 才能玩多 Agent。下面這些工具可以在自家專案做一個縮小版:

    名稱 核心功能 免費方案 適合誰
    Forge 多步代理 guardrails、重試、Dashboard 開源 想提升本地 / 自架 LLM 可靠性的工程師
    llama.cpp + Qwen 本地 Agent 在個人電腦跑本地模型 + 簡易工具調用 開源 想省雲端費用、在內網跑 Agent 的團隊
    MCP 生態(如 OpenAI MCP、各種 server) 統一的工具協議,讓 Agent 調用資料庫、API 等 多數開源 / 免費 想把既有系統暴露為 Agent 工具的後端工程師

    一個實用組合示例:

    • 模型:Qwen 2.5 7B / 14B(透過 llama.cpp 或 Ollama 跑)
    • Runtime:Forge 當 guardrails
    • 工具層:一組 MCP server(例如 PostgreSQL、HTTP、Filesystem)

    你可以先做一個「自動搭建 CRUD 服務」的迷你 Antigravity:

    1. 使用者輸入需求(自然語言)
    2. architect-agent 產出設計 + 任務拆解
    3. backend-agent + frontend-agent 寫程式碼
    4. tester-agent 自動開發 & 執行測試
    5. integrator-agent 跑 build 並回報狀態

    適合誰用:三種典型場景

    1. 後端 / 全端工程師:自動化 CRUD 小專案

    你可以把「打造新微服務」變成一個表單:

    • 輸入資料模型 + 幾個業務規則
    • 多 Agent 流程負責 scaffold、API、測試、docker-compose

    行動:從一個只需要 3–5 小時就能手刻完的小服務開始,先讓多 Agent 幫你做到 70–80%,你只負責 code review。


    2. 資料團隊:資料管線與 ETL 任務

    • planner-agent:解析需求、拆成抽取/轉換/載入步驟
    • sql-agent:產生查詢與 view
    • check-agent:比對 row count、品質指標

    行動:挑一個每天都在重複手動跑的 ETL 任務,做成標準流程,讓 Agent 幫你自動生成 SQL + 驗證報表。


    3. 產品 / PM:快速驗證 Side Project

    • 搭配 Gemini 3.5(雲端)或本地 LLM
    • 定義一個「最小可行功能」(例如 landing page + 簡單 API)
    • 用多 Agent 完成第一版,再丟給工程師接手

    行動:每次新點子,給自己一個規則:「先讓多 Agent 寫一版 Demo,我只在最後 2 小時調整。」


    怎麼開始:一個最小可行範例

    這裡給一條「3–5 小時內可完成」的路線,你可以直接照做:

    步驟 1:選模型 + Agent 框架

    • 模型:
    • 想省錢/本地:Qwen 2.5 7B(透過 llama.cpp 或 Ollama)
    • 想雲端無痛:Gemini 3.5 Flash(透過 Google AI Studio)
    • Runtime / 框架:
    • 想要 guardrails:裝 Forge
    • 想用現成 MCP:選一個支援 MCP 的 Agent 框架(如 OpenAI 官方 Agent SDK)

    步驟 2:挑一個小系統

    條件:

    • 單服務、沒有第三方整合
    • 你自己寫大約 3–5 小時能完成

    例:任務管理 CRUD API + 簡單 React 前端

    步驟 3:設計任務拆分與 Agent 角色

    1. 任務描述寫成一個 markdown 檔(會給 architect-agent 看)
    2. 在 Runtime 中註冊 4 個 Agent:
    3. architect
    4. backend
    5. frontend
    6. tester/integrator
    7. 為每個 Agent 明確:
    8. 可用工具(Git、Filesystem、HTTP…)
    9. 輸入(上一個 Agent 的輸出 / 檔案)
    10. 必須產出什麼檔案

    步驟 4:加上監控 Dashboard

    • 如果用 Forge:直接啟用它的 Dashboard,看每次工作流的步驟成功率
    • 若自己實作:
    • 為每個步驟記錄:開始時間、結束時間、是否重試
    • 每次失敗時存 log + 輸入輸出到一個資料夾

    步驟 5:只做一件事的迭代

    • 第一版只要求「能跑起來」,不追求漂亮結構
    • 每次失敗,你只調整:
    • 任務拆分是否太粗/太細
    • Agent 提示是否太模糊
    • 重試與 checkpoint 是否設太少

    等到這個小系統穩定後,你才讓 Runtime 去碰更大的專案。


    小結:Runtime 是你的「AI 開發主管」

    Antigravity 2.0 用 96 個 Gemini Agent 寫出一套能跑《Doom》 的 OS,看起來很遠,但背後用到的概念其實都可落在你今天的 side project 上:

    • 把任務拆成 Agent 可接手的小單位
    • 用 Runtime 管控流程,而不是寄望模型每次都猜對
    • 利用開源工具(Forge、llama.cpp、MCP)做出自己的「迷你 Antigravity」

    💡 關鍵: 關鍵不是再換一個更大的模型,而是把現有模型放進可靠的 Runtime,讓它真的「交付」可用產物。

    關鍵不是再換一個更大的模型,而是先把你手上的模型,放進一個可靠的 Runtime 裡,讓它真的幫你「交付」東西。

    🚀 你現在可以做的事

    • 在 GitHub 上看看 Forge 專案,了解多步代理的 guardrails 怎麼設計
    • 挑一個 3–5 小時能手刻完的 CRUD 小服務,照文中的 4 個 Agent 角色拆任務實作一次
    • 把既有的單 Agent 自動化腳本,加上 max_retries 和簡單 checkpoint 機制,量化成功率變化
  • GAIA 本地多代理實戰指南

    GAIA 本地多代理實戰指南

    📌 本文重點

    • 本地多代理更可控
    • sandbox 與權限隔離
    • 先選小模型再優化
    • Workflow 可 checkpoint

    在本地硬體上跑 GAIA 多代理 workflow,直接解決三個實際痛點:

    💡 關鍵: 本地部署的核心價值,不只是省雲端費用,更是把隱私、延遲和權限控制都收回自己手上。

    1. 隱私與合規:內網知識庫、檔案內容不出機器,減少 DLP 顧慮。
    2. 可控成本與延遲:不綁雲端 API,長任務與大量工具呼叫的成本與延遲可預期。
    3. 更細緻的權限隔離與除錯:工具執行在你設計的 sandbox 內,log、資源監控都在本機可觀測。

    以下以「本地檔案整理 + 內網知識庫助理」為具體任務,示範如何用 GAIA 在單機上組出一個可用的多代理系統,並說清楚在 Apple Silicon / GPU / 純 CPU 場景下要怎麼選 LLM 和調整架構。


    重點說明

    1. GAIA 的基本心智模型:Agent / 任務 / 工具

    GAIA 的抽象其實很單純:

    • Agent:有「目標 + 能力」的行為體,通常綁一個 LLM + 一組工具。
    • 任務(Task / Workflow):定義起點、終點,以及 Agent 如何接力。
    • 工具(Tools):一組可呼叫的函式,如檔案系統、HTTP、向量搜索,GAIA 會把它們包成可被 LLM 呼叫的函式呼叫介面。

    實務上你會這樣切:

    • 一個 Planner Agent 負責拆解高階目標:例如「整理 ~/Downloads 並產出 README」。
    • 一個 FileOps Agent 只負責檔案遍歷、分類、改名,綁定檔案系統工具,權限嚴格限制。
    • 一個 Knowledge Agent 使用向量庫對內網 markdown/PDF 做檢索與摘要。

    2. 在單機協調多代理:比你想像中輕量

    GAIA 不是重型的分散式框架,而是偏 本地 Orchestrator:

    • 用一個主 loop 或 workflow engine 管理 Agent 呼叫順序、中間狀態與錯誤。
    • 每個 Agent 呼叫相同或不同 LLM(例如:Planner 用小模型,Knowledge Agent 用大模型)。
    • 即使只有一張 GPU 或一台 Apple Silicon,透過限流與序列化調度一樣能跑多代理,只是併發要保守。

    3. 本地 LLM 選擇策略(Apple / GPU / CPU)

    Apple Silicon(M1–M4):

    • 優先考慮 MLX + Qwen3.5 / Gemma 4 / Llama 家族的 8–9B 量化。
    • 善用像 Reddit 提到的 DFlash 推測解碼:在 9B 級模型上可有 ~4× decoding 加速,對多代理回合式對話很有感。

    💡 關鍵: ~4× decoding 加速代表回合式多代理互動的體感差異會非常明顯,特別是在本地裝置上。

    • 32GB RAM 以上:可以考慮 27B 量級,但要注意 context 與 batch size 的 trade-off。

    桌機 GPU(NVIDIA):

    • llama.cpp / vLLM / TensorRT-LLM 都可;若用 llama.cpp,可利用社群的 llm-server v2 --ai-tune 自動調 flags,實測 Qwen3.5-27B 可 +50% tok/s 以上,對長任務吞吐提升很明顯。

    💡 關鍵: +50% tok/s 以上的提升,對長任務與大量工具呼叫會直接反映在整體吞吐量上。

    純 CPU:

    • 參考 Gemma 4 在 CPU 的實測,8B 級模型仍可用,但要:
    • 選擇更小模型 + 更 aggressive 量化(如 Q4_K_M);
    • 控制 max_tokens,避免一次生成太長;
    • 任務設計上用更多工具、多輪互動,降低單次生成長度。

    實作範例:從零到一的本地多代理 workflow

    假設你要在 Mac(M2 Pro + 32GB)上做一個:

    指定資料夾路徑 → 自動整理檔案並產出整理報告 → 同時讓知識庫助理可以回答「這次整理做了什麼?」

    以下用簡化版 pseudo-code 示意 GAIA 專案結構與關鍵程式碼。

    專案結構

    my-gaia-local-agents/
    ├── gaia_config.yaml       # GAIA 全域設定(LLM, 日誌, sandbox)
    ├── agents/
    │   ├── planner_agent.py
    │   ├── fileops_agent.py
    │   └── knowledge_agent.py
    ├── tools/
    │   ├── file_tools.py      # 檔案操作工具
    │   └── vectordb_tools.py  # 內網知識庫檢索
    ├── workflows/
    │   └── organize_and_report.py
    └── main.py
    

    1. 定義本地 LLM backend

    假設你用 Ollama + Qwen2.5 7B 作為通用模型(Apple / GPU / CPU 都能跑):

    # gaia_config.yaml
    llm_backends:
      default:
        type: http
        base_url: "http://localhost:11434/v1"
        model: "qwen2.5:7b"
        # 重要:明確限制 context 和輸出長度,避免拖慢整體 workflow
        params:
          max_tokens: 512
          temperature: 0.3
          top_p: 0.9
    
    logging:
      level: INFO
      file: "logs/gaia.log"
    
    sandbox:
      file_root: "./sandbox_root"   # FileOps 只允許在這之下操作
      allow_network: false           # 預設工具無網路
    

    實際好處:

    • 用 HTTP LLM backend,你可以隨時切換到 llama.cpp server / MLX server / vLLM 而不用改 Agent 邏輯。
    • max_tokens + temperature 控制對本地效能非常關鍵,避免一個 Agent 把整個 context 塞爆。

    2. 定義工具:檔案操作與向量檢索

    # tools/file_tools.py
    from gaia import tool
    from pathlib import Path
    
    SANDBOX_ROOT = Path("./sandbox_root").resolve()
    
    @tool(name="list_files", description="列出目錄下的檔案與大小")
    def list_files(path: str) -> dict:
        root = (SANDBOX_ROOT / path).resolve()
        assert root.is_dir() and str(root).startswith(str(SANDBOX_ROOT)), "path out of sandbox"
        files = []
        for p in root.iterdir():
            if p.is_file():
                files.append({"name": p.name, "size": p.stat().st_size})
        return {"files": files}
    
    @tool(name="move_file", description="移動檔案到新資料夾")
    def move_file(src: str, dst: str) -> str:
        src_path = (SANDBOX_ROOT / src).resolve()
        dst_path = (SANDBOX_ROOT / dst).resolve()
        assert str(src_path).startswith(str(SANDBOX_ROOT))
        assert str(dst_path).startswith(str(SANDBOX_ROOT))
        dst_path.parent.mkdir(parents=True, exist_ok=True)
        src_path.rename(dst_path)
        return f"moved {src} to {dst}"
    

    幾個關鍵點:

    • 用 @tool 裝飾器,GAIA 會自動產生給 LLM 用的工具 schema。
    • 使用 sandbox_root + startswith 檢查,避免 Agent 亂動整個檔案系統。

    向量檢索工具(略寫):

    # tools/vectordb_tools.py
    from gaia import tool
    from my_vectordb import search
    
    @tool(name="kb_search", description="在內網知識庫中搜尋相關文件")
    def kb_search(query: str, top_k: int = 5) -> list:
        return search(query, top_k=top_k)
    

    3. 定義 Agents

    # agents/planner_agent.py
    from gaia import Agent
    from gaia.llm import LLMClient
    
    llm = LLMClient.from_config("default")
    
    planner = Agent(
      name="planner",
      llm=llm,
      tools=[],  # Planner 不直接動檔案
      system_prompt="""
    你是任務規劃專家。使用簡短 JSON 回覆,包含 steps,
    每個 step 指定要由哪個 agent 執行(fileops 或 knowledge)。
    """
    )
    
    # agents/fileops_agent.py
    from gaia import Agent
    from gaia.llm import LLMClient
    from tools.file_tools import list_files, move_file
    
    llm = LLMClient.from_config("default")
    
    fileops = Agent(
      name="fileops",
      llm=llm,
      tools=[list_files, move_file],
      system_prompt="""
    你負責安全地整理檔案,只能使用提供的工具操作 sandbox 內的路徑。
    每次操作前先列出檔案,再決定如何移動。
    """
    )
    
    # agents/knowledge_agent.py
    from gaia import Agent
    from gaia.llm import LLMClient
    from tools.vectordb_tools import kb_search
    
    llm = LLMClient.from_config("default")
    
    knowledge = Agent(
      name="knowledge",
      llm=llm,
      tools=[kb_search],
      system_prompt="""
    你是內網知識庫助理,先呼叫 kb_search 找到相關內容,
    再用找到的內容回答使用者問題。
    """
    )
    

    4. Workflow:協調多代理 + 任務恢復

    # workflows/organize_and_report.py
    import json
    from gaia import Workflow
    from agents.planner_agent import planner
    from agents.fileops_agent import fileops
    from agents.knowledge_agent import knowledge
    
    class OrganizeWorkflow(Workflow):
        def run(self, target_dir: str):
            # 1) 用 planner 拆解任務
            plan = planner.run_sync(f"請為資料夾 {target_dir} 制定整理計畫,輸出 JSON 格式。")
            steps = json.loads(plan["content"]).get("steps", [])
    
            history = []
            for step in steps:
                agent_name = step["agent"]
                instruction = step["instruction"]
    
                if agent_name == "fileops":
                    result = fileops.run_sync(instruction)
                elif agent_name == "knowledge":
                    result = knowledge.run_sync(instruction)
                else:
                    continue
    
                history.append({"agent": agent_name, "instruction": instruction, "result": result})
                self.save_checkpoint(history)  # **關鍵:長任務可恢復**
    
            return history
    
        def save_checkpoint(self, state):
            with open("./state/organize_checkpoint.json", "w") as f:
                json.dump(state, f, ensure_ascii=False, indent=2)
    

    最後入口:

    # main.py
    from workflows.organize_and_report import OrganizeWorkflow
    
    if __name__ == "__main__":
        wf = OrganizeWorkflow()
        history = wf.run("downloads")
        print("任務完成,歷史記錄:")
        print(history)
    

    實際好處:

    • Workflow + checkpoint 讓你可以安全跑幾十分鐘的整理任務,中途 crash 可恢復。
    • 檔案操作與知識庫檢索被清楚拆成不同 Agent,權限與日誌都更好控管。

    建議與注意事項

    1. 模型大小與上下文限制:先決策、再堆功能

    • 本地 Agent 系統最常見的坑是 一開始就選太大模型 + 太大 context:
    • Apple 32GB + 27B 模型 + 128k context 幾乎一定卡。
    • 建議流程:
    • 先用 7–9B 模型 + 8k–16k context 做 MVP。
    • 觀察 GAIA 的日誌與 latency 再決定是否升級模型或 context。
    • 用「多輪互動 + 工具」彌補模型容量,而不是盲目換大模型。

    2. 工具執行安全 & sandbox 設計

    • 檔案操作請一定:
    • 使用 sandbox root + path 檢查(如上例)。
    • 禁用 rm -rf 類型操作,必要時只暴露「移動到 trash」工具。
    • 若 Agent 需要網路:
    • 以 proxy 工具封裝(如 http_get),不要讓 Agent 任意發 HTTP。
    • 在工具層加 domain allowlist。

    3. 長任務與錯誤恢復

    • GAIA workflow 必須:
    • 對每個工具呼叫與 Agent 回應寫入結構化 log(JSON)。
    • 週期性 checkpoint 中間狀態(如上例 save_checkpoint)。
    • 常見錯誤種類:
    • LLM 回 JSON 解析失敗 → 在 workflow 層加入重試 + 自我修復 prompt(要求模型只回合法 JSON)。
    • 工具拋例外(路徑不存在、權限錯)→ 在工具層 catch,回傳結構化錯誤訊息給 Agent 解讀,而不是直接 crash。

    4. 本地 vs 雲端 Agent:怎麼選?

    適合用 GAIA 本地落地的場景:

    • 需要處理敏感檔案 / 內網知識庫(法務、醫療、R&D 原始碼)。
    • 需要低延遲 + 高互動頻率的工具呼叫(檔案整理、CI/CD 助理、開發環境助手)。
    • 有穩定的本地硬體(Mac Studio / 工作站 / 甚至改造手機當常駐節點,如 Xiaomi + Ollama 案例)。

    仍應用雲端 Agent 平台的情境:

    • 短期 PoC,需要快速試多種 SOTA 模型(如 GPT-4.1, Claude 3.7)。
    • 任務高度 bursty,需要按需擴容,或併發數百以上的 Agent 任務。
    • 需要平台級功能(RBAC、審計、隊列管理)而你不想自己實作。

    實務建議:

    • 先在雲端 Agent 平台驗證 prompt、工具設計、整體 UX。
    • 穩定後再把核心工作流搬到 GAIA + 本地 LLM 上,對敏感資料與長任務特別划算。

    總結:GAIA 提供的是一個 在本地硬體上「可觀測、可控、可擴展」的多代理骨架。搭配 Apple Silicon/桌機 GPU 的本地 LLM 加速(--ai-tune、DFlash 等),你可以在單機上跑出相當實用的 AI Agents,而不再被雲端 API 綁死。關鍵是:先把 Agent / 工具 / Workflow 的邊界切清楚,再談模型與效能優化。

    🚀 你現在可以做的事

    • 先在 Ollama 或 llama.cpp 上跑一個 7B 模型
    • 按本文結構拆出 planner、fileops、knowledge 三個 Agent
    • 先用 sandbox_root 做安全檔案操作,再逐步加上 checkpoint 與 kb_search