標籤: AI 趨勢

  • Chrome 偷塞 4GB 模型,踩到瀏覽器戰爭的新雷區

    Chrome 偷塞 4GB 模型,踩到瀏覽器戰爭的新雷區

    📌 本文重點

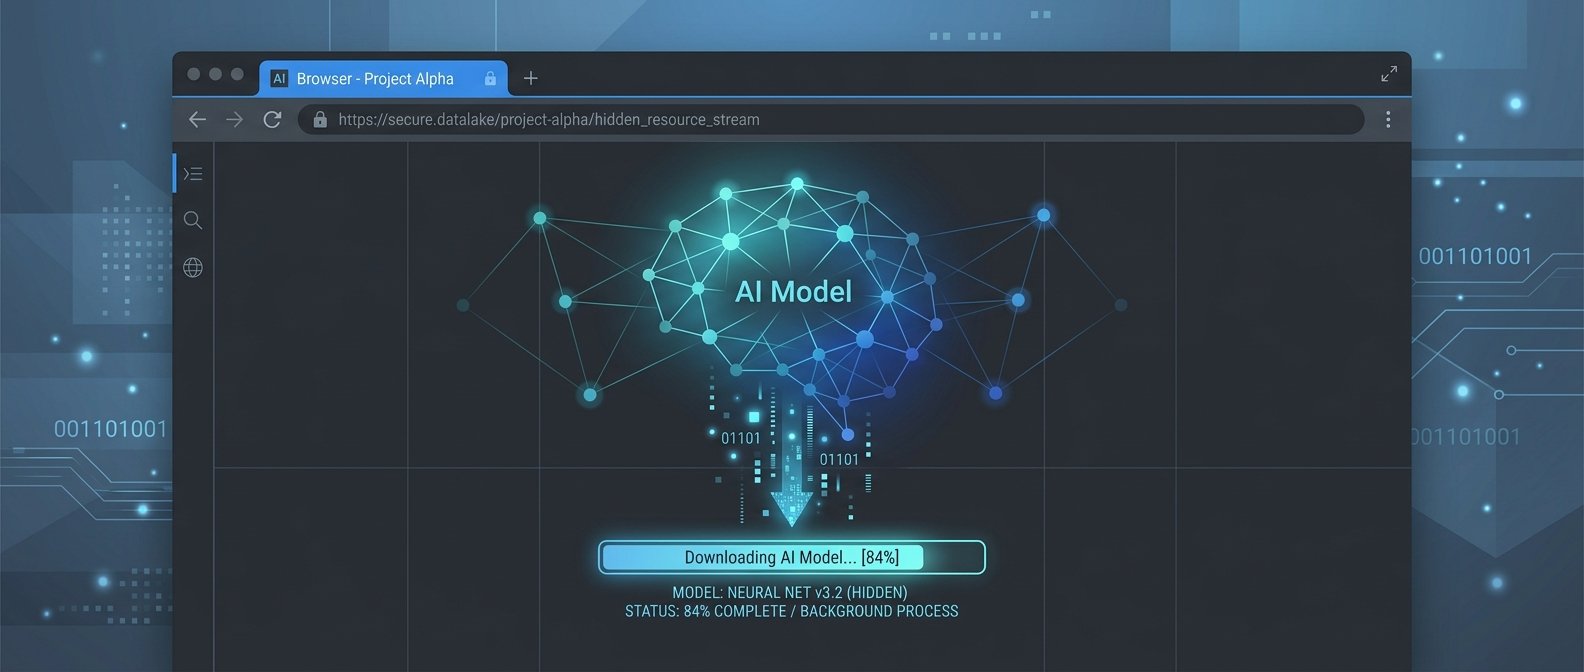
    • Chrome 默默塞入 4GB 本地 AI 模型,瀏覽器正變成隱形 OS
    • 本地 AI 等於新一層追蹤與權限風險,缺乏透明度問題巨大
    • 監管將從「模型安全」走向「部署與預設值」治理,透明與可關閉成新護城河

    第一時間就先把立場講明白:Chrome 在未經明確告知與同意的情況下,默默塞進 4GB 本地 AI 模型,代表瀏覽器正式走向「隱形 OS」——也正式踩進用戶權益與監管紅線。 這不是單一產品決策,而是整個 AI 產業競賽邏輯,被擠壓到瀏覽器這個前線的結果。


    為什麼 Google 非得把 AI 塞進瀏覽器?

    先理解動機,才能理解這次為何如此「硬上」。

    1. 成本壓力逼出本地推論
      雲端推論一問一答都在燒錢。Google 要把 AI 整合進搜尋、Workspace、Chrome,如果全部丟雲端推,等於在自家核心業務上加了一層永久稅。把 約 4GB 的模型直接塞進 Chrome,就是把一部分推論成本,轉嫁到用戶 CPU、GPU 和 SSD 上——而且不必問你願不願意。

    💡 關鍵: 把約 4GB 模型塞進 Chrome,是把原本在雲端燒的 AI 成本,直接轉嫁到使用者的個人硬體與儲存空間上。

    1. 瀏覽器是唯一全平台「強入口」
      終端 OS 被 Apple、Microsoft 卡死,行動端還要面對 App Store gatekeeping。瀏覽器是 Google 唯一能在 Windows、macOS、Android、甚至 iOS 上,直接「下放能力」到終端的通道。要把 AI 變成「基本設施」,Chrome 就一定會被當成系統級 runtime 來用。

    2. 和 OpenAI/Anthropic/Apple 的賽局
      今天 OpenAI 可以透過桌面 App、API 變成開發者的默認 AI runtime;Apple 則在 WWDC 把「Apple Intelligence」綁死在裝置與 OS 層。Google 若不在瀏覽器層直接「預裝 AI」,就等於把入口讓給別人。這是一場誰先占領「用戶默認環境」的戰爭,而 Chrome 是 Google 手上最後一塊最大棋盤。

    所以,從商業與技術角度看,Google 做「本地模型深度嵌入 Chrome」幾乎是必然。但這不代表它可以默默下載 4GB 模型,還假裝這只是例行更新。


    瀏覽器變「隱形 OS」:AI bloatware 與追蹤地獄的起點

    這次爭議最糟糕的地方,不是「模型有多大」,而是它被當成一個不用解釋、不用選擇的系統組件。這宣告了瀏覽器的新角色:

    瀏覽器不再只是裝網頁的容器,而是 AI 的隱形作業系統。

    問題是,OS 級元件如果沒有 OS 級透明度與控制權,後果會非常醜。

    從「外掛」變「預載」:bloatware 的歷史重演

    PC 時代,我們痛恨電腦一開機就塞滿預載軟體:吃資源、難移除、還常常在背後傳資料。今天 Chrome 偷塞 4GB 模型,本質是一樣的邏輯,只是換了 AI 皮。

    差別在於:

    • 模型可以持續更新變大,不是一次性安裝
    • 模型推論過程本身可能 生成、蒐集高敏感度語境資料
    • 模型輸出的行為,又會反過來影響你在網頁上的決策與行為

    如果瀏覽器變成「不可關的 AI 後台」,那不是功能加值,而是結構性風險。

    過去十年我們在跟 Cookie、第三方追蹤碼、指紋辨識打游擊戰。現在,瀏覽器內建模型等於多了一層「在你畫面上思考的程式」,它可以:

    • 看你打的每一行字(輸入法式的監聽問題再現)
    • 理解你看的每一個頁面內容(語意層追蹤)
    • 根據這些語境優化建議、搜索、甚至廣告

    如果這一切都是在「你以為只是打開一個瀏覽器」的前提下默默進行,那跟我們過去批評的黑箱推薦演算法、暗黑模式,完全是同一脈絡,只是換了一個更聰明也更難看懂的殼。

    💡 關鍵: 內建 AI 模型讓瀏覽器可以理解「你在看什麼、打什麼」,從追蹤點擊與 Cookie,升級到直接監聽完整語境。

    AI 模型進政府預審,瀏覽器卻免「知情同意」?

    有趣的對比是:Google、Microsoft、xAI、OpenAI、Anthropic 這些公司,已經和美國商務部旗下 CAISI(Center for AI Standards and Innovation) 合作,允許政府在模型公開前做前置審查與國家安全測試,甚至提供降低安全柵欄的版本來驗證風險。

    同一批公司在國安層面願意接受預審,卻在消費者端直接把 4GB 模型塞進百萬台終端,連一個清楚的彈窗選項都沒有。

    這對監管者來說,是非常明顯的訊號:業者知道 AI 有風險,知道要在高風險情境前置審查,卻在最貼近用戶生活的環境選擇「先上車再說」。 這就是未來被立法「修理」的最佳素材。


    Siri 誇大被罰、AI 模型預審上路:監管已在給市場畫線

    Chrome 塞模型這件事,若放在近期幾個案例旁邊看,脈絡會更清楚。

    Apple 因 Siri 誇大 AI 功能被求償 2.5 億美元

    Apple 因為在 Siri 的 AI 功能上過度行銷、實際落地嚴重延遲,最後選擇以 2.5 億美元和解。這案子傳遞的訊號是:

    • AI 功能不是「講爽的」,功能成熟度與溝通內容不匹配,會直接變成法律與金錢風險
    • 用戶對 AI 的期待,一旦被引導到某個高度,就會被法院視為「合理期待」

    Apple 是因為「說太多」被罰,而 Google Chrome 這次是「說太少」——甚至不說。兩者看似相反,實際上在監管者眼中是一體兩面:都在處理 AI 部署的誠實與透明問題。

    💡 關鍵: Siri 被罰 2.5 億美元,顯示「AI 能力講過頭」要付現金代價;Chrome 這種「不講清楚就部署」同樣是另一種高風險不誠實。

    模型國安預審:AI 變成「類核技術」級別基礎設施

    美國政府透過 CAISI,已經拿到 Anthropic、OpenAI、Google DeepMind、Microsoft、xAI 等公司最新模型的「預發布存取權」,用於國家安全測試。 White House 甚至討論要導入更廣泛的模型上線前政府審查流程。

    這種做法本質上是在宣告:

    • 大型 AI 模型不再被視為一般軟體,而是類戰略物資
    • 高風險能力必須在部署前,對「可能傷到誰」做出交代

    如果模型都要在國家安全層面預審,那麼當模型被默默部署到十億用戶的瀏覽器裡,卻沒有清楚的知情同意與關閉機制,監管者遲早會追問:為何在國家安全面前可以謹慎,在消費者權益面前卻可以粗暴?

    監管下一步:從模型審查走向「部署治理」

    目前的政策焦點還在「模型本身危不危險」。但這次 Chrome 事件會加速一個轉向:監管會開始管「模型怎麼被塞進用戶環境」。可能的方向包括:

    • 要求本地 AI 組件層級的顯示與管理界面(就像系統權限頁面)
    • 強制標示模型大小、資源占用、資料流向
    • 禁止在預設開啟狀態下收集特定敏感資料,除非有明確 opt-in

    一句話:模型審查只是上半場,下半場是部署與默認值的治理。


    開發者與企業:別再迷信「預設開啟」,透明+可關閉才是新護城河

    這件事對開發者與企業的真正啟示是:「預設開啟的 AI 能力」在監管與市場上都會越來越貴。 具體可以歸納成三點行動建議:

    把「AI 開關」當成一級產品需求,而不是設定頁腳的一行字

    • 任何會在本地常駐、持續監聽(鍵盤、麥克風、螢幕內容)或會吞大量資源的 AI 功能,一律需要顯性開關與清楚說明。
    • 不要只給「關閉推薦」這種模糊選項,而是拆成:
    • 是否下載/保留本地模型
    • 是否允許背景啟動
    • 是否允許上傳使用記錄作為訓練資料

    設計「最小可用 AI」而非「最大可見 AI」

    • 少用「一刀切全局代理」,多用場景式、任務式 AI 功能(例如:只在你按下 summarise 時才啟動模型)。
    • 本地模型可以是選配,而非隱形預載:先提供雲端模式+明確提示本地模式優劣,讓用戶自行選擇是否下載那 4GB。

    把「透明+可關閉」變成品牌資產,而不是合規負擔

    • 未來監管與集體訴訟只會比 Siri 那案更兇。誰先把 AI 部署的透明度、可關閉、可刪除資料流程做清楚,誰才有資格談「信任護城河」。
    • 對開發者而言,這不只是風險控管,也是差異化機會:敢在設定頁清楚寫出模型版本、大小、更新頻率、資料走向的產品,在一片黑箱裡會顯得非常不一樣。

    對使用者來說,短期內也只有一個務實建議:

    • 能選擇瀏覽器就別只用一個,把 AI 嵌入策略最「誠實」、開關最清楚的那個,當你的主力工具。 用行為投票,比在社群上抱怨更有效。

    Chrome 偷塞 4GB AI 模型,真正畫出的底線是:AI 不再是雲端玩具,而是本地基礎設施;但誰把它當黑箱塞進來,誰就會在下一輪監管與市場修正裡付出代價。


    🚀 你現在可以做的事

    • 打開你常用瀏覽器的設定頁,檢查是否有本地 AI、隱私與資料上傳相關選項,逐一確認與關閉不必要功能
    • 嘗試安裝第二個瀏覽器,實際比較各家對 AI 功能的說明透明度與開關粒度,再決定主力工具
    • 若你是開發者或產品負責人,列出產品中所有「預設開啟」的 AI 功能,為每一項設計清楚的說明文案與顯性開關頁面
  • 白宮想先審模型?問題問錯了

    白宮想先審模型?問題問錯了

    📌 本文重點

    • 風險應鎖定「系統用途」,而非只看模型大小
    • 模型級事前審查恐強化巨頭壟斷與開源地下化
    • 高風險應用需系統級風控與用途分級監管
    • 監管若只管模型,AGI 軍備競賽將在黑箱中加速

    白宮打算對前沿 AI 模型事前審查,在政治上看起來是「負責任的創新」,但從產業與開發者視角來看,這更像是一種把風險簡化成『模型大小』的錯配治理。在高風險模型應被嚴管這點上,產業其實並不反對,真正的問題是:把關重心放在「模型本身」而不是「系統行為與用途」──會不會既管不好風險,也凍結了錯誤的環節?


    一、白宮看「模型」、五眼看「代理」:監管焦點正在錯位

    先看兩個同步發生的訊號:

    • 白宮討論的是:新一代大型模型(尤其是 frontier models)在發布前要不要先交政府審查,檢測危害能力、決定能不能上線。
    • 五眼聯盟(CISA、NCSC 等)最新的聯合指引,針對的卻是 agentic AI:多代理系統、自主工作流、具持續行動能力的 AI pipeline,明確要求企業在部署前優先考慮韌性與控制, 而不是生產力。

    這兩種路線反映的是兩個不同的威脅模型:

    1. 模型級風險敘事:
    2. 典型畫面是:一個超強模型,一次性釋出後就能讓駭客、恐怖分子瞬間升級。
    3. 治理直覺是:先審後放,像藥品或核能一樣,管住最大顆的東西。

    4. 系統與代理級風險敘事(五眼路線):

    5. 真正危險的不是「模型會回答什麼」,而是代理如何持續行動、調用工具、串接其他系統。
    6. 指引已經把威脅焦點,從單一 LLM 能力,移到「可自動執行任務、能自己發 API call、能在網路上持續探索」的整體系統。

    如果你在做 Agent pipeline,就會知道:

    同一個模型,丟在聊天機器人裡多半是 CSR 升級版;串上瀏覽器、交易 API、RPA、向量庫,再加個 loop,立刻變成「半自主決策系統」。

    從風險工程的角度,白宮現在盯的是錯誤層級。

    • 模型的「潛在有害能力」當然重要,但真正導致事故的,多半是:
    • 沒有限制的工具權限
    • 沒有監督的人機分工
    • 沒有審計的自動化決策鏈
    • 五眼的文件,本質上是在對企業說:「請準備好接受針對『系統行為』的合規審查。」

    💡 關鍵: 真正高風險多發點在「系統與代理行為」,而不是單一模型能回答什麼問題。

    這就是為何很多安全研究者一邊支持 Stuart Russell 對 AGI 軍備競賽的警告,一邊又對「模型級事前審查」保持保留:

    風險是真實的,但管錯層級,只會讓產業付出巨大成本,卻沒有相稱的安全收益。


    二、誰最愛模型審查?巨頭、開源與企業的三角張力

    從產業結構看,「模型級事前審查」直接重塑競爭版圖:

    1. 巨頭:安全、合規、護城河三合一

    對 OpenAI、Google、Anthropic、Meta 這類巨頭來說:

    • 合規成本:可以用數百人安全團隊、專職律師、外部第三方審查來消化,甚至變成 PR 資產——「看,我們是政府認證的安全實驗室」。
    • 監管內化成護城河:
    • 一旦 frontier models 必須事前審查,
    • 真正能玩得起的人,只剩少數幾家,
    • 監管變成規模經濟,新進者被擠在門外。

    這點在 Musk v. Altman 案件中看得很清楚:

    • Musk 指控 OpenAI 背棄非營利承諾,實質抱怨的是:OpenAI 變成了高度商業化 + 高度閉源 + 高度集權的 AI 供應商。
    • 但諷刺的是,一旦政府採用模型級事前審查,這種「昂貴、閉源、只有少數巨頭玩得起的模式」反而會被制度強化。

    2. 開源與中小實驗室:不是被管死,就是被推向灰色地帶

    對開源社群與中小團隊,模型審查是另一個故事:

    • 合規成本不成比例:
    • 你可能有能力在單一 A100 上訓一個 7B 模型,
    • 但你絕對沒能力維護一個能應付多輪政府審查的法務團隊。
    • 法規如果切在「參數規模/算力門檻」,看似只管最前沿,其實會:
    • 把很多有野心但沒預算的團隊,推往灰色與海外託管(繞到較寬鬆司法區訓練與發布)。
    • 鼓勵「算力打補丁」:大家拼命在可管制門檻以下做 model souping、蒸餾、長上下文、工具接入,風險依舊上升,但法律只看到「這不是 frontier model」。

    Local LLaMA 社群早就看出這個方向:

    當主權國家開始嚴控「模型發布」,真正的創新會往開源地下化、跨境部署、分散式訓練走,而不是乖乖排隊等審查。

    3. 企業用戶:安全感上升,靈活度下降

    對企業應用端來說,模型級審查有一好一壞:

    • 好處:
    • 上層管理層可以對董事會說:「我們用的是通過白宮審查的模型」,責任轉嫁變容易。
    • 在某些高風險領域(金融、醫療、關鍵基礎設施),這確實能提供更明確的責任邊界。
    • 壞處:
    • 合規是雙面刃,取得新模型的周期延長、選項變少,反而加強對少數供應商的鎖定。
    • 真正的風險——例如把模型接到內部交易系統、供應鏈決策、敏感客戶數據——仍然出現在系統設計與部署層, 而不是模型發布本身。

    如果你是企業技術主管,真正該問的不是「這個模型有沒有被白宮審過」,而是:

    我們的 agent pipeline、tooling、權限管理、審計與風控,有沒有對齊五眼那種系統級安全要求?


    三、當安全變成政治敘事:Musk、Altman 與 AGI 軍備競賽

    Musk v. Altman 訴訟與 Stuart Russell 對 AGI 軍備競賽的憂慮,表面上看是道德與安全之爭,實際上也在塑造監管框架的「敘事戰場」。

    • Musk 陣營:
    • 一方面在法庭上指責 OpenAI 背棄「造福人類」使命,
    • 一方面透過 xAI 積極追 frontier models,
    • 同時主張政府應嚴控其他實驗室,避免 AGI 軍備競賽失控。
    • Russell 作為 Musk 唯一的 AI 專家證人,強調政府要「約束最前沿實驗室」,避免 RSI(遞迴自我改進)引爆全球安全風險。

    把這些放進 Jack Clark 的判斷就更有張力:

    • 他認為 2027 年底 AI 能自動化 AI 研究機率約 30%,2028 年底超過 60%,也就是說:
    • frontier labs 很快可以用 AI 自己加速模型研發與訓練效率(報告中提到甚至高達 52 倍訓練效率提升)。
    • 一旦這種「AI 幫你造更強 AI」的 RSI 開始滾動,監管節奏就很難跟上。

    💡 關鍵: 若 AI 研發效率可能提升到「52 倍」,監管滯後的代價會被成倍放大。

    於是,我們看到三層混在一起的敘事:

    1. 政治:
    2. 白宮需要在「保護國家安全」與「維持科技領先」之間找到說得出口的姿態。
    3. 模型事前審查,對選民來說很好理解,遠比「我們要管 agent pipeline 的系統風險」好賣得多。

    4. 商業:

    5. frontier labs 一邊喊著安全,一邊積極構建「只有我們玩得起」的閉環——模型、資料、算力、合規一起變成壟斷資本。
    6. 模型級審查完美對齊這個商業結構。

    7. 安全:

    8. 嚴肅學者(如 Stuart Russell)真正擔心的是 全球性的 AGI 軍備競賽與 RSI,而不是單一 GPT-5.5 有多會寫程式。
    9. 但當這種抽象的長期風險,被翻譯成具體政策工具時,往往就被縮減為「管住最大顆的模型」。

    問題是:如果監管只剩「模型級審查」,那 AGI 軍備競賽只會從「沒管」變成「在少數國家與少數巨頭之間悄悄進行」。

    💡 關鍵: 一刀切的模型審查,可能只是把 AGI 軍備競賽推進更不透明、更集中化的黑箱。


    結論:支持嚴管高風險用途,反對一刀切模型審查

    綜合以上,合理的立場應該是:

    • 支持:對 高風險用途(金融交易、醫療診斷、關鍵基礎設施、軍事、選舉操控等)實施精準管制,
    • 要求系統級安全測試、審計、記錄、紅隊演練、責任追溯,
    • 對真正接近 RSI 或 AGI 能力的實驗室,施加額外的透明度與國際協調約束。
    • 質疑:以「參數規模/算力」或單一模型能力,作為事前審查的主要依據;這會:
    • 強化巨頭壟斷,
    • 把創新推向少數國家與黑箱實驗室,
    • 忽略系統與代理行為才是風險主戰場。

    對開發者與企業使用者,我的具體建議是:

    1. 把資源從「追最新模型」轉到「設計安全的系統」:
    2. 投資在權限分級、tool sandbox、可觀測性、審計 log、fail-safe 機制。
    3. 主動對照五眼的 agentic AI 指引,把它當成未來合規底線,而不是選配。

    4. 在組織內部建立「用途級風控」而非「模型級封殺」:

    5. 針對不同用途定義風險等級與流程,而不是僅僅禁止某些模型。
    6. 對高風險應用,預先準備內部審查機制,未來才能更平順接軌外部監管。

    7. 對監管參與發聲:要求以系統行為為單位的分級監管:

    8. 開發者社群、產業協會、企業技術主管,都應主動向政策制定者傳遞一個訊息:
    9. 真正需要的是「用途與系統級」的細緻分級,而不是對模型一刀切的事前審查制度。

    如果我們放任「模型級審查」成為預設答案,AI 的未來很可能會被鎖進少數實驗室與少數國家的鐵盒子裡;
    而一個真正安全、具有韌性且多元競爭的 AI 生態,正好需要相反方向:把監管精準落在系統行為、用途與部署場景上。

    🚀 你現在可以做的事

    • 實際檢查自家 agent pipeline(工具權限、審計 log、fail-safe)是否符合五眼對 agentic AI 的系統級安全指引
    • 在公司內部建立「用途級風控流程」,為高風險 AI 應用設計專門審查與紀錄機制
    • 透過產業協會或公共諮詢,向監管機關回饋:應將監管焦點放在系統行為與用途,而非單純模型大小
  • OpenAI 出走 Azure:真正開打的是編排戰

    OpenAI 出走 Azure:真正開打的是編排戰

    📌 本文重點

    • 微軟失去 GPT 獨占後轉向 Copilot 平台與企業 AI 內網
    • OpenAI 採多雲策略,讓雲鎖定變成 CTO 的談判籌碼
    • 模型正被商品化,agent / workflow 編排層成為新戰場

    第一天重寫合約、第二天登陸 AWS:OpenAI 出走 Azure 不是單一合作案調整,而是 AI 基礎設施從「單一陣營封閉堆疊」走向「模型可替換、編排層爭王」的拐點。真正緊張的,已經不是誰獨占 GPT,而是誰能掌握 agent / workflow 編排層。


    一、微軟失去獨占後:從「賣 GPT」轉向「做 Copilot 平台」

    從公開資訊看,新協議的幾個關鍵變化非常清楚:

    • 獨占權撤除:Microsoft 不再擁有 OpenAI 技術獨家授權,OpenAI 可在任意雲提供服務(The Decoder 報導)。
    • AGI 條款移除:不再綁定「達成 AGI 後收益分配」這種高度不確定的對賭。
    • 收入分成改寫:華爾街消息指出雙方停止原本的廣泛營收分成,合作關係轉為更清晰的「基礎設施 + 產品互利」。

    💡 關鍵: OpenAI 從單一雲獨占改為可上任意雲,直接打開「模型可替換、多雲競價」的新局。

    這對微軟的真正衝擊是:

    1. Azure OpenAI 不再是「非來不可」

    以前,想合法、穩定、企業級地用 GPT,幾乎只能走 Azure OpenAI Service。現在 OpenAI 模型上 AWS Bedrock、OpenAI on AWS 一次到位,雲端客戶多了一條毫無心理負擔的逃生門。

    1. Copilot 必須模型多元,不能再押單一 GPT 牌

    這其實加速了微軟原本就在做的事:

    • Office、Windows 的 Copilot 早就混用自研模型與 OpenAI 模型;
    • GitHub Copilot 也逐步引入 自研與第三方模型。

    失去獨占後,微軟更沒有理由把產品體驗綁死在單一供應商上。未來你在 Word 叫出的 Copilot,很可能背後是 「哪個模型便宜又好就動態切」,OpenAI 只是候選之一。

    1. Azure 的主戰場,從「托管 GPT」變成「托管企業 AI workflow」

    微軟在這局裡的理性選擇是:

    • 把 GPT 視為眾多模型之一,
    • 把資源押在 安全、治理、資料整合、M365 / Dynamics 內嵌 AI workflow,
    • 用 Copilot Studio、Azure AI Studio 搶的是「企業把流程編排、權限、工單、資料管線全交給我」的編排權,而不是「一定要用我的 GPU 跑 OpenAI 模型」。

    換句話說:微軟從「獨門模型供應商」退位,改當「企業 AI 內網總包商」。賭注不在 OpenAI 學身上,而是押在自己能不能把 Copilot 做成企業的 AI 作業系統。


    二、OpenAI 多雲策略:幫 CTO 把「雲鎖定風險」變成談判籌碼

    對 OpenAI 來說,這次改寫協議最核心的戰略,就是從「被單一雲綁架」轉向「讓所有雲來搶我」。這對企業 CTO 的影響,比媒體標題寫的還大。

    1. 技術與合規:多雲從理想變成選項

    2. OpenAI 一天內登上 AWS Bedrock + OpenAI on AWS,加上既有的 Azure,等於直接覆蓋了主流雲。

    3. 再搭配 FedRAMP Moderate 認證(OpenAI Blog),OpenAI 現在能正式進入美國聯邦與高安全需求產業。

    這意味著:

    • 金融、醫療、政府等領域,不再被迫在「合規雲」與「最好模型」之間二選一;
    • CTO 可以在 同一合規框架內做多雲部署,把風險從「單點失靈」切成「可轉移、可比價」。

    • 成本與議價:從「續約只能吞」變成「雲商互相殺價」

    過去企業如果大量採用 GPT,要換雲幾乎等於重建整套 AI 堆疊:

    • 身分系統、私有網路、資料湖連接、監控治理,全都跟單一雲深度綁定;
    • 供應商知道你轉移成本極高,價格、配額、SLA 的談判籌碼在對方手上。

    現在局面反過來:

    • OpenAI 同時在 Azure / AWS 提供,未來很可能也會上 GCP 或地區雲;
    • 企業可以要求:同一套 API、同一版模型,在不同雲做壓價與冗餘配置。

    結果是:

    • 雲商為了守住你這個客戶,會主動在 網路傳輸費用、Reserved Instances、整體帳單信用額度 上讓步;
    • OpenAI 自己也被迫在 定價、用量折扣、自管 vs 託管 agent 模式上更透明,因為 AWS / Azure 可以被拿來對比。

    💡 關鍵: 多雲部署讓企業能在同一套 OpenAI API 上,直接利用不同雲商互相殺價,反轉過去「續約只能吞」的被動局面。

    1. 策略風險:CTO 的真正問題變成「鎖在哪一層」

    多雲聽起來很自由,但新的鎖定點會往上移到:

    • 你選的 agent / workflow 平台(例如 Bedrock Agents、Azure AI Studio、第三方 Orchestrator),
    • 你如何定義 tool schema、任務分解邏輯、觀測與監控。

    如果這一層建在單一雲原生服務上,你仍然被鎖,只是從「GPU 層」挪到「編排層」。

    真正成熟的 CTO 會做的,不是盲目多雲,而是:把業務邏輯封在「可移植的編排層(自建或第三方)」,讓底下模型和雲可以換。


    三、AWS 閃電上架 OpenAI:宣告「模型是商品,agent 才是入口」

    OpenAI 協議一改,AWS 隔天就上線 OpenAI 模型與 Managed Agents(The Decoder、TechCrunch)。這個速度本身就是訊號:

    誰先搶到「開發者預設打開的 agent / workflow 平台」,誰就佔住了新一代「應用商店」的位置。

    1. 模型供應層:變成貨架,而不是護城河

    在 Amazon Bedrock 上,OpenAI 模型只是眾多選項之一:

    • 你可以混用 Anthropic、Cohere、Amazon Titan、自家微調模型;
    • OpenAI 的 GPT、Codex、Managed Agents 被放在同一貨架,重點變成「誰在這個貨架上銷量最高」,而不是「誰獨占整間超市」。

    這是典型的 「平台化去神話」:

    • 大模型被對齊到同一介面、同一計費邏輯;
    • 差異從「我有 GPT 你沒有」變成「在我的平台上,用 GPT 更便宜、更快、更好整合你的 VPC、資料湖、監控系統」。

    • 編排 / Agent 層:新戰場的三個關鍵要素

    AWS、微軟、OpenAI 其實在搶同一個位置:

    • 誰掌握任務分解、工具呼叫、工作流狀態管理的語言與標準;
    • 誰累積到最多「企業級 agent 模板」與最佳實務;
    • 誰的觀測、治理、安全權限模型最符合大型組織的心智模型。

    當 OpenAI Managed Agents 直接出現在 AWS 環境 裡:

    • 對 AWS 而言,它變成吸引開發者留在 Bedrock / Step Functions / Lambda 生態的黏著劑;
    • 對 OpenAI 而言,它在別人的雲內部,嵌了一個「OpenAI 風格的編排語言」,未來要跨雲,就不用從零教育開發者怎麼寫 agent。

    • SaaS 的壓力:你是功能,還是編排系統的一個 node?

    這一波最該焦慮的,反而是中間層 SaaS 供應商:

    • 如果你的產品價值只是「幫客戶把 GPT 串到 CRM / ERP」,
    • 那麼 Azure Copilot Studio、Bedrock Agents + 一堆 connector 很快就會把你變成一個可替換的 plugin。

    相反地,如果你能做到:

    • 給出特定垂直領域的 專業工作流編排、風險控制、監管報告、責任邊界設計,
    • 把自己變成「該產業的 AI 作業系統」,

    那你就可以把底下的 OpenAI / Anthropic / 自研模型,都當成可替換的算力與模型供應層,反向利用這波「模型商品化」。

    💡 關鍵: 模型被擺上同一貨架後,真正稀缺的是「誰控制企業日常運作的 agent / workflow 編排入口」。


    最後:開發者與企業的實際行動清單

    這不是看熱鬧的時間點,而是重新設計 AI 架構的好時機。具體建議:

    1. 對開發者:不要再把自己綁死在「某家雲 + 某個模型 SDK」

    2. 優先學會 多模型路由與降級策略,而不是只會調一個 GPT 參數;

    3. 在架構上,盡量用 自建或雲中立的編排層(例如以自家服務 API 為中心),把雲端特定服務包到 adapter 裡;
    4. 評估使用 Bedrock / Azure AI / OpenAI Agents 時,能否把任務邏輯以「可轉譯」方式封裝,而不是寫滿專屬語法。

    5. 對企業 CTO / 架構師:在未來 12–18 個月內,做三件事

    6. 重寫風險模型:把「供應商鎖定」從 IaaS / 模型層移到編排層來評估,明確定義哪些層級要多雲冗餘,哪些可以單雲換低成本。

    7. 設計可遷移的 agent / workflow 描述:無論是 BPMN、DSL 或 JSON schema,確保工作流可以在不同雲的 orchestrator 之間轉換,而不是鎖在單一雲原生語言。
    8. 把 SaaS 當成節點,而不是最上層:要求 SaaS 供應商提供清晰 API、事件流與權限模型,預設你會用自己的 agent 來 orchestrate 多個 SaaS,而不是反過來被某一家 SaaS 鎖住。

    9. 對產品與商業決策者:開始用「模型可替換」思維做投資決策

    10. 問自己:如果三年後 OpenAI 不是最強模型,我今天這個架構還能不能活?

    11. 把錢花在 資料治理、流程再造、使用者體驗與變革管理,而不是迷信「綁定某家雲 / 某個模型」能買到護城河。

    結論很直接:OpenAI 出走 Azure,真正打開的是 AI 編排層的戰國時代。開發者與企業如果現在還在爭論「要 Azure 還是 AWS」,就等於在手機時代只在意電信商牌子,卻完全忽略誰掌控你的 app store。真正該做的,是趁現在把架構往「模型可替換、編排可攜帶」方向改,讓未來的雲戰與模型戰,變成你手上的議價籌碼,而不是新的技術債。

    🚀 你現在可以做的事

    • 盤點現有專案中與特定雲服務深度綁定的部分,畫出一張「雲鎖定風險地圖」
    • 試用至少一個雲中立的 agent / workflow 編排工具,將一個現有流程改寫成可移植描述
    • 約同 CTO / 產品負責人開一場「模型可替換架構」工作坊,重新檢討未來 3 年的 AI 投資方向
  • Musk vs Altman:AI 聖人敘事的終局審判

    Musk vs Altman:AI 聖人敘事的終局審判

    📌 本文重點

    • Musk vs Altman 官司實際在壓力測試整個「善意非營利 + 營利子公司」AI 模式
    • AI 實驗室將被迫從「聖人敘事」走向條款與治理的赤裸透明
    • 產業競爭重心正從「誰最強」轉向「誰在治理與風險上最不會出事」

    這不是一場八卦官司,而是對整個「善意非營利 + 封閉營利子公司」AI 模式的壓力測試。不論Elon Musk還是 Sam Altman 在法庭上佔上風,OpenAI 這起官司都在針對一個核心問題:當 AGI 被包裝成「造福人類」,公司治理、競爭策略和監管標準是否還能裝作單純的創業故事?


    一、公司治理:保護人類,還是保護估值?

    OpenAI 從一開始的非營利實驗室,到後來成立「OpenAI Global LLC」等營利實體、再加上與 Microsoft 的巨額深度綁定,本來就不是普通人看得懂的結構。Musk 現在在法院主張:當初他掏錢,是因為被承諾這會是一家永遠以非營利為核心、開放造福人類的 AI 實驗室,結果卻變成一家手握封閉模型、準備 IPO、市值千億美元級別的獨角獸。

    💡 關鍵: 從「永遠非營利」到「千億美元獨角獸」,讓捐助變成疑似早期投資,直接動搖 AI 實驗室的道德與法律正當性邊界。

    如果法院最後認定:

    • 早期的「為全人類、開放研究」敘事,在法律上構成對捐助者或早期金主的誤導;
    • 非營利董事會對營利子公司缺乏實質控制,被視為「形式非營利、實質營利」;

    那影響就不只是 OpenAI 能不能上市,而是:

    1. 所有聲稱「為人類福祉」的 AI 實驗室,都得把公司治理文件拿出來重新審視。像 Anthropic 的「公共利益託管基金會」、Google DeepMind 在 Alphabet 內的特殊地位,都可能被投資人要求更透明地揭露「誰真正有最後決定權」。
    2. 未來的「AI 基金會 + 營利公司」雙層結構,條款會變得更殘酷也更誠實。例如:
    3. 明寫:非營利董事會可以在特定條件下改變使命或允許全面商業化;
    4. 對捐助者說清楚:這不是捐給教堂,而是捐給一個可能長成超級獨角獸的前孵化器。

    結論是:Musk 的指控,即便部分被法院否決,也會間接逼 AI 實驗室把「聖人光環」改寫成具體條款。公司治理文件會變厚,宣傳文案會變薄。


    二、產業競爭:別把這當單純的「憤怒前創辦人」戲碼

    Musk 一邊告,一邊推 xAI,這不是矛盾,而是策略。

    • 官司本身在削弱 OpenAI:
    • 法務與高層管理分心;
    • IPO 時程與估值不確定性升高;
    • 內部文件被公開(如 The Verge 彙整的 email、早期架構草案),等於把組織運作和技術路線攤在競爭者面前。
    • 同一時間,xAI、Grok 透過「我們比較開放、我們比較不受 Big Tech 控制」的敘事,搶開發者與技術人才。

    💡 關鍵: 官司既是法律戰,也是品牌與人才戰,讓「反 OpenAI」敘事變成一種具體的市場競爭策略。

    真正值得注意的是旁觀者:Google、Anthropic、Mistral 等玩家怎麼利用這個窗口:

    1. 在 OpenAI 防守時,加速出手搶企業客戶。
    2. 法務纏鬥期間,OpenAI 在大型長約(雲平台、國家級專案)上的談判籌碼變弱;
    3. 競爭者可以用一句話搶單:「你要把核心 AI 能力押在一間可能被法院強制改組的公司上嗎?」
    4. 在「價值敘事」上對沖風險。
    5. Anthropic 可以強調自己的「憲法式 AI」和公共利益信託,暗示「我們從 Day 1 就把治理寫清楚」;
    6. Mistral 則訴求「歐洲式開源 + 主權 AI」,把自己放進「去 OpenAI 化」的宏大敘事裡。

    這場官司實際上加速了一件事:AI 模型不再以「誰最聰明」競爭,而是以「誰在治理與路線上看起來最不會出事」競爭。


    三、資本與監管:AI 聖人光環,不再是盡職調查的折扣碼

    對資本市場來說,Musk v. Altman 在做的一件殘酷但必要的事:

    把「AGI 造福人類」這種軟敘事,硬生生拉回到「股權、控制權、退出路徑」這些冷冰冰的條款上。

    投資人端會出現幾個明顯轉向:

    1. 敬 AI 聖人三分,但合約要寫到血淋淋。
    2. 早期捐助或 SAFE、Convertible Notes 裡,會更明確規定:
      • 未來若引入營利子公司,原捐助者/投資人是否享有轉換或補償機制;
      • 非營利層級的董事會組成、解任機制、與營利層級的資訊權責。
    3. 偏好結構簡單、權責清楚的 AI 公司。
    4. 「基金會 + 雙層股權 + 特殊信託 + 戰略投資」這種四重奏,會開始被打折;
    5. 反而是「單一公司、明確股權、監管可理解」的團隊,在後續輪次會更受青睞。

    💡 關鍵: 未來投資 AI,「公司長得多複雜」反而可能是減分題,簡單透明的結構更容易拿到資本與監管者信任。

    監管機構也不會只是站在邊線:

    • 歐洲、美國、甚至部分亞洲監管單位,很可能把本案當成「教材」,問三個問題:
    • 宣稱追求 AGI 或「公益科技」的公司,是否需要額外披露治理結構與風險?
    • 是否需要創造一種介於「非營利基金會」與「營利股份公司」之間的新類型法人,專門管理這種高外部性技術?
    • 大型 AI 模型是否應比照系統性重要金融機構(SIFI),要求壓力測試、資訊揭露與分離牟利業務?

    關鍵變化是:監管者會開始把「AGI 實驗室」當成潛在的「系統性風險機構」,而不是一般創業公司。


    結語:AI 實驗室,請用「看待華爾街」的方式重新審視

    這場官司真正宣告的是:「一邊說造福全人類、一邊高度封閉圈錢」的曖昧時代正在結束。接下來會是非常赤裸的三件事:

    1. 對開發者:
    2. 把「某實驗室的使命宣言」當成行銷,而不是契約。你真正要讀的是:
      • API 條款、資料使用政策、模型存取權限、停用條件;
    3. 技術棧上要刻意做供應商多元化:至少同時接兩家以上模型(例如 OpenAI + Anthropic / Mistral / xAI),避免任何一家因訴訟、監管或治理事故拖垮你的產品路線。

    4. 對企業採購者:

    5. 在導入大型模型時,盡職調查不能停在「安全白皮書」和「企業方案介紹」,而要問:
      • 公司控制權是否穩定?
      • 是否有潛在法律戰或監管風險,可能導致服務被迫調整?
    6. 你不是在買一個 ChatGPT,而是在押注一整套公司治理與資本結構。

    7. 對一般使用者與社會:

    8. 看待 OpenAI、xAI、Google DeepMind、Anthropic,請用你看待 華爾街投行或大型科技股 的眼光:
      • 他們可以推動進步,但動機永遠是多元的:股價、權力、歷史定位,才不會只有「人類福祉」。

    最務實的態度是:把這些 AI 實驗室當成高風險金融機構,而不是天才托兒所。尊重他們的創新,嚴格審視他們的結構,並為隨時可能發生的治理事故與監管反轉預先設計技術與商業上的備援。

    Musk vs Altman 這場官司,裁決的是誰說了真話;但對整個產業,它正在裁決的是:AI 不再是信仰,而是條款。

    🚀 你現在可以做的事

    • 盤點你目前依賴的 AI 供應商,檢查其公司治理與訴訟/監管風險,並至少規劃一個備援供應商
    • 如果你是開發者,立即閱讀並備份核心 AI 服務的 API 條款、資料政策與停用條件,避免未來突襲調整
    • 若你參與或考慮投資 AI 專案,開始將「治理結構與股權條款審閱」納入標準盡職調查清單
  • 老闆變滑鼠記錄器,AI 還剩多少尊嚴?

    老闆變滑鼠記錄器,AI 還剩多少尊嚴?

    📌 本文重點

    • Meta 把員工當 AI 代理訓練用「行為模擬器」
    • 產業在「多收資料」與「先保護資料」兩路線分裂
    • 模型能力暴衝但資料治理落後,風險呈倍數放大

    這不是單一公司的道德滑坡,而是在 AI 競賽壓力下,整個產業正集體嘗試把「行為監控」重新包裝成「技術創新」。

    問題不在於用資料訓練 AI,而在於:企業開始拿「人怎麼工作」這種最細緻、最貼身的行為軌跡,當成可以隨便開採的礦。

    在這條線上,今天的 Meta 只是走得最粗暴、最高調的一個。


    一、Meta 的 MCI:這不是遙測,是「把人當模擬器」

    根據 Reuters 和 The Verge 報導,Meta 在美國員工電腦上部署 Model Capability Initiative(MCI):

    • 記錄滑鼠移動、點擊、鍵盤輸入
    • 偶爾截圖
    • 在各種工作相關 app 與網站上持續運作
    • 官方保證「不會用於績效評估,只用來訓練 AI 代理」

    💡 關鍵: Meta 強調「不拿來打考績」,但真正關鍵是它把全套細緻行為當成 AI 訓練礦,改變了勞動與監控的邊界。

    表面看,這跟一般企業內部的 遙測(telemetry) 很像:產品崩潰報告、API latency、功能使用頻率……但兩者有一個質的差別:

    傳統遙測是量測「系統怎麼跑」;MCI 是量測「人怎麼活在系統裡」。

    一般遙測:

    • 收的是「事件」:某按鈕被點、某 API 被打
    • 多半是彙總後的統計數據,與個別員工弱綁定
    • 與 AI 訓練有關,但更多用於產品優化與穩定性

    而 MCI 做的是:

    • 記錄「完整操作序列」:滑鼠軌跡、輸入內容、畫面上下文
    • 嚴格對應到特定員工帳號與工作情境
    • 用來訓練能「模仿人類操作電腦」的 AI Agent

    這是另一個等級:

    • 公司不只是知道你完成了哪個任務,而是知道你怎麼完成每個任務,包括猶豫、試錯、切換視窗的節奏
    • 這些細節會被餵給模型,成為之後能在螢幕上替代你操作的一套「人類模板」

    換句話說,員工被當成 AI 代理的「全身動作捕捉裝」。

    Meta 說「不會拿來打考績」其實不重要,因為真正的衝擊有兩個:

    1. 勞動不安全感:你知道公司正在用你自己的操作,把你未來的替代者訓練得更好。
    2. 監控常態化:一旦這種粒度的行為數據被視為「合理訓練資料」,之後所有公司都會想用「我們也在做 AI」來擴張監控正當性。

    在這裡,紅線不是「有沒有收資料」,而是:收的是誰、什麼粒度、能不能退出、是不是 AI 不可或缺的最低必要集。


    二、兩條產業路線:拿資料的 Atlassian vs. 擋資料的 OpenAI

    與 Meta 的「行為採礦」相比,產業裡正在出現兩條幾乎相反的路線。

    1. Atlassian:把預設 opt-out 當成新常態

    根據多篇報導與 Hacker News 討論,Atlassian(Jira、Confluence 母公司)最近做了兩件關鍵事:

    • 預設啟用用戶資料收集,用於訓練自家 AI
    • 需要企業自己去關閉或申請不被用於訓練

    這種做法的訊號很直接:

    「我們先拿,除非你有意識、有時間、有權力來反對。」

    對多數中小企業與個人團隊來說,實際結果就是:

    • 你的專案敘述、任務描述、技術決策、商業 roadmaps
    • 在沒有實質理解與談判空間的情況下,默默進了別人模型的胃

    從產品角度講,Atlassian 的考量並不難理解:

    • 內建 AI 助理若要有價值,就需要讀懂你團隊真實的工作內容
    • 第一手專案協作資料,是極好的訓練與微調素材

    問題在於預設值:當「要不要被用來訓練」變成一個深藏設定裡的開關,用戶實際選擇權幾乎是零。

    💡 關鍵: 當「訓練授權」被藏成預設開啟的小開關,多數用戶事實上是被默默強制 opt-in,形同放棄資料談判力。

    2. OpenAI:把「減少能看到的東西」變成賣點

    對照之下,OpenAI 最近推出的 OpenAI Privacy Filter(開源 PII 過濾模型)則幾乎是反向路線:

    • 精準偵測並遮蔽個資(姓名、電話、地址、證號等)
    • 開源權重,讓任何人都能在自家系統前面加一層「隱私防火牆」

    這背後的賭注是:

    未來真正有價值的,不是你偷偷看到多少原始資料,而是你能幫客戶「藏住」多少不該被任何模型看到的敏感細節。

    一邊是 Atlassian 式:預設收集再說;另一邊是 OpenAI 式:預設先過濾再處理。兩者都在做 AI,但數據治理哲學完全不同。

    Meta 的 MCI、Atlassian 的預設收集,與 OpenAI 的隱私濾器,其實構成了 AI 時代的關鍵選擇題:企業是把「取得更多行為數據」當護城河,還是把「減少自己看見的敏感資料」當護城河?


    三、當模型夠強、又接近攻防場景時,資料風險是乘法不是加法

    Anthropic 最近就同時踩到兩顆地雷:

    1. 被部落格質疑在安裝工具時「偷偷裝 spyware bridge」,雖然細節仍有爭議,但光是「類似間諜軟體」這個指控,就足以動搖技術社群信任。
    2. 更嚴重的是 Claude Mythos 事件:這個被官方視為「落入壞人手裡可能很危險」的安全模型,據 Bloomberg 和 The Verge 報導,被一小群未授權用戶透過承包商帳號與公開 OSINT 工具繞進去。

    這兩件事的組合,讓一個現實赤裸浮出來:

    當模型越強、越接近安全敏感場景時,資料蒐集與管控的任何失誤,帶來的不是「多一點風險」,而是「整個風險結構被改寫」。

    為什麼?

    • 一個強大的攻防模型(例如 Mythos)一旦暴露權限,就可能被用來自動化發掘漏洞、量產攻擊腳本、優化滲透流程
    • 這些能力疊加在外部的 OSINT 工具、被竊取的行為數據上,會產生組合爆炸式的攻擊面

    同理,如果未來真的出現:

    • 大量企業把員工操作軌跡(像 Meta MCI 收集的)丟進雲端
    • 又在同一個雲上跑高能力的攻防模型

    那麼一旦某個環節被突破,你丟掉的就不只是「文件」或「密碼」,而是整個組織的操作習慣、流程弱點、常見錯誤模式——這些都是攻擊者夢寐以求的素材。

    這就是為什麼,我會把 Meta 的滑鼠記錄、Atlassian 的預設收集、Anthropic 的 Mythos 事件放在同一條時間線上看:它們共同指向一個事實——AI 能力曲線在往上衝,但資料治理的安全曲線並沒有同步抬升。

    在這個落差區間內,風險不是線性增加,而是成倍放大。

    💡 關鍵: 當「高能力模型」與「細緻行為數據」同時存在且治理落後時,每一次疏漏都可能把風險從加法推成乘法。


    四、這三種人各自要付出的代價與可以做的選擇

    1. 對產業:信任流失與人才外流,會反噬模型能力本身

    對大公司來說,短期把「更多行為數據」當勝負關鍵,很誘惑,但中長期有兩個反效果:

    • 信任品牌崩壞:一旦被貼上「會偷看一切」標籤,企業客戶就會在招標文件裡開始硬性要求:不能用於訓練、必須可審計、必須 on-prem。你會被迫退回更低資料可見度的環境做模型,等於自廢武功。
    • 人才拒絕加入或留任:最敏感、最懂風險的頂尖工程師與研究員,會用腳投票,轉向 強調隱私與透明治理 的公司。這些人才外流,最終會拉開模型本身的實力差距。

    真正的 AI 護城河不是你偷到多少內部行為數據,而是有多少人願意心甘情願、清楚知情地把資料交給你。

    2. 對開發者與技術決策者:選工具要看三件很具體的事

    如果你是 CTO、架構師或產品負責人,現在選 AI 供應商時,建議至少做到:

    1. 看清「訓練用途」條款:
    2. 有沒有明確寫「此路徑的資料不會被用於模型訓練或微調」?
    3. 是預設 opt-in 還是 opt-out?怎麼退出?需不需要額外付費?
    4. 要求可審計的資料流:
    5. 能不能在你這一側,插入像 OpenAI Privacy Filter 這種前處理?
    6. 日誌裡能不能回溯每次請求傳了什麼、有沒有被遮蔽?
    7. 區分「遙測」和「行為錄影」:
    8. 允許產品收集崩潰報告和性能指標,是合理的
    9. 但凡看到「螢幕錄影」「鍵盤全記錄」「滑鼠軌跡重放」這類,請直接當成高風險監控軟體看待,除非你真的有充分的法律依據與員工同意機制。

    3. 對一般上班族:你要主動要求三種權利

    如果你是被要求安裝「工作用監控工具」的員工(無論在科技或傳統產業),你有理由也有必要問清楚:

    1. 知情權:工具具體收哪些欄位?有沒有截圖?有沒有鍵盤全記錄?資料存多久?誰有權看?
    2. 用途邊界:
    3. 是否明文禁止用於績效、考勤、懲戒?
    4. 是否會被拿去訓練公司內部或外部 AI 模型?如果會,是不是可識別到個人?
    5. 選擇與退出權:
    6. 有沒有 opt-out 機制?如果沒有,是否有「不在你個人設備上安裝,只允許在受管控虛擬桌面內運作」的替代方案?

    在很多司法轄區,這已經不是「公司好不好心」的問題,而是資料保護法與勞動法的硬性要求。你提出來,不是刁難,而是在幫公司避免掉進下一個 Anthropic / Meta 級別的聲譽危機。


    結論:AI 長期贏家,是敢少收資料的人

    我對這一波趨勢的判斷很直接:

    未來能存活、甚至成為巨頭的 AI 公司,不是那些偷到最多滑鼠軌跡的人,而是最早把「可審計、可選擇、最低必要原則」做成標準產品能力的人。

    所謂「最低必要原則」,在 AI 時代就是:

    • 模型只看為完成當下任務最少、最剝離個資的資料
    • 誰在什麼情境下看到原始資料,事後都可以被追溯
    • 每一筆被拿去訓練的資料,都能說得清楚:誰同意的,何時同意,可以怎樣撤回

    Meta 的 MCI、Atlassian 的預設收集、Anthropic 的 Mythos 事件,都是把產業推向同一個選擇:你可以靠偷吃行為數據衝短線,也可以靠尊重資料與人的邊界蓋長線基礎建設。

    如果你是做產品與技術決策的人,現在就該用採購預算和技術選型,投票給後者;

    如果你是一般員工,則可以從今天開始,習慣在每一個「請安裝此工作工具」的時刻,多問一句:

    它只是量測系統,還是在複製一個「未來可以取代你」的你?

    這個問題問得越早,整個產業離健康的 AI 落地就越近一步。

    🚀 你現在可以做的事

    • 檢查團隊現用工具的隱私與訓練條款,確認是否預設用你的資料訓練 AI
    • 在下一次選型或續約時,列出「可審計、可選擇、不默默訓練」作為評估指標
    • 當公司要求安裝監控或「效率」工具時,主動詢問收集內容與是否用於 AI 訓練
  • Google 押注 400 億買 Anthropic,誰被鎖死?

    Google 押注 400 億買 Anthropic,誰被鎖死?

    📌 本文重點

    • 雲巨頭用百億投資預售未來 AI 基礎設施
    • Anthropic 用巨額雲帳單換現金,長期被綁死
    • 開發者短期享便宜模型,長期失去多雲與議價權
    • 兆級估值與上兆 CapEx 正在堆積系統性金融風險

    這不是單純的「Google 看好 Anthropic」。這是一場用400 億美元把未來 AI 基礎設施「預售」給少數雲巨頭的鎖倉行動,短期讓模型變便宜、變好用,長期卻在把整個生態綁死。真正的輸家,不一定是落後的雲廠商,而是開發者、獨立創業者,甚至是被迫承接風險的金融體系。**


    一、從「投資一家實驗室」到「三巨頭包養一實驗室」

    表面上,Google 最多投資 Anthropic 400 億美元,首筆是以 3500 億美元估值投入 100 億現金,後續 300 億視里程碑解鎖,對外故事叫「押注安全導向 AI 先鋒」。但把時間線攤開,你會看到的是一個更詭異的結構:

    • Amazon 先前已經承諾最多 250 億美元投資,換來 未來十年 1000 億美元 AWS 雲支出,外加 Trainium 晶片優先採用權。
    • CoreWeave 則是這場戲裡的算力外包商,補上 GPU 密集型運算缺口。
    • 現在再加上 Google 的 400 億現金 + compute,等於 Anthropic 被三家雲+算力供應商「包養」。

    💡 關鍵: Google 的 400 億只是表面,真正價值在於提前鎖住未來十年規模級別的雲與算力現金流。

    傳統上,雲端是基礎設施、AI 實驗室是客戶;這一輪之後,模型公司和雲基礎設施被「打包售賣」:錢從 Google / Amazon 出來,又以 雲帳單和晶片採購 的形式回流,中間只多了一層「估值衝到兆美元的實驗室」。真正穩賺不賠的是誰?

    • 不是一定能跑出可持續商業模式的 Anthropic,
    • 而是長期鎖定 1000 億等級合約現金流的 AWS、Google Cloud,以及賣晶片、賣機房的 Nvidia、電力與資料中心產業鏈。

    產業結構正在變成:三巨頭合資養一間模型央行,由這間實驗室發行「高階模型貨幣」,再透過自家雲和 API 通路收租。


    二、Anthropic:用 1000 億雲帳單換幾十億現金,換到的是自由還是枷鎖?

    從 Anthropic 的角度,選擇其實殘酷又務實:

    • 高階模型(Claude、Mythos 這類安全/攻防場景模型)需要海量算力。
    • 沒有自建晶片、沒有自建超大機房,只能跟雲巨頭簽 「現金+compute 打包」 的長約。

    於是就有了這種結構:

    • 拿 50 億現金(或 330 億、400 億這級別),
    • 承諾未來十年花 1000 億在 AWS / GCP 上,還要配合採用 Trainium 這種供應商自研晶片。

    💡 關鍵: Anthropic 用數十億現金換來的是百億級別、綁死供應商與技術路線的長期雲承諾。

    短期看,Anthropic 解決了最急迫的 capacity crunch(算力飢荒),可以把 Mythos 拉到更多客戶面前,跟 OpenAI 正面掰手腕。

    但長期看,問題也被鎖死:

    1. 技術路線被寫進合約:
    2. 你不能輕易說:「Nvidia H200 漲價太誇張,我改用其他雲或新創加速卡。」
    3. 因為你的董事會、投資人、甚至債權人,已經把 Trainium / AWS / GCP 的承諾當成未來十年的資本支出預期。

    4. 談判空間被削弱:

    5. 當你還有 800 億美金的未來雲承諾沒花完,你去跟其他雲談條件,只會被當成「拿來壓價的工具」,對方不會給你真正核心資源。

    6. 產品方向被捆綁到雲戰略:

    7. Mythos 主打網路安全、企業級攻防,這剛好是 AWS / GCP 最想守住的高毛利市場。
    8. 模型迭代就會被自然牽引向「怎麼幫雲巨頭賣更多安全產品」,而不是「怎麼讓開源社群更好接入」。

    Anthropic 世代的 AI 實驗室,不再是「從雲租算力的客戶」,而是「被雲預付了十年租金的長約承包商」。這對他們的生存可能是必要條件,但對整個生態是否健康,是另一個問題。


    三、開發者與企業:今天拿到便宜的 Claude,明天多雲自由可能不見了

    從使用者端來看,短期確實是利多:

    • 更多算力 → Claude / Mythos 更便宜、更穩定,吞得下更大的 context、做得動更重的推理與安全分析。
    • Google、Amazon 推聯合方案,企業客戶在 AWS / GCP 上叫用 Anthropic 模型會更方便、可能還有折扣套餐。

    問題在於:這些好處幾乎都建立在綁定前提之上。

    1. 技術綁定:API 不是抽象介面,而是商業鎖鏈
    2. 你以為自己只是「接了一個好用的 LLM API」。
    3. 但當 Claude / Mythos 變成你產品的核心差異化,且實際部署被寫死在 某家雲的私有網路、某種 IAM、某套資料湖格式 時,你已經沒有真正的多雲選擇權。
    4. 想切換到別家模型?重寫一堆 pipeline、安全審計、合規文件,遷移成本高到你只會在合約談不攏時拿來當威脅,而不是實際執行。

    5. 議價能力下滑:從「買方市場」變成「三方壟斷」

    6. 模型市場表面供應者很多:OpenAI、Anthropic、Google、Meta、各種 API 聚合商。
    7. 但在高階能力和企業級 SLA 上,實際上你面對的是 同一批雲與同一批 GPU 供應鏈,價格底線互相心照不宣。
    8. 三巨頭+少數大型實驗室 的組合,足以讓「長期大幅殺價」變成例外,而不是常態。

    9. 擠壓開源與獨立供應商

    10. 當 Claude / Mythos 這種頂級閉源模型被打包進 AWS / GCP 的折扣合約裡,很多 CTO 在預算會議上會問:
      > 「既然我們已經每年給 AWS 幾百萬了,為什麼還要另外付錢給一家小公司或自己維護開源模型?」
    11. 開源模型提供者、獨立推理服務商,將被迫在 沒有規模優勢、沒有資本補貼 的情況下跟巨頭玩價格戰,結局可想而知。

    💡 關鍵: 開發者今天省下的幾十萬雲成本,可能換來未來十年幾乎無法脫身的供應商綁定與議價劣勢。

    對開發者來說,今天省下來的幾十萬雲帳單,有可能換來未來十年的議價權喪失與創新空間緊縮。


    四、政策與金融風險:兆美元估值+巨額舉債機房,風險最後由誰買單?

    這種 「雲換股權」+「巨額 CapEx 舉債」 的循環,已經讓政策圈開始緊張。Elizabeth Warren 在華府直接說:「I know a bubble when I see one.」

    把 Anthropic 放進這個脈絡:

    • 二級市場估值一度衝到兆美元,超過 OpenAI,但現金流仍高度依賴未來可能發生的企業採用。
    • 雲巨頭為了搶 AI 市佔,背後是 上兆美元等級的機房、電力、晶片 CapEx,大量透過債務與結構性融資來支撐。
    • 如果 AI 收益無法在合理時間內覆蓋這些投資,壓力會從幾家科技股,外溢到供應鏈、REITs、公司債市場,甚至壓縮到實體經濟的信貸空間。

    而目前監管的主流焦點仍停在:

    • 「模型會不會胡亂 hallucinate?」
    • 「會不會被用來生成 Deepfake?」

    真正需要被認真檢視的,其實是「資金與算力集中度」,以及這些「循環投資合約」如何在資產負債表上被評價與風險加總。


    結論:這不是在「押對模型」,而是在「鎖倉未來」——開發者要自己保留逃生門

    綜合來看,Google 押 400 億買 Anthropic,不是單純看好 Claude 或 Mythos,而是要提前鎖住 AI 雲基礎設施的未來現金流。短期對使用者是甜頭:模型更強、更便宜、更穩定;長期則可能換來:

    • 產業多樣性被壓縮:三巨頭+少數實驗室的寡頭格局穩固。
    • 開源與獨立廠商被擠壓:很難籌到對抗級別的資本與算力。
    • 系統性金融風險累積:兆美元估值+上兆 CapEx 一旦失速,波及不只是 AI 產業。

    對開發者與企業,我的具體建議是:

    1. 技術架構上,主動維持多雲、多模型策略:
    2. 在設計時就預留 至少兩家模型供應商、一個開源備援路線(例如自家部署開源 LLM 做降級方案)。
    3. 不要把關鍵業務邏輯寫死在某一家雲的專屬 SDK 與權限模型裡。

    4. 合約與治理上,把「可遷移性」寫進去:

    5. 要求 SLA 不只談 uptime,也談 資料可攜、模型切換支援、退出條件。
    6. 對大型長約,董事會層級要看的是 供應商集中度,而不只是折扣百分比。

    7. 投入開源與社群:

    8. 即便主力仍用閉源模型,也應投資部分資源在開源工具鏈與模型上,保持團隊對基礎技術的掌握,而不是完全變成 API glue 工程師。

    9. 對政策討論,不要只談「AI 會不會毀滅人類」,也要談「算力和資金集中到什麼程度算危險」。

    AI 雲戰爭的真正輸家,不必然是技術落後的公司,而是被迫在單一巨頭體系裡「借用未來」的整個生態。你不一定能改變 Google 和 Anthropic 的棋局,但至少可以先確定,自己的技術與商業命運,不是綁在一紙十年雲合約上一起沉沒。

    🚀 你現在可以做的事

    • 審視現有架構,規劃至少兩家雲與兩家模型供應商,加上一條開源 LLM 降級備援路線
    • 檢查與雲/模型廠商的合約,新增或強化資料可攜、退出條款與遷移支援條款
    • 在團隊 roadmap 中留出人力與預算,實作一個最小可用的自託管或開源模型服務,避免完全依賴單一 API
  • Codex 升級:AI 平台戰爭搶的是桌面

    Codex 升級:AI 平台戰爭搶的是桌面

    📌 本文重點

    • Codex 正從「寫程式工具」進化為「桌面中控層」
    • 模型公司正往作業系統與工作流程上捲
    • 企業必須為 Agent 帶來的治理與撤退路徑預先設計

    這一輪 AI 平台戰爭,搶的不是「最強模型」,而是誰先佔領你的「工作流與作業環境」。OpenAI 用這次 Codex 大升級,把戰場從雲端 API 推進到開發者電腦螢幕上;接下來幾年,開發者與企業真正要思考的,不是「用不用 Agent」,而是「敢不敢把電腦交給哪一家」。


    一、Codex 不只是寫程式,它在搶你的「桌面主權」

    這次 Codex 更新,關鍵不是多會寫程式,而是它開始長成一個「半個作業系統」:

    • 電腦操作(Computer use):能在 macOS / Windows 上操控應用程式,從玩井字棋到開 IDE、切換 terminal、改 config,全部自己來。
    • 內建瀏覽器 + 90+ 插件:Codex 不再只是調你現有工具,而是把網頁、第三方服務收編進自己的「小宇宙」。
    • 永續線程與記憶(thread automations + memory):可以跨 session 記住專案脈絡,在背景持續跑任務,等於在你機器上放了一個「常駐 Agent」。
    • 多 Agent 協作:支援多個 Agent 分工,從需求拆解、Coding、測試到部署,自動化程度直逼「AI 軟體工廠」。

    把這些拼起來,你會發現:Codex 已經不是一個「IDE 裡的 copilot」,而是想變成「桌面上的中控層」。

    💡 關鍵: 一旦中控層被某家模型平台占據,你的日常工作流與工具選擇將長期被其技術與商業策略鎖死。

    這也是為什麼這次更新,被視為對 Anthropic 的 Claude Code + MCP 生態 的直接回擊——雙方在搶的,不是「誰幫你補完一段程式碼」,而是「誰來編排、監控、擁有你整個開發與知識工作流程」。


    二、模型公司上捲 OS 層:誰會被擠出局?

    過去十年,雲戰爭的劇本我們看過一次:

    • 一開始是「誰家 VM 便宜」,後來變成 AWS / Azure / GCP 直接往 PaaS、SaaS 卷上去,把一整排第三方服務擠到夾縫。
    • 今天在 Agent 時代,OpenAI、Anthropic 正在對 IDE、copilot 工具、甚至傳統 SaaS 重演一次。

    從這次 Codex + OpenAI Agents SDK 可以看出幾個明確信號:

    1. 第三方 Agent 平台會被邊緣化
      你如果只是幫用戶「把模型接上工具、做點工作流 UI」,OpenAI 直接給你一個 Agents SDK + sandbox + harness,還免費綁最強模型。你的 moat 幾乎瞬間歸零。

    2. 獨立 copilot 工具與專用 IDE 會被「平台吸收」
      當 Codex 能直接控制 VS Code / JetBrains,幫你開 PR、跑 CI、改 config,獨立的 coding copilot 插件,就會變成平台的一個 feature,而不是一家公司。
      Claude Code 一樣在做這件事,只是它透過 MCP 把 IDE、Git、issue tracker 等工具接成標準化「工具協議」。本質上,兩家都在收掉「中小型 DevTool 新創可能活的空間」。

    3. 設計、文件、知識工作軟體,會被「工作流」外包
      當 Agent 能自動開 Figma、Notion、Jira、Slack,幫你整理需求、產出設計稿、開 task、追進度:

    4. 用戶真正愛的是「整條工作流」的體驗,而不是單一工具的 UI。
    5. 誰掌握工作流編排權,誰就能把工具變成可替換零件。

    💡 關鍵: 只做單點工具的新創,若無法成為平台不可替代的一層,很容易在平台上捲的過程中被壓扁或變成小功能。

    換句話說,基礎模型公司正在向「AI 版作業系統」上捲:桌面是 UI,Agent 是排程器,插件/工具是 driver。任何只站在「工具層」的新創,都要重新審視自己的生存空間:你是平台 feature,還是真的不可替代?


    三、Agent 盯著你的螢幕:效率爆表,也是治理噩夢

    當 Codex、Claude 這種 Agent 可以「常駐看螢幕、自己操作電腦」,對企業意味三件事:

    1. 隱私邊界被重新畫一次
      傳統 DLP、端點防護預設「人類是操作者」。現在螢幕前可能是 OpenAI 代碼在操作你的 ERP、CRM、內網 Git:
    2. 誰能看到畫面和輸入?
    3. 操作錄像存哪裡?
    4. 這些資料會不會回流到模型供訓練?
      不處理清楚,你的「機密專案」,等於在外包給一個你無法審計的外部員工。

    5. 內控與審計模型要升級
      傳統軟體出錯會「噴錯停下來」,Agent 會「自我修正繼續做」,風險直接放大。Towards AI 的實務框架 講得很直白:企業現在的 governance,大多沒準備好讓軟體「半自主行動」。

    企業至少要做到:

    • 明確的許可邊界:這個 Agent 可以動哪幾個系統、哪幾種操作?
    • 動態熔斷機制:金額、頻率、風險超過門檻就自動停機 + 人工覆核。
    • 完整審計軌跡:每一步操作有「誰授權、什麼意圖、用什麼工具」的可追溯紀錄。

    • 成本曲線會讓你不得不「設計節制」
      AI Agent 成本正快速上升:多步推理、多工具、多 Agent 協作,本質上就是「把一堆貴推理串在一起」。沒有架構設計,你不是在省人力,是在開一個會自旋的計費黑洞。

    這也是為什麼實務上會出現 Attention Scoping 這種模式:有意識地限制 Agent 每次能看、能用的工具集合,用架構來壓住成本與混亂度。

    💡 關鍵: 若沒有明確的權限與成本邊界設計,導入 Agent 可能在效率提升之前,先帶來失控的費用與合規風險。

    效率確實驚人,但如果你沒有治理框架、沒有成本護欄,Agent 很快會從生產力工具,變成技術債與合規風險的放大器。


    四、押誰的平台與協議?先想「可撤退性」

    對開發者與企業來說,最現實的問題不是哲學,而是:我要押 Codex + OpenAI Agents SDK,還是 Claude + MCP / UCP 這一側?

    幾個關鍵思路:

    1. 區分「應用層依賴」與「協議層依賴」
    2. OpenAI Agents SDK:偏應用框架,深度綁定 OpenAI 生態,長處是上手快、整合模型與 sandbox 容易,但遷出成本高。
    3. Anthropic 的 MCP(Model Context Protocol):偏工具協議,定義「模型怎麼與外部工具對話」。理論上任何模型都能說 MCP,比較像是未來 multi-model、多供應商世界的「共同語言」。

    建議:在 Agent 內部與工具互動,優先採用開放協議(如 MCP 類型);在具體實作與運維,可以各家 SDK 混搭。

    1. 雲戰爭的教訓:一開始就設計 multi-provider
      當年很多團隊「先全上 AWS,將來再 multi-cloud」,結果「將來」永遠來不了。Agent 時代照抄一次就是:

    2. 先全部寫死在 OpenAI Agents SDK / 特定 provider 的沙箱模型裡;

    3. 長大後才發現無法平滑切到 Claude、Gemini 或自家私有模型。

    可行的折衷做法:

    • 把 「任務編排、工具清單、權限邊界」抽象在自己系統裡,不要寫死在某家 SDK 設定;
    • 用 適配層 封裝不同 provider(OpenAI Agent、MCP server、Cloudflare inference layer);
    • 關鍵任務預留「第二供應商」路徑,哪怕一開始不用,也要確認技術上走得通。

    • 善用中立基礎設施:例如 Cloudflare 的 inference layer
      Cloudflare AI Platform 很清楚:它要做的是「專為 Agent 設計的推理層」,而不是再做一個模型。對企業來說,這提供了一個折衷:

    • 在 Cloudflare 這種中立層上跑多家模型與 Agent;

    • 把監控、日志、金鑰管理、流量治理放在這一層;
    • 上層應用可以比較容易切換模型供應商。

    關鍵心態轉換是:不要再問「哪家模型最強」,而是問「哪種架構讓我五年後還能自由選供應商」。


    結語:現在就用「雲戰爭的教訓」,重新設計你的 AI 版 DevOps

    Codex 這次升級,宣告 AI 平台戰爭正式從「模型對比」進入「工作流與作業環境爭奪戰」。短期內,開發者會享受到前所未有的生產力紅利;長期來看,權力與依賴度會高度集中在少數幾家模型公司手上。

    對開發者與企業,我的具體建議是:

    1. 先假設 Agent 一定會進你桌面,然後反推安全與治理設計:從權限、審計、熔斷開始,而不是從 demo 好不好看開始。
    2. 選平台時優先考慮「協議與抽象層」,而不是單一 SDK 的爽度:MCP 類協議 + 自建編排層 + 中立推理層,比全押一家的封閉 SDK 更有長期議價力。
    3. 在架構圖上畫出「我怎麼退出這個供應商」的路徑,如果畫不出來,就當你已經被 vendor lock-in,評估時要把這個成本算進去。

    AI 平台戰爭真正要搶的,是你每天工作的「操作系統層」。你可以享受集中帶來的效率,但必須主動設計自己的分散與治理,否則這場戰爭結束時,你連自己桌面的規則都說不上話。

    🚀 你現在可以做的事

    • 打開你現有的雲與 AI 架構圖,標記所有被單一供應商鎖死的關鍵點,試著畫出替代路徑
    • 評估並選定一種開放協議(如 MCP 類型)作為未來 Agent 與工具互動的統一接口
    • 為第一個導入桌面 Agent 的場景設計「權限邊界 + 審計紀錄 + 熔斷條件」,做一個小規模試點
  • Spud 洩密:OpenAI 正在改寫遊戲規則

    Spud 洩密:OpenAI 正在改寫遊戲規則

    📌 本文重點

    • Spud 是統一底座,讓整個 OpenAI 生態一起升級
    • 护城河時代來臨,戰場從模型轉向企業與平台綁定
    • 開發者與企業必須主動做多供應商與風險分散設計

    Spud 洩密真正說明的,不是「又一個更強模型要來了」,而是:OpenAI 準備用新一代基礎模型,連同 API、ChatGPT、企業方案、代理平台一起「版本跳躍」,把整個生態系鎖進自己的節奏與護城河裡。 這是一場從「模型能力戰」升級到「生態與權力結構戰」的內戰開場。


    一、Spud 不是一個模型,而是一個「版本跳躍樞紐」

    從洩漏備忘錄與公開資訊拼起來,Spud 比較像是下一輪「統一底座」的代號:

    • 技術面:內部說法是讓所有產品「significantly better」,不是只替換一個端點,而是讓 ChatGPT、API、企業版、以及新一輪 AI 代理平台,一次升級到同一個代際。
    • 產品面:搭配 Cloudflare Agent Cloud 上的 GPT-5.4 + Codex、以及針對資安場景的 GPT-5.4-Cyber,可以看出 OpenAI 正在做的,是把「通用基礎模型 + 垂直變體 + 代理框架」打包成一個完整堆疊。

    💡 關鍵: 一旦 Spud 成為所有產品共用底層,每一次模型升級都會變成「整個生態同步跳版」的大遷徙事件。

    這種設計的關鍵不在 benchmark 分數,而在節奏控制權:

    • 一旦 Spud 成為所有產品的共用底層,每一次模型版本前進,等於整個生態一起被迫躍遷。
    • 開發者與企業客戶,將難以停留在舊版行為模型,只能跟著 OpenAI 的升級節奏跑——即使這次升級會打壞既有流程。

    Spud 的本質,是把「模型更新」變成「平台大遷徙」的觸發器。 技術路線與產品節奏被綁在一起,這就是護城河的第一層。


    二、備忘錄裡的殘酷現實:護城河時代的 AI 內戰

    The Verge 公開的備忘錄裡,OpenAI 首席營收長 Denise Dresser 說得很白:

    必須「建立護城河」、「鎖定使用者」,因為客戶換一家模型供應商太容易。

    這段話的關鍵,不在口號,而在後面的細節:

    1. 護城河的對象不是使用者,而是遷移成本

    OpenAI 很清楚,在同質化的模型競爭下,差距不再只在「誰比較聰明」,而是「誰的黏著機制更深」:

    • 不是比一個 API token 的價格,而是比:
    • 有多少工作流已經寫死在自家 function calling、tooling 格式上
    • 有多少企業內部知識庫與權限系統綁在自家平台
    • 有多少代理框架、監控、審計管線,只支援一種供應商

    2. 直接指控 Anthropic「灌水 80 億美元營收」

    備忘錄裡對 Anthropic 的指控,表面看是口水戰,本質其實是 「估值敘事戰」:

    • 直接喊出 「overstating revenue by 8 billion dollars」,是在向投資人、企業客戶暗示:
    • 對手沒你想得那麼穩
    • 你把長期賭注壓在那邊,很可能站錯邊
    • 這不是技術 benchmark,而是搶奪市場信心與資本耐心。

    💡 關鍵: 針對「灌水 80 億美元營收」的指控,本質是在重寫誰才是「安全賭注」的市場敘事。

    3. 企業市場被視為長期權力支點,而不是單純收入來源

    備忘錄反覆強調要擴大 enterprise,搭配 Cloudflare Agent Cloud、Cyber 模型的策略,更像是在說:

    • 一旦把關鍵產業(資安、雲端、核心業務系統)的工作流吃下來,
    • 未來 AI 供應商的更替,會變成「換核心基礎設施」級別的高風險事件。

    Spud 洩密讓我們第一次清楚看到這場內戰的真面目:

    這已經不是「誰模型比較安全、比較聰明」而已,而是「誰能先把自己的模型變成企業生態的預設地板」。


    三、開發者與 B2B 客戶在玩一場「地板一直下沉」的疊疊樂

    在 Reddit 的 r/ClaudeAI 裡,有人總結目前所有 AI 平台的共同現象:

    「我們都在一個每週改版、沒人有長期計畫的地基上蓋房子。」

    這句話,正好可以拿來形容 Spud 時代的風險。

    1. API 行為頻繁變動,長壽命產品越來越難做

    • 模型更新後,同樣的 prompt 開始給出不同風格、不同結構的回應。
    • API 回傳欄位、工具調用方式、上下文行為,常常微調但缺乏完整 changelog。
    • 對於要維持數年穩定運作的企業系統,這種「改進綁破壞」的節奏是災難。

    Spud 若成為全線產品的統一底層,每一次代際更新都會放大這種不確定性。

    2. 抽象層越疊越厚,開發者越來越「看不到地面」

    • 代理平台、工作流編排、企業知識庫對接層,一層一層包裹在模型外面。
    • 好處是上手快、整合爽,但代價是:
    • 你不再能精確控制模型行為,只能「接受這一版的性格」。
    • 任一抽象層更新,都可能造成連鎖 breakage,卻不一定有 rollback 選項。

    3. 風險向開發者與客戶轉移

    在傳統 SaaS,你可以:

    • 卡在某個版本
    • 拿到清楚的 EOL 時程
    • 在控制時間內規劃遷移

    在 AI 平台,你只知道「新模型更好」,但不知道它會在哪些任務上「變得太不一樣」。

    對於開發者與 B2B 客戶來說,這意味著:

    你以為自己在買「能力」,實際上買的是「被動追隨某家公司節奏的義務」。


    四、封閉巨頭 + 平台綁定:監管與產業要面對的不是單一公司,而是一種架構

    當 OpenAI、Anthropic、Google 這類實驗室,同時掌握:

    • 封閉式頂級模型(無法自行驗證與複製)
    • API 與代理平台(綁定工作流與開發者習慣)
    • 雲與安全生態聯盟(如 Cloudflare Agent Cloud、GPT-5.4-Cyber 的「可信存取」計畫)

    產業與監管面對的不再是一家公司的壟斷,而是一種結構性的集中:

    1. 算力與資料流向集中

    • 企業為了使用最新模型與代理能力,被迫把內部流程與資料直接接上這些平台。
    • 長期下來,誰掌握這些代理的行為與日誌,誰就掌握產業神經系統。

    2. 監管框架落後於「平台內戰」現實

    • 多數 AI 監管仍聚焦在模型安全、濫用防範(例如 Cyber 模型的「Trusted Access for Cyber」)。
    • 但更棘手的是:當模型與平台綁成一體時,企業幾乎不可能「局部換供應商」。 這會讓任何監管介入,都變成大手術級別風險。

    3. 開放模型與多雲策略會變得更重要,但門檻也更高

    • 開源與半開放模型是唯一能打破平台綁定邏輯的力量,
    • 但在 Spud 這種整合疊代速度下,開源陣營必須不只追性能、還得追「生態配套」——代理框架、工具介面、穩定更新節奏。

    💡 關鍵: 如果只監管「模型多強、多危險」,而忽視「模型如何編排進企業工作流」,監管與產業其實已經在關鍵戰場上缺席。

    Spud 洩密其實是在提醒監管者:如果只盯著「模型多強、多危險」,而不管「模型怎麼被編排進企業工作流」,那場仗已經輸了一半。


    對開發者與使用者的具體建議:從今天開始分散風險

    如果接受「護城河時代已經開始」這個前提,對開發者與企業使用者,建議非常具體:

    1. 假設模型會經常變,而且會打壞東西

    • 在系統設計上,把「模型行為」當成高變動依賴:
    • 用中介層包 API(自己的 SDK / gateway),不要在業務程式碼裡到處直呼官方端點。
    • 針對關鍵任務建立 regression 測試,用固定 prompt + 測試集來監控模型變化。

    2. 刻意做「多供應商設計」,即使一開始只用一家

    • Prompt、tool schema、任務介面,盡量維持與特定平台解耦,在設計時就想像:
    • 同一套任務可以在 OpenAI + Anthropic + 至少一個開源模型上跑。
    • 哪怕短期只上其中一個,這會大幅降低你未來被價格、節奏、政策綁死的風險。

    3. 企業決策層要把「平台依賴」視為治理議題,而不是單純採購選項

    • 在導入 Spud 這樣的新一代模型與代理平台時,董事會層級應該問三個問題:
    • 三年後,我們能否用相對合理成本換供應商?
    • 哪些核心工作流一旦綁進某家平台,就不可能輕易抽離?
    • 我們有沒有至少一套「降級方案」(性能差一點,但不受單一平台控制)?

    Spud 洩密最重要的訊號是:頂級模型供應商已經不滿足於「賣模型」,而是要「改寫整個企業生態的遊戲規則」。 如果開發者與使用者現在不開始設計自己的護城河,之後就只剩兩個選擇:付錢跟著跑,或付更大的代價逃出去。

    🚀 你現在可以做的事

    • 把現有專案的所有 AI 呼叫包進自家中介層(SDK 或 API Gateway),避免在業務碼中直接呼叫單一供應商端點
    • 選一個任務,實作「同一套 prompt / tool schema 能在 OpenAI、Anthropic 與一個開源模型上跑」的多供應商 PoC
    • 在公司內部推一份簡短備忘錄,盤點哪些關鍵工作流一旦綁上某家 AI 平台,三年內幾乎不可能無痛更換
  • AI 黃金時代,其實是算力黑暗時代

    AI 黃金時代,其實是算力黑暗時代

    📌 本文重點

    • 算力荒正重寫整個 AI 產業的權力結構
    • NVIDIA 透過收購與封閉體系強化「AI 稅收權」
    • 開發者需在算力約束下做「夠好又不浪費」的產品

    第一波生成式 AI 熱潮,把注意力都放在「模型多強」,真正決定權力分配的,其實是「誰有算力」以及「誰能把算力用得更省」。所謂 AI 黃金時代,本質上更像是硬體與能源的黑暗時代開端:算力荒正在重寫從晶片、雲端到開發者的遊戲規則。


    一、上游:NVIDIA 在寫的是「稅法」,不是產品路線圖

    NVIDIA 以約 200 億美元收購 Groq,很多人只從技術角度解讀:LPU 架構拿來補 GPU 在推理解碼的短板。但從產業權力角度看,這是一次對「AI 稅收權」的加碼。

    • Groq 3 LPX 這種專攻推理、低延遲的架構,目標就是把 LLM 的推理成本壓到極致,特別是解碼階段的瓶頸。
    • 收購後,NVIDIA 不只是多了一條產品線,而是把「訓練(GPU)+ 推理(LPU/專用加速)」綁成一個封閉體系,從雲端供應商到模型公司都更難脫鉤。

    這件事的關鍵,不在於 LPU 性能多漂亮,而在於:

    1. 算力短缺把議價權推到供應鏈頂端。當 GPU 二手價格可以如 The Decoder 報導般在一年內跳升近 50%,任何能把「每 Token 成本」壓低的硬體,都直接決定誰能活下來。
    2. NVIDIA 不是怕別人做得更強,而是怕有人做得「夠好又便宜」。收購 Groq,是把潛在的成本破壞者直接納入自己的價格體系。

    💡 關鍵: 當 GPU 二手價一年內漲近 50%,任何降低每 Token 成本的方案都直接變成生死線上的競爭力

    在算力荒的世界裡,晶片廠不再只是賣鏟子的人,而是收過路費的稅官。Groq 被收購,傳遞的訊號是:真正的競爭不在頂峰模型的極限效能,而在「規模化推理」這個現金牛誰來控盤。


    二、中游:模型公司在做的,其實是算力通膨的成本轉嫁

    算力荒最直接的血淋淋場景,現在就出現在 OpenAI、Anthropic 這一層。

    • The Decoder 指出,Anthropic 近期多次服務中斷,外面看是「可靠性問題」,本質上是算力配給:資源要優先保證付費大客戶,免費與低價層就得排隊、降頻。
    • OpenAI 終止 Sora 平台,表面原因可以包裝成策略調整,背後是影音生成的算力成本極高,在 GPU 價格飆漲、推理運行越來越貴的環境下,很難長期開放供「玩」。

    你會看到幾個高度一致的動作:

    1. 限流、排隊、優先企業客戶:不是技術不行,而是 GPU 帳算不攏。
    2. 硬塞 cache、偷改模型規格:從系統層面做 aggressive caching、把體感維持在「還可以」但實際上降低 Token、壓縮上下文,都是為了在算力通膨下維持毛利。
    3. 悄悄砍或降級產品:把最燒算力的玩具級功能下架,或只留給特定付費方案。

    這些行為有一個共同邏輯:當每一次推理都比去年更貴,模型公司就只能把成本往下游砍——要嘛漲價(明顯),要嘛降配(隱性)。所以我們才會看到:

    • 模型能力曲線繼續上升(斯坦福 2026 AI Index 指出頂尖模型仍持續快速進步),
    • 但實際可用的、可負擔的服務體驗,並沒有同比例改善——很多人甚至覺得「越用越慢、越容易掛」。

    💡 關鍵: 技術指標在進步,但使用體驗停滯甚至變差,原因是算力成本的通膨被隱性轉嫁到下游

    換句話說,雖然是黃金模型時代,卻是算力通膨時代。中游玩家被迫扮演「算力通膨的分銷商」,把壓力一路轉嫁到企業客戶與開發者身上。


    三、下游:AI 不再是「無限雲服務」,而是稀缺資源管理

    當上游悶燒、中游限流,真正被迫改變架構思維的,是最下游的 開發者與企業。

    幾個現在就看得到的方向:

    1. 「少量雲端 + 本地/小模型」成為新常態
      Reddit 上那台雙 RTX PRO 6000 (共 192GB VRAM) 的塔機,不只是炫富,它反映一件事:算力貴到一個程度後,中大型團隊開始用 CapEx 把部份推理買回本地,自己控風險、控成本。
    2. 雲:用在高價值、必須大模型的場景(少數關鍵任務、需要最新能力的部分)。
    3. 本地/邊緣:大量日常推理、小模型、隱私敏感工作負載。

    4. 模型不再追「最大」,而是追「剛好夠用」
      以往的預設是:有錢就上最大模型。算力荒之後,合理的策略變成:

    5. 80% 請求用 壓縮後的小模型或量化模型 處理;
    6. 20% 真的複雜或高價值請求,才丟給雲端 SOTA 模型。
      能用 7B 模型就不用 70B,能本地就不遠端。

    7. 架構從「無限擴展」轉向「算力配額」思維
      開發 SaaS 時,傳統做法是假設雲資源可以線性加錢擴展。現在不行了:

    8. GPU 本身缺貨、價格暴漲;
    9. 雲端供應商開始對高密度推理 workload 做更嚴格的限制或差別定價。

    這迫使團隊把算力當成 預算內有限資產,導入像是:
    – per-feature 的算力成本試算,
    – 針對不同客戶等級設計不同推理規格,
    – 對內建立「算力 KPI」而不只是 DAU/收入 KPI。

    甚至連最前沿的 軌道運算 都開始出現。TechCrunch 報導 Kepler Communications 把 40 張 GPU 送上地球軌道,本質上是:地面機房越來越貴、越來越難建之後,任何能換一種空間、能源結構取得算力的方案都會被認真看待。這不是科幻,而是供給曲線被壓扁後的必然結果。


    四、算力已經是國安與能源議題,不只是商業問題

    2026 AI Index 的幾組數字,值得冷靜看:

    • 全球 AI 資料中心耗能已達近 30 吉瓦,等同一個 紐約州尖峰用電量。
    • 單一頂尖模型(如 GPT-4)的訓練與運行周期,可能就消耗相當於 超過 1200 萬人口的飲用水量。
    • 美國擁有 5,427 個數據中心,是其他國家的十倍以上;主流 AI 晶片製造則高度依賴 台積電 (TSMC)。

    💡 關鍵: 算力其實是把電與水轉成模型能力,能源與供應鏈集中讓 AI 直接變成國安議題

    這幾件事疊在一起,得到的結論是:

    1. 算力本質上是能源轉換問題。AI 每進步一點,都是在往電網和水資源要配額。政策討論不再只是「AI 會不會搶工作」,而是「要不要讓某個州多蓋幾個資料中心」。
    2. 供應鏈集中 = 地緣風險集中。當先進製程幾乎綁死在 TSMC,又以美國為核心消化,任何地緣事件都會直接反映在全球 AI 算力供應上——不是抽象風險,而是「下個季度 GPU 交不交得出來」的問題。

    這就是為什麼各國開始談「算力主權」:自己要有一部分可控的硬體、能源與演算法堆疊,不然政策與國安討論都只能在別人定價的前提下進行。


    結論:未來兩年的真正護城河——不是最強,而是「夠好又不浪費」

    在算力荒與算力通膨同時發生的年代,未來兩年的真正護城河,不再是誰的模型略強,而是誰能在算力約束下,做出「夠好但不浪費」的產品與基礎設施。

    對開發者與產品團隊,具體建議是:

    1. 從追新模型,轉向追「算力效率」
    2. 把「每一元雲端帳單換到的實際體驗提升」當主指標。
    3. 主動學會量化、蒸餾、多模型路由(小模型打底,大模型兜底)。

    4. 預設採用多雲 / 本地混合策略

    5. 關鍵資料與高頻推理,盡可能用自建或託管的本地 GPU(哪怕只是小型機櫃)。
    6. 把雲端視為「能力超額保險」,而不是每一個請求的預設去處。

    7. 把算力納入產品設計早期,而不是最後才算成本

    8. 功能規劃時就先問:「這個 feature 的推理成本是什麼級別?有沒有更省算力的替代設計?」
    9. 為不同客戶層級定義不同算力配額與模型等級,而不是一體適用。

    誰能在限制條件下設計出體驗「夠好」、算力「夠省」、架構「夠彈性」的系統,誰就會在這場算力黑暗時代裡活得最久,也最有餘裕等到下一輪真正的技術紅利。

    🚀 你現在可以做的事

    • 盤點現有產品中每個 AI 功能的推理成本,標記哪些可以改用小模型或量化模型
    • 試著在一台本地 GPU 機器上部署一個 7B 模型,實測與雲端大模型的體驗與成本差異
    • 在下次產品規劃會議中,加上一欄「算力預算 / 模型等級」,讓功能設計一開始就納入算力約束
  • Meta 背刺開源,AI 正在變三國殺

    📌 本文重點

    • Meta 從開源急轉封閉,本質是盈利模式選擇
    • 押寶 Llama 的開發者,正面臨升級斷供與信任風險
    • 開源將走向小而專,企業會採用開源+閉源混合棧
    • 未來關鍵是技術棧避鎖定與自托管能力,而非只選哪家模型

    核心結論很殘酷:隨著 Meta Muse Spark 宣布走向專有模型,AI 生態正從「開源群雄混戰」,收斂成 OpenAI、Anthropic、Meta 的三國殺——而開發者與中小企業,正被擠出牌桌,只剩昂貴 API 和愈來愈窄的創新縫隙。全面封閉不是技術必然,而是資本與商業模式的選擇。

    💡 關鍵: AI 正在從開放創新轉向少數巨頭壟斷的高牆花園,開發者的自由度與議價權快速縮水。


    一、從開源旗手到封閉玩家:Meta 為什麼急轉彎?

    Meta 並不是忽然「醒悟」,而是「被財報與排名逼到牆角」。

    過去三年,Llama 系列讓 Meta 成為開源陣營的精神領袖:

    • 數千家新創用 Llama 2 / 3 做成品,從聊天機器人到企業 Copilot
    • 研究圈把 Llama 當成「可改造的 GPT 替代品」
    • 整個產業默認:Meta 會持續釋出高階開源權重

    Muse Spark 打破這個默契。根據公開報導與產業脈絡,背後至少有三層壓力:

    1. 技術競賽落後的焦慮
      Llama 3 雖然在開源圈表現亮眼,但在實際評測與產品體驗上,仍追不上 GPT-4 級別的封閉模型。當 OpenAI、Anthropic 把最強能力鎖在付費 API 裏,Meta 若繼續「開源到底」,反而在高階企業訂單上落於下風。

    2. 資本開銷與盈利壓力
      生成式 AI 的訓練與推論成本,已經上升到「只有超大資本可以玩」的級別。The Verge 談到所謂的 「AI monetization cliff」:

    3. 基建投資是千億美元級別
    4. 若短期無法把模型變現,就會被市場當成泡沫

    在這種敘事下,「開源做公益」說不過去股東,封閉模型 + API 收費 + 企業方案,成了最容易被華爾街理解的故事。

    1. SaaS 模式的誘惑
      OpenAI 的 ChatGPT Enterprise、Anthropic 的 Claude for Business,已經示範了:
    2. 透過 訂閱 + 企業合約,把模型變成可預期現金流
    3. 壓低開發者能直接「跑自建模型」的動機

    Meta 不會不知道,只要繼續放權重出來,每多一個能自建 Llama 的客戶,就少一個被鎖進 Meta Cloud 的長期客戶。Muse Spark 封閉,本質上是在對投資人說:我們也可以像 OpenAI 一樣收租。

    關鍵句:Meta 不是被技術帶向封閉,而是被「盈利模板」拖進封閉。

    💡 關鍵: 從 Llama 開源到 Muse Spark 封閉,轉變背後是向「API 收租+SaaS 訂閱」這套華爾街偏好的盈利模型靠攏。


    二、Llama 生態的隱形成本:升級斷供與信任折價

    這次轉向,受傷最大的不是競爭對手,而是 押在 Llama 路線上的新創與開源社群。

    1. 技術路線突然鎖死

    對很多新創來說,選 Llama 的理由是:

    • 有 穩定迭代路線圖(Llama 2 → 3 → 4…)
    • 可以自建、微調、私有化部署
    • 相信 Meta 不會放棄開源

    Muse Spark 一出,訊號很直接:

    • 下個世代最強模型,未必會再開源
    • 開源版本,可能變成「降級版」「延遲版」

    這等於在告訴創業團隊:

    你可以用 Llama 打底,但高端能力升級,未來得改走 API,還是得回到「雲端地主」那裡交保護費。

    2. 升級斷供的結構風險

    當基礎模型供應商改變策略,你整家公司的技術路線都可能被拖下水。

    • 你今天用 Llama 3 搭了一套產品
    • 明天發現 Muse Spark 的多模態、推理能力遠超現有開源版
    • 客戶追問:「為什麼你們做不到跟 Muse Spark 一樣?」

    這時你有兩個選擇:

    1. 改用 Meta API——接受更高成本與供應商鎖定
    2. 轉向其他基礎模型——承受整個技術棧重構的代價

    無論哪個選,你的議價權都在減少,而且每一次大版本更新,都要再承受一輪相同的風險。

    3. 開源信任度正式打折

    Llama 曾被視為「開源陣營的壓艙石」,現在這塊石頭開始鬆動:

    • 開發者會重新檢視:還能相信哪家巨頭的「開源承諾」?
    • 對基金與企業 CTO 而言,投資任何基於單一大廠開源模型的產品,都要額外計算「政策變心風險」

    長期效果是:開源不會消失,但對巨頭的依賴會轉為「短期利用、長期防範」。

    💡 關鍵: 押注單一大廠開源模型,實際上是在承擔「某天突然變封閉」的政策風險溢價。


    三、開源真的失勢?不,會逼出「小而專」與混合棧

    如果只看參數量和基準測試,開源陣營確實被 Frontier 模型甩得愈來愈遠。但從產業結構來看,Meta 的背刺反而會催生新的均衡。

    1. 小而專:從「一模型吃天下」退燒

    當最強模型愈來愈封閉,開源社群的反應往往不是「放棄」,而是:

    • 往垂直領域深挖:法律、醫療、工業、金融、國防等
    • 追求可解釋性與可控性,而不是盲目追逐通用 benchmark

    你會看到更多:

    • 針對單一語種、單一任務優化的模型
    • 能在中小企業私有算力上跑得動的「邊緣模型」

    這些模型不會在排行榜上打贏 Muse Spark,但會在「可用、可控、可負擔」這三件事上贏。

    2. 開源+閉源混合棧,成為企業默認選項

    OpenAI 在企業 AI 文章中提到:下一階段是 前沿模型+企業代理+整合方案。這種高度一體化的封閉體驗,短期很有吸引力,但也會讓大企業更警惕:

    • 一旦核心流程綁死在單一供應商代理上,遷移成本極高
    • 監管與內控要求下,必須有可以自托管的替代方案

    因此更合理的架構會是:

    • 80% 日常任務,用 開源或自建模型 處理(成本低、可控)
    • 20% 高難度任務,才呼叫 Muse Spark / GPT / Claude 作為「算力昂貴的超級助手」

    這種 Hybrid Stack,既承認封閉模型的技術領先,也避免把整家公司交給單一 API。Meta 的轉向,反而會讓企業更主動規劃這種混合架構。

    3. 三國殺格局下,監管與透明度只會更糟

    當 OpenAI、Anthropic、Meta 都在核心模型上走向封閉:

    • 模型訓練資料、風險防護、對齊策略,都愈來愈不透明
    • 政府、學界、民間很難對這些系統做真正的安全審計

    責任會變成一場踢皮球遊戲:

    • API 提供者說:客戶濫用是應用層問題
    • 應用開發者說:模型是黑箱,我們也無法完全控制

    結果就是:風險外部化給社會,收益內部化在巨頭財報。


    結語:如果產業都變高牆花園,開發者該怎麼辦?

    Meta 的選擇,短期對股價與競爭力有利,但長期若所有龍頭都走向高牆花園,AI 創新會變成「少數巨頭的內部競賽」。你能做的,不是被動等下一個公告,而是主動重構自己的位置:

    1. 技術棧上,預設不信任任何單一供應商
    2. 避免只綁 Llama / Muse / GPT 任一條線
    3. 設計時就留好「可替換層」:模型抽象層、協議兼容、多家 fallback

    4. 投資在開源與自托管能力

    5. 即便主力仍是商業 API,也要保留一套能在本地跑的方案
    6. 為成本控管、資料主權、合規審計留後手

    7. 產品定位上,走向「模型不可替代」而不是「誰模型強就用誰」

    8. 把價值放在:資料網絡、行業 Know-how、流程整合,而不是「我用的是哪家模型」
    9. 讓你的產品可以在 GPT、Claude、Muse 之間切換,而不改變核心價值

    10. 對政策與公共討論,不要沉默

    11. 支持要求基礎模型 透明度、安全審計與可遷移性 的監管倡議
    12. 對「假開源、真鎖定」的行為保持警惕,並用市場選擇給出回應

    未來幾年真正的分水嶺,不是「你用哪家模型」,而是:當 AI 三國殺愈演愈烈時,你是被高牆困住的一方,還是保留了翻牆與自造工具的能力。

    🚀 你現在可以做的事

    • 審視現有技術棧,為 Llama / GPT / Muse 等模型加上抽象層,確保可隨時切換供應商
    • 部署一套可在本地或私有雲運行的開源模型(如任一 Llama 開源版),實測成本與性能
    • 盤點產品價值來源,明確寫下:哪部分依賴模型、哪部分是你獨有的資料與流程資產