標籤: Agent 框架

  • 程式碼化工具呼叫:Agent 下一步

    程式碼化工具呼叫:Agent 下一步

    📌 本文重點

    • Mistral 讓模型一次寫出完整可執行工具計畫
    • Plan 作為結構化 AST,提升可觀測性與可重放
    • 適合多步 workflow、高可靠與多代理協作場景

    Mistral 的程式碼化工具呼叫(code implemented tool calls)瞄準的痛點很直接:現有 Agent/工具呼叫機制太「鬆」——模型吐出一坨 JSON,外層 orchestrator 再硬湊成多步流程,結果是:

    • 提示工程很重(得教模型怎麼排程、怎麼分步)
    • 工具呼叫不可觀測、不易重放(難做 debug/retry)
    • 多代理協作下狀態跟交易邊界很容易打結

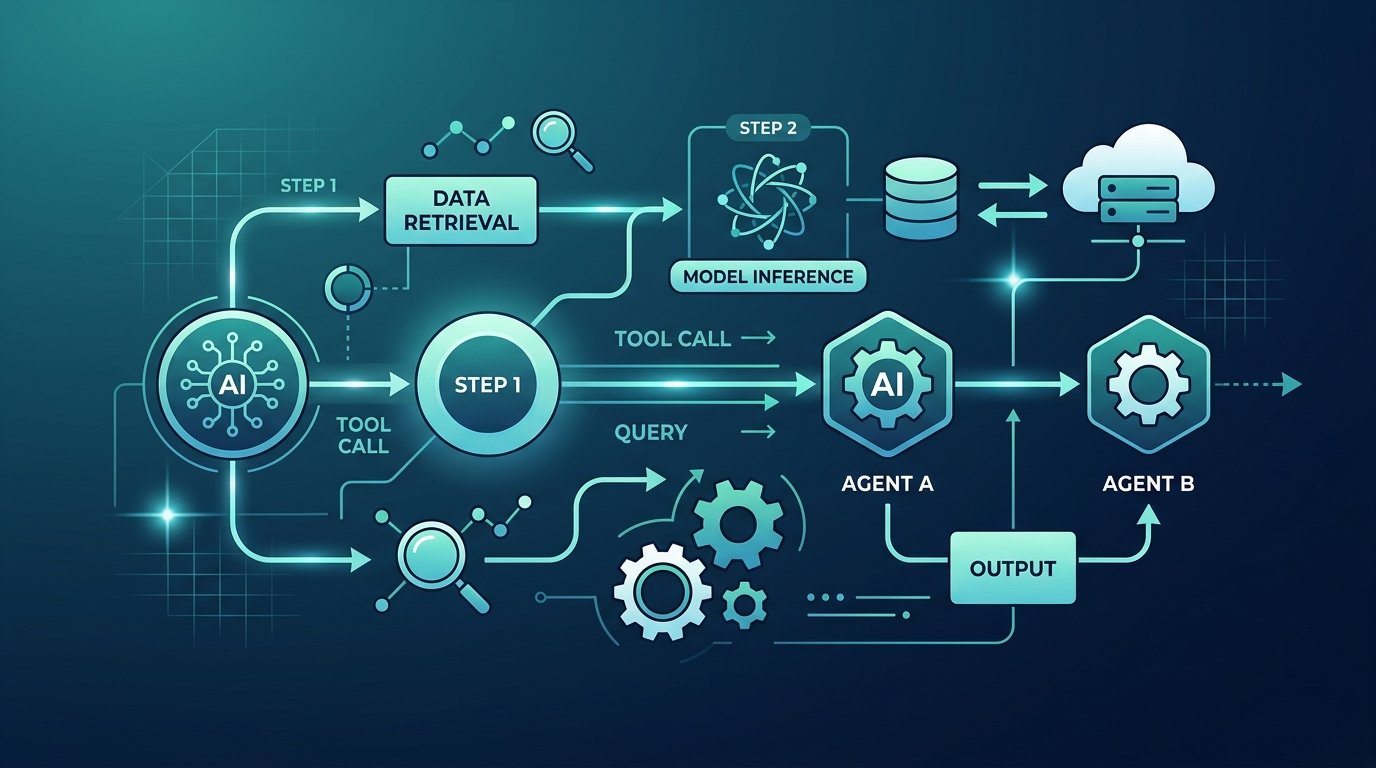
    Mistral 想做的是:讓模型在生成過程中「寫出一個可執行的工具呼叫計畫」,再由執行器直接跑這段計畫,介於「純自然語言」與「完整程式語言」之間,變成一種半結構化、可解釋的 agent 程式碼。


    重點說明

    1. 什麼是「程式碼化工具呼叫」?

    用工程語言講,就是讓模型輸出類似這樣的東西:

    plan = [
      call(tool="search_user", args={"email": "foo@bar.com"}),
      if_("result.found", then=[
        call(tool="update_user_status", args={"id": "result.id", "status": "active"})
      ], else=[
        call(tool="create_user", args={"email": "foo@bar.com"})
      ])
    ]
    

    重點不在語法,而在語意:

    • 這不是單一 function_call,而是一段可執行的呼叫腳本
    • 包含控制流程(if/loop)、工具序列、甚至回滾/補償邏輯
    • 可以被引擎解析、記錄、觀測、部分重試

    💡 關鍵: 透過「一次生成完整腳本」,LLM 從逐步決策器變成計畫產生器,大幅降低 orchestrator 與提示工程負擔

    跟 OpenAI function calling 或 MCP 比較:

    • function calling:一次「我要叫哪個工具 + 參數」,多步需要多輪迭代
    • MCP:標準化「工具服務」與「資源」,但仍偏一次一個呼叫
    • 程式碼化工具呼叫:一次生成完整 workflow blueprint,執行器負責跑與監控

    2. 與現有框架(OpenAI / MCP / LangChain)的差異

    心智模型差異:

    • LangChain / 大部分 Agent:
    • LLM 每回合決定「下一步做什麼」,像 ReAct / Planning+Execution
    • 多步推理由 orchestrator 負責追蹤與 loop
    • Mistral 這種設計:
    • 一次吐出一個計畫(plan as code),再由 runtime 執行
    • LLM 變成「計畫生成器」,而不是「每一步都要決策的狀態機」

    具體好處:

    1. 更少提示工程:
    2. 不用在 system prompt 裡教一大堆「遇到 X 就呼叫 Y、記得先查再算」
    3. 而是用工具 DSL + 執行規則約束模型:你只能用這些原語寫流程

    4. 可觀測性:

    5. 計畫本身就是一種可序列化的 execution graph
    6. 可以記錄在 DB,提供 UI 看「每次 Agent 做了哪些步驟、用了哪些工具」

    7. 重試與補償更簡單:

    8. Plan 是結構化的,你可以:
      • 只重跑失敗的 node
      • 將已成功步驟標記為 committed,失敗則跑補償工具

    💡 關鍵: Plan 作為結構化 execution graph,天然支援觀測、重試與補償,比傳統一輪一呼叫模式更適合長鏈路任務


    3. 多步推理、長任務與多代理的實際價值

    多步推理 / 長任務:

    • 對需要多輪工具呼叫(查資料 → 計算 → 寫回 DB → 發通知)的任務,
      一次生成計畫比每步都叫 LLM 決策更穩定也更便宜
    • 可以做:
    • 長任務分段執行:每段是獨立的計畫
    • 中途中斷再恢復:計畫 + 執行游標即可恢復

    多代理協作:

    • 一個 agent 產生計畫,別的 agent 只負責執行子計畫
    • 或一個高階「戰略 agent」產生 plan,交給「執行 agent」執行
    • Plan 本身扮演協作協議:各 agent 只對自己負責的子樹負責

    實作範例

    以下用 Python 與 TypeScript 模擬一個「程式碼化工具呼叫」風格的框架。重點在介面設計與工程落地,不依賴特定廠商 API。


    1. Python:計畫表示 & 執行器介面

    from typing import Any, Dict, List, Literal, Callable
    
    class ToolCall:
        def __init__(self, name: str, args: Dict[str, Any], retry: int = 0):
            self.type: Literal["tool_call"] = "tool_call"
            self.name = name
            self.args = args
            self.retry = retry
    
    class IfNode:
        def __init__(self, condition: str, then: List[Any], otherwise: List[Any] | None = None):
            self.type: Literal["if"] = "if"
            self.condition = condition  # e.g. "ctx['user']['exists'] == True"
            self.then = then
            self.otherwise = otherwise or []
    
    PlanNode = ToolCall | IfNode
    
    class Plan:
        def __init__(self, steps: List[PlanNode]):
            self.steps = steps
    
    
    class ToolRegistry:
        def __init__(self):
            self._tools: Dict[str, Callable[[Dict[str, Any]], Any]] = {}
    
        def register(self, name: str):
            def decorator(fn):
                self._tools[name] = fn
                return fn
            return decorator
    
        def get(self, name: str) -> Callable[[Dict[str, Any]], Any]:
            return self._tools[name]
    
    
    tools = ToolRegistry()
    
    @tools.register("search_user")
    def search_user(args: Dict[str, Any]):
        # 呼叫現有微服務 / DB
        ...
    
    @tools.register("create_user")
    def create_user(args: Dict[str, Any]):
        ...
    
    
    class PlanExecutor:
        def __init__(self, tools: ToolRegistry):
            self.tools = tools
    
        def run(self, plan: Plan, ctx: Dict[str, Any]):
            for step in plan.steps:
                self._run_node(step, ctx)
            return ctx
    
        def _run_node(self, node: PlanNode, ctx: Dict[str, Any]):
            if isinstance(node, ToolCall):
                self._run_tool(node, ctx)
            elif isinstance(node, IfNode):
                branch = node.then if eval(node.condition, {}, {"ctx": ctx}) else node.otherwise
                for sub in branch:
                    self._run_node(sub, ctx)
    
        def _run_tool(self, node: ToolCall, ctx: Dict[str, Any]):
            fn = self.tools.get(node.name)
            attempt = 0
            while True:
                try:
                    result = fn(node.args)
                    ctx[node.name] = result
                    return
                except Exception as e:
                    attempt += 1
                    if attempt > node.retry:
                        # 這裡可以記錄觀測資料,觸發補償
                        raise e
    

    要點:

    • Plan 是一個結構化 AST,可以序列化/儲存
    • PlanExecutor 是純程式碼,模型只產生 Plan 描述,不負責執行
    • 工具描述透過 ToolRegistry 管理,未來可以輸出 JSON schema 給 LLM 看

    2. 模型輸出格式(給 LLM 的 contract)

    你可以用 system prompt 明確要求模型輸出這種 JSON:

    {
      "steps": [
        {
          "type": "tool_call",
          "name": "search_user",
          "args": { "email": "{{user_email}}" },
          "retry": 1
        },
        {
          "type": "if",
          "condition": "ctx['search_user']['found'] == True",
          "then": [
            {
              "type": "tool_call",
              "name": "update_user_status",
              "args": {"id": "{{ctx.search_user.id}}", "status": "active"}
            }
          ],
          "otherwise": [
            {
              "type": "tool_call",
              "name": "create_user",
              "args": {"email": "{{user_email}}"}
            }
          ]
        }
      ]
    }
    

    重點:

    • Plan schema 是固定的,模型只在這個 schema 內填充內容
    • 執行器可以根據 retry 實作內建重試策略
    • condition 可以限制為簡單表達式(避免讓模型寫任意 Python)

    3. TypeScript:與微服務整合 & 錯誤恢復

    type ToolCall = {
      type: 'tool_call';
      name: string;
      args: Record<string, any>;
      retry?: number;
    };
    
    type IfNode = {
      type: 'if';
      condition: string; // 例如 "ctx.order.status === 'PAID'"
      then: PlanNode[];
      otherwise?: PlanNode[];
    };
    
    export type PlanNode = ToolCall | IfNode;
    
    export interface Tool {
      name: string;
      // 可以包 HTTP call / gRPC / queue message
      invoke: (args: any, ctx: any) => Promise<any>;
    }
    
    export class PlanRunner {
      constructor(private tools: Map<string, Tool>) {}
    
      async run(plan: PlanNode[], ctx: any, options?: { txnId?: string }) {
        for (const step of plan) {
          await this.runNode(step, ctx, options);
        }
        return ctx;
      }
    
      private async runNode(node: PlanNode, ctx: any, options?: { txnId?: string }) {
        if (node.type === 'tool_call') {
          await this.runTool(node, ctx, options);
        } else if (node.type === 'if') {
          const cond = this.evalCondition(node.condition, ctx);
          const branch = cond ? node.then : node.otherwise ?? [];
          for (const s of branch) await this.runNode(s, ctx, options);
        }
      }
    
      private async runTool(node: ToolCall, ctx: any, options?: { txnId?: string }) {
        const tool = this.tools.get(node.name);
        if (!tool) throw new Error(`Tool not found: ${node.name}`);
    
        const maxRetry = node.retry ?? 0;
        let attempt = 0;
        while (true) {
          try {
            const result = await tool.invoke(node.args, ctx);
            ctx[node.name] = result;
            // 可在這裡寫入 observability / event log
            return;
          } catch (err) {
            attempt++;
            if (attempt > maxRetry) {
              // 此處可以觸發補償工具,例如 compensate_${node.name}
              throw err;
            }
          }
        }
      }
    
      private evalCondition(expr: string, ctx: any): boolean {
        // 建議使用安全 expression evaluator,而不是直接 eval
        return Function('ctx', `return (${expr});`)(ctx);
      }
    }
    

    與現有微服務整合建議:

    • 每個工具是對應一個微服務或某個 bounded context 的 use case
    • 工具輸出應明確標示是否已提交 side effect(方便補償)
    • PlanRunner 可以在每個 tool call 前後寫入 event log,方便追蹤

    建議與注意事項

    1. 模型自由度過高 → 亂呼工具

    風險:

    • 模型可能:
    • 亂寫 condition 表達式
    • 緊密 loop 呼叫昂貴工具
    • 混用不應該同時出現的工具(跨 bounded context)

    建議:

    • 提供有限 DSL:例如只允許 if、不允許任意 while
    • 在 runtime 做 plan validation:
    • 最大深度、最大工具呼叫數
    • 禁用某些工具組合
    • 聯合 靜態規則 + LLM 自檢:生成後再請同一模型對 plan 做 sanity check

    2. 狀態與交易邊界混亂

    痛點:

    • Plan 容易跨越多個系統邊界:DB、支付、通知系統
    • 一旦中途失敗,很難知道哪一步已真正「提交」

    建議:

    • 把 工具當作 transactional boundary:
    • Tool 內部自行處理 local transaction
    • Tool 對外暴露「已提交 / 可補償」資訊
    • 在 Plan schema 中加入:
    • idempotency_key
    • compensate_tool(可選)

    範例:

    {
      "type": "tool_call",
      "name": "charge_payment",
      "args": { "order_id": "123" },
      "idempotency_key": "order-123-charge",
      "compensate_tool": "refund_payment"
    }
    

    3. 專利風險與開源 / 自建 Agent 平台

    Mistral 申請專利的關鍵關注點在於:

    • 「在生成過程中嵌入可執行工具呼叫計畫」這種整體 workflow
    • 若你建立的框架:
    • 讓 LLM 生成一段帶控制流程的工具呼叫「程式」
    • 再由執行器直接執行

    可能與專利有重疊風險。

    對開源 / 自建平台的實務建議:

    1. 盡量採用分步決策(step-wise)方式(每步 function calling),避免明確 branding 成「plan as code」
    2. 若要實作類似能力,注意:
    3. 檢查專利條款與地域適用範圍
    4. 避免與專利文本中的特定 claim 結構一模一樣
    5. 企業內部自用系統較少被追訴,但商用 SaaS/開源框架就要謹慎,特別是標榜「code implemented tool calls」之類的功能時。

    💡 關鍵: 若將「LLM 產生可執行計畫 + 執行器直接跑」打包成商用產品,需特別留意與既有專利 claim 的重疊風險


    總結:何時值得導入程式碼化工具呼叫?

    適用場景:

    • 任務天然就是多步 workflow(CRM、自動化運維、財務流程)
    • 需要強觀測性、可重放、可審計的 Agent
    • 多代理/多服務協同,想要一個「共通語言」描述任務

    不適用場景:

    • 單步問答或簡單工具呼叫(RAG 查一次資料就結束)
    • 對專利/法務非常敏感且需求不強時

    對有 AI 開發經驗的你,可以先:

    1. 在現有 Agent 系統上加一層簡單的 Plan schema(如本文示範)
    2. 讓模型輸出 plan,再由你自己的執行器跑
    3. 逐步增加:retry、compensation、observability

    這就是「程式碼化工具呼叫」在工程上的落地版本:不是只靠提示工程,而是用一個可執行、可觀測、可管控的計畫語言,把 LLM 變成真正的 workflow generator。


    🚀 你現在可以做的事

    • 在現有 Agent 專案中,加上一個最小可行的 Plan schema,讓 LLM 先輸出計畫再執行
    • 把現有工具封裝進 ToolRegistry 或類似結構,開始收集執行 log 以觀測計畫執行情況
    • 實作簡單的 plan validation 規則(最大深度/最大步數),並用一兩個實際業務 workflow 試跑驗證
  • autoswarm 自我優化本地 Agent 實戰

    autoswarm 自我優化本地 Agent 實戰

    📌 本文重點

    • 本地 Agent 痛點在於行為難以持續優化與自動化
    • autoswarm 透過 reflect → rewrite → evaluate → write-back 形成閉環
    • skills.yaml + 驗證集讓 Agent 行為像「可訓練參數」持續調整
    • 先從可量化任務(coding/CLI/FAQ)導入 autoswarm 成效最佳

    本地 Agent 最大的痛點不是「模型不夠強」,而是行為難以持續調整:你改了一堆 prompt、skills,效果好壞全憑體感,難以複製、更難自動化。autoswarm 類的自我優化流程,把這件事工程化:讓 Agent 自己從對話紀錄學習、反思、改寫技能檔,並用驗證集嚴格篩選只留下「真有幫助」的改動。

    💡 關鍵: autoswarm 把「調 prompt 靠手感」變成「技能檔可度量、可回滾的工程流程」。

    換句話說,你不再手動調 prompt,而是給 Agent 一套 reflect → rewrite → evaluate → write-back 的閉環,讓本地 coding 助手、CLI 助手、企業 FAQ agent 在你睡覺時自己變強。


    重點說明

    1. autoswarm 關鍵架構:從對話到技能檔

    典型 autoswarm 流程可以拆成四個模組,每個都可以獨立嵌進現有系統:

    1. 對話記錄收集(logs)
    2. 來源:真實使用對話、benchmark(如 TerminalBench)、內部工單。
    3. 形式:(task, context, agent_action, outcome),最好能標註 success/fail 或 score。

    4. 反思(reflect)

    5. 用一個「較強或同級」的 LLM 對失敗例子做事後檢討。
    6. 產出:錯誤原因、改進方向、需要修改的 skill 名稱/段落。

    7. 技能候選改寫(rewrite)

    8. 以 skills.yaml 內容為條件,請 LLM 產生有界改動:新增/刪除/替換特定節點,而不是整檔轟掉重寫。
    9. 借鏡 SkillOpt:每個改動要有 diff 形式 與 rationale,方便審核與回滾。

    10. 驗證集評估 + 寫回(evaluate & write-back)

    11. 對每個候選 skills 版本,跑一輪驗證集,計算 明確的 success metric(accuracy、任務完成率、延遲等)。
    12. 只有 嚴格提升 才寫回主線 skills.yaml,其餘丟棄;可選擇保留失敗改動作為「負樣本」提示未來避免。

    💡 關鍵: 整體流程等同「技能檔梯度下降」,用驗證集決定每次改寫是否保留。

    整體就是一個離線/準線上的 技能檔梯度下降:技能檔被當成可訓練參數,用反覆試錯 + 驗證集擇優更新。


    2. skills.yaml schema 與 success metric 設計

    要讓 autoswarm 好養,技能檔要易於定位、易於局部修改。一個實用的 YAML schema 可以長這樣:

    version: 3
    meta:
      agent_name: local_cli_helper
      description: "CLI + coding local agent"
    
    skills:
      - id: shell_exec
        type: tool
        trigger: ["terminal", "bash", "cli"]
        prompt: |
          你是一個嚴謹的 CLI 助手。只執行使用者要求的指令:
          - 先用自然語言解釋你要做什麼
          - 再給出具體指令
          - 不要執行具有破壞性的指令(rm -rf 等)
        guardrails:
          forbidden_patterns:
            - "rm -rf /"
            - ":(){ :|:& };:"
    
      - id: code_edit
        type: coding
        languages: ["python", "bash"]
        prompt: |
          你是一個本地 code 編輯助手:
          - 優先最小改動
          - 保留原有註解
          - 回傳可直接貼上的 patch
    
      - id: faq_lookup
        type: retrieval
        index: "internal_faq.jsonl"
        prompt: |
          你是企業 FAQ 助理,回答時:
          - 引用文件來源 id
          - 若找不到答案,要明確說明而不是亂猜
    

    幾個關鍵點:

    • id 必須穩定:autoswarm 透過 id 來定位要改哪個 skill。
    • 把行為拆成多個 skill,而不是一個 mega prompt,讓 autoswarm 有「局部調參」的空間。
    • 為每個 skill 準備可計算的 success metric,例如:
    • coding:測試通過數 / 單元測試覆蓋率提升。
    • CLI:命令 exit code == 0 且輸出包含 expected pattern。
    • FAQ:答案包含 ground truth 片段、或人工標註 score。

    💡 關鍵: 每個 skill 綁一個可量化 metric,才能自動決定「這次改寫有沒有真的變好」。


    3. 驗證集與回放:怎麼自動化

    關鍵是把「我覺得好」變成可計算的 pass/fail:

    • 來源:
    • 基準測試(TerminalBench、內部腳本集)。
    • 真的使用者對話 + 事後標註(成功:1、失敗:0)。
    • 半自動生成:用模型自己產 task,再請另一模型打分。

    • 回放機制:

    • 對每個驗證樣本 (input, expected),在新 skills.yaml 下跑一次 Agent,產生 output。
    • 用簡單的 scorer 函數 計算分數,例如:
      • coding:跑 pytest,看全部通過比例。
      • CLI:比對 stdout 是否包含關鍵字,exit code 是否為 0。
      • FAQ:用一個 judge LLM(或傳統 NLP 指標)評估是否回答到點。

    這層其實就是一個小型 harness:把「模型+skills」包成可測試的函式,對照 Deepseek 提出的觀點,就是那層讓 LLM 變成 Agent 的 runtime code。


    4. 如何嵌進現有本地 Agent(MCP/子代理/skills-based)

    不需要重寫整個 Agent,只要插入兩個 hook:

    1. log hook:在 MCP server、子代理 router 或 skills selector 前後,記錄輸入、選到的 skill、輸出、評分。
    2. offline autoswarm worker:定期(例如每天)跑反思-重寫-評估 loop,更新一個新的 skills_version,下次重啟 agent 或熱更新時載入。

    常見集成方式:

    • MCP:把 skills.yaml 當作 MCP tool 的配置,autoswarm 只負責改 YAML,MCP server 本身不改。
    • 多代理框架(如 revfactory/harness):autoswarm 對每個 agent 的 skill 檔做優化,讓「meta-agent」負責決定何時切版本。
    • 傳統 skills-based 系統:把原本寫死在程式碼裡的 prompt 抽到 YAML,才能用 autoswarm 自動調參。

    實作範例:最小可行 autoswarm(Python + YAML + Ollama)

    下面是一個極簡版的 autoswarm:針對單一 skill(faq_lookup),用對話紀錄做反思、改寫 YAML,然後用驗證集評估是否接受改動。

    1. 專案結構

    project/
      skills.yaml
      logs.jsonl         # 真實對話紀錄
      val_set.jsonl      # 驗證集
      autoswarm.py
    

    skills.yaml 示意(只保留 FAQ skill):

    skills:
      - id: faq_lookup
        type: retrieval
        prompt: |
          你是 FAQ 助理,只能根據提供的文件回答。
          若找不到答案,就回答「找不到」。
    

    2. Python:反思 → 重寫 → 評估 loop

    # autoswarm.py
    import json, copy, subprocess, textwrap
    from pathlib import Path
    import yaml
    
    SKILLS_PATH = Path("skills.yaml")
    VAL_PATH = Path("val_set.jsonl")
    LOGS_PATH = Path("logs.jsonl")
    
    # --- 基礎調用 Ollama ---
    
    def call_ollama(prompt: str, model="llama3.1") -> str:
        res = subprocess.run(
            ["ollama", "run", model],
            input=prompt.encode("utf-8"),
            stdout=subprocess.PIPE,
            check=True,
        )
        return res.stdout.decode("utf-8").strip()
    
    # --- Step 1: 從失敗 log 產生改進建議 ---
    
    def load_failed_examples(limit=5):
        examples = []
        with LOGS_PATH.open() as f:
            for line in f:
                obj = json.loads(line)
                if obj.get("success") is False:
                    examples.append(obj)
                if len(examples) >= limit:
                    break
        return examples
    
    
    def reflect_on_failures(examples):
        prompt = """你是資深 prompt engineer。以下是 FAQ agent 的失敗案例:
    
    {cases}
    
    目前 FAQ skill 的行為描述較弱,請提出如何修改 skill prompt 才能避免這些錯誤。
    
    輸出格式:
    - mistakes: 一段文字說明主要錯誤
    - patch: 改寫後的完整 prompt 內容(繁體中文)
    """
        cases_txt = "\n\n".join(
            [
                f"[CASE]\nquestion: {c['input']}\nwrong_answer: {c['output']}\nexpected: {c['expected']}"
                for c in examples
            ]
        )
        resp = call_ollama(prompt.format(cases=cases_txt))
        return resp
    
    # --- Step 2: 產生候選 skills 版本 ---
    
    def generate_candidate_skills():
        skills = yaml.safe_load(SKILLS_PATH.read_text())
        base_skills = copy.deepcopy(skills)
    
        failed = load_failed_examples()
        if not failed:
            print("no failed examples; skip")
            return None
    
        reflection = reflect_on_failures(failed)
    
        # 簡化處理:從 LLM 回應中用標記擷取 patch 區塊
        if "patch:" in reflection:
            patch = reflection.split("patch:", 1)[1].strip()
        else:
            patch = reflection
    
        # 套用到 faq_lookup
        for s in base_skills["skills"]:
            if s["id"] == "faq_lookup":
                s["prompt"] = patch
    
        return base_skills
    
    # --- Step 3: 評估一個 skills 版本 ---
    
    def run_agent(question: str, skills_obj) -> str:
        faq_skill = next(s for s in skills_obj["skills"] if s["id"] == "faq_lookup")
        sys_prompt = faq_skill["prompt"]
        full_prompt = textwrap.dedent(f"""
        系統指令:
        {sys_prompt}
    
        使用者問題:{question}
        請直接回答。
        """)
        return call_ollama(full_prompt)
    
    
    def score_skills(skills_obj) -> float:
        total, ok = 0, 0
        with VAL_PATH.open() as f:
            for line in f:
                obj = json.loads(line)
                question = obj["input"]
                expected = obj["expected"]
                out = run_agent(question, skills_obj)
                total += 1
                if expected.strip() in out:
                    ok += 1
        return ok / total if total else 0.0
    
    # --- 主流程 ---
    
    def main():
        current_skills = yaml.safe_load(SKILLS_PATH.read_text())
        base_score = score_skills(current_skills)
        print("base_score:", base_score)
    
        cand = generate_candidate_skills()
        if cand is None:
            return
    
        cand_score = score_skills(cand)
        print("candidate_score:", cand_score)
    
        if cand_score > base_score:
            backup = SKILLS_PATH.with_suffix(".bak.yaml")
            backup.write_text(SKILLS_PATH.read_text())
            SKILLS_PATH.write_text(yaml.dump(cand, allow_unicode=True))
            print("updated skills.yaml (backup saved)")
        else:
            print("candidate rejected; no improvement")
    
    
    if __name__ == "__main__":
        main()
    

    這個最小範例已經包含核心閉環:

    • 反思:reflect_on_failures 用 LLM 分析失敗案例。
    • 重寫:generate_candidate_skills 產出新的 FAQ skill prompt。
    • 評估:score_skills 在驗證集上打分。
    • 寫回 + 回滾:只有 score 提升才覆蓋 skills.yaml,並保留 .bak 方便回滾。

    你可以把 run_agent 換成實際的 MCP 調用、子代理 router,整套邏輯依然成立。


    建議與注意事項

    1. 避免過度擬合驗證集

    問題:skills 慢慢只會在 val_set 上變強,實戰反而變差。

    建議:

    • 拆 train / val / live 三層:
    • train:用來產生候選改動。
    • val:只決定是否接受改動。
    • live:真實流量,週期性抽樣評估是否「線上變好」。
    • 定期替換驗證集樣本,避免被「背題」。

    2. 技能檔膨脹與行為漂移

    問題:LLM 每輪都喜歡加條款、加例外,skills.yaml 越寫越厚,最後誰也看不懂。

    建議:

    • 為 autoswarm 的 rewrite prompt 加上硬性約束:字數上限、禁止新增無根據規則。
    • 定期跑「壓縮輪」:請模型把冗長 skill 壓縮成短版,再用同一驗證集確認不降分。
    • 每個 skill 保持一個簡短的 design doc(目的、scope、anti-goals),避免 autoswarm 把 skill「學壞」。

    3. 無標準答案任務的侷限

    在開放式對話、創作任務上,很難定義客觀 success metric。

    可以考慮:

    • 使用一個獨立 judge 模型,給 1–5 分,才算作 metric。
    • 只對「明確可評」技能開 autoswarm(如 coding、CLI、FAQ),聊天維持手動設計。
    • 針對負面行為(安全、合規)單獨設計 守門驗證集,只要出現就直接拒絕 candidate。

    4. 版本控制與回滾策略

    • 版本號:在 skills.yaml 加 version 欄位,每次 autoswarm 成功更新 +1。
    • Git 管理:把 skills 連同 autoswarm logs 一起 commit,方便 bisect。
    • 多版本 AB 測試:對企業內部 Agent,可同時跑兩個 skills 版本,對比使用者滿意度或工單解決率。

    實際好處總結:

    • 對本地 coding 助手:用單元測試當驗證集,讓 Agent 自動學會你的專案風格與工具鏈。
    • 對 CLI 助手:從錯誤指令和 crash log 中反覆學習,逐步降低「爆炸指令」風險。
    • 對企業 FAQ/ops agent:用真實工單與 FAQ 命中率做閉環,減少大家輪流調 prompt 的人工成本。

    核心心態是:把 skills.yaml 當成模型參數來訓練,而不是只在 README 裡手動修改的一段文案。有了 autoswarm loop,你的本地 Agent 就能在既有硬體上持續「自我優化」,而不是每天重訓一個新模型。

    🚀 你現在可以做的事

    • 把現有 Agent 的系統 prompt 抽成 skills.yaml,為每個 skill 補上穩定 id 與對應 metric
    • 寫一個最小版 autoswarm.py,先針對單一 skill(例如 faq_lookup)跑 reflect → rewrite → evaluate loop
    • 準備一小批驗證集(10–20 筆即可起步),接上 CI 或排程,讓 skills 每天自動小幅優化