標籤: 多代理工作流

  • RAGFlow 實戰:從 PDF 到多代理助理

    RAGFlow 實戰:從 PDF 到多代理助理

    📌 本文重點

    • RAGFlow 把各種文件變成可查詢的智慧助理
    • 支援 RAG + 多 Agent 工作流,一站式整合
    • 易於部署與接入現有系統,適合團隊內部知識應用
    • 可從簡單問答慢慢擴展到會執行任務的 AI 助理

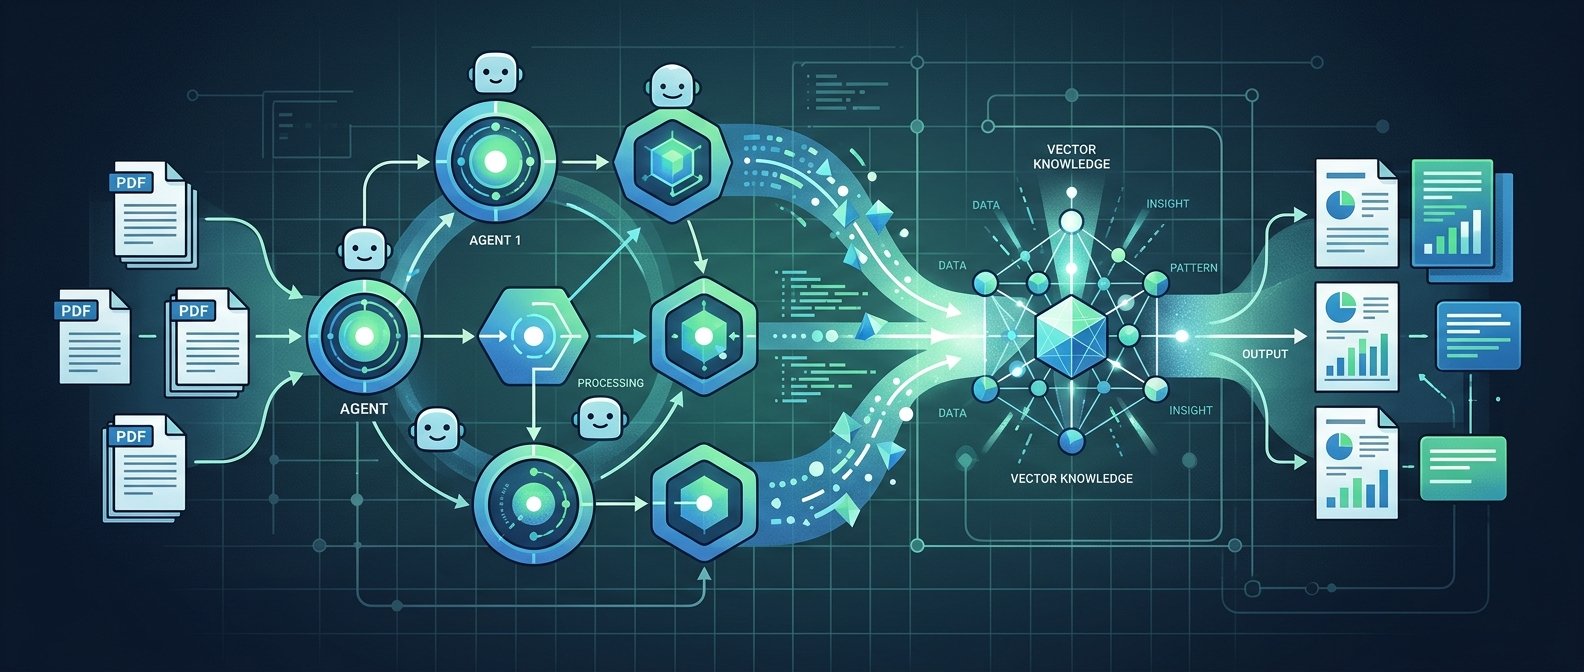
    RAGFlow 解決的問題很直接:把「一大堆文件、網頁」變成「會自己查資料、自己動手執行的 AI 助理」。

    專案連結:https://github.com/infiniflow/ragflow


    核心功能:RAG + Agent 一站搞定

    1. 資料接入與向量化:丟文件就能問

    RAGFlow 的第一層就是把各種原始資料變成「可被 LLM 搜尋理解」的向量索引。

    你可以實際做的事:

    • 支援來源大致可分:
    • 文件:PDF、Word、Markdown、純文字
    • 網頁:URL 抓取、站內內容同步
    • 結構化內容:CSV、JSON(做報表型問答很實用)
    • 常見流程:
    • 在 RAGFlow 後台建立一個 Knowledge Base
    • 上傳公司工程文檔 / 產品手冊 / SOP PDF
    • 設定切分規則(例如:依段落、標題分 chunk)
    • 選擇 Embedding 模型(內建或外部,像是 Hugging Face 上的中文向量模型)
    • 建立索引(系統會自動向量化並存入向量庫)

    這一步做完,你就等於有了一個「會理解語義」的知識庫,而不是只能關鍵字搜尋的檔案櫃。

    💡 關鍵: 透過向量化與語義搜尋,文件從「只能關鍵字查」升級成「能用自然語言問問題」的智慧知識庫。

    2. 檢索層設計:不只是「找幾段文字」

    RAGFlow 把檢索層做得比較「工程化」,可以細調:

    • 索引與向量庫選擇:
    • 內建向量引擎
    • 或接外部向量庫(如 Milvus、PgVector 等)
    • 檢索策略可調:
    • Top-K(一次取幾段)
    • 相似度門檻(不夠像就不要給模型亂猜)
    • 多輪查詢(先廣泛找,再縮小範圍)

    你可以做的調整動作:

    • 對「工程文檔」類知識庫:
    • chunk 設大一點(保留上下文),例如 800–1000 字
    • Top-K 調高(例如 8–10),避免漏掉關鍵步驟
    • 對「QA 知識庫」類資料:
    • chunk 設小一點(每題一段)
    • Top-K 只取 3–5,讓回答更集中

    這樣調完,LLM 拿到的上下文就更乾淨,回答會明顯少犯「自己亂編」的錯。

    💡 關鍵: 調整 chunk 大小與 Top-K 是降低幻覺、提升回答準確率的核心手段。

    3. 多代理協作:有人查、有人想、有人執行

    RAGFlow 的亮點是多 Agent 工作流。不是只給你一個「聊天機器人」,而是可以把任務拆給不同角色:

    常見的 Agent 角色設計:

    • Retriever Agent:只負責根據問題去知識庫檢索
    • Summarizer Agent:把檢索結果整理成可閱讀摘要
    • Planner Agent:拆解任務步驟(例如:先查產品規格,再產出比較表,最後寫結論)
    • Executor Agent:真的去調 API、寫入工單、更新系統

    你可以在 RAGFlow 裡做的事情:

    1. 建立一個 Workflow,指定多個 Agent 節點
    2. 設計流程圖:
    3. 使用者提問 → 檢索 Agent → 摘要 Agent → 回答 Agent
    4. 對客服場景:回答 Agent 判斷是否需建立工單 → 如果需要,丟給 Executor Agent 調用工單系統 API

    這種拆分的好處是:每個 Agent 的 System Prompt 可以很精準,調整也比較容易觀察哪一段出問題。

    💡 關鍵: 多 Agent 拆分角色,讓「查資料、思考、執行」三件事各自優化,比單一聊天機器人穩定得多。


    適合誰用:三個典型場景

    1. 團隊知識庫問答:工程文檔 / 產品手冊 / SOP

    適合情境:

    • 軟體團隊:想讓新人直接問「部署步驟」「API 使用範例」
    • 硬體 / SaaS 產品:希望售前售後都能秒查產品規格、授權規則

    可實際做的:

    • 建立一個「Internal KB」
    • 匯入:
    • Git repo README、Wiki 轉成 PDF
    • 內部 SOP、操作手冊、Onboarding 文件
    • 建立一個 QA Agent:只允許根據知識庫回答,不會自己瞎編超出範圍的內容

    2. 客服與支援 Bot:先查知識庫,再動手開工單

    適合情境:

    • 官網線上客服、App 內支援中心
    • B2B 工單系統前台

    可以設計的流程示例:

    1. User 問:帳號、付費、故障
    2. RAG Agent:
    3. 先查 FAQ / 幫助中心 / 條款文件
    4. 回覆解法
    5. 評估是否要升級:
    6. 若使用者多次追問或提到「不能用」「錯誤碼」,交給 Executor Agent
    7. Executor Agent 呼叫工單 API,建立 Ticket,回傳工單編號

    這樣你得到的不是一個「只能回 FAQ 的機器人」,而是能接著做事情的支援助理。

    3. 數據 / 報告助理:多來源文件 → 週報 / 簡報框架

    適合情境:

    • PM、營運:每週要整理多份報表、數據截圖、訪談記錄
    • 顧問 / 分析師:客戶給你一堆 PDF 報告,要快速產出簡報大綱

    可操作的工作流範例:

    1. 上傳:
    2. Google Analytics / Amplitude 匯出報表(CSV)
    3. 各部門週報(PDF/Docx)
    4. 客戶訪談逐字稿
    5. Workflow 設計:
    6. 檢索 Agent:依照「本週」「產品 A」「轉換率」等關鍵詞找資料
    7. 摘要 Agent:對各來源做重點整理
    8. 報告 Agent:產出「本週成效總結 + KPI 變化原因 + 下週建議行動」框架

    你可以在此基礎上,讓 Executor Agent 直接生成 Markdown / PPT 大綱,甚至丟到自家文檔系統。


    怎麼開始:從部署到接入自家系統

    1. 用 Docker 一鍵部署 RAGFlow

    先準備一台機器(本機或雲端均可):

    • 建議配置:
    • CPU 4 核以上
    • RAM 8GB 以上
    • 有 GPU 更好(但非必須)

    以 Docker Compose 為例(以官方 README 為準):

    # 取得專案
    git clone https://github.com/infiniflow/ragflow.git
    cd ragflow
    
    # 啟動(實際指令以官方文件為準)
    docker compose up -d
    

    啟動後:

    • 打開瀏覽器訪問類似 http://localhost:port 的管理介面(依官方說明)
    • 建立管理帳號

    官方專案與更新請看:https://github.com/infiniflow/ragflow

    2. 接一個免費 / 便宜 LLM

    RAGFlow 可以接:

    • 本地部署開源模型(透過 Ollama / vLLM 等)
    • 或雲端 API(OpenAI、阿里通義、字節、百度等)

    如果你想先用開源模型:

    • 選擇方向示例:
    • Qwen 系列(中文友好)
    • Gemma / Gemma 2(Google 開源,英文較強)
    • Nemotron / Nemotron Lightning(適合雲端部署,高效推論)

    實作步驟:

    1. 在 RAGFlow 的 LLM 設定頁,新增模型提供者
    2. 如果用雲端 API:填入 API Key、模型名稱(如 qwen-turbo)
    3. 如果接本地:填寫本地推論服務的 URL(例如你用 vLLM 啟的 endpoint)

    測試方式:在介面裡直接試打一段文字,看能否正常回應。

    3. 走一個 End-to-End 範例:PDF → Agent Workflow

    假設你要做一個「公司內部 SOP 助理」。

    1. 建立知識庫
    2. 在後台新增 Knowledge Base:company-sop
    3. 上傳:人資流程 SOP、報銷流程、IT 報修流程(PDF/Word)
    4. 設定:

      • chunk 大小 500–800 字
      • 選一個中文向量模型(如 bge-large-zh 類)
      • 建立索引
    5. 建立簡單 Agent 工作流

    6. 建立一個 Workflow:sop-assistant
    7. 節點配置:
      • 節點 1:User Input
      • 節點 2:Retrieval Agent
      • 指定使用 company-sop 知識庫
      • 節點 3:Answer Agent
      • System Prompt 例:
        > 你是公司內部 SOP 助理,只能根據提供的 SOP 文件回答。若文件中沒有相關內容,請明確說「文件中沒有這部分說明」並建議聯絡負責部門。
    8. 連線:User Input → Retrieval Agent → Answer Agent → 輸出

    9. 測試互動

    10. 在 Workflow 測試頁輸入:
      • 「新人報到第一天要做哪些流程?」
      • 「海外差旅報銷要準備什麼文件?」
    11. 檢查:Answer Agent 回覆中是否有明確指出 SOP 條款、步驟,必要時微調 chunk / Top-K。

    4. 用 REST API 接入自家網站 / 工具

    完成 Workflow 之後,你可以透過 HTTP 對它發問,嵌入到產品裡。

    典型 API 互動(偽例,請依官方文件實際調整路徑):

    POST http://your-ragflow-host/api/workflows/sop-assistant/run
    Content-Type: application/json
    
    {
      "input": {
        "query": "我要怎麼申請筆電維修?"
      }
    }
    

    後端會回一個 JSON,其中包含:

    • 模型回答內容
    • 可能還有使用到的文件片段(方便你在前端顯示「引用來源」)

    實際接入建議:

    • 官網 / 內部系統前端:做一個 Chat UI,後端把使用者輸入轉發到 RAGFlow API
    • 內部 Bot(如 Slack、Teams):寫個小 Bot,把訊息丟給 Workflow API,再把回答貼回頻道

    補充:RAGFlow、向量庫與模型框架的關係

    要把整套系統看清楚,可以把角色分成三層:

    名稱 核心功能 免費方案 適合誰
    RAGFlow (https://github.com/infiniflow/ragflow) RAG + 多 Agent 工作流、資料接入、檢索與 LLM 編排 開源自架 想做完整 RAG 應用、需要工作流與 API 的團隊
    向量資料庫(如 Milvus、Postgres + pgvector) 儲存與檢索向量,支援語義搜尋 多數有開源版 有大量文檔 / 多模態資料,要穩定、高效向量檢索的團隊
    Transformers (https://github.com/huggingface/transformers) 提供各類 LLM / embedding 模型與推論框架 開源 需要自行訓練 / 微調模型、客製化 NLP 任務的工程師

    可以簡單理解為:

    • Transformers 負責「模型」
    • 向量庫負責「記憶」
    • RAGFlow 把兩者接在一起,幫你做「會查資料又會動手的 AI 助理」

    想快速上手 RAGFlow,最實用的路徑就是:一台機器 + Docker、一個便宜或免費的 LLM API、一疊 PDF,先做出一個真的能回答問題的內部助理,再慢慢加上更多 Agent 和外部 API,讓它從「會回答」進化到「會幫你做事」。

    🚀 你現在可以做的事

    • 到 GitHub 下載 RAGFlow 專案並用 docker compose up -d 在測試機器上啟動
    • 準備一疊內部 SOP / 產品手冊 PDF,上傳到新建的 Knowledge Base 做第一版助理
    • 在 RAGFlow 裡配置一個簡單 Workflow,然後用自家網站或 Slack Bot 透過 REST API 接入試跑
  • OmniRoute:一個 Endpoint 玩遍 200+ 模型

    OmniRoute:一個 Endpoint 玩遍 200+ 模型

    📌 本文重點

    • OmniRoute 用一個 Endpoint 串接 200+ 模型供應商
    • 內建 RTK + Caveman 壓縮,可節省 15–95% token 成本
    • 支援 MCP / A2A、多代理、多模態 Workflow
    • 適合多模型整合與成本優化的開發者

    用一句話先說清楚:OmniRoute 是一個多雲、多模型的一站式 AI 總機,讓你用同一個 API Endpoint,同時接上 Claude、GPT、Cursor、Copilot 等 200+ 家模型供應商,還順手幫你壓縮 token、自動跳備援模型。

    官方開源庫:https://github.com/diegosouzapw/OmniRoute


    核心功能 1:一個 Endpoint 管理多供應商+自動備援

    傳統做法是:每接一個模型,就要再接一個 SDK / API Key / Base URL。結果是:

    • 前端要切換模型,就得改環境變數
    • 後端要做 fallback,要自己寫 retry + 陣痛的錯誤處理

    OmniRoute 的做法是:所有模型統一走一個 OmniRoute Endpoint,後面怎麼分流、切換供應商、失敗改用誰,全都在 OmniRoute 的設定檔完成。

    💡 關鍵: 把所有模型統一進一個 Endpoint,可以一次解決多家供應商整合與備援問題,前後端只維護單一接點。

    你可以怎麼用

    以「同一個 Code Agent,要能在 Claude / GPT / 本地模型之間切換」為例:

    1. 在 OmniRoute 設定三個 provider:
    2. anthropic/claude-3.5(主力)
    3. openai/gpt-4.1(備援)
    4. local/deepseek(成本最低版)
    5. 設定路由策略:
    6. 主 Endpoint:先走 Claude
    7. 當 Claude timeout 或額度用完,自動 fallback 到 GPT
    8. 夜間批量任務改走本地模型
    9. 在你的程式碼中,只保留一個 OMNIROUTE_API_URL:

    ts
    const response = await fetch(process.env.OMNIROUTE_API_URL, {
    method: "POST",
    headers: {
    "Content-Type": "application/json",
    "Authorization": `Bearer ${process.env.OMNIROUTE_API_KEY}`,
    },
    body: JSON.stringify({
    model: "code-agent", // 這是 OmniRoute 裡定義的邏輯模型名
    messages,
    }),
    });

    可行動建議:

    • 手上的專案如果同時接了 Anthropic + OpenAI + 本地模型,可以先挑一個 API Call 練手,把三個 Base URL 改成一個 OmniRoute URL,測試 auto-fallback 是否生效。

    核心功能 2:RTK + Caveman 壓縮,節省 15–95% token 成本

    OmniRoute 內建兩種壓縮:

    • RTK(Reversible Tokenization Kernel):對常見 prompt 做結構化壓縮,適合長系統提示、多輪聊天歷史
    • Caveman 壓縮:偏「野蠻」但更激進,會重寫聊天記錄,把冗長表述變成精簡語句

    效果:

    • 系統長 prompt:省 15–40% token
    • 帶大量上下文(如文檔 QA):最高可到 95% token 減少

    💡 關鍵: 啟用 RTK 與 Caveman 壓縮後,長上下文任務可大幅降低 15–95% token 成本,直接反映在帳單與模型限額上。

    你可以怎麼用

    以「把整份 API 文檔塞給模型當『長期記憶』」為例:

    1. 在 OmniRoute 後台或設定檔,為 doc-assistant 這條路由開啟壓縮:

    yaml
    routes:
    - id: doc-assistant
    model: anthropic/claude-3.5
    compression:
    rtk: true
    caveman: true

    1. 程式端依然用原本的 messages 結構呼叫,不用自己壓縮:

    jsonc
    {
    "model": "doc-assistant",
    "messages": [
    {"role": "system", "content": "你是某某專案的文檔助手..."},
    {"role": "user", "content": "請根據附件 API 文檔..."}
    ]
    }

    1. OmniRoute 會在轉給底層模型前自動壓縮,再在輸出時解壓(對你來說是透明的)。

    可行動建議:

    • 先挑「最長」的那支 API(例如:聊天歷史超長、帶多篇 PDF 的 QA),在 OmniRoute 上開 RTK+獵人模式(Caveman),觀察一次請求的 token 使用量與帳單變化。

    核心功能 3:MCP / A2A、多代理、多模態 Workflow

    OmniRoute 支援:

    • MCP(Model Context Protocol):讓不同工具 / 代理共享同一套上下文與工具列表
    • A2A(Agent-to-Agent):代理之間可互相呼叫,形成多步驟協作
    • 多模態 API:文字 + 圖片(甚至影音)混合輸入

    這讓你可以把原本散落在不同工具的能力,集中到一條 Workflow 裡。例如:

    • Code Agent 負責寫程式
    • Doc Agent 負責查文件、對比版本
    • Vision Agent 負責讀錯誤截圖

    💡 關鍵: 利用 MCP 與 A2A,可以把多個專職 Agent 串成一條 Workflow,讓 Code、Doc、Vision 等能力在同一上下文中協作。

    你可以怎麼用

    以「Side Project 的 Code Agent + 文檔助手」為例:

    • Code Agent:
    • 模型:Claude 3.5 Sonnet
    • 任務:生成程式碼、重構
    • 文檔助手:
    • 模型:GPT-4.1 / Gemini
    • 任務:閱讀 API 文檔、產生說明
    • 多模態:
    • 模型:如 Gemini / GPT-4o
    • 任務:讀錯誤截圖

    在 OmniRoute 裡定義三條路由,讓 Code Agent 能直接「轉接」給 Doc Agent:

    routes:
      - id: code-agent
        model: anthropic/claude-3.5
        a2a:
          doc-agent: true
          vision-agent: true
      - id: doc-agent
        model: openai/gpt-4.1
      - id: vision-agent
        model: google/gemini-1.5
    

    可行動建議:

    • 先只做兩個代理(Code + Doc),在 OmniRoute 設定 A2A,讓 Code Agent 遇到「不知道 API 用法」時,把問題轉給 Doc Agent,再把結果回傳給使用者。

    實作示範:Side Project 串三家模型的 Code Agent + 文檔助手

    來做一個具體場景:

    需求:在同一個 Side Project 裡,整合三家模型,做一個簡單的「程式碼助理 + 文檔助手」,前端只有一個 Chat UI,後端只有一個 OmniRoute Endpoint。

    架構示意

    • 前端(Next.js / React):
    • 單一聊天框
    • 輸入模式按鈕:寫程式 / 問文檔
    • 後端:
    • 全部請求送到 OMNIROUTE_URL
    • model 欄位用來指定走哪個 logical route(code-agent or doc-assistant)
    • OmniRoute:
    • code-agent → Claude(主)+ GPT(備)
    • doc-assistant → GPT + Caveman 壓縮
    • vision-agent → Gemini,多模態

    前端呼叫範例(TypeScript):

    async function callAgent(mode: "code" | "doc", messages) {
      const model = mode === "code" ? "code-agent" : "doc-assistant";
    
      const resp = await fetch(process.env.NEXT_PUBLIC_OMNIROUTE_URL!, {
        method: "POST",
        headers: {
          "Content-Type": "application/json",
          Authorization: `Bearer ${process.env.NEXT_PUBLIC_OMNIROUTE_KEY}`,
        },
        body: JSON.stringify({ model, messages }),
      });
    
      return resp.json();
    }
    

    後端與前端都不用知道「底下到底是 Claude 還是 GPT」,只認 model: "code-agent" 與 model: "doc-assistant" 兩種邏輯角色即可。


    10 分鐘開箱:從零到第一條 OmniRoute

    以下是一條「最短路徑」,讓你在 10 分鐘內把現有專案換成 OmniRoute。

    1. 註冊與安裝(3 分鐘)

    1. 打開 GitHub 專案:https://github.com/diegosouzapw/OmniRoute
    2. 把 repo 拉下來:

    bash
    git clone https://github.com/diegosouzapw/OmniRoute
    cd OmniRoute
    pnpm install # 或 yarn / npm

    1. 照 README 建一個 .env,填入你現有的 OpenAI / Anthropic 等 API Key。

    2. 啟動 OmniRoute Server(2 分鐘)

    pnpm dev # 或對應的 start 指令
    

    啟動後會有一個本地 URL,例如:http://localhost:8787/v1/chat/completions,這就是你的「總機 Endpoint」。

    3. 設定第一個路由 + 壓縮策略(3 分鐘)

    在 config/routes.yaml(實際以專案為準)中:

    routes:
      - id: code-agent
        model: anthropic/claude-3.5
        fallback:
          - openai/gpt-4.1
        compression:
          rtk: true
          caveman: false
    
      - id: doc-assistant
        model: openai/gpt-4.1
        compression:
          rtk: true
          caveman: true
    

    完成後重新啟動 OmniRoute(若需要)。

    4. 把前端 / 後端改成單一 OmniRoute URL(2 分鐘)

    無論你原本用什麼 SDK(OpenAI, Anthropic, Cursor plugin):

    • 把 baseURL 改成你的 OMNIROUTE_URL
    • 把 model 改成 OmniRoute 裡定義的 id(例如 code-agent)

    以 OpenAI SDK 為例:

    import OpenAI from "openai";
    
    const client = new OpenAI({
      baseURL: process.env.OMNIROUTE_URL,
      apiKey: process.env.OMNIROUTE_KEY,
    });
    
    await client.chat.completions.create({
      model: "code-agent",
      messages,
    });
    

    到這一步,你已經:

    • 用一個 Endpoint 串起至少兩家模型
    • 開啟 basic 的 token 壓縮
    • 為之後加上更多 provider / 代理 / 模態預留位置

    適合誰用?

    使用者類型 具體場景
    獨立開發者 Side Project 同時想用 Claude + GPT + 免費模型,又懶得寫一堆整合
    小團隊 / Startups 想 A/B 測試不同供應商,控制成本,還要有 auto-fallback 防止掛點
    AI Agent Builder 需要多代理協作(Code + Doc + Vision),又希望前端只接一個 Endpoint
    教學 / 實驗環境 需要一鍵切換教學用模型、控制學生 token 使用量

    如果你符合其中一項,可以先把 OmniRoute 當成:

    「把所有 AI 模型集中管理的一支 API Gateway」,再視需要逐步開啟壓縮、A2A、多模態。


    OmniRoute 與其他多模型工具比較

    名稱 核心功能 免費方案 適合誰
    OmniRoute 多供應商整合、auto-fallback、RTK/Caveman 壓縮、MCP/A2A、多模態 開源,支援 50+ 免費供應商 想統一管理多家模型、做複雜 Workflow 的開發者
    直接用 OpenAI 單供應商模型 API 有免費試用額度 只用 GPT 系列、需求簡單的專案
    直接用 Anthropic 單供應商 Claude 模型 有免費試用額度 只想專注 Claude Code / Sonnet

    如果你只接一個模型供應商,OmniRoute 可以先當「統一壓縮 + 路由層」;當你的模型越來越多,它就自然變成你的多雲總機。


    🚀 你現在可以做的事

    • 打開 OmniRoute GitHub 專案,依照 README 在本地啟動一個測試伺服器
    • 挑一支現有的 API 呼叫,將 baseURL 改成 OMNIROUTE_URL,並在 routes.yaml 設好對應的 model id
    • 在同一條路由上開啟 RTK 或 Caveman 壓縮,對比啟用前後的 token 使用量與費用差異
  • 用瀏覽器跑自己的 AI Agent:peerd 實戰

    用瀏覽器跑自己的 AI Agent:peerd 實戰

    📌 本文重點

    • peerd 把瀏覽器變成本機 AI Agent 執行環境
    • 純前端運作,API Key 不經過第三方伺服器
    • 多 Agent 隔離與瀏覽器自動化,適合個人工作流與 QA 腳本

    用一句話講清楚:peerd 就是把「瀏覽器」變成你的 AI Agent 執行環境,所有腳本、代理邏輯都在本機瀏覽器裡跑,不經過第三方伺服器。

    連結先給你:
    – GitHub / 官方介紹:https://github.com/NotASithLord/peerd
    – Demo / 官網入口:https://peerd.ai


    核心功能:瀏覽器就是沙盒 + 多 Agent 控制台

    1. 純前端 JS,API Key 只在你機器裡

    peerd 是一個瀏覽器擴充套件,用原生 JavaScript 寫成,執行邏輯都在前端:

    • 你自己輸入 OpenAI、Anthropic、Gemini 等 API Key
    • 請求直接從瀏覽器送出,不經過 peerd 的伺服器
    • 不需要額外安裝「AI 瀏覽器」或開一個本地 server

    💡 關鍵: API 呼叫完全在本機瀏覽器完成,你的金鑰與請求內容不會經過第三方後端服務。

    你可以立刻做的事:
    1. 打開 https://peerd.ai,依照說明安裝瀏覽器擴充套件(目前以 Chromium / Chrome 系列最佳)。
    2. 安裝後,在擴充圖示裡找到 peerd,開啟設定頁,填入你現有的 OpenAI / Anthropic / Gemini API Key。
    3. 測試呼叫一次簡單指令(例如:讓 Agent 幫你總結目前開啟頁面的內容),確認 Key 有效。

    2. 多 Agent,彼此隔離在不同 sandbox / worker

    peerd 的設計重點是:一個瀏覽器,多個 Agent,各自有自己的工作空間。

    它利用:

    • 多分頁 / 多視窗
    • Web Worker / Service Worker

    來把不同 Agent 隔離,例如:

    • Agent A:專門抓資料,跑在一個 Worker 裡
    • Agent B:負責整理與寫摘要,跑在另一個 Worker
    • Agent C:只負責觸發 UI 操作

    彼此透過訊息溝通,但記憶體與腳本隔離,減少互相干擾。

    💡 關鍵: 每個 Agent 在獨立的 worker/sandbox 裡執行,降低互相干擾與權限混用風險。

    你可以立刻做的事:
    1. 在 peerd 的控制面板中,建立兩個 Agent:例如「資料收集 Agent」「摘要整理 Agent」。
    2. 設定:「資料收集 Agent」負責打開網站、擷取內容;完成後把文字丟給「摘要整理 Agent」。
    3. 觀察兩個 Agent 的 log(通常 peerd 會有 console / log 面板),確認任務是分開跑的。

    3. 自動化瀏覽、跑 JS 腳本,甚至開 WebAssembly VM

    peerd 不只有「叫模型寫文字」這一招,它可以:

    • 控制瀏覽器行為:
    • 自動打開指定網址
    • 在頁面中執行 DOM 查詢、抓元素文字
    • 觸發按鈕點擊、輸入框填寫
    • 執行 JavaScript 腳本:在 sandbox 內跑程式邏輯,像一個本地化的「Agent 腳本引擎」
    • 啟動 WebAssembly(WASM)虛擬機:甚至可在瀏覽器裡跑一個簡化版的 Linux VM + 網路堆疊

    這代表:

    • 你不用額外架 server 就能做「自動化 QA 腳本」
    • 可以把實驗性 side project 完整關在瀏覽器裡玩,不動你的主機環境

    你可以立刻做的事:
    1. 用 peerd 新增一個「任務腳本」,讓它在分頁裡執行以下行為:
    – 打開一個新聞網站
    – 用 document.querySelectorAll('h1, h2') 抓標題
    – 把標題串成一段文字
    2. 把這段文字交給 LLM,請它生成摘要,顯示在 peerd 的面板中。
    3. 如果你熟 JS,可以把這個流程包成一個可重複執行的腳本,日後一鍵跑。


    適合誰用:三種具體場景

    1. 個人資訊整理 / 研究助手

    使用情境:

    • 你每天會看固定幾個新聞網站或技術部落格
    • 想要「早上開機 → 一鍵跑 → 自動抓標題 → 整理成 一頁摘要」

    可以這樣設計一個 peerd Agent:

    1. 設定一個 URL 清單(例如:三個新聞站 + 一個技術站)。
    2. Agent 依序打開每個網站,抓取首頁標題(或特定區塊)。
    3. 把所有標題與小段落交給 LLM,產出:
    4. 一份今日重點摘要
    5. 分類(國際 / 本地 / 技術 / 商業)
    6. 把結果顯示在 peerd 面板,或存成一段 Markdown,傳回你的筆記系統。

    適合:

    • 喜歡自己控制流程、但不想寫一堆後端程式的人
    • 不想讓瀏覽紀錄、研究內容經過第三方服務的人

    2. 產品 / 網頁 QA 腳本、互動 Demo

    peerd 可以把「瀏覽器自動操作 + LLM」組成 QA 工作流:

    範例:

    1. 定義一組 QA 腳本:
    2. 打開測試環境網址
    3. 自動登入測試帳號
    4. 點幾個主要流程(新增、編輯、刪除),截取畫面文字
    5. Agent 檢查:
    6. 是否有錯誤訊息
    7. 版面文字是否符合規格(例如:翻譯是否正確)
    8. 把結果整理成一份 QA 報告,直接在瀏覽器下載或複製。

    適合:

    • 前端工程師、PM、設計師,想要簡單重複測試
    • 需要做互動 Demo,讓 Agent 自動「操作產品給觀眾看」

    3. 不想碰 DevOps 的 side project / workflow 原型

    如果你平常:

    • 有很多「想做個小工具」的點子
    • 但一想到要架 server、部署,就懶了

    peerd 提供一種做法:全部寫成瀏覽器 Agent 腳本:

    • 把流程寫在 JS 裡(在 peerd 提供的 sandbox 中)
    • 需要呼叫 LLM,就用自己的 Key
    • 存資料可以暫時放在 LocalStorage、下載檔案、或手動貼回 Notion / Obsidian

    適合:

    • 想先驗證「這個工作流值不值得做成正式產品」的人
    • 想建立個人專用工作流,但不想管理伺服器的人

    怎麼開始:從「自動抓新聞標題摘要」實作一路到客製 Agent

    以下是一條最快速的上手路徑,你可以照做一次,確認 peerd 的使用感覺。

    步驟 1:安裝 peerd 擴充 & 準備 API Key

    1. 打開 https://peerd.ai,找到瀏覽器擴充安裝連結(多為 Chrome Web Store 或手動載入)。
    2. 安裝完成後,點右上角擴充圖示 → 找到 peerd → 打開控制面板。
    3. 準備至少一個 LLM 服務:
    4. OpenAI(或相容 API)
    5. Anthropic
    6. Gemini
    7. 在 peerd 設定頁,填入你的 API Key,並測試一個簡單 prompt(例如:「請用 50 字說明你是誰」)。

    💡 關鍵: 先用簡單 prompt 驗證 API Key 設定無誤,可以避免後續腳本除錯時間。

    步驟 2:建立一個「新聞摘要 Agent」

    目標:自動打開幾個新聞站,抓首頁標題,總結成一段簡報。

    可以照以下邏輯:

    1. 在 peerd 新建一個 Agent,命名為 NewsSummarizer。
    2. 設定任務腳本(概念上類似 pseudo-code):

    “`js
    const sites = [
    ‘https://news.ycombinator.com’,
    ‘https://www.bbc.com/news’,
    ‘https://www.ft.com’
    ];

    async function run() {
    const allHeadlines = [];

     for (const url of sites) {
       const page = await openTab(url); // peerd 提供的抽象 API(實際名稱依文件)
       const titles = await page.eval(() => {
         return Array.from(document.querySelectorAll('h1, h2'))
           .map(el => el.innerText)
           .filter(Boolean);
       });
       allHeadlines.push({ url, titles });
     }
    
     const prompt = `請根據以下新聞標題,用繁體中文整理出今日重點摘要,分段列出:\n\n${
       JSON.stringify(allHeadlines, null, 2)
     }`;
    
     const summary = await callLLM(prompt); // 依照你選的 provider
     output(summary);
    

    }

    run();
    “`

    1. 儲存腳本後,按「執行」:
    2. peerd 會依序開啟那些網站
    3. 抓取標題
    4. 呼叫 LLM 總結
    5. 在側邊面板或 console 顯示結果

    你可以依照自己的需求修改:

    • 換成台灣 / 香港 / 日本新聞網站
    • 加上「只保留包含特定關鍵字的標題」
    • 把 summary 轉成 Markdown,方便貼到筆記

    步驟 3:客製自己的 Agent 腳本

    當你跑過一次「新聞摘要 Agent」後,可以開始做這幾件事:

    1. 抽出共用邏輯:例如「開頁+抓標題」寫成一個可重用的 function,日後換站台不用重寫。
    2. 加入排程或手動檔案輸出:
    3. 每次執行後自動下載一個 .md 或 .txt
    4. 或直接在 peerd 面板顯示,手動複製
    5. 改成其他任務:
    6. 產品價格比價(抓不同電商同一商品)
    7. 技術文章整理(從多個 blog 抓標題+摘要)

    步驟 4:注意權限與安全設定

    雖然 peerd 是純前端、API Key 在你機器上,但仍有幾個安全重點:

    1. 網站權限:
    2. 當瀏覽器問「是否允許此擴充存取某些網站」時,只開啟你真的需要的網域。
    3. API Key 保護:
    4. 不要在共享電腦上使用 peerd,或至少不要留下儲存的 Key
    5. 若用公用電腦,建議使用臨時 Key,使用完立刻 revoke
    6. 腳本來源:
    7. 只執行你自己寫的,或來自可信來源的腳本
    8. 不要隨便貼「網友分享的完整腳本」就直接跑,避免讀寫你不想暴露的資料

    peerd 在 AI Agent 工具裡的位置

    目前市面上有不少「Agent 平台」或「AI 瀏覽器」,peerd 的定位比較特別:

    名稱 核心功能 免費方案 適合誰
    peerd 瀏覽器內純前端多 Agent、自動化操作 開源專案,可自架 不想碰後端,只想用瀏覽器的人
    AutoGen 多 Agent Python 框架 開源 已有後端環境的開發者
    AgentHub 類 雲端 Agent 編排平台 多提供免費額度 喜歡 GUI、無法自管 API Key 的人

    如果你的重點是:「所有東西都在我瀏覽器裡跑,不想任何 A2A(Agent-to-Agent)中介干預」,那 peerd 很值得試一次。


    結論:

    • 想要一個「不碰後端、不開伺服器」的 AI Agent 沙盒,peerd 是目前少見的純瀏覽器方案。
    • 它最適合拿來做:個人資訊整理、簡易 QA 腳本、side project 原型。
    • 你可以從一個「新聞標題摘要 Agent」開始,熟悉後再把自己的工作流程慢慢搬進瀏覽器裡。

    🚀 你現在可以做的事

    • 到 peerd 官網 安裝擴充,填入自己的 OpenAI / Anthropic / Gemini API Key 並跑一次測試 prompt
    • 依照文中的範例,建立一個 NewsSummarizer Agent,實作「自動抓新聞標題+摘要」工作流
    • 把現有的一項重複性瀏覽器流程(例如 QA 點測、價格比價),改寫成 peerd Agent 腳本並在本機瀏覽器中試跑