
📌 本文重點
- RAGFlow 把各種文件變成可查詢的智慧助理
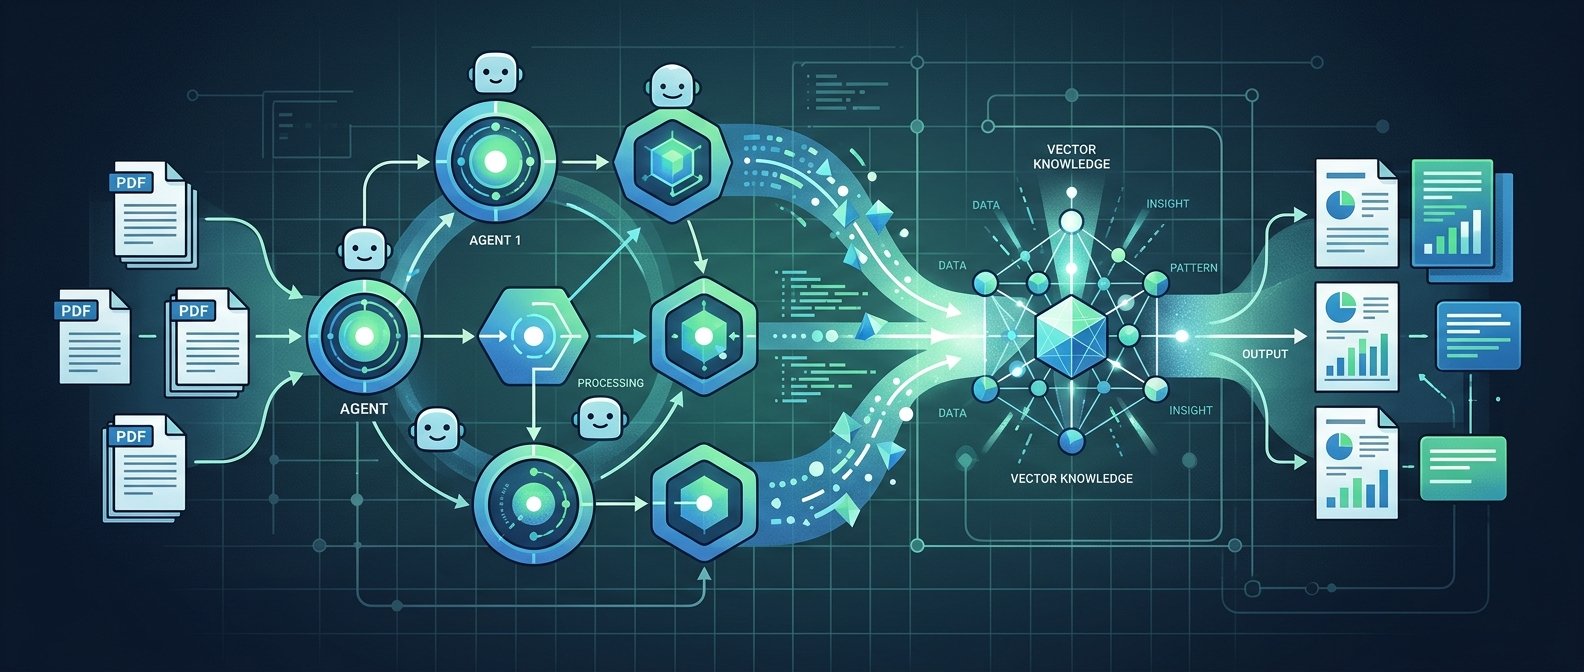
- 支援 RAG + 多 Agent 工作流,一站式整合
- 易於部署與接入現有系統,適合團隊內部知識應用
- 可從簡單問答慢慢擴展到會執行任務的 AI 助理
RAGFlow 解決的問題很直接:把「一大堆文件、網頁」變成「會自己查資料、自己動手執行的 AI 助理」。
核心功能:RAG + Agent 一站搞定
1. 資料接入與向量化:丟文件就能問
RAGFlow 的第一層就是把各種原始資料變成「可被 LLM 搜尋理解」的向量索引。
你可以實際做的事:
- 支援來源大致可分:
- 文件:PDF、Word、Markdown、純文字
- 網頁:URL 抓取、站內內容同步
- 結構化內容:CSV、JSON(做報表型問答很實用)
- 常見流程:
- 在 RAGFlow 後台建立一個
Knowledge Base - 上傳公司工程文檔 / 產品手冊 / SOP PDF
- 設定切分規則(例如:依段落、標題分
chunk) - 選擇 Embedding 模型(內建或外部,像是 Hugging Face 上的中文向量模型)
- 建立索引(系統會自動向量化並存入向量庫)
這一步做完,你就等於有了一個「會理解語義」的知識庫,而不是只能關鍵字搜尋的檔案櫃。
💡 關鍵: 透過向量化與語義搜尋,文件從「只能關鍵字查」升級成「能用自然語言問問題」的智慧知識庫。
2. 檢索層設計:不只是「找幾段文字」
RAGFlow 把檢索層做得比較「工程化」,可以細調:
- 索引與向量庫選擇:
- 內建向量引擎
- 或接外部向量庫(如
Milvus、PgVector等) - 檢索策略可調:
Top-K(一次取幾段)- 相似度門檻(不夠像就不要給模型亂猜)
- 多輪查詢(先廣泛找,再縮小範圍)
你可以做的調整動作:
- 對「工程文檔」類知識庫:
chunk設大一點(保留上下文),例如 800–1000 字Top-K調高(例如 8–10),避免漏掉關鍵步驟- 對「QA 知識庫」類資料:
chunk設小一點(每題一段)Top-K只取 3–5,讓回答更集中
這樣調完,LLM 拿到的上下文就更乾淨,回答會明顯少犯「自己亂編」的錯。
💡 關鍵: 調整
chunk大小與Top-K是降低幻覺、提升回答準確率的核心手段。
3. 多代理協作:有人查、有人想、有人執行
RAGFlow 的亮點是多 Agent 工作流。不是只給你一個「聊天機器人」,而是可以把任務拆給不同角色:
常見的 Agent 角色設計:
Retriever Agent:只負責根據問題去知識庫檢索Summarizer Agent:把檢索結果整理成可閱讀摘要Planner Agent:拆解任務步驟(例如:先查產品規格,再產出比較表,最後寫結論)Executor Agent:真的去調API、寫入工單、更新系統
你可以在 RAGFlow 裡做的事情:
- 建立一個
Workflow,指定多個 Agent 節點 - 設計流程圖:
- 使用者提問 → 檢索 Agent → 摘要 Agent → 回答 Agent
- 對客服場景:回答 Agent 判斷是否需建立工單 → 如果需要,丟給 Executor Agent 調用工單系統
API
這種拆分的好處是:每個 Agent 的 System Prompt 可以很精準,調整也比較容易觀察哪一段出問題。
💡 關鍵: 多 Agent 拆分角色,讓「查資料、思考、執行」三件事各自優化,比單一聊天機器人穩定得多。
適合誰用:三個典型場景
1. 團隊知識庫問答:工程文檔 / 產品手冊 / SOP
適合情境:
- 軟體團隊:想讓新人直接問「部署步驟」「API 使用範例」
- 硬體 / SaaS 產品:希望售前售後都能秒查產品規格、授權規則
可實際做的:
- 建立一個「Internal KB」
- 匯入:
- Git repo
README、Wiki 轉成 PDF - 內部 SOP、操作手冊、Onboarding 文件
- 建立一個 QA Agent:只允許根據知識庫回答,不會自己瞎編超出範圍的內容
2. 客服與支援 Bot:先查知識庫,再動手開工單
適合情境:
- 官網線上客服、App 內支援中心
- B2B 工單系統前台
可以設計的流程示例:
- User 問:帳號、付費、故障
- RAG Agent:
- 先查 FAQ / 幫助中心 / 條款文件
- 回覆解法
- 評估是否要升級:
- 若使用者多次追問或提到「不能用」「錯誤碼」,交給 Executor Agent
- Executor Agent 呼叫工單
API,建立Ticket,回傳工單編號
這樣你得到的不是一個「只能回 FAQ 的機器人」,而是能接著做事情的支援助理。
3. 數據 / 報告助理:多來源文件 → 週報 / 簡報框架
適合情境:
- PM、營運:每週要整理多份報表、數據截圖、訪談記錄
- 顧問 / 分析師:客戶給你一堆 PDF 報告,要快速產出簡報大綱
可操作的工作流範例:
- 上傳:
Google Analytics/Amplitude匯出報表(CSV)- 各部門週報(PDF/
Docx) - 客戶訪談逐字稿
- Workflow 設計:
- 檢索 Agent:依照「本週」「產品 A」「轉換率」等關鍵詞找資料
- 摘要 Agent:對各來源做重點整理
- 報告 Agent:產出「本週成效總結 + KPI 變化原因 + 下週建議行動」框架
你可以在此基礎上,讓 Executor Agent 直接生成 Markdown / PPT 大綱,甚至丟到自家文檔系統。
怎麼開始:從部署到接入自家系統
1. 用 Docker 一鍵部署 RAGFlow
先準備一台機器(本機或雲端均可):
- 建議配置:
- CPU 4 核以上
- RAM 8GB 以上
- 有 GPU 更好(但非必須)
以 Docker Compose 為例(以官方 README 為準):
# 取得專案
git clone https://github.com/infiniflow/ragflow.git
cd ragflow

# 啟動(實際指令以官方文件為準)
docker compose up -d
啟動後:
- 打開瀏覽器訪問類似
http://localhost:port的管理介面(依官方說明) - 建立管理帳號
官方專案與更新請看:https://github.com/infiniflow/ragflow
2. 接一個免費 / 便宜 LLM
RAGFlow 可以接:
- 本地部署開源模型(透過
Ollama/vLLM等) - 或雲端 API(OpenAI、阿里通義、字節、百度等)
如果你想先用開源模型:
- 選擇方向示例:
Qwen系列(中文友好)Gemma/Gemma 2(Google 開源,英文較強)Nemotron/Nemotron Lightning(適合雲端部署,高效推論)
實作步驟:
- 在 RAGFlow 的 LLM 設定頁,新增模型提供者
- 如果用雲端 API:填入
API Key、模型名稱(如qwen-turbo) - 如果接本地:填寫本地推論服務的
URL(例如你用vLLM啟的endpoint)
測試方式:在介面裡直接試打一段文字,看能否正常回應。
3. 走一個 End-to-End 範例:PDF → Agent Workflow
假設你要做一個「公司內部 SOP 助理」。
- 建立知識庫
- 在後台新增
Knowledge Base:company-sop - 上傳:人資流程 SOP、報銷流程、IT 報修流程(PDF/Word)
-
設定:
chunk大小 500–800 字- 選一個中文向量模型(如
bge-large-zh類) - 建立索引
-
建立簡單 Agent 工作流
- 建立一個
Workflow:sop-assistant - 節點配置:
- 節點 1:
User Input - 節點 2:
Retrieval Agent - 指定使用
company-sop知識庫 - 節點 3:
Answer Agent - System Prompt 例:
> 你是公司內部 SOP 助理,只能根據提供的 SOP 文件回答。若文件中沒有相關內容,請明確說「文件中沒有這部分說明」並建議聯絡負責部門。
- 節點 1:
-
連線:
User Input→Retrieval Agent→Answer Agent→ 輸出 -
測試互動
- 在 Workflow 測試頁輸入:
- 「新人報到第一天要做哪些流程?」
- 「海外差旅報銷要準備什麼文件?」
- 檢查:Answer Agent 回覆中是否有明確指出 SOP 條款、步驟,必要時微調
chunk/Top-K。
4. 用 REST API 接入自家網站 / 工具
完成 Workflow 之後,你可以透過 HTTP 對它發問,嵌入到產品裡。
典型 API 互動(偽例,請依官方文件實際調整路徑):
POST http://your-ragflow-host/api/workflows/sop-assistant/run
Content-Type: application/json

{
  "input": {
    "query": "我要怎麼申請筆電維修?"
  }
}
後端會回一個 JSON,其中包含:
- 模型回答內容
- 可能還有使用到的文件片段(方便你在前端顯示「引用來源」)
實際接入建議:
- 官網 / 內部系統前端:做一個 Chat UI,後端把使用者輸入轉發到 RAGFlow API
- 內部 Bot(如 Slack、Teams):寫個小 Bot,把訊息丟給 Workflow API,再把回答貼回頻道
補充:RAGFlow、向量庫與模型框架的關係
要把整套系統看清楚,可以把角色分成三層:
| 名稱 | 核心功能 | 免費方案 | 適合誰 |
|---|---|---|---|
| RAGFlow (https://github.com/infiniflow/ragflow) | RAG + 多 Agent 工作流、資料接入、檢索與 LLM 編排 | 開源自架 | 想做完整 RAG 應用、需要工作流與 API 的團隊 |
向量資料庫(如 Milvus、Postgres + pgvector) |
儲存與檢索向量,支援語義搜尋 | 多數有開源版 | 有大量文檔 / 多模態資料,要穩定、高效向量檢索的團隊 |
| Transformers (https://github.com/huggingface/transformers) | 提供各類 LLM / embedding 模型與推論框架 | 開源 | 需要自行訓練 / 微調模型、客製化 NLP 任務的工程師 |
可以簡單理解為:
Transformers負責「模型」- 向量庫負責「記憶」
- RAGFlow 把兩者接在一起,幫你做「會查資料又會動手的 AI 助理」
想快速上手 RAGFlow,最實用的路徑就是:一台機器 + Docker、一個便宜或免費的 LLM API、一疊 PDF,先做出一個真的能回答問題的內部助理,再慢慢加上更多 Agent 和外部 API,讓它從「會回答」進化到「會幫你做事」。
🚀 你現在可以做的事
- 到 GitHub 下載 RAGFlow 專案並用
docker compose up -d在測試機器上啟動- 準備一疊內部 SOP / 產品手冊 PDF,上傳到新建的
Knowledge Base做第一版助理- 在 RAGFlow 裡配置一個簡單 Workflow,然後用自家網站或 Slack Bot 透過 REST API 接入試跑