分類: AI 工具

  • 把技術書變成 Claude 助教

    把技術書變成 Claude 助教

    📌 本文重點

    • book-to-skill 把技術 PDF 變成 Claude 專屬助教
    • 透過向量搜尋,讓 Claude 有「依據地翻書」
    • 最適合工程師、考證照與公司內規查詢
    • 先選一本常用技術書技能化,再擴展到更多書

    一句話先講白:book-to-skill 能把一本厚厚的技術 PDF,變成你在 Claude 裡隨叫隨到的專屬助教,查手冊、問觀念、看範例都靠它。

    專案連結:https://github.com/virgiliojr94/book-to-skill


    核心功能:怎麼把「書」變成「技能」?

    book-to-skill 目標很單純:讓 Claude 能像熟讀那本書的助教一樣,回答你問題。背後大致分三步:

    💡 關鍵: book-to-skill 的核心價值是讓 Claude「有書可依」,回答都能對應到原書具體章節,而不是憑空生成


    1. 從 PDF 抽取結構化內容

    行動重點:先準備「可選字」的 PDF(不是純掃描圖片)。

    book-to-skill 會做的事:

    • 解析目錄、章節標題,切成「小段知識塊」(chunks)
    • 保留章節層級(例如:第 3 章 / 3.2 / 3.2.1),讓 Claude 知道上下文
    • 盡量區分:
    • 正文說明
    • 程式碼區塊
    • 小節標註(例如「Tip」「Warning」)

    這一步的效果:你問一個問題時,Claude 能直接定位該書第幾章、第幾節的內容來回答,而不是憑空亂講。


    2. 建立向量資料庫,讓 Claude 精準「翻書」

    行動重點:在執行流程前,要有一組向量資料庫(一般內建用本地或雲端向量引擎)。

    在 book-to-skill 裡,它會:

    • 把每個「知識塊」丟給嵌入模型(embedding)轉成向量
    • 存進向量資料庫
    • 之後你問問題時,用語義搜尋找出最相關的幾段內容

    簡單理解:你問問題 → 書中相關段落被找出 → Claude 再根據這些段落回答。這樣 Claude 的回答就「有根據」,不再只是通用知識。


    3. 生成 Claude 專用 skill:問答 / 解說 / 摘要

    book-to-skill 的最後一步,是幫你產生一個可在 Claude 中使用的「技能」(skill),裡面已經寫好:

    • 這個 skill 的用途:
    • 針對書內內容回答問題
    • 幫你做重點整理
    • 把書裡的概念轉成實作範例
    • 如何引用書中內容:
    • 優先用向量資料庫找到的段落
    • 如果找不到,就誠實說「這本書沒提」,不要亂掰
    • 回答格式:
    • 可以附上「出自第幾章、第幾節」
    • 可以整理成步驟、表格或程式碼範例

    行動重點:

    • 你完成轉換後,會得到一個可以在 Claude Code / Skills 面板中載入的 skill
    • 之後在任何對話裡打開這個 skill,就像多了一位「專門只看過這本書」的助教

    💡 關鍵: skill 的規則會強制 Claude「找不到就說沒提」,大幅降低亂掰與幻覺風險


    適合誰用:三種典型場景

    book-to-skill 最實用的地方是,把「一本大家都該看的技術書」,變成「團隊共享的 AI 助教」。以下三個最常見的用法:


    1. 工程師寫程式時查框架手冊

    場景:

    • 例如 Spring Boot 官方指南、Django 文件、Kubernetes 手冊
    • 你在寫程式,突然忘了某個 annotation 或 config 怎麼寫

    用法:

    • 把官方 PDF 或整理好的手冊丟進 book-to-skill
    • 在 Claude 裡問:
      -「依照這本書,@Transactional 在這種情境要注意什麼?」
      -「照書上的做法改寫下面這段程式碼。」

    效果:比直接問 Claude 靠譜,因為它會基於那本書的版本說明,不會混入網路上別的框架版本的寫法。


    2. 考證照:題目解析 + 重點複習

    場景:

    • AWS / GCP / Cisco / 資安證照
    • 有一本官方考試指南 PDF

    用法:

    • 先把官方指南變成 skill
    • 丟一題題目進 Claude,指示:
      -「用這本書的內容解析這題,並指出相關章節。」
      -「請依照書的架構,整理出本章考點清單。」

    效果:

    • 不只是出答案,而是帶你回到書裡的原文解釋
    • 讀題 → 回書本 → 再回題目,形成一個穩定的複習 loop

    3. 團隊共用標準文件:把 PDF 內規變成「制度客服」

    場景:

    • 公司有一本厚厚的「開發標準」「資安政策」「客服流程手冊」 PDF
    • 新人加入時,最常問:「這個情境要照哪條規範?」

    用法:

    • 把這份內規 PDF 轉成 skill
    • 在 Claude 裡問:
      -「依照公司內規,如果客戶資料要保留超過 1 年,需要哪些批准?」
      -「這段 SOP 是否符合本書的流程條件?」

    效果:

    • 變成一個24 小時不會累的規範客服
    • 即使文件沒人想翻,也能透過 Claude 查到正確條目

    💡 關鍵: 把「沒人願意翻的大部頭 PDF」轉成可問答的制度客服,是提升新手上手速度的低成本方法


    怎麼開始:一步一步把第一本書「技能化」

    這裡以最常見的情境:在本機跑 book-to-skill,然後在 Claude 中使用。流程大致三步:


    步驟 a:準備一份技術 PDF

    行動清單:

    1. 選一本你真的會常查的書,例如:
    2. 框架官方手冊
    3. 證照官方考試指南
    4. 公司內部規範 PDF
    5. 儘量選:
    6. 可選取文字的 PDF(非掃描圖片)
    7. 章節結構清晰,有目錄

    常見坑:

    • 純掃描 PDF:book-to-skill 需要 OCR 才能讀;如果原專案沒有整合 OCR,你要先用別的工具(如 OCR 軟體)轉成可選字的 PDF 再丟進來。
    • PDF 內嵌字型怪:解析時可能出現亂碼,建議先開啟確認文字是否正常。

    步驟 b:在本機或雲端部署 book-to-skill

    行動清單(以本機為例):

    1. 安裝必備環境:
    2. Python 3.x
    3. pip / uv / conda 任選一種套件管理
    4. Clone 專案:
    git clone https://github.com/virgiliojr94/book-to-skill.git
    cd book-to-skill
    
    1. 安裝依賴:
    pip install -r requirements.txt
    # 或依照 repo 說明使用對應工具
    
    1. 設定 API Key:

    2. 到 Anthropic 建立 API key

    3. 新增 .env(或依 repo 說明)填入:
    ANTHROPIC_API_KEY=你的_API_key
    

    常見坑:

    • 忘記設定地區 / 帳號權限,導致模型呼叫被拒
    • API key 放進 git repo:請務必把 .env 加入 .gitignore

    步驟 c:跑完一次轉換流程

    大致流程(名稱依實際 repo 為準):

    1. 執行轉換命令:
    python book_to_skill.py \
      --pdf path/to/your_book.pdf \
      --output ./skills/your_book_skill
    
    1. 轉換過程會:
    2. 解析 PDF → 切成章節 chunks
    3. 建立向量資料庫
    4. 生成對應的 Claude skill 定義檔(通常是 JSON / YAML)

    5. 完成後,你會得到:

    6. 一個可在 Claude 中註冊的 skill 定義
    7. 相關的向量資料檔案

    程式碼與公式處理注意:

    • 程式碼區塊:
    • 有些 PDF 把 code 斷在奇怪地方;轉換後可以抽查幾段,看縮排是否錯誤
    • 公式:
    • 以純文字形式存進向量庫,適合解釋概念,但不適合做精確 LaTeX 排版

    步驟 d:在 Claude 中載入並實際操作

    以「Claude Code + Skills」為例,操作大致如下(依當前產品 UI 為準):

    1. 打開 Claude Code → 找到 Skills / Plugins 管理頁面
    2. 選擇「匯入技能 / 自訂 skill」
    3. 指定 book-to-skill 生成的 skill 定義檔
    4. 啟用後,你可以:
    5. 在任何對話中切換到這個 skill
    6. 用自然語言指示:
      -「接下來所有解釋,都請只根據這本書。」
      -「請用書中的說明,幫我把這段程式碼改成推薦寫法。」

    常見使用習慣建議:


    book-to-skill 與一般 Claude 插件的差異

    如果你已經在看 Claude 插件市場,可能會有這個疑惑:「這算 plugin?skill?connector?」

    根據 Towards AI 的實測文章(The Only 11 Claude Plugins You Need in 2026),生態圈的命名確實有點亂。

    用一張表整理 book-to-skill 在這個世界觀裡的位置:

    名稱 核心功能 免費方案 適合誰
    book-to-skill 把 PDF 技術書轉成 Claude skill + 向量搜尋 開源,自架需 API 想把特定技術書變成助教的工程師 / 團隊
    一般 Claude 插件(plugin) 擴充 Claude 能力,如連結 Git、DB、工具 多數有免費層級 想接外部服務、做自動化工作流的使用者
    CLAUDE.md(設定檔) 定義專案規則、上下文、風格 內建免費 希望 Claude 像熟悉專案的隊友的開發者

    你可以這樣理解:

    • plugin / connector:讓 Claude 接到更多外部系統
    • book-to-skill:讓 Claude 多一個「專門熟讀某本書」的大腦
    • CLAUDE.md:告訴這個大腦「你在這個專案裡要怎麼說話、怎麼做事」

    收尾:先把「一本你最常翻的書」技能化

    最後給一個最簡單的行動建議:

    1. 選 一本你這一年一定會反覆查的技術書(而不是你覺得「應該讀」但其實不會打開的那種)。
    2. 用上面的步驟跑完一次 book-to-skill 流程。
    3. 在接下來一週寫程式或讀書時,逼自己所有相關問題先問 Claude 助教,看它給不給力;遇到錯誤答案,順手標記對應章節修正 prompt。

    等你把第一本書「技能化」成功,第二本、第三本就只是在重複同一套流程。真正的差別是:

    你不再只是「收藏 PDF」,而是把它們變成每天會主動被你用到的活教材。


    🚀 你現在可以做的事

    • 先在 GitHub 打開 book-to-skill 專案,確認環境需求與使用說明
    • 從你的電腦挑出一份「這一年一定會常查」的技術 PDF,檢查是否可選字且章節清晰
    • 在本機依照文中步驟跑完一次轉換,並在 Claude 中匯入 skill,開始用這本「技能化」的書來解決實際問題
  • Kimi K3 開源巨模型這樣玩

    Kimi K3 開源巨模型這樣玩

    📌 本文重點

    • Kimi K3:接近 GPT/Claude 的開源巨型模型
    • 專長程式碼與 Agent 任務,易於接商業系統
    • 可用雲端 API 或本地部署,自由度與控制高
    • 適合工程師、Agent 架構師與重度玩家實驗

    Kimi K3 解決的問題很單純:給你一個接近 GPT/Claude 水準、擅長程式與 Agent 任務的大模型,而且開源、可自己選擇在雲端或本機跑。

    相關連結:
    – Kimi K3 HuggingFace 模型頁:https://huggingface.co/moonshotai/Kimi-K3
    – Telnyx Inference K3 公告:https://telnyx.com/release-notes/kimi-k3-telnyx-inference
    – Unsloth K3 GGUF:https://huggingface.co/unsloth/Kimi-K3-GGUF


    什麼是 Kimi K3?跟 GPT / Claude 有什麼不一樣?

    用一句話概括:Kimi K3 是 Moonshot AI 開源的 2.8 兆參數巨型語言模型,對程式碼與 Agent 控制任務特別友好,目前表現被評為「僅次於 Claude Fable 5 和 GPT 5.6 Sol」等頂級閉源模型(來源:HN 社群與官方基準測試)。

    💡 關鍵: 2.8 兆參數的大模型搭配開源授權,讓你在接近 GPT/Claude 能力的同時,保有高度部署與成本控制自由度。

    跟 GPT / Claude 比較時,你可以這樣理解:

    • 能力層級接近:在長上下文、程式碼生成、多輪推理上,已經可以拿來對標主流商業模型。
    • 部署選擇更多:你可以用 Telnyx 的雲端推論 API,也可以下載權重自己跑(甚至用 GGUF + 本地推理框架)。
    • 成本與控制權:不綁死單一雲廠商,企業可以放在自家基礎設施,用自訂安全與合規策略。

    若你已經習慣用 OpenAI API,K3 的好處是:幾乎不用改程式碼,就能多一個「接近 GPT 等級、但開源」的備用模型。


    核心功能:這三件事值得你花時間試

    1. 程式碼生成與重構:偏工程、偏實作

    Moonshot 自己把 K3 定位在「程式與 Agent 任務」上,實際上,你可以這樣用:

    • 產生完整模組:給需求(功能 + 輸入 / 輸出),讓 K3 生成一個 Node.js/Go/Python 模組,再自行接測試。
    • 讀懂舊專案:把關鍵檔案貼進去,請 K3 建立架構圖、流程說明,或寫 README 草稿。
    • 重構與風格統一:讓它把多個檔案改成同一風格(命名規則、錯誤處理方式)。

    可立即行動:

    • 在 Telnyx 建一個 K3 endpoint,實測「給一份 200 行以上程式檔,請它加 log + 補型別註解」。
    • 用現有 GPT prompt 直接丟給 K3,看產出品質差異。

    2. 工具 / Agent 控制能力:讓它當「任務調度員」

    K3 被設計來擅長 Agent 類任務,包含:

    • 呼叫外部工具:根據自然語言指令自動選擇要呼叫的 API(例如:查資料 / 寫檔 / Call 內部服務)。
    • 多步驟工作流程:把「需求拆分 → 呼叫多支工具 → 彙整結果」變成自動化流程。

    實作方式很簡單:

    • 用現成 Agent 框架,如:
    • openwork
    • Task Monki
    • 把它們原本的 OpenAI / Anthropic provider,換成 Telnyx 的 K3 endpoint(通常只改 API base URL + model 名稱)。

    你可以做的具體場景:

    • 內部 Copilot:
    • Agent 負責:根據 ticket 自動查 DB、抓 log、產生初版修補建議。
    • 人類工程師:只做審核 & 修改。
    • 定時自動化工作:
    • 用 K3 + Agent 每天抓報表、生成 Slack 摘要。

    3. 長上下文 + 多地區推論:大專案與企業環境好用

    K3 的模型巨大(2.8 兆參數),這讓它在處理長文件、複雜專案時比較穩定。

    Telnyx 的優勢是:

    • 自有 GPU 基礎設施,在美 / 歐 / APAC / MENA 部署,減少延遲。
    • 零資料保留:回應送出後不存 prompt / completion,對隱私要求高的團隊友善。

    立即可做的事:

    • 把一份 100+ 頁的規格文件(或公司內部 SOP PDF)丟給 K3,測試:
    • 能否回答細節問題?
    • 能否根據規格寫出一份 API 設計草稿?

    適合誰用?三種典型使用者

    1. 後端工程師:把 K3 當成「外部推論服務」

    場景:你已經有 Node / Python 後端,希望:

    • 增加「用自然語言操作系統功能」的能力。
    • 做內部 Copilot / Chatbot,而不想完全依賴單一閉源模型。

    可做的事:

    • 在 Telnyx 註冊帳號、建立 API Key。
    • 用 OpenAI compatible 接口,把原本的 api.openai.com 換成 Telnyx endpoint。

    2. Agent / 自動化開發者:整合 openwork / Task Monki

    場景:你正在做多工具 Agent,或內部自動化流程。

    可做的事:

    • 在 Agent 專案的「模型 provider 設定」裡,加一個 kimi-k3 選項。
    • 給 K3 一個「工具列表 + JSON schema」,觀察它在多步驟任務中的表現。

    3. 重度玩家與本地部署愛好者

    場景:你有強力伺服器 / 迷你機櫃,想自己掌控推論環境。

    可以善用:

    • Unsloth 提供的 K3 GGUF:
    • MXFP4 版本約 1.5 TB,適合多 GPU / 伺服器集群。
    • 可搭配 LLaMA.cpp、vLLM 或其他支援 GGUF 的推論框架。
    • Reddit 上已有人用 80× RTX 5090 + 25GbE 跑 K3,用來驗證分散式推論架構。

    具體行動:

    • 先用 Telnyx API 測試 prompt 設計。
    • 確認效果滿意後,再評估是不是值得投資本地硬體。

    怎麼開始:最小可行程式碼

    1. 用 curl 測試:確認 API 正常

    假設 Telnyx 提供 OpenAI 兼容 API(實際 endpoint 以官方文件為準),你可以這樣打:

    curl https://api.telnyx.com/v1/chat/completions \
      -H "Authorization: Bearer YOUR_TELNYX_API_KEY" \
      -H "Content-Type: application/json" \
      -d '{
        "model": "kimi-k3",
        "messages": [
          {"role": "system", "content": "You are a helpful coding assistant."},
          {"role": "user", "content": "用 Node.js 寫一個回傳 Hello Kimi K3 的 API server"}
        ]
      }'
    

    看到 JSON 回應就表示:

    • API Key 正常
    • 模型名稱設定正確

    接下來就能接進你的後端程式。

    2. Node.js 範例:在 Express 後端接 K3

    // 安裝:npm install openai axios
    import OpenAI from "openai";
    
    const client = new OpenAI({
      apiKey: process.env.TELNYX_API_KEY,
      baseURL: "https://api.telnyx.com/v1" // 以官方文件為準
    });
    
    async function askK3(prompt) {
      const completion = await client.chat.completions.create({
        model: "kimi-k3",
        messages: [
          { role: "system", content: "You are a senior backend engineer." },
          { role: "user", content: prompt }
        ]
      });
      return completion.choices[0].message.content;
    }
    
    // Express handler
    import express from "express";
    const app = express();
    app.use(express.json());
    
    app.post("/k3", async (req, res) => {
      try {
        const answer = await askK3(req.body.prompt);
        res.json({ answer });
      } catch (e) {
        console.error(e);
        res.status(500).json({ error: "K3 request failed" });
      }
    });
    
    app.listen(3000, () => console.log("Server running on http://localhost:3000"));
    

    立即可做的事:

    • 把 prompt 改成你的業務場景,例如「根據這個 JSON 產生 SQL 查詢」。
    • 加上簡單的 rate limit(例如用 express-rate-limit),避免過度消耗。

    3. Python 範例:快速做一個 CLI 助手

    # 安裝:pip install openai
    import os
    from openai import OpenAI
    
    client = OpenAI(
        api_key=os.environ.get("TELNYX_API_KEY"),
        base_url="https://api.telnyx.com/v1"  # 以官方文件為準
    )
    
    def ask_k3(prompt: str) -> str:
        resp = client.chat.completions.create(
            model="kimi-k3",
            messages=[
                {"role": "system", "content": "You are a helpful coding assistant."},
                {"role": "user", "content": prompt},
            ],
        )
        return resp.choices[0].message.content
    
    if __name__ == "__main__":
        while True:
            q = input("Question> ")
            if not q:
                break
            ans = ask_k3(q)
            print("\nK3:\n", ans, "\n")
    

    硬體與費用:API 用戶 vs 重度玩家

    一般使用者:建議走 Telnyx 等推論 API

    原因很直接:

    • 模型太大:2.8 兆參數,連 GGUF 壓縮版都動輒 TB 級。
    • 基礎設施複雜:多 GPU、網路拓撲、負載均衡都要自己維護。

    💡 關鍵: 對大多數團隊來說,先用雲端推論服務評估延遲與成本,再決定是否投資自架硬體,是風險最低的路線。

    實際做法:

    • 先用 Telnyx 的免費額度或最低計價方案測試。
    • 實際量測:每個請求平均延遲與成本,決定是否放進正式產品。

    重度玩家:考慮 GGUF + 自架集群

    若你符合以下條件:

    • 有多張高階 GPU(至少數十張 RTX 4090/5090 或同級別伺服器卡)。
    • 熟悉分散式訓練 / 推論、InfiniBand / 高速乙太網架構。

    可以這樣走:

    • 從 Unsloth 的 Kimi K3 GGUF 下載合適量化版本(例如 MXFP4)。
    • 搭配 LLaMA.cpp、vLLM 等框架測試吞吐量與延遲。
    • 先跑內部 PoC,把 prompt、系統設計穩定後再考慮大規模部署。

    小結:先把 K3 當「第二個 GPT 入口」來用

    如果你現在已經在用 GPT/Claude:

    • 第一步:把現有程式加一個 kimi-k3 選項,實際比較輸出品質。
    • 第二步:選一個流程(例如程式碼重構或自動產出內部報表)交給 K3 + Agent 試跑。
    • 第三步:根據成本與延遲,決定要不要深度綁定,或甚至規劃本地/自架方案。

    Kimi K3 的價值不在「多一個模型」,而是:讓你在接近 GPT/Claude 能力的級別上,第一次有了真正開源、可自由部署的選擇。

    🚀 你現在可以做的事

    • 到 Telnyx 註冊帳號並建立 kimi-k3 endpoint,用你的既有 GPT prompt 實測輸出品質與延遲
    • 在現有後端或 Agent 專案中,新增一個 kimi-k3 provider,實驗程式碼重構或內部 Copilot 場景
    • 前往 HuggingFace 下載 K3 模型或 Unsloth GGUF 版本,評估未來在自家硬體上部署的可行性
  • 用 HeyZoku 指揮程式碼 Agent 的最簡上手法

    用 HeyZoku 指揮程式碼 Agent 的最簡上手法

    📌 本文重點

    • HeyZoku 以語音協調多個程式碼 Agent
    • 讓 AI 自動分工處理修 bug、重構、測試與文件
    • 適合個人開發者與團隊做多 Agent 開發實驗
    • 從連接 Git repo 與設定 Agent 即可開用

    用一句話說清楚:HeyZoku 是讓你用語音指令協調多個程式碼代理(coding agents),一起幫你完成修 bug、重構、寫測試、產生文件的工作台。

    相比用鍵盤一個一個丟指令給 ChatGPT、Cursor、LangChain,HeyZoku 主打的是「我只負責說清楚要做什麼,具體執行交給一群 AI 程式碼 Agent 分工」。

    官網/Product Hunt:https://www.producthunt.com/products/heyzoku


    核心功能:把你的語音變成多 Agent 的「作業清單」

    1. 語音介面:說話就能派工,而不是打字寫 Prompt

    HeyZoku 的核心是語音介面:你開口說,系統負責轉成結構化指令,再分派給不同程式碼 Agent。

    可以先從這幾種語音指令開始練習:

    • 任務型指令:
    • 「幫我檢查這個 PR 的潛在 bug,重點看錯誤處理。」
    • 「把 user-service.ts 裡的重複邏輯抽成共用函式。」
    • 範圍型指令:
    • 「只看 backend 資料夾,不要動 frontend。」
    • 限制型指令:
    • 「改動控制在 50 行以內,先給我 diff 再套用。」

    💡 關鍵: 透過語音明確描述任務與限制,HeyZoku 能自動轉成結構化多 Agent 作業清單,大幅減少手動寫 Prompt 的負擔。

    可以馬上做的事:

    1. 列一份自己常對 AI 說的開發請求,把它改寫成一句話就能說清楚的格式。
    2. 盡量包含:目標檔案/行為(修 bug、重構、寫測試…)/限制條件(行數、不要動哪裡)。

    2. 多個程式碼 Agent 協作:讓 AI 自動分工而不是一個模型包山包海

    HeyZoku 的設計是「一個工作台 + 多個角色分明的 coding agents」。典型設定會長這樣:

    • 分析 Agent:負責理解需求、拆解成具體子任務。
    • 實作 Agent:在程式碼庫裡進行實際修改、新增檔案。
    • 測試 Agent:補齊或更新單元測試、行為測試。
    • 文件 Agent:根據變更更新 README、API 文件、註解。

    當你下達語音指令時,HeyZoku 的工作台會:

    1. 把語音轉成文字並抽取「任務」、涉及檔案、限制。
    2. 交給分析 Agent 拆解成多個可執行的步驟。
    3. 由不同 Agent 順序執行,並把進度回報到同一個介面。

    可以馬上做的事:

    先替自己腦中「理想的 AI 開發小組」命名 3 個角色:

    • Agent A:只負責拆需求和寫 TODO。
    • Agent B:只負責動程式碼和開 PR。
    • Agent C:只負責寫測試和文件。

    到 HeyZoku 裡對應設定,避免「一個 Agent 什麼都做」導致上下文混亂。


    3. 支援的典型開發任務與環境整合

    HeyZoku 主打的是重複、結構明確的開發工作:

    • 修 bug:根據 log / issue / PR diff,幫你定位問題並產生修補程式碼。
    • 重構:整理長函式、去除重複邏輯、抽共用模組。
    • 寫測試:補齊缺失的單元測試、行為測試(例如 Gherkin 格式)。
    • 產生文件:同步更新 README、API docs、註解,避免程式碼改了文件沒跟上。

    典型整合環境包含:

    • Git repo(GitHub / GitLab 等,實際支援要以 HeyZoku 最新說明為準)。
    • 主流語言專案:JavaScript/TypeScript、Python 等常見 web/backend 專案結構。
    • 可能串接現有 Issue tracker 或 CI,把測試結果回報到同一工作台。

    可以馬上做的事:

    1. 選一個已存在的 Git 專案,而不是從零開始(AI agent 在既有結構裡表現更好)。
    2. 清點這個專案里最耗時的重複工作(例如每次改 API 都要改 3 個地方),列成 HeyZoku 要接手的任務清單。

    適合誰用:三種典型場景

    1. 個人開發者:把「重複體力活」外包給 AI 小組

    如果你是一人公司或自由接案者,通常會遇到:

    • 改一個小需求,要自己寫程式、寫測試、寫文件。
    • 常常在不同 repo、不同專案間切換。

    HeyZoku 的用法是:你用語音定義「什麼算完成」,讓多個 Agent 幫你跑完全部流程。

    例子:

    「新增一個 POST /users/{id}/deactivate API,要求:
    – 有基本驗證錯誤處理
    – 有單元測試覆蓋成功和失敗情境
    – 更新 API 文件與 README 的使用範例」

    可以馬上做的事:

    • 選出一個你最不想自己動手寫、但規則很清楚的小功能,交給 HeyZoku 測試整個「需求到測試與文件」的流程。

    2. 團隊:試驗「AI Pair Programming 小組」

    在團隊裡,HeyZoku 更適合作為實驗用工作台:

    • 一名人類開發者 + 一組 AI Agent 當「虛擬 Pair」,幫忙拆需求、做初版 commit。
    • Team lead 定義測試、品質規則,像 Uncle Bob 提到的那樣用約束而不是肉眼審每一行 AI code。

    可以借鏡這則 Hacker News 提到的思路:

    「我不再閱讀 agents 寫的程式碼,而是用單元測試、gherkin 測試、品質指標、變異測試等手段,確保它們產出的程式碼有足夠信心。」
    原文:https://news.ycombinator.com/item?id=49074693

    對 HeyZoku 來說,就是:

    • 團隊只審查測試與約束是否夠嚴。
    • AI Agent 在這些約束下自動跑修 bug、重構、文件更新。

    可以馬上做的事:

    1. 選一個「技術債清理」類的支線專案,讓 HeyZoku 的 Agent 專門負責重構與測試補齊。
    2. 團隊只在 PR 層面把關:測試是否完備、CI 是否全綠。

    3. 行動情境:走動中、會議中也能操作 AI 開發

    HeyZoku 的語音介面特別適合這幾種情境:

    • 走路通勤時:想到一個改動,就直接用手機說明任務。
    • 會議中:討論到某個需求,當場用語音下指令,讓 Agent 回頭補程式碼與測試草稿。

    例子:需求討論到一半,你說:

    「為現在的訂單系統新增一個『預約取消』功能,先給我:
    – 用例清單
    – 影響到的服務清單
    – 這一版不改 DB 結構,只改 service 層。」

    分析 Agent 會先幫你產出拆解與影響範圍,等你回到桌前再決定要不要進一步讓實作 Agent 開始寫程式。

    可以馬上做的事:

    • 想像自己在走路或開會時,最希望 AI 幫忙做的「前期準備」是什麼(用例整理、影響分析、TODO 列表),先在 HeyZoku 裡讓分析 Agent專門負責這一塊。

    怎麼開始:從註冊到第一次語音下指令

    Step 0:準備好要讓 Agent 動手的環境

    在開啟 HeyZoku 前,先準備:

    • 至少一個 Git repo(本機或雲端皆可,但要能被 HeyZoku 讀取)。
    • 清楚的專案結構(src/, tests/, docs/ 等最好有基本規範)。
    • 一份簡短專案說明(README 或架構圖),讓分析 Agent 有上下文可用。

    可以馬上做的事:

    • 為你的主力專案補一份「給 AI 看的 README」,寫清楚:主要模組、測試位置、常見指令(啟動、測試、lint)。

    Step 1:註冊並登入 HeyZoku

    1. 前往 Product Hunt 頁面:https://www.producthunt.com/products/heyzoku,找到官方連結進入 HeyZoku。
    2. 使用 GitHub 或 Email 進行註冊(實際支援方式以當前版本為準)。
    3. 登入後,尋找「Workspace」或「Project」入口,建立第一個工作區。

    可以馬上做的事:

    • 為第一個 Workspace 命名成你常用的專案名,例如 backend-orders-service,方便之後語音指令直接說專案名。

    Step 2:連接你的程式碼庫與設定 Agent 分工

    1. 在 HeyZoku 介面中,連接你的 Git repo(授權讀寫必要權限)。
    2. 建立 3–4 個核心 Agent:
    3. PlannerAgent:拆需求、寫 TODO。
    4. CoderAgent:寫實作程式碼。
    5. TestAgent:補測試、追求覆蓋率。
    6. DocAgent:更新文件與註解。
    7. 對每個 Agent 提供對應的說明與範圍(例如 TestAgent 只能動 tests/ 資料夾)。

    可以馬上做的事:

    • 在每個 Agent 的說明中寫明「不該動的區域」,例如:DocAgent 不得修改 production config。

    Step 3:設計適合語音的指令格式

    語音指令的關鍵在於結構清楚,建議用固定模板:

    「在【專案/資料夾】裡,對【檔案/功能】,做【動作類型】,限制是【條件】。」

    幾個範例:

    • 「在 backend-orders-service 裡,針對 OrderController,重構取消訂單的邏輯,限制是不要改資料庫 schema。」
    • 「在 user-service 專案,對 auth 模組新增登入失敗重試次數的設定,限制是要有對應單元測試與 README 更新。」

    可以馬上做的事:

    • 把這個模板貼在自己螢幕前,實際對著麥克風練習 3 種不同任務的語音說法,觀察 HeyZoku 的理解情況。

    Step 4:示範一個「小型自動化開發流水線」的 playbook

    我們來示範一條簡單流水線:

    角色配置:

    • Agent 1(需求拆解):PlannerAgent
    • Agent 2(寫程式):CoderAgent
    • Agent 3(測試與文件):TestDocAgent(合併角色)

    語音指令:

    「在 backend-orders-service 專案,新增『延遲出貨』功能:
    – PlannerAgent:先拆成具體子任務與影響模組列表
    – CoderAgent:實作出貨延遲的核心邏輯與 API
    – TestDocAgent:補上對應的單元測試與 README 使用範例
    限制是:不改既有資料庫表,只在 service 層實作。」

    預期流程:

    1. PlannerAgent 產出:子任務列表 + 影響範圍(哪些 service / controller / config)。
    2. 你確認列表沒有遺漏,再允許 CoderAgent 開始 commit。
    3. TestDocAgent 根據 diff 補測試與文件。
    4. HeyZoku 工作台顯示整個流水線的狀態,最後產出一個 PR 或變更集供你審查。

    可以馬上做的事:

    • 找一個「現有功能的小改版」來跑這條流水線,例如:新增一種訂單狀態、調整折扣計算方式,用來驗證 HeyZoku 是否能完整跑完分析→實作→測試→文件的鏈。

    跟其他多 Agent 工具的差異

    如果你已經聽過 LangChain、Composer 等多 Agent 工具,可以用下表快速對比定位:

    名稱 核心功能 免費方案 適合誰
    HeyZoku 語音指令協調多個程式碼 Agent 依官方方案,偏雲端服務 想用說話操作 AI 的開發者
    LangChain Python/JS 中組合 LLM + Tool + Agent 開源框架,免費使用 要自行搭建 Agent 系統的工程師
    Composer v3 多模型、多元件工作流程編排 社群工具,視專案而定 研究者與實驗多模型整合的人

    💡 關鍵: 若你不想寫多 Agent 框架程式碼,HeyZoku 提供即開即用的語音工作台,是從「想試試多 Agent 能做什麼」到「再用 LangChain/Composer 客製」之間的理想起點。

    可以馬上做的事:

    • 如果你不想自己寫 Agent 框架程式碼,只想快點看「多 Agent 實際能幫我做什麼」,先從 HeyZoku 開始;之後再視需要用 LangChain 或 Composer 做客製化延伸。

    🚀 你現在可以做的事

    • 前往 HeyZoku Product Hunt 頁面,註冊並建立第一個 backend-orders-service 工作區
    • 選一個既有 Git 專案,連接 Repo 並設定 PlannerAgent、CoderAgent、TestAgent、DocAgent 的職責與禁止修改區域
    • 實際用語音下達一個「小改版需求」,跑完分析→實作→測試→文件的完整流水線,觀察多 Agent 協作效果
  • Moonshot Kimi K3:免費玩前沿級大模型

    Moonshot Kimi K3:免費玩前沿級大模型

    📌 本文重點

    • Kimi K3 提供接近前沿模型的開源選項
    • 原生支援約 100 萬 tokens 超長上下文
    • 採 MoE 結構與 MXFP4 量化,部署成本可控
    • 資安與數學能力較弱,需搭配其他模型

    Kimi K3 解決的是一個很直接的問題:中小團隊想用接近 Fable 5 / GPT-5.6 Sol 水準的大模型,但不想被閉源 API 的價格與限制綁死。

    官方與基準介紹可參考 Moonshot 與媒體報導:The Verge 解讀中國開源策略(連結)、The Decoder 的 K3 權重釋出分析(連結)。


    核心功能:你真的能拿來做什麼

    1. 超長上下文:最高 100 萬 tokens

    Kimi K3 最實用的亮點,是原生支援最高約 1M tokens 的上下文,這代表:

    • 一次放進去整份法規、技術手冊、研究報告,讓模型直接「看完再回答」
    • 免拆章節、免自己做分段檢索(RAG),可以先用「暴力長上下文」快速原型

    💡 關鍵: 約 1M tokens 的上下文,讓你可以直接丟整份大型文件進模型處理,不必先做複雜的分段與檢索設計

    可以直接做的事:

    • 把公司內訓教材、API 文件打包成一個長 PDF,上傳到 K3 雲端推理,讓新人直接「問系統」而不是翻文件
    • 法務團隊把合約全集丟進模型,要求它找出一個特定條款在不同版本中的變化

    2. MoE 結構:896 個專家,16 個同時上場

    Kimi K3 是一個大型 Mixture of Experts(MoE)模型:

    • 約 2.8 兆參數、896 個 expert,每個 token 只啟用 16 個 expert
    • 好處:推理成本不像「全參數都算」那麼誇張,但表現接近前沿模型

    💡 關鍵: 以 2.8 兆參數、每個 token 僅啟用 16 個 expert 的 MoE 設計,在保留模型能力的同時,大幅降低推理成本

    對你而言的具體效果:

    • 做聊天助理、知識問答時,回應品質比一般開源中階模型要穩定
    • 成本與效能在「自己架」與「雲端推理」之間有彈性空間

    3. 視覺能力 + MXFP4 量化:為部署而生

    K3 內建:

    • 視覺能力:可以處理圖片(例如讀圖表、截圖說明、簡單 UI 規劃)
    • MXFP4 量化感知訓練:權重約 1.4 TB,原生就以低精度格式訓練,對推理效能更友善

    💡 關鍵: 原生 MXFP4 量化感知訓練與約 1.4 TB 權重,讓你在部署時不用額外量化,直接享受低精度帶來的效能優勢

    這對你意味著:

    • 如果你在做「文件 + 圖表」分析(財報、研究報告、技術圖解),可以用一套模型完成
    • 部署時不用自己再做一次量化,直接用官方 MXFP4 權重即可

    適合誰用:三種典型場景

    1. 中小團隊:自架聊天 / 知識助理,替代閉源 API

    痛點:用 GPT 類模型做內部知識庫或客服助理,API 成本難控、資料怕外流、客製受限。

    Kimi K3 能做的事:

    • 自架「公司版 ChatGPT」,所有資料在自己控制的環境裡
    • 把 FAQ、產品手冊、內部 SOP 都塞進去,做第一版知識助理原型

    具體行動:

    • 先用 Hugging Face 雲端推理試跑聊天助理雛型
    • 如果效果符合預期,再評估是否值得投入 GPU 成本做正式部署

    2. 長文檔處理:法務、研究、技術文件

    痛點:一般模型需要分段 + RAG,設定複雜,而且容易漏掉跨章節脈絡。

    Kimi K3 的優勢:

    • 用超長上下文直接塞進完整文件,不必先切小塊
    • 對「跨章節、跨文件」的比較與歸納特別方便

    具體行動:

    • 法務:將過去三年的合約樣本合併成一個長文件,讓 K3 找出常見風險條款
    • 研究:把十篇相關論文丟進同一 session,請模型整理不同方法的優劣與假設

    3. 做 AI 產品原型:蒸餾、微調的母模型

    痛點:想做垂直領域模型(醫療、金融、工業),但找不到足夠強的開源基底。

    Kimi K3 適合:

    • 當成「教師模型」,給你下游小模型做蒸餾
    • 作為微調基底,針對特定任務(寫程式、產出技術報告)強化

    具體行動:

    • 用雲端推理先定義「你希望學生模型學會的風格與能力」
    • 再用 K3 + 你的任務數據做一次指令微調,產出中型學生模型,方便在更便宜的硬體跑

    怎麼開始:免硬體門檻到最低部署指南

    路徑一:先用 Hugging Face / 雲端推理快速試

    如果你只是想評估 K3 適不適合你的場景,不要一開始就買 GPU,先用雲端:

    1. 到 Hugging Face 找模型卡
      搜尋「Kimi K3」或 Moonshot 官方模型卡(權重預計放在 HF,對應 Reddit 討論:連結)。

    2. 點進「Inference API」或社群提供的 web demo

    3. 用你的實際任務測試:

    4. 貼一段長文件(法規、說明書)
    5. 要它做摘要、條款比對、寫技術說明

    6. 記錄:

    7. 回答是否跟得上上下文
    8. 對專業領域的理解是否足夠

    評估重點:

    • 如果主要是長文理解、摘要與一般知識問答,K3 通常足夠
    • 若你要高風險場景(資安、程式驗證、精準數學),記下它的弱點,準備搭配其他模型

    路徑二:有 GPU 的讀者,最低門檻部署指南

    K3 的完整 MXFP4 權重大約 1.4 TB,單節點塞滿是高難度任務。社群實測從 A100 到 B300,結論大致如下:

    GPU 配置 記憶體總量(8 卡) 實際狀況 適合誰
    A100 80G 約 640 GB 明顯不足,需多節點 + 進階分片,延遲高,數學表現被壓縮 有現成 A100 集群、願意做工程優化的團隊
    H200 約 1.13 TB 仍略不足,需要多節點;推理可行但調度較複雜 已在用 H200 做大模型、有 infra 團隊
    B300 約 2.3 TB 理論上單節點可放完整模型,部署體驗最佳 願意為前沿模型砸錢的大型團隊

    以上配置分析來源:r/LocalLLaMA 部署討論(連結)。

    最低實用部署步驟(以有 H200 / B300 為例)

    1. 決定你要跑的場景

    2. 若只做測試與小流量聊天:多節點 H200 即可

    3. 若預計有穩定商業流量:優先考慮 B300 單節點,省通訊痛苦

    4. 準備軟體堆疊(雲端或本地)

    5. 安裝支援大模型的推理框架:如 vLLM、TensorRT-LLM 或自家客制方案

    6. 確定框架支援 MXFP4 / 低精度推理與 MoE 分片

    7. 下載權重並做分片配置

    8. 從 Hugging Face 拉取 K3 權重(約 1.4 TB,需有足夠存儲)

    9. 根據 GPU 數量與記憶體設定分片策略:每張卡 load 部分 expert

    10. 發布一個簡單的 API

    11. 預設路由:/chat、/completion、/file-qa

    12. 對內部前端(客服面板、知識庫 UI)只暴露 HTTP API,方便日後換模型

    成本與取捨提醒

    • A100 世代:沒有最新低精度 tensor core,跑 K3 會偏吃力,延遲與能耗都不優;如果只是測試,OK,但不建議長期商用。
    • H200:算力與頻寬更好,但仍需要多節點分散模型;工程複雜度較高。
    • B300:最接近「想跑就跑」的體驗,但硬體成本非常高,只適合已有前沿模型需求的公司。

    弱點與搭配策略:資安與數學要小心

    獨立測試與媒體報導提到,K3 在網路安全與數學能力上有明顯差距,很可能跟蒸餾過程有關(參考 The Decoder 報導:連結)。

    實際使用時,建議你這樣處理:

    1. 資安 / 攻擊向量相關任務

    2. 不要把「產生攻擊腳本、滲透測試細節」交給 K3

    3. 若你的產品涉及資安,只用 K3 做一般說明與文件整理,再用專門模型(或人工審核)處理技術細節

    4. 高精度數學與程式驗證

    5. 複雜數學推導、金融衍生品定價等,不要只信 K3 的第一個答案

    6. 可以採用「雙模型策略」:

      • K3 負責理解題目與長上下文(例如一整份投資報告)
      • 用擅長數學 / coding 的模型(如專門 code LLM)負責計算與程式檢查
    7. 內部評估流程

    8. 上線前,先設計一套測試題(你自己的真實問題),量測:

      • 資安敏感問題的回答是否合規
      • 數字題、程式題的錯誤率
    9. 把測試結果寫入內部使用指南,明確標記「K3 能做什麼/不能做什麼」。

    小結:你可以立刻採取的三個行動

    1. 先在 Hugging Face 上跑一次你的真實長文場景
      丟一份你現在用 GPT 處理的 PDF,看看 K3 的回答差異。

    2. 評估是否值得搭建內部知識助理
      若你每月在閉源 API 上花的錢已經不小,K3 是一個值得算帳的替代選項。

    3. 如果你有 GPU 集群,安排一個週末 PoC
      用最小配置把 K3 部署成內部 API,跑一輪你關鍵團隊(法務、客服、研發)的真實工作流程,再決定要不要進一步優化。

    Kimi K3 把「前沿級模型」帶進了開源與可控成本的範圍內,只要你清楚它的長處與短板,就能把它變成你團隊的工具,而不是風險。

    🚀 你現在可以做的事

    • 去 Hugging Face 搜尋「Kimi K3」,用 Inference API 跑一份你實際的長文件
    • 整理公司內部 FAQ、SOP 與技術文件,規劃一版「公司版 ChatGPT」原型需求
    • 盤點現有 GPU / 雲端資源,模擬在 H200 或 B300 上部署 K3 成內部 /chat API 的 PoC 計畫
  • Chat2DB:一句話查遍所有資料庫

    Chat2DB:一句話查遍所有資料庫

    📌 本文重點

    • Chat2DB 將多種資料庫集中成一個可用中文聊天操作的工作台
    • 透過自然語言即可生成、優化 SQL 並視覺化查詢結果
    • 適合工程師、分析師與產品/營運作跨庫查詢與報表自助

    一句話先講清楚:Chat2DB 就是把多種資料庫變成一個可以用自然語言聊天、查數據、改結構的單一工作台。

    你不用記一堆 SQL 語法,也不用在多個資料庫工具之間切換,只要開一個視窗,打中文問題,Chat2DB 就能幫你生成 SQL、跑查詢、畫圖、做常見管理操作。

    原始碼與下載點:https://github.com/OtterMind/Chat2DB


    核心功能:把「聊天」變成查資料庫的主入口

    1. 支援多種主流資料庫,一次連完集中管理

    Chat2DB 本質上是一個 GUI SQL 客戶端 + AI 助理,支援常見關聯式資料庫:

    • MySQL
    • PostgreSQL
    • Oracle
    • SQL Server
    • DB2
    • SQLite
    • H2
    • ClickHouse
    • 其他更多在持續增加中

    能做的事:

    • 在左側一次看到所有已連線的資料庫與資料表
    • 對每個連線分別設定權限、名稱(例如「線上庫」「測試庫」「報表庫」)
    • 在同一個介面切換不同資料庫資料表,省去打開多個工具的麻煩

    你可以立刻做的事:

    1. 把目前專案的 MySQL、公司的分析 PostgreSQL 一次都連到 Chat2DB
    2. 用同一個聊天框去問跨庫問題(例如:線上訂單在 MySQL,歷史訂單在 ClickHouse)

    💡 關鍵: 把所有資料庫連線集中在一個介面,可大幅減少在多種工具間切換的時間與錯誤風險。


    2. 用聊天生成、優化 SQL:從「問題」到「查詢」一步到位

    Chat2DB 的主角是右側的聊天視窗,你可以用自然語言描述需求,它會:

    1. 讀取你選擇的資料庫和資料表結構
    2. 生成對應的 SQL 查詢
    3. 執行並顯示結果(表格 / 圖表)

    實際效果示例:

    • 輸入:「請幫我查 2024 年 7 月每一天的新註冊用戶數,按日期排序。」
    • Chat2DB:生成 SELECT date(created_at) AS day, COUNT(*) ... 之類的 SQL,跑出每日註冊數
    • 輸入:「把剛才的查詢改成只看台灣地區。」
    • Chat2DB:根據上一個 SQL 增加 WHERE country = 'TW' 條件

    你可以立刻做的事:

    • 把常用報表(週活躍、訂單轉化)用中文描述給 Chat2DB,讓它幫你寫出第一版 SQL
    • 再用聊天微調,例如「改成最近 30 天」「把結果依訂單金額排序」

    3. 查詢結果視覺化 + 常見管理操作一站完成

    生成 SQL 之後,Chat2DB 不只給你純文字結果,而是:

    • 以表格顯示查詢結果,可排序、過濾、匯出
    • 支援視覺化:根據時間序列或分類欄位,快速切換折線圖、柱狀圖等
    • 內建常見管理操作:建表、改欄位、改索引、查看 schema

    具體能做的事:

    • 在聊天視窗輸入:「幫我把 users 表的 phone 欄位長度改成 32。」
    • Chat2DB 會生成 ALTER TABLE 語句,並提示你確認執行
    • 查出訂單數據後,按一下圖表按鈕,把「每日訂單量」畫成折線圖
    • 對結果表格直接匯出為 CSV,丟給同事或進 Excel 做後續加工

    你可以立刻做的事:

    • 把常用的結構變更(加欄位、改型別)交給 Chat2DB 先生成 SQL,再由你確認
    • 用圖表快速檢查趨勢,而不是只看裸 SQL 結果

    💡 關鍵: 將查詢、視覺化與結構管理整合在一站,能讓資料查詢流程從「寫 SQL → 抓數據 → 拉圖」縮短成單一路徑。


    適合誰用:工程師、分析師、產品/營運三種典型場景

    1. 工程師:快速試 query、跨多資料庫環境

    你手上可能同時有:

    • 線上 MySQL
    • 分析 PostgreSQL
    • 本地 SQLite

    過去要開 2-3 種不同工具,現在只要一個 Chat2DB。

    實際場景:

    • 在改 API 前,快速用聊天生成查詢,驗證資料狀態
    • 在調效能時,請 Chat2DB 「幫我優化這段 SQL,減少全表掃描」,讓它提供索引或重寫建議

    工程師可以立刻做的事:

    • 建一個「測試庫專用」連線,所有危險操作只在這裡試
    • 把複雜 SQL 貼進去,要求 Chat2DB 解釋這段 SQL 在做什麼,幫自己查 bug

    2. 資料分析師:不熟 SQL 也能拿到報表與圖表

    如果你了解指標邏輯,但不擅長寫 SQL,Chat2DB 很適合當作輔助腳本工具。

    實際場景:

    • 你只需要用中文描述:「我要看 7 月新客的首購金額分佈,按照金額區間統計」,由 Chat2DB 將需求翻成 SQL
    • 生成的結果直接用圖表查看分佈,確認是否有異常尖峰

    分析師可以立刻做的事:

    • 把常用的分析問題整理成一份「問題清單」,每天用 Chat2DB 跑一遍,作為簡易報表系統
    • 將生成的 SQL 保存,下次再用同一段 SQL + 微調日期條件

    3. 產品/營運:用簡單中文問題拉出關鍵數據

    產品經理或營運人員,通常沒有太多 SQL 經驗,但很常提出問題:

    實際場景:

    • 問:「最近 7 天新註冊的用戶中,有多少人完成首購?」
    • 問:「哪三個城市的退貨率最高?給我城市名稱、訂單數量、退貨比例。」

    Chat2DB 可以:

    • 從既有資料庫結構中推測相關表(users、orders、refunds)
    • 生成對應的 SQL 和結果

    產品/營運可以立刻做的事:

    • 請工程師幫你建立一個「只讀」帳號連到 Chat2DB
    • 自己在 Chat2DB 用自然語言問營運問題,不必每次都麻煩工程師拉數據

    💡 關鍵: 讓非工程背景的人可以直接對資料庫發問,能明顯縮短「提需求 → 等工程拉數 → 再確認」的反覆溝通時間。


    怎麼開始:從安裝到第一個自然語言查詢

    1. 下載與安裝:桌面版或 Docker 二選一

    (A)桌面版:最快上手路徑

    1. 前往 GitHub Releases:https://github.com/OtterMind/Chat2DB/releases
    2. 選擇對應作業系統的安裝檔(Windows / macOS / Linux)
    3. 安裝後啟動 Chat2DB,看到左側是連線管理,右側是聊天 / SQL 視窗

    (B)Docker 部署:適合團隊共享或伺服器環境

    1. 準備有 Docker 的伺服器
    2. 在 GitHub 尋找對應的 Docker 啟動指令(通常是 docker run 搭配映像檔)
    3. 部署完成後,用瀏覽器進入指定 URL,即可使用 Web 版 Chat2DB

    安裝細節可能隨版本更新,建議依照官方 README 最新說明操作:https://github.com/OtterMind/Chat2DB


    2. 連線 MySQL / PostgreSQL:示例設定

    以 MySQL 為例,在 Chat2DB 裡新增連線:

    • 類型:MySQL
    • Host:your-mysql-host
    • Port:一般為 3306
    • Database:要連的資料庫名稱(例如 prod_db 或 analytics_db)
    • 帳號/密碼:建議使用只讀帳號,限制寫入與刪除

    PostgreSQL 則類似:

    • 類型:PostgreSQL
    • Port:一般為 5432
    • 其他欄位照實填寫即可

    連線測試成功後,你會在左側看到資料表清單,可以點開查看欄位與結構。

    你可以立刻做的事:

    • 建兩個連線:一個連測試庫(可寫),一個連線上庫(只讀),確保自己不會在錯的環境做修改

    3. 開啟 AI 助理與實用 Prompt 範本

    Chat2DB 通常在介面上提供「AI 助理」或「Chat」入口,進入後就可以開始用自然語言互動。

    常用 Prompt 範本,你可以直接複製調整:

    1. 生成查詢
    2. 「在目前選擇的資料庫中,幫我查出最近 30 天每天的訂單數量與總金額,按日期排序。」
    3. 優化現有 SQL
    4. 「這段 SQL 執行很慢,請幫我分析原因並提出優化建議:YOUR_SQL_HERE」
    5. 解釋 SQL
    6. 「請用條列方式解釋下面這段 SQL 的作用,並指出可能有風險的地方:YOUR_SQL_HERE」
    7. 修改資料表結構
    8. 「幫我在 users 表新增一個 last_login_at 的欄位,型別用 datetime,預設值為 null,生成 ALTER TABLE 語句但不要直接執行。」

    你可以把這些 Prompt 存成自己的「操作模板」,每天重複使用。


    4. 在生產庫使用時的權限與風險控管

    Chat2DB 再好用,連到生產資料庫時一定要注意:

    • 使用只讀帳號:除非非常必要,不要給 Chat2DB 有刪除或更新權限
    • 分環境設定:清楚標註 prod、staging、dev,避免在錯誤環境執行修改
    • 先生成後確認再執行:尤其是 UPDATE / DELETE / ALTER TABLE 類型的語句
    • 限制可見資料庫:帳號只授權需要的 schema,減少誤操作範圍

    你可以立刻做的事:

    • 請 DBA 或工程師幫你建立一個專用只讀帳號,專門給 Chat2DB 使用
    • 約定團隊規則:所有結構變更 SQL 先由 AI 生成,再由工程師人工 review、手動執行

    結論很簡單:如果你每天都在查資料庫、寫 SQL、拉數據,Chat2DB 是一個能立刻提升效率的工具。把它當成「會寫 SQL 的聊天夥伴」,從今天開始,用一句句自然語言問題,換回更快的數據與報表。

    🚀 你現在可以做的事

    • 到 Chat2DB GitHub Releases 下載桌面版並連上你的第一個資料庫
    • 準備一份「常問數據問題清單」,在 Chat2DB 裡用中文逐條轉成查詢
    • 與團隊討論並設定一個專用只讀帳號與環境標註規則,安全地在生產庫使用 Chat2DB
  • 錄一遍就會做:Claude Cowork 桌面助理

    錄一遍就會做:Claude Cowork 桌面助理

    📌 本文重點

    • 用錄螢幕+講解,一次教會 Claude 重複操作
    • 特別適合固定流程的「點來點去」電腦工作
    • 不用寫程式或 Prompt,就能建立自己的任務技能庫

    Claude Cowork 就是一個「可以看你操作、聽你解說,學會重複執行電腦工作的桌面 AI 助理」,讓你用錄螢幕+講解的方式,把枯燥的例行電腦任務交給它做。

    工具連結:桌面版 Claude Cowork 功能介紹可參考 The Decoder 報導:https://the-decoder.com/claude-cowork-learns-new-skills-through-screen-recordings-and-voice-over-explanations/


    核心功能:把「你怎麼做」變成可重用任務

    1. 錄屏+旁白,一次教會一個 Task

    Claude Cowork 的新技能很直白:

    1. 開啟桌面版 Claude Cowork。
    2. 點選「Record」或類似的錄製按鈕。
    3. 開始操作你平常會做的工作(例如登入後台、下載報表、貼到 Notion)。
    4. 一邊做,一邊講解:「現在我先登入系統,選這個月份,按這個按鈕匯出……」。
    5. 完成後停止錄製,給這段錄製一個名稱,例如「下載月報表」。

    Claude 會把你剛才的螢幕操作+語音說明,轉成一個可重用的「技能」(skill 或 task)。

    之後你只需要在桌面 app 裡說:

    「幫我跑一次『下載月報表』,月份改成 2025/02。」

    它就會照你教過的流程,一步步在電腦上重演。

    💡 關鍵: 只要花一次時間示範,之後相同任務都能交給 Claude 自動重播流程。

    可以立刻行動: 想一個你每週都要重複操作 3 次以上的電腦任務,先用錄屏+講解方式讓 Claude 學會,只教一次就能重複用。


    2. 支援各種「點來點去」的流程型工作

    這種錄屏式教學,特別適合下面幾種操作:

    • 填表/重複輸入資料
      例:每週把 Google 表單回應匯出,再整理成 Excel、加上固定欄位後寄給主管。
    • 後台批次操作
      例:電商後台每月整理商品庫存,調整標籤、下架過期品、下載銷售報表。
    • 內容排程與發布
      例:社群貼文排程,登入多個平台,貼同一份文案,調整時間與標籤。
    • 檔案整理與備份
      例:
    • 把本週的截圖移到指定資料夾
    • 將客戶資料依專案分類
    • 定期把某資料夾壓縮備份到雲端硬碟

    你只要在錄屏時,把判斷規則說清楚:

    「每一筆資料,如果狀態是 Completed,就移到『已完成』資料夾;如果是 Pending,就保留。」

    Claude 會把這些口頭說明,轉成它在操作時的規則,後面就能自動照做。

    可以立刻行動: 打開你常用的後台/雲端硬碟,選一個「流程很固定」的任務,試著錄一段 3–5 分鐘的操作+口頭規則,完成後就可以重放測試。


    3. 不用寫 Prompt、不用寫 Script,也能做「半自動化」

    傳統要讓 AI 還有工具幫你做事,通常有兩條路:

    • 寫很長的文字 Prompt,詳細交代每一步該怎麼做。
    • 寫腳本(Python、AutoHotkey 等),用程式控制滑鼠鍵盤與 API。

    Claude Cowork 的做法,是把「寫文字」改成「錄一段你實際操作給它看」。

    差異可以用這樣來理解:

    做法 你要做的事 入門門檻 適合任務
    傳統 Prompt 打一大段指令,反覆試錯 需要抽象表達能力 內容生成、複雜推理
    寫 Script 用程式碼描述流程 需要寫程式 大量重複、需要精準控制的任務
    Claude 錄屏 像教新人一樣,邊做邊講給 AI 看 只要會操作電腦 流程固定的點擊操作、後台例行工作

    如果你曾經想自動化報表下載、檔案整理,但卡在「不會寫程式」、「不知道怎麼寫 Prompt」,這個錄屏教學的方式就是給這群人用的。

    💡 關鍵: 把本來需要程式或長指令的自動化門檻,降低到只要會用電腦、會邊做邊講就能上手。

    可以立刻行動: 選一個你一直想「寫腳本自動化」但遲遲沒動手的任務,改用錄屏+語音示範給 Claude,看它能不能跑出你要的效果。


    適合誰用?幾個具體場景

    1. 個人工作者:每月固定報表、帳務整理

    典型任務:

    • 每月從不同平台(Shopify、綠界、銀行網銀)下載營收報表。
    • 把下載的 CSV 合併、加上統一欄位、存成一份「月報」。

    用 Claude Cowork 的 workflow:

    1. 錄一次完整流程:從登入、過濾日期、下載檔案,到合併進 Excel 模板。
    2. 旁白說明:
    3. 「月份都用 yyyy-mm 格式命名。」
    4. 「把不同平台的報表貼到同一份『總報表』分頁。」
    5. 存成技能【產出月營收報表】。
    6. 之後每月只要打開桌面 app,說:「執行『產出月營收報表』,月份改成 2025-03。」

    2. 小團隊:社群內容排程與後台設定

    典型任務:

    • 每週固定在 Facebook、Instagram、LinkedIn 排程貼文。
    • 後台新增活動、設定折扣碼、調整權限。

    用 Claude Cowork 的 workflow:

    1. 錄屏示範一次完整排程流程:
    2. 開啟你的排程工具(如 Buffer、Meta Business Suite)。
    3. 貼上文案、上傳圖片、設定時間。
    4. 旁白說明:「標題用第一行文字,Hashtag 放在最後。」
    5. 存成技能【每週社群排程】。
    6. 之後每次準備好一週的文案時,只要:
    7. 將文案放在指定表格或文件。
    8. 啟動【每週社群排程】,讓 Claude 依照你錄過的流程貼上、排程。

    3. 內部行政:檔案整理、權限設定

    典型任務:

    • 每週整理專案資料夾,把舊檔案移到 Archive。
    • 為新同事設定系統權限、加進團隊、賦予角色。

    用 Claude Cowork 的 workflow:

    1. 錄一次整理流程:
    2. 打開雲端硬碟、依建立日期排序。
    3. 移動 3 個月前的檔案到 Archive 資料夾。
    4. 旁白說明「跳過名稱內含 重要 的檔案」。
    5. 存成技能【每週檔案整理】。
    6. 之後每週只要啟動這個技能,檔案就會依你教過的規則被整理好。

    可以立刻行動: 將你目前手上 3 個最耗時的「流程型任務」寫下來,對照上面範例,挑一個最簡單的先用 Claude 試一次。


    怎麼開始:從下載到建立自己的技能庫

    以下是一條「最快上手」路線,目標是在 30 分鐘內錄好你的第一個任務。


    步驟 1:下載桌面版 Claude Cowork

    1. 前往 Anthropic 官網或 Claude 官方下載頁(依目前提供的平台為主):
    2. 官網入口:https://claude.ai
    3. Cowork 相關功能可持續關注 The Decoder 這篇報導:https://the-decoder.com/claude-cowork-learns-new-skills-through-screen-recordings-and-voice-over-explanations/
    4. 下載適用於你系統的桌面版(Windows 或 macOS)。
    5. 登入你的 Anthropic / Claude 帳號。

    目前 Anthropic 對不同地區的開放程度可能不同,若尚未在你所在國家提供,建議先註冊帳號,關注官方公告或候補名單。

    免費方案 / 試用小提醒:

    • 一般會有免費層級或試用期,可先用來錄幾個常用技能。
    • 付費方案通常限制較少(例如更多錄製次數或更長工作流程),適合覺得好用之後再升級。

    步驟 2:錄你的第一個任務

    1. 打開桌面版 Claude Cowork,找到「Record screen」或類似功能。
    2. 想好一個 5 分鐘內可以完成的小任務,例如:
    3. 把 Downloads 資料夾裡的檔案整理到專案資料夾。
    4. 登入某個後台下載今日報表。
    5. 點擊開始錄製:
    6. 正常操作就好,不用刻意表演。
    7. 盡量邊做邊說:「這裡我會……」、「遇到錯誤就……」。
    8. 結束錄製後,給這個技能一個清楚名稱,如【下載今日報表】。

    可以立刻行動: 在錄第一段時,不要追求完美,目標是「成功產生一個可執行的技能」,之後再修版本。


    步驟 3:測試與修正

    1. 在 Claude Cowork 裡找到剛才建立的技能。
    2. 按下執行,觀察它是否:
    3. 點了正確的按鈕。
    4. 根據你旁白的規則做出對的判斷。
    5. 若有步驟失誤:
    6. 再錄一次,這次把規則說得更精準。
    7. 或在工具內補充說明(視官方介面是否支援文字補充)。

    重複「錄一次 → 測一次 → 修一次」的迴圈,你會逐漸抓到:「錄的時候,要講到什麼程度,Claude 才能完全理解」的手感。

    💡 關鍵: 透過反覆錄製與微調說明,可以快速優化技能準確度,而不需要動任何程式碼。


    步驟 4:建立自己的「技能庫」

    當你錄了 3–5 個穩定可用的任務後,可以開始整理:

    1. 把技能依用途分類,例如:
    2. 報表類:月報表下載、週報整理
    3. 檔案類:截圖整理、專案備份
    4. 社群類:貼文排程、素材上傳
    5. 對每個技能加上簡短備註:
    6. 需要提前準備的檔案/資料在哪裡。
    7. 執行前要先開啟哪些應用程式。
    8. 若你有小團隊:
    9. 可以把錄好的技能當成「標準作業流程(SOP)」分享給同事,大家就算不在同一地點,也能用同一套流程。

    可以立刻行動: 訂一個小目標——本週先錄 3 個技能,分別對應「報表、檔案、社群」三種任務,練習用 Claude 代替你處理一部分例行工作。


    小結:錄一次、重複用,先從最無聊的工作開始

    Claude Cowork 的這個錄屏+旁白功能,本質上就是:

    把你每天在電腦上重複做的事情,「教一次」,之後交給桌面 AI 助理解決。

    不需要學腳本、不需要想花俏 Prompt,只要像帶新人一樣邊做邊說,就能讓 Claude 變成你的「流程助手」。

    先從最無聊、最重複的那一個任務開始,你會直觀感受到差別。

    下一步,就是把這些任務慢慢累積成你的專屬「技能庫」,讓電腦上的例行公事越來越少,真正需要你判斷與創意的工作,比例越來越高。

    🚀 你現在可以做的事

    • 打開你常用的電腦工作流程,選一個 5 分鐘內可完成的任務實際錄製一次給 Claude
    • 列出 3 個每週重複發生的例行任務,規劃成待錄製的技能清單
    • 到 Claude 官方網站 或 The Decoder 文章頁了解 Cowork 最新功能與開放情況
  • BTL-3:8GB 就能跑的本地程式代理人

    BTL-3:8GB 就能跑的本地程式代理人

    📌 本文重點

    • BTL-3 是可本地部署的程式代理人模型
    • 8.39GB GGUF 保留約 92% 的 27B 能力
    • 特化在工具呼叫與完整程式工作流
    • 適合離線開發與本地 Agent 架構

    想要在自己電腦上擁有類似 GitHub Copilot / Claude Code 的程式代理人,又不想連雲端?BTL-3 是目前少數「真實可落地」的開源選擇。

    原帖與技術細節:[Reddit] BTL-3 27B agentic coding model


    核心功能:一顆小體積、但會「自己想和動手做」的模型

    1. Agentic 架構:不只是聊天,而是完整工作迴圈

    BTL-3 的訓練目標不是「回答問題」,而是模擬一個真正的程式代理人工作流:

    Reason → Act → Inspect → Recover → Continue

    你可以直接把它當成一個「會自己規劃與檢查的本地 Copilot」,實際用法像這樣:

    1. Reason(思考):給它一個 repo 跟目標,例如:把這個專案加上簡單的健康檢查 API。
    2. Act(行動):它會規劃要改哪些檔案、生成修改方案或腳本。
    3. Inspect(檢查):搭配工具(如 git diff、測試腳本)檢查結果。
    4. Recover(恢復):若測試失敗,會根據錯誤訊息繼續修正。

    行動建議:

    • 設計你的 prompt 時,直接描述「任務目標 + 可用工具 + 成功條件」,讓它接手後續流程,而不是只叫它「寫一段程式」。

    2. 工具呼叫:一次、連續、並行都能掌握

    BTL-3 內建工具使用能力,可做到:

    • 單次工具呼叫:例如呼叫 bash 跑測試、或呼叫 HTTP client 打內部 API。
    • 連續呼叫:先爬資料,再處理,再更新資料庫。
    • 並行呼叫:同時對多個服務發出請求,再整合結果。
    • 知道何時不要用工具:測試顯示,它在「工具呼叫放棄」場景的表現也很不錯(原文數據:工具呼叫放棄約 91.2% 準確)。

    💡 關鍵: 約 91.2% 的工具呼叫放棄準確率,代表它不只會用工具,也懂得在不需要時適時收手。

    你可以把它接到現成 orchestrator(如 MCP、或你自己的 agent framework),讓 BTL-3 再負責「判斷何時用哪個工具」。

    行動建議:

    • 若你已有工具系統(CLI、內部 API),先列出 3–5 個常用操作,包成「工具描述 + I/O 格式」,再讓 BTL-3 透過這些工具完成任務,而不是只輸出文字。

    3. 在 8.39GB GGUF 裡塞進 92% 的 27B 智慧

    BTL-3 原始是 27B 參數模型,但 Bad Theory Labs 用自家量化壓縮技術(AVQ2 解碼、INT4 仿射運算等),做出一個:

    • 單一 GGUF 檔(約 8.39GB)
    • 每參數不到 2.5 bits
    • 保留約 92.2% 原始模型能力

    💡 關鍵: 約 8.39GB 的 GGUF 就保留 92.2% 能力,代表一般開發者電腦即可接近 27B 模型效能。

    一個關鍵指標是 HumanEval pass@1 約 95.12%,這個成績在開源程式模型裡非常高,實際效果就是:

    • 常見演算法題、資料處理、API 包裝腳本,大多可以一次寫對(或只需小修)。

    💡 關鍵: HumanEval pass@1 約 95.12%,表示它在「一次寫對程式」上的成功率已逼近頂級商業程式模型水準。

    行動建議:

    • 若你現在在本地跑的是 7B–8B 一般聊天模型(例如常見的「通用 LLM」),可以直接用同一套 llama.cpp / LM Studio 配置,換成 BTL-3 GGUF,感受一次「針對程式與工具使用優化」的落差。

    適合誰用:三種典型場景

    1. 離線/內網環境的程式開發助手

    如果你的程式碼不能上雲(金融、政府、內網產品),BTL-3 提供一條路:

    • 在機房或開發者筆電本地部署,不經過外部 API。
    • 讓它讀 repo、理解架構、提出修改建議。

    典型任務:

    • 在不同微服務間統一 logging 格式。
    • 為舊專案補上基本 test suite。

    行動建議:

    • 選一個「不能丟到 GitHub Copilot」的專案,讓 BTL-3 先生成一份「系統總覽 + 待改善清單」,作為內網 code review 助手。

    2. 自動化腳本 & 工具串接

    BTL-3 對工具呼叫特別強,適合當成:

    • CLI 自動化腳本生成器:幫我寫一個每天備份某資料夾到 S3 的腳本。
    • 爬蟲與內部 API orchestration:串接 curl、Python script、內部 REST API。

    行動建議:

    • 設計一個小專案:例如「自動整理 log + 發 Slack 通知」,讓 BTL-3 負責生成腳本、再透過工具跑一次,測試它的完整 workflow 能力。

    3. 本地 Agent 開發環境的一顆「程式專家」核心

    你可能已經在用:

    • llama.cpp / vLLM 當推理引擎
    • 本地 IDE 插件(VS Code extension、JetBrains plugin)
    • MCP 或其他 orchestrator 做多工具協調

    BTL-3 可以直接當「程式 & 工具專家」,其他模型負責一般聊天或決策。

    行動建議:

    • 在你的 agent framework 裡,新增一個 coding-agent 路由:
    • 當任務涉及 repo、CLI、API 操作時,轉給 BTL-3。
    • 其他任務仍用通用模型(如 Solar Open 2、Laguna S 2.1 等)。

    下面用表格簡單比較常見選項:

    名稱 核心功能 免費方案 適合誰
    BTL-3 本地程式代理人、工具呼叫 開源、GGUF 免費 想要本地 Copilot / 程式 Agent
    Solar Open 2 長上下文、辦公 & 程式代理 開源模型 文件密集 + 長上下文任務
    Laguna S 2.1 多語言、大型本地通用模型 開源模型 需要高性能通用助手

    相關連結:


    怎麼開始:從硬體到第一個 workflow

    Step 1:確認硬體配置

    官方 8.39GB GGUF 版本的目標是「一般開發者電腦可以跑得動」,實務建議:

    • RAM:16–32GB(越多越穩定)
    • GPU:一張中階卡(8–12GB VRAM 足夠),或純 CPU 也可嘗試
    • 儲存空間:至少預留 20GB 給模型與前端工具

    行動建議:

    • 先在自己的機器跑過任一 7B–8B GGUF 模型,如果能順跑,再換 BTL-3 應可接受。

    Step 2:下載 BTL-3 GGUF 模型

    目前 BTL-3 GGUF 版本由 Bad Theory Labs 釋出(連結通常在 Reddit 原帖或其 X 帳號):

    行動建議:

    • 用瀏覽器或 wget 下載 GGUF 檔到一個固定資料夾,例如:~/models/btl3/btl3-agentic.gguf。

    Step 3:用 llama.cpp / LM Studio / Ollama 載入

    三條常見路徑:

    1. llama.cpp(命令列 / 伺服器模式)
    2. 安裝:依官方 repo 說明編譯。
    3. 啟動 server:
      bash
      ./llama-server \
      -m ~/models/btl3/btl3-agentic.gguf \
      -c 262144 \
      --host 0.0.0.0 --port 8080
    4. 之後透過 HTTP API 或前端連接。

    5. LM Studio

    6. 開啟 LM Studio → Add local model → 指向 GGUF 檔。
    7. 選好推理設定(context 長度、GPU offload),直接在內建聊天介面測試。

    8. Ollama 類工具

    9. 建一個 Modelfile 指向 BTL-3 GGUF。
    10. ollama run btl3 即可啟動本地推理。

    行動建議:

    • 初次使用先從 LM Studio 或類似 GUI 工具開始,快速確認模型品質,再把配置搬到 llama.cpp / server 模式。

    Step 4:實作一個簡單 workflow:讀 repo → 改動 → Patch → 自評測

    以下示範用「BTL-3 + llama.cpp server + 你習慣的 HTTP client」做一個小流程。

    1. 讓 BTL-3 讀 repo
    2. 先用你自己的 script 把重要檔案(README、主要程式入口、config)整理成一個壓縮過的文字輸入。
    3. 發送一個請求:
      json
      {
      "prompt": "你是一個程式代理人。以下是專案的主要檔案內容:...\n\n請先用條列方式整理這個系統的主要模組與依賴,再列出 3 個可以改善的地方。",
      "max_tokens": 2048
      }

    4. 規劃改動

    5. 根據它提出的改善建議,選一項(例如「增加健康檢查 API」),再下指令:
      > 「請為此改動設計一個實作計畫:要改哪些檔案、新增哪些函式、需要哪些測試。」

    6. 生成 Patch

    7. 要求它輸出 git-style unified diff:
      > 「根據上面的計畫,請輸出 unified diff 格式的 patch,適用於 git apply。」

    8. 自評測

    9. 套用 patch,跑測試(可寫成工具讓 BTL-3 呼叫)。
    10. 把測試結果回傳給 BTL-3:
      > 「以下是測試輸出,請根據錯誤訊息更新 patch。」

    行動建議:

    • 把上述流程包成一個腳本或簡單 web UI,讓 BTL-3 成為你團隊的「自動 Patch 提案助手」,從單一專案先試用。

    Step 5:接進你現有的 Agent workflow(如 MCP)

    如果你已在用 MCP 或其他 orchestrator:

    1. 新增一個 LLM provider 指向 BTL-3:
    2. 透過 llama.cpp server / LM Studio API 對接。

    3. 定義工具:

    4. read_repo:讀指定路徑檔案並壓縮輸出。
    5. run_tests:執行 test 命令並回傳 stdout / stderr。
    6. apply_patch:套用 diff 到 repo。

    7. 給 BTL-3 的 system prompt:

    8. 明確告訴它有哪些工具、何時該使用、成功定義(例如「所有測試通過」)。

    行動建議:

    • 在你的 orchestrator 裡,把「所有涉及程式碼修改的任務」預設派給 BTL-3,其他任務仍用通用模型,實際對比整體完成品質與速度。

    BTL-3 的定位很清楚:不是要取代所有模型,而是成為你本地環境裡專門負責「寫程式 + 用工具」的那顆專家模型。如果你正在找一個接近本地版 Copilot / Claude Code 的選擇,它值得你花一個週末搭起來試用。

    🚀 你現在可以做的事

    • 到 Reddit 原帖下載 BTL-3 GGUF,並用 LM Studio 或 llama.cpp 在本地先跑一輪測試
    • 選一個不能上雲的專案,讓 BTL-3 產生「系統總覽 + 改善清單」,試做一次 Patch workflow
    • 在你現有的 agent framework 中新增 coding-agent 路由,將程式與工具相關任務導向 BTL-3 並觀察效果
  • 一句話搞懂 Gemini 3.6 Flash 家族

    一句話搞懂 Gemini 3.6 Flash 家族

    📌 本文重點

    • 3.6 Flash:多模態主力模型,長文省 token
    • Flash-Lite:專攻低延遲、低成本 API 場景
    • Flash Cyber + CodeMender:程式碼安全掃描與修補解決方案
    • 先用 AI Studio 試 3.6 Flash,再視需求串 API 與導入安全模型

    用一句話講清楚:Gemini 3.6 Flash 家族,就是「一套便宜好用、從寫作到程式安全都能涵蓋」的多模態模型組合,讓一般用戶寫內容、開發者串 API、安全團隊掃漏洞,都有對應的工具可用。


    一句話搞懂三個 Flash 模型怎麼分工

    先用一行幫你記住三款模型的定位:

    3.6 Flash 負責主力多模態(長文本、省錢),3.5 Flash-Lite 負責低延遲 API,3.5 Flash Cyber 搭 CodeMender 負責程式碼安全掃描與修補。

    💡 關鍵: 3 款模型分工明確,從內容生成到大量 API 呼叫再到安全掃描,都有專門工具可選,用對模型就能兼顧效果與成本。

    對應到你的需求,很簡單:

    • 想寫作、翻譯、看圖、看 PDF 👉 用 3.6 Flash
    • 想做聊天機器人、內部 FAQ Bot 👉 後端 API 選 Flash-Lite
    • 想掃 Repo 漏洞、產安全修補 PR 👉 用 Flash Cyber + CodeMender

    官方介紹與細節可參考:


    核心功能:為什麼說「免費又省錢」

    1. Gemini 3.6 Flash:多模態主力+省 65% token

    3.6 Flash 是這次更新的主角:

    • 多模態能力:支援文字、圖片、程式碼、文件,拿圖請它「幫我總結這張資訊圖」,或把 PDF 貼給它做重點整理都很適合。
    • 長上下文+節省 token:官方說明可 節省最多約 65% token 使用量(來源:The Decoder 報導),等於同樣一篇長文,token 花費更低。
    • 適合當「日常主力模型」:寫文章、改寫、翻譯、整理會議記錄、理解技術文件,都可以直接丟給 3.6 Flash。

    💡 關鍵: 最多節省約 65% token,代表在長文本情境下能顯著壓低使用成本,特別適合高頻率內容工作者。

    你可以做的事:

    • 開啟 Google AI Studio,用 3.6 Flash 當預設模型,先試三件事:
    • 貼一篇你最近寫的文章,請它「改寫成 3 點精簡重點」
    • 上傳一張複雜圖表,問它「用白話講裡面的結論」
    • 貼一段英文技術文件,請它「翻譯+加註解」

    入口:Google AI Studio(免信用卡可先玩)👉 https://aistudio.google.com

    2. 3.5 Flash-Lite:給開發者的低延遲 API

    Flash-Lite 是 3.5 Flash 的精簡版,定位很清楚:給需要大量 API 呼叫、講求速度和成本的開發者。

    特點:

    • 低延遲:用在聊天機器人、即時問答服務,不會讓使用者等太久。
    • 便宜:相較大型模型,Flash-Lite 的單次呼叫成本更低,適合 side project 或公司內部工具。

    你可以做的事:

    • 做一個公司內部 FAQ Bot:
    • 把人資 / IT / 行政 FAQ 整理成一個 JSON 或資料庫
    • 用自家後端(Node.js / Python)接 Gemini API,模型選 Flash-Lite
    • 在前端做一個簡單聊天視窗,把使用者問題送給 Flash-Lite,再加上你的 FAQ 檢索結果

    💡 關鍵: Flash-Lite 把「低延遲+低成本」綁在一起,特別適合需要高併發、多次呼叫的聊天與工具型應用。

    3. 3.5 Flash Cyber + CodeMender:安全掃描+自動修補

    Flash Cyber 是專門做 程式碼安全 的模型,主要搭配 Google 的安全編碼代理工具 CodeMender 使用。

    重點能力:(來源:The Verge 報導)

    • 快速發現與標記安全漏洞:支援多次高速呼叫,掃整個 Repo 的潛在問題。
    • 產生修補建議甚至自動 PR:透過 CodeMender,可直接給出修補的 patch 或 Pull Request。
    • 比同類大型安全模型(如 Anthropic Mythos)更具成本效益:適合 DevSecOps 團隊把「安全掃描」變成 CI pipeline 的一環。

    你可以做的事:

    • 把 Flash Cyber+CodeMender塞進你的 CI/CD:
    • 選定關鍵 Repo(例如:支援金流的服務)
    • 在 CI pipeline 增加一個步驟呼叫 CodeMender(綁 Flash Cyber)做安全掃描
    • 設定「阻擋條件」:偵測到高危漏洞就阻擋部署,並自動開 Issue / PR 給開發者

    注意:Flash Cyber 目前偏向提供給政府與可信任夥伴,普通開發者需要留意資格與開放程度(可留意 DeepMind 官網更新)。


    三款模型一張表看懂

    名稱 核心功能 免費方案 / 試用 適合誰
    Gemini 3.6 Flash 多模態主力、長上下文、省 token Google AI Studio 線上免費試用 一般使用者、內容創作者、分析師
    3.5 Flash-Lite 低延遲、低成本 API Cloud 上有免費額度與試用配額 Side project 開發者、內部工具團隊
    3.5 Flash Cyber 程式碼與安全漏洞掃描+修補 目前對政府與特定夥伴開放 安全團隊、DevSecOps、雲端平台營運方

    適合誰用:三類典型場景

    1)個人用戶:寫作、翻譯、圖片理解

    你只想要一個好用又省錢的 AI 助理,重點就是:全部用 3.6 Flash 就好。

    具體可以這樣用:

    • 寫作:給它「大綱+口氣要求」,讓它幫你產出初稿,再自己微調
    • 翻譯:把英文技術文章貼上,請它「翻譯成繁體中文+保留術語」
    • 圖片理解:上傳會議投影片截圖,問「這張的重點是什麼?幫我變成三點待辦事項」

    2)開發者:side project/內部工具串 Flash-Lite

    你要的是:API 便宜+速度可以接受,而不是每次都上最強的大模型。

    典型 side project:

    • 公司內部 FAQ Bot
    • 報表解說助手(讀 CSV / JSON,整合你自己的後端邏輯)
    • 客戶服務前台聊天機器人

    做法:

    1. 在 Google AI Studio 建一個新 API Key
    2. 後端選 Node.js / Python,用官方 SDK 串接
    3. 模型選 3.5 Flash-Lite,加上你自己的向量資料庫或關鍵字搜尋

    3)安全/DevSecOps:Flash Cyber + CodeMender

    如果你的工作是:

    • 管理大規模微服務 Repo
    • 維護金融或政府相關系統

    就可以把 Flash Cyber 當成「安全同事」,在以下場景使用:

    • 每次合併 PR 前,跑一次安全掃描
    • 每季度對關鍵服務做「全面程式碼健康檢查」
    • 新人上線前,先掃他改動的部分,避免引入基本錯誤

    怎麼開始:從線上玩到串 API

    步驟 1:用 Google AI Studio 線上試玩

    1. 打開 https://aistudio.google.com
    2. 登入 Google 帳號
    3. 在模型列表選 Gemini 3.6 Flash
    4. 嘗試:
    5. 貼一段你公司文件,請它「整理成給新人看的版本」
    6. 上傳一張圖表,請它「用中學生也懂的方式解釋」

    這一步的目的:先確認 3.6 Flash 的表現符合你的期待,再考慮串 API。

    步驟 2:拿 API Key 串自己的 side project

    1. 進 Google AI Studio,切到 API / Key 管理
    2. 建立一個新專案,生成 API Key
    3. 後端程式碼示意(以 Node.js 為例):
    npm install @google/generative-ai
    
    import { GoogleGenerativeAI } from "@google/generative-ai";
    
    const genAI = new GoogleGenerativeAI(process.env.GEMINI_API_KEY);
    const model = genAI.getGenerativeModel({ model: "gemini-3.5-flash-lite" });
    
    async function ask(question) {
      const result = await model.generateContent(question);
      console.log(result.response.text());
    }
    

    你可以立刻把這段變成:

    • FAQ Bot:把使用者問題+你整理出的 FAQ 一起丟進 prompt
    • 報表解說助手:先由後端讀取 CSV,算出數字,再請模型「用文字說明這些指標變化」

    步驟 3:學會「選模型+估成本」

    粗略的模型選擇與成本思路:

    • 優先用 Flash 系列:
    • 若是內容生成/多模態理解 👉 3.6 Flash
    • 若是大量聊天/高併發問答 👉 3.5 Flash-Lite
    • 若是安全掃描 👉 Flash Cyber
    • 遇到以下情況再考慮大模型(如 Pro 類型):
    • 極高難度推理
    • 任務對準確度要求極端嚴格

    估成本的簡單方法:

    1. 在 AI Studio 看一次 token 使用量,記下「平均一次請求的 token 數」
    2. 估計每日請求次數(例如:1,000 次)
    3. 套用 Cloud 價格表(官方文件),算出每月概算
    4. 如果超出預算,先:
    5. 改用 Flash-Lite
    6. 精簡 prompt(例如縮短系統指令、用摘要代替全文)

    小結:把 Gemini 3.6 Flash 家族當成你的「AI 三件套」

    實際用起來,你可以這樣記:

    • 3.6 Flash:我日常寫作、看圖、看文件的主力
    • Flash-Lite:我做聊天機器人和內部工具時的省錢 API
    • Flash Cyber + CodeMender:我在 Repo 上的安全掃描與自動修補幫手

    先從 AI Studio 免費玩 3.6 Flash 開始,熟悉手感之後,拿 API Key 把 Flash-Lite 接進你的 side project,最後視公司安全需求再評估導入 Flash Cyber,這樣就能用最低成本,讓 Gemini 3.6 Flash 家族成為你工作流程裡的多模態新主力。

    🚀 你現在可以做的事

    • 打開 Google AI Studio,用 Gemini 3.6 Flash 試跑你手上的文章、圖表或技術文件
    • 申請 API Key,照文中的 Node.js 範例把 3.5 Flash-Lite 串進一個小型 FAQ Bot 或報表說明工具
    • 若你在安全/DevSecOps 團隊,追蹤 DeepMind 官方關於 Flash Cyber 與 CodeMender 的開放狀態,評估未來導入到 CI/CD Pipeline
  • moonshine 實戰:10 行程式碼做語音代理

    moonshine 實戰:10 行程式碼做語音代理

    📌 本文重點

    • moonshine 是可本地部署的低延遲語音代理 C++ pipeline
    • 一條 pipeline 完成 STT、意圖辨識與 TTS
    • 適合客服熱線、語音面板與 IoT 離線語音控制
    • 可直接接上任意 REST API 打造專屬語音 agent

    只想做一個語音版 ChatGPT、客服機器人,卻不想被雲端 API 綁死、每月付帳單?moonshine 就是那套「自己裝在機器上、一次搞定語音輸入+理解+回覆」的 C++ pipeline。

    原始碼在 GitHub:https://github.com/moonshine-ai/moonshine


    核心功能:一條語音 pipeline,全都自己掌控

    moonshine 的定位很直接:

    Very low latency speech to text, intent recognition, and text to speech, for building voice agents and interfaces.

    你可以把它想成「本地版語音代理引擎」——不是雲端服務,而是一個可以編譯進你自己程式的 C++ library/工具。

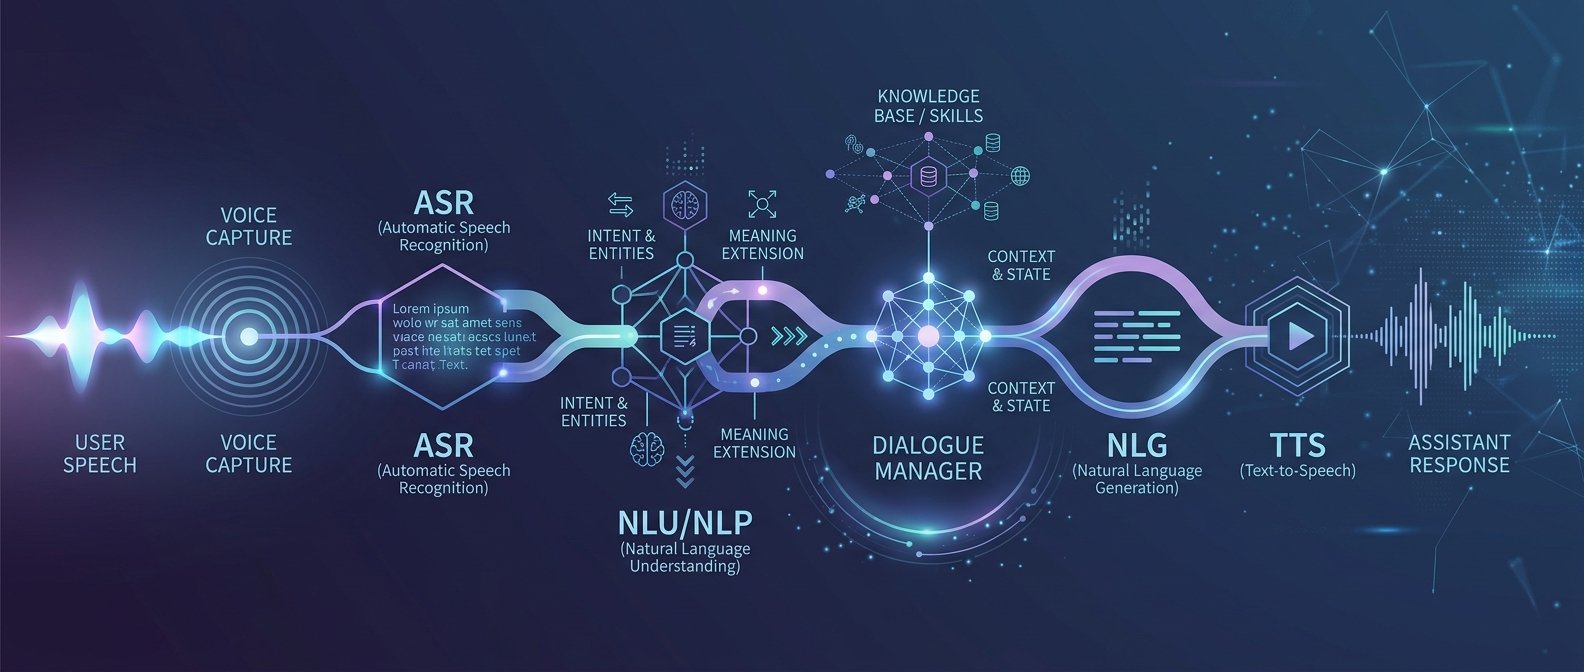
    💡 關鍵: moonshine 把 STT、意圖辨識與 TTS 串成單一低延遲 pipeline,從輸入到輸出都在你自己的機器上完成。

    1. 語音輸入:低延遲 STT(Speech-to-Text)

    • 功能:把麥克風語音即時轉成文字,延遲低,適合對話場景。
    • 實際效果:跑在桌機或中高階單板機上,可以做到「你講一句,它同時開始辨識」的互動感。
    • 你可以立刻做的事:
    • 把它接到客服電話錄音,轉成文字後送到 FAQ 引擎。
    • 接到操作面板上,用語音替代滑鼠點選。

    2. 意圖辨識:Intent Recognition

    • 功能:從文字中判斷「使用者想做什麼」,例如:查訂單、開支援 ticket、關燈、查庫存。
    • moonshine 的做法:把語音轉文字後,丟進意圖模型(可換成你自己訓練的分類器/LLM)。
    • 你可以立刻做的事:
    • 自訂幾個意圖(如 查訂單、問價格、人工轉接),用簡單規則或模型判斷要打到哪個 API。

    3. 語音輸出:TTS(Text-to-Speech)

    • 功能:把系統回覆文字轉成語音,直接播放給使用者。
    • 實際效果:完成一個「講話→理解→查資料→講回來」的完整迴路,不需要外接雲端 TTS。
    • 你可以立刻做的事:
    • 做一個「語音 FAQ 機器人」,接電話後用 TTS 讀出答案。
    • 做桌面語音助理,說出系統通知或報表摘要。

    適合誰用:三種典型場景

    1. 客服/熱線:電話接起來就有語音機器人

    問題情境:

    • 只想讓機器人先接電話、回答常見問題或先收集基本資料,但不想把所有通話丟到雲端 AI。

    moonshine 的用法:

    • 把語音輸入接到電話系統的音訊流(VoIP/SIP 方案都可),用 STT 轉文字。
    • 用意圖辨識判斷是「查訂單」「問營業時間」「真人客服」。
    • 走不同後端 API,最後用 TTS 回覆。

    你可以立刻做的實驗:

    • 先不接真正電話,用錄音檔或麥克風假裝客戶提問,串一個「FAQ 搜尋 API」,測試回答流程。

    2. 語音面板:替既有系統加一層「講話就能操作」

    問題情境:

    • 你有一套 SaaS 或內部系統(CRM、ERP、工單系統),想讓使用者用「語音」查資料、下指令,但不想大改前端。

    moonshine 的用法:

    • 在桌面 app 或 web 前端旁放一個小語音代理程式:
    • 監聽麥克風 → STT → 判斷意圖 → 呼叫既有 REST API → 整理結果 → TTS 講回來或貼在 UI。

    你可以立刻做的實驗:

    • 選一個已有的 REST API(例如:查客戶資訊),用下方「10 行程式碼」範例改成語音查詢。

    3. IoT/嵌入式:低資源設備上的離線語音控制

    問題情境:

    • 想做離線語音控制:開關設備、切換模式,但硬體算力有限、網路不穩。

    moonshine 的用法:

    • 把精簡版模型放在裝置上(例如 ARM 單板機),只做幾個固定意圖:
    • 「開燈」「關燈」「設定 25 度」等,直接對接硬體控制程式。

    💡 關鍵: 在 IoT 裝置離線情境下,moonshine 可只保留少數固定意圖,大幅降低對算力與網路的依賴。

    你可以立刻做的實驗:

    • 在一台樹莓派或小型工控機上跑最簡 demo,先做「聽到關燈就印出 turn_off_light」的文字,再接上 GPIO 控制。

    怎麼開始:從 GitHub clone 到第一個語音 agent

    💡 關鍵: 從 git clone 到可用 demo,大致只需一次編譯與模型下載,就能完整體驗整條語音 pipeline。

    1. 先把專案拉下來、編譯成功

    1. 安裝基本依賴(以 Ubuntu 為例):

    bash
    sudo apt update
    sudo apt install -y git cmake build-essential

    1. Clone 專案:

    bash
    git clone https://github.com/moonshine-ai/moonshine.git
    cd moonshine

    1. 編譯:

    bash
    mkdir build && cd build
    cmake ..
    make -j$(nproc)

    完成後,你會得到可以執行的示範程式(名稱以官方 repo 為準,一般會有 demo/example 可跑)。

    2. 跑最簡 demo:確認 STT / TTS pipeline

    官方 repo 一般會提供類似:

    ./moonshine_demo --input mic --output speaker
    

    典型流程會是:

    1. 啟動程式,指定輸入為麥克風、輸出為喇叭。
    2. 程式下載或載入預設 STT/TTS 模型(通常第一次跑會需要網路)。
    3. 你講一句話,終端機顯示辨識出的文字,並用 TTS 回覆一句預設回答。

    具體參數以官方 README 為準,重點是:先確認你機器上的音訊裝置、模型下載都 OK。

    3. 配置模型:STT / TTS / Intent 拆清楚

    在實際專案中,你要決定三件事:

    1. STT 模型:
    2. 選語系(中文/英文等)和大小(依你設備算力)。
    3. moonshine 通常會支援多種 backend,可以在 config 檔或啟動參數指定。
    4. TTS 模型:
    5. 選擇語音風格(男聲/女聲)和延遲表現。
    6. 在設定中指定 model path 或使用預設 URL 拉取。
    7. Intent 模型或規則:
    8. 簡單做法:先用關鍵字+正則,把意圖分成幾類。
    9. 進階做法:接上本地 LLM(例如使用你現有的推論服務)做意圖分類。

    你可以建立一個簡單的 config.json:

    {
      "stt_model": "models/stt_zh_small.bin",
      "tts_model": "models/tts_zh_small.bin",
      "intent_backend": "http://localhost:8000/intent"
    }
    

    程式啟動時讀取這個 config,就能自由替換模型和意圖服務。

    4. 10 行程式碼:把任何 REST API 包成語音代理

    以下用「C++ + moonshine + 一個任意 REST API」示意,把核心流程壓縮成約 10 行邏輯。實際使用時需依官方 API 做正確呼叫。

    #include "moonshine.h"      // 假設提供 STT / TTS 接口
    #include <httplib.h>         // 用任意 HTTP client
    
    int main() {
        MoonshineAgent agent{"config.json"};              // 載入 STT/TTS 設定
        httplib::Client api("https://api.yourservice.com");
    
        while (true) {
            std::string text = agent.listen();             // 1. 麥克風→文字
            auto res = api.Get("/search?query=" + text);  // 2. 呼叫任意 REST API
            std::string reply = res->body;                 // 3. 取回文字結果
            agent.speak(reply);                            // 4. TTS 語音回覆
        }
    }
    

    這個基本版就已經是一個「語音代理壓在你自己的後端」:

    • 你說話 → STT -> text
    • 丟到你預先寫好的 API(可以是 FAQ 搜尋、工單建立、資料查詢)
    • 回傳文字 → 用 TTS 說回來

    你可以改幾行,就變成不同場景:

    • 客服熱線:把 text 先送進意圖辨識 API,再決定要打哪一個後端。
    • 語音面板:把 reply 不是用 TTS,而是顯示在 UI,TTS 只讀重點。
    • IoT 控制:把 api.Get(...) 換成控制硬體的函式,例如 set_light(false)。

    小結:想自己掌控語音代理,就先把 moonshine 跑起來

    如果你:

    • 不想被雲端 STT/TTS 綁約
    • 想在桌面 app、行動裝置或後端服務內嵌語音代理

    那 moonshine 提供的就是一個單純、可編譯進你程式的 C++ 語音 pipeline。從 GitHub clone 下來,先跑官方 demo,再按照上面範例把你的 REST API 接上去,你就能在一台機器上完成第一個「可用的語音 agent」。

    🚀 你現在可以做的事

    • 前往 moonshine GitHub 專案 clone 並完成一次編譯與官方 demo 執行
    • 寫一個簡單的 config.json,指定本地 STT/TTS 模型與一個測試用意圖服務 endpoint
    • 按照文中「10 行程式碼」範例,挑一個現有 REST API,實作一個可對答的語音查詢小工具
  • 用 Whisper+Ollama 做一個本地語音助理

    用 Whisper+Ollama 做一個本地語音助理

    📌 本文重點

    • 用 Whisper+Ollama 做完全本地語音助理
    • 語音→文字→LLM→語音的完整閉環
    • 30 分鐘內跑起最小可行版本
    • 資料與聲音全留在自己機器上

    一句話就能叫得動電腦,而你的聲音和資料完全留在自己機器上,這就是用 Whisper+Ollama 做本地語音助理要解決的問題。

    參考原文:Build a Fully Local Voice Assistant With Whisper and Ollama(Towards AI)
    https://pub.towardsai.net/build-a-fully-local-voice-assistant-with-whisper-and-ollama-e5e6f713a220


    核心架構:一句話進,AI 一句話回

    這個本地語音助理由三塊組成:

    1. Whisper:把「語音 → 文字」(Speech-to-Text)
    2. Ollama + 本地 LLM:負責理解與生成文字回應
    3. 任一 TTS(Text-to-Speech):把「文字 → 語音」再念出來

    整體流程:

    1. 按快捷鍵開始錄音
    2. Whisper 辨識成文字指令
    3. 文字送到本地 LLM(透過 Ollama)推理
    4. 回傳文字答案,再由 TTS 念出

    💡 關鍵: Whisper+Ollama+TTS 組成「完全本地、無需雲端」的語音互動閉環。

    下文會先講三個核心功能,再看哪些人適合用,最後給一個可以在 30 分鐘內跑起來的最小範例。


    核心功能:你可以用聲音做什麼

    1. 聲控指令:一句話叫電腦做事

    你可以用自然語言下達指令,背後由 LLM 把「人話」轉成實際操作(shell 指令、API 呼叫或執行特定程式)。

    可做的事例如:

    • 「幫我開啟 VS Code 並打開 project 資料夾」
    • 「開始錄音會議,結束時幫我整理重點」
    • 「幫我查今天的天氣,再念給我聽」

    實作上,你可以:

    • 在 LLM 回應中約定一個格式,例如輸出 {"action": "open_app", "target": "VSCode"}
    • 程式解析 JSON,對應到不同的系統操作(Python 用 subprocess、Node 用 child_process)

    2. 問答與解說:本地 ChatGPT,用嘴巴問

    Ollama 支援多種本地模型(如 Llama、Qwen),你可以當成「只在本地跑的 ChatGPT」:

    • 「用白話講一次這段程式在做什麼」
    • 「幫我設計一個 3 天東京行程,預算一天 5000 台幣」
    • 「這篇英文信幫我改寫得更禮貌」

    如果你在意隱私(公司機密、未發表研究),這類內容只會停留在你的機器,不會上雲端。

    💡 關鍵: 對隱私敏感的程式碼、文件與會議內容,都可以在本地模型中處理而不外流。

    3. 筆記與總結:會議錄完直接變摘要

    結合 Whisper 長錄音能力,你可以:

    • 開會時一直錄音,會後自動產出:
    • 決議事項
    • 待辦清單
    • 各參與者的責任分工
    • 學習影片邊聽邊錄,最後生成「重點整理 + 閱讀筆記」

    做法:

    1. 持續錄音,分段送 Whisper 辨識
    2. 把完整文字餵給 LLM,提示詞(prompt)中要求輸出特定格式:例如「請用 5 點整理會議重點,並列出行動項目」

    適合誰用:具體場景示例

    1. 常開線上會議的知識工作者

    使用方式:

    • 開會前按快捷鍵啟動錄音
    • 會議中不必手寫紀錄
    • 開完會輸出「摘要+待辦」,貼回 Notion / Obsidian

    好處:

    • 不用依賴雲端錄音服務
    • 內部機密內容留在公司內網或個人電腦

    2. 開發者的語音 Coding 小助手

    使用方式:

    • 「幫我生成一個 Python 函數,讀取 CSV 並輸出 JSON」
    • 「這段錯誤訊息說什麼?幫我猜可能原因」
    • 「把這段程式重構成 class 寫法」

    你可以直接把 LLM 回應輸出到檔案,或搭配編輯器 API 完成簡單的自動插入。

    3. 家庭中控 / 桌面自動化

    使用方式:

    • 「關掉 Spotify,改播 YouTube 音樂」
    • 「打開家裡 NAS 的網頁介面」
    • 「查一下電價 API,現在是不是離峰」

    背後是:

    • LLM 產生要呼叫的 API 名稱 + 參數
    • 程式把它映射到實際的 REST API or Shell 指令

    工具比較:Whisper、Ollama、TTS

    名稱 核心功能 免費方案 適合誰
    Whisper 語音轉文字(STT) 開源、免費 要離線語音辨識的人
    Ollama 管理與執行本地 LLM 開源、免費 想在本地跑各種模型的人
    Coqui TTS 本地語音合成(TTS) 開源、免費 想客製化聲音的開發者
    pyttsx3 / edge-tts 簡單 TTS,快速上手 免費 只要能聽到回應即可的人

    Whisper GitHub:https://github.com/openai/whisper
    Ollama 官網:https://ollama.com


    怎麼開始:30 分鐘跑起一個最小版本

    下面以 Python+Whisper+Ollama+簡單 TTS 為例,目標是做到:

    按快捷鍵 → 說話 → AI 在本地回答並念出來

    💡 關鍵: 只要有 8GB RAM 和 Python 環境,大多數電腦在約 30 分鐘內就能完成這套本地語音助理的基本版。

    1. 最小硬體與環境需求

    • 作業系統:macOS / Linux / Windows(建議 10 以上)
    • RAM:至少 8 GB(12–16 GB 更順)
    • GPU:有當然更快,沒有也可跑小模型
    • Python 3.10+(或 Node 也可以,本文用 Python)

    2. 安裝 Ollama 與模型

    1. 到 https://ollama.com 下載並安裝
    2. 開啟終端機,拉一個小模型(例如 llama3.2 或 qwen2.5):
    ollama pull llama3.2
    # 或
    ollama pull qwen2.5
    
    1. 測試一次:
    ollama run llama3.2
    

    能對話就表示後面 Python 可以直接透過 HTTP 使用它。

    3. 安裝 Whisper 與 TTS

    建立虛擬環境(可選,但建議):

    python -m venv venv
    source venv/bin/activate  # Windows: venv\Scripts\activate
    

    安裝必要套件:

    pip install openai-whisper sounddevice numpy requests pyttsx3
    

    說明:

    • openai-whisper:Whisper STT
    • sounddevice:錄音
    • pyttsx3:離線 TTS(Windows/macOS/Linux 都可用)
    • requests:呼叫 Ollama HTTP API

    4. 最小可行 main.py

    下面是一個簡化範例:按 Enter 開始錄音,Ctrl+C 結束程式。你可以之後再綁定系統快捷鍵(如 AutoHotkey、Karabiner)。

    import sounddevice as sd
    import numpy as np
    import whisper
    import requests
    import pyttsx3
    
    MODEL_NAME = "llama3.2"  # 或改成 "qwen2.5" 等你已拉下的模型
    OLLAMA_URL = "http://localhost:11434/api/generate"
    
    whisper_model = whisper.load_model("small")  # 可換 tiny / base / small / medium
    engine = pyttsx3.init()
    
    SAMPLE_RATE = 16000
    DURATION = 5  # 錄音秒數,可改成你想要的
    
    
    def record_audio(duration=DURATION):
        print("開始錄音,請說話...")
        audio = sd.rec(int(duration * SAMPLE_RATE), samplerate=SAMPLE_RATE, channels=1)
        sd.wait()
        print("錄音結束")
        return np.squeeze(audio)
    
    
    def speech_to_text(audio):
        print("正在轉文字...")
        result = whisper_model.transcribe(audio, fp16=False)
        text = result["text"].strip()
        print(f"你說:{text}")
        return text
    
    
    def call_ollama(prompt):
        print("正在思考...")
        resp = requests.post(
            OLLAMA_URL,
            json={"model": MODEL_NAME, "prompt": prompt},
            stream=False,
        )
        data = resp.json()
        answer = data.get("response", "")
        print(f"AI:{answer}")
        return answer
    
    
    def speak(text):
        engine.say(text)
        engine.runAndWait()
    
    
    if __name__ == "__main__":
        try:
            while True:
                input("按 Enter 開始錄音(Ctrl+C 結束):")
                audio = record_audio()
                text = speech_to_text(audio)
                if not text:
                    continue
                answer = call_ollama(text)
                speak(answer)
        except KeyboardInterrupt:
            print("\n結束程式")
    

    執行:

    python main.py
    

    流程:

    1. 按 Enter → 錄音 5 秒
    2. Whisper 轉文字 → 顯示你說的話
    3. 文字送到 Ollama → LLM 回答
    4. pyttsx3 把文字念出來

    你已經完成一個基本版「本地語音 ChatGPT」。接下來就可以:

    • 把錄音時間改成動態(按住鍵才錄)
    • 在 call_ollama 的 prompt 中加入系統指令,例如:「你是一個會輸出 JSON 指令的系統助手」
    • 在 answer 中解析 JSON,呼叫不同的系統功能

    換成本地 Qwen、Llama 模型與低配機調整建議

    換模型:Qwen、Llama 等

    Ollama 已經預設支援多個模型,換模型只要:

    1. 先拉模型:
    ollama pull qwen2.5
    ollama pull llama3.1
    
    1. 把 MODEL_NAME 改成相對應名稱,例如:
    MODEL_NAME = "qwen2.5"
    # 或
    MODEL_NAME = "llama3.1"
    
    1. 重新執行 main.py 即可。

    低配機(8GB RAM / 無 GPU)調優建議

    • Whisper 模型:改用 tiny 或 base:
      python
      whisper_model = whisper.load_model("tiny")
    • LLM 模型:優先選擇 *-mini 或 3B 以內的小模型(例如 llama3.2 small 版)
    • TTS:選 pyttsx3 這種輕量離線 TTS,避免重型神經網路 TTS
    • 錄音長度:縮短單次錄音(例如 3–5 秒),減少 STT 負載
    • 批次模式:需要長會議紀錄時,可先用系統錄音軟體錄整段,之後分段丟給 Whisper 處理

    總結:把「叫電腦做事」變成一句話

    你現在已經有一套可以在本地跑的語音助理:

    • Whisper 負責聽懂你說什麼
    • Ollama+本地模型負責思考與生成回應
    • TTS 負責把答案念出來

    從這個最小版本開始,你可以一步步加上:「控制應用程式」、「呼叫 API」、「自動整理會議紀錄」,最後變成一個完全客製化的本地語音中控系統。

    🚀 你現在可以做的事

    • 安裝 Ollama 並拉下 llama3.2 或 qwen2.5 模型,在終端測試對話
    • 建立 Python 虛擬環境,安裝 openai-whisper、sounddevice、pyttsx3 等套件後跑起 main.py
    • 改寫 call_ollama 部分,讓回應輸出 JSON 指令,開始用語音控制你的桌面或 API